Úvod
Dokumentace k TeskaLabs LogMan.io
Vítejte v dokumentaci TeskaLabs LogMan.io.
TeskaLabs LogMan.io
TeskaLabs LogMan.io™️ je softwarový produkt pro sběr logů, agregaci logů, ukládání a retenci logů, analýzu logů v reálném čase a rychlou reakci na incidenty v IT infrastruktuře, souhrnně známé jako správa logů.
TeskaLabs LogMan.io se skládá z centrální infrastruktury a kolektorů logů, které se nacházejí na monitorovaných systémech, jako jsou servery nebo síťová zařízení. Kolektory logů shromažďují různé logy (operační systém, aplikace, databáze) a systémové metriky, jako je využití CPU, využití paměti, volné místo na disku atd. Shromážděné události jsou v reálném čase odesílány do centrální infrastruktury pro konsolidaci, orchestraci a uložení. Díky své povaze v reálném čase poskytuje LogMan.io alerty pro anomální situace z pohledu provozu systému (např. je místo na disku nedostatečné?), dostupnosti (např. běží aplikace?), byznysu (např. je počet transakcí pod normálem?) nebo bezpečnosti (např. nějaký neobvyklý přístup k serverům?).
TeskaLabs SIEM
TeskaLabs SIEM je real-time nástroj pro Security Information and Event Management. TeskaLabs SIEM poskytuje analýzu a korelaci bezpečnostních událostí a alertů v reálném čase zpracovávaných TeskaLabs LogMan.io. Návrh TeskaLabs SIEM je zaměřen na zlepšení kybernetické bezpečnosti a dosažení souladu s předpisy.
Více komponent
TeskaLabs SIEM a TeskaLabs LogMan.io jsou samostatné produkty. Díky své modulární architektuře tyto produkty zahrnují také další technologie TeskaLabs:
- TeskaLabs SeaCat Auth pro autentizaci a autorizaci včetně uživatelských rolí a jemně zrnitého řízení přístupu.
- TeskaLabs SP-Lang je výrazový jazyk používaný na mnoha místech v produktu.
Vytvořeno s ❤️ TeskaLabs
TeskaLabs LogMan.io™️ je produkt TeskaLabs.
Funkce
TeskaLabs LogMan.io je real-time SIEM s log managementem.
- Multitenance: jedna instance TeskaLabs LogMan.io může sloužit více tenantům (zákazníkům, oddělením).
- Multiuser: TeskaLabs LogMan.io může být používán neomezeným počtem uživatelů současně.
Technologie
Kryptografie
- Transportní vrstva: TLS 1.3
- Symetrická kryptografie: AES-128, AES-256
- Asymetrická kryptografie: RSA, ECC
- Hash metody: SHA-256, SHA-384, SHA-512
- MAC funkce: HMAC
- HSM: PKCS#11 rozhraní
Poznámka
TeskaLabs LogMan.io používá pouze silnou kryptografii, což znamená, že používáme pouze tyto šifry, hashovací funkce a další algoritmy, které jsou uznávány jako bezpečné kryptografickou komunitou a organizacemi jako ENISA nebo NIST.
Podporované zdroje logů
TeskaLabs LogMan.io podporuje různé technologie, které jsou uvedeny níže.
Formáty
- Syslog RFC 5424 (IEFT)
- Syslog RFC 3164 (BSD)
- Syslog RFC 3195 (BEEP profil)
- Syslog RFC 6587 (Rámce přes TCP)
- Reliable Event Logging Protocol (RELP), včetně SSL
- Windows Event Log
- SNMP
- ArcSight CEF
- LEEF
- JSON
- XML
- YAML
- Avro
- Vlastní/surový formát logu
A mnoho dalších.
Info
Syslog protokoly mohou být přenášeny přes TCP, UDP a TLS/SSL.
Prodejci a produkty
Cisco
- Cisco Firepower Threat Defense (FTD)
- Cisco Adaptive Security Appliance (ASA)
- Cisco Identity Services Engine (ISE)
- Cisco Meraki (MX, MS, MR zařízení)
- Cisco Catalyst Switches
- Cisco IOS
- Cisco WLC
- Cisco ACS
- Cisco SMB
- Cisco UCS
- Cisco IronPort
- Cisco Nexus
- Cisco Routers
- Cisco VPN
- Cisco Umbrella
Palo Alto Networks
- Palo Alto Next-Generation Firewalls
- Palo Alto Panorama (Centrální správa)
- Palo Alto Traps (Ochrana koncových bodů)
Fortinet
- FortiGate (Next-Generation Firewalls)
- FortiSwitch (Přepínače)
- FortiAnalyzer (Log Analytics)
- FortiMail (Bezpečnost emailů)
- FortiWeb (Web Application Firewall)
- FortiADC
- FortiDDos
- FortiSandbox
Juniper Networks
- Juniper SRX Series (Firewally)
- Juniper MX Series (Routery)
- Juniper EX Series (Přepínače)
Check Point Software Technologies
- Check Point Security Gateways
- Check Point SandBlast (Prevence hrozeb)
- Check Point CloudGuard (Cloudová bezpečnost)
Microsoft
- Microsoft Windows (Operační systém)
- Microsoft Azure (Cloudová platforma)
- Microsoft SQL Server (Databáze)
- Microsoft IIS (Web server)
- Microsoft Office 365
- Microsoft Exchange
- Microsoft Sharepoint
Linux
- Ubuntu (Distribuce)
- CentOS (Distribuce)
- Debian (Distribuce)
- Red Hat Enterprise Linux (Distribuce)
- IPTables
- nftables
- Bash
- Cron
- Kernel (dmesg)
Oracle
- Oracle Database
- Oracle WebLogic Server (Aplikační server)
- Oracle Cloud
Amazon Web Services (AWS)
- Amazon EC2 (Virtuální servery)
- Amazon RDS (Databázová služba)
- AWS Lambda (Serverless Computing)
- Amazon S3 (Služba úložiště)
VMware
- VMware ESXi (Hypervisor)
- VMware vCenter Server (Správní platforma)
F5 Networks
- F5 BIG-IP (Aplikační datové řadiče)
- F5 Advanced Web Application Firewall (WAF)
Barracuda Networks
- Barracuda CloudGen Firewall
- Barracuda Web Application Firewall
- Barracuda Email Security Gateway
Sophos
- Sophos XG Firewall
- Sophos UTM (Unified Threat Management)
- Sophos Intercept X (Ochrana koncových bodů)
Aruba Networks (HPE)
- Aruba Switches
- Aruba Wireless Access Points
- Aruba ClearPass (Kontrola přístupu k síti)
- Aruba Mobility Controller
HPE
- iLO
- IMC
- HPE StoreOnce
- HPE Primera Storage
- HPE 3PAR StoreServ
Trend Micro
- Trend Micro Deep Security
- Trend Micro Deep Discovery
- Trend Micro TippingPoint (Prevence průniků)
- Trend Micro Endpoint Protection Manager
- Trend Micro Apex One
Fidelis
- Fidelis Elevate
Zscaler
- Zscaler Internet Access (Secure Web Gateway)
- Zscaler Private Access (Vzdálený přístup)
Akamai
- Akamai (Content Delivery Network a Bezpečnost)
- Akamai Kona Site Defender (Web Application Firewall)
- Akamai Web Application Protector
Imperva
- Imperva Web Application Firewall (WAF)
- Imperva Database Security (Monitorování databází)
SonicWall
- SonicWall Next-Generation Firewalls
- SonicWall Email Security
- SonicWall Secure Mobile Access
WatchGuard Technologies
- WatchGuard Firebox (Firewally)
- WatchGuard XTM (Unified Threat Management)
- WatchGuard Dimension (Viditelnost bezpečnosti sítě)
Apple
- macOS (Operační systém)
Apache
- Apache Cassandra (Databáze)
- Apache HTTP Server
- Apache Kafka
- Apache Tomcat
- Apache Zookeeper
NGINX
- NGINX (Web server a reverzní proxy server)
Docker
- Docker (Platforma pro kontejnery)
Kubernetes
- Kubernetes (Orchestrace kontejnerů)
Atlassian
- Jira (Správa issues a projektů)
- Confluence (Kolaborační software)
- Bitbucket (Kolaborace na kódu a verzování)
Cloudflare
- Cloudflare (Content Delivery Network a Bezpečnost)
SAP
- SAP HANA (Databáze)
Balabit
- syslog-ng
Open-source
- PostgreSQL (Databáze)
- MySQL (Databáze)
- OpenSSH (Vzdálený přístup)
- Dropbear SSH (Vzdálený přístup)
- Jenkins (Continuous Integration and Continuous Delivery)
- rsyslog
- GenieACS
- Haproxy
- SpamAssassin
- FreeRADIUS
- BIND
- DHCP
- Postfix
- Squid Cache
- Zabbix
- FileZilla
IBM
- IBM Db2 (Databáze)
- IBM AIX (Operační systém)
- IBM i (Operační systém)
Brocade
- Brocade Switches
Google
- Google Cloud
- Pub/Sub & BigQuery
Elastic
- Logstash
- Filebeat
- Winlogbeat
- Auditbeat
- Metricbeat
- Packetbeat
- Heartbeat
- ... a beats z komunitního seznamu
- ElasticSearch
Citrix
- Citrix Virtual Apps and Desktops (Virtualizace)
- Citrix Hypervisor (Virtualizace)
- Citrix ADC, NetScaler
- Citrix Gateway (Vzdálený přístup)
- Citrix SD-WAN
- Citrix Endpoint Management (MDM, MAM)
Dell
- Dell EMC Isilon (síťové úložiště)
- Dell PowerConnect Switches
- Dell W-Series (Přístupové body)
- Dell iDRAC
- Dell Force10 Switches
FlowMon
- Flowmon Collector
- Flowmon Probe
- Flowmon ADS
- Flowmon FPI
- Flowmon APM
GreyCortex
- GreyCortex Mendel
Huawei
- Huawei Routers
- Huawei Switches
- Huawei Unified Security Gateway (USG)
Synology
- Synology NAS
- Synology SAN
- Synology NVR
- Synology Wi-Fi routers
Ubiquity
- UniFi
Avast
- Avast Antivirus
Kaspersky
- Kaspersky Endpoint Security
- Kaspersky Security Center
Kerio
- Kerio Connect
- Kerio Control
- Kerio Clear Web
Symantec
- Symantec Endpoint Protection Manager
- Symantec Messaging Gateway
ESET
- ESET Antivirus
- ESET Remote Administrator
AVG
- AVG Antivirus
Extreme Networks
- ExtremeXOS
IceWarp
- IceWarp Mail Server
Mikrotik
- Mikrotik Routers
- Mikrotik Switches
Pulse Secure
- Pulse Connect Secure SSL VPN
QNAP
- QNAP NAS
Safetica
- Safetica DLP
Veeam
- Veeam Backup and Restore
SuperMicro
- IPMI
Mongo
- MongoDB
YSoft
- SafeQ
Bitdefender
- Bitdefender GravityZone
- Bitdefender Network Traffic Security Analytics (NTSA)
- Bitdefender Advanced Threat Intelligence
Stapro
- Stapro FONS Akord
Tento seznam není vyčerpávající, protože existuje mnoho dalších prodejců a produktů, které mohou posílat logy do TeskaLabs LogMan.io pomocí standardních protokolů, jako je Syslog. Kontaktujte nás, pokud hledáte specifickou technologii k integraci.
Extrakce logů z SQL
TeskaLabs LogMan.io může extrahovat logy z různých SQL databází pomocí ODBC (Open Database Connectivity).
Mezi podporované databáze patří:
- PostgreSQL
- Oracle Database
- IBM Db2
- MySQL
- SQLite
- MariaDB
- SAP HANA
- Sybase ASE
- Informix
- Teradata
- Amazon RDS (Relational Database Service)
- Google Cloud SQL
- Azure SQL Database
- Snowflake
Ochranné známky
Všechny ochranné známky nebo obchodní názvy zmíněné nebo použité jsou majetkem jejich příslušných vlastníků.
Architektura TeskaLabs LogMan.io

lmio-collector
LogMan.io Collector slouží k přijímání logových řádků z různých zdrojů, jako jsou SysLog NG, soubory, Windows Event Forwarding, databáze přes ODBC konektory a podobně. Logové řádky mohou být dále zpracovávány deklarativním procesorem a poslány do LogMan.io Ingestoru přes WebSocket.
lmio-ingestor
LogMan.io Ingestor přijímá události přes WebSocket, transformuje je do formátu čitelného pro Kafka a
pokládá je do Kafka collected- topicu. Existuje několik ingestorů pro různé
formáty událostí, jako jsou SysLog, databáze, XML a další.
lmio-parser
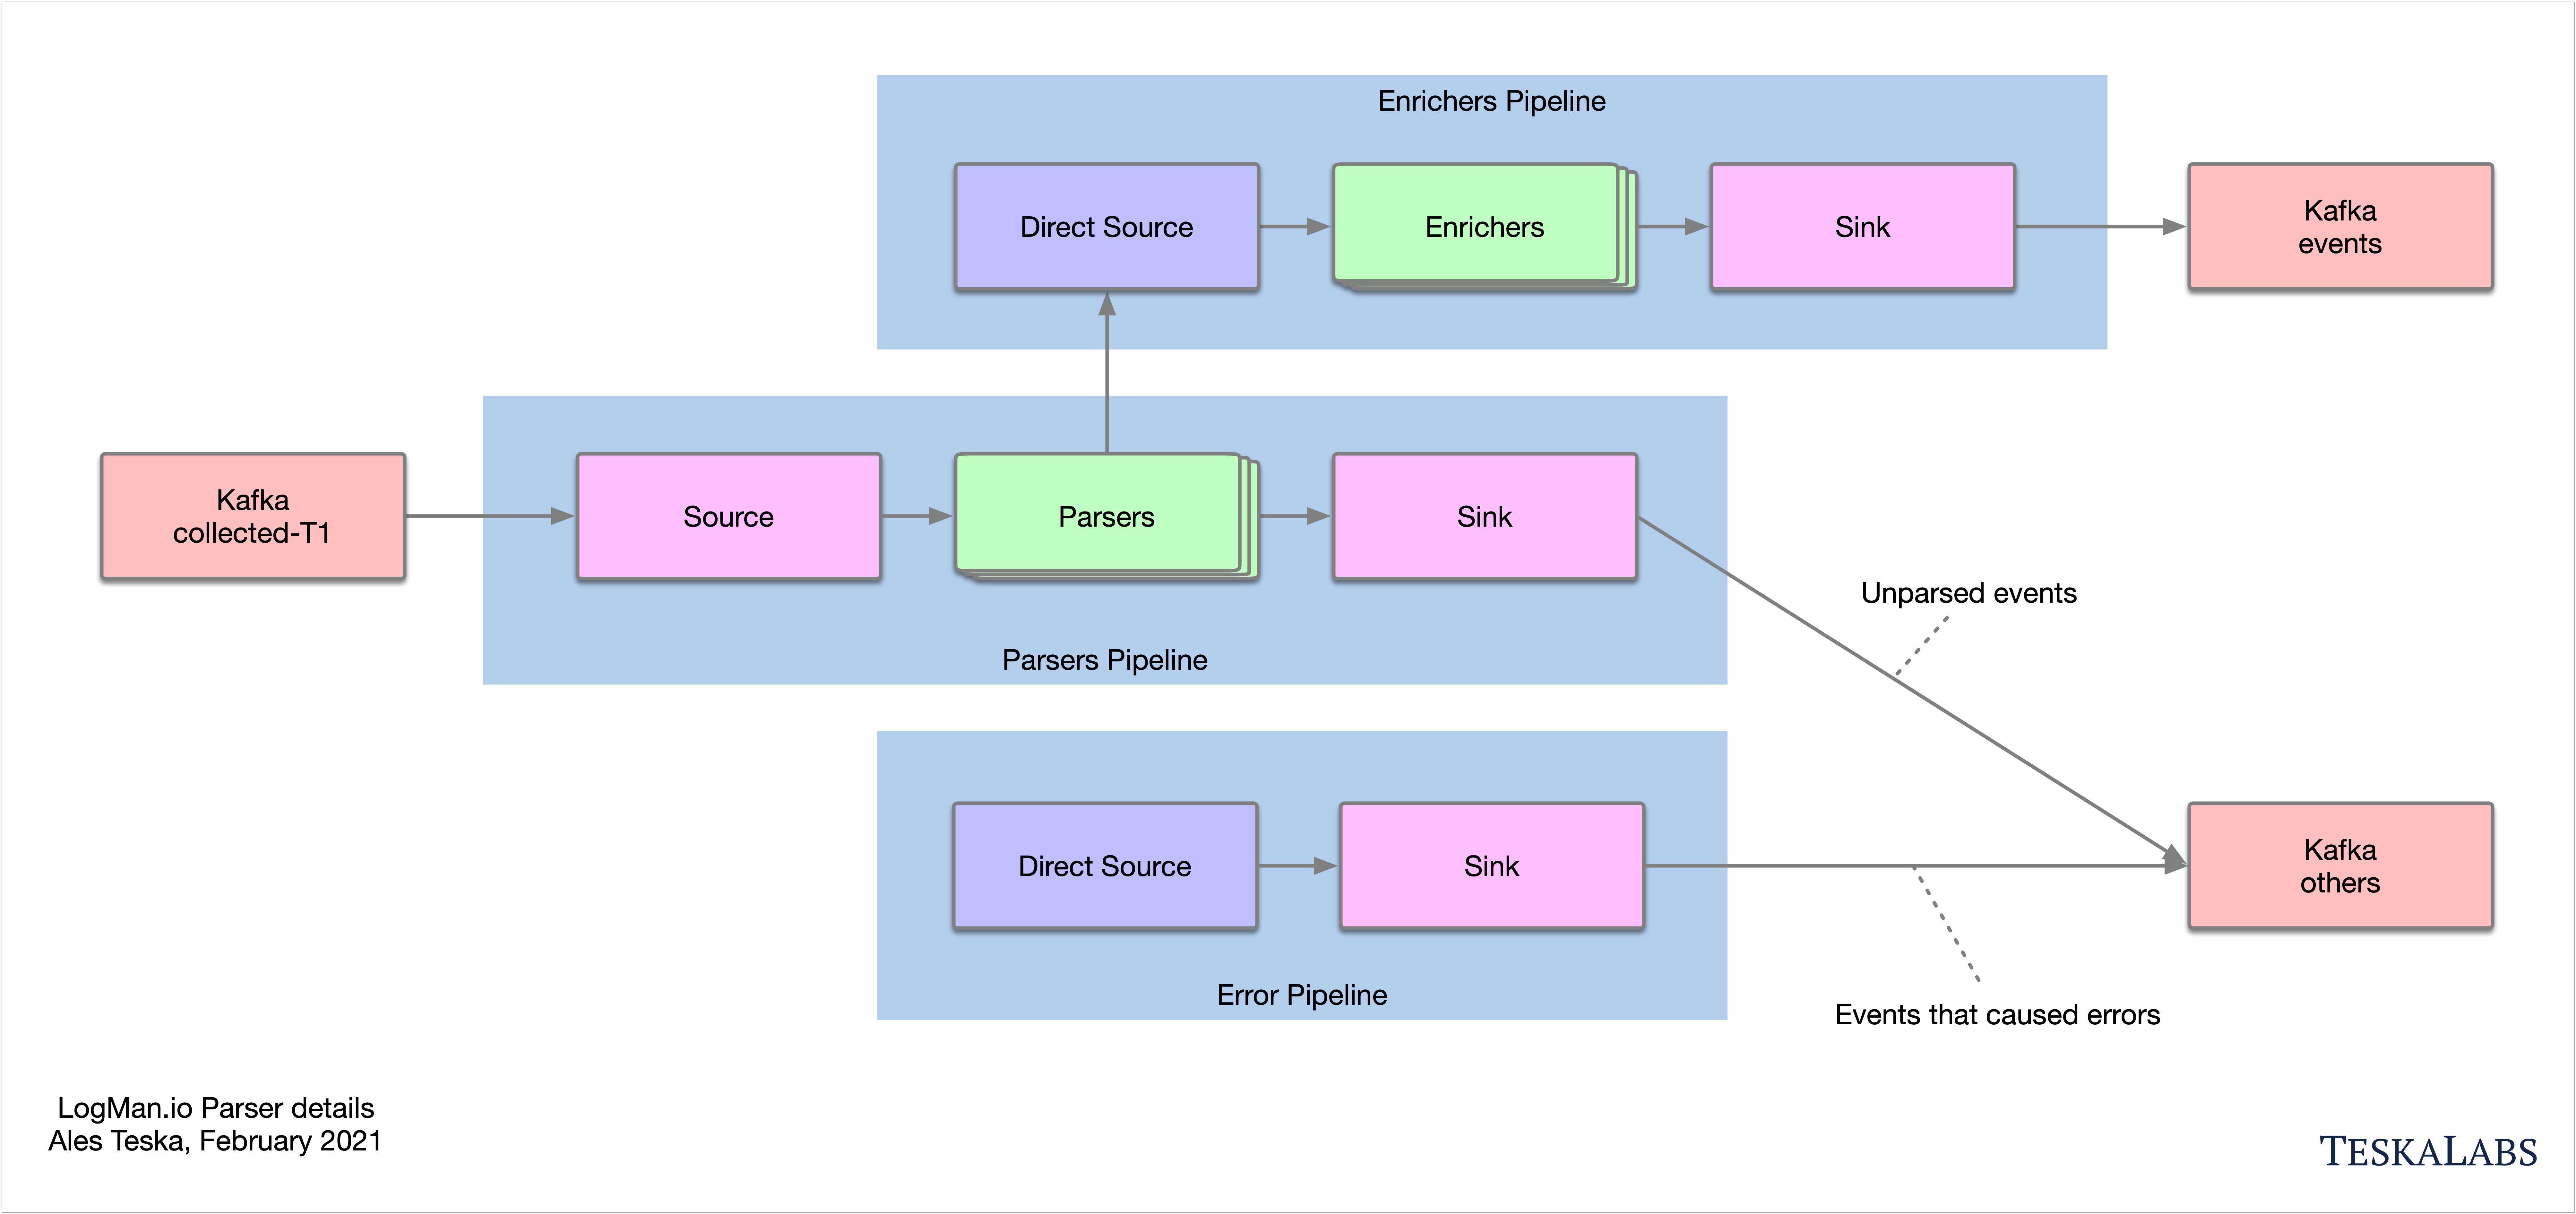
LogMan.io Parser běží v několika instancích, aby přijímal různé formáty příchozích událostí (různé Kafka topicy) a/nebo stejné události (instance pak běží ve stejné Kafka skupině, aby rozdělovaly události mezi sebou). LogMan.io Parser načítá LogMan.io Library přes ZooKeeper nebo ze souborů k načítání deklarativních parserů a obohacovačů z nakonfigurovaných parserových skupin.
Pokud byly události parsovány načteným parserem, jsou položeny do Kafka topicu lmio-events, jinak
vstupují do Kafka topicu lmio-others.
lmio-dispatcher
LogMan.io Dispatcher načítá události z Kafka topicu lmio-events a posílá je jak do všech
přihlášených (přes ZooKeeper) LogMan.io Correlator instancí, tak do ElasticSearch v
příslušném indexu, kde mohou být všechny události dotazovány a vizualizovány pomocí Kibana.
LogMan.io Dispatcher běží také v několika instancích.
lmio-correlator

LogMan.io Correlator používá ZooKeeper k přihlášení ke všem LogMan.io Dispatcher instancím, aby přijímal parsované události (logové řádky apod.). Poté LogMan.io Correlator načítá LogMan.io Library přes ZooKeeper nebo ze souborů k vytváření korelátorů na základě deklarativní konfigurace. Události produkované korelátory (Window Correlator, Match Correlator) jsou následně předávány LogMan.io Dispatcherovi a LogMan.io Watcherovi přes Kafka.
lmio-watcher
LogMan.io Watcher sleduje změny v lookupech používaných v instancích LogMan.io Parserů a LogMan.io Correlatorů.
Když dojde ke změně, všechny běžící komponenty, které používají LogMan.io Library, jsou informovány
přes Kafka topic lmio-lookups o změně a lookup je aktualizován v ElasticSearch,
který slouží jako trvalé úložiště pro všechny lookupy.
lmio-integ
LogMan.io Integ umožňuje integraci LogMan.io s podporovanými externími systémy přes očekávaný formát zpráv a výstupní/vstupní protokol.
Podpora
Online pomoc
Náš tým je dostupný na našem online kanálu podpory na Slack. Můžete posílat zprávy našim interním expertům přímo, konzultovat své plány, problémy a výzvy a dokonce získat online pomoc přes sdílení obrazovky, takže se nemusíte obávat hlavních aktualizací a podobně. Přístup je poskytován zákazníkům s aktivním podpůrným plánem.
E-mailová podpora
Kontaktujte nás na: support@teskalabs.com
Pracovní doba podpory
Úroveň podpory 5/8 je dostupná ve všední dny podle českého kalendáře, 09-18 hodin středoevropského času (Evropa/Praha).
Úroveň podpory 24/7 je také k dispozici, záleží na vašem aktivním podpůrném plánu.
Uživatelský manuál
Vítejte
Co najdete v uživatelské příručce?
Zde se můžete dozvědět, jak používat aplikaci TeskaLabs LogMan.io. Pro informace o instalaci, konfiguraci a údržbě navštivte Administrátorskou příručku nebo Referenční příručku. Pokud nemůžete najít potřebnou pomoc, kontaktujte Podporu.
Rychlý start
Přejít na:
- Získat přehled o všech událostech ve vašem systému (Domů)
- Číst příchozí logy a filtrovat logy podle pole a času (Průzkumník)
- Zobrazit a filtrovat data ve formě grafů a diagramů (Dashboardy)
- Zobrazit a tisknout reporty (Reporty)
- Spustit, stáhnout a spravovat exporty (Export)
- Změnit obecná nebo uživatelská nastavení
Některé funkce jsou viditelné pouze pro administrátory, takže nemusíte vidět všechny funkce, které jsou zahrnuty v Uživatelské příručce ve vaší vlastní verzi TeskaLabs LogMan.io.
Rychlý start pro administrátory
Jste administrátor? Přejít na:
- Přidávat nebo upravovat soubory ve knihovně, jako například dashboardy, reporty a exporty (Knihovna)
- Přidávat nebo upravovat lookupy (Lookupy)
- Přistupovat k externím komponentům, které pracují s TeskaLabs LogMan.io (Nástroje)
- Změnit konfiguraci vašeho rozhraní (Konfigurace)
- Zobrazit mikroslužby (Služby)
- Spravovat uživatelská oprávnění (Auth)
Nastavení
Použijte tyto ovládací prvky v pravém horním rohu obrazovky pro změnu nastavení:


Tenanti
Tenant je jedním subjektem shromažďujícím data ze skupiny zdrojů. Když používáte program, můžete vidět pouze data patřící vybranému tenantovi. Data daného tenanta jsou zcela oddělena od dat ostatních tenantů v TeskaLabs LogMan.io (další informace o multitenanci). Vaše společnost může mít pouze jednoho tenanta, nebo také více tenantů (například pro různé oddělení). Pokud distribuujete nebo spravujete TeskaLabs LogMan.io pro jiné klienty, máte více tenantů, minimálně jednoho pro každého klienta.
Tenanti mohou být přístupní více uživateli a uživatelé mohou mít přístup k více tenantům. Více o tenantech se dozvíte zde.
Tipy
Pokud jste noví ve sběru logů, klikněte na tipové boxy, abyste se dozvěděli, proč byste mohli chtít použít určitou funkci.
Proč používat TeskaLabs LogMan.io?
TeskaLabs LogMan.io sbírá logy, což jsou záznamy o každé jednotlivé události v síťovém systému. Tyto informace vám mohou pomoci:
- Pochopit, co se děje ve vaší síti
- Řešit problémy sítě
- Vyšetřovat bezpečnostní incidenty
Správa vašeho účtu
Název vašeho účtu se nachází v pravém horním rohu obrazovky:


Změna hesla
- Klikněte na název vašeho účtu.
- Klikněte na Změnit heslo.
- Zadejte své aktuální heslo a nové heslo.
- Klikněte na Nastavit heslo.
Měli byste vidět potvrzení o změně hesla. Chcete-li se vrátit na stránku, na které jste byli před změnou hesla, klikněte na Vrátit se zpět.
Změna informací o účtu
- Klikněte na název vašeho účtu.
- Klikněte na Spravovat.
- Zde můžete:
- Změnit své heslo
- Změnit svou emailovou adresu
- Změnit nebo přidat své telefonní číslo
- Odhlásit se
- Klikněte na to, co chcete udělat, a proveďte změny. Změny nebudou okamžitě viditelné - budou viditelné po odhlášení a opětovném přihlášení.
Zobrazení oprávnění přístupu
- Klikněte na název vašeho účtu.
- Klikněte na Kontrola přístupu, kde uvidíte, jaká oprávnění máte.
Odhlášení
- Klikněte na název vašeho účtu.
- Klikněte na Odhlásit se.
Můžete se také odhlásit z obrazovky Spravovat.
Odhlášení ze všech zařízení
- Klikněte na název vašeho účtu.
- Klikněte na Spravovat.
- Klikněte na Odhlásit se ze všech zařízení.
Po odhlášení budete automaticky přesměrováni na přihlašovací obrazovku.
Používání domovské stránky
Domovská stránka vám poskytuje přehled vašich datových zdrojů a kritických příchozích událostí. Po přihlášení budete automaticky na domovské stránce, ale na domovskou stránku se můžete také dostat z tlačítek vlevo.
Možnosti zobrazení
Zobrazení grafu a seznamu
Pro přepínání mezi zobrazením grafu a seznamu klikněte na tlačítko seznamu.


Získání dalších podrobností
Kliknutím na jakoukoli část grafu přejdete do Průzkumníku, kde se zobrazí seznam logů, které tvoří tuto část grafu. Odtud můžete zkoumat a filtrovat tyto logy.


Zde můžete vidět, že Průzkumník automaticky filtruje události z vybraného datasetu (z grafu na domovské stránce), event.dataset:devolutions.
Použití Průzkumníka
Průzkumník vám poskytuje přehled o všech logech, které jsou sbírány v reálném čase. Zde můžete filtrovat data podle času a pole.
Navigace Průzkumníkem


Termíny
Celkový počet: Celkový počet logů v zobrazeném časovém rozmezí.
Agregováno podle: V sloupcovém grafu každý sloupec reprezentuje počet logů sebraných během časového intervalu. Použijte Agregováno podle pro volbu časového intervalu. Například Agregováno podle: 30m znamená, že každý sloupec v grafu zobrazuje počet všech logů sebraných během 30 minutového časového intervalu. Pokud změníte na Agregováno podle: hodina, pak každý sloupec reprezentuje jednu hodinu logů. Dostupné možnosti se mění v závislosti na celkovém časovém rámci, který zobrazuje Průzkumník.
Filtrování dat
Změňte časový rámec, ze kterého se logy zobrazují, a filtrovejte logy podle pole.
Tip: Proč filtrovat data?
Logy obsahují mnoho informací, více než potřebujete k dokončení většiny úkolů. Když filtrujete data, vybíráte, které informace chcete vidět. To vám může pomoci lépe pochopit vaši síť, identifikovat trendy a dokonce lovit hrozby.
Příklady:
- Chcete vidět údaje o přihlášení od jednoho uživatele, takže filtrujete data, aby se zobrazovaly logy obsahující jeho uživatelské jméno.
- Večer ve středu došlo k bezpečnostnímu incidentu a chcete se dozvědět více, takže filtrujete data, aby se zobrazovaly logy z tohoto časového období.
- Všimnete si, že nevidíte žádná data od jednoho z vašich síťových zařízení. Můžete filtrovat data, aby se zobrazovaly všechny logy pouze z tohoto zařízení. Nyní můžete zjistit, kdy data přestala přicházet a jaká událost mohla způsobit problém.
Změna časového rámce
Můžete zobrazit logy z určeného časového rámce. Nastavte časový rámec výběrem počátečního a koncového bodu pomocí tohoto nástroje:


Pamatujte: Po změně časového rámce stiskněte modré tlačítko pro obnovení, aby se stránka aktualizovala.
Použití nástroje pro nastavení času
Nastavení relativního počátečního/koncového bodu
Pro nastavení počátečního nebo koncového bodu v relativním čase od teď použijte záložku Relativní.
Rychlé nastavení času
Použijte rychlé možnosti now- ("teď mínus") pro nastavení časového rámce na přednastavenou hodnotu jedním kliknutím. Výběr jedné z těchto možností ovlivňuje oba počáteční a koncový bod. Například, pokud zvolíte now-1 týden, počáteční bod bude před týdnem a koncový bod bude "teď." Výběr možnosti now- z koncového bodu udělá to samé jako výběr možnosti now- z počátečního bodu. (Nemůžete použít možnosti now- k nastavení koncového bodu na cokoliv jiného než "teď.")
Možnosti rozbalovacího seznamu
Pro nastavení relativního času (například před 15 minutami) pro počáteční nebo koncový bod použijte možnosti relativního času pod rychlým nastavením. Vyberte jednotku času z rozbalovacího seznamu a napište nebo klikněte na požadované číslo.
Pro potvrzení výběru klikněte na Nastavit relativní čas a zobrazte logy kliknutím na tlačítko pro obnovení.
Příklad ukázaný: Tento výběr zobrazí logy sebrané od jednoho dne zpátky až do nynějška.


Nastavení přesného počátečního/koncového bodu
Pro výběr přesného dne a času pro počáteční nebo koncový bod použijte záložku Absolutní a vyberte datum a čas v kalendáři.
Pro potvrzení výběru klikněte na Nastavit datum.
Příklad ukázaný: Tento výběr zobrazí logy sebrané od 7. června 2023 v 6:00 až do nynějška.


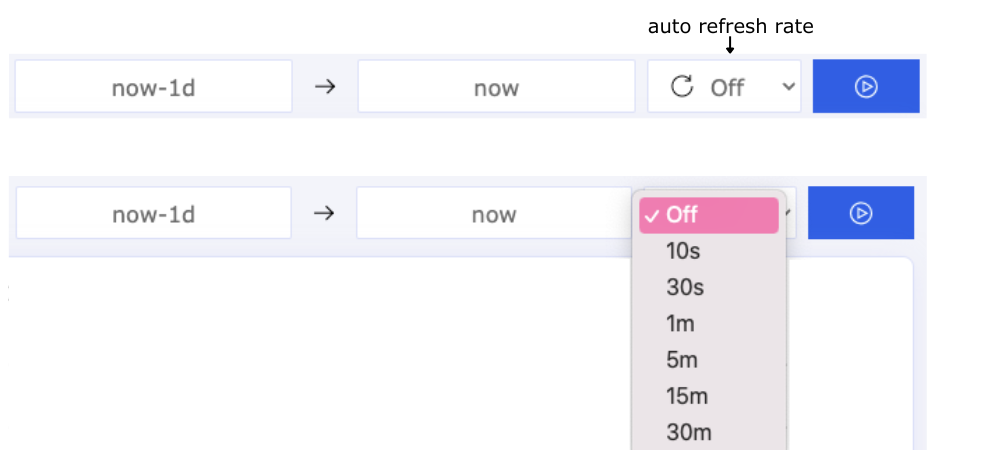
Automatické obnovení
Pro automatické aktualizace zobrazení v nastaveném časovém intervalu zvolte obnovovací frekvenci:
Obnovení
Pro znovunačtení zobrazení s vašimi změnami klikněte na modré tlačítko pro obnovení.


Poznámka: Nevybírejte "Teď" jako počáteční bod. Protože program nemůže zobrazit data novější než "teď," není to platné a zobrazí se chybová zpráva.
Použití voliče času
Pro výběr konkrétnějšího časového období v rámci aktuálního časového rámce klikněte a přetáhněte na grafu.


Filtrování podle pole
V Průzkumníku můžete filtrovat data podle jakéhokoliv pole několika způsoby.
Použití seznamu polí
Použijte vyhledávací lištu pro nalezení požadovaného pole nebo procházejte seznam.


Izolace pole
Pro výběr, která pole chcete vidět v seznamu logů, klikněte na symbol + vedle názvu pole. Můžete vybrat více polí.
Příklad:


Zobrazení všech hodnot v jednom poli
Pro zobrazení procentuálního rozložení všech hodnot z jednoho pole klikněte na lupu vedle názvu pole (lupa se zobrazí při přejetí myší přes název pole).
Příklad:


Tip: Co to znamená?
Tento seznam hodnot z pole http.response.status_code porovnává, jak často uživatelé dostávají určité http odpovědní kódy. 51.4 % času uživatelé dostávají kód 404, což znamená, že stránka nebyla nalezena. 43.3 % času uživatelé dostávají kód 200, což znamená, že požadavek byl úspěšný. Vysoké procento "nenalezených" odpovědních kódů může informovat administrátora webu, že jeden nebo více často klikaných odkazů je rozbitý.
Zobrazení a filtrování detailů logů
Pro zobrazení detailů jednotlivých logů jako tabulku nebo v JSON, klikněte na šipku vedle časové značky. Filtry můžete aplikovat pomocí názvů polí v zobrazení tabulky.


Filtrování z rozšířeného tabulkového zobrazení
Můžete použít ovládací prvky v tabulkovém zobrazení pro filtrování logů:


Filtr pro logy obsahující stejnou hodnotu ve vybraném poli (update_item v action v příkladu)
Filtr pro logy, které NEobsahují stejnou hodnotu ve vybraném poli (update_item v action v příkladu)
Zobrazit procentuální rozložení hodnot v tomto poli (stejná funkce jako lupa v seznamu polí vlevo)
Přidat do seznamu zobrazených polí pro všechny viditelné logy (stejná funkce jako v seznamu polí vlevo)
Dotazovací lišta
Můžete filtrovat pole (ne čas) pomocí dotazovací lišty. Dotazovací lišta vám řekne, jaký dotazovací jazyk použít. Dotazovací jazyk závisí na vašem zdroji dat. Použijte Lucene Query Syntax pro data uložená pomocí ElasticSearch.
Po napsání dotazu nastavte časový rámec a klikněte na tlačítko pro obnovení. Vaše filtry budou aplikovány na viditelné příchozí logy.
Vyšetřování IP adres
Můžete vyšetřit IP adresy pomocí externích analyzačních nástrojů. Například můžete chtít toto udělat, pokud vidíte více podezřelých přihlášení z jedné IP adresy.
Použití externích nástrojů pro analýzu IP
1. Klikněte na IP adresu, kterou chcete analyzovat.
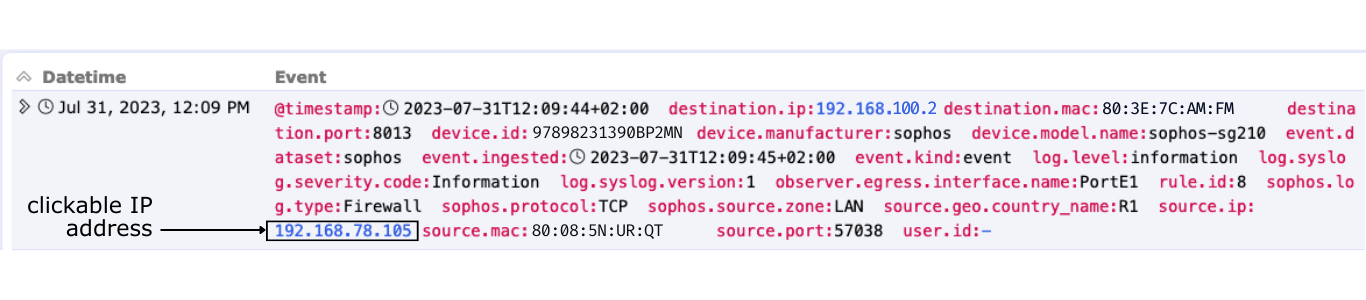
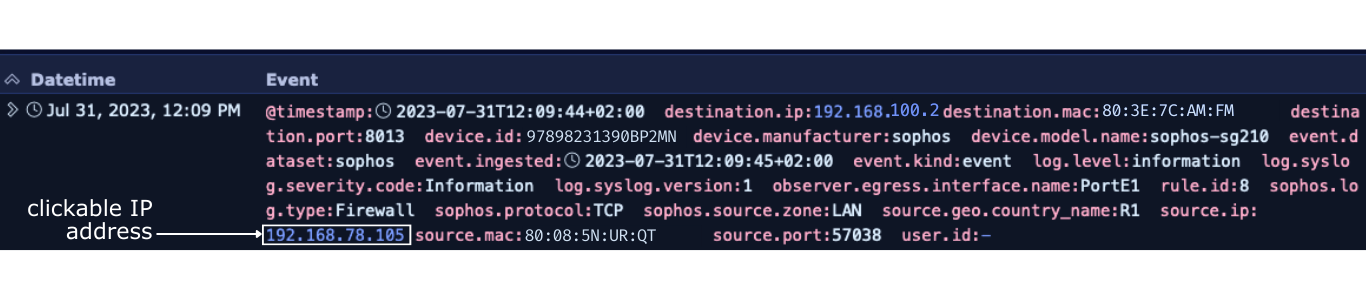
2. Klikněte na nástroj, který chcete použít. Budete přesměrováni na webovou stránku nástroje, kde můžete vidět výsledky analýzy IP adresy.


Použití Dashboardů
Dashboard je sada grafů a diagramů, které reprezentují data z vašeho systému. Dashboardy vám umožňují rychle získat přehled o tom, co se děje ve vaší síti.
Váš administrátor nastavuje dashboardy na základě zdrojů dat a polí, která jsou pro vás nejvíce užitečná. Například můžete mít dashboard, který zobrazuje grafy týkající se pouze e-mailové aktivity nebo pouze pokusů o přihlášení. Můžete mít mnoho dashboardů pro různé účely.
Můžete filtrovat data tak, aby se změnila data, která dashboard zobrazuje v rámci svých přednastavených omezení.
Jak mi mohou dashboardy pomoci?
Usnadněním určitých dat do grafu, tabulky nebo diagramu můžete získat vizuální přehled o aktivitách ve vašem systému a identifikovat trendy.
V tomto příkladu můžete vidět, že 19. června bylo odesláno a přijato velké množství e-mailů.


Navigace v Dashboardech
Otevření dashboardu
Chcete-li otevřít dashboard, klikněte na jeho název.


Ovládací prvky dashboardu


Nastavení časového rámce
Můžete změnit časový rámec, který dashboard reprezentuje. Najděte průvodce nastavením času zde. Aby se dashboard aktualizoval s novým časovým rámcem, klikněte na tlačítko obnovit.
Poznámka: Dashboardy nemají automatickou obnovovací frekvenci.
Filtrování dat dashboardu
Pro filtrovaní dat, která dashboard zobrazuje, použijte query bar. Query language, který musíte použít, závisí na vašem zdroji dat. Query bar vám sdělí, který query language použít. Použijte Lucene Query Syntax pro data uložená pomocí ElasticSearch.
Přesouvání widgetů
Můžete přemisťovat a měnit velikost jednotlivých widgetů. Pro přesunutí widgetů klikněte na tlačítko menu dashboardu a vyberte Edit.
Pro přesunutí widgetu klikněte kdekoliv na widget a tahem přesuňte. Pro změnu velikosti widgetu klikněte na pravý dolní roh widgetu a tahem změňte velikost.
Pro uložení změn klikněte na zelené tlačítko pro uložení. Pro zrušení změn klikněte na červené tlačítko pro zrušení.


Tisk dashboardů
Pro tisk dashboardu klikněte na tlačítko menu dashboardu a vyberte Print. Váš prohlížeč otevře nové okno, kde si můžete zvolit nastavení tisku.
Zprávy
Zprávy jsou vizuální reprezentace vašich dat vhodné pro tisk, podobně jako tisknutelné nástěnky. Váš administrátor vybírá, jaké informace se do vašich zpráv dostanou, na základě vašich potřeb.
Najděte a vytiskněte zprávu
- Vyberte zprávu ze svého seznamu nebo použijte vyhledávací lištu, abyste zprávu našli.
- Klikněte na Tisk. Váš prohlížeč otevře okno pro tisk, kde můžete upravit nastavení tisku.
Použití Exportu
Převádějte sady logů na stahovatelné a odesílatelné soubory pomocí Exportu. Tyto soubory můžete mít na svém počítači, prohlížet v jiném programu nebo je posílat emailem.
Co je export?
Export není soubor, ale proces, který vytváří soubor. Export obsahuje a následuje vaše instrukce pro to, jaká data do souboru zahrnout, jaký typ souboru vytvořit a co s ním udělat. Když export spustíte, vytvoříte soubor.
Proč bych měl exportovat logy?
Možnost vidět skupinu logů v jednom souboru vám může pomoci data důkladněji prozkoumat. Několik důvodů, proč byste chtěli exportovat logy:
- Pro vyšetření události nebo útoku
- Pro zaslání dat analytikovi
- Pro prozkoumání dat v programu mimo TeskaLabs LogMan.io
Navigace Exportu
Seznam exportů


Seznam exportů vám ukazuje všechny již provedené exporty.
Na stránce seznamu můžete:
- Zobrazit detaily exportu kliknutím na název exportu
- Stáhnout export kliknutím na ikonu cloudu vedle jeho názvu
- Smazat export kliknutím na ikonu koše vedle jeho názvu
- Hledat exporty pomocí vyhledávacího pole
Status exportu je barevně odlišen:
- Zelená: Dokončeno
- Žlutá: Probíhá
- Modrá: Naplánováno
- Červená: Selhalo
Přeskočit na:
Spustit export
Spuštění exportu přidá export na váš Seznam exportů, ale automaticky ho nestáhne. Viz Stáhnout export pro instrukce.
Spustit export na základě přednastavení
1. Klikněte na Nový na stránce Seznam exportů. Nyní můžete vidět přednastavené exporty:


2. Pro spuštění přednastaveného exportu, klikněte na tlačítko spuštění vedle názvu exportu.
NEBO
2. Pro editaci exportu před spuštěním, klikněte na tlačítko editace vedle názvu exportu. Proveďte změny a poté klikněte na Start. (Použijte tento průvodce pro naučení se provádět změny.)
Jakmile spustíte export, budete automaticky přesměrováni zpět na seznam exportů a váš export se objeví na vrcholu seznamu.
Poznámka
Přednastavené exporty jsou vytvořeny administrátory.
Spustit export na základě exportu, který jste již dříve spustili
Můžete znovu spustit export. Znovu spuštění exportu nepřepíše původní export.
1. Na stránce Seznam exportů klikněte na název exportu, který chcete znovu spustit.
2. Klikněte na Restart.
3. Zde můžete provést změny (viz tento průvodce) nebo spustit export tak, jak je.
4. Klikněte na Start.
Jakmile spustíte export, budete automaticky přesměrováni zpět na seznam exportů a váš nový export se objeví na vrcholu seznamu.
Vytvořit nový export
Vytvořit export z prázdného formuláře
1. V Seznamu exportů klikněte na Nový, poté klikněte na Vlastní.
2. Vyplňte pole.


Poznámka
Možnosti v rozbalovacích menu se mohou změnit na základě vašich výběrů.
Název
Pojmenujte export.
Zdroj dat
Vyberte zdroj dat z rozbalovacího seznamu.
Výstup
Zvolte typ souboru pro vaše data. Může to být:
- Raw: Pokud chcete stáhnout export a importovat logy do jiného software, zvolte raw. Pokud je zdroj dat Elasticsearch, formát raw souborů je .json.
- .csv: Hodnoty oddělené čárkou
- .xlsx: Formát Microsoft Excel
Kompresní formát
Zvolte, zda chcete soubor s exportem zkomprimovat (zip), nebo nechat nekomprimovaný. Zkomprimovaný soubor je menší a snadněji se posílá, a také zabírá méně místa na disku.
Cíl
Zvolte cíl pro váš soubor. Může to být:
- Stáhnout: Soubor, který můžete stáhnout do svého počítače.
- Email: Vyplňte emailová pole. Když export spustíte, email bude odeslán. Soubor s daty můžete kdykoli stáhnout na stránce Seznam exportů.
- Jupyter: Uloží soubor do Jupyter notebooku, přístupného přes stránku Nástroje. K přístupu do Jupyter notebooku potřebujete administrátorská oprávnění, takže zvolte Jupyter jako cíl pouze pokud jste administrátor.
Oddělovač
Pokud zvolíte .csv jako váš výstup, vyberte znak, který bude označovat oddělení mezi jednotlivými hodnotami v každém logu. I když CSV znamená hodnoty oddělené čárkou, můžete zvolit jiný oddělovač, jako je středník nebo mezera.
Plánování (volitelně)
Pro naplánování exportu místo jeho okamžitého spuštění, klikněte na Přidat plán.
-
Naplánovat jednorázově:
- Pro jednorázové spuštění exportu v budoucnu zadejte požadovaný datum a čas ve formátu
YYYY-MM-DD HH:mm, například2023-12-31 23:59(31. prosince 2023, 23:59).
- Pro jednorázové spuštění exportu v budoucnu zadejte požadovaný datum a čas ve formátu
-
Naplánovat opakovaný export:
-
Pro nastavení exportu ke spuštění automaticky v pravidelném intervalu použijte
cronsyntaxi. Více ocronse můžete dozvědět na Wikipedii a použít tento nástroj a tato příklady od Cronitoru pro pomoc při psanícronvýrazů. -
Pole Plán podporuje také náhodné použití
Ra Vixie cron-style@klíčové výrazy.
-
Dotaz
Zadejte dotaz pro filtrování určitých dat. Dotaz určuje, která data se budou exportovat, včetně časového rámce logů.
Varování
Musíte zahrnout dotaz do každého exportu. Pokud spustíte export bez dotazu, všechna data uložená ve vašem programu budou exportována bez filtru pro čas nebo obsah. To může vytvořit extrémně velký soubor a způsobit zátěž na komponenty pro ukládání dat, a soubor pravděpodobně nebude užitečný pro vás ani pro analytiky.
Pokud náhodou spustíte export bez dotazu, můžete export smazat, zatímco stále běží, na stránce Seznam exportů kliknutím na ikonu koše.
TeskaLabs LogMan.io používá Elasticsearch Query DSL (Domain Specific Language).
Zde je kompletní průvodce Elasticsearch Query DSL.
Příklad dotazu:
{
  "bool": {
    "filter": [
      {
        "range": {
          "@timestamp": {
            "gte": "now-1d/d",
            "lt": "now/d"
          }
        }
      },
      {
        "prefix": {
         "event.dataset": {
            "value": "microsoft-office-365"
          }
       }
      }
   ]
  }
}
Rozbor dotazu:
bool: To nám říká, že celý dotaz je Boolean dotaz, který kombinuje několik podmínek, jako jsou "must," "should," a "must not." Zde se používá filter pro nalezení vlastností, které data musí mít, aby byla zahrnuta do exportu. filter může mít více podmínek.
range je první podmínka filtru. Jelikož se vztahuje k poli pod ním, což je @timestamp, bude filtrovat logy na základě rozsahu hodnot v poli timestamp.
@timestamp nám říká, že dotaz filtruje čas, takže exportuje logy z určitého časového rámce.
gte: To znamená "větší nebo rovno," což je nastavena na hodnotu now-1d/d, což znamená, že nejstarší timestamp (první log) bude přesně jeden den starý v době spuštění exportu.
lt znamená "menší než," a je nastaveno na now/d, takže nejnovější timestamp (poslední log) bude ten nejnovější v době spuštění exportu ("now").
prefix je druhá filtrační podmínka. Hledá logy, kde hodnota pole, v tomto případě event.dataset, začíná na microsoft-office-365.
Takže, co tento dotaz znamená?
Tento export zobrazí všechny logy z Microsoft Office 365 za posledních 24 hodin.
3. Přidat sloupce
Pro .csv a .xlsx soubory je třeba specifikovat, jaké sloupce chcete mít ve vašem dokumentu. Každý sloupec reprezentuje datové pole. Pokud nespecifikujete žádné sloupce, výsledná tabulka bude mít všechny možné sloupce, takže tabulka může být mnohem větší, než očekáváte nebo potřebujete.
Můžete vidět seznam všech dostupných datových polí v Průzkumník. Chcete-li zjistit, která pole jsou relevantní pro logy, které exportujete, prozkoumejte jednotlivý log v Průzkumník.


- Pro přidání sloupce klikněte na Přidat. Zadejte název sloupce.
- Pro smazání sloupce klikněte na -.
- Pro změnu pořadí sloupců klikněte a přetáhněte šipky.
Varování
Stisknutí enter po zadání názvu sloupce spustí export.
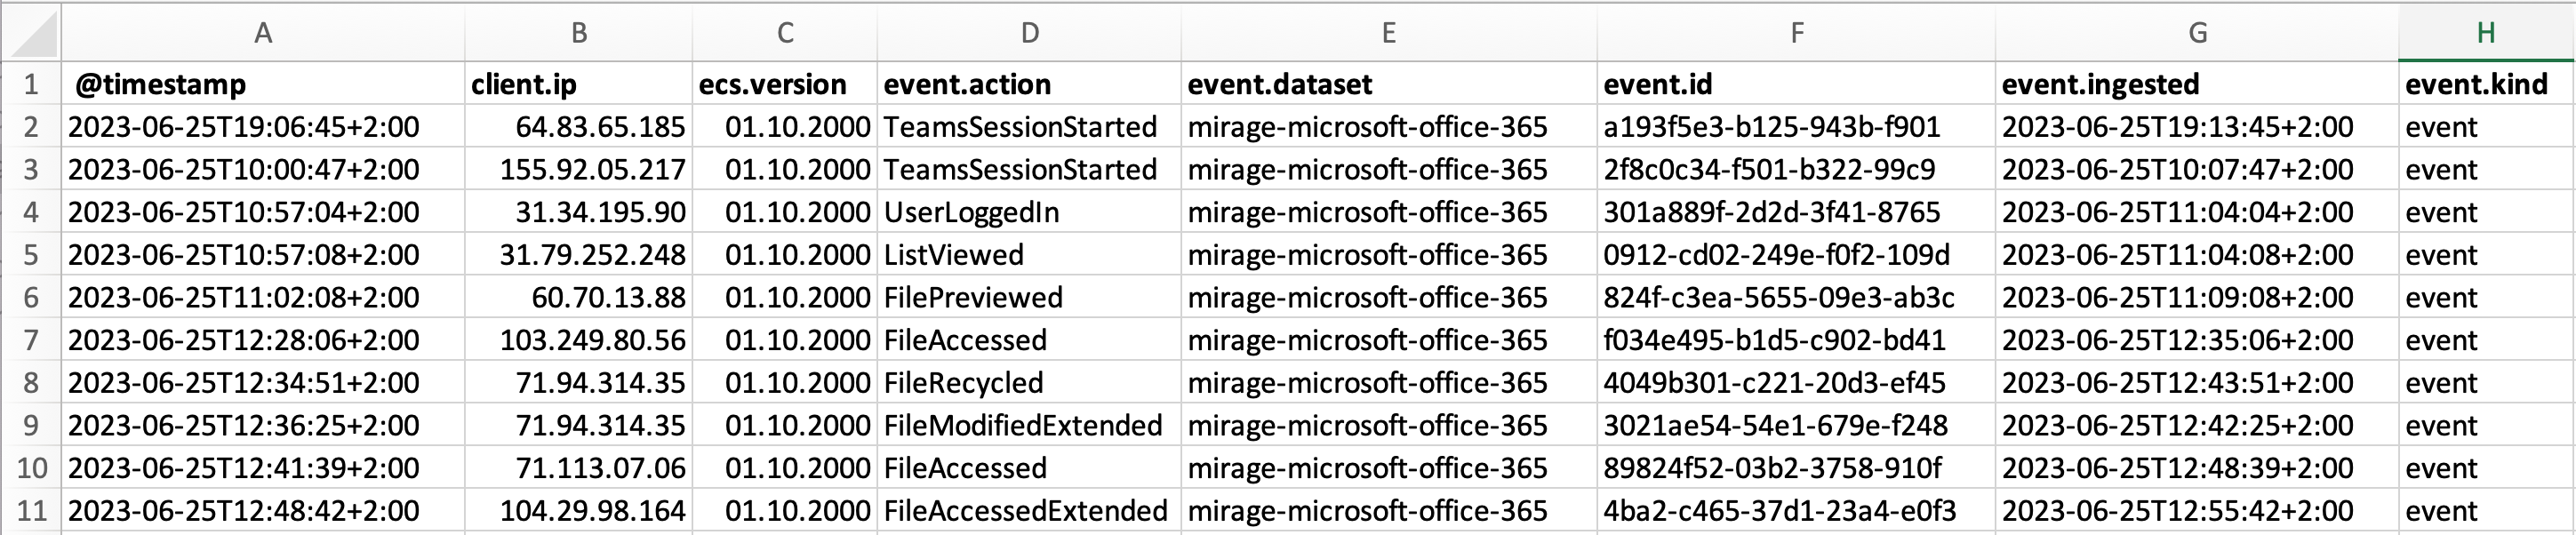
Tento příklad byl stažen z exportu uvedeného výše jako .csv soubor, poté oddělen do sloupců pomocí Microsoft Excel Převést text na sloupce čaroděj. Můžete vidět, že sloupce zde odpovídají sloupcům specifikovaným v exportu.
4. Spustit export stisknutím Start.
Jakmile spustíte export, budete automaticky přesměrováni zpět na seznam exportů a váš export se objeví na vrcholu seznamu.
Stáhnout export
1. Na stránce Seznam exportů klikněte na ikonu cloudu pro stažení.
NEBO
1. Na stránce Seznam exportů klikněte na název exportu.
2. Klikněte na Stáhnout.
Váš prohlížeč by měl automaticky zahájit stahování.
Smazat export
1. Na stránce Seznam exportů klikněte na ikonu koše.
NEBO
1. Na stránce Seznam exportů klikněte na název exportu.
2. Klikněte na Odstranit.
Export by měl zmizet ze seznamu.
Přidat export do knihovny
Poznámka
Tato funkce je dostupná pouze pro administrátory.
Pokud se vám líbí export, který jste vytvořili nebo upravili, můžete jej uložit do knihovny jako přednastavení pro budoucí použití.
1. Na stránce Seznam exportů klikněte na název exportu.
2. Klikněte na Uložit do Knihovny.
Když kliknete na Nový na stránce Seznam exportů, vaše nové přednastavení exportu by mělo být v seznamu.
Přehled vlasností
Domovská stránka
Domovská stránka vám poskytuje přehled o vašich zdrojích dat a kritických příchozích událostech.
Možnosti zobrazení
Graf a seznam
Pro přepnutí mezi grafem a seznamem klikněte na tlačítko seznamu.
Získání dalších podrobností
Kliknutím na kteroukoli část grafu se dostanete do Průzkumníka, kde uvidíte seznam logů, které tvoří tuto část grafu. Odtud můžete tyto logy prozkoumat a filtrovat.
Zde můžete vidět, že Průzkumník automaticky filtruje události z vybrané datové sady (z grafu na domovské stránce), event.dataset:devolutions.
Objevování
Objevování vám poskytuje přehled o všech logách, které se shromažďují v reálném čase. Zde můžete filtrovat data podle času a pole.
Navigace v Objevování
Pojmy
Celkový počet: Celkový počet logů ve zvoleném časovém období.
Agregováno podle: V sloupcovém grafu každý sloupec představuje počet logů shromážděných v časovém intervalu. Pomocí Agregováno podle můžete zvolit časový interval. Například Agregováno podle: 30m znamená, že každý sloupec v grafu zobrazuje počet všech logů shromážděných během 30 minutového období. Pokud změníte na Agregováno podle: hodina, pak každý sloupec představuje jednu hodinu logů. Dostupné možnosti se mění na základě celkového časového intervalu, který prohlížíte v Objevování.
Filtrování dat
Změňte časové období, ze kterého se zobrazují logy, a filtrujte logy podle pole.
Tip: Proč filtrovat data?
Logy obsahují mnoho informací, více než je potřeba k většině úkolů. Při filtrování dat si vybíráte, které informace vidíte. To vám může pomoci lépe pochopit vaši síť, identifikovat trendy a dokonce lovit hrozby.
Příklady:
- Chcete vidět data o přihlášení pouze jednoho uživatele, takže filtrujete data tak, aby zobrazovala logy obsahující jeho uživatelské jméno.
- Měli jste bezpečnostní událost ve středu večer a chcete se o ní dozvědět více, takže filtrujete data pro zobrazení logů z této doby.
- Všimli jste si, že nevidíte žádná data z jednoho vašeho síťového zařízení. Můžete filtrovat data tak, aby zobrazovala všechny logy pouze z tohoto zařízení. Nyní můžete vidět, kdy data přestala přicházet a co byla poslední událost, která mohla způsobit problém.
Změna časového období
Můžete prohlížet logy z určeného časového období. Nastavte časové období výběrem počátečního a koncového bodu pomocí tohoto nástroje:
Pamatujte: Jakmile změníte časové období, stiskněte modré tlačítko obnovy, aby se aktualizovala vaše stránka.
Použití nástroje pro nastavení času
Nastavení relativního počátečního/konečného bodu
Chcete-li nastavit počáteční nebo koncový bod na čas relativní k aktuálnímu času, použijte kartu Relativní.
Rychlá nastavení času
Použijte rychlé možnosti nyní- ("nyní mínus") k nastavení časového období na přednastavené hodnoty jedním kliknutím. Výběr jedné z těchto možností ovlivňuje oba počáteční i koncový bod. Například pokud zvolíte nyní-1 týden, počáteční bod bude před týdnem a koncový bod bude "nyní". Výběr možnosti nyní- z koncového bodu udělá totéž jako výběr možnosti nyní- z počátečního bodu. (Není možné použít možnosti nyní- k nastavení koncového bodu na cokoliv jiného než "nyní.")
Rozbalovací možnosti
Chcete-li nastavit relativní čas (například před 15 minutami) pro počáteční nebo koncový bod, použijte relativní časové možnosti pod rychlými nastaveními. Vyberte jednotku času z rozbalovacího seznamu a zadejte nebo klikněte na požadované číslo.
Chcete-li volbu potvrdit, klikněte na Nastavit relativní čas a zobrazte logy kliknutím na tlačítko obnovy.
Příklad zobrazen: Tato volba zobrazí logy shromážděné od jednoho dne zpět až do současnosti.
Nastavení přesného počátečního/konečného bodu
Chcete-li zvolit přesné datum a čas pro počáteční nebo koncový bod, použijte kartu Absolutní a vyberte datum a čas v kalendáři.
Chcete-li volbu potvrdit, klikněte na Nastavit datum.
Příklad zobrazen: Tato volba zobrazí logy shromážděné od 7. června 2023, 6:00 až do současnosti.
Automatické obnovení
Chcete-li aktualizovat zobrazení automaticky ve stanoveném časovém intervalu, vyberte frekvenci obnovení:
Obnovení
Chcete-li načíst zobrazení s vašimi změnami, klikněte na modré tlačítko obnovy.
Poznámka: Nevybírejte "Nyní" jako počáteční bod. Program nemůže zobrazit data novější než "nyní," takže to není platné a zobrazí se chybová zpráva.
Použití výběru času
Chcete-li vybrat konkrétnější časové období v rámci aktuálního časového období, klikněte a přetáhněte na grafu.
Filtrování podle pole
V Objevování můžete filtrovat data podle jakéhokoli pole několika způsoby.
Použití seznamu polí
Použijte vyhledávací pole k vyhledání požadovaného pole nebo projděte seznam.
Izolování polí
Chcete-li zvolit, která pole se zobrazují v seznamu logů, klikněte na symbol + vedle názvu pole. Můžete vybrat více polí.
Příklad:
Zobrazení všech hodnot v jednom poli
Chcete-li zobrazit procentuální rozložení všech hodnot z jednoho pole, klikněte na lupu vedle názvu pole (lupa se zobrazí po najetí myší na název pole).
Příklad:
Tip: Co to znamená?
Tento seznam hodnot z pole http.response.status_code porovnává, jak často uživatelé dostávají určité http odpovědní kódy. 51,4 % času uživatelé dostávají kód 404, což znamená, že stránka nebyla nalezena. 43,3 % času uživatelé dostávají kód 200, což znamená, že požadavek byl úspěšný. Vysoké procento odpovědí "stránka nenalezena" může informovat administrátora webu, že jeden nebo více jeho často kliknutých odkazů je nefunkční.
Zobrazení a filtrování detailů logů
Chcete-li zobrazit detaily jednotlivých logů jako tabulku nebo v JSON, klikněte na šipku vedle časové značky. Můžete použít pole v zobrazení tabulky pro aplikaci filtrů.
Filtrování z rozšířeného pohledu tabulky
Můžete použít ovládací prvky v zobrazení tabulky pro filtrování logů:
Filtrovat logy, které obsahují stejnou hodnotu ve vybraném poli (update_item v action v příkladě)
Filtrovat logy, které NEobsahují stejnou hodnotu ve vybraném poli (update_item v action v příkladě)
Zobrazit procentuální rozložení hodnot v tomto poli (stejná funkce jako lupa v seznamu polí vlevo)
Přidat do seznamu zobrazovaných polí pro všechny viditelné logy (stejná funkce jako v seznamu polí vlevo)
Hledací lišta
Můžete filtrovat pole (ne čas) pomocí hledací lišty. Hledací lišta vám řekne, který dotazovací jazyk používat. Dotazovací jazyk závisí na vašem zdroji dat. Použijte Lucene Query Syntax pro data uložená pomocí ElasticSearch.
Po zadání dotazu nastavte časový rámec a klikněte na tlačítko obnovy. Vaše filtry se uplatní na viditelné příchozí logy.
Vyšetřování IP adres
Můžete vyšetřovat IP adresy pomocí externích nástrojů pro analýzu. Můžete to například chtít udělat, když vidíte více podezřelých přihlášení z jedné IP adresy.
Použití externích nástrojů pro analýzu IP
1. Klikněte na IP adresu, kterou chcete analyzovat.
2. Klikněte na nástroj, který chcete použít. Budete přesměrováni na webovou stránku nástroje, kde můžete vidět výsledky analýzy IP adresy.
Dashboardy
Dashboard je sada grafů a diagramů, které představují data z vašeho systému. Dashboardy vám umožňují rychle získat přehled o tom, co se děje ve vaší síti.
Váš administrátor nastaví dashboardy na základě datových zdrojů a polí, která jsou pro vás nejvíce užitečná. Například můžete mít dashboard, který zobrazuje grafy týkající se pouze e-mailové aktivity, nebo pouze pokusů o přihlášení. Můžete mít mnoho dashboardů pro různé účely.
Data můžete filtrovat tak, aby se změnily údaje, které dashboard zobrazuje v rámci svých předem nastavených omezení.
Jak mi mohou dashboardy pomoci?
Když máte určitá data uspořádána do grafu, tabulky nebo diagramu, můžete získat vizuální přehled o aktivitě ve vašem systému a identifikovat trendy.
V tomto příkladu můžete vidět, že velký objem e-mailů byl odeslán a přijat 19. června.
Navigace v dashboardech
Otevření dashboardu
Chcete-li otevřít dashboard, klikněte na jeho název.
Ovládání dashboardu
Nastavení časového rámce
Můžete změnit časový rámec, který dashboard představuje. Najděte návod k nastavení času zde. Pro obnovení dashboardu s novým časovým rámcem klikněte na tlačítko obnovit.
Poznámka: V Dashboardech není žádná automatická obnova.
Filtrování dat na dashboardu
Chcete-li filtrovat data, která dashboard zobrazuje, použijte dotazovací lištu. Dotazovací jazyk, který potřebujete použít, závisí na vašem datovém zdroji. Dotazovací lišta vám sdělí, jaký dotazovací jazyk použít. Použijte Lucene Query Syntax pro data uložená pomocí ElasticSearch.
Příklad výše používá Lucene Query Syntax.
Přesunování widgetů
Můžete přemístit a změnit velikost jednotlivých widgetů. Chcete-li přesouvat widgety, klikněte na tlačítko menu dashboardu a vyberte Upravit.
Chcete-li přesunout widget, klikněte na kterékoli místo na widgetu a táhněte. Chcete-li změnit velikost widgetu, klikněte na pravý dolní roh widgetu a táhněte.
Pro uložení změn klikněte na zelené tlačítko uložit. Pro zrušení změn klikněte na červené tlačítko zrušit.
Tisk dashboardů
Chcete-li vytisknout dashboard, klikněte na tlačítko menu dashboardu a vyberte Tisk. Váš prohlížeč otevře okno, kde si můžete vybrat nastavení tisku.
Reporty
Reporty jsou pro tisk optimalizované vizuální reprezentace vašich dat, podobně jako tisknutelné řídicí panely. Váš administrátor volí, jaké informace budou v reportech obsaženy na základě vašich potřeb.
Najděte a vytiskněte report
- Vyberte report ze svého seznamu, nebo použijte vyhledávací lištu k nalezení vašeho reportu.
- Klikněte na Tisk. Váš prohlížeč otevře okno pro tisk, ve kterém můžete zvolit nastavení tisku.
Export
Převádějte sady logů do stahovatelných, zasílatelných souborů v Exportu. Tyto soubory můžete uchovávat na svém počítači, zkoumat je v jiném programu nebo je posílat e-mailem.
Co je export?
Export není soubor, ale proces, který vytváří soubor. Export obsahuje a následuje vaše pokyny, které data umístit do souboru, jaký typ souboru vytvořit a co s ním udělat. Když spustíte export, vytvoříte soubor.
Proč bych měl exportovat logy?
Pohled na skupinu logů v jednom souboru vám může pomoci lépe prozkoumat data. Několik důvodů, proč byste mohli chtít exportovat logy, jsou:
- K prozkoumání události nebo útoku
- K odeslání dat analytikovi
- K prozkoumání dat v programu mimo TeskaLabs LogMan.io
Navigace v exportu
Seznam exportů
Seznam exportů vám zobrazuje všechny exporty, které byly spuštěny.
Na stránce se seznamem můžete:
- Vidět podrobnosti exportu kliknutím na název exportu
- Stáhnout export kliknutím na ikonu cloudu vedle jeho názvu
- Smazat export kliknutím na ikonu koše vedle jeho názvu
- Vyhledávat exporty pomocí vyhledávací lišty
Stav exportu je kódován barvami:
- Zelená: Dokončeno
- Žlutá: Probíhá
- Modrá: Naplánováno
- Červená: Selhalo
Přeskočit na:
Spustit export
Spuštění exportu přidá export do vašeho Seznamu exportů, ale automaticky export nestáhne. Pokyny k tomu naleznete v části Stáhnout export.
Spustit export na základě přednastavených šablon
1. Na stránce Seznam exportů klikněte na Nový. Nyní vidíte přednastavené šablony exportů:
2. Chcete-li spustit přednastavený export, klikněte na tlačítko spuštění vedle názvu exportu.
NEBO
2. Chcete-li před spuštěním upravit export, klikněte na tlačítko úprav vedle názvu exportu. Proveďte změny a poté klikněte na Spustit. (Použijte tento návod, abyste se dozvěděli více o provádění změn.)
Jakmile spustíte export, budete automaticky přesměrováni zpět na seznam exportů a váš export se objeví na vrcholu seznamu.
Note
Předvolby vytvářejí administrátoři.
Spustit export na základě již dříve spuštěného exportu
Můžete znovu spustit již dříve spuštěný export. Opětovné spuštění exportu nepřepíše původní export.
1. Na stránce Seznam exportů klikněte na název exportu, který chcete znovu spustit.
2. Klikněte na Restartovat.
3. Můžete zde provést změny (viz tento návod) nebo export spustit tak, jak je.
4. Klikněte na Spustit.
Jakmile spustíte export, budete automaticky přesměrováni zpět na seznam exportů a váš nový export se objeví na vrcholu seznamu.
Vytvořit nový export
Vytvořit export z prázdného formuláře
1. V Seznamu exportů klikněte na Nový, poté klikněte na Vlastní.
2. Vyplňte pole.
Poznámka
Volby v rozbalovacích nabídkách se mohou měnit na základě provedených výběrů.
Název
Pojmenujte export.
Zdroj dat
Vyberte zdroj dat z rozbalovací nabídky.
Výstup
Vyberte typ souboru pro svá data. Může být:
- Surový: Pokud si přejete stáhnout export a importovat logy do jiného softwaru, zvolte surový. Pokud je zdroj dat Elasticsearch, formát surového souboru je .json.
- .csv: Hodnoty oddělené čárkou
- .xlsx: Formát Microsoft Excel
Kompresie
Zvolte, zda chcete exportní soubor zabalit, nebo jej nechat nekomprimovaný. Zabalený soubor je komprimovaný, a tudíž menší, což usnadňuje jeho odeslání a zabírá méně místa na vašem počítači.
Cíl
Vyberte cíl pro váš soubor. Může to být:
- Stáhnout: Soubor, který můžete stáhnout do svého počítače.
- E-mail: Vyplňte e-mailová pole. Když spustíte export, e-mail se odešle. Data si stále můžete kdykoliv stáhnout v Seznamu exportů.
- Jupyter: Uloží soubor do Jupyter notebooku, který můžete získat přístup na stránce Nástroje. K přístupu do Jupyter notebooku potřebujete mít administrativní oprávnění, takže si jako cíl vyberte Jupyter, pouze pokud jste administrátor.
Oddělovač
Pokud vyberete jako výstup .csv, zvolte, jaký znak bude označovat oddělení mezi jednotlivými hodnotami v každém logu. I když CSV znamená hodnoty oddělené čárkou, můžete použít jiný oddělovač, například středník nebo mezera.
Plán (volitelný)
Chcete-li plánovat export místo jeho okamžitého spuštění, klikněte na Přidat plán.
-
Jednorázový plán:
- Chcete-li export spustit jednorázově v budoucnu, zadejte požadované datum a čas ve formátu
YYYY-MM-DD HH:mm, například2023-12-31 23:59(31. prosince 2023, ve 23:59).
- Chcete-li export spustit jednorázově v budoucnu, zadejte požadované datum a čas ve formátu
-
Pravidelný export:
-
Chcete-li nastavit export, který se automaticky spustí v pravidelném intervalu, použijte syntaxi
cron. Více o cron se můžete dozvědět na Wikipedii a použijte tento nástroj a tyto příklady od Cronitoru k psaní cron výrazů. -
Pole Plán také podporuje náhodné použití
Ra výrazy klíčových slov ve stylu Vixie cron@.
-
Dotaz
Zadejte dotaz pro filtrování určitých dat. Dotaz určuje, která data se mají exportovat, včetně časového rámce logů.
Warning
V každém exportu musíte použít dotaz. Pokud spustíte export bez dotazu, veškerá data uložená ve vašem programu budou exportována bez filtru pro čas nebo obsah. To by mohlo vytvořit extrémně velký soubor a zatížit komponenty pro ukládání dat a soubor pravděpodobně nebude užitečný ani pro vás, ani pro analytiky.
Pokud omylem spustíte export bez dotazu, můžete export smazat, zatímco stále běží v Seznamu exportů kliknutím na tlačítko koše.
TeskaLabs LogMan.io používá Elasticsearch Query DSL (Domain Specific Language).
Zde je kompletní příručka Elasticsearch Query DSL.
Příklad dotazu:
{
  "bool": {
    "filter": [
      {
        "range": {
          "@timestamp": {
            "gte": "now-1d/d",
            "lt": "now/d"
          }
        }
      },
      {
        "prefix": {
         "event.dataset": {
            "value": "microsoft-office-365"
          }
       }
      }
   ]
  }
}
Rozbor dotazu:
bool: To nám říká, že celý dotaz je binární, což kombinuje více podmínek jako "musí", "měl by" a "nesmí". Zde se používá filter k nalezení charakteristik, které data musí mít, aby se dostala do exportu. filter může mít více podmínek.
range je první podmínka filtru. Jelikož se odkazuje na pole pod sebou, což je @timestamp, bude filtrovat logy na základě rozsahu hodnot v poli timestamp.
@timestamp nám říká, že dotaz filtruje čas, takže bude exportovat logy z určitého časového období.
gte: To znamená "větší než nebo rovno", což je nastaveno na hodnotu now-1d/d, což znamená, že nejstarší časové razítko (první log) bude z přesně jednoho dne zpět v okamžiku, kdy spustíte export.
lt znamená "méně než" a je nastaveno na now/d, takže nejnovější časové razítko (poslední log) bude nejnovější v okamžiku spuštění exportu ("teď").
prefix je druhá podmínka filtru. Hledá logy, kde hodnota pole, v tomto případě event.dataset, začíná na microsoft-office-365.
Co tento dotaz znamená?
Tento export zobrazí všechny logy z Microsoft Office 365 za posledních 24 hodin.
3. Přidejte sloupce
Pro soubory .csv a .xlsx musíte specifikovat, jaké sloupce chcete mít ve svém dokumentu. Každý sloupec představuje datové pole. Pokud nespecifikujete žádné sloupce, výsledná tabulka bude mít všechny možné sloupce, takže tabulka může být mnohem větší, než očekáváte nebo potřebujete.
Seznam všech dostupných datových polí naleznete v Průzkumníku. Chcete-li zjistit, jaká pole jsou relevantní pro logy, které exportujete, prozkoumejte jednotlivé logy v Průzkumníku.
- Chcete-li přidat sloupec, klikněte na Přidat. Zadejte název sloupce.
- Chcete-li sloupec odebrat, klikněte na -.
- Chcete-li sloupce přeuspořádat, klikněte a přetáhněte šipky.
Varování
Stisknutí enter po zadání názvu sloupce spustí export.
Tento příklad byl stažen z výše uvedeného exportu jako .csv soubor a poté oddělen do sloupců pomocí Průvodce převodem textu na sloupce Microsoft Excel. Můžete vidět, že sloupce zde odpovídají sloupcům specifikovaným v exportu.
4. Spusťte export stisknutím Start.
Jakmile spustíte export, budete automaticky přesměrováni zpět na seznam exportů a váš export se objeví na vrcholu seznamu.
Stáhnout export
1. Na stránce Seznam exportů klikněte na tlačítko cloudu ke stažení.
NEBO
1. Na stránce Seznam exportů klikněte na název exportu.
2. Klikněte na Stáhnout.
Váš prohlížeč by měl automaticky zahájit stahování.
Smazat export
1. Na stránce Seznam exportů klikněte na tlačítko koše.
NEBO
1. Na stránce Seznam exportů klikněte na název exportu.
2. Klikněte na Odstranit.
Export by měl zmizet ze seznamu.
Přidat export do knihovny
Note
Tato funkce je k dispozici pouze administrátorům.
Pokud se vám líbí export, který jste vytvořili nebo upravili, můžete jej uložit do své knihovny jako přednastavenou šablonu pro budoucí použití.
1. Na stránce Seznam exportů klikněte na název exportu.
2. Klikněte na Uložit do knihovny.
Když na stránce Seznam exportů kliknete na Nový, měl by se váš nový přednastavený export objevit v seznamu.
Knihovna
Funkce pro administrátory
Knihovna je funkce pro administrátory. Knihovna má významný dopad na to, jak TeskaLabs LogMan.io funguje. Někteří uživatelé nemají k Knihovně přístup.
Knihovna uchovává položky (soubory), které určují, co vidíte při používání TeskaLabs LogMan.io. Položky v Knihovně určují například vaši domovskou stránku, dashboardy, reporty, exporty, pravidla pro parsování a korelaci a některé funkce SIEM.
TeskaLabs LogMan.io je dodáván s předem vytvořeným obsahem. Tento obsah můžete přizpůsobit vašim potřebám.
Warning
Změna položek v Knihovně má vliv na to, jak TeskaLabs LogMan.io a TeskaLabs SIEM fungují. Pokud si nejste jisti změnami v Knihovně, kontaktujte Podporu.
Navigace v Knihovně


Vyhledávání položek
Pro nalezení položky použijte vyhledávací pole, nebo procházejte složky.
Pokud přejdete do složky v Knihovně a chcete se vrátit k vyhledávacímu poli, klikněte znovu na Knihovna.
Přidávání položek do Knihovny
Vytváření položek ve složce
Položku můžete vytvořit přímo v určitých složkách. Pokud je možné přidat položku, zobrazí se tlačítko Vytvořit novou položku ve (složce) při kliknutí na složku.
- Pro přidání položky klikněte na Vytvořit novou položku ve (složce).
- Pojmenujte položku, vyberte příponu souboru z rozbalovací nabídky a klikněte na Vytvořit.
- Pokud se položka neobjeví okamžitě, aktualizujte stránku, a vaše položka by se měla objevit v Knihovně.
Přidání položky zkopírováním existující položky
- Klikněte na položku, kterou chcete zkopírovat.
- Klikněte na tlačítko ... v horní části.
- Klikněte na Kopírovat.
- Přejmenujte položku, vyberte příponu souboru z rozbalovací nabídky, a klikněte na Kopírovat.
- Pokud se položka neobjeví okamžitě, aktualizujte stránku, a vaše položka by se měla objevit v Knihovně.
Úprava položky v Knihovně
- Klikněte na položku, kterou chcete upravit.
- Pro úpravu položky klikněte na Upravit.
- Pro uložení změn klikněte na Uložit, nebo ukončete editor bez uložení kliknutím na Zrušit.
- Pokud se vaše úpravy neprojeví okamžitě, aktualizujte stránku, a vaše změny by měly být uloženy.
Odstranění položky z Knihovny
- Klikněte na položku, kterou chcete odstranit.
- Klikněte na tlačítko ... v horní části.
- Klikněte na Odstranit a potvrďte Ano, pokud vás váš prohlížeč vyzve.
- Pokud se položka neodstraní okamžitě, aktualizujte stránku, a odstraněná položka by měla zmizet.
Deaktivace položek
Můžete dočasně deaktivovat položku. Zůstane ve vaší knihovně, ale její dopad na váš systém bude pozastaven.
Pro deaktivaci položky klikněte na položku a klikněte na Deaktivovat.
Položku můžete kdykoliv znovu aktivovat kliknutím na Aktivovat.
Note
Nemůžete číst obsah položky, když je deaktivovaná.
Vrstvy Knihovny
Položky Knihovny jsou uloženy ve vrstvách.
- Vrstva nájemce (cyan): obsah viditelný pouze pro vybraného nájemce.
- Globální vrstva (purple): obsah viditelný pro všechny nájemce.
- Základní vrstva (blue): předem vytvořený obsah poskytovaný TeskaLabs, viditelný pro všechny nájemce.
Vrstva je indikována na panelu obsahu.


Položka na základní vrstvě může být přepsána globální nebo vrstvou nájemce. Položka na globální vrstvě může být přepsána vrstvou nájemce.
Úprava na globální / nájemní vrstvě
U některých položek můžete vybrat cílovou vrstvu (globální nebo nájemní), kam chcete uložit své změny. Tato možnost je k dispozici vedle tlačítka Uložit.


Obnovení zpět na základní vrstvu
Položka na globální nebo nájemní vrstvě, která přepisuje základní vrstvu, může být obnovena, tj. vrácena zpět na základní vrstvu. Jednoduše klikněte na tlačítko Akce a vyberte Obnovit.


Vyhledávání
Administrátorská funkce
Vyhledávání je administrátorská funkce. Někteří uživatelé nemají přístup k Vyhledáváním.
Můžete použít vyhledávání k získání a uložení dalších informací z externích zdrojů. Další informace obohatí vaše data a přidají relevantní kontext. Díky tomu jsou vaše data hodnotnější, protože můžete data analyzovat hlouběji. Například můžete uložit uživatelská jména, aktivní uživatele, aktivní VPNky a podezřelé IP adresy.
Tip
Můžete si přečíst více o Vyhledávání zde v Referenční příručce.
Navigace Vyhledáváním


Vytvoření nového vyhledávání
Pro vytvoření nového vyhledávání:
- Klikněte na Vytvořit vyhledávání.
- Vyplňte pole: Název, Krátký popis, Podrobný popis a Klíč(e).
- Pro přidání dalšího klíče klikněte na +.
- Zvolte, zda chcete přidat nebo nepřidat expiraci.
- Klikněte na Uložit.


Vyhledání vyhledávání
Použijte vyhledávací lištu pro nalezení konkrétního vyhledávání. Použití vyhledávací lišty neprohledává obsah vyhledávání, pouze názvy vyhledávání. Pro zobrazení všech vyhledávání znovu po použití vyhledávací lišty vymažte vyhledávací lištu a stiskněte Enter nebo Return.
Zobrazení a úprava detailů vyhledávání
Zobrazení klíčů/položek vyhledávání
Pro zobrazení klíčů a hodnot, nebo položek, vyhledávání klikněte na tlačítko ..., a klikněte na Položky.
Úprava klíčů/položek vyhledávání
Z Seznamu vyhledávání klikněte na tlačítko ... a klikněte na Položky. To vás vezme na stránku individuálního vyhledávání.
Přidání: Pro přidání položky klikněte na Přidat položku.
Úprava: Pro úpravu stávající položky klikněte na tlačítko ... na řádku položky a klikněte na Upravit.
Smazání: Pro smazání položky klikněte na tlačítko ... na řádku položky a klikněte na Smazat.
Nezapomeňte kliknout na Uložit po provedení změn.
Zobrazení popisu vyhledávání
Pro zobrazení podrobného popisu vyhledávání klikněte na tlačítko ... na stránce Seznam vyhledávání a klikněte na Informace.
Úprava popisu vyhledávání
- Klikněte na tlačítko ... na stránce Seznam vyhledávání a klikněte na Informace. To vás vezme na stránku informací vyhledávání.
- Klikněte na Upravit vyhledávání ve spodní části.
- Po provedení změn klikněte na Uložit, nebo klikněte na Zrušit pro ukončení režimu úprav.
Smazání vyhledávání
Pro smazání vyhledávání:
-
Klikněte na tlačítko ... na stránce Seznam vyhledávání a klikněte na Informace. To vás vezme na stránku informací vyhledávání.
-
Klikněte na Smazat vyhledávání.
Nástroje
Funkce administrátora
Nástroje jsou funkcí pro administrátora. Změny, které provedete při návštěvě externích nástrojů, mohou mít významný dopad na fungování TeskaLabs LogMan.io. Někteří uživatelé nemají přístup na stránku Nástroje.
Stránka Nástroje poskytuje rychlý přístup k externím programům, které spolupracují nebo mohou být použity společně s TeskaLabs LogMan.io.


Používání externích nástrojů
Pro automatické zabezpečené přihlášení k nástroji klikněte na ikonu nástroje.
Upozornění
- I když jsou data tenantů v TeskaLabs LogMan.io UI oddělena, data tenantů nejsou oddělena v rámci těchto nástrojů.
- Změny, které provedete v Zookeeper, Kafka a Kibana, by mohly poškodit vaše nasazení TeskaLabs LogMan.io.
Údržba
Funkce administrátora
Údržba je funkcí administrátora. To, co v rámci Údržby provádíte, má významný dopad na způsob, jakým TeskaLabs LogMan.io funguje. Někteří uživatelé nemají přístup k Údržbě.
Sekce Údržby zahrnuje Konfiguraci a Služby.
Konfigurace
Konfigurace obsahuje soubory JSON, které určují některé komponenty, které můžete vidět a používat v TeskaLabs LogMan.io. Například Konfigurace zahrnuje:
- Stránku Průzkumníka
- Postranní panel
- Tenants
- Stránku Nástrojů
Upozornění
Konfigurační soubory mají významný dopad na způsob, jakým TeskaLabs LogMan.io funguje. Pokud potřebujete pomoc s konfigurací uživatelského rozhraní, kontaktujte Podporu.
Základní a Pokročilý režim
Můžete přepínat mezi Základním a Pokročilým režimem pro konfigurační soubory.
Základní má vyplňovací pole. Pokročilý zobrazuje soubor ve formátu JSON. Chcete-li zvolit režim, klikněte na Základní nebo Pokročilý v pravém horním rohu.
Úprava konfiguračního souboru
Chcete-li konfigurační soubor upravit, klikněte na název souboru, zvolte preferovaný režim a proveďte změny. Soubor je vždy editovatelný - nemusíte na nic klikat, aby bylo možné začít upravovat. Nezapomeňte kliknout na Uložit, až budete hotovi.
Služby
Služby vám ukazují všechny služby a mikroservices ("mini programy"), které tvoří infrastrukturu TeskaLabs LogMan.io.
Upozornění
Vzhledem k tomu, že TeskaLabs LogMan.io je tvořen mikroservices, zásah do mikroservices může mít významný dopad na výkon programu. Pokud potřebujete pomoc s mikroservices, kontaktujte Podporu.
Zobrazení detailů služby
Chcete-li zobrazit detaily služby, klikněte na šipku vlevo od názvu služby.
Auth: Kontrola přístupu uživatelů
Funkce pro administrátory
Auth je funkce pro administrátory. Má významný dopad na lidi používající TeskaLabs LogMan.io. Někteří uživatelé nemají přístup na stránky Auth.
Sekce Auth (autorizace) zahrnuje všechny ovládací prvky, které administrátoři potřebují k řízení uživatelů a tenantů.
Přihlašovací údaje
Přihlašovací údaje jsou uživatelé. Z obrazovky Přihlašovací údaje můžete vidět:
- Jméno: Uživatelské jméno, které někdo používá k přihlášení
- Tenanti: Tenanti, ke kterým má tento uživatel přístup (viz Tenanti)
- Role: Soubor oprávnění, které tento uživatel má (viz Role)
Vytvoření nových přihlašovacích údajů
1. Pro vytvoření nového uživatele klikněte na Vytvořit nové přihlašovací údaje.
2. Na kartě Vytvořit zadejte uživatelské jméno. Pokud chcete osobě poslat e-mail s pozvánkou k nastavení nového hesla, zadejte její e-mailovou adresu a zaškrtněte políčko Poslat pokyny k nastavení hesla.


3. Klikněte na Vytvořit přihlašovací údaje.
Nové přihlašovací údaje se objeví v seznamu Přihlašovací údaje. Pokud jste zaškrtli políčko Poslat pokyny k nastavení hesla, nový uživatel by měl obdržet e-mail.
Úprava přihlašovacích údajů
Pro úpravu přihlašovacího údaje klikněte na uživatelské jméno a poté klikněte na Upravit v sekci, kterou chcete změnit. Nezapomeňte kliknout na Uložit pro uložení změn nebo klikněte na Zrušit pro ukončení editoru.
Tenanti
Tenant je entita, která shromažďuje data z několika zdrojů. Každý tenant má izolovaný prostor pro shromažďování a správu svých dat. (Data každého tenanta jsou v UI zcela oddělena od dat ostatních tenantů.) Jedno nasazení TeskaLabs LogMan.io může zvládnout mnoho tenantů (multitenance).
Jako uživatel může být vaše společnost jen jeden tenant, nebo můžete mít různé tenanty pro různé oddělení. Pokud jste distributor, každý z vašich klientů má alespoň jednoho tenant.
Jeden tenant může být přístupný několika uživateli a uživatelé mohou mít přístup k více tenantům. Můžete kontrolovat, kteří uživatelé mají přístup k jakým tenantům, přiřazením přihlašovacích údajů k tenantům nebo naopak.
Zdroje
Zdroje jsou nejzákladnější jednotkou autorizace. Jsou to jednotlivá a specifická přístupová oprávnění.
Příklady:
- Možnost přístupu k dashboardům z určitého datového zdroje
- Možnost mazat tenanty
- Možnost provádět změny v Knihovně
Role
Role je kontejnerem pro zdroje. Můžete vytvořit roli, která zahrnuje libovolnou kombinaci zdrojů, takže role je soubor oprávnění.
Klienti
Klienti jsou další aplikace, které přistupují k TeskaLabs LogMan.io pro podporu jeho fungování.
Varování
Odebrání klienta může přerušit základní funkce programu.
Sezení
Sezení jsou aktivní přihlašovací období aktuálně probíhající.
Způsoby, jak ukončit sezení:
- Klikněte na červené X na řádku sezení na stránce Sezení.
- Klikněte na název sezení, poté klikněte na Ukončit sezení.
- Pro ukončení všech sezení (odhlášení všech uživatelů) klikněte na Ukončit vše na stránce Sezení.
Tip
Modul Auth využívá TeskaLabs SeaCat Auth. Pro více informací si můžete přečíst jeho dokumentaci nebo se podívat na jeho repozitář na GitHubu.
Tabulky dat
Některé funkce LogMan.io používají tabulky dat k zobrazení seznamů.
Nepřetržitě pracujeme na rozšíření možností tabulek dat v celém produktu.
Stránky funkcí, které používají tabulky dat, zahrnují Exporty, Baseliner, Upozornění, Vyhledávání, Údržbu služeb, Kolektory a moduly Autentizace, jako jsou Přihlašovací údaje, Nájemci atd.
Řazení
Řazení podle jednoho sloupce
Data můžete řadit podle jakéhokoli sloupce, vedle názvu sloupce se zobrazuje ikona pro řazení.
Pro alfanumerické řazení podle sloupce klikněte na ikonu se dvěma šipkami vedle názvu sloupce.


Šipka směřující dolů označuje řazení v alfanumerickém pořadí, sestupně.


Šipka směřující nahoru označuje, že data jsou seřazena v alfanumerickém pořadí, vzestupně.


Řazení podle více sloupců
Pro alfanumerické řazení podle více sloupců držte shift, zatímco klikáte na ikony pro řazení.
Položky na stránku
Chcete-li změnit počet položek zobrazených na stránce:
- Klikněte na číslo vedle Položek na stránku v dolní části obrazovky.
- Vyberte číslo. Stránka se automaticky znovu načte.


Alternativně můžete přizpůsobit počet položek na stránku pomocí URL.
URL obsahuje i= následované číslem.
Chcete-li změnit počet položek na stránku, změňte toto číslo a stiskněte enter nebo return.
Například i=7 zobrazuje 7 položek na stránku.
Specializované filtrování
Některé funkce, jako například Upozornění, umožňují specializované filtrování.
Zde můžete například filtrovat podle konkrétních hodnot z polí Typ, Závažnost a Stav.


Analytikův manuál
Manuál analytika
Manuál analytika
Odborníci na kybernetickou bezpečnost a datoví analytici používají Manuál analytika k:
- Dotazování a vyšetřování událostních dat
- Psaní, nasazení a ladění detekčních pravidel
- Sledování hostů, uživatelů a služeb jako aktiv
- Vytváření pravidel pro parsování a obohacení
- Tvorbě dashboardů a notifikací
Pro každodenní navigaci ve webové aplikaci navštivte Uživatelský manuál. Pro instalaci a nastavení clusteru viz Administrátorský manuál a Referenční příručku.
Začněte zde
Vyberte úkol, který potřebujete udělat. Každý odkaz vede na cílenou příručku.
Vyšetřování událostí
| Cíl | Začněte zde |
|---|---|
| Hledání a filtrování surových logů | Dotazy |
| Obrazovka Discover (UI) | Uživatelský manuál: Discover |
| Grafy a dashboardy | Dashboardy |
Nasazení a ladění detekcí
| Cíl | Začněte zde |
|---|---|
| Co je detekční pravidlo | O detekcích |
| Povolit pravidla v produkci | Nasazení detekčních pravidel |
| Napsat window korelační pravidlo | Příručka window korelací |
| Číst metriky a opravit pomalá pravidla | Sledování výkonu detekcí |
| Lookupy v pravidlech | Lookups v detekcích |
| Threat intelligence v pravidlech | Threat intelligence feedy |
| Naplnit IOC lookup z MISP | MISP feed |
| Pokročilá vícefázová pravidla | Pokročilá korelační pravidla |
| Nainstalovat Sysmon, aby Windows detekce a korelace dostaly procesy, síť a soubory | Konfigurace Sysmon |
Správa aktiv
| Cíl | Začněte zde |
|---|---|
| Inventář, riziko, stale alerty, upozornění na nová aktiva | Správa aktiv |
Normalizace user.name z Active Directory |
LDAP / AD feed identity uživatelů |
| Rizikové skóre řízené detekcemi | Hodnocení rizika |
Parsování a obohacení dat
| Cíl | Začněte zde |
|---|---|
| Přehled parsování | Pravidla pro parsování |
| Geolokační zóny | Geolokační vyhledávání |
| ASN obohacení (vlastník sítě) | ASN obohacení |
| Vlastní MaxMind databáze | Vlastní MaxMind enricher |
Notifikace a reakce
| Cíl | Začněte zde |
|---|---|
| E-mail z detekcí nebo alertů | Notifikace |
| Upozornění při objevení nového aktiva | Správa aktiv: notifikace nového aktiva |
| E-mailové šablony | Tvorba e-mailových šablon |
Cesta detection engineeringu
Pokud píšete pravidla poprvé, postupujte v tomto pořadí:
- Co je detekce?
- Příklad window korelace
- Jak napsat window korelační pravidlo
- Predikáty a Triggery
- Nasazení detekčních pravidel: povolení pravidel na obrazovce Detekce
- Sledování výkonu detekcí
Rychlá reference
- Dotazy: Psaní dotazů pro hledání a filtrování dat
- Dashboardy: Návrh vizualizací pro souhrny a vzory dat
- Pravidla pro parsování: Vytváření a přizpůsobení pravidel pro parsování
- Detekce: Vlastní detekce aktivit a vzorů
- Nasazení detekčních pravidel: Povolení pravidel pro tenant
- Správa aktiv: Hosti, uživatelé, služby, riziko, stale alerty a notifikace nových aktiv
- LDAP / AD feed identity uživatelů: Naplnění
usernames2useridz Active Directory pro automatickou normalizaciuser.id - Lookups v detekcích: Whitelisty, blacklisty, lookupy v korelačních pravidlech a seed dat lookupu v testech pravidel
- Geolokační vyhledávání: Vlastní IP rozsahové zóny
- ASN obohacení: Číslo autonomního systému a organizace na IP polích
- Vlastní MaxMind enricher: Vlastní
.mmdba mapování atributů na události - Threat intelligence feedy: Plnění IOC lookupů z feedů (HTTP, CSV, MISP, …) a zapojení do detekcí a hodnocení rizika
- Pokročilá korelační pravidla: Vícefázové detekce v knihovně a validace v labu
- Pokrytí MITRE: Pohledy matice ATT&CK pro vestavěná pravidla a pro vestavěná pravidla plus Sigma
- Sledování výkonu detekcí: Metriky na obrazovce Detekce a ladění pomalých pravidel
- Notifikace: Odesílání zpráv e-mailem z detekcí nebo alertů
Použití Lucene Query Syntax
Pokud ukládáte data do Discover obrazovky v TeskaLabs LogMan.io, musíte pro dotazování dat používat Lucene Query Syntax.
Zde jsou některé rychlé tipy pro použití Lucene Query Syntax, ale můžete také vidět úplnou dokumentaci na webové stránce Elasticsearch nebo navštívit tento tutoriál.
Lucene Query Syntax můžete použít při tvorbě dashboardů, filtrování dat v dashboardech a při hledání logů v Průzkumník.
Základní dotazové výrazy
Hledání pole message s jakoukoli hodnotou:
message:*
Hledání hodnoty delivered v poli message:
message:delivered
Hledání fráze Email was delivered v poli message:
message:"Email was delivered"
Hledání jakékoli hodnoty v poli message, ale NE hodnoty delivered:
message:* -message:delivered
Hledání textu delivered kdekoli ve hodnotě v poli message:
message:"*delivered*"
Toto může vrátit výsledky zahrnující:
message: delivered
message: not delivered
message: delivered with delay
Tip
Doporučujeme používat uvozovky "..." kolem vašich vyhledávacích termínů, zejména při hledání frází nebo hodnot obsahujících mezery, speciální znaky nebo IP adresy. Uvádění do uvozovek zajišťuje, že dotaz odpovídá přesné frázi nebo hodnotě, jak bylo zamýšleno, a pomáhá se vyhnout neočekávaným výsledkům způsobeným prioritou operátorů nebo tokenizací.
Typy Elasticsearch
Elasticsearch ukládá data do polí se specifickými typy, jako jsou keyword (pro přesné textové hodnoty), number (pro celá nebo reálná čísla), ip (pro IP adresy) a geo_point (pro geografické souřadnice). Typ pole určuje, jak můžete dotazovat.
- keyword: Používá se pro přesné shody (např.
event.outcome:success). - number: Podporuje dotazy v rozsahu (např.
source.port:[10000 TO 20000]). - ip: Používá se pro adresy IPv4 a IPv6. Můžete hledat konkrétní IP nebo rozsah/podsíť (např.
source.ip: "192.168.1.0/24"). - geo_point: Používá se pro souřadnice zeměpisné šířky/délky (pokročilé dotazy).
Úplnou referenci naleznete zde.
Dotazování čísel:
Pro hledání rozsahu portů:
source.port:[10000 TO 20000]
Dotazování IP adres:
Pro hledání konkrétní IPv4 adresy:
source.ip: "192.168.1.10"
Pro hledání IPv4 adresy v rámci podsíti (CIDR notace):
source.ip: "192.168.1.0/24"
Pro hledání IPv6 adresy v rámci podsíti (CIDR notace):
source.ip: "2a01:9ce0:0:1:7ec2:55ff:fe25::/64"
Tip
Použijte nástroje jako ip address guide pro převod mezi rozsahy IP adres a CIDR notací.
Kombinování dotazových výrazů
Použijte booleovské operátory pro kombinování výrazů:
AND - kombinuje kritéria
OR - alespoň jedno z kritérií musí být splněno
Použití závorek
Použijte závorky, když je třeba seskupit více položek dohromady, aby vytvořily výraz.
Příklady seskupených výrazů:
Hledání logů, kde buď dataset je linux a zdrojová IP je v podsíti 107.10.0.0/28, nebo cílová IP je ve stejné podsíti a výsledek události je "failure":
(event.dataset:"linux" AND source.ip:"107.10.0.0/28") OR
(destination.ip:"107.10.0.0/28" AND event.outcome:"failure")
Příklad ze skutečného světa:
Hledání logů, kde dataset je linux a zdrojová IP je v podsíti 10.0.0.0/24, nebo cílová IP je ve stejné podsíti a akce události je "blocked":
(event.dataset:"linux" AND source.ip:"10.0.0.0/24") OR
(destination.ip:"10.0.0.0/24" AND event.action:"blocked")
Dashboards
Dashboards jsou vizualizace příchozích logových dat. Zatímco TeskaLabs LogMan.io přichází s knihovnou přednastavených dashboardů, můžete si také vytvořit vlastní. Zobrazte přednastavené dashboardy v webové aplikaci LogMan.io v Dashboards.
Abychom vytvořili dashboard, musíte napsat nebo zkopírovat soubor dashboardu do Library.
Vytvoření souboru dashboardu
Napište dashboardy v JSON.
Vytvoření prázdného dashboardu
- V TeskaLabs LogMan.io přejděte do Library.
- Klikněte na Dashboards.
- Klikněte na Create new item in Dashboards.
- Pojmenujte položku a klikněte na Create. Pokud se nová položka ihned nezobrazí, obnovte stránku.
Kopírování existujícího dashboardu
- V TeskaLabs LogMan.io přejděte do Library.
- Klikněte na Dashboards.
- Klikněte na položku, kterou chcete duplikovat, a poté klikněte na ikonu blízko horní části. Klikněte na Copy.
- Zvolte nové jméno pro položku a klikněte na Copy. Pokud se nová položka ihned nezobrazí, obnovte stránku.
Struktura dashboardu
Napište dashboardy v JSON a mějte na paměti, že jsou citlivé na velikost písmen.
Dashboardy mají dvě části:
- Základ dashboardu: Panel dotazu, výběr času, tlačítko pro obnovení a tlačítko pro možnosti
- Widgety: Vizualizace (graf, tabulka, seznam atd.)
Základ dashboardu
Zahrňte tuto sekci přesně tak, jak je, abyste zahrnuli panel dotazu, výběr času, tlačítko pro obnovení a možnosti.
{
    "Prompts": {
        "dateRangePicker": true,
        "filterInput": true,
        "submitButton": true
Panel dotazu vykreslený:


Widgety
Widgety se skládají z párů datasource a widget. Když píšete widget, musíte zahrnout jak sekci datasource, tak sekci widget.
Tipy pro formátování JSON:
- Oddělte každou sekci
datasourceawidgetsloženou závorkou a čárkou},kromě posledního widgetu v dashboardu, který čárku nepotřebuje (viz celý příklad) - Ukončete každý řádek čárkou
,kromě poslední položky v sekci
Umístění widgetu
Každý widget má rozvrhové řádky, které určují velikost a umístění widgetu. Pokud při psaní widgetu nezahrnete rozvrhové řádky, dashboard je vygeneruje automaticky.
- Zahrňte rozvrhové řádky s doporučenými hodnotami z každé šablony widgetu, NEBO nezahrnujte žádné rozvrhové řádky. (Pokud nezahrnete žádné rozvrhové řádky, ujistěte se, že poslední položka v každé sekci nekončí čárkou.)
- Přejděte na Dashboards v LogMan.io a změňte velikost a umístění widgetu.
- Když přesunete widget na stránce Dashboards, soubor dashboardu v Knihovně automaticky generuje nebo upravuje rozvrhové řádky podle potřeby. Pokud pracujete v souboru dashboardu v Knihovně a současně měníte umístění widgetů na Dashboards, ujistěte se, že uložíte a obnovíte obě stránky po provedení změn na kterékoliv stránce.
Pořadí widgetů ve vašem souboru dashboardu neurčuje umístění widgetu a pořadí se nemění, pokud widgety přemístíte na Dashboards.
Pojmenování
Doporučujeme se dohodnout na konvencích pojmenování pro dashboardy a widgety ve vaší organizaci, abyste se vyhnuli zmatku.
matchPhrase filtr
Pro datové zdroje Elasticsearch použijte Lucene dotazovou syntaxi pro hodnotu matchPhrase.
Barvy
Ve výchozím nastavení widgety koláčového grafu a sloupcového grafu používají modrou barevnou paletu. Chcete-li změnit barevnou paletu, vložte "color":"(barevná paleta)" přímo před rozvrhové řádky.
- Modrá: Není třeba žádné další řádky
- Fialová:
"color":"sunset" - Žlutá:
"color":"warning" - Červená:
"color":"danger"
Odstraňování problémů s JSON
Pokud při pokusu o uložení souboru dostanete chybovou zprávu o formátování JSON:
- Řiďte se doporučením chybové zprávy, která specifikuje, co JSON "očekává" - může to znamenat, že vám chybí povinný pár klíč-hodnota, nebo je interpunkce nesprávná.
- Pokud nemůžete najít chybu, zkontrolujte, zda je vaše formátování konzistentní s ostatními funkčními dashboardy.
Pokud se váš widget nezobrazuje správně:
- Ujistěte se, že hodnota
datasourcese shoduje v sekcích datového zdroje a widgetu. - Zkontrolujte pravopisné chyby nebo problémy se strukturou dotazu v jakýchkoli odkazovaných polích a v polích uvedených v dotazu
matchphrase. - Zkontrolujte jakékoli další překlepy nebo nesrovnalosti.
- Zkontrolujte, že zdroj logů, na který odkazujete, je připojen.
Použijte tyto příklady jako vodítka. Klikněte na ikony , abyste se dozvěděli, co každá řádka znamená.
Sloupcové grafy
Sloupcový graf zobrazuje hodnoty s vertikálními sloupci na ose x a y. Délka každého sloupce je úměrná datům, která představuje.
Příklad JSON pro sloupcový graf:
    "datasource:office365-email-aggregated": { #(1)
        "type": "elasticsearch", #(2)
        "datetimeField": "@timestamp", #(3)
        "specification": "lmio-{{ tenant }}-events*", #(4)
        "aggregateResult": true, #(5)
        "matchPhrase": "event.dataset:microsoft-office-365 AND event.action:MessageTrace" #(6)
    },
    "widget:office365-email-aggregated": { #(7)
        "datasource": "datasource:office365-email-aggregated", #(8)
        "title": "Odeslané a přijaté e-maily", #(9)
        "type": "BarChart", #(10)
        "xaxis": "@timestamp", #(11)
        "yaxis": "o365.message.status", #(12)
        "ylabel": "Počet", #(13)
        "table": true, #(14)
        "layout:w": 6, #(15)
        "layout:h": 4,
        "layout:x": 0,
        "layout:y": 0,
        "layout:moved": false,
        "layout:static": true,
        "layout:isResizable": false
    },
datasourceoznačuje začátek sekce datového zdroje a také název datového zdroje. Název neovlivňuje funkci dashboardu, ale musíte na něj správně odkazovat v sekci widgetu.- Typ datového zdroje. Pokud používáte Elasticsearch, hodnota je
"elasticsearch" - Indikuje, které pole v logech je polem s datem a časem. Například v logech Elasticsearch, které jsou parsovány Elastic Common Schema (ECS), je pole s datem a časem
@timestamp. - Odkazuje na index, ze kterého se načítají data v Elasticsearch. Hodnota
lmio-{{ tenant}}-events*odpovídá našim názvovým konvencím indexů v Elasticsearch a{{ tenant }}je místo pro aktivního tenanta. Hvězdička*umožňuje neupřesněné další znaky v názvu indexu zaevents. Výsledek: Widget zobrazuje data z aktivního tenanta. aggregateResultnastaveno natrueprovádí agregaci na datech před jejich zobrazením v dashboardu. V tomto případě se počítají odeslané a přijaté e-maily (vypočítává se součet).- Dotaz, který filtruje konkrétní logy pomocí Lucene dotazové syntaxi. V tomto případě musí být jakákoli data zobrazená v dashboardu z datasetu Microsoft Office 365 a mít hodnotu
MessageTracev polievent.action. widgetoznačuje začátek sekce widgetu a také název widgetu. Název neovlivňuje funkci dashboardu.- Odkazuje na sekci datového zdroje výše, která ji naplňuje. Ujistěte se, že hodnota zde přesně odpovídá názvu příslušného datového zdroje. (Tímto se widget dozví, odkud získá data.)
- Název widgetu, který se bude zobrazovat v dashboardu
- Typ widgetu
- Pole z logů, jehož hodnoty budou reprezentovány na ose x
- Pole z logů, jehož hodnoty budou reprezentovány na ose y
- Popis pro osu y, který se bude zobrazovat v dashboardu
- Nastavení
tablenatruevám umožňuje přepínat mezi zobrazením grafu a zobrazením tabulky na widgetu v dashboardu. Výběrfalsezakáže funkci přepínání mezi grafem a tabulkou. - Viz poznámka výše o umístění widgetů pro informace o rozvrhových řádcích.
Widget sloupcového grafu vykreslený:


Šablona sloupcového grafu:
Pro vytvoření widgetu sloupcového grafu zkopírujte a vložte tuto šablonu do souboru dashboardu v Knihovně a vyplňte hodnoty. Doporučené rozvrhové hodnoty, hodnoty specifikující datový zdroj Elasticsearch a hodnota, která organizuje sloupcový graf podle času, jsou již vyplněny.
    "datasource:Název datového zdroje": {
        "type": "elasticsearch",
        "datetimeField": "@timestamp",
        "specification": "lmio-{{ tenant }}-events*",
        "aggregateResult": true,
        "matchPhrase": " "
    },
    "widget:Název widgetu": {
        "datasource": "datasource:office365-email-aggregated",
        "title": "Název widgetu",
        "type": "BarChart",
        "xaxis": "@timestamp",
        "yaxis": " ",
        "ylabel": " ",
        "table": true,
        "layout:w": 6,
        "layout:h": 4,
        "layout:x": 0,
        "layout:y": 0,
        "layout:moved": false,
        "layout:static": true,
        "layout:isResizable": false
    },
Koláčové grafy
Koláčový graf je kruh rozdělený na plátky, přičemž každý plátek představuje procento celku.
Příklad JSON pro koláčový graf:
    "datasource:office365-email-status": { #(1)
        "datetimeField": "@timestamp", #(2)
        "groupBy": "o365.message.status", #(3)
        "matchPhrase": "event.dataset:microsoft-office-365 AND event.action:MessageTrace", #(4)
        "specification": "lmio-{{ tenant }}-events*", #(5)
        "type": "elasticsearch", #(6)
        "size": 20 #(7)
    },
    "widget:office365-email-status": { #(8)
        "datasource": "datasource:office365-email-status", #(9)
        "title": "Stav přijatých e-mailů", #(10)
        "type": "PieChart", #(11)
        "tooltip": true, #(12)
        "table": true, #(13)
        "layout:w": 6, #(14)
        "layout:h": 4,
        "layout:x": 6,
        "layout:y": 0,
        "layout:moved": false,
        "layout:static": true,
        "layout:isResizable": false
    },
datasourceoznačuje začátek sekce datového zdroje a také název datového zdroje. Název neovlivňuje funkci dashboardu, ale musíte na něj správně odkazovat v sekci widgetu.- Indikuje, které pole v logech je polem s datem a časem. Například v logech Elasticsearch, které jsou parsovány Elastic Common Schema (ECS), je pole s datem a časem
@timestamp. - Pole, jehož hodnoty budou reprezentovat každý "plátek" koláčového grafu. V tomto příkladu koláčový graf oddělí logy podle jejich stavu zprávy. Bude existovat samostatný plátek pro každý z Odeslaných, Rozšířených, Karanténních atd., aby ukázal procentuální výskyt každého stavu zprávy.
- Dotaz, který filtruje konkrétní logy. V tomto případě budou zobrazeny pouze data z logů z datasetu Microsoft Office 365 s hodnotou
MessageTracev polievent.action. - Odkazuje na index, ze kterého se načítají data v Elasticsearch. Hodnota
lmio-{{ tenant}}-events*odpovídá našim názvovým konvencím indexů v Elasticsearch a{{ tenant }}je místo pro aktivního tenanta. Hvězdička*umožňuje neupřesněné další znaky v názvu indexu zaevents. Výsledek: Widget zobrazuje data z aktivního tenanta. - Typ datového zdroje. Pokud používáte Elasticsearch, hodnota je
"elasticsearch" - Kolik hodnot chcete zobrazit. Protože tento koláčový graf zobrazuje stavy přijatých e-mailů, hodnota
size20 zobrazuje nejlepších 20 typů stavů. (Koláčový graf může mít maximálně 20 plátků.) widgetoznačuje začátek sekce widgetu a také název widgetu. Název neovlivňuje funkci dashboardu.- Odkazuje na sekci datového zdroje výše, která ji naplňuje. Ujistěte se, že hodnota zde přesně odpovídá názvu příslušného datového zdroje. (Tímto se widget dozví, odkud získá data.)
- Název widgetu, který se bude zobrazovat v dashboardu
- Typ widgetu
- Pokud je
tooltipnastaven natrue: Když najedete myší na každý plátek koláčového grafu v dashboardu, malý informační okno s počtem hodnot v plátku se zobrazí u vašeho kurzoru. Pokud jetooltipnastaven nafalse: Počítací okno se objeví v levém horním rohu widgetu. - Nastavení
tablenatruevám umožňuje přepínat mezi zobrazením grafu a zobrazením tabulky na widgetu v dashboardu. Výběrfalsezakáže funkci přepínání mezi grafem a tabulkou. - Viz poznámka výše o umístění widgetů pro informace o rozvrhových řádcích.
**Widget koláč
Jak vytvořit vlastní geolokační zóny
LogMan.io umožňuje analytikům obohatit události o vlastní geolokační data pomocí vyhledávání založeného na IP rozsahu. To je užitečné pro označování interních zón, poboček nebo geografických oblastí definovaných zákazníkem.
Pro whitelisty, blacklisty a obecné použití lookupů v predikátech detekcí viz Lookups v detekcích. Pro obohacení vlastníka sítě na IP (číslo ASN a organizace) viz ASN obohacení.
Vytvoření geolokačního vyhledávání
Přejděte do sekce LogMan.io → Vyhledávání a vytvořte nové vyhledávání.
- Skupina:
geo - Klíč: Pár IP adres:
startaend, definující kontinuální IP rozsah. - Pole (volitelné, ale doporučené):
name: "Křivoklát LAN"
country_iso_code: "CZ"
region_name: "Středočeský kraj"
city_name: "Křivoklát"
location: [50.036, 13.877]  # zeměpisná šířka, zeměpisná délka
Tato pole jsou založena na Elastic Common Schema (ECS) pro kompatibilitu s obohacením Parsec.
Příklad položky
| Start IP | End IP | name | country_iso_code | city_name | location |
|---|---|---|---|---|---|
| 192.168.108.122 | 192.168.108.124 | HQ Office LAN | CZ | Praha | 50°5.28' N, 14°25.2' E |
| 10.10.0.1 | 10.10.0.254 | Remote Branch #1 | CZ | Brno | 49°11.7' N, 16°36.54' E |
Uložte vyhledávání pod jedinečným názvem, například hq_locations.
Podporovaná pole
| Pole | Typ | Popis |
|---|---|---|
name |
string | Popisný název zóny |
country_iso_code |
string | ISO 3166-1 alpha-2 kód země |
region_name |
string | Název regionu nebo provincie |
city_name |
string | Název města nebo oblasti |
location |
geopoint | GPS souřadnice |
Použití
Automatické obohacení
Když je skupina vyhledávání nastavena na geo, data jsou automaticky používána LogMan.io Parsec pro obohacení polí jako source.ip, destination.ip, client.ip atd.
Příklad výstupu po obohacení:
{
  "source.ip": "192.168.108.123",
  "source.geo": {
    "name": "HQ Office LAN",
    "country_iso_code": "CZ",
    "city_name": "Praha",
    "location": [50.088, 14.420]
  }
}
Použití v korelátoru
Vlastní geolokační vyhledávání může být odkazováno v pravidlech Korelátoru pro filtrování nebo logiku založenou na zónách.
Příklad: Upozornění na přihlášení z neinterní IP
predicate:
  !NOT:
  what:
    !IN
    what: !ITEM EVENT source.ip
    where:
      !LOOKUP
      what: hq_locations
Příklad: Shoda s více geozónami
predicate:
  !OR:
  - !IN
    what: !ITEM EVENT client.ip
    where: !LOOKUP { what: hq_locations }
  - !IN
    what: !ITEM EVENT destination.ip
    where: !LOOKUP { what: remote_sites }
Tipy a nejlepší praktiky
- Zajistěte, aby se rozsahy nepřekrývaly, aby se předešlo nejednoznačnosti.
- Používejte konzistentní a popisné názvy pro snadnější filtrování na dashboardu.
- Poskytněte
location, aby bylo možné provádět geospatial vizualizace. - Pro připojení hotové MaxMind databáze
.mmdb(s vlastním mapováním) viz Vlastní MaxMind enricher.
Řešení problémů
Obohacení nefunguje?
- Ověřte, že skupina vyhledávání je
geo. - Potvrďte, že IP je v definovaném rozsahu
start-end. - Použijte funkci
Test Lookupv uživatelském rozhraní pro simulaci vyhledávání.
Více překrývajících se shod?
- Vyhněte se překrývání; první shoda obvykle vyhrává.
ASN obohacení
ASN obohacení přidává k IP adresám na události číslo autonomního systému (as.number). Toto číslo identifikuje, kterému autonomnímu systému (síti) IP v datech veřejného směrování patří.
Běží automaticky pro parsery, které zahrnují výchozí enrichery z common library. Rozsahy ASN v UI Lookups neudržujete; vestavěná veřejná databáze DB-IP ASN se aplikuje přes lookup skupinu asn.
ASN enricher zapisuje pouze *.as.number (a related.as.number, když se agregují související IP). Země, město, souřadnice a další polohová pole přicházejí z odděleného geo enricheru, ne z ASN.
K čemu slouží
Analytici používají as.number k:
- Identifikaci autonomního systému IP (např.
13238) a pivotování vyšetřování na danou síť. - Filtrování a seskupování událostí v Discover podle ASN vedle geo polí z geo enricheru.
- Tvorbě detekcí závislých na neočekávaných ASN (ASN popisuje vlastnictví směrování; geo popisuje polohu).
- Korelaci skenů, C2 nebo neobvyklého egressu, když několik IP sdílí stejné ASN.
Kontext polohy (země, město, region) stále přichází z geo obohacení na stejné události.
Jak to funguje
V common library je výchozí IP ASN enricher:
Parsers/Default/Enrichers/ip_asn.yaml
define:
  type: parsec/enricher/ip
  group: asn

schema:
  /Schemas/ECS.yaml:
    postfix: as.

  /Schemas/CEF.yaml:
    section: as
Co to znamená:
group: asnnačte ASN IP rozsahová data z/lookups/asn/(soubory*.iprvytvořené IP address processor).- S ECS mapuje
postfix: as.atribut lookupunumberna pole jakosource.as.number,destination.as.numberneboclient.as.numberpodle toho, které IP pole bylo vyřešeno. - Vestavěná deklarace je
Lookups/public-dbip-asn-num.yaml(group: asn, global). V UI není uvedena jako běžný editovatelný lookup; platforma ji připraví pro Parsec.
Pole přidaná ASN enricherem:
| Pole události | Význam |
|---|---|
source.as.number / destination.as.number / … |
ASN pro IP dané entity |
related.as.number |
Agregovaný seznam ASN ze souvisejících IP na události |
Geolokační pole jako source.geo.country_iso_code, destination.geo.city_name nebo related.geo.location vyplňuje Parsers/Default/Enrichers/ip_geo.yaml (group: geo), ne ASN enricher.
Pouze IP, které odpovídají ASN databázi, dostanou as.number. Soukromé nebo nemapované adresy mohou stále dostat geo data a pole ASN nemusí mít.
Příklad události
Po parsování FortiGate traffic logu může obohacení produkovat pole jako (výňatek):
{
  "source.ip": "2a02:6b8:b010:9020::1:abcd",
  "destination.ip": "15.40.71.82",
  "source.as.number": 13238,
  "related.as.number": [13238],
  "source.geo.country_iso_code": "RU",
  "destination.geo.country_iso_code": "US",
  "destination.geo.city_name": "Palo Alto"
}
source.as.number/related.as.number: z ASN enricheru.*.geo.*: z geo enricheru.
V tomto vzorku pouze zdrojová IP dostala ASN shodu; cíl může vynechat destination.as.number, pokud se neuplatní záznam ASN.
V Discover můžete hledat například:
source.as.number:13238
nebo:
related.as.number:13238
Použití ASN v detekcích
Chovejte se ke as.number jako k libovolnému poli události v predikátech. Příklad: alert, když provoz zahrnuje konkrétní ASN:
predicate:
  !AND
  - !IN
    what: source.as.number
    where: !EVENT
  - !EQ
    - !ITEM EVENT source.as.number
    - 13238
Pro seznamy povolených/zakázaných ASN vložte čísla do lookupu a testujte členství pomocí !IN / !LOOKUP (viz Lookups v detekcích).
Tipy
- ASN obohacení závisí na veřejných směrovacích datech. Hodnoty mohou zaostávat za přečíslováním nebo se měnit v čase.
- Pro přesné filtry používejte
as.number. Od ASN enricheru neočekávejte atributy organizace nebo geo; pro polohu použijte geo obohacení. - Pokud na veřejných IP chybí
as.number, zkontrolujte, že parser zahrnuje výchozí enrichery a že pod/lookups/asn/jsou ASN lookup soubory (zeptejte se administrátora). - Vlastní MaxMind nebo geo zóny z UI nenahrazují ASN; pro polohová data použijte Geolokační vyhledávání a Vlastní MaxMind enricher.
Související
- Geolokační vyhledávání: vlastní IP rozsahové zóny
- Vlastní MaxMind enricher: připojení vlastního
.mmdb - Deklarace enricherů: další typy enricherů
- Lookups v detekcích: použití obohacených polí v pravidlech
- IP address lookups: typy IP rozsahových lookupů v Referenci
Připojení vlastní MaxMind databáze
Pro vlastní zóny už používáte geo lookups (viz Geolokační vyhledávání). Pokud máte soubor MaxMind DB (.mmdb) s vlastními sloupci, můžete obohacovat IP pole stejným způsobem: umístěte soubor tam, kde ho Parsec najde, a přidejte krátkou deklaraci enricheru.
Pokud si nejste jisti, kde se soubory na serveru ukládají, zeptejte se administrátora. Parsery znovu sestavovat v kódu nemusíte.
Co potřebujete
- Soubor
.mmdb(GeoLite, GeoIP nebo vlastní MaxMind DB s vašimi atributy). - Název skupiny pro složku (často
geo, stejně jako veřejné geo obohacení). - Atributy z DB, které chcete na události (např. název města nebo vlastní skóre).
- Odpovídající pole ve schématu události (obvykle ECS), aby je Discover a dashboardy mohly ukládat.
1. Umístění databázového souboru
Zkopírujte .mmdb do složky lookups pro vaši skupinu, například:
/lookups/geo/my-custom.mmdb
Použijte stejný název skupiny v enricheru níže. Složky specifické pro tenant jsou možné; layout potvrdí administrátor.
2. Přidání deklarace enricheru
V Knihovně pod cestou parseru pro zdroj logů (vedle ostatních enricherů) přidejte YAML soubor, například 55_enricher_maxmind.yaml:
define:
  type: enricher/ip
  group: geo

schema:
  /Schemas/ECS.yaml:
    mapping:
      city_name: "{entity}.geo.city_name"
      country.iso_code: "{entity}.geo.country_iso_code"
V praxi to znamená:
group: geonačte každý.mmdb(a další geo lookup soubory) ze složkygeo.mappingříká: vezmi tento atribut z databáze a zapiš ho do tohoto pole na události.{entity}se nahradí zasource,destination,clienta podobně podle toho, které IP pole bylo vyhledáno.
Příklad: pro source.ip se city_name stane source.geo.city_name.
Volitelné: jednoduché pojmenování bez tabulky mapování
Pokud názvy atributů v databázi už odpovídají ECS příponě (např. city_name → source.geo.city_name), můžete použít postfix místo výčtu každého pole:
define:
  type: enricher/ip
  group: geo

schema:
  /Schemas/ECS.yaml:
    postfix: geo.
Použijte mapping, když se názvy liší nebo chcete plnou kontrolu. Použijte postfix, když názvy už sedí.
3. Pole schématu události
Ujistěte se, že cílová pole existují ve vašem schématu (Knihovna → Schemas), například:
source.geo.city_namesource.geo.country_iso_codedestination.geo.city_name- a libovolná vlastní pole, která mapujete
Pokud pole ve schématu chybí, obohacení pro daný atribut se přeskočí.
4. Kontrola výsledku
- Uložte enricher a počkejte na reload Parsec (nebo požádejte provoz o reload parseru).
- Pošlete nebo počkejte na událost s
source.ip(nebo jiným IP polem) pokrytým vaší databází. - V Discover otevřete událost a hledejte nová pole
*.geo.*(nebo vaše mapovaná pole).
Tipy
- Začněte s jedním nebo dvěma mapovanými atributy, pak přidávejte další.
- Vlastní data držte ve stejné skupině
geojen pokud to chcete; jinak použijte jiný název skupiny a stejnou skupinu v enricheru. - Prázdné hodnoty z databáze se na událost nezapisují.
- Pro rozsahy IP, které sami spravujete v UI (zóny, pobočky), používejte Geolokační vyhledávání. Soubory MaxMind jsou pro hotové nebo dodavatelské databáze.
Související
- Geolokační vyhledávání: vlastní IP rozsahové zóny v UI Lookups
- ASN obohacení: číslo autonomního systému a organizace na IP polích
- Deklarace enricherů: další typy enricherů
- Lookups v detekcích: použití obohacených polí v pravidlech
Lookupy v detekcích
Lookupy jsou seznamy (a tabulky klíč/hodnota), které detekční pravidla používají k rozhodnutí, zda má událost vyvolat alert. Jako analytik hlavně udržujete obsah lookupů a odkazujete na ně v predikátech, aby pravidla zůstala přesná bez hard-codování uživatelských jmen, IP nebo portů v YAML.
Typické použití:
- Whitelisty: potlačení známé dobré aktivity (skenery, jump hosty, povolené segmenty, cloudové rozsahy dodavatelů jako Microsoft 365).
- Blacklisty / watchlisty: zaměření na známě špatné nebo zajímavé entity (Tor exit nodes, ransom rozšíření, break-glass účty).
- Inventářní seznamy: označení, kdo nebo co je v rozsahu (admini, servisní účty, privilegované skupiny, interní zóny).
Pro deklarace lookupů, typy a nasazení viz reference Lookups. Pro správu položek v UI viz Uživatelský manuál: Lookups. Vlastní geolokační zóny pokrývá Geolokační vyhledávání. Připojení MaxMind .mmdb viz Vlastní MaxMind enricher. Plnění IOC lookupů z externích zdrojů viz Threat intelligence feedy. Plnění usernames2userid z Active Directory viz LDAP / AD feed identity uživatelů.
Jak se lookupy objevují v pravidlech
V korelačních predikátech se lookup téměř vždy používá jako test členství: je hodnota pole klíčem v lookupu?
Shoda, když je hodnota v lookupu (!IN + !LOOKUP)
Pro watchlisty a seznamy „v rozsahu“ (admini, IoC, neobvyklé porty):
predicate:
  !AND
  - !IN
    what: user.name
    where: !EVENT
  - !IN
    what: !ITEM EVENT user.name
    where:
      !LOOKUP
      what: admins
Tento vzor je běžný v common library (např. Administrator Logon Outside Business Hours, Break Glass Account Used, Traffic from Tor Exit Nodes).
Vyloučení, když je hodnota v lookupu (whitelist)
Obalte test členství do !NOT, aby uvedené entity nespouštěly alert:
predicate:
  !AND
  - !IN
    what: source.ip
    where: !EVENT
  - !NOT
    what:
      !IN
      what: !ITEM EVENT source.ip
      where:
        !LOOKUP
        what: excludedipaddresses
Pravidla network sweep / port sweep používají excludedipaddresses tak, aby skenery a monitorovací hosty nevyvolaly false positives.
Use case: vyloučení rozsahů IP Microsoft 365 (nebo jiných)
Cíl: detekce nemá alertovat, když destination.ip (nebo source.ip) spadá do publikovaných rozsahů služeb Microsoft 365 / Office 365, ale stále alertuje na jiné cíle.
1. Lookup typu IP rozsah
Ano: uložte rozsahy do lookupu typu lookup/ipaddressrange (dva IP klíče: začátek a konec rozsahu). Jednoduchý IP lookup (lookup/ipaddress) je pro CIDR nebo start/end bloky špatně.
Příklad deklarace (Knihovna /Lookups/):
---
define:
  type: lookup/ipaddressrange
  name: m365ipranges
  label: Microsoft 365 IP ranges
  description_title: Published Microsoft 365 service IP ranges used as detection exceptions

keys:
  - name: start
    type: ip
  - name: end
    type: ip

fields:
  name:
    type: str
Vytvořte lookup v UI se stejným názvem a přidejte položky jako páry start/end (z publikovaného seznamu IP Microsoftu). Volitelné name může označit produkt nebo oblast služby.
Detaily typu: IP address range lookup.
2. Výjimka v pravidle: IP není v lookupu
Stejný whitelist vzor: !NOT kolem !IN + !LOOKUP. Příklad pro destination:
predicate:
  !AND
  # … další podmínky detekce …
  - !IN
    what: destination.ip
    where: !EVENT
  - !NOT
    what:
      !IN
      what: !ITEM EVENT destination.ip
      where:
        !LOOKUP
        what: m365ipranges
Pro source.ip změňte názvy polí stejným způsobem. Zkratka:
- !NOT
  what:
    !LOOKUP.CONTAINS
    what: !ITEM EVENT destination.ip
    in: m365ipranges
Členství proti IP rozsahovému lookupu uspěje, když IP události leží uvnitř uloženého rozsahu start/end (CIDR v predikátu sami nerozepisujete).
3. Aktuální rozsahy (volitelné feedy)
- Ručně / CSV: vložte nebo importujte rozsahy do lookupu, když Microsoft seznam aktualizuje.
- Feed: pokud z API získáte prefixy jako CIDR (nebo podobně), feed může rozsahový lookup automaticky obnovovat. Viz příklad Netbox prefixů: Threat intelligence feedy: Netbox prefixy.
Stejný vzor funguje pro libovolného dodavatele nebo povolenou sadu subnetů (Azure, AWS, partnerské sítě), nejen Microsoft 365.
Zkratka: !LOOKUP.CONTAINS
Některá pravidla používají !LOOKUP.CONTAINS místo !IN s where: !LOOKUP. Chování je stejné: test, zda je hodnota v pojmenovaném lookupu.
# Alert jen pokud uživatel NENÍ na autorizovaném sudo seznamu
- !NOT
  what:
    !LOOKUP.CONTAINS
    what: !ITEM EVENT user.name
    in: sudousers
# Alert pokud cíl je známý DB server A zdroj není povolen
- !LOOKUP.CONTAINS
  what: !ITEM EVENT destination.ip
  in: databaseservers
- !NOT
  what:
    !LOOKUP.CONTAINS
    what: !ITEM EVENT source.ip
    in: alloweddbsegments
Cast při rozdílných typech klíčů
Klíče lookupu mají deklarovaný typ (str, ip atd.). Pokud je pole události číslo (např. port) a lookup ukládá řetězce, před kontrolou použijte cast:
- !IN
  what:
    !CAST
    what: !ITEM EVENT destination.port
    type: str
  where:
    !LOOKUP
    what: unusualports
Složené klíče (!TUPLE)
Lookupy s více klíči (např. země + datum v holidays) potřebují !TUPLE ve stejném pořadí jako deklarace. Viz Použití složeného klíče v pravidlech.
Whitelisty vs blacklisty
Neexistuje samostatný typ lookupu „whitelist“ nebo „blacklist“. Role vychází z toho, jak pravidlo seznam používá:
| Role | Myšlenka predikátu | Příklady z knihovny |
|---|---|---|
| Whitelist (povolit / ignorovat) | !NOT + členství v lookupu |
excludedipaddresses, sudousers, alloweddbsegments, safecountries, vlastní IP rozsahy (např. m365ipranges) |
| Blacklist / watchlist (alert při přítomnosti) | členství v lookupu | torexitnodes, vpnexitnodes, ransomwareextensions, breakglassaccounts, maliciousipaddresses |
| Rozsah / inventář | členství definuje koho pravidlo zajímá | admins, serviceaccounts, admingroups, zones |
V jednom pravidle můžete kombinovat obojí. Suspicious Connection vyžaduje source.ip v zones a destination.ip mimo zones (provoz opouštějící interní rozsahy).
Praktické tipy
- Při změně množiny uživatelů nebo IP upravujte položky lookupu v UI spíš než pravidlo.
- Udržujte whitelist klíče přesné; chybějící záznam často znamená šum, navíc záznam může skrýt skutečné detekce.
- Slaďte hodnoty klíčů s testovaným polem události (
user.namevsuser.id, ISO kódy zemí, tečkované IP). - Pro IP rozsahy a privátní geografii používejte IP/geo lookupy. Viz Geolokační vyhledávání a IP address lookups.
Běžné lookupy v detekčních pravidlech
Tyto názvy se často objevují v TeskaLabs common correlation library. Naplňte je pro tenant, aby dodávaná pravidla fungovala podle očekávání.
| Lookup | Typická role | Použití |
|---|---|---|
admins |
Rozsah | Pravidla pro admin autentizaci a privilegia |
breakglassaccounts |
Watchlist | Použití emergency / break-glass účtů |
serviceaccounts |
Rozsah / watchlist | Interaktivní nebo neobvyklé použití servisních účtů |
defaultaccounts |
Watchlist | Aktivita vestavěných / výchozích účtů |
disabledaccounts |
Stavový seznam | Neúspěšná přihlášení na disabled účty (některá pravidla také aktualizují) |
sudousers |
Whitelist | Autorizovaní sudo uživatelé (alert, když není v seznamu) |
excludedipaddresses |
Whitelist | IP vyloučené ze sweep / scan detekcí |
zones |
Inventář / geo | Interní IP rozsahy; firewall pravidla překračující zóny |
safecountries |
Whitelist | Očekávané ISO kódy zemí pro přihlášení |
holidays |
Whitelist / kalendář | Složené klíče (např. země + datum) pro logiku mimo pracovní dobu |
unusualports |
Watchlist | Nestandardní porty |
torexitnodes / vpnexitnodes |
Blacklist | Provoz se známými exit nodes |
ransomwareextensions |
Blacklist | Ransomware související přípony souborů |
domainprivilegedgroups / admingroups / privilegedlocalgroups / monitoredgroups |
Rozsah | Detekce změn členství ve skupinách |
criticalservices |
Rozsah | Zastavení / změna kritických služeb |
activevpnusers |
Stavový seznam | Kdo je aktuálně na VPN (zapisují VPN login/logout pravidla) |
Deklarace těchto lookupů jsou pod /Lookups v knihovně. Mnoho se vytvoří automaticky (default: true) s malou sadou default_items; nahraďte nebo rozšiřte pro své prostředí.
Aktualizace lookupů z detekcí
Pravidla mohou při spuštění zapisovat obsah lookupu pomocí lookup trigger:
trigger:
  - lookup: activevpnusers
    key: !ITEM EVENT user.name
  - lookup: activevpnusers
    delete: !ITEM EVENT user.name
Příklady v knihovně:
- VPN login / logout udržují
activevpnusers. - Disable / enable účtu udržují
disabledaccounts. - Start / dokončení scheduled task udržují
scheduledtasks(složený klíč s!TUPLE).
Používejte pro krátkodobý stav, který konzumují jiná pravidla. Pro dlouhodobé allow/deny seznamy, které vlastní analytici, preferujte UI Lookups (nebo CSV import) místo kódování seznamu v pravidle.
Testování pravidel s lookupy
Při validaci detekčního pravidla v Knihovně nebo s correlator builderem predikáty volající lookupy (!LOOKUP.CONTAINS, !IN s !LOOKUP atd.) potřebují v čase testu data lookupu. Nemusíte plnit produkční lookup soubory ani spoléhat na ZooKeeper pro offline testy pravidel.
Přidejte blok lookups do každého pojmenovaného případu pod top-level sekcí test pravidla. Deklarace lookupu musí už existovat v Knihovně pod /Lookups/ (název, typy klíčů, pole). Testovací případ dodá jen řádky pro daný běh.
test:
  alice_is_allowed:
    lookups:
      allowed_events:
        alice:
          reason: whitelisted
        bob:
          reason: blocked

    input:
      - user.name: alice
        "@timestamp": 142446461673537536
        tenant: default
        _id: 1

    output:
      tenant: default
      # … očekávaný complex / trigger výstup …
| Část | Význam |
|---|---|
Název lookupu na top level (allowed_events) |
Název lookupu bez přípony tenantu |
Vnitřní klíč (alice) |
Klíč záznamu lookupu |
| Vnitřní hodnota | Pole záznamu podle deklarace v /Lookups/ |
Pro složené klíče použijte seznam záznamů s explicitním _id ve stejném pořadí jako klíče deklarace:
lookups:
  UserList:
    - _id: [tenant1, alice]
      role: admin
Poznámky k chování:
- Pokud testovací případ nedefinuje
lookups, synchronní lookupy se načtou z produkční cesty builderu (lookup.base_path, typicky/lookups). Použijte, když chcete otestovat reálná data tenantu. - Pokud jakýkoli případ v pravidle definuje
lookups, builder použije pro ty testy dočasnou složku lookupů. - Podporované pro seed testů: generické lookupy s
keysafields(stejná struktura jako lookup builder služba). - Nepodporované v seed testů:
lookup/ipaddressrangealookup/macaddressrange(použijte produkční lookup soubory nebo mockujte predikát jinak). - Lookup triggery (
- lookup:podtrigger:) jsou při testech pravidel stále mockované: zápisy se logují, ale neaplikují na seedovaný lookup pro další události v tomže případu.
Pro úplnou strukturu sekce test (input, output, časové značky, _id) viz Test (volitelné, pro validaci pravidla).
Související čtení
- Predikáty: stavba SP-Lang filtrů
- Triggery: akce událostí a notifikací (lookup triggery detailně v Referenci)
- Co je detekce?
- Reference Lookups: typy, deklarace, buildery
- Lookup trigger:
set/delete/add/sub - Threat intelligence feedy: feedy plnící IOC lookupy
Threat intelligence feedy
Threat intelligence feedy udržují lookupy naplněné aktuálními indikátory kompromitace (IOC): IP adresy, domény, URL, hashe a podobné hodnoty. Jako analytik obvykle zvolíte, který feed plní který lookup, a pak lookup použijete v detekcích (volitelně v hodnocení rizika), aby pravidla zůstala aktuální bez hard-codování seznamů indikátorů v YAML.
Typické použití:
- Watchlisty: alert při provozu nebo DNS zásahu známé špatné IP nebo domény.
- Risk boost: zvýšení
event.risk_score, když dimenze okna sedí na řádek IOC. - Sdílený intel: jeden udržovaný seznam pro mnoho korelačních pravidel.
Testy členství a vzory whitelist / blacklist v predikátech: Lookupy v detekcích. Jak řádky IOC mění numerické riziko: Hodnocení rizika. Typy a deklarace lookupů: reference Lookups.
Jak se feedy propojují s detekcemi
Cesta je vždy stejná:
- Deklarace feedu v Knihovně (
/Feeds/…) stahuje data podle plánu (HTTP JSON, CSV, MISP, LDAP a podobné zdroje). - Feed zapisuje položky do pojmenovaného lookupu (
output.lookup). - Detekce (nebo hodnocení rizika) čte lookup pomocí
!LOOKUP/!LOOKUP.CONTAINS, nebo přes skupinu lookupůioc.
External source (TI API, MISP, LDAP, …) → Feed (lmio-feeds) → Lookup items → Correlator / enricher / risk score
Feed můžete připojit i z UI Lookups (feedPath). Runtime efekt je stejný: obsah lookupu se obnovuje z feedu.
Kdo za co zodpovídá
Analytici udržují které indikátory záleží (obsah lookupu a cíle feedů). Detection engineeri drží propojení predikátů stabilní. Při růstu sady indikátorů preferujte změnu feedu / lookupu místo úpravy YAML pravidla.
Předpoklady
- Je nasazena služba LogMan.io Feeds (běží deklarace feedů).
- Existuje deklarace lookupu pod
/Lookups(mnoho IOC lookupů je v common library sdefault: true). output.lookupfeedu sedí nadefine.namelookupu (tenant suffix řeší platforma).- Typy klíčů sedí: IP feedy →
lookup/ipaddress(nebo IP rozsah); domény → string klíče; atd.
Dodávané IOC lookupy zahrnují:
| Lookup | Typický klíč | Skupina | Použití |
|---|---|---|---|
maliciousipaddresses |
IP | ioc |
Špatné source / destination IP |
maliciousdomains |
doména | ioc |
DNS a HTTP hostnames |
maliciousurls |
URL | (různé) | Shoda celé URL |
malicioushashes |
hash souboru | (různé) | Soubory / malware hashe |
torexitnodes / vpnexitnodes |
IP | (žádná) | Exit nodes anonymizérů |
Dejte lookup do skupiny ioc, když chcete, aby Correlator risk scoring automaticky přidal skóre za shodné dimenze okna. Viz IOC a threat intelligence.
Příklad: feed plnící lookup špatných IP
Minimální feed čtoucí JSON seznam IP objektů a aktualizující maliciousipaddresses.
Příklad odpovědi z GET /api/v1/ips (fiktivní TI API, zkráceno). Feed iteruje results:
{
  "count": 2,
  "results": [
    {
      "ip": "203.0.113.66",
      "risk.score": 25.0,
      "tags": ["botnet", "scanner"]
    },
    {
      "ip": "198.51.100.14",
      "risk.score": 40.0,
      "tags": ["c2"]
    }
  ]
}
Mapování ve feedu níže:
iterate: results→ jedna položka lookupu na objektkey: !ITEM EVENT ip→203.0.113.66a198.51.100.14se stanou klíči vmaliciousipaddressesrisk.scorese uloží na položku pro hodnocení rizika; pokud chybí, feed defaultuje na25.0- extra pole jako
tagsse ignorují, pokud je nepřidáte doschema/apply
---
define:
  name: Malicious IP Feed
  type: lmio/feed

  schema:
    ip: str
    risk.score: fp64

input:
  source: https://ti.example.com/api/v1/ips
  type: json
  iterate: results
  period: 1h
  headers: '{"Authorization": "Bearer {{TI_API_TOKEN}}"}'
  verify: none

apply:
  key: !ITEM EVENT ip
  risk.score:
    !TRY
    - !ITEM EVENT risk.score
    - 25.0

output:
  lookup: maliciousipaddresses
Poznámky:
periodřídí, jak často se feed obnovuje (např.1h,1d).keyje klíč lookupu; extra pole (např.risk.score) jsou atributy pro risk scoring.- Upravte URL, hlavičky a cestu
iteratepodle JSON vašeho TI providera. - V hlavičkách preferujte Vault placeholdery (např.
Bearer {{TI_API_TOKEN}}), aby tokeny nebyly ve sdíleném YAML Knihovny. Viz Vault placeholder pro heslo (Feedsv26.12.07+, LogMan.iov26.12.12). - Pro API s
nextURL na stránku použijte paginaci (subtype: pagination,pagination_mode: url). Zeptejte administrátora na zapojení.
Po běhu feedu otevřete Lookups → maliciousipaddresses a ověřte nové IP.
Příklad: CSV feed (včetně souborů bez hlavičky)
Mnoho TI a inventářních seznamů přichází jako CSV. Na input feedu použijte type: csv. Ve výchozím nastavení je první řádek hlavička a názvy sloupců se stanou poli události pro apply.
---
define:
  name: Malicious Domains CSV Feed
  type: lmio/feed

  schema:
    domain: str
    risk.score: fp64

input:
  source: https://ti.example.com/lists/malicious-domains.csv
  type: csv
  delimiter: ","
  period: 1d
  verify: none

apply:
  key: !ITEM EVENT domain
  risk.score:
    !TRY
    - !ITEM EVENT risk.score
    - 20.0

output:
  lookup: maliciousdomains
CSV bez hlavičky
Pokud soubor nemá řádek hlavičky, nastavte fieldnames na názvy sloupců v pořadí. První datový řádek se pak čte jako hodnoty, ne jako hlavičky.
input:
  source: ./data/dbip-asn-ipv4-num.csv
  type: csv
  delimiter: ","
  fieldnames:
    - start_ip
    - end_ip
    - number
    - organization.name
  period: 1d
Poznámky:
fieldnamesfunguje pro CSV ze souboru, HTTP a OAuth2.- Můžete předat i řetězec oddělený čárkami, např.
fieldnames: "start_ip,end_ip,number". - Při vytváření feedu z UI Lookups / API šablony použijte stejný seznam jako
csvFieldnames. headerspodinputjsou HTTP hlavičky požadavku, ne názvy sloupců CSV.
Po běhu feedu otevřete cílový lookup a ověřte, že klíče sedí se sloupci v fieldnames / hlavičce CSV.
Příklad: MISP feed
MISP (Malware Information Sharing Platform) ukládá a sdílí threat indikátory jako atributy (IP, domény, hashe, URL atd.). LogMan.io Feeds může na plán stahovat vybrané typy atributů z instance MISP a zapisovat je do IOC lookupu.
Feed vytvoříte dvěma způsoby:
- UI Lookups — otevřete cílový lookup, přidejte feed, zvolte šablonu MISP (
mispLines) a vyplňte formulář (MISP URL, API klíč, typy atributů, period). UI zapíše stejné YAML Knihovny jako níže. - YAML Knihovny — deklarace feedu pod
/Feeds/(příklad níže).
Co potřebujete
| Pole | Povinné | Příklad | Význam |
|---|---|---|---|
source |
ano | https://misp.example.com |
Base URL instance MISP. Feeds ji použije jako PyMISP connection URL. |
type |
ano | misp |
Musí být misp, aby LogMan.io Feeds použil MISP zdroj. |
api_key |
ano | "{{MISP_API_KEY}}" |
MISP Auth klíč (Automation key). Preferujte Vault placeholder; viz Vault placeholder pro heslo. Ve formuláři UI je to API key (apiKey). |
types |
ano | ip-dst nebo ip-dst,ip-src |
Čárkou oddělené MISP typy atributů. Výchozí při vynechání v UI je ip-dst. Ve formuláři MISP types (mispTypes). |
period |
ano | 1h |
Jak často Feeds znovu dotazuje MISP (např. 1h, 1d). |
Také potřeba:
- LogMan.io Feeds dosáhne na MISP host (HTTPS, firewall / DNS).
- Lookup, jehož typ klíče sedí na atributy, které taháte (IP →
maliciousipaddresses/lookup/ipaddress; domény →maliciousdomains; hashe →malicioushashes; atd.). - MISP uživatel s Auth klíčem, který může hledat atributy zvolených typů.
Příklad: destination IP do maliciousipaddresses
---
define:
  name: MISP malicious IPs
  type: lmio/feed

  schema:
    value: str

input:
  source: https://misp.example.com
  type: misp
  period: 1h
  api_key: "{{MISP_API_KEY}}"
  types: ip-dst

apply:
  key:
    !CAST
    what: !ITEM EVENT value
    type: ip

output:
  lookup: maliciousipaddresses
Mapování:
type: misphledá MISP atributy stype_attributepodle seznamu vtypes.- Každý vrácený atribut je jedna událost; indikátor je v poli
value. apply.keycastujevaluenaippro IP lookup. Pro string lookupy (domény, hashe) použijtekey: !ITEM EVENT valuebez IP castu — UI šablona cast vybere podle typu klíče lookupu.api_key: "{{MISP_API_KEY}}"se rozbalí z Feeds[passwords](Vault přes Maestro). Mapujte tajemství v/Site/model.yamlstejně jako ostatní feed secrets:
services:
  lmio-feeds:
    asab:
      config:
        passwords:
          MISP_API_KEY: "{{MISP_API_KEY}}"

secrets:
  MISP_API_KEY: {}
Další typy atributů
Nasměrujte types (a output.lookup) na indikátory, které vás zajímají. Příklady:
| Cíl | types (příklady) |
Typický lookup |
|---|---|---|
| Destination / source IP | ip-dst, ip-src, nebo ip-dst,ip-src |
maliciousipaddresses |
| Domény / hostnames | domain, hostname |
maliciousdomains |
| URL | url |
maliciousurls |
| File hashe | md5, sha1, sha256 |
malicioushashes |
Čárkou oddělený seznam, když jeden feed táhne více souvisejících typů do stejného lookupu (např. types: domain,hostname). Oddělené feedy, když se liší typy klíčů (IP vs string).
Vytvoření z UI Lookups
- Otevřete Lookups a vyberte cílový lookup (např.
maliciousipaddresses). - Vytvořte / připojte feed a zvolte šablonu MISP.
- Nastavte Source na MISP base URL, API key na
"{{MISP_API_KEY}}"(nebo lab plaintext klíč), MISP types na typy atributů a Period (např.1h). - Uložte, použijte Test pokud je k dispozici, nebo počkejte jeden
perioda ověřte nové klíče v lookupu.
UI generuje YAML Knihovny ekvivalentní příkladu výše (template: mispLines). Úprava YAML v Knihovně poté je volitelná.
Po běhu feedu otevřete cílový lookup a ověřte hodnoty atributů MISP jako klíče. Pak propojte detekce jako v sekcích níže (členství / ioc risk).
Příklad: alert při provozu na IOC IP
Stejný vzor jako jiné watchlisty v Lookupy v detekcích: členství source.ip v lookupu.
predicate:
  !AND
  - !IN
    what: source.ip
    where: !EVENT
  - !IN
    what: !ITEM EVENT source.ip
    where:
      !LOOKUP
      what: maliciousipaddresses

trigger:
  - event:
      source.ip: !ITEM EVENT source.ip
      destination.ip: !ITEM EVENT destination.ip
      threat.indicator.confidence: high
      threat.indicator.ip: !ITEM EVENT source.ip
      threat.indicator.type: malicious_ip
Pravidla Knihovny jako Traffic from Tor Exit Nodes používají stejnou idea s torexitnodes místo maliciousipaddresses. Nasměrujte feed na torexitnodes (nebo držte vlastní Tor seznam) a dodávané pravidlo začne matchovat, jakmile položky přistanou v lookupu.
Zkratka
- !LOOKUP.CONTAINS
  what: !ITEM EVENT source.ip
  in: maliciousipaddresses
Příklad: špatné domény a DNS
- Feed zapisuje hostnames do
maliciousdomains(string klíče). - Pravidlo testuje
dns.question.name(nebourl.domainpodle parserů).
predicate:
  !AND
  - !IN
    what: dns.question.name
    where: !EVENT
  - !IN
    what: !ITEM EVENT dns.question.name
    where:
      !LOOKUP
      what: maliciousdomains
Slaďte klíč feedu s polem události (FQDN vs holá doména). Normalizujte v sekci apply feedu, pokud TI zdroj a DNS logy používají různé formáty.
Příklad: zvýšení rizika bez vlastního pravidla
Pokud je lookup ve skupině ioc, Correlator může přičíst risk.score z odpovídajících řádků, když dimenze okna detekce obsahují tuto hodnotu (např. source.ip nebo dns.question.name). Pro tento boost nepotřebujete samostatné pravidlo „IOC hit“.
key              risk.score
203.0.113.66     25.0
evil.example.com 20.0
Pravidlo selhání VPN se základním skóre 45, jehož source.ip sedí na první řádek, má 70 před váhou aktiva. Detaily: Hodnocení rizika.
Explicitní watchlist pravidlo (předchozí sekce) stále použijte, když chcete dedikovaný alert za každé zahlédnutí IOC, ne jen bump skóre na jiných detekcích.
Kontrolní seznam zapojení
- Lookup existuje a má správný typ (
ip, string atd.). - Volitelně:
group: iocv deklaraci lookupu pro automatické přičtení rizika. - Feed
output.lookuprovná se názvu lookupu. - Feed
key/ schema sedí na klíče lookupu; vapplycastujte typy podle potřeby. - Detekce používá
!LOOKUP/!LOOKUP.CONTAINSna stejný název, nebo spoléháte jen naiocrisk. - Po nasazení počkejte jeden
periodfeedu, ověřte položky v UI a test událost v Discover.
Praktické tipy
- Preferujte jeden feed na lookup (nebo jasnou merge strategii), aby vlastnictví bylo zřejmé.
- Držte základní severity pravidla poctivě; IOC
risk.scorea ladění pravidel použijte k prioritizaci bez přepisování predikátů. - Globální lookupy / feedy pro sdílený intel napříč tenanty; tenant-scoped pro lokální nebo zákaznické seznamy.
- Nevkládejte velké statické IOC seznamy do korelačního YAML; k tomu jsou feedy a lookupy.
- Při testu vložte jednu známou test IP nebo doménu do lookupu (UI nebo feed), pošlete syntetickou událost, pak testovací řádek odstraňte.
Pokročilý příklad: Netbox prefixy jako obohacení
Ne každý feed je klasický IOC watchlist. Stejná cesta feed → lookup může udržovat inventář aktuální a znovu ho použít v obohacení při parsování a v detekcích. Běžný případ jsou Netbox IPAM prefixy: každý prefix je CIDR s volitelným VLAN a popisem; feed ukládá do lookupu IP rozsah; Parsec pak taguje události podle source.ip.
1. IP rozsahový lookup
Deklarujte lookup se dvěma IP klíči (start, end) a atributy, které chcete na události:
---
define:
  type: lookup/ipaddressrange
  name: netbox
  label: Netbox prefixes
  description_title: Prefixes and VLANs from Netbox IPAM

keys:
  - name: start
    type: ip
  - name: end
    type: ip

fields:
  prefix:
    type: str
  description:
    type: str
  vlan.id:
    type: str
  vlan.name:
    type: str
  status:
    type: str
2. Feed stránkující Netbox a rozbalující CIDR klíče
Netbox (a podobná Django REST API) vrací absolutní URL next. Použijte pagination_mode: url. Klíč feedu je CIDR řetězec (prefix); LogMan.io Feeds ho rozbalí na start / end pro IP rozsahový lookup.
Příklad odpovědi z GET /api/ipam/prefixes/?limit=100 (zkráceno). Feed iteruje results a sleduje next, dokud není null:
{
  "count": 2,
  "next": "https://netbox.example.com/api/ipam/prefixes/?limit=100&offset=100",
  "previous": null,
  "results": [
    {
      "id": 42,
      "prefix": "10.0.112.0/22",
      "description": "Office LAN Prague",
      "status": {
        "value": "active",
        "label": "Active"
      },
      "vlan": {
        "id": 7,
        "vid": 112,
        "name": "OFFICE-PRG"
      }
    },
    {
      "id": 43,
      "prefix": "10.0.200.0/24",
      "description": "Guest WiFi",
      "status": {
        "value": "active",
        "label": "Active"
      },
      "vlan": null
    }
  ]
}
Mapování ve feedu níže:
iterate: results→ jedna položka lookupu na objekt prefixupagination_path: next→ URL druhé stránky výše; poslední stránka má"next": nullkey: !ITEM EVENT prefix→ např.10.0.112.0/22se stane rozsahem10.0.112.0…10.0.115.255- vnořené
vlan.vid/vlan.nameastatus.labelpřes vnořené!GET; když jevlannull,!TRYuloží prázdný řetězec
---
define:
  name: Netbox Prefixes Feed
  type: lmio/feed

  schema:
    prefix: str
    description: str
    vlan: "(id: si64, vid: si64, name: str)"
    status: "(value: str, label: str)"

input:
  source: https://netbox.example.com/api/ipam/prefixes/?limit=100
  type: json
  subtype: pagination
  pagination_path: next
  pagination_mode: url
  iterate: results
  period: 1d
  headers: '{"Authorization": "Bearer {{NETBOX_TOKEN}}"}'
  verify: none

apply:
  key: !ITEM EVENT prefix

  prefix:
    !CAST
    what: !ITEM EVENT prefix
    type: str

  description:
    !TRY
    - !CAST
      what: !ITEM EVENT description
      type: str
    - ""

  vlan.id:
    !TRY
    - !CAST
      what:
        !GET
        from:
          !GET
          from: !EVENT
          what: vlan
        what: vid
      type: str
    - ""

  vlan.name:
    !TRY
    - !CAST
      what:
        !GET
        from:
          !GET
          from: !EVENT
          what: vlan
        what: name
      type: str
    - ""

  status:
    !TRY
    - !CAST
      what:
        !GET
        from:
          !GET
          from: !EVENT
          what: status
        what: label
      type: str
    - ""

output:
  lookup: netbox
Vnořené Netbox objekty (vlan, status) potřebují vnořené !GET (ne ploché !ITEM EVENT vlan.vid). Chybějící VLAN řeší !TRY a prázdný řetězec. Šablona tohoto feedu je pod /Templates/Feeds/ v common library.
3. Enricher: mapování source.ip na ECS pole
Po naplnění lookupu Parsec enricher může najít rozsah obsahující source.ip a zapsat ECS pole jako source.vlan.id, source.vlan.name, source.subnet.id a network.name. Enricher dejte do parser chain po mapování, aby source.ip už existovalo.
---
define:
  type: parsec/enricher
  schema: /Schemas/ECS.yaml

enrich:
  source.vlan.id:
    !OR
    - !GET
      what: vlan.id
      from:
        !GET
        from:
          !LOOKUP
          what: netbox
        what: !ITEM EVENT source.ip
    - !ITEM EVENT source.vlan.id

  source.vlan.name:
    !OR
    - !GET
      what: vlan.name
      from:
        !GET
        from:
          !LOOKUP
          what: netbox
        what: !ITEM EVENT source.ip
    - !ITEM EVENT source.vlan.name

  source.subnet.id:
    !OR
    - !GET
      what: prefix
      from:
        !GET
        from:
          !LOOKUP
          what: netbox
        what: !ITEM EVENT source.ip
    - !ITEM EVENT source.subnet.id

  network.name:
    !OR
    - !GET
      what: description
      from:
        !GET
        from:
          !LOOKUP
          what: netbox
        what: !ITEM EVENT source.ip
    - !ITEM EVENT network.name
!OR zachová existující hodnotu, když lookup mine (neznámá nebo veřejná IP). Stejný vzor funguje pro destination.ip nebo client.ip s paralelními bloky.
Schema auto enrich
ECS také dokumentuje automatické obohacení z lookupu subnets do source.vlan.id / source.subnet.id. Pokud lookup pojmenujete subnets a slaďte názvy polí, Parsec může tyto dvě pole naplnit bez vlastního enricheru. Enricher výše je pro lookup pojmenovaný netbox a extra pole jako source.vlan.name a network.name.
4. Volitelně: detekce na obohacených nebo raw lookup datech
Po obohacení mohou pravidla filtrovat source.vlan.id nebo network.name jako jakékoli jiné ECS pole. Členství v rozsahovém lookupu můžete testovat přímo (stejný styl jako zóny):
- !IN
  what: !ITEM EVENT source.ip
  where:
    !LOOKUP
    what: netbox
Užitečné pro pravidla stylu „provoz z Netbox spravovaného prefixu“, zatímco enricher drží Discover a dashboardy čitelné bez opakování lookupu v každém dotazu.
Pokročilý příklad: Active Directory SID na user ID
Feedy nejsou omezeny na threat intel API. LDAP feed může synchronizovat účty z Active Directory do lookupu, aby parsery a detekce řešily Windows SID na usernames.
Common library dodává lookup sids2userid (group: asset) a Windows Event Log enrichery mapující we.user.security.id (a podobná SID pole) přes lookup na user.name / související identity pole.
1. Lookup
sids2userid používá string SID jako klíč a ukládá user.id (typicky sAMAccountName):
---
define:
  type: lookup/string
  name: sids2userid
  label: Security Identifiers to User ID
  group: asset
  description_title: List of user security identifiers to user IDs
  default: true

keys:
  - name: sid
    type: str

fields:
  user.id:
    type: str
2. LDAP feed
Feed se binduje na domain controller, hledá user objekty, převádí binární objectSid pomocí !LDAP.SID a zapisuje každý řádek do sids2userid.
Nahraďte host, bind účet, base DN a název tajemství pro vaše prostředí. Preferujte Vault placeholder v password, aby YAML Knihovny neukládal bind heslo.
Zabezpečení bind hesla Vaultem
Dostupnost
Vyžaduje LogMan.io Feeds v26.12.07 nebo novější (LogMan.io v26.12.12). Viz LDAP / AD: Vault placeholder pro heslo.
- Uložte heslo do Vaultu (na hostu LogMan.io):
curl -X PUT localhost:8891/vault/LDAP_USER_PASSWORD --data 'supersecret'
- Namapujte na Feeds v
/Site/model.yaml, pak aplikujte:
services:
  lmio-feeds:
    asab:
      config:
        passwords:
          LDAP_USER_PASSWORD: "{{LDAP_USER_PASSWORD}}"

secrets:
  LDAP_USER_PASSWORD: {}
- Ve feedu použijte
password: "{{LDAP_USER_PASSWORD}}"(viz příklad níže).
Úplný postup krok za krokem (včetně alternativní syntaxe a řešení problémů) je v LDAP / AD feed identity uživatele: Použití Vault placeholderu pro heslo.
---
define:
  name: Sids to User ID Feed
  type: lmio/feed
  # Define schema from the input fields loaded by the feed
  schema:
    objectSid: binary
    sAMAccountName: str

input:
  source: ldap://10.84.203.57
  type: ldap
  username: adldap@domain.int
  password: "{{LDAP_USER_PASSWORD}}"
  base: dc=DOMAIN,dc=int
  filter: (&(objectCategory=person)(objectClass=user))
  attributes: objectSid sAMAccountName
  period: 1h

apply:
  key:
    !LDAP.SID
    what: !ITEM EVENT objectSid

  user.id:
    !CAST
    what: !ITEM EVENT sAMAccountName
    type: str

output:
  lookup: sids2userid
Mapování:
type: ldaptahá záznamy z Active Directory při každémperiod(1hvýše).-
password: "{{…}}"rozbalí bind heslo z Feeds[passwords](Vault přes Maestro); neukládejte plaintext hesla do sdílených feedů Knihovny. -
filtervybírá person/user objekty;attributesomezuje vrácené LDAP atributy. !LDAP.SIDpřevede binárníobjectSidna string SID jako klíč lookupu.user.idukládásAMAccountNamejako atribut lookupu (stejný název jako v deklaraci lookupu).
Po běhu feedu otevřete Lookups → sids2userid a ověřte páry SID → username.
3. Obohacení a detekce
Windows parsery v common library už používají sids2userid (např. SID → user.name). Jakmile feed drží lookup aktuální, obohacené události ukazují názvy účtů, i když raw log nesl jen SID.
Pro mapování display names (nebo jiných username řetězců) na kanonické user.id přes usernames2userid viz LDAP / AD feed identity uživatele.
V detekcích můžete testovat členství nebo řešit identitu stejně jako u jiných lookupů (viz Lookupy v detekcích). Držte period feedu dost krátké pro churn nástupů a odchodů v AD.
Související čtení
- Lookupy v detekcích: whitelist a blacklist predikáty
- LDAP / AD feed identity uživatele: plnění
usernames2useridz Active Directory - LDAP / AD: Vault placeholder pro heslo: bind hesla (a MISP API klíče) mimo YAML Knihovny
-
Tools: MISP: MISP jako integrovaný nástroj LogMan.io
-
Hodnocení rizika: skupina IOC a vrstvy skóre
- Predikáty: SP-Lang filtry
- Deklarace enricherů: přidávání polí při parsování
- Reference Lookups: typy, deklarace, nasazení
- IP address lookups: IP a IP rozsahové lookupy
- Pokročilá korelační pravidla: vícestupňová pravidla konzumující threat intel signály
LDAP / Active Directory feed pro normalizaci identity uživatele
Logy často nesou zobrazovaná jména, přihlašovací jména nebo jiné řetězcové identity, které neodpovídají jedinému kanonickému user.id. LDAP (Active Directory) feed může synchronizovat účty do lookupu usernames2userid. Parsec pak používá tento lookup při normalizaci identity aktiv, aby user.name na událostech mapoval na stabilní user.id.
Jde o stejnou cestu feed → lookup jako u threat intelligence feedů, ale cílem je konzistence identity pro Assets, Discover a detekce, ne IOC watchlisty.
Co potřebujete (LDAP vstup)
Než feed napíšete, shromážděte tyto hodnoty. Patří do sekce input: feedu:
| Pole | Povinné | Příklad | Význam |
|---|---|---|---|
source |
ano | ldap://10.91.44.128 nebo "{{LDAP_URL}}" |
LDAP URL řadiče domény. Použijte ldap://host nebo ldap://host:389. Pro TLS ldaps://host nebo ldaps://host:636. Feeds zkopíruje URL do LDAP připojení uri. Může použít Vault placeholder (Feeds v26.12.07+, LogMan.io v26.12.12). |
username |
ano | adldap@domain.int nebo "{{LDAP_BIND_USER}}" |
Bind účet (UPN nebo DOMAIN\user). Potřebuje čtení uživatelů, které hledáte. Může použít Vault placeholder (Feeds v26.12.07+, LogMan.io v26.12.12). |
password |
ano | "{{LDAP_USER_PASSWORD}}" |
Bind heslo. Preferujte Vault placeholder (Feeds v26.12.07+, LogMan.io v26.12.12); plaintext jen v labu. |
base |
ano | dc=DOMAIN,dc=int |
LDAP base DN, kde začíná hledání (obvykle kořen domény nebo konkrétní OU). |
filter |
ano | (&(objectCategory=person)(objectClass=user)) |
LDAP filtr výběru uživatelských účtů (bez počítačových objektů). |
attributes |
ano | sAMAccountName displayName |
AD atributy oddělené mezerou. Každý atribut v schema / apply musí být uveden zde. |
period |
ano | 1h |
Jak často feed znovu spustí hledání (např. 1h, 1d). |
type |
ano | ldap |
Musí být ldap, aby LogMan.io Feeds použil LDAP zdroj. |
Síť: služba LogMan.io Feeds musí dosáhnout na host a port v source (firewall / DNS). Preferujte dedikovaný bind účet pouze pro čtení omezený na potřebné OU.
Na straně LogMan.io také:
- Existuje lookup
usernames2userid(common library,default: true, skupinaasset). - Parsery emitují
user.name(nebo jiné pole uvedené podusernames2useridv/Schemas/Mappings/Asset_<schema>.yaml).
Varianta podle SID (sids2userid): Threat intelligence feedy: Active Directory SID na user ID. Jak Parsec aplikuje asset lookupy: Správa aktiv a activity stream.
Použití Vault placeholderu pro heslo
Dostupnost
Rozbalení placeholderů {{…}} / ${passwords:…} z [passwords] v deklaracích feedů vyžaduje LogMan.io Feeds v26.12.07 nebo novější (LogMan.io v26.12.12).
Neukládejte tajemství do sdíleného YAML feedu v Knihovně jako plaintext. Do polí jako source / url, username, password nebo HTTP headers dejte placeholder; LogMan.io Feeds načte skutečnou hodnotu ze své konfigurace služby ([passwords]), kterou ASAB Maestro doplní z Vaultu.
Typické rozdělení práce:
| Krok | Kdo | Co |
|---|---|---|
| 1 | Admin / operátor | Uložit tajemství do Vaultu |
| 2 | Admin / operátor | Namapovat tajemství na lmio-feeds v /Site/model.yaml a aplikovat |
| 3 | Analytik | Použít placeholdery v deklaraci feedu (Knihovna /Feeds/…) |
1. Uložení hesla do Vaultu
Na hostu LogMan.io (upravte název tajemství, pokud používáte jiné id):
curl -X PUT localhost:8891/vault/LDAP_USER_PASSWORD --data 'supersecret'
Názvy tajemství jsou case insensitive. Použijte stabilní id velkými písmeny, např. LDAP_USER_PASSWORD nebo LDAP_FEEDS_BIND_PASSWORD.
Stejný Vault vzor používá SeaCat Auth LDAP; viz Integrace LDAP serveru.
2. Mapování tajemství do konfigurace Feeds
V /Site/model.yaml deklarujte tajemství a vložte ho do sekce Feeds [passwords]:
services:
  lmio-feeds:
    asab:
      config:
        passwords:
          LDAP_USER_PASSWORD: "{{LDAP_USER_PASSWORD}}"

secrets:
  LDAP_USER_PASSWORD: {}
Poté aplikujte model (Použít v Knihovně na /Site, nebo na hostu ./gov.sh up). Po aplikaci vygenerovaný /conf/lmio-feeds.conf obsahuje např.:
[passwords]
LDAP_USER_PASSWORD=<value from vault>
Restartujte / znovu vytvořte instanci Feeds, pokud váš provozní proces automaticky nenačte změny konfigurace.
3. Odkaz na tajemství ve feedu
V sekci input feedu nastavte password na placeholder (stejný název jako ve Vaultu / modelu):
input:
  source: ldap://10.91.44.128
  type: ldap
  username: adldap@domain.int
  password: "{{LDAP_USER_PASSWORD}}"
  base: dc=DOMAIN,dc=int
  filter: (&(objectCategory=person)(objectClass=user))
  attributes: sAMAccountName displayName
  period: 1h
Ekvivalent ve stylu ASAB:
password: ${passwords:LDAP_USER_PASSWORD}
Obyčejné password: … stále funguje v labu; necommitujte reálná hesla do sdílených Knihoven.
HTTP hlavičky (Authorization a podobně)
Stejné placeholdery fungují uvnitř hodnot HTTP hlaviček, včetně JSON řetězců headers u TI a jiných HTTP feedů:
input:
  source: https://ti.example.com/api/v1/ips
  type: json
  headers: '{"Authorization": "Bearer {{API_TOKEN}}"}'
Mapujte API_TOKEN do Feeds [passwords] stejně jako LDAP (Vault + model.yaml). Můžete použít i YAML mapování:
headers:
  Authorization: "Bearer {{API_TOKEN}}"
  X-Api-Key: "{{API_TOKEN}}"
Pole URL (source, url, uri, oauth2_token_url, proxy_url) podporují stejné placeholdery, např. source: "{{LDAP_URL}}".
Když feed selže při bindu
- Ověřte, že záznam ve Vaultu existuje (
curllist/get přes Remote Control Vault API podle vašeho procesu). - Ověřte, že
secrets:apasswords:v modelu používají stejný název jako uvnitř{{…}}. - Ověřte, že model byl aplikován a Feeds conf byl znovu vygenerován.
- V logu Feeds chybějící mapování vypadá jako: secret was not found in the
[passwords]section.
Co získáte
| Část | Role |
|---|---|
| LDAP / AD | Zdroj pravdy pro názvy účtů (displayName, sAMAccountName a podobně) |
Feed (lmio/feed, type: ldap) |
Periodicky čte AD a zapisuje řádky lookupu |
Lookup usernames2userid |
Mapuje řetězec uživatelského jména (klíč) na user.id (atribut) |
| Parsec asset mapping | U každé události hledá user.name v usernames2userid a doplní user.id, pokud chybí |
Active Directory → LDAP feed → usernames2userid → Parsec identity normalization → user.id on events / Assets
1. Lookup: usernames2userid
Deklarace v common library (/Lookups/usernames2userid.yaml):
---
define:
  type: lookup/string
  name: usernames2userid
  label: User names to User ID
  description_title: List of user names or other string values to user IDs
  group: asset
  default: true

keys:
  - name: name
    type: str

fields:
  user.id:
    type: str
- Klíč: řetězec, jak se objeví v logách (např.
displayNamenebo jiný AD atribut zvolený jakoapply.key). - Atribut
user.id: kanonická identita, kterou Parsec zapíše po úspěšné normalizaci (častosAMAccountNamenebosAMAccountName@tenant).
ECS asset mapping propojí lookup s user.name:
identity:
  usernames2userid:
    - user.name
Pokud je user.id na události už nastaveno, Parsec ho nepřepisuje. Lookup se stále spouští pro kontext aktiva. Když lookup nic nenajde, volitelný fallback na user.name (např. lowercase_and_domain_removal) může stále vytvořit id.
2. Vytvoření LDAP feedu
Přidejte deklaraci feedu pod /Feeds/ v Knihovně (nebo ji vytvořte z UI Lookups s cestou feedu). Vyplňte každé povinné pole input podle Co potřebujete.
---
define:
  type: lmio/feed
  name: LDAP User Name Extractor

  schema:
    sAMAccountName: str
    displayName: str

input:
  source: ldap://10.91.44.128
  type: ldap
  username: adldap@domain.int
  password: "{{LDAP_USER_PASSWORD}}"
  base: dc=DOMAIN,dc=int
  filter: (&(objectCategory=person)(objectClass=user))
  attributes: sAMAccountName displayName
  period: 1h

apply:
  key: !ITEM EVENT displayName
  user.id:
    !JOIN
    delimiter: "@"
    items:
      - !ITEM EVENT sAMAccountName
      - !ARG TENANT

output:
  lookup: usernames2userid
Mapování:
source/type: ldap: LogMan.io Feeds otevře LDAP připojení (ldap://…neboldaps://…) a při každémperiodprovede hledání.password: "{{…}}": bind heslo z Vaultu / Feeds[passwords](viz Použití Vault placeholderu pro heslo); vyhněte se plaintext heslům ve sdíleném YAML Knihovny.baseafilter: omezí hledání na OU / uživatelské objekty, které vás zajímají.attributes: do schématu feedu se načtou jen uvedené AD atributy.apply.key: stane se klíčem lookupu. ZdedisplayNameodpovídá logům se zobrazovaným jménem vuser.name.apply.user.id: hodnota uložená na řádku lookupu. Příklad sestavísAMAccountName@<tenant>pomocí!JOINa!ARG TENANT. Pro prostý název účtu:
apply:
  key: !ITEM EVENT displayName
  user.id:
    !CAST
    what: !ITEM EVENT sAMAccountName
    type: str
Zvolte atribut klíče tak, aby odpovídal tomu, co parsery dávají do user.name. Pokud logy už používají sAMAccountName, nastavte klíč i user.id z toho atributu (nebo feed pro ty zdroje přeskočte).
Volitelně: e-maily → user.id
Stejný vzor plní useremails2userid z AD mail, které Parsec mapuje z user.email. Viz testovací feed v knihovně Feeds LDAP User Email Extractor; výstupní lookup musí být useremails2userid.
3. Ověření lookupu
- Počkejte jeden
periodfeedu (nebo spusťte feed ručně, pokud to váš provoz umožňuje). - Otevřete Lookups → usernames2userid a ověřte klíče (display names) a hodnoty
user.id. - Pošlete nebo počkejte na událost, kde
user.namerovná klíči lookupu auser.idje prázdné. - V Discover ověřte doplněné
user.id. V Assets by měl uživatelský principál odpovídat tomuto id.
4. Jak automatická normalizace používá data
Na parse cestě, po obohacení, AssetIdentityProcessor (z /Schemas/Mappings/Asset_ECS.yaml):
- Načte
user.namez události. - Vyhledá řetězec v
usernames2userid. - Pokud řádek má
user.id, zapíše ho na událost, kdyžuser.idbylo prázdné. - Pokračuje s
useremails2userid/ fallbacky podle konfigurace.
Normalizované user.id řídí inventář Assets, principály activity streamu a konzistentní korelaci na identitu.
Pořadí e-mailových lookupů: nejdřív uživatelská jména, pak e-maily, pak fallback. Detaily: Parsec správa aktiv.
Praktické tipy
- Preferujte Vault placeholder v
password(např."{{LDAP_USER_PASSWORD}}"); viz Použití Vault placeholderu pro heslo. - Slaďte velikost písmen a formát klíčů feedu s parsovaným
user.name(mezery, diakritika,DOMAIN\uservs display name). Neshoda klíčů tiše mine. - Preferujte read-only AD bind účet omezený na potřebné OU.
perioddržte dost krátké pro nástupy a odchody (často1h); velmi velké adresáře mohou potřebovat delší periodu nebo užší filtr.- Jeden feed by měl vlastnit obsah
usernames2userid, pokud nemáte jasnou strategii slučování. - Pro Windows události jen se SID použijte samostatný LDAP feed do
sids2userid(a Windows SID enrichery), ne tento lookup. - UI alternate names na aktivu mohou lookupy doplnit; feed udržuje mapování ve škále adresáře aktuální automaticky.
Související čtení
- Threat intelligence feedy: deklarace feedů včetně AD SID →
sids2userid - Integrace LDAP serveru: Vault tajemství pro SeaCat Auth LDAP (stejná idea Vaultu)
- Správa aktiv: UI Assets pro analytiky
- Parsec: normalizace identity: jak lookupy plní
user.id - Lookupy v detekcích: lookupy v korelačních pravidlech
- Reference Lookups: typy lookupů a nasazení
Parsování
Parsování
Parsování je proces analýzy původního logu (který je obvykle ve formátu jednořádkového/mnohořádkového řetězce, JSON nebo XML) a jeho transformace do seznamu párů klíč-hodnota, které popisují data logu (například kdy došlo k původní události, priorita a závažnost logu, informace o procesu, který log vytvořil, atd.).
Každý log, který vstoupí do vašeho systému LogMan.io od TeskaLabs, musí být zparsován. Mikroslužba LogMan.io Parsec je zodpovědná za parsování logů. Parsec potřebuje parsery, což jsou sady deklarací (YAML soubory), aby věděl, jak parsovat každý typ logu.
Všechna zparsovaná pole v LogMan.io jsou mapována na nějaké schéma. To zajišťuje, že data logu z různých zdrojů jsou normalizována a strukturována konzistentně, což usnadňuje vyhledávání, analýzu a korelování událostí ve vašem prostředí.
LogMan.io přichází s Common Library, která má již vytvořené mnohé parsery pro běžné typy logů. Pokud však potřebujete vytvořit své vlastní parsery, porozumění klíčovým termínům, seznámení se s deklaracemi a využití návodu na parsování vám může pomoci.
Základní příklad parsování
Parsování vezme surový log, jako je tento (příklad z firewallu Sophos):
<30>2023-12-04T15:33:59.033+00:00 hostname3 ulogd[1620]: id="2001" severity="info"
sys="SecureNet" sub="packetfilter" name="Packet dropped" action="drop"
fwrule="60002" initf="eth2.3009" outitf="eth6" srcmac="e0:63:da:73:bb:3e"
dstmac="7c:5a:1c:4c:da:0a" srcip="172.60.91.60" dstip="192.168.99.121"
proto="17" length="168" tos="0x00" prec="0x00" ttl="63"
srcport="47100" dstport="12017"
# Časová značka
"@timestamp": 2023-12-04 15:33:59.033

# Syslog hlavička
log.syslog.priority: 30
log.syslog.facility.code: 3
log.syslog.facility.name: daemon
log.syslog.severity.code: 6
log.syslog.severity.name: information

host.hostname: hostname3
process.name: ulogd
process.pid: 1620

# Pole události
event.dataset: sophos
event.action: Packet dropped
event.id: 2001

# Pole zdroje
source.bytes: 168
source.ip: 172.60.91.60
source.mac: e0:63:da:73:bb:3e
source.port: 47100

# Pole cíle
destination.ip: 192.168.99.121
destination.mac: 7c:5a:1c:4c:da:0a
destination.port: 12017

# Další relevantní informace
observer.egress.interface.name: eth6
observer.ingress.interface.name: eth2.3009
sophos.action: drop
sophos.fw.rule.id: 60002
sophos.prec: 0x00
sophos.protocol: 17
sophos.sub: packetfilter
sophos.sys: SecureNet
sophos.tos: 0x00
device.model.identifier: SG230
dns.answers.ttl: 63
Parsování klíčových pojmů
Důležité pojmy relevantní pro LogMan.io Parsec a proces parsování.
Událost
Jednotka dat, která prochází procesem parsování, se nazývá událost. Původní událost přichází do LogMan.io Parsec jako vstup a je následně zpracována procesory. Pokud je parsování úspěšné, produkuje parsovanou událost, a pokud parsování selže, produkuje událost chyby.
Původní událost
Původní událost je vstup, který LogMan.io Parsec přijímá - jinými slovy, neparsovaný log. Může být reprezentována jako surový (možná zakódovaný) řetězec nebo struktura ve formátu JSON nebo XML.
Parsovaná událost
Parsovaná událost je výstup z úspěšného parsování, formátovaný jako neuspořádaný seznam párů klíč-hodnota serializovaných do struktury JSON. Parsovaná událost vždy obsahuje jedinečné ID, původní událost a obvykle informace o tom, kdy byla událost vytvořena zdrojem a přijata Apache Kafka.
Událost chyby
Událost chyby je výstup z neúspěšného parsování, formátovaný jako neuspořádaný seznam párů klíč-hodnota serializovaných do struktury JSON. Je produkována, když parsování, mapování nebo obohacení selže, nebo když dojde k jiné výjimce v LogMan.io Parsec. Vždy obsahuje původní událost, informace o tom, kdy byla událost neúspěšně parsována, a chybovou zprávu popisující důvod, proč proces parsování selhal. I přes neúspěšné parsování bude událost chyby vždy ve formátu JSON, páry klíč-hodnota.
Knihovna
Vaše TeskaLabs LogMan.io Knihovna obsahuje všechny vaše deklarace (stejně jako mnoho dalších typů souborů). Můžete upravit své deklarace ve své Knihovně prostřednictvím Zookeeper.
Deklarace
Deklarace popisují, jak bude událost transformována. Deklarace jsou YAML soubory, které LogMan.io Parsec může interpretovat k vytvoření deklarativních procesorů. V LogMan.io Parsec existují tři typy deklarací: parsers, enrichers a mappings. Více informací naleznete v sekci Deklarace.
Parser
Parser je typ deklarace, která bere původní událost nebo konkrétní pole částečně parsované události jako vstup, analyzuje její jednotlivé části a poté je ukládá jako páry klíč-hodnota do události.
Mapování
Deklarace mapování je typ deklarace, která bere částečně parsovanou událost jako vstup, přejmenuje názvy polí a nakonec převádí datové typy. Pracuje společně se schématem (ECS, CEF). Také funguje jako filtr, aby vyloučila data, která nejsou potřebná v konečné parsované události.
Obohacovač
Obohacovač je typ deklarace, která doplňuje částečně parsovanou událost o další data.
Schéma v TeskaLabs LogMan.io
TeskaLabs LogMan.io používá schémata k standardizaci a normalizaci logových dat z různých zdrojů. Schémata zajišťují, že logy z různých systémů, aplikací a zařízení jsou mapovány na společnou strukturu, což usnadňuje jejich čtení, analýzu a korelaci. Tato normalizace zlepšuje čitelnost a přístupnost, což umožňuje analytikům pracovat s logy z různých zdrojů, aniž by museli rozumět jedinečnému formátu každého zdroje.
Proč používat schémata?
- Normalizace: Schémata transformují heterogenní formáty logů do jednotné struktury, což umožňuje konzistentní dotazování a analýzu.
- Čitelnost: Standardizovaná pole činí logy snadněji interpretovatelnými, čímž se snižuje nejednoznačnost a zvyšuje efektivita pro analytiky.
- Přístupnost: S běžným schématem lze logy z různých zdrojů přistupovat a porovnávat bez problémů, což podporuje vyšetřování a reportování napříč systémy.
ECS Schéma
TeskaLabs LogMan.io přijímá Elastic Common Schema (ECS) jako své primární schéma pro normalizaci logů. ECS definuje sadu polí pro strukturování dat událostí, což usnadňuje ingestování, vyhledávání a vizualizaci logů.
Důležitá pole ECS
Datetime pole
- @timestamp: Datum a čas, kdy k události došlo, obvykle parsováno z události samotné.
- event.created: Datum a čas, kdy byla událost shromážděna LogMan.io Kolektorem.
- event.ingested: Datum a čas, kdy byla událost přijata LogMan.io Receiverem (centrální systém) a uložena do Archivu.
Chronologické pořadí časových razítek je následující:
@timestamp < event.created < event.ingested
Základní pole
- event.original: Původní logová zpráva, uchovávaná pro referenci.
- message: Část události čitelná pro člověka, pokud je přítomna, se obvykle ukládá do tohoto pole.
- _id: Jedinečný identifikátor pro událost. V TeskaLabs LogMan.io se to vztahuje na
row_idv Archivu. - related.ip: Seznam všech IP adres pozorovaných v události.
Pole události
- event.category: Vysoká úroveň kategorie události (např.
authentication,network,file), která pomáhá seskupovat podobné události. - event.action: Konkrétní akce provedená (např.
user login,file access). - event.outcome: Výsledek události. Možné hodnoty jsou:
success,failurenebounknown. - event.type: Popisuje typ události, jako je
info,error,start,endneboaccess. Toto pole dále klasifikuje povahu události v rámci její kategorie. - event.kind: Označuje obecný typ události, jako je
event,alert,metricnebostate. Toto pole je užitečné pro rozlišení mezi běžnými událostmi, upozorněními a jinými typy dat.
Identifikátory
- host.id: Jedinečný identifikátor pro hostitele, ze kterého událost pochází. V TeskaLabs LogMan.io je obvykle obohacen z host.hostname pomocí vyhledávání.
- user.id: Jedinečný identifikátor pro uživatele spojeného s událostí. V TeskaLabs LogMan.io je obvykle obohacen z user.name pomocí vyhledávání.
Další běžná pole
- log.level: Původní úroveň logu události (např.
info,warning,error). - source.ip a destination.ip: IP adresy zapojené do události, které jsou zásadní pro analýzu sítě.
- process.name a process.pid: Informace o procesu zapojeném do události, užitečné pro systémové, koncové a aplikační logy.
Pole specifická pro LogMan.io
- lmio.source: Identifikuje původ události. Pro události shromážděné pomocí syslog je dále obohaceno do následujících polí:
- lmio.logsource.ip: IP adresa zařízení, ze kterého log pochází.
- lmio.logsource.port: Zdrojový port zařízení, ze kterého log pochází.
- lmio.logsource.protocol: Protokol použitý pro předávání logů (např.
tcp,udp,tls).
- tenant: Název nájemce, ke kterému událost patří.
Ostatní schéma
Ostatní schéma se používá pro chybové události, tj. pro události, které nebyly úspěšně zpracovány. Je odvozeno od schématu ECS.
Důležitá pole ostatního schématu
- event.dataset: Identifikuje Event Lane, ze které událost pochází.
- event.original: Původní log.
- @timestamp: Datum a čas, kdy byla událost zpracována během parsování.
- error.id: Jedinečný identifikátor chyby.
- error.message: Popis výjimky, proč událost nebyla úspěšně zpracována.
Deklarace
Deklarace
Deklarace popisují, jak by měl být událost analyzována. Jsou uloženy jako YAML soubory v knihovně. LogMan.io Parsec interpretuje tyto deklarace a vytváří procesory pro analýzu.
Existují tři typy deklarací:
- Deklarace parseru: Parser přijímá původní událost nebo konkrétní pole částečně analyzované události jako vstup, analyzuje její jednotlivé části a ukládá je jako páry klíč-hodnota do události.
- Deklarace mapování: Mapování přijímá částečně analyzovanou událost jako vstup, přejmenovává názvy polí a nakonec převádí datové typy. Pracuje společně se schématem (ECS, CEF).
- Deklarace obohacení: Obohacovač doplňuje částečně analyzovanou událost o další data.
Tok dat
Typická, doporučená sekvence analýzy je řetězec deklarací:
- První hlavní deklarace parseru začíná řetězec a další parsery (nazývané sub-parsery) extrahují podrobnější data z polí vytvořených předchozím parserem.
- Poté, (jediná) deklarace mapování přejmenovává klíče analyzovaných polí podle schématu a filtruje pole, která nejsou potřebná.
- Nakonec deklarace obohacení doplňuje událost o dodatečná data. I když je možné použít více souborů obohacení, doporučuje se použít pouze jeden.
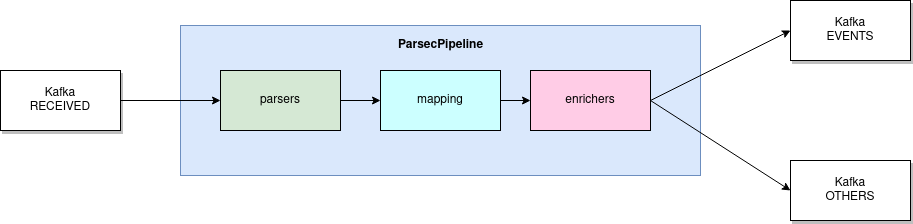
Pojmenování deklarací
Důležité: Konvence pojmenování
LogMan.io Parsec načítá deklarace abecedně a vytváří odpovídající procesory ve stejném pořadí. Proto vytvořte seznam souborů deklarací podle těchto pravidel:
-
Začněte všechny názvy souborů deklarací číselným prefixem:
10_parser.yaml,20_parser_message.yaml, ...,90_enricher.yaml.Doporučuje se "nechat nějaký prostor" ve vašem číslování pro budoucí deklarace v případě, že chcete přidat novou deklaraci mezi dvě existující (např.
25_new_parser.yaml). -
Zahrňte typ deklarace do názvů souborů:
20_parser_message.yamlspíše než10_message.yaml. - Zahrňte typ schématu použitý v názvech souborů mapování a obohacení:
40_mapping_ECS.yamlspíše než40_mapping.yaml.
Příklad:
/Parsers/MyParser/:
    - 10_parser.yaml
    - 20_parser_username.yaml
    - 30_parser_message.yaml
    - 40_mapping_ECS.yaml
    - 50_enricher_lookup.yaml
    - 60_enricher_ECS.yaml
Deklarace parserů
Deklarace parseru bere jako vstup původní událost nebo specifické pole částečně zpracované události, analyzuje její jednotlivé části a ukládá je jako páry klíč-hodnota do události.
LogMan.io Parsec v současnosti podporuje tři typy deklarací parserů:
- Parser-kombinátor
- JSON parser
- XML parser
- Parser Windows Events
Struktura deklarace
Aby bylo možné určit typ deklarace, je nutné specifikovat sekci define.
define:
    type: parsec/<type>
Pro deklaraci parseru:
define:
    type: parsec/parser
Parser-kombinátor
Parser-kombinátor (parsec) se používá pro zpracování událostí v prostém textovém formátu. Je založen na SP-Lang Parsec výrazech.
Pro zpracování původních událostí použijte následující deklaraci:
define:
    name: Můj Parser
    type: parsec/parser

parse:
    !PARSE.KVLIST
    - ...
    - ...
    - ...
define:
    name: Můj Parser
    type: parsec/parser
    field: <custom_field>

parse:
    !PARSE.KVLIST
    - ...
    - ...
    - ...
Když je specifikováno field, zpracování se aplikuje na toto pole, jinak se aplikuje na původní událost. Proto musí být přítomno v každém sub-parseru.
Příklady deklarací parser-kombinátorů
Příklad 1: Jednoduchý příklad
Pro účely příkladu si řekněme, že chceme zpracovat kolekci jednoduchých událostí:
Ahoj Miroslave z Prahy!
Ahoj Kristýno z Plzně.
Příklad deklarace parseru:
define:
    type: parsec/parser

parse:
    !PARSE.KVLIST
    - !PARSE.UNTIL " " # 'Ahoj '
    - name: !PARSE.UNTIL " " # 'Miroslav '
    - !PARSE.EXACTLY "z " # 'z '
    - city: !PARSE.LETTERS # 'Praha'
    - !PARSE.CHARS # '!'
Výstupy:
{
    "name": "Miroslav",
    "city": "Praha"
}
{
    "name": "Kristýna",
    "city": "Plzeň"
}
Příklad 2: Složitější příklad
Pro účely tohoto příkladu si řekněme, že chceme zpracovat kolekci jednoduchých událostí:
Process cleaning[123] finished with code 0.
Process log-rotation finished with code 1.
Process cleaning[657] started.
A chceme, aby výstup byl v následujícím formátu:
{
    "process.name": "cleaning",
    "process.pid": 123,
    "event.action": "process-finished",
    "return.code": 0
}
{
    "process.name": "log-rotation",
    "event.action": "process-finished",
    "return.code": 1
}
{
    "process.name": "cleaning",
    "process.pid": 657,
    "event.action": "process-started",
}
Deklarace bude následující:
define:
    type: parsec/parser

parse:
    !PARSE.KVLIST
    - !PARSE.UNTIL " "
    - !TRY
        - !PARSE.KVLIST
            - process.name: !PARSE.UNTIL "["
            - process.pid: !PARSE.UNTIL "]"
            - !PARSE.SPACE
        - !PARSE.KVLIST
            - process.name: !PARSE.UNTIL " "
    - !TRY
        - !PARSE.KVLIST
            - !PARSE.EXACTLY "started."
            - event.action: "process-started"
        - !PARSE.KVLIST
            - !PARSE.EXACTLY "finished with code "
            - event.action: "process-finished"
            - return.code: !PARSE.DIGITS
Příklad 3: Zpracování syslog událostí
Pro účely příkladu si řekněme, že chceme zpracovat jednoduchou událost ve formátu syslog:
<189>Sep 22 10:31:39 server-abc server-check[1234]: User "harry potter" logged in from 198.20.65.68
Chtěli bychom, aby výstup byl v následujícím formátu:
{
    "log.syslog.priority": 189,
    "@timestamp": 1695421899,
    "host.hostname": "server-abc",
    "process.name": "server-check",
    "process.pid": 1234,
    "user.name": "harry potter",
    "source.ip": "198.20.65.68"
}
Vytvoříme dva parsery. První parser zpracuje hlavičku syslogu a druhý zpracuje zprávu.
define:
    name: Syslog parser
    type: parsec/parser

parse:
    !PARSE.KVLIST
    - "<"
    - PRI: !PARSE.DIGITS # 189
    - ">"
    - "@timestamp": !PARSE.DATETIME RFC3164 # Sep 22 10:31:39
    - host.hostname: !PARSE.UNTIL " " # server-abc
    - process.name: !PARSE.UNTIL "[" # server-check
    - process.pid: !PARSE.UNTIL "]" # 1234
    - ":"
    - !PARSE.SPACES
    - message: !PARSE.CHARS # User "harry potter" logged in from 198.20.65.68
    define:
        type: parsec/parser
        field: message

    parse:
        !PARSE.KVLIST
        - !PARSE.UNTIL " " # Uživatel
        - user.name: !PARSE.BETWEEN { what: '"' } # harry potter
        - " "
        - !PARSE.UNTIL " " # přihlášen
        - !PARSE.UNTIL " " # z
        - !PARSE.UNTIL " " # adresy
        - source.ip: !PARSE.CHARS
JSON parser
JSON parser se používá pro zpracování událostí se strukturou JSON.
define:
    name: JSON parser
    type: parsec/parser/json
Toto je kompletní JSON parser a zpracovává události do objektu JSON, který může být později odkazován v sub-parsers a mapování.
XML parser
XML parser se používá pro zpracování událostí se strukturou XML.
define:
    name: XML parser
    type: parsec/parser/xml
Toto je kompletní XML parser a zpracovává události do objektu XML, který může být později odkazován v sub-parsers a mapování.
Parser Windows Event
Parser Windows Events se používá pro zpracování událostí, které jsou generovány z Microsoft Windows. Tyto události jsou ve formátu XML.
define:
    name: Parser Windows Events
    type: parsec/parser/windows-event
Toto je kompletní parser Windows Event a zpracovává události z Microsoft Windows, oddělující pole do párů klíč-hodnota.
Deklarace mapování
Poté, co jsou všechny deklarované pole získány z parserů, musí být pole přejmenována podle nějakého schématu (ECS, CEF, ...) v procesu nazývaném mapování. Mapování zajišťuje, že logy z různých zdrojů mají sjednocené, konzistentní názvy a typy polí.
Proces mapování:
- přejmenuje pole z analyzovaných logů podle nějakého schématu
- případně převede typy polí (např. ze stringu na celé číslo, IP, MAC atd.)
- filtruje všechna pole, která nejsou uvedena v mapování
Deklarace
define:
    type: parsec/mapping
    schema: /Schemas/ECS.yaml

mapping:
    <original_key>: <new_key>
    <original_key>: <new_key>
    ...
Specifikujte parsec/mapping jako type v sekci define. V poli schema specifikujte cestu k schématu, které používáte.
Příklad
Pro účely příkladu si představme, že chceme analyzovat jednoduchou událost:
User harry_potter login from 178.2.1.20
a chtěli bychom, aby konečný výstup vypadal takto:
{
    "user.name": "harry_potter",
    "event.action": "login",
    "source.ip": "178.2.1.20"
}
Všimněte si, že názvy klíčů v původní události se liší od názvů klíčů v požadovaném výstupu.
Pro počáteční deklaraci parseru v tomto případě můžeme použít jednoduchý JSON parser:
define:
    type: parsec/parser

parse:
    !PARSE.KVLIST
    - "User "
    - USER: !PARSE.UNTIL " "
    - ACTION: !PARSE.UNTIL " "
    - !PARSE.UNTIL " "
    - IP: !PARSE.IP
Tento parser vytvoří seznam párů klíč-hodnota:
USER        harry_potter
ACTION      login
IP          178.2.1.20
Abychom změnili názvy jednotlivých polí, vytvoříme soubor deklarace mapování, 20_mapping_ECS.yaml, ve kterém popíšeme, která pole mapovat a jak:
---
define:
    type: parsec/mapping  # určete typ deklarace
    schema: /Schemas/ECS.yaml  # které schéma je použito

mapping:
    USER: user.name
    ACTION: event.action
    IP: source.ip
Tato deklarace vytvoří požadovaný výstup.
Deklarace enricherů
Enrichery doplňují parsovanou událost o další data.
Enricher může:
- Vytvořit nové pole v události.
- Transformovat hodnoty pole (změna velikosti písmen, výpočty atd.).
Enrichery se nejčastěji používají k:
- Určení datasetu, kam se logy uloží v ElasticSearch (pole
event.dataset). - Získání facility a severity z pole syslog priority.
Výchozí IP enrichery v common library také přidávají geolokaci a ASN (Autonomous System) k IP polím. Viz Geolokační vyhledávání a ASN obohacení.
Pro připojení MaxMind databáze .mmdb k IP polím (skupina a mapování) viz Vlastní MaxMind enricher.
Deklarace
define:
    type: parsec/enricher
    schema: /Schemas/ECS.yaml

enrich:
    event.dataset: <dataset_name>
    new.field: <expression>
    ...
Example
Následující příklad je enricher pro události ve formátu syslog. Předpokládejme parser pro události ve formě:
<14>1 2023-05-03 15:06:12 server pid: Username 'HarryPotter' logged in.
{
    "log.syslog.priority": 14,
    "user.name": "HarryPotter"
}
Chcete získat syslog severity a facility, které se počítají standardním způsobem:
(facility * 8) + severity = priority
Také chcete převést jméno HarryPotter na harrypotter, aby byli uživatelé sjednoceni napříč logovacími zdroji.
Proto vytvoříte enricher:
define:
    type: parsec/enricher
    schema: /Schemas/ECS.yaml

enrich:
    event.dataset: 'dataset_name'
    user.id: !LOWER { what: !GET {from: !ARG EVENT, what: user.name} }

    # facility a severity se počítají ze 'syslog.pri' standardním způsobem
    log.syslog.facility.code: !SHR
            what: !GET { from: !ARG EVENT, what: log.syslog.priority }
            by: 3
    log.syslog.severity.code: !AND [ !GET {from: !ARG EVENT, what: log.syslog.priority}, 7 ]
Návod na analýzu
Celý proces analýzy vyžaduje deklarace parseru, mapování a obohacovače. Tento návod podrobně popisuje vytváření deklarací krok za krokem. Navštivte LogMan.io Parsec documentation pro více informací o mikroservisu Parsec.
Než začnete
SP-Lang
Deklarace pro analýzu jsou psány v jazyce SP-Lang od TeskaLabs. Pro více informací o výrazech pro analýzu navštivte dokumentaci SP-Lang.
Deklarace
Pro více informací o konkrétních typech deklarací viz:
Ukázkové logy
Tento příklad používá tuto sadu logů shromážděných z různých zařízení Sophos SG230:
<181>2023:01:12-13:08:45 asgmtx httpd: 212.158.149.81 - - [12/Jan/2023:13:08:45 +0100] "POST /webadmin.plx HTTP/1.1" 200 2000

<38>2023:01:12-13:09:09 asgmtx sshd[17112]: Failed password for root from 218.92.0.190 port 56745 ssh2

<38>2023:01:12-13:09:20 asgmtx sshd[16281]: Did not receive identification string from 218.92.0.190

<38>2023:01:12-13:09:20 asgmtx aua[2350]: id="3005" severity="warn" sys="System" sub="auth" name="Authentication failed" srcip="43.139.111.88" host="" user="login" caller="sshd" reason="DENIED"
Tyto logy používají formát syslog popsaný v RFC 5424.
Logy lze obvykle rozdělit na dvě části: hlavičku a tělo. Hlavička je cokoli, co předchází prvnímu dvojtečce po časovém razítku. Tělo je zbytek logu.


Strategie analýzy
Parsec interpretuje každou deklaraci abecedně podle názvu, takže pořadí názvů je důležité. V rámci každé deklarace následuje proces analýzy pořadí, ve kterém píšete výrazy jako kroky.
Sekvence analýzy může zahrnovat více deklarací parseru a také potřebuje deklaraci mapování a deklaraci obohacovače. V tomto případě vytvořte tyto deklarace:
- První deklarace parseru: Analyzujte hlavičky syslogu
- Druhá deklarace parseru: Analyzujte tělo logů jako zprávu.
- Deklarace mapování: Přejmenujte pole
- Deklarace obohacovače: Přidejte metadata (například název datasetu) a vypočítejte zařízení a závažnost syslogu z priority
Podle pojmenovacích konvencí pojmenujte tyto soubory:
- 10_parser_header.yaml
- 20_parser_message.yaml
- 30_mapping_ECS.yaml
- 40_enricher.yaml
Pamatujte, že deklarace jsou interpretovány v abecedním pořadí, v tomto případě podle rostoucího číselného předpony. Používejte předpony jako 10, 20, 30 atd., abyste mohli později přidat novou deklaraci mezi stávající, aniž byste museli přejmenovávat všechny soubory.
1. Analýza hlavičky
Toto je první deklarace parseru. Následující části podrobně rozebírají a vysvětlují každou část deklarace.
---
define:
    type: parsec/parser

parse:
    !PARSE.KVLIST

    # Část PRI
    - '<'
    - PRI: !PARSE.DIGITS
    - '>'

    # Časové razítko
    - TIMESTAMP: !PARSE.DATETIME
            - year: !PARSE.DIGITS  # rok: 2023
            - ':'
            - month: !PARSE.MONTH { what: 'number' }  # měsíc: 01
            - ':'
            - day: !PARSE.DIGITS # den: 12
            - '-'
            - hour: !PARSE.DIGITS # hodina: 13
            - ':'
            - minute: !PARSE.DIGITS # minuta: 08
            - ':'
            - second: !PARSE.DIGITS # sekunda: 45
    - !PARSE.UNTIL ' '

    # Název hostitele a proces
    - HOSTNAME: !PARSE.UNTIL ' '  # asgmtx
    - PROCESS: !PARSE.UNTIL ':'

    # Zpráva
    - !PARSE.SPACES
    - MESSAGE: !PARSE.CHARS
Hlavičky logů
Hlavičky syslogu jsou ve formátu:
<PRI>TIMESTAMP HOSTNAME PROCESS.NAME[PROCESS.PID]:


Důležité: Variabilita logů
Všimněte si, že PROCESS.PID v hranatých závorkách není přítomen v hlavičce prvního logu. Abychom vyřešili tuto nesrovnalost, parser bude potřebovat způsob, jak se vypořádat s možností, že PROCESS.PID může být buď přítomný, nebo nepřítomný. To bude řešeno později v návodu.
Analýza PRI
Nejprve analyzujte PRI, který je uzavřen mezi znaky < a >, bez mezery mezi nimi.
Jak analyzovat <PRI>, jak je vidět v první deklaraci parseru:
!PARSE.KVLIST
- !PARSE.EXACTLY { what: '<' }
- PRI: !PARSE.DIGITS
- !PARSE.EXACTLY { what: '>' }
Použité výrazy:
!PARSE.EXACTLY: Analyzování znaků<a>!PARSE.DIGITS: Analyzování čísel (číslic) PRI
!PARSE.EXACTLY zkratka
Výraz !PARSE.EXACTLY má syntaktickou zkratku, protože je tak často používán. Místo zahrnutí celého výrazu, PARSE.EXACTLY { what: '(character)' } může být zkráceno na '(character').
Takže, výše uvedená deklarace parseru může být zkrácena na:
!PARSE.KVLIST
- '<'
- PRI: !PARSE.DIGITS
- '>'
Analýza časového razítka
Neanalyzovaný formát časového razítka je:
yyyy:mm:dd-HH:MM:SS
2023:01:12-13:08:45
Analyzujte časové razítko pomocí výrazu !PARSE.DATETIME.
Jak je vidět v první deklaraci parseru:
# 2023:01:12-13:08:45
- TIMESTAMP: !PARSE.DATETIME
        - year: !PARSE.DIGITS  # rok: 2023
        - ':'
        - month: !PARSE.MONTH { what: 'number' }  # měsíc: 01
        - ':'
        - day: !PARSE.DIGITS # den: 12
        - '-'
        - hour: !PARSE.DIGITS # hodina: 13
        - ':'
        - minute: !PARSE.DIGITS # minuta: 08
        - ':'
        - second: !PARSE.DIGITS # sekunda: 45
- !PARSE.UNTIL { what: ' ', stop: after }
Analýza měsíce:
Výraz !PARSE.MONTH vyžaduje, abyste specifikovali formát měsíce v parametru what. Možnosti jsou:
'number'(použito v tomto případě), které přijímá čísla 01-12'short'pro zkrácené názvy měsíců (LED, ÚNO atd.)'full'pro plné názvy měsíců (LEDEN, ÚNOR atd.)
Analýza mezery:
Mezera na konci časového razítka také potřebuje být analyzována. Použití výrazu !PARSE.UNTIL analyzuje vše až do znaku mezery (' '), zastavuje se po mezeře, jak je definováno (stop: after).
!PARSE.UNTIL zkratky a alternativy
!PARSE.UNTIL má syntaktickou zkratku:
- !PARSE.UNTIL ' '
- !PARSE.UNTIL { what: ' ', stop: after }
Alternativně můžete zvolit výraz, který specificky analyzuje jednu nebo více mezer, respektive:
- !PARSE.SPACE
nebo
- !PARSE.SPACES
V tomto okamžiku je analyzována sekvence znaků <181>2023:01:12-13:08:45 (včetně mezery na konci).
Analýza názvu hostitele a procesu
Další je analýza názvu hostitele a procesu: asgmtx sshd[17112]:.
Pamatujte, že hlavička prvního logu se liší od ostatních. Pro řešení, které zohledňuje tuto odchylku, vytvořte deklaraci parseru a subparser.
Jak je vidět v první deklaraci parseru:
    # Název hostitele a proces
    - HOSTNAME: !PARSE.UNTIL ' '  # asgmtx
    - PROCESS: !PARSE.UNTIL ':'

    # Zpráva
    - !PARSE.SPACES
    - MESSAGE: !PARSE.CHARS
- Analyzujte název hostitele: Pro analýzu názvu hostitele použijte výraz
!PARSE.UNTIL, který analyzuje vše až do jediného znaku uvedeného uvnitř' ', což je v tomto případě mezera, a zastaví se po tomto znaku, aniž by zahrnoval znak do výstupu. - Analyzujte proces: Znovu použijte
!PARSE.UNTILpro analýzu až do:. Po dvojtečce ('), je hlavička analyzována. - Analyzujte zprávu: V této deklaraci použijte
!PARSE.SPACESpro analýzu všech mezer mezi hlavičkou a zprávou. Poté uložte zbytek události do poleMESSAGEpomocí výrazu!PARSE.CHARS, který v tomto případě analyzuje všechny zbývající znaky v logu. Další deklarace použijete k analýze částí zprávy.
1.5. Analýza pro variabilitu logů
Abychom vyřešili problém, že první log nemá PID procesu, potřebujete druhou deklaraci parseru, subparser. V ostatních logech je PID procesu uzavřen v hranatých závorkách ([ ]).
Vytvořte deklaraci nazvanou 15_parser_process.yaml. Abychom zohlednili rozdíly v logech, vytvořte dvě "cesty" nebo "větve", které parser může použít. První větev bude analyzovat PROCESS.NAME, PROCESS.PID a :. Druhá větev bude analyzovat pouze PROCESS.NAME.
Proč potřebuji dvě větve?
U třech logů je PID procesu uzavřen v hranatých závorkách ([ ]). Proto začíná výraz, který izoluje PID, analýzu na hranaté závorce [. Avšak v prvním logu pole PID není přítomno. Pokud se pokusíte analyzovat první log pomocí stejného výrazu, parser se pokusí najít hranatou závorku v tomto logu a bude pokračovat v hledání, bez ohledu na to, že znak [ není v hlavičce přítomen.
Výsledkem by bylo, že cokoli, co je uvnitř hranatých závorek, je analyzováno jako PID, což by v tomto případě bylo nesmyslné a narušilo by zbytek procesu analýzy pro tento log.


Druhá deklarace:
---
define:
    type: parsec/parser
    field: PROCESS

parse:
    !PARSE.KVLIST
    - !TRY
        - !PARSE.KVLIST
            - PROCESS.NAME: !PARSE.UNTIL '['
            - PROCESS.PID: !PARSE.UNTIL ']'
        - !PARSE.KVLIST
            - PROCESS.NAME: !PARSE.CHARS
Abychom toho dosáhli, vytvořte dvě malé parsery pod kombinátorem !PARSE.KVLIST pomocí výrazu !TRY.
Výraz !TRY
Výraz !TRY vám umožňuje zanořit seznam výrazů pod ním. !TRY začíná tím, že se pokusí použít první výraz, a pokud je tento první výraz nepoužitelný pro log, proces pokračuje druhým zanořeným výrazem, a tak dále, dokud nebude úspěšný.
Pod výrazem !TRY:
První větev:
1. Výraz analyzuje PROCESS.NAME a PROCESS.PID, očekávající, že hranaté závorky [ a ] budou přítomny v události. Po jejich analýze také analyzuje znak :.
2. Pokud log neobsahuje znak [, výraz !PARSE.UNTIL '[' selže, a v tomto případě selže celá !PARSE.KVLIST v první větvi.
Druhá větev:
3. Výraz !TRY bude pokračovat dalším parserem, který nevyžaduje, aby znak [ byl přítomen v události. Jednoduše analyzuje vše před : a zastaví se po něm.
4. Pokud tento druhý výraz selže, log jde do OTHERS.
2. Analýza zprávy
Znovu zvažte události:
``` <181>2023:01:12-13:08:45 asgmtx httpd: 212.158.149.81 - - [12/Jan/2023:13:08:45 +0100] "POST /webadmin.plx HTTP/1.
Examples
Úvod
Syslog je široce používaný standard pro zaznamenávání zpráv v počítačových systémech, síťových zařízeních a aplikacích. Umožňuje sběr, ukládání a analýzu logových zpráv z různých zdrojů, což poskytuje cenné informace pro monitorování, odstraňování problémů a analýzu bezpečnosti.
Existují dva hlavní typy syslog protokolů:
- Syslog RFC3164: Dědičná varianta syslog protokolu, často označovaná jako BSD syslog. Jeho formát zprávy je popsán v RFC3164, sekce 4.
- Syslog RFC5424: Standardizovaná a strukturovanější varianta, popsaná v RFC5424, sekce 6. Zavádí další pole a vylepšenou strukturu zprávy.
Porozumění rozdílům mezi těmito protokoly je nezbytné pro přesné parsování a normalizaci syslog událostí.
- Syslog RFC3164: Dědičná varianta syslog protokolu. Formát zprávy je popsán v RFC3164, sekce 4.
- Syslog RFC5424: Standardizovaná varianta syslog protokolu. Formát zprávy je popsán v RFC5424, sekce 6.
Syslog RFC3164
Událost ve formátu RFC3164 typicky sestává z následujících částí:


- priorita (PRI část): Číslo uzavřené v "<>" závorkách, které označuje zařízení a závažnost logu.
- časová značka: Místní čas ve formátu Mmm dd hh:mm:ss (např. Jan 17 12:10:03). Časové pásmo by mělo být nastaveno na UTC.
- hostname: Název zařízení, které událost vyprodukovalo.
- proces: Identifikátor procesu, který událost vyprodukoval. Může obsahovat PID v hranatých závorkách.
- zpráva: Část zprávy události.
Parsování hlavičky
Následující deklarace parseru rozděluje zprávu RFC3164 na její komponenty:
---
define:
  type: parsec/parser

parse:
  !PARSE.KVLIST
  - "<"
  - PRI: !PARSE.DIGITS
  - ">"
  - TIMESTAMP: !PARSE.DATETIME RFC3164
  - !PARSE.SPACES
  - HOSTNAME: !PARSE.UNTIL " "
  - PROCESS: !PARSE.UNTIL " "
  - !PARSE.OPTIONAL { what: !PARSE.SPACES }
  - MESSAGE: !PARSE.CHARS
Parsování procesu
Pole procesu se skládá z názvu procesu a PID. V současnosti následující vstup:
<38>Sep 3 13:38:07 host01 systemd-logind[1078]: New session 49 of user harrypotter
produkuje výstup:
"PROCESS": "systemd-logind[1078]:"
Abychom správně rozdělili pole PROCESS na PROCESS.NAME a PROCESS.PID, potřebujeme druhý parser pro všechny případy:
---
define:
  type: parsec/parser
  field: PROCESS

parse:
  !TRY  #(1)

  - !PARSE.KVLIST  #(2)
    - PROCESS.NAME: !PARSE.UNTIL "["
    - PROCESS.PID: !PARSE.UNTIL "]"
    - !PARSE.OPTIONAL { what: !PARSE.EXACTLY ":" }

  - !PARSE.KVLIST  #(3)
    - PROCESS.NAME: !PARSE.UNTIL ":"

  - !PARSE.KVLIST  #(4)
    - PROCESS.NAME: !PARSE.CHARS
- Výraz
!TRYpřijímá seznam výrazů jako argument. Pokyny parseru pokračovat s prvním prvkem. Pokud tento výraz selže, pokračuje druhým, poté třetím atd. - Tato větev se zabývá vstupy ve formátu
PROCESS.NAME[PROCESS.PID](např.cron[123]). - Tato větev se zabývá vstupy ve formátu
PROCESS.NAME:(např.sudo:). - Tato větev se zabývá vstupy ve formátu
PROCESS.NAME, bez:na konci (např.sudo).
Mapování na ECS schéma
Po proscanování celého logu vypadá výstup takto:
PRI: 38
TIMESTAMP: Sep 3 13:38:07
HOSTNAME: host01
PROCESS.NAME: systemd-logind
PROCESS.PID: 1078
MESSAGE: New session 49 of user harrypotter
Další fází je mapování na ECS schéma:
---
define:
  type: parsec/mapping
  schema: /Schemas/ECS.yaml

mapping:
  PRI: log.syslog.priority
  TIMESTAMP: "@timestamp"
  HOSTNAME: host.hostname
  PROCESS.NAME: process.name
  PROCESS.PID: process.pid
  MESSAGE: message
Po mapování vypadá výstup takto:
log.syslog.priority: 38
@timestamp: Sep 3 13:38:07
host.hostname: host01
process.name: systemd-logind
process.pid: 1078
message: New session 49 of user harrypotter
Obohacení závažnosti a zařízení syslogu
Zařízení a závažnost syslogu lze vypočítat z priority následujícím způsobem:
PRIORITY = FACILITY * 8 + SEVERITY

FACILITY = PRIORITY // 8
SEVERITY = PRIORITY (mod) 8
Výpočet lze dále optimalizovat pomocí bitových posunů.
Abychom obohatili událost o log.syslog.facility.code, log.syslog.facility.name, log.syslog.severity.code a log.syslog.severity.name, použijeme deklaraci obohacovače:
---
define:
  type: parsec/enricher
  schema: /Schemas/ECS.yaml

enrich:
  # SYSLOG ZAŘÍZENÍ
  log.syslog.facility.code: !SHR { what: !GET { from: !ARG EVENT, what: log.syslog.priority }, by: 3 }
  log.syslog.facility.name: !MATCH
                            what: !GET { from: !ARG EVENT, what: log.syslog.facility.code }
                            with:
                              0: kern
                              1: user
                              2: mail
                              3: daemon
                              4: auth
                              5: syslog
                              6: lpr
                              7: news
                              8: uucp
                              9: cron
                              10: authpriv
                              11: ftp
                              16: local0
                              17: local1
                              18: local2
                              19: local3
                              20: local4
                              21: local5
                              22: local6
                              23: local7

  # SYSLOG ZÁVAŽNOST
  log.syslog.severity.code: !AND [ !GET { from: !ARG EVENT, what: log.syslog.priority }, 7 ]
  log.syslog.severity.name: !MATCH
                            what: !GET {from: !ARG EVENT, what: log.syslog.severity.code}
                            with:
                              0: emergency
                              1: alert
                              2: critical
                              3: error
                              4: warning
                              5: notice
                              6: information
                              7: debug
To produkuje následující (a konečný) výstup, s přidanými poli:
log.syslog.priority: 38
log.syslog.severity.code: 6
log.syslog.severity.name: information
log.syslog.facility.code: 4
log.syslog.facility.name: auth
@timestamp: Sep 3 13:38:07
host.hostname: host01
process.name: systemd-logind
process.pid: 1078
message: New session 49 of user harrypotter
Syslog RFC5424
Zprávy Syslog RFC5424 mají strukturovanější formát než zprávy RFC3164. Událost ve formátu RFC5424 typicky sestává z následujících částí:
- priorita (PRI část): Číslo uzavřené v "<>" závorkách, které označuje zařízení a závažnost logu.
- verze: Verze syslog protokolu (obvykle "1").
- časová značka: Časová značka ve formátu YYYY-MM-DDThh:mm:ss.sTZD (např. 2003-10-11T22:14:15.003Z), podle RFC3339.
- hostname: Název zařízení, které událost vyprodukovalo.
- app-name: Název aplikace, která událost vyprodukovala.
- procid: ID procesu aplikace, která událost vyprodukovala.
- msgid: ID zprávy.
- structured-data: Volitelná strukturovaná data uzavřená v hranatých závorkách.
- zpráva: Část zprávy události.
Parsování hlavičky
Následující deklarace parseru rozděluje zprávu RFC5424 na její komponenty:
---
define:
  type: parsec/parser

parse:
  !PARSE.KVLIST
  - "<"
  - PRI: !PARSE.DIGITS
  - ">"
  - VERSION: !PARSE.DIGITS
  - !PARSE.SPACES
  - TIMESTAMP: !PARSE.DATETIME RFC3339  #(1)
  - !PARSE.SPACES
  - HOSTNAME: !PARSE.UNTIL " "
  - APPNAME: !PARSE.UNTIL " "
  - PROCID: !PARSE.UNTIL " "
  - MSGID: !PARSE.UNTIL " "
  - !PARSE.OPTIONAL { what: !PARSE.SPACES }
  - STRUCTURED_DATA: !PARSE.OPTIONAL { what: !PARSE.BETWEEN { start: "[", stop: "]" } }  #(2)
  - !PARSE.OPTIONAL { what: !PARSE.SPACES }
  - MESSAGE: !PARSE.CHARS
- Výraz
!PARSE.DATETIME RFC3339parsuje časovou značku podle formátu RFC3339. - Strukturovaná data jsou volitelná a uzavřená v hranatých závorkách. Výraz
!PARSE.OPTIONALzajišťuje, že parser může zpracovat zprávy bez strukturovaných dat.
Mapování na ECS schéma
Po proscanování celého logu vypadá výstup takto:
PRI: 38
VERSION: 1
TIMESTAMP: 2003-10-11T22:14:15.003Z
HOSTNAME: host01
APPNAME: myapp
PROCID: 1234
MSGID: ID47
STRUCTURED_DATA: [exampleSDID@32473 iut="3" eventSource="Application" eventID="1011"]
MESSAGE: An application event log entry...
Další fází je mapování na ECS schéma:
---
define:
  type: parsec/mapping
  schema: /Schemas/ECS.yaml
mapping:
  PRI: log.syslog.priority
  VERSION: log.syslog.version
  TIMESTAMP: "@timestamp"
  HOSTNAME: host.hostname
  APPNAME: process.name
  PROCID: process.pid
  MSGID: log.syslog.message_id
  STRUCTURED_DATA: log.syslog.structured_data
  MESSAGE: message
Po mapování vypadá výstup takto:
log.syslog.priority: 38
log.syslog.version: 1
@timestamp: 2003-10-11T22:14:15.003Z
host.hostname: host01
process.name: myapp
process.pid: 1234
log.syslog.message_id: ID47
log.syslog.structured_data: [exampleSDID@32473 iut="3" eventSource="Application" eventID="1011"]
message: An application event log entry...
Obohacení závažnosti a zařízení syslogu
Zařízení a závažnost syslogu lze vypočítat z priority následujícím způsobem:
PRIORITY = FACILITY * 8 + SEVERITY

FACILITY = PRIORITY // 8
SEVERITY = PRIORITY (mod) 8
Výpočet lze dále optimalizovat pomocí bitových posunů.
Abychom obohatili událost o log.syslog.facility.code, log.syslog.facility.name, log.syslog.severity.code a log.syslog.severity.name, použijeme deklaraci obohacovače:
---
define:
  type: parsec/enricher
  schema: /Schemas/ECS.yaml

enrich:
  # SYSLOG ZAŘÍZENÍ
  log.syslog.facility.code: !SHR { what: !GET { from: !ARG EVENT, what: log.syslog.priority }, by: 3 }
  log.syslog.facility.name: !MATCH
                            what: !GET { from: !ARG EVENT, what: log.syslog.facility.code }
                            with:
                              0: kern
                              1: user
                              2: mail
                              3: daemon
                              4: auth
                              5: syslog
                              6: lpr
                              7: news
                              8: uucp
                              9: cron
                              10: authpriv
                              11: ftp
                              16: local0
                              17: local1
                              18: local2
                              19: local3
                              20: local4
                              21: local5
                              22: local6
                              23: local7

  # SYSLOG ZÁVAŽNOST
  log.syslog.severity.code: !AND [ !GET { from: !ARG EVENT, what: log.syslog.priority }, 7 ]
  log.syslog.severity.name: !MATCH
                            what: !GET {from: !ARG EVENT, what: log.syslog.severity.code}
                            with:
                              0: emergency
                              1: alert
                              2: critical
                              3: error
                              4: warning
                              5: notice
                              6: information
                              7: debug
To produkuje následující (a konečný) výstup, s přidanými poli:
log.syslog.priority: 38
log.syslog.severity.code: 6
log.syslog.severity.name: information
log.syslog.facility.code: 4
log.syslog.facility.name: auth
log.syslog.version: 1
@timestamp: 2003-10-11T22:14:15.003Z
host.hostname: host01
process.name: myapp
process.pid: 1234
log.syslog.message_id: ID47
log.syslog.structured_data: [exampleSDID@32473 iut="3" eventSource="Application" eventID="1011"]
message: An application event log entry...
Detekce
LogMan.io Correlator
TeskaLabs LogMan.io Correlator je výkonná, rychlá a škálovatelná součást LogMan.io a TeskaLabs SIEM. Correlator je klíčovým prvkem pro efektivní kyberbezpečnost díky své schopnosti detekovat hrozby.
Correlator identifikuje specifické aktivity, vzorce, anomálie a hrozby v reálném čase podle pravidel detekce. Correlator pracuje v datovém proudu vašeho systému namísto diskového úložiště, což z něj činí rychlý a jedinečně škálovatelný bezpečnostní mechanismus.
Co Correlator dělá?
Correlator sleduje události a jejich časovou souvislost ve vztahu k širšímu vzorci či aktivitě.
- Nejprve identifikujete vzorec, hrozbu nebo anomálii, kterou chcete, aby Correlator monitoroval. Napíšete detekci, která definuje aktivitu, včetně toho, jaké typy událostí (logů) jsou relevantní a kolikrát se musí událost vyskytnout v definovaném časovém rámci, aby byla vyvolána reakce.
-
Correlator identifikuje relevantní příchozí události a organizuje je nejprve podle určitého atributu v události (dimenze), jako je zdrojová IP adresa nebo uživatelské ID, a poté třídí události do krátkých časových intervalů, takže může analyzovat počet událostí. Časové intervaly jsou také definovány pravidlem detekce.
Poznámka: Nejčastěji se v Correlatoru používá funkce sum pro počítání událostí, které se vyskytly ve specifikovaném časovém rámci. Correlator může také analyzovat za použití dalších matematických funkcí.
-
Correlator analyzuje tyto dimenze a časové intervaly, aby zjistil, zda se relevantní události vyskytly ve stanoveném časovém rámci. Když Correlator detekuje aktivitu, vyvolá reakci specifikovanou v detekci.
Jinak řečeno, tento mikroslužba sdílí stav událostí v časových intervalech a používá klouzavé okno pro analýzu.
Co je klouzavé analýzové okno?
Použití klouzavého okna analýzy znamená, že Correlator může kontinuálně analyzovat více časových intervalů. Například při analýze období 30 sekund Correlator posouvá své 30 sekundové okno analýzy tak, aby překrýval předchozí analýzy, jak čas postupuje.


Tento obrázek představuje jedinou dimenzi, například analýzu událostí se stejnou zdrojovou IP adresou. Ve skutečném pravidle detekce byste měli několik řad této tabulky, jedna řada pro každou IP adresu. Více v příkladu níže.
Klouzavé okno umožňuje analyzovat překrývající se 30 sekundové časové rámce 0:00-0:30, 0:10-0:40, 0:20-0:50 a 0:30-0:60 namísto pouze 0:00-0:30 a 0:30-0:60.
Příklad
Příklad scénáře: Vytvoříte detekci, která vás upozorní, když je učiněno 20 pokusů o přihlášení ke stejnému uživatelskému účtu během 30 sekund. Protože tato rychlost zadávání hesel je vyšší, než by většina lidí mohla dosáhnout sami, může tato aktivita naznačovat útok hrubou silou.
Aby Correlator mohl detekovat tuto bezpečnostní hrozbu, potřebuje vědět dvě věci:
- Které události jsou relevantní. V tomto případě to znamená neúspěšné pokusy o přihlášení ke stejnému uživatelskému účtu.
- Kdy se tyto události (pokusy o přihlášení) staly ve vztahu k sobě navzájem.
Poznámka: Následující logy a obrázky jsou závažně zjednodušeny pro lepší ilustraci myšlenek.
1. Tyto logy se vyskytují v systému:


Co tyto logy znamenají?
Každá tabulka, kterou vidíte výše, je log pro událost jednoho neúspěšného pokusu o přihlášení uživatele.
log.ID: Unikátní identifikátor logu, jak je vidět v tabulce nížetimestamp: Čas, kdy se událost odehrálausername: Correlator bude analyzovat skupiny logů od stejných uživatelů, protože by nebylo efektivní analyzovat pokusy o přihlášení napříč všemi uživateli dohromady.event.message: Correlator hledá pouze neúspěšné přihlášení, jak by bylo definováno pravidlem detekce.
2. Correlator začíná sledovat události v řádcích a sloupcích:


- Uživatelské jméno je dimenze, jak je definováno pravidlem detekce, takže každý uživatel má svůj vlastní řádek.
- Log ID (A, B, C, atd.) je zde v tabulce, aby bylo vidět, které logy jsou počítány.
- Číslo v každé buňce je kolik událostí se v daném časovém intervalu pro daného uživatele (dimenze) vyskytlo.
3. Correlator pokračuje ve sledování událostí:
Vidíte, že jeden účet nyní zažívá vyšší objem neúspěšných pokusů o přihlášení.


4. Zároveň Correlator analyzuje 30-sekundové časové rámce pomocí analýzového okna:


Analýzové okno se pohybuje přes časové intervaly a počítá celkový počet událostí v 30-sekundových časových rámcích. Vidíte, že když analýzové okno dosáhne časového rámce 01:20-01:50 pro uživatelské jméno anna.s.ample, spočítá více než 20 událostí. To by vyvolalo reakci z Correlatoru, jak je definováno v detekci (více o triggerech zde).
Gif pro ilustraci pohybu analýzového okna


30-sekundové analýzové okno "klouže" nebo "roluje" podél časových intervalů a počítá, kolik událostí se stalo. Když najde 20 nebo více událostí v jedné analýze, akce z pravidla detekce je spuštěna.
Paměť a úložiště
Correlator funguje v datovém proudu, ne v databázi. To znamená, že Correlator sleduje události a provádí analýzu v reálném čase, jakmile se události stávají, namísto tahání minulých sbíraných událostí z databáze k provedení analýzy.
Aby mohl fungovat v datovém proudu, Correlator používá mapování paměti, což mu umožňuje fungovat v rychle přístupné paměti systému (RAM) spíše než spoléhat na diskové úložiště.
Mapování paměti poskytuje významné výhody:
- Detekce v reálném čase: Data v RAM jsou rychlejší na přístup než data z diskového úložiště. To činí Correlator velmi rychlým, což vám umožňuje detekovat hrozby okamžitě.
- Simultánní zpracování: Větší kapacita zpracování umožňuje Correlatoru provozovat mnoho paralelních detekcí najednou.
- Škálovatelnost: Objem dat v systému pro shromažďování logů pravděpodobně vzroste, jak vaše organizace poroste. Correlator může držet krok. Alokace další RAM je rychlejší a jednodušší než zvětšování diskového úložiště.
- Perzistence: Pokud se systém neočekávaně vypne, Correlator neztrácí data. Historie Correlatoru je často zálohována na disk (SSD), takže data jsou dostupná, když se systém znovu spustí.
Pro více technických informací navštivte naše referenční dokumentaci Correlatoru.
Správa upozornění
Každé pravidlo detekce a korelace odesílá signál pro správu upozornění, aby vytvořilo tiket, aktualizovalo existující a nastavilo plán pro hlavní přechody tiketů.
Co je detekce?
Detekce (někdy nazývaná korelační pravidlo) definuje a nachází vzorce a specifické události ve vašich datech. Velký objem událostních logů prochází vaším systémem a detekce pomáhají identifikovat události a kombinace událostí, které mohou být výsledkem bezpečnostního narušení nebo systémové chyby.
Důležité
- Možnosti vašich detekcí závisí na vaší Konfiguraci korelátoru.
- Všechny detekce jsou psány v TeskaLabs SP-Lang. K dispozici je rychlý průvodce SP-Lang v příkladu korelace okna a další pokyny pro detekci.
Co mohou detekce dělat?
Můžete napsat detekce, které popisují a nacházejí nekonečnou kombinaci událostí a vzorců, ale toto jsou běžné aktivity k monitorování:
- Více neúspěšných pokusů o přihlášení: Četné neúspěšné pokusy o přihlášení během krátké doby, často ze stejné IP adresy, kvůli zachycení brute-force nebo útoků pomocí posypávání hesel.
- Neobvyklý přenos nebo exfiltrace dat: Abnormální nebo velký přenos dat z vnitřní sítě na externí místa.
- Skenování portů: Pokusy o identifikaci otevřených portů na síťových zařízeních, které mohou být předzvěstí útoku.
- Neobvyklé hodiny aktivity: Aktivita uživatelů nebo systému během nepracovních hodin, což by mohlo naznačovat kompromitovaný účet nebo vnitřní hrozbu.
- Geografické anomálie: Přihlášení nebo aktivity pocházející z neočekávaných geografických míst na základě typického chování uživatele.
- Přístup k citlivým zdrojům: Neoprávněné nebo neobvyklé pokusy o přístup k důležitým nebo citlivým souborům, databázím nebo službám.
- Změny kritických systémových souborů: Neočekávané změny systémových a konfiguračních souborů.
- Podozrivá e-mailová aktivita: Phishingové e-maily, přílohy s malwarem nebo jiné typy škodlivého obsahu v e-mailech.
- Eskalatace privilegií: Pokusy o eskalaci privilegií, například když se běžný uživatel snaží získat přístup na úrovni administrátora.
Začínáme
Pečlivě plánujte své korelační pravidlo, abyste se vyhli chybějícím důležitým událostem nebo přitahování pozornosti k irelevantním událostem. Odpovězte na otázky:
- Jakou aktivitu (události nebo vzorce) chcete detekovat?
- Které logy jsou relevantní pro tuto aktivitu?
- Co chcete, aby se stalo, pokud bude aktivita detekována?
Pro začátek psaní detekce si prohlédněte tento příklad korelace okna a postupujte podle těchto dalších pokynů.
Nasazení detekčních pravidel
Po napsání nebo úpravě detekčního pravidla v Knihovně je stále potřeba ho pro tenant povolit. Povolení říká LogMan.io, která pravidla mají běžet v produkci. Dokud pravidlo není povoleno, zůstává v Knihovně, ale nezpracovává živé události.
Tato stránka popisuje, jak povolit pravidla z obrazovky Detekce, co znamenají stavové štítky a metriky a jak nasazení souvisí s psaním pravidel v Knihovně.
Kdo to může dělat?
K otevření obrazovky Detekce potřebujete oprávnění lmio:detection:access. Pro zaškrtávání polí a kliknutí na Povolit také lmio:detection:edit. K otevření pravidla v Knihovně potřebujete asab:library:access.
Kde pracovat
| Místo | Co tam děláte |
|---|---|
| Knihovna | Vytváření, úpravy a testování detekčních pravidel (YAML soubory) |
| Detekce | Volba, která pravidla jsou pro tenant povolena |
| Discover | Vyšetřování událostí a triggerů pro konkrétní pravidlo |
Obrazovka Detekce se nazývá Přehled detekcí a korelací. Otevřete ji z hlavního menu (ikona brýlí). Strom zobrazuje pravidla ze dvou oblastí Knihovny:
- Correlations — korelační pravidla (window, match, sigma a podobné typy)
- Detections — detekční pravidla v širším stromu detections
Pravidla, která nejsou povolena, jsou ve stromu vidět, ale nemají zelený štítek povoleno.
Povolení pravidel krok za krokem
1. Projděte strom pravidel
Po načtení obrazovky LogMan.io zobrazí:
- Všechna pravidla a složky z Knihovny
- Která pravidla jsou aktuálně povolena (zelený štítek)
- Živé metriky za poslední hodinu (pokud jsou k dispozici)
Vypnuté položky Knihovny jsou zešedlé. Pravidlo vypnuté v Knihovně nemůžete povolit, dokud ho administrátor nebo editor souboru znovu nezapne.
2. Vyberte, co má běžet
Použijte zaškrtávací políčka ve stromu:
- Jedno pravidlo — zaškrtněte řádek jednoho YAML souboru
- Složka — zaškrtněte složku a vyberete všechna pravidla uvnitř (včetně podsložek)
- Zrušení výběru — odškrtněte pravidlo nebo složku
Tooltip u políčka říká Zaškrtnout pro nasazení.
Složky vs. jednotlivá pravidla
Celou složku můžete povolit, když mají běžet všechna pravidla uvnitř, nebo vybrat jednotlivé soubory, když potřebujete jen část složky. Kořenové úrovně Correlations a Detections nemají políčka. Vždy vybíráte složky nebo soubory pod nimi.
Speciální složky: Pravidla pod Detections → Parsec a Detections → Filters se spravují jinak. Ve stromu jsou vždy zobrazena jako povolená a z této obrazovky je nelze přepínat.
3. Klikněte na Povolit
Klikněte na tlačítko Povolit vpravo nahoře.
LogMan.io uloží celý výběr pro tenant. Zpráva Detekční pravidla byla úspěšně nasazena potvrzuje změnu. Strom se znovu načte a povolená pravidla mají zelený štítek.
Povolit nahrazuje celý seznam
Povolit vždy uloží kompletní sadu zaškrtnutých pravidel. Pokud pravidlo odškrtnete a znovu kliknete na Povolit, pravidlo se z produkce odstraní. Samostatné tlačítko Zakázat neexistuje.
4. Ověření v Discover (volitelné)
U povoleného pravidla klikněte na oblast metrik v řádku a otevřete Discover filtrovaný na to pravidlo (poslední hodina). Pomůže ověřit, že triggery nebo zásahy predikátu vypadají rozumně po nasazení.
Stav a metriky
Štítek povoleno
Zelený štítek povoleno na řádku znamená, že cesta pravidla je součástí nasazení tenantu. Pokud jste povolili složku, každý soubor pod ní zahrnutý ve výběru štítek zobrazí.
Metriky na každém řádku
Metriky se obnovují přibližně každých 60 sekund. Popisují poslední hodinu, pokud časový rozsah jinde nezměníte.
| Popisek | Význam |
|---|---|
| Trigger In (zvonek) | Kolikrát pravidlo dosáhlo fáze trigger |
| Predicate Hit (šipka) | Kolik událostí odpovídalo predikátu pravidla |
| Total time | Čas zpracování pravidla (všechny fáze) |
| P / E / A / T | Čas v Predicate, Evaluate, Analyze nebo Trigger (window pravidla) |
Na řádku složky jsou čísla agregovaná ze všech podřízených pravidel. Řádky složek nevedou do Discover.
Zvýrazněné písmeno pod P / E / A / T ukazuje fázi s nejvyšším časem. Pokud je Total time vysoké, viz Sledování výkonu detekcí.
Typické postupy
Zapnutí nového pravidla, které jste napsali
- Uložte a otestujte pravidlo v Knihovně
- Otevřete Detekce
- Najděte soubor pravidla a zaškrtněte ho (nebo zaškrtněte nadřazenou složku)
- Klikněte na Povolit
- Počkejte na metriky a podle potřeby otevřete Discover z řádku pravidla
Vypnutí pravidla bez smazání
- Otevřete Detekce
- Odškrtněte pravidlo (nebo složku, pokud jste povolili celou složku)
- Klikněte na Povolit
Soubor pravidla zůstane v Knihovně. Jen přestane zpracovávat živé události.
Povolení mnoha pravidel najednou
- Zaškrtněte složku (např. složku dodavatele nebo use case pod Correlations)
- Zkontrolujte, že všechny soubory pod ní mají běžet
- Klikněte na Povolit
Administrátor může nastavit limity počtu pravidel na instanci correlatoru. Velmi velké složky platforma automaticky rozdělí. Z UI to nekonfigurujete.
Složky Sigma a instance correlatoru
Pravidla pod Detections → Sigma (/Detections/Sigma/) se seskupují do instancí correlatoru maximálně tři úrovně složek pod tím kořenem (např. /Detections/Sigma/windows/builtin/security/). Hlubší vnořené složky sdílejí stejnou instanci. Ostatní stromy Knihovny (např. Correlations) stále mapují jeden correlator na nejbližší vybranou složku. Operátoři to konfigurují v Tenant Rex; viz Tenant Rex.
Úprava pravidla, které už je povoleno
- Otevřete pravidlo ze stromu Detekce (název vede do Knihovny)
- Upravte a otestujte v Knihovně
- Uložte soubor
Pokud pravidlo zůstane zaškrtnuté na obrazovce Detekce, po reloadu correlatorů na platformě běží s aktualizovaným obsahem. Znovu klikat na Povolit nemusíte, pokud jste nezměnili, která pravidla jsou vybrána.
Jak to do sebe zapadá
flowchart LR
    LIB[Knihovna: psaní a test pravidel]
    DET[Detekce: výběr a Povolit]
    RUN[Correlatory spouštějí povolená pravidla]
    DIS[Discover: vyšetřování událostí]

    LIB --> DET
    DET --> RUN
    RUN --> DIS
Na pozadí LogMan.io Tenant Rex uloží výběr, aktualizuje konfiguraci correlatorů a restartuje služby correlatorů v clusteru. Servery z obrazovky Detekce nespravujete. Detaily pro operátory: Tenant Rex.
Oprávnění a řešení problémů
| Problém | Co zkontrolovat |
|---|---|
| Menu Detekce chybí | Požádejte o lmio:detection:access |
| Políčka jsou neaktivní | Požádejte o lmio:detection:edit |
| Nelze otevřít název pravidla | Požádejte o asab:library:access |
| Pravidlo povoleno, ale bez metrik | Počkejte jeden cyklus obnovy (~60 s); ověřte, že události odpovídají logsource |
| Pravidlo povoleno, ale v Discover žádné triggery | Predikát může být příliš přísný; zkontrolujte event lane a časový rozsah |
| Pravidlo ve stromu zešedlé | Soubor je vypnutý v Knihovně |
Související čtení
- Co je detekce?: koncepty a typy pravidel
- Sledování výkonu detekcí: čtení metrik a ladění pomalých pravidel
- Predikáty a Triggery — stavební kameny pravidel
- Uživatelský manuál — obecná navigace ve webové aplikaci
Psaní detekčního pravidla typu korelace okna
Pravidlo pro korelaci okna je velmi všestranný typ detekce, který může identifikovat kombinace událostí v čase. Tento příklad ukazuje některé techniky, které můžete použít při psaní pravidel pro korelaci okna, ale existuje mnoho dalších možností, takže tato stránka vám poskytne další vedení.
Než budete moci napsat nové detekční pravidlo, musíte:
- Rozhodnout, jakou aktivitu hledáte, a rozhodnout časový rámec, ve kterém je tato aktivita významná.
- Identifikovat, který zdroj dat produkuje logy, které by mohly spustit pozitivní detekci, a zjistit, jaké informace tyto logy obsahují.
- Rozhodnout, co chcete, aby se stalo, když je aktivita detekována.
Použijte TeskaLabs SP-Lang pro psaní korelačních pravidel.
Sekce korelačního pravidla
Zahrňte následující sekce do vašeho pravidla:
- Define: Informace, které popisují vaše pravidlo.
- Predicate: Sekce
predicateje filtr, který identifikuje, které logy vyhodnotit, a které logy ignorovat. - Evaluate: Sekce
evaluatetřídí nebo organizuje data k analýze. - Analyze: Sekce
analyzedefinuje a hledá požadovaný vzorec — včetně testovacího výrazu uvnitřanalyze.test, který rozhodne, kdy okno odpovídá (viz níže). - Trigger: Sekce
triggerdefinuje, co se stane při pozitivní detekci. - Test (volitelné): Top-level testovací případy s ukázkovými událostmi a očekávaným výstupem pro offline validaci pravidla.
K lepšímu pochopení struktury korelačního pravidla okna konzultujte tento příklad.
Výkon
Po nasazení pravidla otevřete Detekce ve webové aplikaci a zkontrolujte Total time. Udržujte Total time pod 5 sekundami; pokud je vyšší, optimalizujte predikáty (strukturovaná pole, ne podřetězec v message).
Závorky
Slova v závorkách () jsou zástupné symboly, které ukazují, že by v této části obvykle byla hodnota. Korelační pravidla nepoužívají závorky.
Define
Vždy zahrňte do define:
| Položka v pravidlu | Jak zahrnout |
|---|---|
|
Pojmenujte pravidlo. I když název nemá žádný vliv na funkčnost pravidla, měl by být jasný a snadno pochopitelný pro vás i ostatní. |
|
Popište pravidlo stručně a přesně. Popis také nemá vliv na funkčnost pravidla, ale může pomoct vám i ostatním pochopit, k čemu pravidlo slouží. |
|
Zahrňte tento řádek tak, jak je. type ovlivňuje funkčnost pravidla. Pravidlo používá correlator/window k fungování jako korelátor oken.
|
Pro nastavení skupiny pro hodnocení rizika přidejte do sekce define volbu lookup_group.
define:
  lookup_group: myGroup
Predicate
Sekce predicate je filtr. Při psaní predicate používáte SP-Lang výrazy ke struktuře podmínek filtru pro "povolení" pouze logů, které jsou relevantní k aktivitě nebo vzorci, který pravidlo detekuje.
Pokud log splňuje podmínky predikátu, je analyzován v dalších krocích detekčního pravidla spolu s dalšími souvisejícími logy. Pokud log nesplňuje podmínky predikátu, detekční pravidlo log ignoruje.
Viz tato příručka, abyste se dozvěděli více o psaní predikátů.
Evaluate
Jakýkoli log, který projde filtrem v predicate, je hodnocen v evaluate. Sekce evaluate organizuje data, aby mohla být analyzována. Obvykle nelze odhalit bezpečnostní hrozbu (nebo jiné významné vzorce) pouze na základě jedné události (například jednoho neúspěšného pokusu o přihlášení), proto je potřeba psát detekční pravidla k seskupení událostí dohromady, aby se našly vzorce, které ukazují na bezpečnostní nebo provozní problémy.
Sekce evaluate vytváří neviditelné hodnotící okno - můžete si okno představit jako tabulku. Tabulku používá sekce analyze k detekci aktivity, kterou hledá detekční pravidlo.
Můžete vidět příklad sekcí evaluate a analyze spolupracujících zde.
Položka v evaluate |
Jak zahrnout |
|---|---|
|
dimension vytváří řádky v tabulce. V tabulce jsou hodnoty specifikovaných polí seskupeny do jednoho řádku (viz tabulka níže).
|
|
by vytváří sloupce v tabulce. Ve většině případů je @timestamp správnou volbou, protože pravidla korelace oken jsou založena na čase. Takže každý sloupec v tabulce je interval času, který specifikuje resolution.
|
|
Jednotka resolution je sekundy. Každý časový interval bude počet sekund, které určíte.
|
|
Pole saturation nastavuje, kolikrát může být spouštěč aktivován, než pravidlo přestane počítat události v jedné buňce, které způsobily spuštění (viz tabulka níže). S doporučeným nasycením 1 přestanou být relevantní události, které se stanou v rámci stejného určeného časového rámce (resolution), počítány po jednom spuštění. Nastavení saturace na 1 zabraňuje dalšímu spouštění pro totožné chování ve stejném časovém rámci.
|
Analyze
analyze používá tabulku vytvořenou sekcí evaluate, aby zjistil, zda se stala aktivita, kterou hledá detekční pravidlo.
Můžete vidět příklad sekcí evaluate a analyze spolupracujících zde.
Položka v analyze |
Jak zahrnout |
|---|---|
|
Okno analyzuje specifikovaný počet buněk v tabulce vytvořené sekcí evaluate, z nichž každá představuje logy v určeném časovém rámci. Hoppingové okno: Okno bude počítat hodnoty v buňkách, testující všechny přilehlé kombinace buněk, aby pokryla stanovené časové období, s přesahem. Hoppingové okno je doporučeno. Tumblingové okno: Okno počítá hodnoty v buňkách, testující všechny přilehlé kombinace buněk, aby pokryla stanovené časové období, BEZ přesahu. Viz poznámka níže pro další informace o hoppingových a tumblingových oknech. |
|
aggregate závisí na dimension. Použijte unique count, abyste zajistili, že pravidlo nebude počítat stejnou hodnotu vašeho specifikovaného pole v dimension více než jednou.
|
|
Span nastavuje počet buněk v tabulce, které budou analyzovány najednou. span vynásobený resolution je časový rámec, ve kterém korelační pravidlo hledá vzorec nebo chování. (Například 2*60 je 2 minutový časový rámec.)
|
|
Výraz !GE znamená "větší než nebo rovno" a !ARG VALUE odkazuje na výstupní hodnotu funkce aggregate. Hodnota uvedená pod !ARG VALUE je počet unikátních výskytů hodnoty v jednom analyzačním okně, které spustí korelační pravidlo.
|
Hoppingová vs. tumblingová okna
Tato stránka o tumblingových a hoppingových oknech vám může pomoci pochopit různé typy analyzačních oken.
Agregace distance a velocity
Pro distance nastavte analyze.dimension na source.geo.location (nebo jiný geo point) pro impossible travel (práh v metrech), nebo na numerické pole pro kumulativní změnu mezi vzorky. Pro velocity použijte numerické pole (rychlost změny). Viz Window Correlator: distance a velocity.
Trigger
Po identifikaci podezřelé aktivity, kterou jste specifikovali, pravidlo může:
- Odeslat detekci do Elasticsearch jako dokument. Poté můžete vidět detekci jako log v TeskaLabs LogMan.io. Můžete vytvořit svůj vlastní dashboard pro zobrazení detekcí korelačních pravidel, nebo najít logy v Průzkumník.
- Poslat notifikaci emailem
Navštivte stránku triggerů pro nastavení triggerů vytvářejících události a stránku notifikací pro odesílání zpráv z detekcí.
Test (volitelné, pro validaci pravidla)
Top-level sekce test je volitelná. Je oddělená od analyze.test, což je SP-Lang výraz vyhodnocovaný na agregovaných hodnotách při živé korelaci (viz Analyze). Top-level test definuje pojmenované testovací případy pro syntetické události a ověření očekávaného výstupu triggeru — užitečné při psaní nebo revizi vícefázových window pravidel.
Struktura:
test: Mapa názvů případů na definice (např.test1,negative_no_trigger).lookups(volitelné, na případ): Seed dat lookupu pro offline validaci, když predikát používá lookupy. Deklarace musí existovat pod/Lookups/; viz Testování pravidel s lookupy.input: Seznam syntetických událostí. Každá by měla odpovídat schématu pravidla (např. ECS pole vpredicateaevaluate.dimension). Zahrňte:@timestamp: V interní časové reprezentaci korelačního pravidla (Nanosecond Counter Time), konzistentně s ostatními pravidly.tenant: Identifikátor tenantu pro test._id: Stabilní identifikátor každého řádku vstupu; očekávanérelated.eventsve výstupu na ně může odkazovat.- Další pole vyžadovaná predikáty (např.
we.channel,event.code,host.id,process.executable). output: Očekávaný výsledek korelace při spuštění — typicky pole complex / alert události (např.event.kind,event.dataset,event.risk_score,related.events,rule.id,rule.name,rule.description,rule.ruleset, dimenzní pole a MITRE nebo ECS threat metadata zdefine).
Příklad kostry:
trigger:
  - event:
      host.id: !ITEM EVENT host.id
      # ...

test:
  test1:
    input:
      - "@timestamp": 142446461673537536
        "we.channel": "Microsoft-Windows-Sysmon/Operational"
        "event.code": "1"
        "host.id": "test.host.domain"
        "tenant": "default"
        "_id": 1
      # ... další události splňující všechny fáze korelace

    output:
      tenant: default
      event.kind: alert
      event.dataset: complex
      related.events:
        - 1
        # ...
      rule.name: "Your rule name"
      rule.id: "/Correlations/Path/To/Your Rule.yaml"

  whitelist_case:
    lookups:
      excludedipaddresses:
        10.0.0.5: {}
    input:
      - "@timestamp": 142446461673537536
        source.ip: 10.0.0.5
        tenant: default
        _id: 2
    output: null   # pravidlo by nemělo spustit, když je IP na whitelistu
Důležité rozdíly:
| Sekce | Účel |
|---|---|
analyze.test |
SP-Lang výraz vyhodnocený na agregovaných výsledcích okna při živé korelaci (např. !GE na !ARG nebo !ARG VALUE). Vyžadováno pro spuštění pravidla. |
Top-level test |
Volitelné fixture: ukázkové události input a očekávaný output pro nástroje nebo ruční validaci chování pravidla. |
test.<case>.lookups |
Volitelné řádky lookupu pro daný případ, když predikát čte lookup; viz Testování pravidel s lookupy. |
Pokud pravidlo používá více vstupních fází (páry logsource + predicate pod inputs), syntetické události v test.input musí kolektivně splnit logiku korelace, aby test okna prošel a trigger vytvořil dokumentovaný output.
Příklad detekčního pravidla pro korelaci oken
Pravidlo pro korelaci oken je typ detekce, které může identifikovat kombinace událostí v průběhu času. Než použijete tento příklad pro napsání svého vlastního pravidla, navštivte tyto pokyny, abyste lépe porozuměli jednotlivým částem pravidla.
Jako všechna detekční pravidla, i pravidla pro korelaci oken píšeme v TeskaLabs SP-Lang.
Sigma korelace
Korelátor oken je také používán jako motor pro Sigma korelace, jejichž syntaxe může být takto nativně použita v LogMan.io. Pro více informací o Sigma korelacích, viz Dokumentace Sigma korelací.
Přejít na: Definovat | Predikát | Vyhodnotit | Analyzovat | Spustit
Toto detekční pravidlo hledá jednu externí IP adresu, která se snaží přistupovat ke 25 nebo více unikátním interním IP adresám během 2 minut. Tato aktivita může naznačovat pokus útočníka prohledávat síťovou infrastrukturu kvůli zranitelnosti.
Poznámka
Jakýkoli řádek začínající hashtag (#) je komentář, není součástí detekčního pravidla. Přidávejte poznámky do svých detekčních pravidel, aby ostatní lépe pochopili účel a funkci pravidel.
Kompletní detekční pravidlo pomocí korelace oken:
define:
  name: "Network T1046 Network Service Discovery"
  description: "Externí IP přistupující k 25+ interním IP adresám během 2 minut"
  type: correlator/window

  risk_score: 20.0

  mitre:
    tactic: TA0007
    technique: T1046

predicate:
  !AND
  - !OR
    - !EQ
      - !ITEM EVENT event.dataset
      - "fortigate"
    - !EQ
      - !ITEM EVENT event.dataset
      - "sophos"
  - !OR
    - !EQ
      - !ITEM EVENT event.action
      - "deny"
    - !EQ
      - !ITEM EVENT event.action
      - "drop"
  - !IN
    what: source.ip
    where: !EVENT
  - !NOT
    what:
      !STARTSWITH
      what: !ITEM EVENT source.ip
      prefix: "193.145"
  - !NE
    - !ITEM EVENT source.ip
    - "8.8.8.8"
  - !IN
    what: destination.ip
    where: !EVENT

evaluate:
  dimension: [tenant, source.ip]
  by: "@timestamp"
  resolution: 60
  saturation: 1

analyze:
  window: hopping
  aggregate: unique count
  dimension: destination.ip
  span: 2
  test:
    !GE
    - !ARG VALUE
    - 25

trigger:
  - event:
      !DICT
      type: "{str:any}"
      with:
        ecs.version: "1.10.0"
        lmio.correlation.depth: 1
        lmio.correlation.name: "Network T1046 Network Service Discovery"

        # Události
        events: !ARG EVENTS

        # Popis hrozby
        # https://www.elastic.co/guide/en/ecs/master/ecs-threat.html
        threat.framework: "MITRE ATT&CK"
        threat.software.platforms: "Network"
        threat.indicator.sightings: !ARG ANALYZE_RESULT

        threat.indicator.confidence: "Medium"
        threat.indicator.ip: !ITEM EVENT source.ip
        threat.indicator.port: !ITEM EVENT source.port
        threat.indicator.type: "ipv4-addr"

        threat.tactic.id: "TA0007"
        threat.tactic.name: "Discovery"
        threat.tactic.reference: "https://attack.mitre.org/tactics/TA0007/"

        threat.technique.id: "T1046"
        threat.technique.name: "Network Service Discovery"
        threat.technique.reference: "https://attack.mitre.org/techniques/T1046/"

        # Identifikace
        event.kind: "alert"
        event.dataset: "correlation"
        source.ip: !ITEM EVENT source.ip
Definovat
define:
  name: "Network T1046 Network Service Discovery"
  description: "Externí IP přistupující k 25+ interním IP adresám během 2 minut"
  type: correlator/window

  risk_score: 20.0

  mitre:
    tactic: TA0007
    technique: T1046
| Položka v pravidle | Co to znamená? |
|---|---|
|
To je název pravidla. Název je pro uživatele a nemá žádný dopad na samotné pravidlo. |
|
Popis je také pro uživatele. Popisuje, co pravidlo dělá, ale nemá žádný dopad na samotné pravidlo. |
|
Typ má dopad na pravidlo. Pravidlo používá correlator/window k fungování jako okno korelace.
|
Predikát
predicate je filtr, který kontroluje, zda příchozí log může souviset s událostí, kterou detekční pravidlo hledá.
Predikát je složen z výrazů SP-Lang. Výrazy vytvářejí podmínky. Pokud je výraz "pravdivý", je podmínka splněna. Filtr kontroluje příchozí log, aby zjistil, zda log činí výrazy predikátu "pravdivými" a tedy splňuje podmínky.
Pokud log splňuje podmínky predikátu, je analyzován dalším krokem detekčního pravidla spolu s dalšími souvisejícími logy. Pokud log nesplňuje podmínky predikátu, detekční pravidlo log ignoruje.
Kompletní dokumentaci k SP-Lang najdete zde.
Výrazy SP-Lang, v pořadí, ve kterém se objevují v predikátu
| Výraz | Význam |
|---|---|
!AND |
VŠECHNY kritéria vnořené pod !AND musí být splněny, aby !AND bylo pravdivé |
!OR |
Alespoň JEDNO z kritérií vnořených pod !OR musí být splněno, aby !OR bylo pravdivé |
!EQ |
"Rovná se". Musí se rovnat, nebo odpovídat hodnotě, aby bylo pravdivé |
!ITEM EVENT |
Získává informace z obsahu příchozích logů (přistupuje k polím a hodnotám v příchozích logech) |
!IN |
Hledá hodnotu v rozsahu hodnot (co v kde) |
!NOT |
Hledá opak výrazu vnořeného pod !NOT (následující co) |
!STARTSWITH |
Hodnota pole (co) musí začínat na specifikovaný text (prefix), aby byla pravdivá |
!NE |
"Nerovná se". Musí se NEROVNAT (nesmí odpovídat hodnotě), aby byla pravdivá |
Je vidět, že pod !AND je několik výrazů. Log musí splňovat VŠECHNY podmínky vnořené pod !AND, aby prošel přes filtr.
| Jak je vidno v pravidle | Co to znamená? |
|---|---|
|
To je první !OR výraz a má vnořeny dva !EQ výrazy, takže alespoň JEDNA !EQ podmínka vnořená pod toto !OR musí být pravdivá. Pamatujte, !ITEM EVENT získává hodnotu pole, které specifikuje. Pokud má příchozí log v poli event.dataset "fortigate" NEBO "sophos", pak log splňuje podmínku !OR.
Tento filtr přijímá události pouze ze zdrojů dat FortiGate a Sophos. FortiGate a Sophos poskytují bezpečnostní nástroje jako jsou firewally, takže toto pravidlo hledá události generované bezpečnostními nástroji, které možná již zachycují podezřelou aktivitu. |
|
Tato podmínka je strukturována stejně jako předchozí. Pokud má příchozí log hodnotu "deny" NEBO "drop" v poli event.action, pak log splňuje tuto podmínku !OR.
Hodnoty "deny" a "drop" v logu signalizují, že bezpečnostní zařízení, jako například firewall, zablokovalo pokus o přístup na základě autorizačních nebo bezpečnostních politik. |
|
Pokud pole source.ip existuje v příchozím logu (!EVENT), pak log splňuje tuto podmínku !IN.
Pole source.ip je IP adresa, která se snaží získat přístup k jiné IP adrese. Protože toto pravidlo se specificky týká IP adres, log musí obsahovat zdrojovou IP adresu, aby byl relevantní.
|
|
Pokud hodnota pole source.ip NEZAČÍNÁ na "193.145", pak je tento výraz !NOT pravdivý. 193.145 je začátek interních IP adres této sítě, takže výraz !NOT filtruje interní IP adresy. To proto, že interní IP adresy přistupující k mnoha jiným interním IP adresám v krátkém časovém období by nebyly podezřelé. Pokud by nebyly interní IP adresy vyfiltrovány, pravidlo by vracelo falešně pozitivní výsledky.
|
|
Pokud příchozí log NEMÁ hodnotu "8.8.8.8" v poli source.ip, pak log splňuje tuto podmínku !NE.
Pravidlo filtruje 8.8.8.8 jako zdrojovou IP adresu, protože je to známý a důvěryhodný DNS resolver provozovaný společností Google. 8.8.8.8 obecně není spojována s podezřelou aktivitou, takže pokud bychom ji nevyloučili, pravidlo by vyvolalo falešně pozitivní výsledky. |
|
Pokud pole destination.ip existuje v příchozím logu, pak log splňuje tuto podmínku !IN.
Pole destination.ip je IP adresa, ke které je přistupováno. Protože toto pravidlo se specificky týká IP adres, log musí obsahovat cílovou IP adresu, aby byl relevantní.
|
Pokud příchozí log splní VŠECHNY podmínky uvedené výše (vnořené pod !AND), pak je log vyhodnocován a analyzován v dalších částech detekčního pravidla.
Vyhodnotit
Každý log, který projde filtrem v predicate, je vyhodnocen v evaluate. Sekce evaluate organizuje data tak, aby mohla být analyzována. Obvykle není možné rozpoznat bezpečnostní hrozbu (nebo jiné významné vzory) pouze na základě jedné události (např. jednoho neúspěšného pokusu o přihlášení), takže detekční pravidlo skupinuje události, aby našlo vzory, které ukazují na bezpečnostní nebo provozní problémy.
Sekce evaluate vytváří neviditelné hodnotící okno - můžete si ho představit jako tabulku. Tuto tabulku používá sekce analyze k detekci události, kterou detekční pravidlo hledá.
evaluate:
  dimension: [tenant, source.ip]
  by: "@timestamp"
  resolution: 60
  saturation: 1
| Jak je vidno v rámci pravidla | Co to znamená? |
|---|---|
|
dimension vytváří řádky v tabulce. Řádky jsou tenant a source.ip. V konečné tabulce jsou hodnoty tenant a source.ip seskupeny do jednoho řádku (viz tabulka níže).
|
|
by vytváří sloupce v tabulce. Odkazuje na pole @timestamp, protože hodnoty z tohoto pole umožňují pravidlu porovnávat události v průběhu času. Takže každý sloupec je interval času, který specifikuje resolution.
|
|
Jednotkou resolution jsou sekundy, takže hodnota zde je 60 sekund. Každý časový interval bude dlouhý 60 sekund.
|
|
Pole saturation nastavuje, kolikrát může být spouštěč aktivován, než pravidlo přestane počítat události v jedné buňce, která způsobila spouštěč (viz tabulka ní |
Pokročilá korelační pravidla
Tato stránka popisuje vícestupňové window detekce z korelační knihovny: šest pravidel pod /Correlations/Advanced/ a dvě související Sysmon window pravidla pod /Correlations/Microsoft/Sysmon/, která analytici často validují ve stejných lab cvičeních.
Každé pravidlo hledá posloupnost souvisejících událostí v krátkém časovém okně (typicky 15 až 60 minut), ne jediný podezřelý řádek logu. Window pravidla odpovídají na jinou otázku než match pravidla: stalo se na stejném hostu nebo uživateli několik podezřelých kroků v pořadí?
Pravidla jsou označena experimental nebo test. Validaci provádějte jen v kontrolovaném testovacím prostředí (izolovaný lab host nebo dedikovaný test tenant). Bez schválení neprovádějte simulace útoků na produkci.
Než začnete
- Ověřte, že pravidla jsou nasazena v Knihovně (
/Correlations/Advanced/a kde je uvedeno/Correlations/Microsoft/Sysmon/). - Zajistěte, že Correlator konzumuje relevantní logové zdroje (Windows Security a Sysmon pro většinu pravidel; sign-in logy identity providera pro travel pravidlo).
- Pro Sysmon endpointy použijte Common Library konfiguraci a WEF forwarding z Konfigurace Sysmon.
- Otevřete Discover pro hledání příchozích událostí, Detections pro potvrzení nasazení pravidla a metrik, Alerts pro tikety z detekcí.
- Po posledním testovacím kroku počkejte několik minut na ingest a korelaci. Window pravidla potřebují všechny fáze uvnitř nastaveného časového rámce.
Když pravidlo funguje podle očekávání, Correlator vytvoří complex událost (event.dataset: complex) s názvem pravidla, risk score a related.events propojujícími přispívající aktivitu. Pokud pravidlo posílá signál do Alert Management (výchozí), uvidíte také tiket v Alerts pro triage analytika.
Impossible Travel, MFA, and High Risk
Co detekuje
Scénář: Útočník se přihlásí ukradeným heslem z neobvyklé lokace, identity platforma označí relaci jako rizikovou a uživatel (nebo útočník) interaguje s MFA.
Pravidlo vytvoří critical complex událost, když stejný uživatelský účet v rámci přibližně 20 minut ukáže několik signálů identity rizika:
- Úspěšné přihlášení ze dvou různých zemí (impossible travel).
- Registrace nebo první použití nového zařízení při přihlášení.
- MFA výzva, která byla zamítnuta nebo později potvrzena.
- Zvýšené identity risk score hlášené identity platformou.
Je určeno pro cloud identity providery (Microsoft Entra ID, Okta, VPN portály s geo obohacením), ne pro samotné Windows server logony.
Jak testovat
- Použijte testovacího uživatele v sandboxu identity providera nebo lab tenantu.
- Přihlaste se úspěšně z lokace v zemi A (nebo simulujte schváleným VPN výstupem v té zemi).
- Do 20 minut se přihlaste znovu ze země B prohlížečem nebo zařízením, které IdP považuje za nové (vymažte cookies zařízení, použijte nový profil prohlížeče nebo zaregistrujte nové test zařízení).
- Dokončete nebo nezdařte MFA výzvu při druhém přihlášení.
- Zajistěte, že IdP emituje sign-in záznam se zvýšeným risk score pro uživatele (Entra ID Identity Protection, Okta ThreatInsight nebo ekvivalent).
Na co se dívat
V Discover filtrujte testovacího uživatele a event.category: authentication. Měli byste vidět úspěšná přihlášení ze dvou zemí, signál nového zařízení, události výsledku MFA a pole risk score na alespoň jedné události.
Po poslední fázi očekávejte jednu complex událost pro toto pravidlo v Discover a tiket v Alerts s uživatelem a výsledkem MFA a souvisejícími autentizačními událostmi.
Znaky správného chování
- Pravidlo se spustí jen po všech čtyřech fázích, ne po jednom neobvyklém přihlášení.
- Complex událost je vázána na jednoho uživatele v celém řetězci.
- Pokud vynecháte krok nového zařízení nebo druhou zemi, pravidlo nemá vystřelit.
Ransomware Kill Chain
Co detekuje
Scénář: Operátoři ransomwaru připravují host na šifrování: zaplní disk novými soubory, zničí zálohy, zastaví bezpečnostní nebo zálohovací služby, přejmenují data na ransom přípony, pak komunikují s command and control.
Pravidlo propojí ranou přípravu ransomwaru na Windows hostu v rámci přibližně 30 minut:
- Mnoho nových souborů v krátkém období (hromadné staging).
- Smazání shadow copy (např. přes
vssadminnebowmic). - Zastavení nebo zakázání bezpečnostních nebo zálohovacích služeb.
- Hromadné přejmenování na běžné ransom přípony (
.encrypted,.locked,.cryptonebo přípony z lookupu ransomwaru). - Odchozí command and control komunikace shodná s threat intelligence.
Je širší a pozdější v útoku než Ransomware Activity Detected (níže), které se zaměřuje na tři odlišné prekurzory na jednom hostu.
Jak testovat
Na lab Windows serveru nebo workstation se Sysmon a Security auditingem se přihlaste jako test administrátor:
- Vytvořte alespoň deset nových souborů v test složce (krátká PowerShell smyčka nebo batch skript stačí).
- V elevated příkazovém řádku spusťte smazání shadow copy:
vssadmin delete shadows /all /quiet(jen lab). - Změňte start typ služby Windows Defender na disabled, nebo zastavte zálohovací službu, aby se vygeneroval záznam v System logu.
- Přejmenujte alespoň pět test souborů na přípony jako
.encryptednebo.locked. - Pokud prostředí feeduje threat intelligence do síťových nebo threat kategorií, vygenerujte nebo přehrávejte test událost shodnou se známým C2 indikátorem ze stejného hostu (volitelné v minimálních testech; první čtyři fáze mohou stačit pro validaci staging logiky).
Všechny kroky proveďte do 30 minut na stejném hostu.
Na co se dívat
V Discover hledejte podle host.hostname a ověřte vytvoření souborů (Sysmon event 11 nebo file audit), process create pro vssadmin, zprávy o změně služby zmiňující Defender nebo zálohu a rename události na .encrypted souborech.
Očekávejte complex událost pro Ransomware Kill Chain v Discover a critical tiket v Alerts pro host s kontextem procesů a souborů.
Znaky správného chování
- Vytvoření jen jednoho nebo dvou souborů pravidlo nemá spustit.
- Kroky rozptýlené na různé hosty nemají splynout do jedné complex události.
- Complex událost by měla referencovat stejné
host.hostnamev celém řetězci.
Ransomware Activity Detected
Cesta v knihovně: /Correlations/Microsoft/Sysmon/Ransomware Activity Detected.yaml
Co detekuje
Scénář: Host se připravuje na nebo už podstupuje dopad ransomwaru: zálohy jsou smazané, soubory získávají ransom přípony a běží skriptovací nástroje pro enumeraci nebo šifrování.
Toto critical Sysmon a Security window pravidlo spojí tři fáze na stejném hostu do přibližně 15 minut:
- Inhibit recovery: Sysmon process create (event 1) pro
vssadmin.exenebowmic.exesdelete shadowsneboshadowcopy deletev command line. - Encryption pattern: Alespoň tři file události (Security 4663/4656/4659/4660 nebo Sysmon 11), kde
we.object.nameobsahuje ransom příponu jako.encrypted,.lockednebo.crypto(nebo příponu z lookupuransomwareextensions). - Script activity: Sysmon process create pro PowerShell (s
-enc,-encodedcommandneboGet-ChildItemv command line) nebo cmd.exe s/c.
Fáze 2 používá we.object.name z Windows Security logu (ObjectName). Sysmon 11 ukládá cesty do we.target.file_name, což samo o sobě nesplňuje toto pravidlo. Zapněte File System auditing a generujte Security 4663 na lab souborech, nebo spoléhejte na Security události z rename a access.
Jak testovat
Na lab Windows serveru nebo workstation se Sysmon a File System auditingem se přihlaste jako test administrátor přes RDP. Všechny kroky na stejném hostu do 15 minut.
- Fáze 1 (shadow copies): V elevated cmd nebo PowerShell spusťte
vssadmin.exe delete shadows /all /quiet(jen lab; smaže všechny Volume Shadow Copies). Pokud potřeba, použijtewmic shadowcopy delete. Ověřte, že Sysmon loguje process create provssadmin.exenebowmic.exe, ne jen parentcmd.exe. - Fáze 2 (ransom přípony): Zapněte File System audit success, pokud ještě není. Vytvořte test složku (např.
C:\Temp\lab-ransomware). Vytvořte soubory, přejmenujte alespoň tři na.encrypted,.lockeda.crypto, pak každý přečtěte, aby Security logoval 4663 (nebo 4656) s plnou cestou vwe.object.name. - Fáze 3 (scripting): Spusťte PowerShell s encoded příkazem, např.:
powershell.exe -NoProfile -enc <Base64 neškodného příkazu jako Write-Output "lab-test">
Na co se dívat
V Discover (posledních 30 minut, stejné host.hostname):
- Fáze 1:
event.code:1 AND process.executable:*vssadmin* AND we.command_line:*delete*shadow* - Fáze 2:
event.code:(4663 OR 4656) AND we.object.name:*lab-ransomware* - Fáze 3:
event.code:1 AND process.executable:*powershell* AND we.command_line:*-enc*
Ignorujte nesouvisející Security šum (např. DHCP soubory pod c:\windows\system32\dhcp\). Filtrujte cestu test složky.
Očekávejte complex událost pro Ransomware Activity Detected a critical tiket v Alerts.
Znaky správného chování
- Samotné smazání shadow copy pravidlo nemá spustit.
- Méně než tři file události s ransom příponami nemají spustit pravidlo.
- Fáze na různých hostnames nemají splynout.
- Toto pravidlo je také feeder pro MITRE Attack Chain Incident (fáze Execution).
Trojan Activity via File Download and Execution
Cesta v knihovně: /Correlations/Microsoft/Sysmon/Trojan Activity via File Download and Execution.yaml
Co detekuje
Scénář: Uživatel nebo skript stáhne payload, spustí ho přes command interpreter a načte script host nebo LOLBin, které trojany často zneužívají (typické pro phishing a drive-by následky).
Toto critical Sysmon window pravidlo propojí tři fáze na stejném hostu a stejném uživatelském kontextu (host.id a we.user.data) do přibližně 20 minut:
- Download: Sysmon process create (event 1), kde
process.executableobsahujecurl,wgetnebobitsadmin. - Execution: Sysmon process create (event 1), kde
we.command_lineobsahujecmd.exe, encoded PowerShell neboregsvr32.exe /s. - Script or LOLBin load: Sysmon image load (event 7), kde
process.executableobsahujemshta.exe,rundll32.exenebowscript.exe.
Vzor odpovídá běžným post-compromise řetězcům (např. Qakbot styl download, cmd staging, wscript nebo mshta execution).
Jak testovat
Na lab Windows workstation nebo serveru se Sysmon (události 1 a 7) se přihlaste jako test uživatel přes RDP. Zůstaňte na stejném hostu a stejné user session do 20 minut.
- Fáze 1 (download): Stáhněte neškodný soubor vestavěným nástrojem, např.:
curl.exe -o C:\Temp\lab-test.ico https://www.microsoft.com/favicon.ico - Fáze 2 (command line): Spusťte příkaz přes cmd, např.:
cmd.exe /c echo lab-test - Fáze 3 (script host): Vytvořte minimální test skript a spusťte wscript, např. jednořádkové
.vbsvC:\Tempswscript.exe //B //Nologo C:\Temp\lab-test.vbs.
Všechny tři kroky pod stejným interaktivním uživatelem, aby host.id a we.user.data seděly napříč fázemi.
Na co se dívat
V Discover (posledních 30 minut, stejný host a user kontext):
event.code:1 AND process.executable:*curl*event.code:1 AND we.command_line:*cmd.exe*event.code:7 AND process.executable:*wscript*rule.name:"Trojan Activity via File Download and Execution"
Očekávejte complex událost pro Trojan Activity via File Download and Execution v Discover a Critical tiket v Alerts.
Znaky správného chování
- Download bez cmd nebo wscript aktivity pravidlo nemá spustit.
wscriptbez předchozího downloadu na stejném hostu a uživateli nemá dokončit řetězec.- Toto pravidlo je feeder pro MITRE Attack Chain Incident (fáze Execution).
Pass the Hash Lateral Movement
Co detekuje
Scénář: Útočník znovu použije zachycený NTLM hash pro laterální pohyb: neúspěšné pokusy, pak úspěch, vzdálené spuštění a persistence styl nástroje na cíli.
Pravidlo popisuje vzor laterálního pohybu na jednom Windows hostu do přibližně 30 minut:
- Několik neúspěšných logonů (alespoň tři).
- Úspěšný logon pomocí NTLM.
- Vzdálené spuštění přes PsExec nebo WMI.
- Nová Windows služba nainstalovaná.
- PowerShell execution na hostu.
Jak testovat
Na lab Windows serveru (member server nebo domain controller v testu):
- Vygenerujte tři nebo více neúspěšných logonů pro stejný test účet (špatné heslo ze stejného nebo jiného stroje).
- Následně úspěšný NTLM logon pro tento účet (network logon na server často používá NTLM).
- Z jiného lab stroje spusťte PsExec proti cílovému serveru s neškodným příkazem, nebo WMI
process call createswmic. - Ověřte událost service installed v System logu (PsExec vytváří
PSEXESVC). - Spusťte viditelný PowerShell příkaz na cíli (např.
Get-Process) ve stejné relaci.
Veškerá aktivita na stejném cílovém hostname do 30 minut. Zapněte Audit Logon na cíli, aby 4624/4625 autentizační události byly v Discover.
Na co se dívat
V Discover filtrujte host.hostname a hledejte authentication failures, NTLM success, event code 7045 (service installed), Sysmon nebo 4688 process události pro powershell.exe.
Očekávejte complex událost pro Pass the Hash Lateral Movement v Discover a tiket v Alerts s hostem, uživatelem a PowerShell command line.
Znaky správného chování
- Dva neúspěšné logony samy nestačí.
- Aktivita rozdělená na nesouvisející hostnames nemá splynout.
- PsExec nebo WMI plus instalace služby a PowerShell by měly být v
related.events.
Privilege Escalation Chain
Co detekuje
Scénář: Útočník získá admin práva, přihlásí se elevovaným účtem, oslabí endpoint ochranu a spustí ofenzivní nástroje.
Na jednom Windows hostu do přibližně 30 minut pravidlo propojí:
- Uživatel přidán do privilegované skupiny (Administrators, Domain Admins nebo Enterprise Admins).
- Úspěšný logon tímto elevovaným účtem.
- Antivirus nebo endpoint protection oslaben (disabled nebo stopped).
- Spuštění podezřelého procesu (
powershell.exe,cmd.exe,rundll32.exeneboregsvr32.exe).
Jak testovat
Na lab domain joined Windows serveru:
- Přihlaste se jako domain admin a přidejte test uživatele do lokální skupiny Administrators (nebo Domain Admins v test OU). Vygeneruje security událost změny členství ve skupině.
- Odhlaste se a přihlaste jako elevovaný test uživatel na stejném serveru.
- V elevated relaci nastavte Windows Defender na disabled nebo zastavte službu WinDefend (jen lab).
- Spusťte PowerShell s jednoduchým neškodným skriptem (např. výpis služeb).
Všechny kroky na stejném hostu do 30 minut.
Na co se dívat
V Discover hledejte události změny skupiny, úspěšný logon test uživatele, změny konfigurace služby zmiňující Defender a process create pro PowerShell.
Očekávejte complex událost pro Privilege Escalation Chain v Discover a tiket v Alerts s hostem, elevovaným uživatelem a detaily PowerShell.
Znaky správného chování
- Přidání uživatele do skupiny bez následného logonu a process aktivity pravidlo nemá spustit.
- Zakázání Defenderu na hostu bez předchozí změny privilegií nemá spustit tento konkrétní řetězec.
- Complex událost by měla pojmenovat stejný host pro všechny fáze.
Living off the Land Chain
Co detekuje
Scénář: Malware se skrývá v důvěryhodných aplikacích: Office spustí PowerShell, PowerShell použije certutil pro stažení payloadu, pak signed LOLBin načte DLL.
Pravidlo najde fileless styl útokový řetězec na Windows, kdy Office nebo Teams spustí nástroje, které útočníci často zneužívají, do přibližně 30 minut:
- Office nebo Teams aplikace spustí PowerShell.
- PowerShell spustí certutil.
- certutil stáhne nebo dekóduje soubor (
urlcache,decodenebosplitv command line). - rundll32 nebo regsvr32 spustí DLL.
Jak testovat
Na lab Windows workstation s Microsoft Office a Sysmon:
- Otevřete Word (nebo Excel, Outlook nebo Teams).
- V test labu jen spusťte PowerShell jako child Wordu (např. kontrolované VBA makro nebo test harness, který spustí
WINWORD.EXEa pak PowerShell s Wordem jako parent procesem). Cíl je strom procesů: Office → PowerShell. - Z té PowerShell relace spusťte certutil pro stažení neškodného test souboru, např.:
certutil.exe -urlcache -split -f https://your-lab-server/test.bin C:\Temp\test.bin - Spusťte rundll32 proti neškodné test DLL v
C:\Temp, např.:
rundll32.exe C:\Temp\test.dll,EntryPoint
(použijte signed nebo vlastní test DLL, která jen vrátí success).
Zůstaňte na stejném hostu a stejném uživateli do 30 minut.
Na co se dívat
V Discover filtrujte process.parent.name obsahující winword, excel nebo outlook, pak sledujte child procesy powershell.exe, certutil.exe a rundll32.exe.
Očekávejte complex událost pro Living off the Land Chain v Discover a tiket v Alerts s finální rundll32 nebo regsvr32 command line.
Znaky správného chování
- PowerShell spuštěný jen z Exploreru nesplní fázi 1.
- certutil bez Office parenta nemá dokončit řetězec.
- Fáze na různých hostech nebo uživatelích nemají splynout.
MITRE Attack Chain Incident
Co detekuje
Scénář: Samostatné detekce už vystřelily napříč kill chain pro jednoho uživatele; toto meta pravidlo zvedne jeden konsolidovaný incident, když jsou přítomny initial access, execution, credential access a lateral movement.
Je to meta detekce. Nepoužívá přímo raw Windows logy. Místo toho čeká, dokud čtyři samostatné existující detekce nevystřelí pro stejného uživatele do přibližně 60 minut, pokrývající tyto fáze útoku:
| Fáze | Příklady feeder detekcí |
|---|---|
| Initial Access | Impossible Travel, Impossible Travel by Country, brute force s úspěchem |
| Execution | Critical Command Usage, Trojan Activity via File Download and Execution |
| Credential Access | Suspicious LSASS Memory Access |
| Lateral Movement | PsExec Service Installed, Using Remote Control Tool |
Když jsou všechny čtyři fáze přítomny, vytvoří jednu critical complex událost a odpovídající tiket v Alerts, který spojí příběh dohromady.
Jak testovat
Naplánujte lab cvičení pro jeden testovací uživatelský účet do 60 minut:
- Initial Access: Spusťte jedno z feeder pravidel (např. simulujte impossible travel, nebo brute force se úspěšným přihlášením podle dokumentace pravidla).
- Execution: Na lab Windows hostu spusťte Critical Command Usage nebo Trojan Activity via File Download and Execution podle manuálních lab kroků v dokumentaci pravidla.
- Credential Access: V labu spusťte schválený test pro Suspicious LSASS Memory Access (pouze schválené red team nástroje nebo test signatury).
- Lateral Movement: Nainstalujte nebo simulujte aktivitu služby PsExec, nebo spusťte Using Remote Control Tool.
Každý krok by měl vytvořit complex událost z feeder pravidla s user.name nastaveným na test účet. Každé feeder pravidlo může také vytvořit vlastní tiket v Alerts.
Na co se dívat
V Discover hledejte event.dataset: complex a user.name:<test user>. Ověřte čtyři odlišné hodnoty feeder rule.name v jedné hodině.
Po čtvrté feeder complex události očekávejte jednu konsolidovanou complex událost pro MITRE Attack Chain Incident v Discover a critical tiket v Alerts pro toho uživatele.
Znaky správného chování
- Tři feeder fáze bez čtvrté nemají vytvořit meta complex událost.
- Feeder complex události pro různé uživatele nemají splynout.
- Meta complex událost by měla v
related.eventsukazovat na čtyři přispívající complex události. - Pokud nasazení přejmenovává korelační soubory, feeder
rule.idcesty musí stále sedět s cestami v meta pravidle (koordinujte s detection engineerem).
Řešení problémů
| Příznak | Co zkontrolovat |
|---|---|
| Žádná complex událost nebo tiket | Zpoždění ingestu, špatný tenant, Correlator není přihlášen ke zdroji logů, nebo fáze mimo časové okno |
| Feeder pravidla vystřelí, meta ne | user.name musí přesně sedět napříč complex událostmi; MITRE chain povoluje až 60 minut |
| Částečné fáze jen v Discover | Predikát nemusí sedět s formátem logu; porovnejte názvy polí s fungující událostí ze stejného zdroje |
| Ransomware fáze 2 chybí | File System audit a SACL na lab složce; hledejte 4663 s we.object.name, ne jen Sysmon 11 |
| Ransomware fáze 1 chybí | Potřeba Sysmon 1 s process.executable obsahujícím vssadmin, ne jen cmd.exe obalující vssadmin |
| Trojan fáze rozdělené mezi uživatele | Fáze musí sdílet stejné host.id a we.user.data; vše v jedné interaktivní RDP relaci |
| Pravidlo příliš hlučné v produkci | Ladění prahů s detection engineerem; pravidla jsou experimental |
Pro ladění výkonu po nasazení viz Sledování výkonu detekcí.
Pro autorství a offline YAML testy viz Psaní window korelačního pravidla.
Pokrytí MITRE
Tato stránka zobrazuje pokrytí MITRE ATT&CK pro obsah v common library. K dispozici jsou dva pohledy:
- Vestavěná pravidla — korelační pravidla pouze pod
/Correlations/(naše nativní detekce a window pravidla). - Vestavěná pravidla plus Sigma — stejná vestavěná sada plus Sigma pravidla pod
/Detections/Sigma/, která distribuujeme jako část balíčku SIEM obsahu.
Matice níže ukazují, které techniky ATT&CK jsou pokryty a kolik pravidel se mapuje na každou buňku.
Pomocí těchto pohledů zjistíte:
- Které taktiky jsou pokryty
- Které techniky mají jedno nebo více pravidel
- Které buňky matice v daném pohledu zůstávají nepokryté
Pokryté buňky jsou zelené. Tmavší zelená znamená více pravidel mapovaných na danou techniku. Šedé buňky v daném pohledu nepokryté nejsou.
Pouze vestavěná pravidla
Tato matice odráží pouze pravidla v /Correlations/. Jsou to vestavěná korelační a detekční pravidla dodávaná s knihovnou (match pravidla, window pravidla a související obsah), ne samostatný Sigma balíček.
Snímek ke dni 27. července 2026. Otevřít v plné velikosti

Vestavěná pravidla plus Sigma
Tato matice přidává Sigma detekce z /Detections/Sigma/. Spolu s vestavěnými pravidly jde o širší obraz pokrytí toho, co SIEM distribuuje zákazníkům.
Snímek ke dni 27. července 2026. Otevřít v plné velikosti

Detekce anomálií aktivity uživatelů pomocí vektorových baseline Event Code na Windows hostech
Monitoring aktivity uživatelů na Windows endpointech se často zaměřuje na high-risk události, změny privilegií nebo konkrétní útočné techniky. Jedním z nejsilnějších early-warning signálů je ale něco mnohem jednoduššího: rozložení příchozích Windows Event Codes.
Místo sledování jednotlivých událostí izolovaně se pro každý host naučí behaviorální baseline analýzou, jak často se různé Event Codes objevují v jednohodinovém okně. Metoda seskupí události do vysokodimenzionálního vektoru (např. velikost 20 000), kde každá dimenze odpovídá konkrétnímu event code. Každá hodina vytvoří jeden takový vektor — „tvar“ normální aktivity pro host.
Klíčové pojmy
Než půjdeme do detailů, definujme základní termíny této detekční metody:
Event Code
Číselný identifikátor přiřazený každému typu Windows události. Například:
4624= Úspěšné přihlášení účtu4625= Neúspěšné přihlášení účtu4688= Byl vytvořen nový proces4720= Byl vytvořen uživatelský účet
Každá Windows security událost má Event Code kategorizující typ aktivity.
Baseline
Naučený statistický profil „normálního“ chování. V tomto kontextu baseline zachycuje, jak se konkrétní host typicky chová v daném časovém období (např. pondělí v 10:00 ve všední den). Ukládá průměrné chování (mean) a typickou variaci (směrodatná odchylka) pro porovnání s aktuální aktivitou.

Vektor
Matematická struktura s více hodnotami v uspořádaném seznamu. V této metodě:
- Každá pozice (dimenze) vektoru reprezentuje konkrétní Event Code
- Hodnota na každé pozici je počet výskytů daného Event Code v jednohodinovém okně
- Příklad: Pokud pozice 4624 má hodnotu 150, Event Code 4624 nastal v té hodině 150×
Jde o otisk popisující hodinovou aktivitu napříč všemi možnými Event Codes.
Norma vektoru
Jedno číslo shrnující celkovou „velikost“ nebo „magnitudu“ vektoru. Matematicky je to euklidovská vzdálenost od počátku k bodu reprezentovanému vektorem. Pro naše účely:
- Vysoká norma = v té hodině bylo hodně událostí
- Nízká norma = málo událostí
- Konkrétní vzor toho, které Event Codes přispěly k normě, dělá každou hodinu jedinečnou
Sigma (σ) / směrodatná odchylka
Statistická míra, jak moc se hodnoty typicky liší od průměru. V našem kontextu:
- Nízká sigma = hodnoty jsou obvykle blízko průměru (konzistentní chování)
- Vysoká sigma = hodnoty se silně liší od průměru (nekonzistentní chování)
„5 sigma“ znamená, že aktuální hodnota je 5 směrodatných odchylek od průměru — extrémně vzácné, pokud je chování normální.
Z-Score
Standardizovaná míra, jak neobvyklá je hodnota oproti baseline. Výpočet:
Z-Score = |Current Value - Average Value| / Standard Deviation
- Z-Score 0 = naprosto normální (přesně na průměru)
- Z-Score 1–2 = mírně neobvyklé, ale běžné
- Z-Score 3 = vzácné (~0,3 % času u normálního rozdělení)
- Z-Score 5 = extrémně vzácné (~0,00006 % času)
V této metodě se Z-Score a Sigma používají zaměnitelně — obojí popisuje, kolik směrodatných odchylek je aktuální chování od normálu.
Temporální třídy
Kategorie seskupující podobná časová období kvůli podobným vzorům chování:
- Workdays: pondělí až pátek při běžné provozní aktivitě
- Weekends: sobota a neděle s typicky nižší aktivitou
- Holidays: zvláštní dny s unikátními vzory (minimální aktivita nebo maintenance okna)
Učením oddělených baseline pro každou třídu systém chápe, že nízká aktivita v neděli je normální, ale stejně nízká aktivita ve středu by byla podezřelá.
Agregace
Proces seskupení a shrnutí jednotlivých událostí. V této metodě:
- Události se seskupí podle
host.id(z kterého počítače přišly) - Uvnitř hosta se počítají podle
event.code(typ události) - Počty se bucketují do jednohodinových oken
Agregace promění tisíce raw událostí v jeden vektor za hodinu na host.
Jednoduchý příklad
Konkrétními čísly:
Scénář: Host WORKSTATION-01 v pondělí v 10:00
Raw události (zjednodušeno):
Event Code 4624 occurred 120 times (successful logons)
Event Code 4688 occurred 45 times (process creations)
Event Code 5156 occurred 2,340 times (network connections)
Reprezentace vektorem:
[0, 0, 0, ..., 120, ..., 45, ..., 2340, ..., 0, 0]
 ^              ^         ^        ^
 Position 0    Pos 4624  Pos 4688 Pos 5156
Norma vektoru (zjednodušený výpočet): √(120² + 45² + 2340²) ≈ 2,343
Baseline (naučeno z předchozích pondělků v 10:00): - Průměrná norma vektoru: 2 200 - Směrodatná odchylka: 100
Výpočet aktuálního Z-Score:
Z-Score = |2,343 - 2,200| / 100 = 1.43
Výsledek: Z-Score 1,43 je normální (pod prahem 5), alert se nespustí. Mírná odchylka je v očekávaném chování pro tento host v tento čas.
Kdyby stejný host náhle ukázal 8 500 síťových spojení místo obvyklých 2 340, dramatický nárůst by posunul Z-Score nad 5 a spustil alert anomálie.
Učení normálního „tvaru vektoru“
Baseliner sbírá data několik dní napříč typickými behaviorálními třídami — workdays, weekends a holidays. Po zachycení dostatek vzorků (v našem případě čtyři platné vzorky na třídu) se systém naučí, jak vypadá normální hodinový vektor. Výstupem učící fáze je jediná skalární hodnota: norma vektoru. Ta funguje jako signatura hosta pro daný temporální kontext.
Převod odchylek na sigmu
Při příchodu nové aktivity systém znovu spočítá normu vektoru pro aktuální hodinu a porovná ji s historickým průměrem a směrodatnou odchylkou pro stejnou hodinu a třídu. Odchylka se vyjádří jako Z-score:
Z = |CURRENT_VALUE – MEAN_VALUE| / STDEV
Často se tomu říká sigma skóre. Vysoké sigma hodnoty znamenají, že aktuální vzor Event Codes je fundamentálně jiný, než host obvykle produkuje.
Například nárůst logon událostí, neobvyklá sekvence service-related kódů nebo náhlý pokles očekávaného provozního šumu mohou posunout normu vektoru natolik, že vznikne vysoké Z-score. Když sigma překročí nastavený práh — typicky 5 a více — systém to bere jako smysluplnou anomálii.
Od baseline k detekci
Tento přístup není sám o sobě určen jako vysoce přesný alerting mechanismus. Slouží jako behaviorální signál pro širší korelační pravidla. Pokud host ukáže prudkou odchylku ve vektoru event codes, událost „behavior-anomaly“ může napájet další detekční logiku a zvýraznit kompromitované stroje nebo abnormální akce uživatele.
Vektorové baseline místo pevných prahů nebo filtrů na jednotlivé události se přirozeně přizpůsobí hlučným enterprise prostředím. Zachytí jemné behaviorální posuny, které by jinak zůstaly neviditelné — a zůstane dostatečně lehký pro provoz ve velkém měřítku.
Příklad konfigurace
Úplný příklad konfigurace Event-Code Vector Baseline s vysvětlením jednotlivých sekcí.
---
define:
  name: Event Codes Per Host  #(1)
  description: Creates baseline for host and triggers an alert if number of events within a 1-hour window shows an anomaly from the learned baseline based on event codes  #(2)
  type: baseliner  #(3)
  risk_score: 30.0  #(4)

baseline:
  region: Czech Republic  #(5)
  period: day  #(6)
  learning: 4  #(7)
  classes: [workdays, weekends, holidays]  #(8)
  aggregation: vector  #(9)
  vector_size: 20000  #(10)
  weights:  #(11)
    "4624": 0.5  # Reduce weight of successful logons
    "4634": 0.5  # Reduce weight of logoffs
    "5156": 0.3  # Reduce weight of Windows Filtering Platform connections
    "4688": 2.0  # Increase weight of process creation events

# Event Codes baseline is meant for analysis and as input for correlations,
# not an entry to alert management
signal:
  default: false  #(12)

logsource:
  vendor:
    - microsoft  #(13)
  product:
    - windows  #(14)

predicate:
  !AND
  - !IN  #(15)
    what: event.code
    where: !EVENT
  - !IN  #(16)
    what: host.id
    where: !EVENT

evaluate:
  key: host.id  #(17)
  aggregate_by: event.code  #(18)
  timestamp: "@timestamp"  #(19)

analyze:
  test:
    !GT  #(20)
    - !ARG SIGMA  #(21)
    - 5  #(22)

trigger:
  - event:  #(23)
      host.id: !ITEM EVENT dimension

      # Event description
      event.action: "behavior-anomaly"  #(24)
      event.reason: "Activity from a host that deviates from the learned vector baseline."  #(25)
      event.kind: "alert"  #(26)
      event.type: "indicator"  #(27)
-
Název: Popisný název baseline pravidla zobrazený v rozhraní LogMan.io.
-
Popis: Vysvětluje, co baseline dělá — vytváří naučenou baseline na host a spouští alerty, když se vzor událostí výrazně odchýlí od normálního chování.
-
Typ:
baselineroznačuje baseline detekční pravidlo místo korelace nebo jiného typu. -
Risk Score: Přiřadí risk score 30,0 anomáliím z tohoto pravidla. Skóre slouží k prioritizaci a korelaci s jinými detekcemi.
-
Region: Časové pásmo / region pro temporální klasifikaci (např. „Czech Republic“ určuje místní čas pro workdays/weekends).
-
Period: Temporální granularita výpočtu baseline.
dayznamená sledování hodinových vzorů napříč dny v týdnu. -
Learning: Počet platných vzorků na třídu, než je baseline „naučena“. S
learning: 4systém potřebuje 4 vzorky pro každou hodinu každé třídy (workday/weekend/holiday). -
Classes: Behaviorální kategorie s odlišnými normálními vzory.
workdays,weekendsaholidaysumožní různé baseline pro různé typy dnů. -
Aggregation:
vectorpro vektorovou analýzu. Vytvoří vysokodimenzionální vektor, kde každá dimenze je frekvence event code. -
Vector Size: Maximální dimenzionalita vektoru (20 000). Musí být dost velká pro všechny očekávané Event Code hodnoty.
-
Weights (volitelné): Slovník vlastních vah pro konkrétní Event Codes ve vektoru:
- Snížení váhy velmi častých, nízkohodnotných událostí (např.
4624logony,5156síťová spojení), které přidávají šum - Zvýšení váhy high-value událostí (např.
4688process creation,4672special privileges), které silně indikují anomálie - Každý záznam mapuje Event Code (řetězec) na násobitel (float). Hodnoty pod 1,0 snižují důležitost, nad 1,0 zvyšují.
- Neuvedené Event Codes mají výchozí váhu 1,0.
- Snížení váhy velmi častých, nízkohodnotných událostí (např.
-
Default Signal:
false, protože baseline je pro analýzu a vstup do korelací, ne přímý alert. Zabrání automatickému signálu, ale anomálie lze použít v jiných pravidlech. -
Vendor: Filtruje události jen od vendor
microsoft— analyzujeme Windows události. -
Product: Dále filtruje na produkt
windows— Windows Event Logs. -
Predikát Event Code:
!INověří existenci poleevent.codev události. -
Predikát Host ID: Druhé
!INověří existencihost.id— stavíme per-host baseline. -
Key:
host.idjako klíč baseline. Oddělená baseline pro každý unikátní host. -
Aggregate By: Agregace podle
event.code— dimenze vektoru. -
Timestamp: Pole pro temporální bucketing.
@timestampurčuje jednohodinové okno. -
Greater Than Test:
!GTporovná vypočtenou SIGMA s prahem. -
SIGMA Argument:
!ARG SIGMAje Z-score(|ACTUAL_value - MEAN_value|) / STDEV. -
Threshold: Hodnota
5— anomálie při SIGMA nad 5 směrodatnými odchylkami. -
Trigger Event: Při anomálii systém generuje novou událost s uvedenými poli.
-
Event Action: Tag
behavior-anomalypro filtrování a korelaci. -
Event Reason: Lidsky čitelné vysvětlení pro analytiky.
-
Event Kind:
alertv ECS schématu. -
Event Type:
indicatorjako indikátor potenciální kompromitace nebo neobvyklé aktivity (ECS).
Jak to funguje v praxi
Když je baseline pravidlo aktivní:
-
Učící fáze: Sběr dat pro každý host napříč temporálními třídami (workdays, weekends, holidays).
-
Hodinové vektory: Pro každou hodinu a host vektor s dimenzemi = frekvence Event Code.
-
Aplikace vah: Pokud jsou
weights, každý počet Event Code se vynásobí váhou před výpočtem normy. -
Výpočet baseline: Po dostatek vzorků (4 na třídu) mean a směrodatná odchylka normy vektoru pro každou kombinaci hodina + třída.
-
Průběžný monitoring: Nové události průběžně přepočítávají normu aktuální hodiny (s váhami) a porovnávají s baseline.
-
Detekce anomálií: Při Z-score (SIGMA) nad 5 systém rozpozná anomálii a může spustit downstream akce.
-
Vstup do korelací: Generované
behavior-anomalyudálosti konzumují jiná korelační pravidla pro behaviorální kontext.
Use cases
Vektorová baseline detekce je obzvlášť účinná pro:
- Kompromitované účty: Neobvyklé vzory autentizace, změn privilegií nebo spouštění procesů. Váhami zdůrazněte vzácné privilege události (4672, 4648) a snižte šum z rutinních logonů.
- Laterální pohyb: Náhlé změny síťových Event Codes na dříve tichém hostu. Zvyšte váhu process creation (4688) a explicit credential use (4648).
- Malware aktivita: Abnormální vytváření služeb, změny registru nebo přístup k souborům. Zvyšte váhy u service událostí a scheduled task creation pro persistence.
- Privilegované uživatele: Neobvyklé aktivity administrátorů mimo jejich vzory. Váhami zaměřte admin akce a filtrujte rutinu.
- Detekce posunu baseline: Když host fundamentálně změní roli nebo konfiguraci. Vektorový přístup detekuje posun „behavior profilu“, i když jednotlivé události vypadají normálně.
Best practices
-
Učící období: Nechte sběr dat alespoň 4 dny, aby všechny temporální třídy měly dost vzorků.
-
Ladění prahu: Začněte se SIGMA prahem 5 a upravujte podle false positives. Vyšší prahy (6–7) snižují šum, ale mohou minout jemné anomálie.
-
Ladění vah: Parametr
weightspro citlivost: - Snížit (0,1–0,5) u častých, nízkohodnotných událostí:
4624: úspěšné logony4634: odhlášení5156: WFP allowed connections4663: přístup k objektům (často velmi hlučné)
- Zvýšit (1,5–3,0) u vzácných security událostí:
4688: process creation4672: special privileges při novém logonu4720: vytvoření uživatelského účtu4732: člen přidán do security-enabled lokální skupiny4648: logon s explicitními credentials
-
Začněte bez vah, analyzujte dominující Event Codes, pak upravte.
-
Seskupení hostů: Oddělené baseline pro typy hostů (servery, workstations, DC) pomocí rolí nebo tagů v poli
key. -
Vyloučení: Predikáty pro hlučné Event Codes nebo maintenance okna, která zkreslí baseline.
-
Korelace: Kombinujte s jinými pravidly (failed logins, privilege escalation) pro vysokou jistotu.
Výhody oproti tradičním přístupům
- Adaptivní: Automaticky se přizpůsobí normálu každého hosta bez ručního ladění prahů
- Temporální awareness: Chápe, že normál v pondělí ráno ≠ sobota v noci
- Multidimenzionální: Vzory napříč tisíci Event Codes současně
- Laditelná citlivost: Volitelné
weightspro konkrétní Event Codes bez ztráty automatického učení - Škálovatelné: Lehký výpočet pro velké flotily endpointů
- Kontextové: Behaviorální kontext pro jiná pravidla místo binárního alertu
Další zdroje
- Definice baseline:
MEAN,STDEV,SIGMAaanalyze.testv deklaracích Baseliner - Baseliner
- Detekční pravidla
- Hodnocení rizika
- Triggery
Sledování výkonu detekcí
Výkon korelací se kontroluje na dvou místech pro dvě různé otázky:
| Kde | Co kontrolujete | Otázka |
|---|---|---|
| Grafana | Consumer lag Kafka na instanci Correlator (group_id) |
Která instance zaostává? |
LogMan.io UI → Detekce (/detection) |
Časové metriky na pravidlo (timetotal, P/E/A/T, …) |
Která pravidla na té instanci jsou nákladná? |
Nepoužívejte Grafana k ladění jednotlivých pravidel podle času. correlator.time je pro operátory a plánování kapacity. Analytici optimalizují pravidla pomocí Total time na obrazovce Detekce.
Časové metriky v UI pocházejí z LogMan.io Correlator, agreguje LogMan.io TRex, obnovení přibližně každých 60 sekund.
Viz Correlator, Metriky Correlator a Prometheus monitoring.
Časové metriky na Detekcích (která pravidla?)
Otevřete Detekce ve webové aplikaci. Strom vypisuje korelační pravidla z Knihovny (podle složek a YAML souborů). Každý řádek pravidla může zobrazovat:
| Popisek UI | Klíč metriky | Význam |
|---|---|---|
| Total time (stopky) | timetotal |
Kumulativní CPU čas strávený na pravidle (všechny fáze) |
| P | timepredicate |
Čas ve filtru predicate |
| E | timeevaluate |
Čas v evaluate (window pravidla) |
| A | timeanalyze |
Čas v analyze (window pravidla) |
| T | timetrigger |
Čas v trigger |
| Ikona zvonku | triggerin |
Spuštění triggeru za poslední hodinu |
| Ikona šipky | predicatehit |
Zásahy predikátu za poslední hodinu |
Fáze s nejvyšším časem je zvýrazněna (varovná barva). Kliknutím na řádek pravidla s metrikami otevřete Discover na complex události pro to pravidlo (poslední hodina).
Řádky složek mohou zobrazovat agregované metriky všech pravidel pod danou cestou.
Typy pravidel
Rozpad P / E / A / T je nejvýznamnější pro window korelační pravidla. Match, sigma, list a další typy correlatoru stále hlásí Total time a počítadla predicate/trigger, ale nemusí používat každou fázi.
Jak číst Total time
Total time není latence jedné události. Je to součet času zpracování, který Correlator strávil na pravidle v okně metrik (v sekundách, tři desetinná místa).
| Total time | Doporučení |
|---|---|
| < 1 s | Obvykle v pořádku |
| 1–5 s | Sledovat; zkontrolujte predikát a objem událostí |
| ≥ 5 s | Vysoké: považujte za problém výkonu daného pravidla |
Vysoké Total time s vysokým počtem predicate hit často znamená, že pravidlo běží na příliš mnoha událostech. Vysoké Total time s nízkým počtem zásahů ukazuje na nákladný predikát nebo krok analyze na událostech, které projdou.
Porovnejte fáze:
- Dominuje P → zjednodušte
predicate, používejte strukturovaná pole, nevyhledávejte vmessage. - Dominuje E nebo A → zužte okno (
predicate,logsource), snižte kardinalitu vevaluate.dimension, zjednodušteanalyze.test. - Dominuje T → zkontrolujte akce triggeru (šablony, lookupy, objem výstupu).
Correlator vzorkuje časové metriky každé N. události (výchozí N = 10) a škáluje zaznamenanou dobu, aby počítadla zůstala reprezentativní. Administrátoři mohou nastavit [correlator] time_metrics_sample_interval v konfiguraci Correlator.
Kafka consumer lag v Grafana (která instance?)
Každá instance Correlator konzumuje Kafka se vlastní consumer group. Lag ukazuje, zda instance události zpracovává dostatečně rychle.
Typické hodnoty group_id:
- V konfiguraci:
[pipeline:CorrelatorsPipeline:KafkaSource] group_id=...(viz Konfigurace Correlator) - Nebo auto-generované:
lmio_correlator_{tenant}_{groups}(volitelná přípona sharding)
V Grafana (nebo Prometheus) sledujte:
- Metrika:
kafka.consumer_group.lag - Filtr:
group =~ /^lmio_correlator.*/: vyberte konkrétní skupinu, která roste
Lag nesmí nepřetržitě růst. Rostoucí lag na jednom group_id znamená, že ta instance Correlator je přetížená nebo její pravidla jsou kolektivně příliš pomalá.
Více instancí Correlator
Velké nasazení rozdělí skupiny pravidel mezi několik instancí Correlator (různé [declarations] groups a často jiné group_id). Optimalizujte pravidla na instanci, jejíž lag v Grafana roste, ne na instanci, která je v pořádku.
Mapování instance → pravidla:
[declarations] groups/correlator.groupsv modelu vypisuje složky Knihovny, které instance načítá (např./Correlations/Firewall/).- Stejné cesty jsou ve stromu obrazovky Detekce.
- Pod
/Detections/Sigma/Tenant Rex standardně umisťuje correlatory maximálně tři segmenty cesty pod tím kořenem ([correlator] folder_max_depth). Hlubší Sigma listy se srolují do jedné instance. Ostatní stromy drží jednu instanci na nejbližší / nejhlubší složku, pokud není jinak nastaveno. Operátorská reference: Tenant Rex.
Metriky na pravidlo na Detekcích neobsahují Kafka lag.
Typické příčiny pomalých pravidel
1. Podřetězcové hledání v message místo strukturovaných polí
Vyhněte se filtrování na surovém řádku logu, když existují parsovaná pole:
# Pomalé: prohledává celý text message u každé kandidátní události
predicate:
  - !IN
    what: "failed password"
    where: !ITEM EVENT message
Preferujte rovnost na normalizovaných polích ECS / schématu z Parsec:
# Rychlé: vhodné pro index, odpovídá výstupu parseru
predicate:
  - !EQ
    - !ITEM EVENT event.action
    - "login-failed"
  - !EQ
    - !ITEM EVENT event.outcome
    - "failure"
Pokud zdroj dat nemá vhodné pole, nejdřív rozšiřte mapování parseru, pak pište detekci proti novému poli. Viz Predikáty a Pravidla pro parsování.
2. Příliš široký predikát
- Chybí filtry
event.dataset,event.category,observer.typenebologsource. !ORs mnoha větvemi místo jednoho!EQnaevent.codeneborule.id.!INswhere: !EVENTjen pro test existence pole; kombinujte s úzkými kontrolami hodnot.
Každá událost, která vstoupí do predikátu, stojí CPU i při miss. Použijte počty zvonku / šipky: velmi vysoký predicate hit s málo triggery může být normální; velmi vysoké zásahy s vysokým časem P znamenají příliš volný filtr.
3. Nákladné window evaluate / analyze
- Krátký
spans vysokou rychlostí událostí → velká okna v paměti. - Vysoká kardinalita
evaluate.dimension(např. volná textová pole). - Nákladný
analyze.test(složitý SPLang, mnoho lookupů).
4. Lookupy v predikátu
Každé volání lookupu přidá latenci. Přesuňte lookupy do trigger, když je to možné, nebo předem obohacujte v Parsec.
Praktický postup
- Grafana: Najděte consumer group Correlator s rostoucím lagem (
kafka.consumer_group.lag,group =~ /^lmio_correlator.*/). Poznamenejtegroup_ida ke které instanci / groups deklarace patří. - LogMan.io → Detekce: Otevřete strom pravidel pro tenant. Zaměřte se na pravidla pod stejnými složkami Knihovny, které lagující instance načítá.
- Najděte pravidla s Total time ≥ 5 s (a zkontrolujte zvýrazněnou fázi P/E/A/T).
- Upravte pravidla v Knihovně: zpřísněte
predicate, vyhněte se podřetězci vmessage, snižte náklady okna/analyze (viz níže). - Na Detekcích porovnejte predicate hit vs trigger in, že filtr není příliš široký.
- Po nasazení počkejte několik minut: znovu zkontrolujte Total time na Detekcích a lag v Grafana pro dané
group_id.
Pokud je lag na všech instancích v pořádku, ale některá pravidla mají stále vysoké Total time, optimalizace se vyplatí (zbytečné CPU), ale není naléhavá kvůli zásobě.
Související dokumentace
- Co je detekční pravidlo?
- Jak napsat window korelační pravidlo
- Predikáty
- Metriky Correlator
- Metriky pipeline (throughput, duty cycle)
- Konfigurace Correlator (Kafka
group_id, volby[correlator])
Hodnocení rizika v LogMan.io Correlator
LogMan.io Correlator přiřazuje číselné hodnocení rizika každému výstupu detekce (complex události, signály, alerty). Analytici ho používají k řazení front, ladění pravidel a k entitnímu riziku na aktivech.
Skóre jsou hodnoty s plovoucí desetinnou čárkou, typicky na škále 0 až 100. Orientačně: 20 je nízké, 50 střední, 80 vysoké. Hodnoty mohou přesáhnout 100, když se sečte více bonusů.
Hodnocení rizika vs. severity
Severity popisuje potenciální dopad, pokud by nález byl pravdivý (low, medium, high, critical). Je to stabilní štítek scénáře.
Hodnocení rizika je číslo, které se mění v okamžiku výstupu: základ pravidla, předchozí skóre na spouštěcí události, lookupy a shody IOC se sčítají. Odpovídá na otázku „Jak silně máme na tuto detekci reagovat právě teď?“
Co se stane při spuštění detekce
Když korelační pravidlo spustí trigger (complex událost nebo signál), Correlator vypočítá event.risk_score ve čtyřech krokách, pokud šablona triggeru pole explicitně nenastaví:
| Krok | Zdroj | Efekt |
|---|---|---|
| 1. Základ | define.risk_score nebo define.severity pravidla a volitelně existující event.risk_score na spouštěcí události |
Počáteční hodnota nebo eskalace existujícího skóre (viz níže) |
| 2. Ladění pravidla | lookup ruleid2riskscore |
Přičte se k základu |
| 3. IOC / threat intel | Lookupy ve skupině ioc (a lookupy v define.lookups, které odpovídají dimenzím okna) |
Přičte se za každou odpovídající hodnotu dimenze |
| 4. Váha aktiva | hostid2riskscore, userid2riskscore, serviceid2riskscore |
Přičte se, když událost nese odpovídající id principálu |
Výsledek se zapíše do výstupu detekce (výchozí ECS pole event.risk_score). Tuto hodnotu vidíte v Discover, v alertech a jako skóre entity v Assets (viz Entitní hodnocení rizika na aktivech).
Pohled analytika
Vzorec v UI nekonfigurujete. Výsledek ovlivníte:
risk_scoreneboseverityv YAML pravidla- řádky v Lookups (
ruleid2riskscore,ioc, …) - Risk score weight na aktivu v Assets (naplní
userid2riskscorea sourozence)
Základní skóre z pravidla
Základ pravidla nastavte v define:
define:
  name: "Failed login burst"
  risk_score: 40.0
Pokud vynecháte risk_score, můžete použít kategorickou severity. Převede se na číslo, např. low → 30, medium → 50, high → 70, critical → 90.
Pokud spouštěcí událost nemá předchozí hodnocení rizika, základ je prostě hodnota pravidla.
Když spouštěcí událost už má hodnocení rizika
Parsované nebo upstream události někdy už nesou event.risk_score (např. předchozí detekce na complex lane). Následné pravidlo toto číslo nenahrazuje. Eskaluje ho směrem k 100 pomocí vlastního risk_score pravidla (nebo mapované severity):
new_base = existing + (100 - existing) × (rule_risk / 100)
Pravidlo funguje jako procento zbývajícího prostoru do 100. Vysoká existující skóre se hýbou méně; nízká mohou vyskočit více.
Příklad eskalace
Host už má event.risk_score: 40 z dřívější detekce. Druhé pravidlo spustí s define.risk_score: 30.
40 + (100 - 40) × (30 / 100) = 40 + 18 = 58
Druhé pravidlo skóre zvýšilo o 18 bodů, nepřičetlo 30 k 40.
Silná eskalace
Stejný start 40, ale druhé pravidlo má risk_score: 80:
40 + 60 × 0.8 = 88
Vysoký základ pravidla u řetězené detekce může výstup posunout téměř na vrchol škály v jednom kroku.
Pokud pravidlo v define nemá ani risk_score ani severity, jako základ zůstane skóre události (lookupy v krokách 2 až 4 se stále uplatní).
Ladění pravidla (ruleid2riskscore)
Úpravy pro jednotlivá pravidla přidejte do lookupu ruleid2riskscore. Klíč je id pravidla (cesta v Knihovně k YAML souboru). Sloupec score se přičte po základu.
key                                                              score
/Correlations/Windows/Failed login burst.yaml                    10.0
Ladění hlučných pravidel
Užitečné pravidlo, které často spouští, může držet define.risk_score: 50 pro férovou severity, ale ruleid2riskscore: -15 (nebo nižší kladnou hodnotu), aby analytici nebyli zahlceni prioritou top alertů, dokud IOC nebo váha aktiva nezvedne celkové skóre.
IOC a threat intelligence
Lookupy ve skupině ioc (a kompatibilní lookupy v define.lookups) se kontrolují proti dimenzím okna na události (např. source.ip, user.name, dns.question.name). Každá shoda přičte své risk.score (výchozí 10, pokud řádek skóre nemá).
Aby lookupy zůstaly naplněné z externích zdrojů, viz Threat intelligence feedy.
key                         risk.score
203.0.113.66                25.0
evil.example.com            20.0
IOC na dimenzi
Pravidlo neúspěšného VPN přihlášení má po eskalaci základ 45. Zdrojová IP odpovídá řádku IOC s 25. Výstup je 70 před váhou aktiva. Analytik vidí střední pravidlo jako vysokou prioritu, protože IP je známě špatná.
Váha hodnocení rizika na aktivu
V Assets → detail aktiva můžete nastavit Risk score weight (0 až 100) pro host, uživatele nebo službu. Hodnota je v hostid2riskscore, userid2riskscore nebo serviceid2riskscore. Když výstup detekce obsahuje id tohoto principálu, váha se přičte k finálnímu skóre.
VIP servisní účet
Základ pravidla 35, bez IOC. Uživatel svc-backup má v Assets váhu 30. Finální event.risk_score: 65. Stejné pravidlo u obecného uživatele zůstane na 35.
Eskalace plus váha aktiva
Window pravidlo má define.risk_score: 20. Dvě události v okně nesou event.risk_score: 10. Odpovídající host má v Assets váhu 10.
Do vzorce vstoupí skóre pouze spouštěcí události (dvě desítky se nesčítají):
base = 10 + (100 − 10) × (20 / 100) = 10 + 18 = 28
final = 28 + 10 = 38
Finální event.risk_score: 38. Kdyby spouštěcí událost neměla předchozí skóre, výsledek by byl 20 + 10 = 30.
Tato váha je nezávislá na Average risk score v Assets (entitní skóre v čase). Váha ovlivňuje budoucí výstupy detekcí; entitní skóre odráží minulé detekce. Viz Entitní hodnocení rizika v LogMan.io Assets.
Úplný příklad (všechny vrstvy)
Window pravidlo s define.risk_score: 50 spustí na uživatele jsmith.
- Spouštěcí complex událost už má
event.risk_score: 20(upstream detekce). - Základ po eskalaci:
20 + 80 × 0.5= 60 - Záznam
ruleid2riskscorepro toto pravidlo: +5 → 65 source.ipodpovídá IOC: +15 → 80userid2riskscoreprojsmith: +10 → 90
Výstupní complex událost:
event.risk_score: 90.0
Pořadí je důležité v hlavě, ne v konfiguraci
Konfigurujete jen pravidlo a lookupy. Correlator vždy aplikuje: základ (s eskalací) → ladění pravidla → IOC → váha aktiva. Pořadí kroků v YAML neměníte.
Explicitní skóre v triggeru
Pokud blok trigger nastaví event.risk_score (nebo pole rizika ve vašem schématu) ve výstupní šabloně, použije se hodnota jak je zapsaná. Automatický výpočet se pro tento trigger přeskočí.
Používejte pro výjimečné případy. Většina pravidel by měla spoléhat na define a lookupy, aby ladění zůstalo centralizované.
Shrnutí
| Vrstva | Kde se konfiguruje | Efekt |
|---|---|---|
| Základ pravidla | define.risk_score nebo define.severity |
Počáteční skóre nebo eskalace existujícího event.risk_score |
| Ladění pravidla | lookup ruleid2riskscore |
Přičtení |
| IOC / intel | skupina ioc (+ define.lookups) |
Přičtení za odpovídající dimenzi |
| Váha aktiva | UI Assets → risk score weight | Přičtení, když je na události id principálu |
Pro psaní pravidel viz Correlator a Jak napsat window korelační pravidlo.
Entitní hodnocení rizika na aktivech
event.risk_score na complex lane události je skóre té detekce. LogMan.io Assets udržuje oddělené entitní hodnocení rizika na každém aktivu (host, user, service): číslo, které v čase slábne, když pro principál nepřicházejí nové detekce.
| Vrstva | Kde | Role |
|---|---|---|
| Correlator / complex událost | event.risk_score |
Jedna detekce (pravidlo + lookupy) |
| Inventář aktiv | Risk score v UI Assets | Aktuální riziko principálu po decay |
Seřaďte seznam aktiv podle risk score a upřednostněte vyšetřování. Postranní panel detailu aktiva ukazuje Average risk score (stav entity teď); graf risk score ukazuje špičky detekcí v čase.
Pro přesný decay model (akumulátory, poločas, background tick) viz Risk score decay (detailed). Pro příklady a volitelnou Risk score weight viz Entity risk score in LogMan.io Assets.
Správa aktiv
Assets jsou hosty, uživatelé a služby, které LogMan.io poznává ze streamu událostí. Platforma sleduje, kdy byla entita poprvé a naposledy viděna, zda je stále aktivní a jak detekční aktivita ovlivňuje její risk score. Pomocí Assets udržujete inventář, odhalíte neaktivní nebo rizikové entity a přejdete do Discover pro hlubší vyšetřování.
Tato stránka popisuje obrazovky Assets ve webové aplikaci: inventář, detail, stale alerty a typické kroky vyšetřování. Jak se activity události vytvářejí v Parsec (mapování identity, skip, Kafka topicy), viz Správa aktiv a activity stream.
Kdo to může dělat?
Otevření modulu Assets vyžaduje lmio:asset:access. Úprava tagů, alertů nebo mazání aktiv vyžaduje lmio:asset:edit. Změna alternate names nebo risk score weight vyžaduje lmio:lookup:edit. Otevření Discover z aktiva vyžaduje bitswan:discover:access.
Otevření modulu Assets
V hlavním menu vyberte Assets (ikona krabice). Můžete procházet:
| Obrazovka | Co zobrazuje |
|---|---|
| All assets | Celý inventář |
| Hosts | Počítače a servery |
| Users | Uživatelské účty |
| Services | Servisní principály |
| Asset detail | Jedna entita s grafy a nastavením |
Aktiva se vytvářejí automaticky při příchodu odpovídajících událostí. V UI je ručně nevytváříte.
Co vidíte v seznamu
Tabulka aktiv obsahuje:
| Sloupec | Význam |
|---|---|
| Id | Název principála (hostname, username, service id). Kliknutím otevřete detail. |
| Alert badge | Zda je nastaven alert stale after (viz níže) |
| Last activity | Poslední událost pro toto aktivum |
| Risk score | Aktuální entitní riziko z detekcí (časově rozpadlé) |
| Activity | Zelená ikona = aktivní; červená = neaktivní (viz Aktivní vs neaktivní) |
Vyhledávací pole filtruje podle id nebo typu. Filtr Activity zobrazí jen Active nebo Inactive. Řazení podle id, last activity, risk score nebo stavu activity.
Download all exportuje aktuální filtrovaný seznam do CSV.
Detail aktiva: grafy a postranní panel
Klikněte na Id aktiva pro detail.
Postranní panel (identita a nastavení)
- Type: host, user nebo service
- First / last activity: kdy LogMan.io entitu poprvé a naposledy viděl
- Average risk score: rozpadlé skóre z detekčních událostí
- Activity status: aktivní nebo neaktivní
- Alternate names: aliasy (hostname, IP, username, e-mail) pro hosty a uživatele
- Stale after (alert): práh neaktivity před vyvoláním alertu
- Risk score weight: násobitel ovlivňující skórování detekcí pro tento principál
- Tags: štítky pro filtrování a reporting
Grafy
- Activity: objem událostí v čase (podle datasetu, pokud je k dispozici)
- Risk score: špička detekčního rizika v časovém bucketu
- Related principals: hosty ukazují související uživatele; uživatelé související hosty
Pomocí výběru časového rozsahu a volitelného filtru LARK klikněte na Fetch data pro obnovení grafů. Výchozí rozsah jsou poslední tři dny.
Otevření v Discover
Klikněte na Open in Discover pro hledání raw událostí tohoto principála ve zvoleném časovém rozsahu. Hlavní cesta z aktiva k plnému vyšetřování.
Risk score vs activity
Měří různé věci:
| Koncept | Zdroj | Otázka |
|---|---|---|
| Activity | Activity event lane | Posílá entita stále logy? |
| Risk score | Detekční události (complex lane) | Kolik podezřelé aktivity se entity nedávno týkalo? |
Host může být aktivní (stále loguje) s nízkým risk score, nebo neaktivní s vysokým skóre z minulých detekcí, dokud nerozpadne.
Čárový graf na detailu ukazuje, kdy detekce vystřelily. Prázdný bucket znamená žádné kvalifikující detekční události v tom intervalu.
Aktivní vs neaktivní
Zelená/červená ikona Activity (a filtr Active / Inactive v seznamu) odpovídá na: Byla entita nedávno dostatečně viděna?
active ⇔ (now − last activity) ≤ threshold
| Stale after (alert) | Práh pro badge |
|---|---|
Nastaveno (např. 1d, 3d) |
Stejné okno jako alert |
| Vymazáno / vypnuto | 7 dní |
Bez last activity → inactive.
Badge vs Alert Management
Vypnutí Stale after (alert) neznamená, že aktivum zůstane navždy zelené. Po 7 dnech bez activity se stále zobrazí jako neaktivní. Co vypnete, je tiket Asset inactive v Alert Management; ten kanál běží jen při nastaveném prahu.
Technický detail (API pole active): LogMan.io Assets - Active vs inactive.
Stale asset alerty
LogMan.io může upozornit, když aktivum přestane posílat události.
- Na detailu aktiva (nebo přes Bulk actions v seznamu) nastavte Stale after (alert): např.
1dnebo3d - Uložte
Pokud v tom okně nepřijde activity, Alert Management dostane signál Asset inactive. Otevřený signál obsahuje, jak dlouho je aktivum tiché (event.duration ve výchozím nastavení jako lidsky čitelná délka). Po obnovení activity se alert automaticky zavře.
Pro zastavení monitoringu smažte práh (tlačítko X na detailu, nebo Clear alerts v bulk akcích). Pokud už byl otevřen tiket Asset inactive pro to aktivum, vymazání (nebo zvýšení prahu tak, že last activity spadne do nového okna) pošle recovery signál, který může tiket v Alert Management zavřít (popis: aktivum je znovu aktivní). Smazání aktiva (nebo sloučení) také zavře otevřený tiket s popisem, že aktivum bylo smazáno — ne že se znovu aktivovalo.
Vymazání prahu nezamrzne Activity badge: bez alert_after znamená neaktivní stále více než 7 dní od last activity (viz Aktivní vs neaktivní).
Výchozí hodnota pro nová aktiva
Nová aktiva dostanou výchozí stale alert: 3 dny pro hosty a služby, 7 dní pro uživatele (Knihovna /Assets/Defaults/settings.yaml, nebo INI služby [assets] default_alert_after_*). Krátká okna jako 2h často otevírají a zavírají tikety opakovaně u zdravých hostů, které část dne mlčí. Po recovery tiketu je další otevření drženo přibližně den (stale_alert_reopen_cooldown_sec). Práh můžete změnit nebo vymazat na každém aktivu.
Notifikace při novém aktivu
Administrátoři mohou zapnout notifikace asab-iris (e-mail, Slack, SMS nebo push), když LogMan.io z activity streamu objeví nový host, uživatele nebo službu.
| Režim | Co dostanete |
|---|---|
| Instant | Jedna zpráva při prvním vytvoření aktiva |
| Scheduled | Periodický souhrn aktiv vytvořených v posledním intervalu (výchozí často 1 hodina) |
To není totéž jako stale asset alerty (ty jdou do Alert Management, když aktivum zmlkne). Notifikace nových aktiv se spouští jen při prvním objevení, ne při každé další aktualizaci last_seen.
Nastavení je Knihovna + konfigurace služby (kanál, šablony, volitelné filtry). Zeptejte administrátora, nebo viz Konfigurace Assets.
Filtrování šumu z inventáře
Některé identity by se nikdy neměly stát aktivy (např. Windows SYSTEM nebo jednorázové hostnames). Administrátoři je mohou filtrovat na dvou místech:
| Vrstva | Kde | Co filtruje |
|---|---|---|
| Assets Library | /Assets/Skip/settings.yaml |
Host a user tituly přes names / prefixes / suffixes / contains (case-insensitive); zahodí aktiva na activity a complex |
| Parsec event lane | parsec.asset.skip |
Host a user přes exact / prefixes / suffixes / contains / ip; zahodí z activity Kafka streamu |
Použijte Knihovnu /Assets/Skip/ (prefixes, min_hyphens, ip, …) v inventáři. Detaily: Konfigurace Assets a Parsec správa aktiv.
Pokud logy dávají IP do host.hostname a stane se z toho host.id, požádejte administrátora o parsec.asset.skip.host.ip: true na dané event lane (Přeskočení IP použitých jako hostname). Zachová fallback pro skutečné hostnames.
Tagy a alternate names
Tagy
Tagy jsou volné štítky na aktivu (např. label=prod, team=soc nebo critical). Jsou v sidecar kolekci vedle dokumentu aktiva a na detailu. Přidávat a odebírat můžete s oprávněním edit.
Tagy a události v Discover
Pro vyšetření všech událostí každého hosta (nebo uživatele / služby) se stejným tagem nemusíte ručně vkládat názvy hostů.
V Discover / Chart
Vyberte datasource, který v Knihovně deklaruje asset_tag (např. Events (hosts label=prod) z Common Library). Chart se zeptá Assets na odpovídající principály a omezí dotaz na tyto host.id (volitelně user.id / service.id). Viz Události pro aktiva podle tagu.
Přes Assets API
- Seznam tagovaných aktiv:
GET /api/lmio-assets/{tenant}/asset?atag=label:prod - Sestavení Discover filtru:
GET /api/lmio-assets/{tenant}/asset/events-filter?atag=label:prod&akind=host
Odpověď events filter obsahuje data.filter (např. host.id:(web01, web02)). Vložíte do Discover, nebo spoléháte na Chart datasource, který filtr aplikuje automaticky.
Vyžaduje lmio:asset:access. Shoda je case insensitive.
Alternate names
Hosty a uživatelé mohou mít alternate names: další hostnames, IP, MAC, usernames nebo e-maily mapované na stejné aktivum. Pomáhá, když stejný stroj nebo osoba v logách vystupuje pod různými identifikátory.
Úprava alternate names vyžaduje oprávnění lookup edit, protože hodnoty jsou ve watcher lookupech.
Pro aktuální mapování username → user.id ve škále adresáře z Active Directory použijte LDAP feed do usernames2userid. Viz LDAP / AD feed identity uživatele.
Risk score weight
Risk score weight (0 až 100) upravuje, jak silně detekce ovlivňují skóre aktiva. Pro známé dobré systémy (nižší váha) nebo cíle s vysokou hodnotou (vyšší váha). Vyžaduje oprávnění lookup edit.
Hromadné akce v seznamu
- Otevřete All assets (nebo Hosts, Users, Services)
- Klikněte na Bulk actions (ikona mřížky)
- Vyberte řádky checkboxy, nebo vše na stráně
- V postranním panelu:
- Nastavte nebo vymažte Stale after (alert) pro výběr
- Smažte vybraná aktiva (s potvrzením)
Smazání odstraní záznam aktiva. Znovu se vytvoří, pokud přijdou odpovídající události.
Typické postupy analytika
Najít riziková nebo tichá aktiva
- Otevřete Assets → All
- Seřaďte podle Risk score sestupně, nebo filtr Inactive
- Otevřete zajímavé řádky a projděte grafy a last activity
Vyšetřit jeden host nebo uživatele
- Otevřete detail aktiva
- Nastavte časový rozsah na incident
- Zkontrolujte graf risk score pro špičky detekcí
- Zkontrolujte graf activity pro mezery v logování
- Klikněte Open in Discover pro jednotlivé události
- U hostů nebo uživatelů projděte related principals pro laterální kontext
Monitorovat kritické servery
- Otevřete host aktivum
- Nastavte Stale after (alert) na rozumné okno (např.
1dnebo3d) - Přidejte tagy jako
critical - Reagujte na alerty Asset inactive v Alert Management
Úklid po přejmenování
Když stejný host nebo uživatel vystupuje jako dvě aktiva (např. krátký název a FQDN):
- Otevřete aktivum, které chcete zachovat (kanonické Id)
- Pod Alternate names přidejte druhý identifikátor
- Pokud tento název už existuje jako samostatné aktivum, Assets může po potvrzení duplicitu odstranit; události se starým názvem pak řeší zachované aktivum přes lookup
Jak aktiva souvisí s detekcemi
flowchart TB
    EV[Incoming events]
    ACT[Activity lane]
    CMP[Complex lane / detections]
    AST[(Assets)]
    UI[Assets screens]
    DIS[Discover]
    ALM[Alert Management]

    EV --> ACT
    EV --> CMP
    ACT --> AST
    CMP --> AST
    AST --> UI
    UI --> DIS
AST --> ALM- Activity aktualizuje first seen, last seen a stav aktivní/neaktivní (viz Správa aktiv a activity stream)
- Detekce na complex lane naplňují risk score
- Stale alerty propojují aktiva s Alert Management, ne s obrazovkou Detections
- Notifikace nových aktiv (volitelné) jdou přes asab-iris, ne Alert Management
Souhrn oprávnění
| Úkol | Oprávnění |
|---|---|
| Zobrazit Assets | lmio:asset:access |
| Upravit tagy, stale alert, smazat | lmio:asset:edit |
| Upravit alternate names, risk weight | lmio:lookup:edit |
| Open in Discover | bitswan:discover:access |
| Zobrazit podkladové lookupy | lmio:lookup:access |
| Řešit stale asset alerty | lmio:alert:access (Alert Management) |
Související čtení
- Správa aktiv a activity stream: Parsec activity stream, mapování identity a event lane
skip - Konfigurace Assets: skip seznamy v Knihovně, notifikace nových aktiv (instant a scheduled digesty)
- Hodnocení rizika: výpočet detekčního risk score
- Rozpad entitního risk score: přesný model pro sloupec risk score v Assets
- Sledování výkonu detekcí: ladění pravidel, která řídí riziko aktiv
- Notifikace: zprávy z detekcí nebo alertů přes asab-iris
- Uživatelský manuál: Discover, dashboardy a navigace
- Lookupy v detekcích: lookup tabulky pro pravidla a aktiva
- LDAP / AD feed identity uživatele: plnění
usernames2useridz Active Directory pro automatickou normalizaciuser.id
Predikáty
predikát je filtr složený z podmínek vytvořených pomocí SP-Lang výrazů.
Jak psát predikáty
Než můžete vytvořit filtr, musíte znát možné pole a hodnoty logů, které hledáte. Abyste zjistili, jaká pole a hodnoty mají vaše logy, přejděte do Průzkumníka ve webové aplikaci TeskaLabs LogMan.io.
SP-Lang výrazy
Sestavte podmínky pro filtr pomocí SP-Lang výrazů. Filtr kontroluje příchozí log, aby zjistil, zda log splňuje podmínky tím, že činí výrazy "pravdivými".
Kompletní dokumentaci k SP-Lang najdete zde.
Běžné SP-Lang výrazy:
| Výraz | Význam |
|---|---|
!AND |
VŠECHNY kritéria vnořená pod !AND musí být splněna, aby byl !AND pravdivý |
!OR |
Alespoň JEDNO ze kritérií vnořených pod !OR musí být splněno, aby bylo !OR pravdivé |
!EQ |
"Rovná se". Musí se rovnat nebo odpovídat hodnotě, aby bylo pravdivé |
!NE |
"Nerovná se", nebo neodpovídá. Musí se NEROVNAT (nesmí odpovídat hodnotě), aby bylo pravdivé |
!IN |
Hledá hodnotu v množině hodnot (what v where) |
!STARTSWITH |
Hodnota pole (what) musí začínat specifikovaným textem (prefix), aby byla pravdivá |
!ENDSWITH |
Hodnota pole (what) musí končit specifikovaným textem (postfix), aby byla pravdivá |
!ITEM EVENT |
Získává informace z obsahu příchozích logů (umožňuje filtru přistupovat k polím a hodnotám v příchozích logech) |
!NOT |
Hledá opak výrazu vnořeného pod !NOT (následující what) |
!LOOKUP |
Odkazuje na lookup tabulku (často jako where u !IN) pro whitelist / blacklist / inventář |
Pro vzory whitelistu a blacklistu s lookupy v detekcích viz Lookups v detekcích.
Podmínky
Použijte tento průvodce ke správnému strukturování jednotlivých podmínek.
Závorky
Slova v závorkách () jsou náhradní symboly pro ukázku, kam vkládat hodnoty. SP-Lang nepoužívá závorky.
| Filtr pro log, který: | SP-Lang |
|---|---|
| Má specifikovanou hodnotu ve specifikovaném poli |
|
| Má specifikované pole |
|
| NEMÁ specifikovanou hodnotu ve specifikovaném poli |
|
| Má jednu z více možných hodnot v poli |
|
| Má specifikovanou hodnotu, která začíná specifikovaným číslem nebo textem (prefixem), ve specifikovaném poli |
|
| Má specifikovanou hodnotu, která končí specifikovaným číslem nebo textem (postfixem), ve specifikovaném poli |
|
| NESPLŇUJE podmínku nebo sadu podmínek |
|
Příklad
Abyste pochopili, co jednotlivé výrazy znamenají v kontextu tohoto příkladu, klikněte na ikony .
  !AND #(1)
  - !OR #(2)
    - !EQ
      - !ITEM EVENT event.dataset
      - "sophos"
    - !EQ
      - !ITEM EVENT event.dataset
      - "vmware-vcenter"
  - !OR #(3)
    - !EQ
      - !ITEM EVENT event.action
      - "Authentication failed"
    - !EQ
      - !ITEM EVENT event.action
      - "failed password"
    - !EQ
      - !ITEM EVENT event.action
      - "unsuccessful login"
  - !OR #(4)
    - !IN
      what: source.ip
      where: !EVENT
    - !IN
      what: user.id
      where: !EVENT
  - !NOT #(5)
    what:
      !STARTSWITH
      what: !ITEM EVENT user.id
      prefix: "harry"
- Každý výraz vnořený pod
!ANDmusí být pravdivý, aby log prošel tímto filtrem. - V logu musí být v poli
event.datasethodnotasophosnebovmware-vcenter, aby bylo toto!ORpravdivé. - V logu musí být v poli
event.actionhodnotaAuthentication failed,failed passwordnebounsuccessful login, aby bylo toto!ORpravdivé. - Log musí obsahovat pole
source.ipnebo poleuser.id, aby bylo toto!ORpravdivé. - V logu se pole
user.idnesmí začínat naharry, aby bylo toto!NOTpravdivé.
Tento filtr hledá logy, které:
- Mají hodnotu
sophosnebovmware-vcenterv polievent.datasetA - Mají hodnotu
Authentication failed,failed passwordnebounsuccessful loginv polievent.actionA - Obsahují alespoň jedno z polí
source.ipnebouser.idA - Nemají hodnotu začínající
harryv poliuser.id
Pro další nápady a tipy na formátování si prohlédněte tento příklad v kontextu detekčního pravidla včetně podrobností o sekci predicate.
Triggery
Trigger v alertu nebo detekci provede akci. Například v detekci může sekce trigger odeslat e-mail, když je detekována specifikovaná aktivita.
Trigger může:
- Spustit událost: Odeslat událost do Elasticsearch, kde je uložena jako dokument. Pak událost vidíte jako log ve webové aplikaci TeskaLabs LogMan.io. Můžete vytvořit vlastní dashboard pro zobrazení detekcí korelačních pravidel, nebo logy najít v Discover.
- Spustit notifikaci: Odeslat zprávu e-mailem
- Aktualizovat lookup: Přidat nebo odebrat klíče používané jinými detekcemi (např. aktivní VPN uživatelé). Viz Lookups v detekcích a referenci lookup trigger.
Spuštění události
Můžete spustit událost. Výsledkem je log události, který vidíte v TeskaLabs LogMan.io.
Položka v trigger |
Jak zahrnout |
|---|---|
|
V triggeru event znamená, že pravidlo vytvoří událost na základě pozitivní detekce a pošle ji do datového pipeline přes Elasticsearch, kde je uložena jako dokument. Událost pak přijde do TeskaLabs LogMan.io, kde ji vidíte v Discover a na dashboardech.
|
|
!DICT vytvoří slovník klíčů (polí) a hodnot. type má "st:any" (řetězec), aby hodnotou v páru klíč–hodnota mohl být libovolný typ (čísla, text atd.). with začíná seznam párů klíč–hodnota, které definujete. To jsou pole a hodnoty, ze kterých se událost složí.
|
Za with uveďte seznam párů klíč–hodnota, nebo polí a hodnot, které chcete v události.
!DICT
type: "{str:any}"
with:
key.1: "value"
key.2: "value"
key.3: "value"
key.4: "value"
Pokud používáte Elasticsearch a tedy Elastic Common Schema (ECS), standardní pole popisuje ECS referenční příručka.
Spuštění notifikace
Notifikace odesílají zprávy. Aktuálně můžete notifikace použít k odesílání e-mailů.
Více o psaní notifikací, e-mailových notifikacích (včetně předávání IP adres do šablon pomocí !CAST) a vytváření e-mailových šablon.
Notifikace
Notifikace
Notifikace odesílají zprávy. Sekci notification můžete přidat kamkoli, kde chcete, aby výstup trigger byl zprávou, například v alertu nebo detekci. V detekci může sekce notification odeslat zprávu při zjištění specifikované aktivity (např. potenciální hrozby).
TeskaLabs LogMan.io používá TeskaLabs ASAB Iris, mikroservisu TeskaLabs, k odesílání zpráv.
Warning
Aby nedošlo k zahlcení notifikacemi, používejte notifikace pouze pro vysoce naléhavá a dobře otestovaná detekční pravidla. Některé detekce jsou vhodnější k odesílání jako události přes Elasticsearch a prohlížení ve webové aplikaci LogMan.io.
Typy notifikací
Aktuálně můžete odesílat zprávy přes e-mail.
LogMan.io Assets vás také může upozornit, když se objeví nový host, uživatel nebo služba (okamžitě nebo jako plánovaný souhrn přes asab-iris). Tato cesta je oddělená od triggerů detekcí; viz Notifikace při objevení nového aktiva.
Odesílání upozornění prostřednictvím e-mailu
Upozornění pište v TeskaLabs SP-Lang. Pokud píšete upozornění na detekci, napište e-mailové upozornění v sekci trigger.
Důležité
Pro upozornění, která odesílají e-maily, musíte vytvořit e-mailovou šablonu v Knihovně, se kterou se propojíte. Tato šablona obsahuje skutečný text, který příjemce uvidí, s prázdnými poli, která se mění podle toho, co bylo detekováno (používá se Jinja templating), včetně logů zapojených do detekce a jakýchkoli dalších informací dle vašeho výběru. Sekce upozornění v pravidle detekce vyplňuje prázdná pole v e-mailové šabloně. Jednu e-mailovou šablonu můžete použít pro více pravidel detekce.
Příklad:
Použijte tento příklad jako vodítko. Klikněte na ikony , abyste zjistili, co znamená každý řádek.
trigger: #(1)
- notification: #(2)
type: email #(3)
template: "/Templates/Email/Notification.md" #(4)
to: [email@example.com] #(5)
variables: #(6)
!DICT #(7)
type: "{str:any}" #(8)
with: #(9)
name: Notifikace z detekce X #(10)
events: !ARG EVENTS #(11)
address: !ITEM EVENT client.address #(12)
description: Detekce X pomocí TeskaLabs LogMan.io #(13)
-
Označuje začátek sekce
trigger. -
Označuje začátek sekce
notification. -
Pro odeslání e-mailu napište email jako
type. -
Toto řekne upozornění, kde získat e-mailovou šablonu. Musíte specifikovat cestu k e-mailové šabloně v Knihovně. V tomto příkladu je šablona v Knihovně, v záložce Templates, v podzáložce Email a jmenuje se Notification.md.
-
Napište e-mailovou adresu, kam chcete, aby e-mail přišel.
-
Začíná sekce, která dává pokyny, jak vyplnit prázdná pole z e-mailové šablony.
-
SP-Lang výraz, který vytváří slovník, abyste mohli použít páry klíč-hodnota v upozornění. (Klíč je první slovo a hodnota je následující.) Vždy zahrňte
!DICT. -
Vždy napište type "{str:any}", aby hodnoty v párech klíč-hodnota mohly být v jakémkoli formátu (čísla, slova, pole, atd.).
-
Vždy zahrňte
with, protože to začíná seznam polí z e-mailové šablony. Všechno vnořené podwithje pole z e-mailové šablony. -
Jméno pravidla detekce, které by mělo být srozumitelné příjemci.
-
eventsje klíč, nebo název pole, a!ARG EVENTSje SP-Lang výraz, který uvádí logy, které způsobily pozitivní detekci z pravidla detekce. -
addressje klíč, nebo název pole, a!ITEM EVENT client.addresszískává hodnotu poleclient.addressz každého logu, který způsobil pozitivní detekci z pravidla detekce. -
Váš popis události, který musí být velmi jasný a přesný.
Vyplňování e-mailové šablony
name, events, address a description jsou pole v e-mailové šabloně v tomto příkladu. Vždy se ujistěte, že klíče, které píšete v sekci with, odpovídají polím ve vaší e-mailové šabloně.
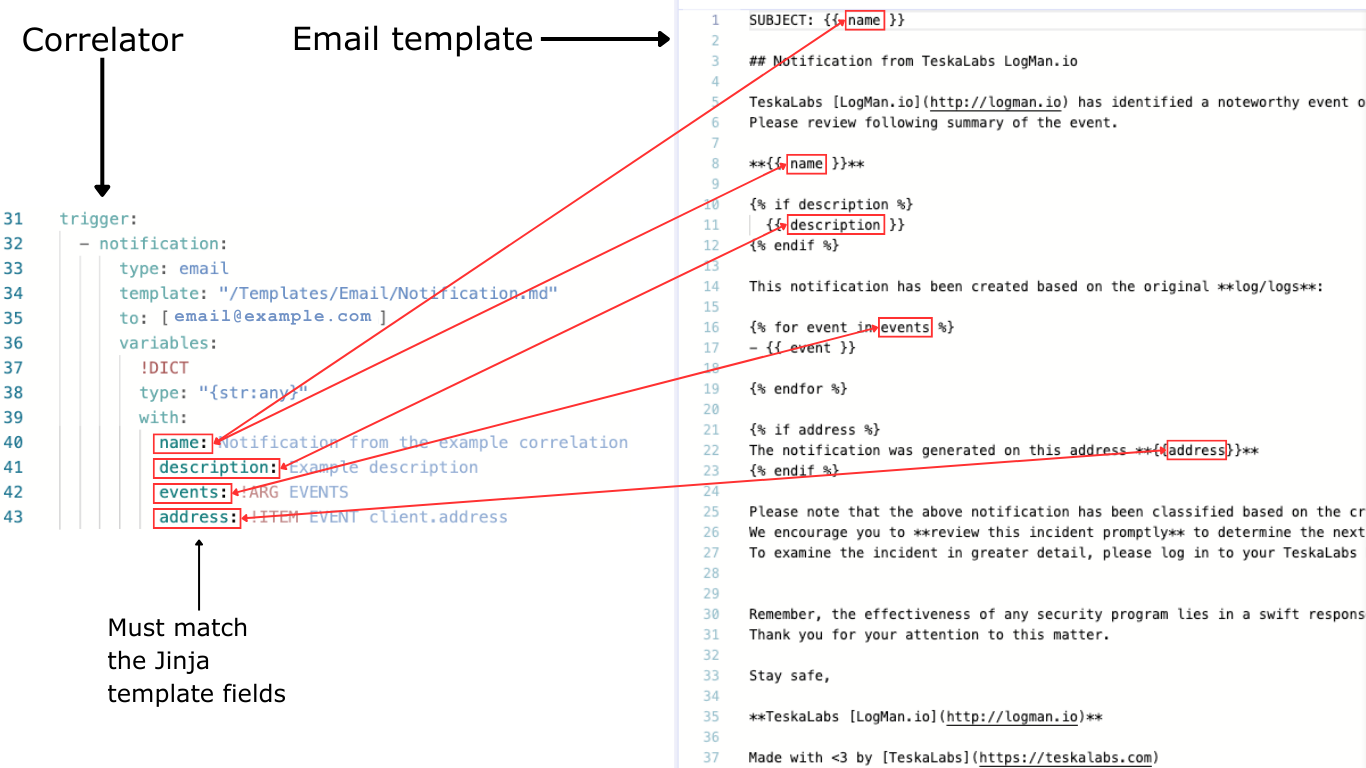
Pole name a description jsou statické textové hodnoty - zůstávají stejné v každém upozornění.
Pole events a address jsou dynamické hodnoty - mění se podle toho, které logy způsobily pozitivní detekci z pravidla detekce. Můžete psát dynamická pole použitím TeskaLabs SP-Lang.
Odkazujte se na naše pokyny pro vytváření e-mailových šablon, abyste mohli psát šablony, které správně fungují jako upozornění.
Vytvoření emailových šablon
Emailová šablona je dokument, který spolupracuje s notifikací, aby odeslal email, například jako výsledek pozitivní detekce v detekčním pravidle. Jinja šablonová pole umožňují emailové šabloně mít dynamické hodnoty, které se mění na základě proměnných, jako jsou události zapojené v pozitivní detekci. (Poté, co se naučíte vytvářet emailové šablony, naučte se používat Jinja šablonová pole.)
Emailová šablona poskytuje text, který příjemce vidí, když obdrží email z notifikace. Emailové šablony najdete ve své Knihovně ve složce Templates.
Když píšete emailovou šablonu ke spojení s notifikací, ujistěte se, že šablonová pole v každé položce odpovídají.


Jak spolu notifikace a emailová šablona spolupracují?
TeskaLabs ASAB Iris je mikroslužba pro zasílání zpráv, která spojuje notifikaci a emailovou šablonu a odesílá emaily s vyplněnými zástupnými poli.
Vytvoření emailové šablony
Vytvoření nové prázdné emailové šablony
- V Knihovně, klikněte na Templates, poté klikněte na Email.
- Vpravo klikněte na Vytvořit novou položku v Email.
- Pojmenujte svou šablonu, vyberte typ souboru a klikněte na Vytvořit. Pokud se nová položka neobjeví okamžitě, obnovte stránku.
- Nyní můžete psát šablonu.
Kopírování existující emailové šablony
- V Knihovně, klikněte na Templates, poté klikněte na Email.
- Klikněte na existující šablonu, kterou chcete zkopírovat. Kopie, kterou vytvoříte, bude umístěna ve stejné složce jako originál.
- Klikněte na ikonu v horní části obrazovky a klikněte na Copy.
- Přejmenujte soubor, vyberte typ souboru a klikněte na Copy. Pokud se nová položka neobjeví okamžitě, obnovte stránku.
- Klikněte na Edit, abyste provedli změny, a klikněte na Save, abyste uložili své změny.
Chcete-li opustit režim úprav, uložte kliknutím na Save nebo zrušte kliknutím na Cancel.
Psaní emailové šablony
Emailové šablony můžete psát v Markdown nebo v HTML. Markdown je méně složité, ale HTML vám dává více možností formátování.
Když píšete text, ujistěte se, že příjemci vyjasníte:
- Kdo email odesílá
- Proč tento email dostávají
- Co znamená email/alert
- Jak vyšetřit nebo dále postupovat při řešení problému - zahrňte všechny relevantní a užitečné informace, jako jsou ID logů nebo přímé odkazy na zobrazení vybraných logů
Jednoduchý příklad šablony pomocí Markdown:
PŘEDMĚT: {{ name }}
TeskaLabs LogMan.io identifikoval významnou událost ve vaší IT infrastruktuře, která může vyžadovat vaši okamžitou pozornost.
Prosím přezkoumejte následující shrnutí události:
Událost: {{name}}
Popis události: {{description}}
Tato notifikace byla vytvořena na základě originálního logu/logů:
{% for event in events %}
- {{event}}
{% endfor %}
Notifikace byla vygenerována pro tuto adresu: {{address}}
Doporučujeme, aby jste toto incident rychle přezkoumali a určili další příslušný postup.
Pamatujte, že účinnost jakéhokoli bezpečnostního programu spočívá v rychlé reakci.
Děkujeme za vaši pozornost k této záležitosti.
Zůstaňte v bezpečí,
TeskaLabs LogMan.io
Vytvořeno s <3 od [TeskaLabs](https://teskalabs.com)
Slova ve dvou složených závorkách (jako {{address}}) jsou šablonová pole nebo zástupce. Toto jsou Jinja šablonová pole, která čerpají informace z sekce notifikace v detekčním pravidle. O Jinja šablonách se dozvíte více zde.
Testování emailové šablony
Emailovou šablonu můžete otestovat pomocí funkce Test template. Testování emailové šablony znamená odeslání skutečného emailu, aby se zjistilo, zda se formát a pole zobrazují správně. Tento test žádným způsobem neinteraguje s detekčním pravidlem.


Vyplňte pole From, To, CC, BCC a Subject stejným způsobem jako u jakéhokoli emailu (ale je nejlepší praxí poslat email sami sobě). Vždy musíte vyplnit minimálně pole From a To.
Testovací parametry
Můžete naplnit Jinja šablonová pole pro testovací účely pomocí nástroje Parameters. Napište parametry v JSON. JSON používá páry klíč-hodnota. Klíče jsou pole v šabloně a hodnoty jsou to, co naplní pole.
V tomto příkladu jsou klíče a hodnoty zvýrazněny, aby ukázaly, že klíče v Parameters musí odpovídat polím v šabloně a hodnoty naplní pole ve výsledném emailu:


Parameters má dva režimy úprav: textový editor a klikací JSON editor. Chcete-li přepínat mezi režimy, klikněte na ikonu <···> nebo vedle Parameters. Můžete přepínat mezi režimy bez ztráty své práce.
Klikací editor
Chcete-li přepnout na klikací JSON editor, klikněte na ikonu <···> vedle Parameters. Klikací editor formátuje vaše parametry za vás a říká vám typ hodnoty pro každou položku.
Jak používat klikací editor:
V klikacím editoru, editujte, smažte a přidejte ikony, které se zobrazují při najetí myší nad řádky a položky.
1. Přidejte klíč: Když najedete myší nad horní řádek (říká počet klíčů, které máte, například 0 items), objeví se ikona . Chcete-li přidat parametr, klikněte na ikonu . Výzva vás požádá o název klíče. Zadejte název klíče (název pole, které chcete testovat) a klikněte na ikonu , aby se uložil. Nepoužívejte uvozovky - editor je přidá za vás. Název klíče se objeví vedle hodnoty NULL.


2. Přidejte hodnotu: Chcete-li upravit hodnotu, klikněte na ikonu , která se objeví, když najedete myší vedle hodnoty NULL. Zadejte hodnotu (co chcete, aby se zobrazilo místo pole/zástupce v emailu, který odešlete), a uložte kliknutím na ikonu .


3. Chcete-li přidat další páry klíč-hodnota, klikněte na ikonu , která se objeví, když najedete myší nad horní řádek.
4. Chcete-li položku smazat, klikněte na ikonu , která se objeví, když najedete myší nad položku. Chcete-li položku upravit, klikněte na ikonu , která se objeví, když najedete myší nad položku.
Textový editor
Chcete-li přepnout do textového editoru, klikněte na ikonu vedle Parameters.
Příklad formátování parametrů:
{
"name":"Detection rule 1",
"description":"Description of Detection rule 1",
"events":["log-ID-1", "log-ID-2", "log-ID-3"],
"address":"Example address"
}
Rychlé tipy pro JSON
- Parametry začněte a ukončete složenými závorkami
{} - Každou položku, jak klíče, tak hodnoty, pište do uvozovek
"" - Připojte klíče k jejich hodnotám dvojtečkou
:(např.:"key":"value") - Oddělte páry klíč-hodnota čárkami
,. Můžete také použít mezery a nové řádky pro lepší čitelnost - ve funkci budou ignorovány. - Pole pište do závorek
[]a oddělte položky čárkami (klíčeventsmůže mít více hodnot, jak umožňuje výrok Jinjafor, takže zde je to napsáno jako pole)
Testovací okno vám řekne, pokud parametry nejsou v platném formátu JSON.
Přepínání režimů
Můžete přepínat režimy a pokračovat v úpravách svých parametrů. Nástroj Parameters automaticky převede vaši práci na nový režim.


Poznámka o polích
Pole je seznam více hodnot. Chcete-li upravit hodnotu pole v klikacím editoru, musíte nejprve ručně napsat alespoň dvě hodnoty ve správném formátu pole v textovém editoru (viz Rychlé tipy pro JSON výše). Poté můžete přepnout do klikacího editoru a přidat další položky do pole.
Odeslání testovacího emailu
Když budete připraveni testovat email, klikněte na Send. Obdržíte email do schránky adresáta v poli To:, kde můžete zkontrolovat formátování šablony. Pokud email nevidíte, zkontrolujte svou složku se spamem.
Jinja šablonování
Sekce notification v detekčním pravidlu pracuje s emailovou šablonou k odeslání zprávy, když je detekční pravidlo spuštěno. Emailová šablona obsahuje pole pro zástupce, a notifikace určuje, co tato zástupná pole v reálném emailu, který příjemce obdrží, vyplní. To je možné díky šablonovacímu jazyku Jinja. (Naučte se psát emailové šablony před tím, než se naučíte o Jinja polích.)
Formát
Formátujte všechna Jinja šablonová pole dvěma složenými závorkami na každé straně názvu pole, jak v Markdown, tak v HTML emailových šablonách. Můžete, ale nemusíte, použít mezeru na každé straně názvu pole.
{{fieldname}} NEBO {{ fieldname }}
Pro podrobnější vysvětlení šablonování pomocí Jinja navštivte tento návod.
if výraz
Možná budete chtít použít stejnou emailovou šablonu pro více detekčních pravidel. Vzhledem k tomu, že různá detekční pravidla mohou obsahovat různá data, některé části vašeho emailu mohou být relevantní pouze pro některá detekční pravidla. Můžete použít if, aby se sekce zahrnula pouze tehdy, pokud má určitý klíč v notifikační šabloně hodnotu. To vám pomůže vyhnout se nevyplněným šablonovým polím nebo nesmyslnému textu v emailu.
V tomto příkladu bude vše mezi if a endif zahrnuto v emailu pouze tehdy, pokud má klíč sender hodnotu v notifikační sekci detekčního pravidla. (Pokud není hodnota pro sender, tato sekce se v emailu neobjeví.)
{% if sender %}
Emailová adresa {{ sender }} odeslala podezřelé množství emailů.
{% endif %}
Pro více detailů navštivte tento návod.
for výraz
Použijte for, když máte více hodnot ze stejné kategorie, které chcete zobrazit jako seznam ve vašem emailu.
V tomto příkladu je events skutečné pole šablony, které vidíte v notifikaci, a může obsahovat více hodnot (v tomto případě více log ID). Zde je log pouze dočasná proměnná používaná pouze v tomto for výrazu k reprezentaci jedné hodnoty, kterou notifikace odesílá z pole events. (Tato dočasná proměnná může být jakékoli slovo, protože odkazuje pouze na sebe v emailové šabloně.) Výraz for umožňuje šabloně zobrazit tyto více hodnot jako odrážkový seznam (více instancí).
{% for log in events %}
- {{ log }}
{% endfor %}
Pro více detailů navštivte tento návod.
Link šablonování
Díky TeskaLabs ASAB Iris můžete do svých emailů zahrnout odkazy, které se mění na základě tenanta nebo událostí detekovaných pravidlem.
Odkaz na domovskou stránku tenanta:
{{lmio_url}}/?tenant={{tenant}}#/
tenant do sekce notification vašeho detekčního pravidla, aby odkaz fungoval.
Odkaz na specifický log:
[{{event}}]({{lmio_url}}/?tenant={{tenant}}#/discover/lmio-{{tenant}}-events?aggby=minute&filter={{event}}&ts=now-2d&te=now&refresh=off&size=40)
tenant nebo lmio_url do sekce notification vašeho detekčního pravidla, aby odkaz fungoval.Použití Base64 obrázků v HTML šablonách e-mailů
Pro pevné zakódování obrázku do e-mailové šablony napsané v HTML použijte Base64. Převod obrázku na Base64 přemění obrázek na dlouhý řetězec textu.
- Použijte nástroj pro převod obrázku (například tento od Atatus), abyste svůj obrázek převedli na Base64.
- Pomocí tagů
<img>pro obrázek aaltpro alternativní text zkopírujte a vložte Base64 řetězec do své šablony takto:
<img alt="ZDE ALTERNATIVNÍ TEXT" src="ZDE VLOŽTE"/>
Poznámka
Alternativní text je volitelný, ale doporučuje se, protože se zobrazí v případě, že se váš obrázek z nějakého důvodu nenačte.
Administrační manuál
Administrátorská příručka TeskaLabs LogMan.io
Vítejte v administrátorské příručce. Použijte tuto příručku k nastavení a konfiguraci LogMan.io pro sebe nebo klienty.
Instalace
Instalace
TeskaLabs LogMan.io může být nainstalován na fyzických serverech ("bare metal"), virtuálních serverech, soukromých a veřejných cloudových instancích. Může běžet jak jako instalace na jednom uzlu, tak v clusteru pro zajištění vysoké dostupnosti.
Požadavky na cluster
Všechny uzly clusteru MUSÍ splňovat všechny předpoklady. Počet jádrových uzlů clusteru musí být lichý (3, 5 atd.), aby se předešlo split-brain.
Předpoklady
- Fyzický nebo virtuální server, specifikace je zde
- OS Linux: Ubuntu 22.04 LTS, RedHat 9, CentOS 9 (pro ostatní nás prosím kontaktujte)
- Síťové připojení s povoleným odchozím přístupem na Internet (může být omezeno po instalaci); podrobnosti jsou popsány zde
- Přihlašovací údaje k SMTP serveru pro odchozí e-maily
- DNS doména, i interní (potřebná pro nastavení HTTPS)
- Přihlašovací údaje k TeskaLabs Docker registru
docker.teskalabs.com(kontaktujte naši podporu, pokud je nemáte)
Plán implementace
Pro větší nebo důležitou instalaci poskytujeme šablonu plánu implementace. Plán implementace pomáhá shromáždit předpoklady od koncového uživatele. Prosím kontaktujte naši podporu, abyste získali kopii.
Instalace
Ujistěte se, že splňujete všechny předpoklady pro každý krok.
- Fáze 1: Z bare metal na operační systém
- Fáze 2: Z operačního systému na Docker
- Fáze 3: Instalace TeskaLabs LogMan.io
- Fáze 4: Úvodní nastavení TeskaLabs LogMan.io
Danger
TeskaLabs LogMan.io NEMŮŽE být provozován pod uživatelským účtem root (superuživatel). Porušení tohoto pravidla může vést k významným kybernetickým rizikům.
Od fyzického serveru k operačnímu systému
Note
Přeskočte tuto fázi, pokud instalujete na virtuálním stroji, respektive na hostiteli, na kterém je již nainstalován operační systém.
Požadavky
- Server, který vyhovuje předepsané organizaci ukládání dat.
- Bootovatelný USB flash disk s Ubuntu Server 22.04 LTS; nejnovější verze.
- Přístup k serveru vybavenému monitorem a klávesnicí; alternativně přes IPMI nebo ekvivalentní Out-of-band management.
- Síťové připojení s povoleným odchozím přístupem na Internet.
Note
Toto jsou další požadavky nad rámec obecných požadavků.
Kroky
1) Spusťte server pomocí bootovatelného USB flash disku s Ubuntu Server.
Vložte bootovatelný USB flash disk do USB portu serveru a poté zapněte server.
Použijte UEFI oddíl na USB flash disku jako bootovací zařízení.
Vyberte „Zkusit nebo nainstalovat Ubuntu Server“ v bootovacím menu.
2) Vyberte „Čeština“ jako jazyk
3) Aktualizujte na nový instalátor, pokud je to potřeba
4) Vyberte českou klávesnici
5) Vyberte typ instalace „Ubuntu Server“
6) Nakonfigurujte síťové připojení
Toto je síťová konfigurace pro účely instalace, konečná síťová konfigurace může být odlišná.
Pokud používáte DHCP server, je síťová konfigurace automatická.
DŮLEŽITÉ: Internetové připojení musí být k dispozici.
Poznamenejte si IP adresu serveru pro budoucí použití.
7) Přeskočte nebo nakonfigurujte proxy server
Přeskočte (stiskněte „Hotovo“) konfiguraci proxy serveru.
8) Potvrďte vybranou adresu zrcadla
Potvrďte vybranou adresu zrcadla stisknutím „Hotovo“.
9) Vyberte „Vlastní uspořádání úložiště“
Vlastní uspořádání úložiště systému je následující:
| Mount | Velikost | FS | Part. | RAID / Part. | VG / LV |
|---|---|---|---|---|---|
/boot/efi |
1G | fat32 | 1 | ||
| SWAP | 64G | 2 | |||
/boot |
2G | ext4 | 3 | md0 / 1 |
|
/ |
50G | ext4 | 3 | md0 / 2 |
systemvg / rootlv |
/var/log |
50G | ext4 | 3 | md0 / 2 |
systemvg / loglv |
| Nepoužité | >100G | 3 | md0 / 2 |
systemvg |
Legenda:
- FS: Souborový systém
- Part.: GUID oddíl
- RAID / Part.: MD RAID svazek a oddíl na daném RAID svazku
- VG: LVM Skupina svazků
- LV: LVM Logický svazek
Note
Nepoužitý prostor bude později použit během instalace např. pro Docker kontejnery.
10) Identifikujte dva systémové úložné disky
Dva systémové úložné disky jsou strukturovány symetricky pro zajištění redundancy v případě selhání jednoho systémového disku.
Note
Rychlé a pomalé úložiště není zde konfigurováno během instalace OS, ale později z nainstalovaného OS.
11) Nastavte první systémový disk jako primární bootovací zařízení
Tento krok vytvoří první GPT oddíl s UEFI, který je namontován na /boot/efi.
Velikost tohoto oddílu je přibližně 1 GB.
12) Nastavte druhý systémový disk jako sekundární bootovací zařízení
Další UEFI oddíl je vytvořen na druhém systémovém disku.
13) Vytvořte SWAP oddíly na obou systémových discích
Na každém z dvou disků přidejte GPT oddíl o velikosti 64G a formát swap.
Vyberte „volný prostor“ na příslušném systémovém disku a poté „Přidat GPT oddíl“
Výsledné uspořádání je následující:
14) Vytvořte GPT oddíl pro RAID1 na obou systémových discích
Na každém z dvou disků přidejte GPT oddíl se vším zbývajícím volným prostorem. Formát je „Neformátovat“, protože tento oddíl bude přidán do RAID1 pole. Můžete nechat „Velikost“ prázdnou, abyste použili veškerý zbývající prostor na zařízení.
Výsledkem je „oddíl“ místo „volného prostoru“ na příslušných discích.
15) Vytvořte softwarový RAID1
Vyberte „Vytvořit softwarový RAID (md)“.
Název pole je md0 (výchozí).
RAID úroveň je „1 (zrcadlené)“.
Vyberte dva oddíly z výše uvedeného kroku, nechte je označené jako „aktivní“ a stiskněte „Vytvořit“.
Uspořádání systémových disků je následující:
16) Vytvořte BOOT oddíl RAID1
Přidejte GPT oddíl na md0 RAID1 z výše uvedeného kroku.
Velikost je 2G, formát je ext4 a mount je /boot.
17) Nastavte LVM oddíl na RAID1
Zbývající prostor na RAID1 bude spravován pomocí LVM.
Přidejte GPT oddíl na md0 RAID1, pomocí „volného prostoru“ pod zařízením md0.
Použijte maximální dostupný prostor a nastavte formát na „Neformátovat“. Můžete nechat „Velikost“ prázdnou, abyste použili veškerý zbývající prostor na zařízení.
18) Nastavte LVM skupinu svazků systému
Vyberte „Vytvořit skupinu svazků (LVM)“.
Název skupiny svazků je systemvg.
Vyberte dostupný oddíl na md0, který byl vytvořen výše.
19) Vytvořte logický svazek root
Přidejte logický svazek s názvem rootlv na systemvg (v „volném prostoru“), velikost je 50G, formát je ext4 a mount je /.
20) Přidejte dedikovaný logický svazek pro systémové logy
Přidejte logický svazek s názvem loglv na systemvg, velikost je 50G, formát je ext4 a mount je „Jiné“ a /var/log.
21) Potvrďte uspořádání systémových disků
Stiskněte „Hotovo“ na spodní části obrazovky a nakonec „Pokračovat“, abyste potvrdili aplikaci akcí na systémových discích.
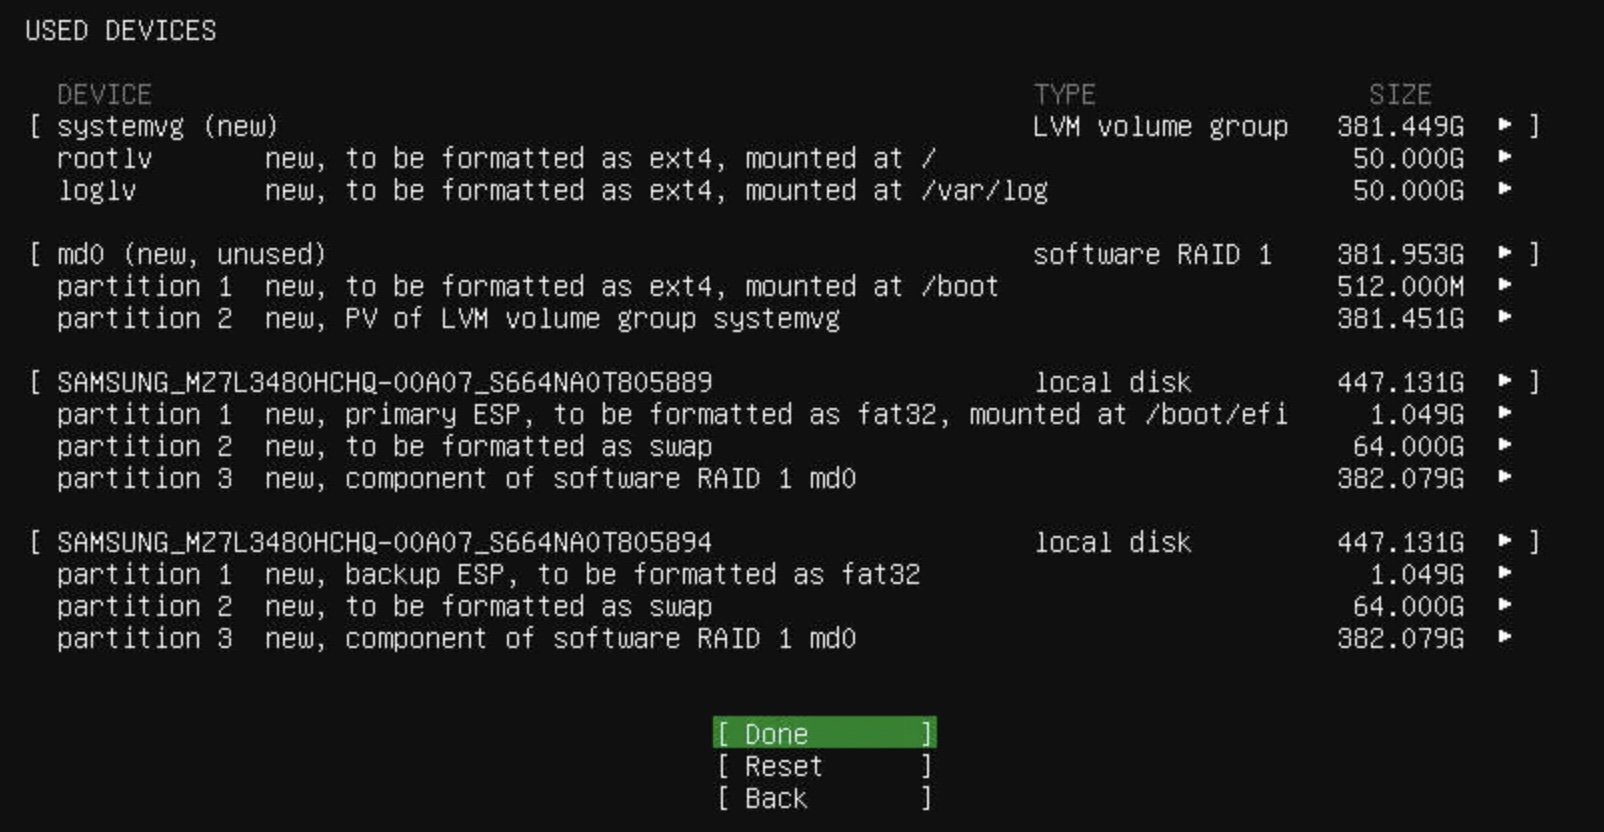
22) Nastavení profilu
Vaše jméno: TeskaLabs Admin
Název vašeho serveru: lm01 (například)
Vyberte uživatelské jméno: tladmin
Vyberte dočasné heslo, které bude odstraněno na konci instalace.
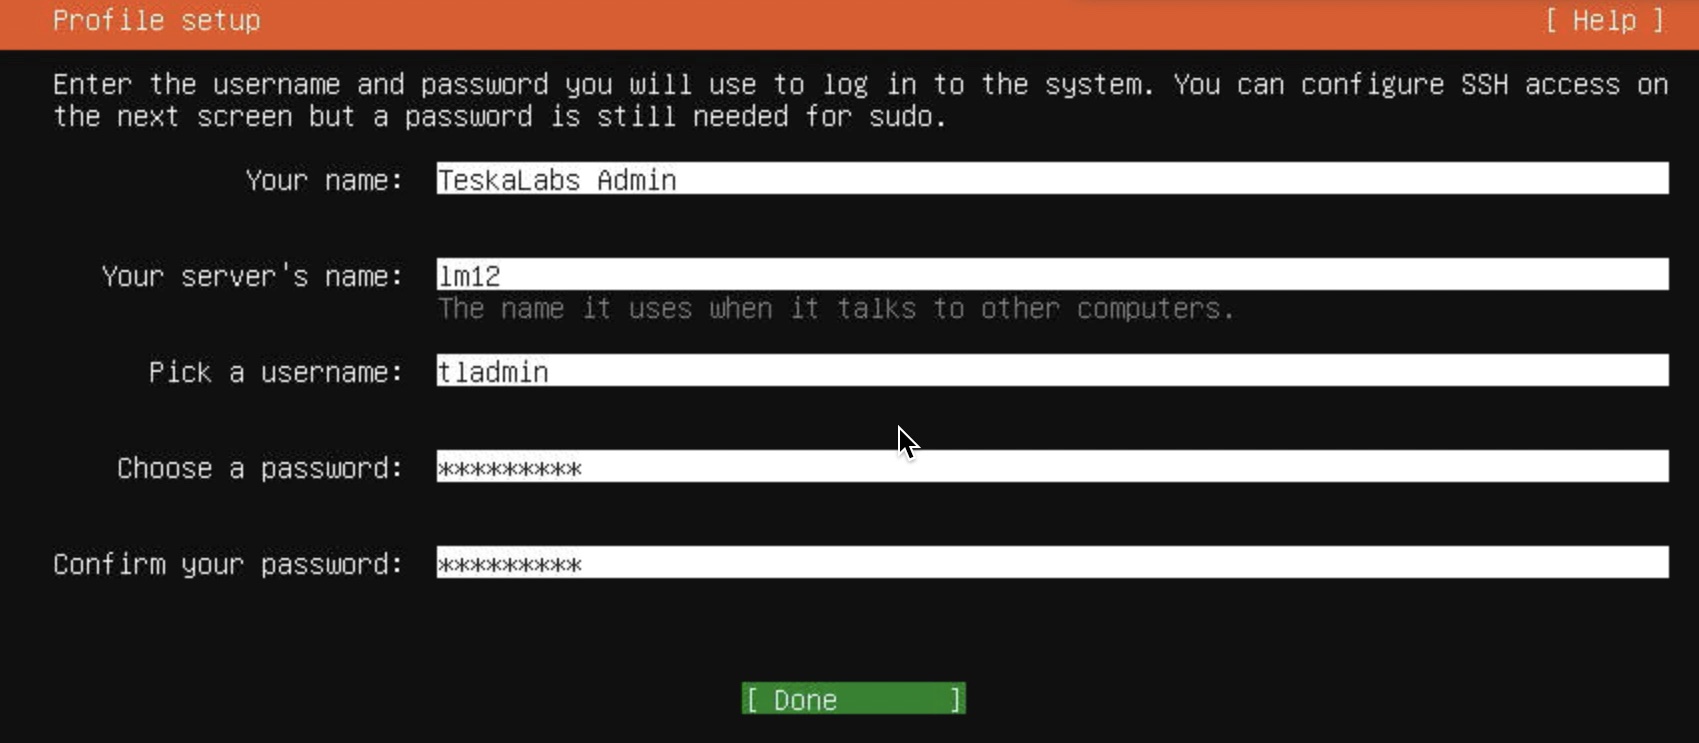
23) Nastavení SSH
Vyberte „Nainstalovat OpenSSH server“
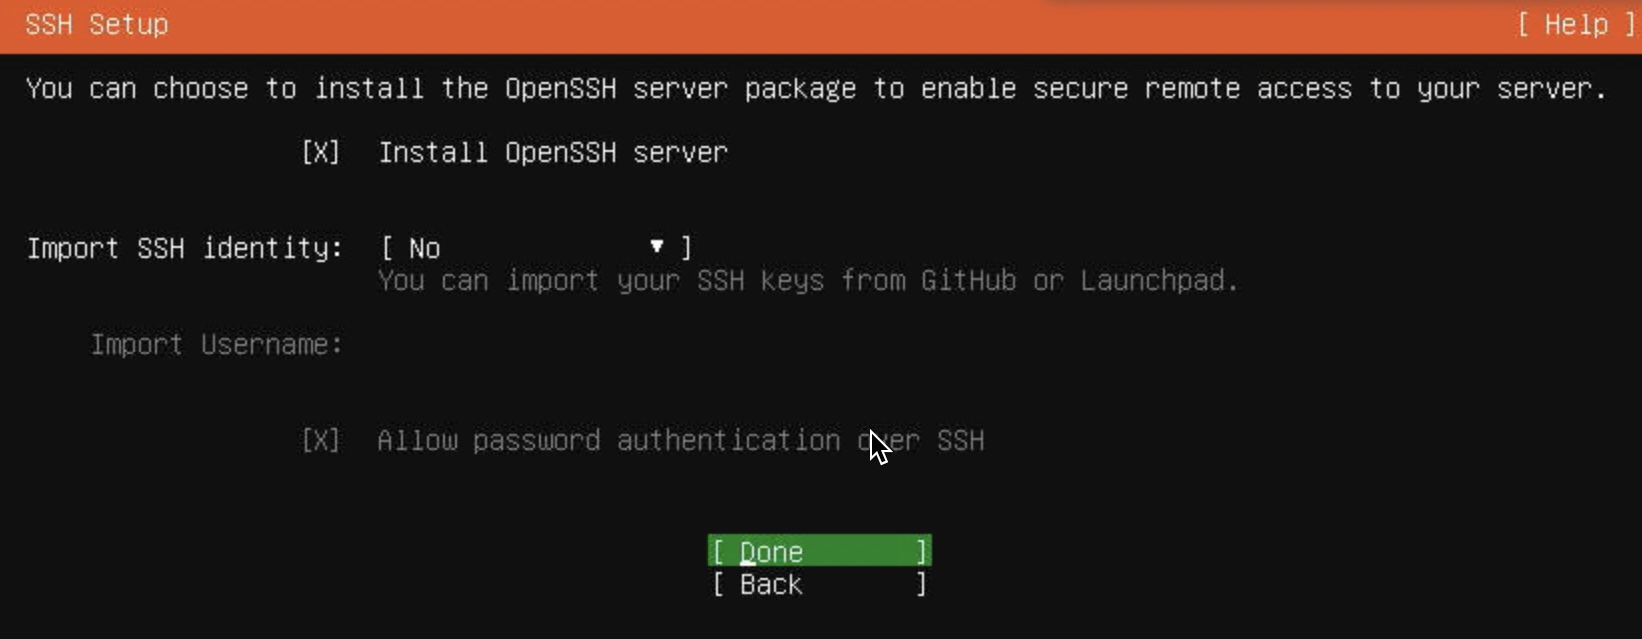
24) Přeskočte serverové snapy
Stiskněte „Hotovo“, žádné serverové snapy nebudou nainstalovány z této obrazovky.
25) Počkejte, až bude server nainstalován
Trvá to přibližně 10 minut.
Když je instalace dokončena, včetně bezpečnostních aktualizací, vyberte „Restartovat nyní“.
26) Když budete vyzváni, odpojte USB flash disk ze serveru
Stiskněte „Enter“, abyste pokračovali v procesu restartování.

Note
Tento krok můžete přeskočit, pokud instalujete přes IPMI.
27) Spusťte server do nainstalovaného OS
Vyberte „Ubuntu“ na obrazovce GRUB nebo prostě počkejte 30 sekund.
28) Přihlaste se jako tladmin
29) Aktualizujte operační systém
sudo apt update
sudo apt upgrade
sudo apt autoremove
30) Nakonfigurujte pomalé úložiště dat
Pomalé úložiště dat (HDD) je namontováno na /data/hdd.
Předpokládáme, že server poskytuje následující disková zařízení /dev/sdc, /dev/sdd, /dev/sde, /dev/sdf, /dev/sdg a /dev/sdh.
Vytvořte softwarové RAID5 pole na /dev/md1 s ext4 souborovým systémem, namontovaným na /data/hdd.
sudo mdadm --create /dev/md1 --level=5 --raid-devices=6 /dev/sdc /dev/sdd /dev/sde /dev/sdf /dev/sdg /dev/sdh
Note
Pro RAID6 pole použijte --level=6.
Vytvořte EXT4 souborový systém a mount point:
sudo mkfs.ext4 -L data-hdd /dev/md1
sudo mkdir -p /data/hdd
Zadejte následující řádek do /etc/fstab:
/dev/disk/by-label/data-hdd /data/hdd ext4 defaults,noatime 0 1
Danger
Příznak noatime je důležitý pro optimální výkon úložiště.
Namontujte disk:
sudo mount /data/hdd
Note
Konstrukce RAID pole může trvat značnou dobu. Můžete sledovat průběh pomocí cat /proc/mdstat. Restartování serveru je během konstrukce RAID pole bezpečné.
Můžete urychlit konstrukci zvýšením rychlostních limitů:
sudo sysctl -w dev.raid.speed_limit_min=5000000
sudo sysctl -w dev.raid.speed_limit_max=50000000
Tato nastavení rychlostních limitů vydrží až do dalšího restartu.
31) Nakonfigurujte rychlé úložiště dat
Rychlé úložiště dat (SSD) je namontováno na /data/ssd.
Předpokládáme, že server poskytuje následující disková zařízení /dev/nvme0n1 a /dev/nvme1n1.
Vytvořte softwarové RAID1 pole na /dev/md2 s ext4 souborovým systémem, namontovaným na /data/ssd.
sudo mdadm --create /dev/md2 --level=1 --raid-devices=2 /dev/nvme0n1 /dev/nvme1n1
sudo mkfs.ext4 -L data-ssd /dev/md2
sudo mkdir -p /data/ssd
Zadejte následující řádek do /etc/fstab:
/dev/disk/by-label/data-ssd /data/ssd ext4 defaults,noatime 0 1
Danger
Příznak noatime je důležitý pro optimální výkon úložiště.
Namontujte disk:
sudo mount /data/ssd
32) Uložte konfiguraci RAID pole
Spusťte:
sudo mdadm --detail --scan > /etc/mdadm/mdadm.conf
sudo echo "MAILADDR root" >> /etc/mdadm/mdadm.conf
Aktualizujte init ramdisk:
sudo update-initramfs -u
33) Deaktivujte periodickou kontrolu RAID
sudo systemctl disable mdcheck_continue
sudo systemctl disable mdcheck_start
34) Nainstalujte základní nástroje
sudo apt install cron dnsutils iputils-ping tcpdump netcat
sudo apt autoremove
35) Instalace OS je dokončena
Restartujte server, abyste ověřili správnost instalace OS.
sudo reboot
Zde je video, které shrnuje instalační proces:
Od operačního systému k Dockeru
V této fázi nejen nainstalujete Docker, ale také celkově připravíte stroj na instalaci TeskaLabs LogMan.io.
Pokud jste přeskočili instalaci na holém hardwaru a provedli instalaci na virtuálním serveru, věnujte pozornost požadavkům.
Požadavky
- Běžící server s nainstalovaným operačním systémem.
- Přístup na server přes SSH, uživatel je
tladmins oprávněním vykonávatsudo. - Pomalé úložiště připojené na
/data/hdd. - Rychlé úložiště připojené na
/data/ssd.
Časové pásmo UTC
Časové pásmo operačního systému pro TeskaLabs LogMan.io MUSÍ být nastaveno na UTC.
Pokud není časové pásmo již nastaveno na UTC, spusťte následující příkaz pro jeho konfiguraci:
sudo timedatectl set-timezone UTC
Kroky
1) Přihlaste se na server přes SSH jako uživatel tladmin
ssh tladmin@<ip-of-the-server>
2) Nakonfigurujte přístup přes SSH
Nainstalujte veřejný SSH klíč pro uživatele tladmin:
cat > /home/tladmin/.ssh/authorized_keys
Omezení přístupu:
sudo vi /etc/ssh/sshd_config
Změny v /etc/ssh/sshd_config:
PermitRootLoginnanoPubkeyAuthenticationnayesPasswordAuthenticationnano
Odstraňte výchozí konfiguraci:
sudo rm /etc/ssh/sshd_config.d/50-cloud-init.conf
3) Nakonfigurujte síť
Odstraňte výchozí cloud-init konfiguraci:
sudo rm /etc/netplan/50-cloud-init.yaml
Vytvořte novou Netplan konfiguraci:
sudo vi /etc/netplan/netplan.yaml
Tip
Podívejte se na kapitolu Networking pro více podrobností o správné konfiguraci sítě.
Aplikujte novou síťovou konfiguraci:
sudo netplan apply
4) Nakonfigurujte parametry jádra Linuxu
Zapište tento obsah do souboru /etc/sysctl.d/01-logman-io.conf
vm.max_map_count=262144
net.ipv4.ip_unprivileged_port_start=80
fs.inotify.max_user_instances=1024
fs.inotify.max_user_watches=1048576
fs.inotify.max_queued_events=16384
Parametr vm.max_map_count zvyšuje maximální počet mmaps v subsystému virtuální paměti Linuxu.
Je to potřeba pro Elasticsearch.
Parametr net.ipv4.ip_unprivileged_port_start umožňuje neprivilegovaným procesům naslouchat na portu 80 (a více).
To je potřeba, aby NGINX mohl naslouchat na tomto portu a nevyžadoval zvýšená oprávnění.
5) Nainstalujte Docker
Docker je nezbytný pro nasazení všech mikroservis LogMan.io v kontejnerech, konkrétně Apache Kafka, Elasticsearch, NGINX a jednotlivé streamingové pumpy atd.
Vytvořte logický svazek dockerlv s EXT4 souborovým systémem:
sudo lvcreate -L100G -n dockerlv systemvg
sudo mkfs.ext4 -L docker-ssd /dev/systemvg/dockerlv
sudo mkdir /var/lib/docker
Zadejte následující řádek do /etc/fstab:
/dev/disk/by-label/docker-ssd /var/lib/docker ext4 defaults,noatime 0 1
Připojte svazek:
sudo mount /var/lib/docker
Nainstalujte balíček Docker:
sudo apt-get install ca-certificates curl gnupg lsb-release
sudo mkdir -p /etc/apt/keyrings
curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
sudo chmod a+r /etc/apt/keyrings/docker.gpg
echo "deb [arch=$(dpkg --print-architecture) signed-by=/etc/apt/keyrings/docker.gpg] https://download.docker.com/linux/ubuntu $(lsb_release -cs) stable" | sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
sudo apt-get update
sudo apt-get install docker-ce docker-ce-cli containerd.io docker-compose-plugin
sudo usermod -aG docker tladmin
Znovu se přihlaste na server, aby se projevila změna skupiny.
6) Deaktivujte Docker bridge síť
Docker vytváří bridge síť (docker0) ve výchozím nastavení, která není potřebná pro TeskaLabs LogMan.io.
Toto je způsob, jak deaktivovat výchozí bridge síť Dockeru.
Vytvořte soubor /etc/docker/daemon.json s následujícím obsahem:
{
"bridge": "none"
}
7) Nainstalujte Wireguard
Wireguard je rychlá a nejbezpečnější VPN technologie. TeskaLabs LogMan.io využívá Wireguard pro interní komunikaci v rámci clusteru.
Rozsah IP adres Wireguard sítě je 192.0.2.0/24.
Každý uzel clusteru získá jednu IP adresu z tohoto rozsahu, první uzel dostane 192.0.2.1, druhý 192.0.2.2 a tak dále.
Co je to podsíť 192.0.2.0/24?
Celý blok 192.0.2.0/24 je definován v RFC 5737 jako podsíť TEST-NET-1. Jeho použití interně v TeskaLabs LogMan.io minimalizuje riziko konfliktu s existujícím soukromým IP rozsahem v síti. Můžete použít jakoukoli jinou soukromou síť podle svých potřeb a požadavků.
sudo apt install wireguard
sudo su -
cd /etc/wireguard/
umask 077
wg genkey > wg0.key
wg pubkey < wg0.key > wg0.pub
Vytvořte /etc/wireguard/wg0.conf s následujícím obsahem.
Upravte sekce [Peer], aby odrážely rozložení vašeho clusteru.
Pokud instalujete variantu s jedním uzlem, bude přítomna pouze jedna sekce [Peer].
Na každém uzlu nakonfigurujte sekci Interface s odpovídajícím privátním klíčem a IP adresou příslušného uzlu.
[Interface]
PrivateKey = <obsah souboru wg0.key>
ListenPort = 41194
Address = 192.0.2.1/24
MTU = 1412
[Peer]
# První uzel
PublicKey = <obsah souboru wg0.pub>
Endpoint = <IP adresa prvního uzlu lm1>:41194
AllowedIPs = 192.0.2.1/32
PersistentKeepalive = 60
[Peer]
# Druhý uzel
PublicKey = <obsah souboru wg0.pub ze uzlu lm2>
Endpoint = <IP adresa druhého uzlu lm2>:41194
AllowedIPs = 192.0.2.2/32
PersistentKeepalive = 60
[Peer]
# Třetí nebo jakýkoli jiný uzel
PublicKey = <obsah souboru wg0.pub ze uzlu lm3>
Endpoint = <IP adresa uzlu lm3>:41194
AllowedIPs = 192.0.2.3/32
PersistentKeepalive = 60
sudo wg-quick up wg0
sudo systemctl enable wg-quick@wg0.service
8) Nakonfigurujte rozlišení názvů hostitelů (volitelně)
Cluster TeskaLabs LogMan.io vyžaduje, aby každý uzel mohl rozlišit IP adresu jakéhokoli jiného uzlu clusteru podle jeho názvu.
Pokud nakonfigurovaný DNS server tuto schopnost neposkytuje, názvy uzlů a jejich IP adresy musí být vloženy do /etc/hosts.
sudo vi /etc/hosts
Příklad /etc/hosts
192.0.2.1 lm1
192.0.2.2 lm2
192.0.2.3 lm3
Všimněte si, že IP adresy jsou převzaty z rozsahu Wireguard.
Použijte tyto IP adresy při nastavování LogMan.io v následujících krocích.
9) Restartujte server
sudo reboot
Je důležité aplikovat všechny výše uvedené parametry.
Instalace TeskaLabs LogMan.io
Požadavky
- Správné nastavení disků a logických svazků podle předchozích fází.
- Konfigurace v
/etc/sysctl.d/01-logman-io.confje aplikována. - Docker běží a uživatel
tladminje ve skupinědocker. - Ujistěte se, že adresář
/opt/siteje prázdný.
Info
Data budou uložena v adresářích /data/hdd a /data/ssd.
Ujistěte se, že tyto složky neobsahují žádný obsah, který by mohl interferovat s instalací.
Note
Můžete použít skript pro kontrolu požadavků pro rychlou kontrolu vašeho systému.
# Stáhněte skript
curl https://libsreg.z6.web.core.windows.net/prerequisites/prerequisites.sh -o /tmp/prerequisites.sh
# Stáhněte odpovídající SHA-256 kontrolní součet
curl https://libsreg.z6.web.core.windows.net/prerequisites/prerequisites.sh.sha256 -o /tmp/prerequisites.sh.sha256
# Ověřte integritu skriptu
(cd /tmp && sha256sum -c prerequisites.sh.sha256)
# Umožněte skriptu být spustitelným a spusťte ho
chmod +x /tmp/prerequisites.sh
(cd /tmp && ./prerequisites.sh)
rm /tmp/prerequisites.sh /tmp/prerequisites.sh.sha256
První uzel nebo jediný uzel
1) Stáhněte instalační skript
curl -s https://lmio.blob.core.windows.net/library/lmio/install-ubuntu2204.sh -o /tmp/install-lmio.sh
2) Spusťte instalaci
sudo bash /tmp/install-lmio.sh
Vyberte "První jádrový uzel"
Stiskněte < Pokračovat >
Zadejte přihlašovací údaje do registru Docker TeskaLabs
Stiskněte < Přihlásit se > pro pokračování.
Note
Přihlašovací údaje poskytuje podpora TeskaLabs. Prosím, kontaktujte nás, pokud je nemáte.
Vyplňte ID uzlu a IP adresu
ID uzlu je název hostitele a MUSÍ být rozpoznatelný.
IP adresa musí být dosažitelná z ostatních uzlů clusteru přes interní síť. Pro instalaci jediného uzlu použijte IP adresu stroje v síti Froting.
Jakmile zadáte všechny potřebné informace a potvrdíte stisknutím tlačítka, instalace pokračuje. To může trvat od několika minut až po půl hodiny. Buďte trpěliví a nezastavujte proces.
Sledování instalace
Pro sledování Docker kontejnerů, které se registrují, otevřete druhý terminál a zadejte watch docker ps -a.
3) Otevřete webové uživatelské rozhraní
Webová aplikace TeskaLabs LogMan.io bude přístupná na portu 443 s použitím názvu hostitele jako doménového jména.
V příkladu, https://lmio-test/.
4) První uzel je nainstalován
LogMan.io může běžet jak jako instalace jediného uzlu, tak v clusteru. Pokud běžíte LogMan.io pouze na jednom stroji, vaše instalace je dokončena. Pokračujte k nastavení vaší instalace TeskaLabs LogMan.io pro sběr logů.
Druhý a třetí uzel
Ujistěte se, že druhý a třetí jádrový uzel clusteru splňuje požadavky uvedené na začátku této stránky. Také se ujistěte, že můžete dosáhnout prvního uzlu clusteru přes síť.
Pokud jste připraveni, použijte tento příkaz pro zahájení instalace.
docker run -it --rm --pull always \
-v /var/run/docker.sock:/var/run/docker.sock \
-v /opt/site:/opt/site \
-v /opt/site/docker/conf:/root/.docker/ \
-v /data:/data \
-e NODE_ID=`hostname -s` \
--network=host \
pcr.teskalabs.com/asab/asab-governator:stable \
python3 -m governator.bootstrap
Když se GUI otevře, vyberte instalaci druhého/třetího jádrového uzlu.
Na další obrazovce zadejte IP adresu prvního uzlu clusteru, ke kterému se chcete připojit.
Další obrazovka zobrazuje aktuální stav clusteru Zookeeper a umožňuje vám zkontrolovat název hostitele a IP adresu.
Zkontrolujte nebo opravte název hostitele a IP adresu a stiskněte "Vytvořit nový uzel clusteru"
Čekejte, až proces skončí.
Zbytek lze nastavit z webové aplikace LogMan.io. Takže, přihlaste se.
Na novém uzlu clusteru (lmio-test2) běží nové instance. Zkontrolujte to na obrazovce Služby.
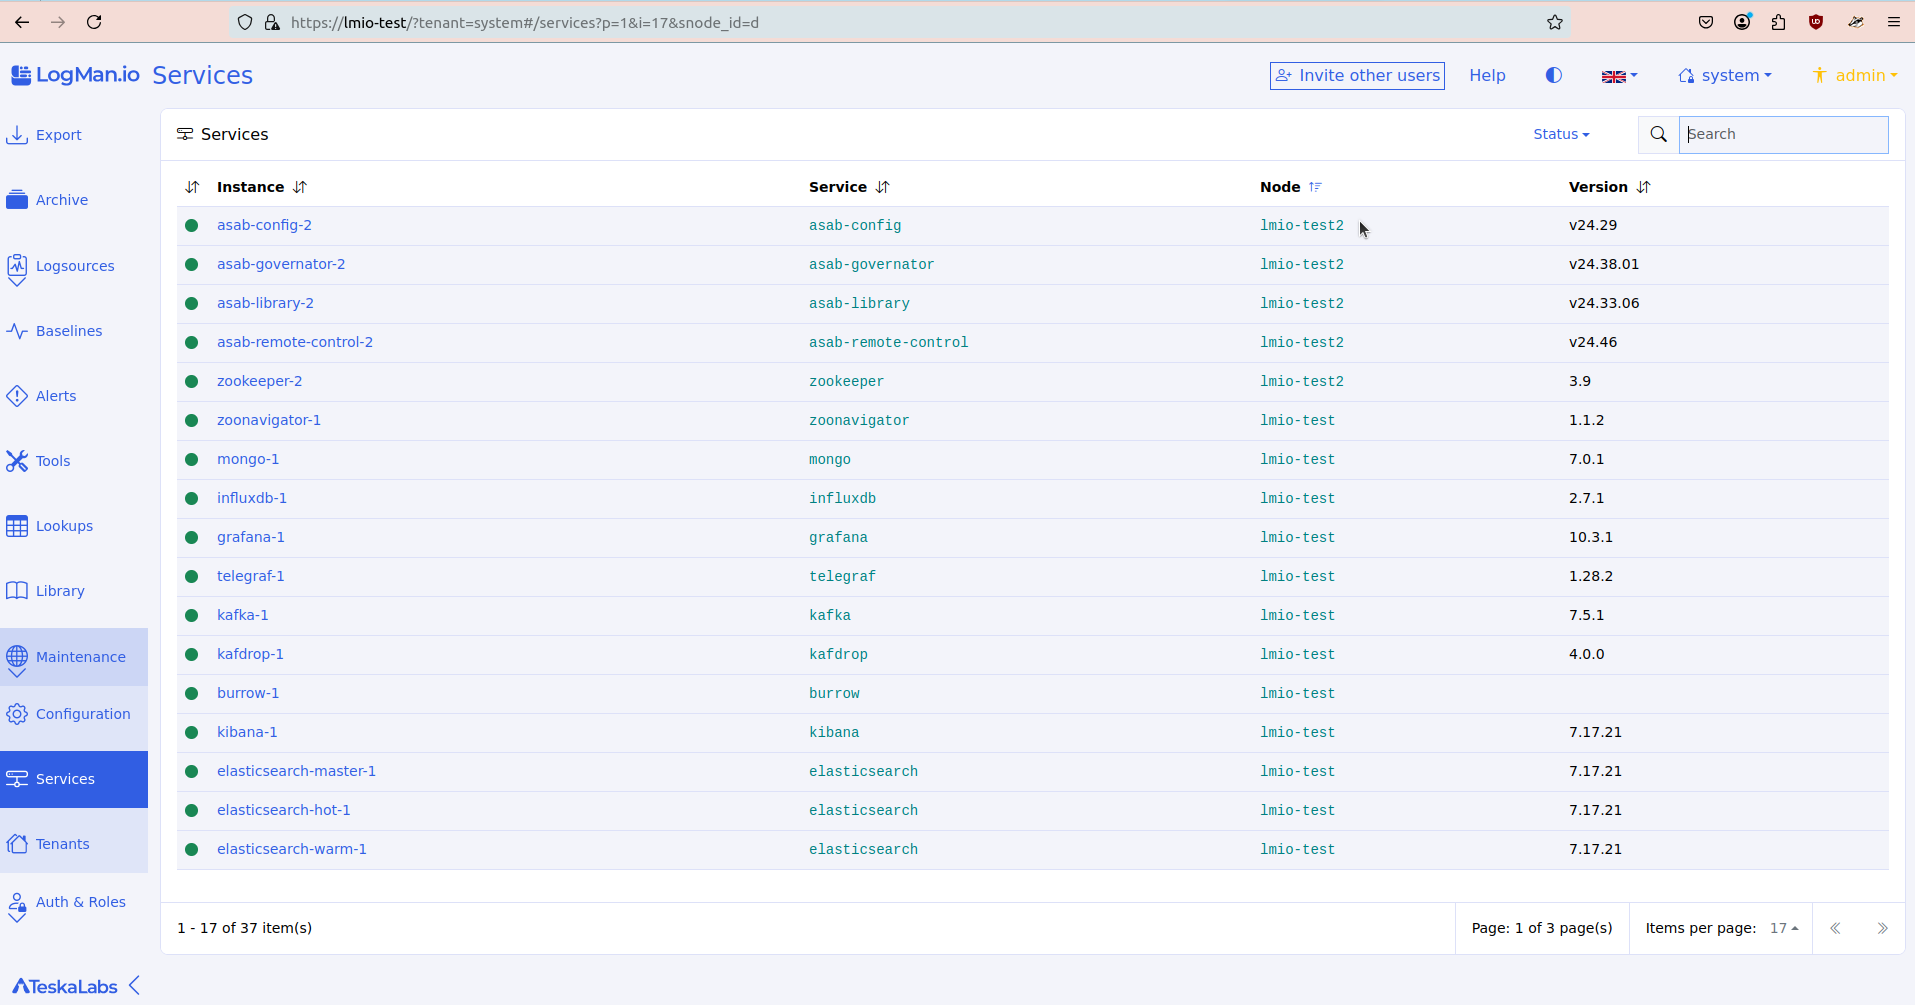
Instalace arbitra/quorum uzlu
Pokračujte s těmito nastaveními pouze pokud neplánujete zpracovávat data na uzlu clusteru.
Upravte záznam uzlu v Zookeeperu. Ručně mu přiřaďte roli "arbitra".
Prostřednictvím nabídky Nástroje otevřete Zoonavigator a přejděte do adresáře /asab/nodes. Najděte uzel, který chcete označit jako arbitra a přidejte mu roli:
ip:
- XX.XX.XX.XX
roles:
- arbiter
Uložte soubor.
Nastavení clusteru
Ujistěte se, že technologie clusteru jsou nainstalovány. Zookeeper je již nainstalován.
Přidejte k novému uzlu instanci pro každou službu:
- mongo
- elasticsearch-master
- telegraf
- lmio-collector-system
Přejděte do Knihovny a otevřete model.yaml umístěný ve složce Site.
Hledejte výše uvedené služby v modelu a přidejte instanci každé na nově nainstalovaném uzlu.
Na tomto snímku obrazovky můžete vidět soubor model.yaml uvnitř Knihovny, který je upravován na řádku 9. Přidejte ID uzlu nově nainstalovaného uzlu (lmio-test2) do seznamu instancí služby mongo. Pokračujte podobně pro všechny výše uvedené služby. Specifikujte instanci elasticsearch master explicitně, podobně jako master-1. Až budete hotovi, stiskněte Uložit a aplikujte změny na dotčený uzel.
Vyberte nový uzel (lmio-test2) a stiskněte tlačítko Aplikovat.
Když je instalace dokončena, vyberte jeden po druhém zbývající uzly a stiskněte Aplikovat. Aktuální změny musí být aplikovány na všechny uzly clusteru.
Instalace datového uzlu
Pokud je tento uzel určen pro sběr logů a zpracování dat, nainstalujte instance následujících služeb podobným způsobem:
- nginx
- kafka
- lmio-receiver
- lmio-depositor
- elasticsearch-hot
- elasticsearch-warm
- elasticsearch-cold
- lmio-lookupbuilder
- lmio-ipaddrproc
Round-Robin DNS vyvažování
Vyvažování sběru logů se provádí prostřednictvím DNS vyvažování. Ujistěte se, že váš DNS server může rozpoznat všechny uzly, kde očekáváte sběr logů.
Instalace bez ASAB Maestro
Instalace bez orchestrace Maestro vyžaduje následující kroky:
1) Vytvořte strukturu složek
sudo apt install git
2) Vytvořte strukturu složek
sudo mkdir -p \
/data/ssd/zookeeper/data \
/data/ssd/zookeeper/log \
/data/ssd/kafka/kafka-1/data \
/data/ssd/elasticsearch/es-master/data \
/data/ssd/elasticsearch/es-hot01/data \
/data/ssd/elasticsearch/es-warm01/data \
/data/hdd/elasticsearch/es-cold01/data \
/data/ssd/influxdb/data \
/data/hdd/nginx/log
Změňte vlastnictví na složku dat elasticsearch:
sudo chown -R 1000:0 /data/ssd/elasticsearch
sudo chown -R 1000:0 /data/hdd/elasticsearch
3) Klonujte konfigurační soubory webu do složky /opt:
cd /opt
git clone https://gitlab.com/TeskaLabs/<PARTNER_GROUP>/<MY_CONFIG_REPO_PATH>
4) Přihlaste se do docker.teskalabs.com.
cd <MY_CONFIG_REPO_PATH>
docker login docker.teskalabs.com
5) Vstupte do repozitáře a nasazujte server specifický Docker Compose soubor
docker compose -f docker-compose-<SERVER_ID>.yml pull
docker compose -f docker-compose-<SERVER_ID>.yml build
docker compose -f docker-compose-<SERVER_ID>.yml up -d
6) Zkontrolujte, že všechny kontejnery běží
docker ps
Nastavení TeskaLabs LogMan.io
Váš TeskaLabs LogMan.io je čerstvě nainstalován a připraven. Nastavme ho pro sběr logů!
Webové uživatelské rozhraní
TeskaLabs LogMan.io je dostupný přes HTTPS na prvním uzlu clusteru.
V tomto příkladu je URL https://lmio-test/ — zadejte ji do webového prohlížeče.
Self-signed SSL certifikáty
Výchozí instalace TeskaLabs LogMan.io používá self-signed SSL certifikáty. Prohlížeč upozorní na potenciální bezpečnostní riziko. Nemůže ověřit SSL certifikát. Jde však o vaši instalaci. Riziko přijměte a pokračujte na web.
Self-signed certifikáty můžete nahradit vlastními certifikáty.
Budete přesměrováni na přihlašovací obrazovku. Výchozí přihlašovací údaje získáte od podpory TeskaLabs.
Vytvoření přihlašovacích údajů a pozastavení výchozího admin
Počáteční nastavení LogMan.io obsahuje tenant system pro administraci a analýzu systémových logů a výchozí přihlašovací údaje admin.
Pro bezpečné přihlášení vytvořte nové přihlašovací údaje s rolí superuser.
Pokud ještě nemáte nakonfigurovaný SMTP server, instrukce pro reset hesla najdete v logách služby seacat auth na serveru.
Ověřte úspěšné přihlášení do TeskaLabs LogMan.io s novými přihlašovacími údaji.
Poté pozastavte výchozí přihlašovací údaje admin.
Systémové kolektory
Provision systémových kolektorů do tenantu system
Pro zahájení sběru logů ze systémových kolektorů provisionujte každý dostupný systémový kolektor do tenantu system.
Povolení rsyslog
Systémový kolektor naslouchá na UDP/9950 pro logy z operačního systému. Pro sběr logů musí být na každém uzlu clusteru povolen rsyslog a nakonfigurován pro přesměrování logů na systémový kolektor.
-
Nainstalujte rsyslog, pokud ještě není, a spusťte službu:
sudo apt install rsyslog rsyslog-gnutls sudo systemctl enable rsyslog sudo systemctl start rsyslog -
Vytvořte konfigurační soubor rsyslog pro přesměrování logů na systémový kolektor na port 9950:
sudo bash -c 'cat > /etc/rsyslog.d/90-system-collector.conf << "EOF" *.* action( type="omfwd" protocol="udp" target="127.0.0.1" port="9950" KeepAlive="on" queue.type="LinkedList" queue.size="10000" template="RSYSLOG_SyslogProtocol23Format" ) EOF' -
Ověřte konfiguraci kvůli syntaktickým chybám:
sudo rsyslogd -N1 -
Změny aplikujte restartem služby rsyslog:
sudo systemctl restart rsyslog.service
Přizpůsobení instalace
SMTP
Jak nakonfigurovat SMTP server
Doménové jméno
Nastavte parametr PUBLIC_URL v modelu a klikněte na Apply.
SSL certifikáty
Jak přidat vlastní SSL certifikát
Vytvoření prvního tenantu
Tenant system je určen pouze pro sběr logů z LogMan.io.
Pro sběr logů z vaší IT infrastruktury vytvořte nový tenant.
V sekci Auth & Roles vyberte Tenants a v pravém horním rohu klikněte na New tenant.
Vytvořte konfiguraci pro nový tenant. Název konfigurace MUSÍ být stejný jako název tenantu. Vyberte schéma (výchozí ECS) a časové pásmo (např. Europe/Prague)
Provision kolektoru
Pro sběr logů musí být nainstalován TeskaLabs LogMan.io Collector.
K dispozici je více způsobů instalace — vyberte ten, který nejlépe vyhovuje vaší infrastruktuře.
Více v Log Collector.
Po instalaci a konfiguraci připojení k instanci LogMan.io se Collector zobrazí na obrazovce Collectors. Provisionujte ho do nově vytvořeného tenantu.
Pro sběr logů z běžných zdrojů postupujte podle dokumentace konfigurace Collectoru.
How to
Jak na to v LogMan.io
Sada stručných návodů ke běžným úkolům pro každého administrátora.
Tyto návody platí pouze pro automatizované instalace „Maestro“. V ostatních případech kontaktujte podporu TeskaLabs.
- Jak upgradovat TeskaLabs LogMan.io
- Jak aktualizovat certifikát Nginx
- Konfigurace služeb ASAB z modelu
- Přesun úprav Docker Compose do modelu
- Řešení problémů ASAB Maestro
Autorizace
Konfigurace e-mailu
Elasticsearch
- Nastavení Elasticsearch Remote Cluster
- Konfigurace paměti Elasticsearch
- Nouzová nastavení clusteru Elasticsearch (pokračovat v ukládání při výpadku site / cluster red nebo yellow)
Sběr logů
- Sběr logů pomocí Elastic Agentů přes Fleet
- Konfigurace HAProxy pro přesměrování logů z kolektoru do clusteru LogMan.io
Monitoring
Jak nakonfigurovat SMTP server
Pro umožnění e-mailových oznámení je vyžadováno připojení k SMTP serveru.
Postupujte podle navigace Údržba >> Konfigurace v aplikaci LogMan.io. Vyberte sekci SMTP, poskytněte konfiguraci a klikněte na tlačítko Uložit.
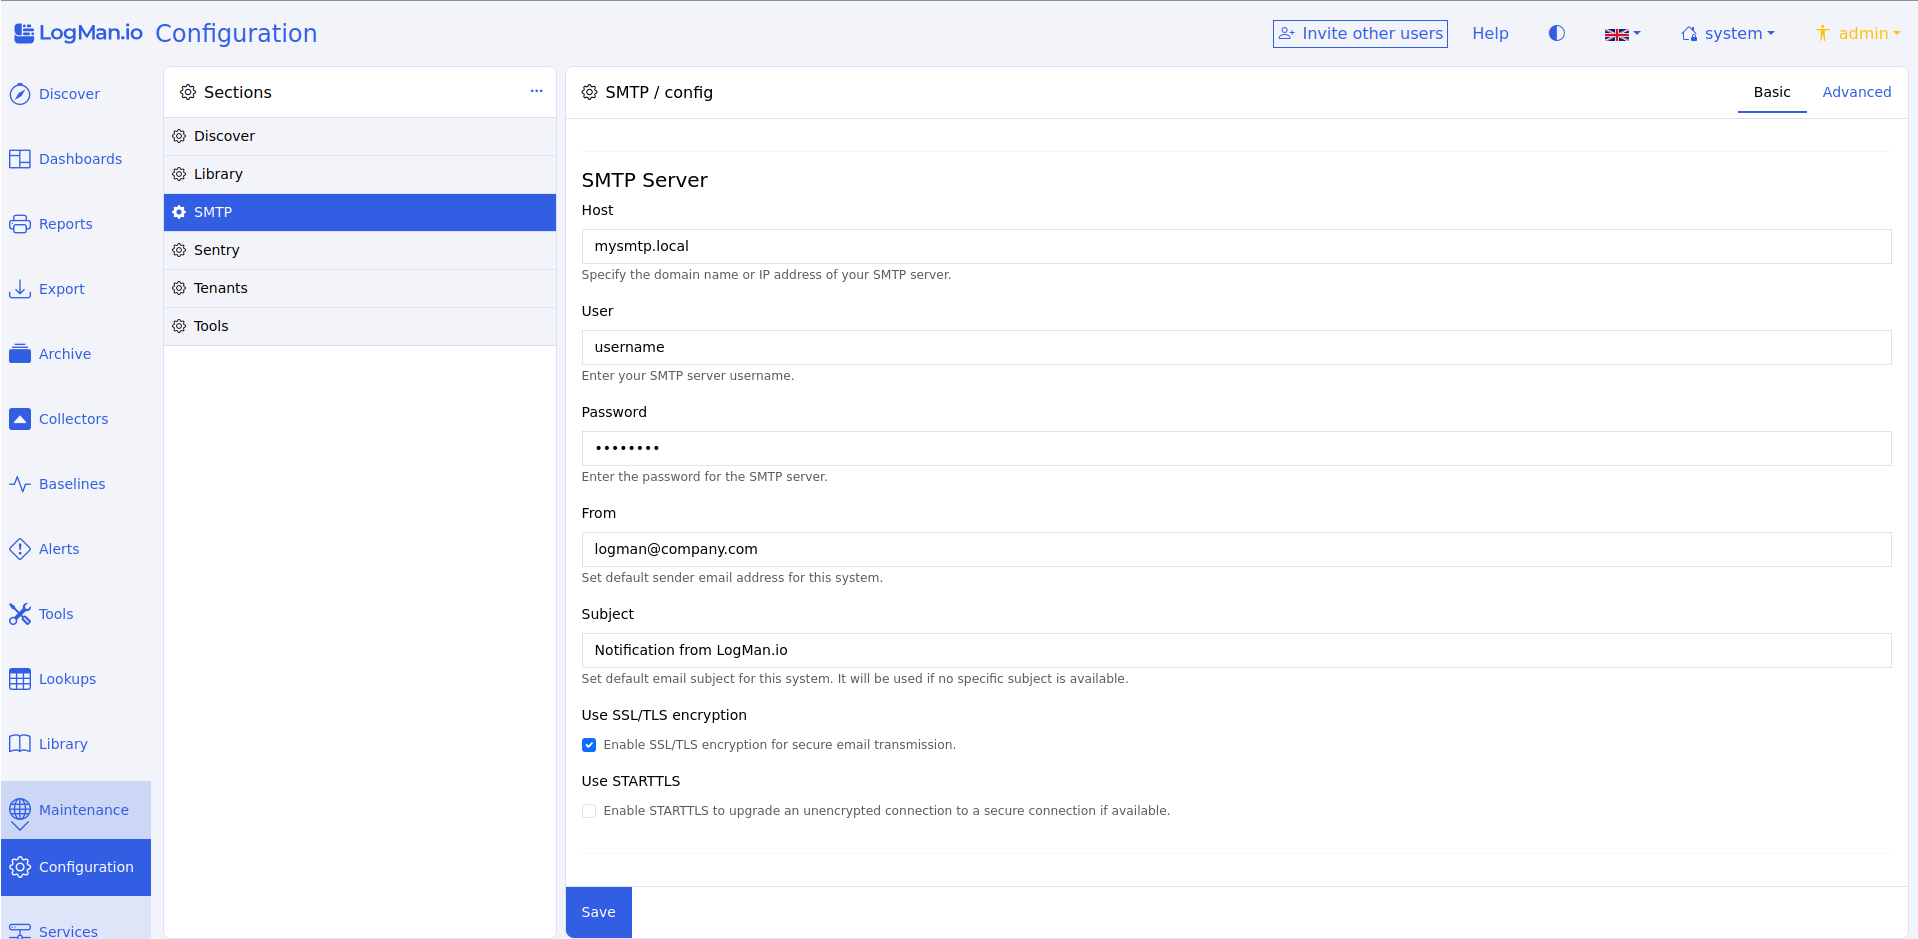
Konfigurace SMTP je uložena, ale není aktivní. Musí být aplikována na všechny komponenty.
Klikněte na tlačítko Použít, které je přístupné ve složce /Site Knihovny, nebo použijte příkazovou řádku.
Na hostitelském serveru, v adresáři /opt/site, použijte příkaz:
./gov.sh up
Aplikujte změny na všechny komponenty, tj. na všechny uzly clusteru.
Jak aktualizovat certifikát Nginx
kompatibilitní poznámka: (dostupné v instalaci Maestro od verze v24.38)
Instalace TeskaLabs LogMan.io přichází s výchozími samopodepsanými SSL certifikáty. Můžete chtít tyto certifikáty změnit na vlastní SSL certifikáty, které je také potřeba čas od času obnovit.
Podívejte se na jak vygenerovat CSR pro vaši certifikační autoritu.
Certifikát Nginx je uložen ve Vaultu jako nginx_certificate. Soukromý klíč je uložen ve Vaultu jako nginx_private_key.
Nastavit SSL certifikát
Pro nahrazení výchozích samopodepsaných certifikátů poskytněte jak soukromý klíč, tak certifikát. Nejprve umístěte oba soubory na server. Poté je odešlete prostřednictvím API do Vaultu. Použijte tyto příkazy na libovolném uzlu clusteru s běžícím ASAB Remote Control:
curl -X PUT localhost:8891/vault/nginx_private_key --data-binary '@/absolute/path/to/private_key.pem'
curl -X PUT localhost:8891/vault/nginx_certificate --data-binary '@/absolute/path/to/certificate.pem'
Pro aplikaci nového certifikátu stiskněte tlačítko "Apply" (nebo spusťte ./gov.sh up v /opt/site) pro každý uzel se službou nginx.
Obnovit SSL certifikát
Pokud máte certifikát uložený, spusťte tento příkaz na libovolném uzlu clusteru s běžícím ASAB Remote Control:
curl -X PUT localhost:8891/vault/nginx_certificate --data-binary '@/absolute/path/to/certificate.pem'
Pro aplikaci nového certifikátu stiskněte tlačítko "Apply" (nebo spusťte ./gov.sh up v /opt/site) pro každý uzel se službou nginx.
Řešení problémů
Můj certifikát nefunguje. Chci zpět výchozí.
Může se stát, že po nahrání vlastního SSL certifikátu Nginx nenastartuje kvůli problémům s certifikáty a ztratíte přístup k GUI. Vždy můžete nechat Maestro regenerovat samopodepsaný certifikát.
Nejprve odstraňte svůj vlastní certifikát a klíč z Vaultu:
curl -X DELETE localhost:8891/vault/nginx_private_key
curl -X DELETE localhost:8891/vault/nginx_certificate
Stiskněte tlačítko "Apply" (nebo spusťte ./gov.sh up v /opt/site) pro každý uzel se službou nginx.
Když Maestro nemůže tyto položky ve Vaultu najít, vygeneruje je a můžete Nginx znovu spustit.
Jak nastavit verzi
Jak nastavit verzi LogMan.io
Produkt TeskaLabs LogMan.io se skládá ze dvou aplikací, LogMan.io a ASAB Maestro.
Pro spuštění LogMan.io musíte v modelu specifikovat obě aplikace a jejich verze.
define:
type: rc/model
services:
...
applications:
- name: "ASAB Maestro"
version: v24.30.01
- name: "LogMan.io"
version: v24.30.01
Verze a soubory verzí
Verze se vztahuje na konkrétní soubor verze v Knihovně.
Verze v24.30.01 aplikace ASAB Maestro se vztahuje na soubor verze /Site/ASAB Maestro/Versions/v24.30.01.yaml.
Verze v24.30.01 aplikace LogMan.io se vztahuje na soubor verze /Site/LogMan.io/Versions/v24.30.01.yaml.
define:
type: rc/version
product: LogMan.io
version: v24.30.01
asab_maestro_library: v24.29
versions:
lmio-collector: v24.25
lmio-receiver: v24.19.01
lmio-parsec: v24.30
lmio-depositor: v24.30
lmio-alerts: v24.24
lmio-elman: v24.22-beta3
lmio-lookupbuilder: v24.30
lmio-ipaddrproc: v24.30
lmio-watcher: v24.22
system-collector: v24.25
lmio-baseliner: v24.30
lmio-correlator: v24.30.01
library lmio-common-library: v24.30.01
Chcete-li změnit verzi LogMan.io, jednoduše přepište verze aplikací v modelu, uložte model a aplikujte změny.
Vyberte existující verze a zajistěte kompatibilitu
Vyberte pouze soubory verzí, které skutečně existují v Knihovně.
Zajistěte, aby verze aplikací ASAB Maestro a LogMan.io byly kompatibilní.
Vlastní verze
Vyhněte se vlastním verzím
LogMan.io se skládá z několika služeb a testujeme jejich kompatibilitu před každým vydáním. Verze distribuované TeskaLabs jsou testovány a silně doporučovány.
Nemůžeme zaručit kompatibilitu služeb, pokud jsou použity kombinace JINÉ než ty v oficiálních souborech verzí.
Pro pokročilé uživatele, kteří ignorovali varování, zde jsou tipy, jak přizpůsobit verze:
Vytvoření nového souboru verze
V Knihovně vytvořte nový YAML soubor ve složce /Site/<application>/Versions/. Dodržujte požadovanou strukturu souboru verze a specifikujte verze služeb. Pokud není pro službu specifikována žádná verze, bude použita verze latest jako výchozí. Nastavte název nového souboru jako verzi aplikace v modelu.
Vlastní verze
Předpokládejme, že nový vlastní soubor verze aplikace LogMan.io se jmenuje custom.yaml a je umístěn v /Site/LogMan.io/Versions/custom.yaml v Knihovně.
Aby bylo možné použít nový soubor verze, propojte ho v modelu a stiskněte tlačítko "Použít".
define:
type: rc/model
services:
...
applications:
- name: "ASAB Maestro"
version: v24.30.01
- name: "LogMan.io"
version: custom
Přepsání verze v modelu
Chcete-li přepsat soubor verze z modelu, použijte klíč "version" v deklaraci služby.
V tomto příkladu bude verze instance asab-iris-1 nastavena na v24.36. Verze v souboru verze /Site/ASAB Maestro/Versions/v24.30.01.yaml bude ignorována.
define:
type: rc/model
services:
...
asab-iris:
instances:
- node1
version: v24.36
applications:
- name: "ASAB Maestro"
version: v24.30.01
- name: "LogMan.io"
version: v24.30.01
Nastavení verze pro každou instanci se nedoporučuje
Je možné nastavit odlišnou verzi pro každou instanci. Tento přístup však nedoporučujeme. Spuštění více instancí s odlišnými verzemi vede k vážným chybám ve většině služeb.
define:
type: rc/model
services:
...
asab-iris:
instances:
1:
node: node1
version: v24.36
2:
node: node1
version: v24.25
applications:
- name: "ASAB Maestro"
version: v24.30.01
- name: "LogMan.io"
version: v24.30.01
Jak integrovat LDAP server
LDAP server nebo Active Directory umožňuje uživatelům bezproblémové přihlášení do TeskaLabs LogMan.io.
Připojení k LDAP specifikujte v modelu konfigurací TeskaLabs SeaCat Auth (autorizační server v rámci TeskaLabs LogMan.io).
V modelu najděte službu seacat-auth a postupujte podle tohoto příkladu.
Důležité
Před aplikací změn v modelu bezpečně nahrajte tajemství (v tomto případě LDAP_USER_PASSWORD) do Vaultu. Tajemství je dostupné při aplikaci změn na konfiguraci SeaCat Auth jen poté.
define:
type: rc/model
services:
...
seacat-auth:
instances:
- node1 #(1)
asab:
config:
"seacatauth:credentials:ldap:external":
uri: ldap://ad.company.cz #(2)
username: "CN=user,OU=Users_System,DC=company,DC=cz" #(3)
attrusername: sAMAccountName
password: "{{LDAP_USER_PASSWORD}}"
base: DC=company,DC=cz
filter: "(&(objectClass=user)(|(sAMAccountName=novakjan)(sAMAccountName=novotnypavel)))"
attributes: "mail mobile"
secrets:
LDAP_USER_PASSWORD: {}
- Seznam uzlů s instancí seacat-auth.
- URI vašeho LDAP serveru.
- Celé uživatelské jméno v Active Directory.
Tajemství uložte do Vaultu na hostiteli LogMan.io tímto příkazem. Upravte klíč a hodnotu hesla podle potřeby.
curl -X PUT localhost:8891/vault/LDAP_USER_PASSWORD --data 'supersecret'
Klikněte na Apply ve složce /Site v Library nebo použijte příkazovou řádku.
Na hostiteli v adresáři /opt/site spusťte:
./gov.sh up
Zabezpečené LDAP připojení (LDAPS)
Pro zabezpečené připojení uveďte LDAP uri se schématem ldaps://.
Dodání certifikátů a klíčů
Podle politiky můžete zadat CA soubor serveru a/nebo klientský certifikát a klíč.
Připravte soubory na serveru a bezpečně je nahrajte do Vaultu:
cd /opt/site
./gov.sh curl -X PUT $NODE_ID:8891/vault/ldap_tls_cafile --data-binary '@/absolute/path/to/cafile.crt'
./gov.sh curl -X PUT $NODE_ID:8891/vault/ldap_tls_certfile --data-binary '@/absolute/path/to/certfile.crt'
./gov.sh curl -X PUT $NODE_ID:8891/vault/ldap_tls_keyfile --data-binary '@/absolute/path/to/keyfile.pem'
Nahraďte $NODE_ID názvem serveru.
Aktualizujte soubor /Site/model.yaml v Library:
services:
...
seacat-auth:
...
asab:
config:
"seacatauth:credentials:ldap:external":
...
tls_cafile: /conf/tls_cafile.crt #(3)
tls_certfile: /conf/tls_certfile.crt
tls_keyfile: /conf/tls_keyfile.pem
tls_require_cert: allow #(4)
files: #(2)
- "/conf/tls_cafile.crt": "{{LDAP_TLS_CAFILE}}"
- "/conf/tls_certfile.crt": "{{LDAP_TLS_CERTFILE}}"
- "/conf/tls_keyfile.pem": "{{LDAP_TLS_KEYFILE}}"
secrets: #(1)
...
LDAP_TLS_CAFILE: {}
LDAP_TLS_CERTFILE: {}
LDAP_TLS_KEYFILE: {}
- Vystavte certifikáty/klíče z Vaultu v sekci
secrets. - Převeďte tajemství na soubory dostupné službě SeaCat Auth.
- Propojte certifikát/klíč v LDAP konfiguraci SeaCat Auth.
- Politika TLS certifikátu serveru:
never,allow,demand,hard
Nakonec změny uložte a aplikujte tlačítkem Apply v Library nebo příkazem /opt/site/gov.sh up na serveru.
LDAP skupiny pro řízení přístupu
Tenanty a role LogMan.io můžete přiřadit automaticky podle členství ve skupinách LDAP (nebo Active Directory). Sync skript v kontejneru SeaCat Auth čte memberOf skupiny uživatele, porovnává je s mapou skupin a udržuje přiřazení tenantů a rolí aktuální.
Užitečné, pokud přístup spravujete v LDAP a chcete, aby oprávnění LogMan.io sledovala stejné skupiny — bez ručního přiřazování pro každého uživatele.
Note
LDAP přihlášení musí fungovat (viz výše). Sync pouze přiřazuje tenanty a role; nezakládá účty LogMan.io. Uživatelé se stále autentizují přes LDAP credentials provider.
Jak to funguje
- Skript se připojí k LDAP stejnou konfigurací SeaCat Auth LDAP (
uri, bind user,base,filter, TLS atd.). - Vyhledá uživatele odpovídající LDAP
filterz konfigurace. - Pro každého uživatele čte atribut
memberOfa porovnává DN skupin s mapou skupin. - Přiřadí mapované tenanty a role v SeaCat Auth a odstraní dříve synchronizovaná přiřazení, která už neplatí.
Přiřazení ze sync jsou označena jako spravovaná lmio-access-sync. Skript přidává/odebírá jen tato spravovaná přiřazení. Ruční tenanty a role zůstávají.
Uživatel ve více mapovaných skupinách má tenanty a role jako sjednocení všech odpovídajících záznamů.
Příprava mapy skupin
Vytvořte YAML mapující DN každé LDAP skupiny na tenanty a role LogMan.io pro její členy.
Použijte plné distinguished name skupiny přesně jako v LDAP (např. v Active Directory Users and Computers nebo atributu distinguishedName). Porovnávání je bez ohledu na velikost písmen.
"CN=System Administrators,CN=Builtin,DC=EXAMPLE,DC=com":
tenants:
- system
- mycompany
roles:
- "*/admin"
"CN=Analysts,CN=Users,DC=EXAMPLE,DC=com":
tenants:
- mycompany
roles:
- "*/analyst"
"CN=Operators,CN=Users,DC=EXAMPLE,DC=com":
tenants:
- mycompany
roles:
- "*/operator"
| Pole | Popis |
|---|---|
| Klíč (DN skupiny) | Plné LDAP distinguished name skupiny. |
tenants |
Seznam ID tenantů LogMan.io k přidělení. |
roles |
Seznam ID rolí LogMan.io. Globální role */admin, */analyst, */operator, */reader nebo tenant-scoped např. mycompany/analyst. |
Viz User Roles and Responsibilities pro vestavěné role.
Tip
Začněte s malou mapou (jedna–dvě skupiny) a ověřte sync před mapováním celého adresáře.
Nasazení mapy skupin přes model
Přidejte mapu skupin jako soubor služby seacat-auth v /Site/model.yaml. Po Apply je soubor v kontejneru na /conf/ldap-group-map.yaml (výchozí cesta sync skriptu).
services:
...
seacat-auth:
...
files:
- "conf/ldap-group-map.yaml": |
"CN=System Administrators,CN=Builtin,DC=EXAMPLE,DC=com":
tenants:
- system
- mycompany
roles:
- "*/admin"
"CN=Analysts,CN=Users,DC=EXAMPLE,DC=com":
tenants:
- mycompany
roles:
- "*/analyst"
Pokud seacat-auth už má sekci files: (např. pro LDAPS certifikáty), přidejte mapu do stejného seznamu — nevytvářejte druhý klíč files:.
Model uložte a aplikujte Apply v Library nebo na hostiteli:
cd /opt/site
./gov.sh up
Ruční spuštění sync
Na hostiteli LogMan.io najděte kontejner SeaCat Auth:
docker ps | grep seacat-auth
Název je např. seacat-auth-1 (číslo je ID instance).
Sync spusťte jednou:
docker exec seacat-auth-1 python3 /app/seacat-auth/scripts/ldap-access-sync.py
Ve výchozím nastavení skript čte:
- Konfiguraci SeaCat Auth z
/conf/seacatauth.conf - Mapu skupin z
/conf/ldap-group-map.yaml
Další argumenty v kontejneru obvykle nepotřebujete.
Úspěšný výstup
Při přiřazení nebo odebrání přístupu skript vytiskne jeden řádek na změnu:
Assigned tenant 'mycompany' to credentials 'ldap:external:Q049am5vdmFrLE9VPVVzZXJzLERDPWV4YW1wbGUsREM9Y29t'
Assigned role '*/analyst' to credentials 'ldap:external:Q049am5vdmFrLE9VPVVzZXJzLERDPWV4YW1wbGUsREM9Y29t'
Unassigned role '*/operator' from credentials 'ldap:external:Q049am5vdmFrLE9VPVVzZXJzLERDPWV4YW1wbGUsREM9Y29t'
Unassigned tenant 'oldtenant' from credentials 'ldap:external:Q049am5vdmFrLE9VPVVzZXJzLERDPWV4YW1wbGUsREM9Y29t'
Pokud nic nemění, výstup může být malý nebo prázdný — normální při nezměněném členství v LDAP.
Varování:
LDAP query returned no users
Group from group map not found in any user: 'CN=Analysts,CN=Users,DC=EXAMPLE,DC=com'
- No users — zkontrolujte LDAP
filter,basea konektivitu v konfiguraci SeaCat Auth LDAP. Syncují se jen uživatelé odpovídající filtru. - Group not found — žádný synchronizovaný uživatel nemá skupinu v
memberOf. Ověřte DN, členství ve skupině a že uživatelé spadají pod LDAP filter.
Plánování sync přes cron
Změny přístupu v LDAP se do LogMan.io aplikují až po dalším běhu skriptu. Naplánujte ho na hostiteli.
Vytvořte cron soubor, např. /etc/cron.d/lmio-ldap-access-sync:
*/10 * * * * root docker exec seacat-auth-1 python3 /app/seacat-auth/scripts/ldap-access-sync.py
Sync běží každých 10 minut. Upravte plán a název kontejneru (seacat-auth-1) podle prostředí.
Po instalaci cron položky počkejte na další běh nebo spusťte sync ručně a ověřte v LogMan.io tenanty a role testovacího uživatele.
Provozní poznámky
- LDAP filter — Sync zpracuje jen uživatele z
filterv LDAP credentials konfiguraci. memberOf— Skript vždy žádá atributmemberOf. Standardní na Active Directory. U jiného LDAP zajistěte ekvivalent členství ve skupinách.- Ruční přepsání — Tenanty a role můžete přiřadit ručně; sync je neodstraní. Pro plnou kontrolu LDAP vyhněte se konfliktní kombinaci ručního a synchronizovaného přiřazení.
- Po změně mapy — Aktualizujte
/Site/model.yaml, aplikujte model, spusťte skript (nebo počkejte na cron). Odebrání skupiny z mapy při dalším sync odebere tenanty a role od té skupiny (jen spravovaná přiřazení). - LDAPS — Při
ldaps://a TLS souborech SeaCat Auth sync tuto konfiguraci znovu použije bez dalšího TLS nastavení pro sync.
Sběr logů pomocí Elastic Agentů přes Fleet
Tento postup popisuje nasazení managovaných Elastic Agentů prostřednictvím Fleet Serveru s přesměrováním výstupu do LogMan.io Collectoru přes Logstash output. Agenty spravujete centrálně v Kibana Fleet, logy zpracovává pipeline LogMan.io.
Předpoklady
Před zahájením konfigurace je třeba mít k dispozici:
- LogMan.io Collector s povoleným Beats vstupem
- LogMan.io v26.12 nebo vyšší
- Elasticsearch a Kibana ve verzi 8.19 nebo vyšší (kompatibilní s nasazovaným Elastic Agentem)
- Přístup k certifikátové autoritě (CA) používané LogMan.io Collectorem
- Server, na kterém poběží Fleet Server
1. Příprava certifikátů pro Logstash vstup na Collectoru
Pro zabezpečenou komunikaci mezi Elastic Agenty (resp. Fleet Serverem) a LogMan.io Collectorem je nutné připravit serverový certifikát Collectoru a klientský certifikát pro Fleet Logstash output.
Kolektor obvykle certifikát již má. U integrovaných kolektorů může být vystaven na jinou IP adresu, než na kterou se zdroje připojují, a proto může být vhodné ho vystavit znovu.
1.1 Aktualizace serverového certifikátu Collectoru
Vygenerujte nový CSR s odpovídající IP adresou kolektoru:
openssl req -new \
-key ssl-server-key.pem \
-out server-new.csr \
-subj "/O=TeskaLabs/OU=LogMan.io Collector/CN={INGRESS_IP_ADDRESS}"
Vytvořte konfigurační soubor pro rozšíření certifikátu:
cat > server_ext.cnf << 'EOF'
[ v3_req ]
basicConstraints = critical, CA:FALSE
keyUsage = digitalSignature, nonRepudiation, keyEncipherment, keyAgreement
subjectKeyIdentifier = hash
authorityKeyIdentifier = keyid:always
subjectAltName = DNS:10.44.170.82
EOF
Hodnotu subjectAltName upravte podle adresy vašeho Collectoru.
Podepište certifikát pomocí CA:
openssl x509 -req \
-in server-new.csr \
-CA ca-cert.pem \
-CAkey ca-key.pem \
-CAcreateserial \
-out server-new.crt \
-days 3650 \
-sha256 \
-extfile server_ext.cnf \
-extensions v3_req
Proveďte zálohu a náhradu stávajícího certifikátu:
cp ssl-server-cert.pem ssl-server-cert.pem.bak
cp ssl-server-key.pem ssl-server-key.pem.bak
cp server-new.crt ssl-server-cert.pem
Restartujte Collector, aby se nový certifikát načetl.
1.2 Vytvoření klientského certifikátu pro Logstash output
Vygenerujte klientský klíč a certifikát pro konfiguraci Fleet výstupu:
openssl genpkey -algorithm EC \
-pkeyopt ec_paramgen_curve:P-256 \
-out logstash-client-key.pem
openssl req -new \
-key logstash-client-key.pem \
-out logstash-client.csr \
-subj "/O=TeskaLabs Ltd/OU=LogMan.io Collector/CN=Logstash Client"
openssl x509 -req \
-in logstash-client.csr \
-CA ca-cert.pem \
-CAkey ca-key.pem \
-CAcreateserial \
-out logstash-client-cert.pem \
-days 3650 \
-extfile <(printf "keyUsage=digitalSignature\nextendedKeyUsage=clientAuth\n")
Soubory pro Fleet Settings
Soubory logstash-client-cert.pem, logstash-client-key.pem a ca-cert.pem budete potřebovat při konfiguraci Logstash výstupu ve Fleet Settings (krok 4).
2. Inicializace Fleet Serveru
Fleet Server je centrální komponenta, přes kterou Kibana spravuje Elastic Agenty. Inicializace probíhá v Kibana:
- Přejděte do Kibana → Fleet → Settings.
- Klikněte na Add a Fleet Server.
- V dialogu vyplňte:
- Name: název Fleet Serveru (např.
logman-node-1) - URL: veřejná IP adresa nebo hostname s portem
8220(např.https://10.20.30.40:8220)
- Name: název Fleet Serveru (např.
- Klikněte na Continue.
Po vytvoření Fleet Server policy se zobrazí instalační příkazy. Na cílovém Linux serveru spusťte:
curl -L -O https://artifacts.elastic.co/downloads/beats/elastic-agent/elastic-agent-8.19.12-linux-x86_64.tar.gz
tar xzvf elastic-agent-8.19.12-linux-x86_64.tar.gz
cd elastic-agent-8.19.12-linux-x86_64
sudo ./elastic-agent install \
--fleet-server-es=http://localhost:9200 \
--fleet-server-service-token=<VYGENEROVANÝ_TOKEN> \
--fleet-server-policy=<NÁZEV_POLICY> \
--fleet-server-port=8220
Instalační příkaz
Přesný příkaz včetně service tokenu a názvu policy vygeneruje Kibana. Hodnoty se liší pro každou instalaci.
Po úspěšné instalaci Fleet potvrdí připojení Fleet Serveru.
3. Konfigurace Fleet Server Policy
Po inicializaci Fleet Serveru upravte výchozí Fleet Server Policy, aby Fleet Server agent neodesílal vlastní logy a metriky přímo do Elasticsearch:
- Přejděte do Kibana → Fleet → Agent policies → Fleet Server Policy → Settings.
- V sekci Agent monitoring odškrtněte:
- Collect agent logs
- Collect agent metrics
Fleet Server pak slouží čistě jako správcovská komponenta.
4. Vytvoření Logstash výstupu
Přesměrujte data z Elastic Agentů do LogMan.io Collectoru prostřednictvím Logstash protokolu:
- Přejděte do Kibana → Fleet → Settings.
- V sekci Outputs klikněte na Add output.
- Vyplňte:
- Name:
logstash-collector(nebo jiný popisný název) - Type: Logstash
- Logstash hosts: IP adresa a port LogMan.io Collectoru (např.
10.20.30.40:5044) - Server SSL certificate authorities: obsah souboru
ca-cert.pem - Client SSL certificate: obsah souboru
logstash-client-cert.pem - Client SSL certificate key: obsah souboru
logstash-client-key.pem
- Name:
- Zaškrtněte Make this output the default for agent integrations.
- Klikněte na Save and apply settings.
V přehledu Outputs by měl být nový výstup typu Logstash s označením Agent integrations ve sloupci Default.
5. Vytvoření Agent policies pro sběr logů
Pro každý typ sběru nebo skupinu agentů vytvořte samostatnou Agent Policy:
- Přejděte do Kibana → Fleet → Agent policies.
- Klikněte na Create agent policy.
- Pojmenujte policy a nastavte:
- Output for integrations:
logstash-collector - Fleet Server: váš Fleet Server (např.
logman-node-1)
- Output for integrations:
- Přidejte požadované integrace (např. System, Windows, Custom logs).
Ověřte výstup u každé policy
U každé nové policy vždy ověřte, že je jako výstup nastaven logstash-collector, nikoli výchozí Elasticsearch output. Jinak logy obcházejí pipeline LogMan.io.
6. Instalace Elastic Agentů
Nainstalujte Elastic Agenty na cílové systémy a přiřaďte je k agent policies:
- Přejděte do Kibana → Fleet → Agents.
- Klikněte na Add agent.
- Vyberte příslušnou Agent Policy.
- Postupujte dle instalačních instrukcí pro daný operační systém (Linux, Windows, macOS).
Po úspěšné instalaci a enrollmentu se agent zobrazí ve Fleet a začne odesílat data přes Logstash output do LogMan.io Collectoru.
Architektura
graph LR
agent[Elastic Agent<br/>cílový host]
fleet[Fleet Server]
collector[LogMan.io Collector<br/>Beats vstup]
pipeline[LogMan.io<br/>pipeline]
kibana[Kibana<br/>Fleet]
agent --> fleet
fleet --> collector
collector --> pipeline
kibana --> fleet
kibana --> agentElastic Agenty jsou centrálně spravovány přes Kibana Fleet. Logy proudí přes Logstash protokol přímo do LogMan.io Collectoru a dále standardní zpracovatelskou pipeline LogMan.io.
Řešení problémů
- Fleet Server se nepřipojí: Ověřte dostupnost portu
8220a správnost service tokenu. - Agent neodesílá data: Zkontrolujte, zda má Agent Policy nastaven správný output (
logstash-collector) a zda je Collector dostupný na uvedené adrese a portu. - Chyby certifikátů: Ověřte, že klientský certifikát byl podepsán stejnou CA jako serverový certifikát Collectoru a že SAN odpovídá adrese, na kterou se agent připojuje.
- Logy se objevují v Elasticsearch místo v LogMan.io: Ve Fleet Settings musí být output
logstash-collectornastaven jako výchozí pro agent integrations.
Odstraňování problémů ASAB Maestro
Aplikace změn z příkazového řádku
Ve složce /opt/site na každém uzlu se nachází skript ./gov.sh.
Použijte ho k aplikaci změn na jakémkoli uzlu.
Tento příkaz aplikuje změny v modelu na aktuální uzel:
$ cd /opt/site
$ ./gov.sh up
Aplikujte nejnovější změny na jiném uzlu. (Nahraďte <node_id> skutečným ID uzlu.)
$ ./gov.sh up <node_id>
Autorizace curl požadavků pomocí gov.sh
Můžete posílat autorizované požadavky na ASAB a LMIO mikroservisy pomocí příkazu ./gov.sh curl.
Např. GET požadavek na službu asab-config pro načtení konfigurace knihovny.
$ ./gov.sh curl localhost:8894/config/Library/config.json
Ruční interakce s Dockerem nebo Podmanem
Skript ./gov.sh funguje přesně stejně jako příkaz docker, ale ve správném nastavení clusteru.
To zahrnuje i část docker compose.
To je užitečné, když komponenty ASAB Maestro nefungují podle očekávání a jejich UI nebo API není k dispozici.
Příklad:
$ cd /opt/site
$ ./gov.sh compose up -d
[+] Spuštění 6/6
✔ Kontejner asab-config-1 Spuštěno 0.1s
✔ Kontejner asab-remote-control-1 Spuštěno 0.1s
✔ Kontejner zookeeper-1 Spuštěno 0.1s
✔ Kontejner zoonavigator-1 Spuštěno 0.1s
✔ Kontejner asab-library-1 Spuštěno 0.1s
✔ Kontejner asab-governator-1 Spuštěno 0.1s
$
Ruční aktualizace na nedávný ASAB Governator
Pokud potřebujete ručně aktualizovat asab-governator na konkrétním uzlu, zde je správný postup:
$ cd /opt/site
$ ./gov.sh image pull docker.teskalabs.com/asab/asab-governator:stable
$ ./gov.sh compose up -d asab-governator-1
Nahraďte asab-governator-1 správným instance_id na asab-governator na daném uzlu.
Použijte ./gov.sh ps -a k identifikaci instance_id.
Nginx se nemůže připojit na port 80
Nginx log
nginx: [emerg] bind() to 0.0.0.0:80 failed (13: Permission denied)
Řešení
$ sudo sysctl -w net.ipv4.ip_unprivileged_port_start=80
Elasticsearch se nespouští kvůli alokaci virtuální paměti
Řešení
$ sudo sysctl vm.max_map_count=262144
Access Control
Uživatelské role a správa přístupu
TeskaLabs LogMan.io poskytuje systém řízení přístupu založený na zdrojích (RBAC) pro efektivní správu oprávnění uživatelů. Každá role poskytuje přístup k specifickým zdrojům, čímž zajišťuje, že uživatelé mají správnou úroveň kontroly na základě svých odpovědností.
Systém zahrnuje předdefinované role jako Administrátor, Analytik, Operátor a Čtenář, z nichž každá má různé úrovně přístupu k funkcím jako správa upozornění, analýza logů, dashboardy a export dat.
Porozumění těmto rolím je nezbytné pro udržení bezpečnosti, správu oprávnění a zajištění toho, že uživatelé mají odpovídající přístup k funkcím TeskaLabs LogMan.io.
Uživatelské role a odpovědnosti
V TeskaLabs LogMan.io definují uživatelské role oprávnění a úrovně přístupu pro různé uživatele. Každá role je přizpůsobena specifickým odpovědnostem a úkolům v systému. Níže jsou uvedeny hlavní uživatelské role dostupné v TeskaLabs LogMan.io spolu s jejich odpovědnostmi a zamýšlenými případy použití.
Note
Globální role */~lmio-admin, */~lmio-plus-admin, */~lmio-analyst a role specifické pro nájemce <tenant>/~analyst, <tenant>/~operator, <tenant>/~lmio-admin, <tenant>/~lmio-plus-admin a <tenant>/~reader jsou v LogMan.io v25.30 zastaralé a budou odstraněny v budoucích verzích. Prosím, přejděte na nové výchozí role: */admin, */analyst, */operator a */reader.
Administrátor
- Název role:
*/admin
Administrátor má plný přístup ke všem nájemcům a všem funkcím v TeskaLabs LogMan.io.
Odpovědnosti:
- Spravuje konfigurace služeb a údržbu.
- Dozoruje uživatelské účty a přiřazení rolí.
- Konfiguruje a spravuje panely, reporty a upozornění.
- Spravuje exporty dat a analýzu systému.
- Administruje event lanes, replaye a kolektory.
- Edituje parsery a pravidla korelace.
- Spravuje konfigurace upozornění a baseliny.
Zamýšleno pro:
- Systémové administrátory a IT pracovníky odpovědné za celkové řízení a bezpečnost systému.
Analytik
- Název role:
*/analyst
Analytik monitoruje a chrání online systémy a sítě, identifikuje bezpečnostní hrozby a má přístup ke všem nástrojům a funkcím TeskaLabs LogMan.io.
Odpovědnosti:
- Monitoruje bezpečnostní upozornění a incidenty.
- Analyzuje logová data a reporty.
- Přistupuje k panelům a nástrojům pro vizualizaci dat.
- Konfiguruje a spravuje upozornění, reporty a exporty.
- Spravuje baseline data a lookup tabulky.
- Edituje parsery a pravidla korelace.
Zamýšleno pro:
- Bezpečnostní analytiky a lovce hrozeb odpovědné za identifikaci a zmírnění bezpečnostních rizik.
Operátor
- Název role:
*/operator
Operátor vykonává základní monitorovací a analytické úkoly v TeskaLabs LogMan.io. Tato role zahrnuje nezávislé přezkoumávání upozornění, monitorování datových toků a provádění počátečních vyšetřování logů a vizualizací. Operátoři mají přístup k základním analytickým nástrojům, ale nezabývají se pokročilou analýzou nebo správou konfigurací.
Odpovědnosti:
- Monitoruje panely a reporty.
- Provádí základní vyšetřování logů a vizualizací.
- Přistupuje a spravuje lookup tabulky.
- Pracuje s logovými parsery a replay nástroji.
- Zpracovává upozornění a analýzu událostí.
- Podporuje údržbu a provoz systému.
Zamýšleno pro:
- Operátory a IT pracovníky odpovědné za každodenní monitorování a řešení problémů.
Čtenář
- Název role:
*/reader
Role Čtenáře poskytuje uživatelům přístup pouze pro čtení k logům, vizualizacím a souvisejícím datům v TeskaLabs LogMan.io. To zahrnuje prozkoumávání událostí na obrazovce Discover, zobrazení panelů, reportů, exportů a upozornění.
Odpovědnosti:
- Zobrazuje a prozkoumává data na obrazovce Discover.
- Zobrazuje panely a reporty.
- Monitoruje správu upozornění.
- Přistupuje k exportům dat v režimu pouze pro čtení.
Zamýšleno pro:
- Uživatelé, kteří potřebují viditelnost do systémových dat, ale nepotřebují administrativní nebo provozní přístup.
Hardware pro TeskaLabs LogMan.io
Toto jsou hardwarové specifikace navržené pro vertikální škálovatelnost. Jsou optimalizované pro ty, kteří plánují postavit počáteční TeskaLabs LogMan.io cluster s co nejnižšími náklady, avšak s možností postupně přidávat více hardwaru, jak cluster roste. Tato specifikace je také plně kompatibilní se strategií horizontální škálovatelnosti, což znamená přidání jednoho nebo více nových serverových uzlů do clusteru.
Specifikace
- Šasi: 2U
- Přední HDD zásobníky: 12 pozic pro disky, 3,5", pro data HDD, hot-swap
- Zadní HDD zásobníky: 2 pozice pro disky, 2,5", pro OS HDD, hot-swap
- CPU: 1x AMD EPYC 32 jader
- RAM: 256GB DDR4 3200, pomocí 64GB modulů
- Datová SSD: 2x 4TB SSD NVMe, PCIe 3.0+
- Řadič datových SSD: NVMe PCIe 3.0+ stoupačka, bez RAID; nebo použijte NVMe sloty na základní desce
- Datová HDD: 3x 20TB SATA 2/3+ nebo SAS 1/2/3+, 6+ Gb/s, 7200 ot./min.
- Řadič datových HDD: karta HBA nebo IT mód, SATA nebo SAS, JBOD, bez RAID, hot-swap
- OS HDD: 2x 256GB+ SSD SATA 2/3+, HBA, bez RAID, přímo připojeno k SATA na základní desce
- Síťová karta: 2x (duální) 1Gbps Ethernet NIC; nebo 1x dvouportový
- Napájecí zdroj: redundantní 920W
- IPMI nebo ekvivalentní
Poznámka
RAID je implementován v softwaru, respektive v operačním systému.
Vertikální škálovatelnost
- Přidejte další CPU (celkem 2 CPU), pro tuto volbu je vyžadována základní deska s 2 sloty pro CPU
- Přidejte RAM až do 512GB
- Přidejte až 9 dalších data HDD, maximální prostor 220 TB pomocí 12x 20 TB HDD v RAID5
- Vyměňte síťovou kartu za duální 10Gbps Ethernet NIC (nebo lepší)
Poznámka
K dispozici jsou také varianty 3U a 4U s 16 respektive 24 pozicemi pro disky.
Poslední aktualizace: srpen 2024
Úložiště dat
TeskaLabs LogMan.io pracuje s několika různými úrovněmi úložiště, aby poskytlo optimální izolaci dat, výkon a náklady.
Struktura úložiště dat

Schéma: Doporučená struktura úložiště dat.
Rychlé úložiště dat
Rychlé úložiště dat (také známé jako "hot" úroveň) obsahuje nejnovější logy a další události přijaté do TeskaLabs LogMan.io. Doporučujeme použít nejrychlejší možnou třídu úložiště pro nejlepší propustnost a výkon při vyhledávání. Komponenta v reálném čase (Apache Kafka) také používá rychlé úložiště dat pro perzistenci proudu.
- Doporučené časové období: jeden den až jeden týden
- Doporučená velikost: 2TB - 4TB
- Doporučená redundance: RAID 1, další redundanci poskytuje aplikační vrstva
- Doporučený hardware: NVMe SSD PCIe 4.0 a lepší
- Fyzická zařízení pro rychlé úložiště dat MUSÍ být spravována pomocí mdadm
- Montovací bod:
/data/ssd - Souborový systém: EXT4, doporučuje se nastavit příznak
noatimepro optimální výkon
Strategie zálohování
Příchozí události (logy) jsou kopírovány do archivního úložiště jakmile vstoupí do TeskaLabs LogMan.io. To znamená, že vždy existuje způsob, jak "přehrát" události do TeskaLabs LogMan.io v případě potřeby. Data jsou také replikována na další uzly klastru okamžitě po jejich příjezdu do klastru. Z tohoto důvodu se nedoporučuje tradiční zálohování, ale je možné.
Obnovení je řešeno komponenty klastru replikací dat z dalších uzlů klastru.
Příklad
/data/ssd/kafka-1
/data/ssd/elasticsearch/es-master
/data/ssd/elasticsearch/es-hot1
/data/ssd/zookeeper-1
/data/ssd/influxdb-2
...
Pomalu úložiště dat
Pomalu úložiště obsahuje data, která není třeba rychle přistupovat, a obvykle obsahují starší logy a události, jako jsou teplé a studené indexy pro ElasticSearch.
- Doporučená redundance: softwarový RAID 6 nebo RAID 5; RAID 0 pro virtualizované/cloud instance s podkladovou redundancí úložiště
- Doporučený hardware: cenově efektivní pevné disky, SATA 2/3+, SAS 1/2/3+
- Typická velikost: desítky TB, např. 18TB
- Karta řadiče: SATA nebo HBA SAS (IT Mode)
- Fyzická zařízení pro pomalu úložiště MUSÍ být spravována softwarovým RAID (mdadm)
- Montovací bod:
/data/hdd - Souborový systém: EXT4, doporučuje se nastavit příznak
noatimepro optimální výkon
Výpočet kapacity klastru
Toto je vzorec pro výpočet celkové dostupné kapacity klastru na pomalu úložišti.
total = (disks-raid) * capacity * servers / replica
disksje počet disků pomalu úložiště na serverraidje náklad na RAID, 1 pro RAID5 a 2 pro RAID6capacityje kapacita disku pomalu úložištěserversje počet serverůreplicaje replikační faktor v ElasticSearch
Příklad
(6[disks]-2[raid6]) * 18TB[capacity] * 3[servers] / 2[replica] = 108TB
Strategie zálohování
Data uložená na pomalu úložišti jsou VŽDY replikována na další uzly klastru a také uložena v archivu. Z tohoto důvodu se nedoporučuje tradiční zálohování, ale je možné (uvážíme-li obrovskou velikost pomalu úložiště).
Obnovení je řešeno komponenty klastru replikací dat z dalších uzlů klastru.
Příklad
/data/hdd/elasticsearch/es-warm01
/data/hdd/elasticsearch/es-warm02
/data/hdd/elasticsearch/es-cold01
/data/hdd/mongo-2
/data/hdd/nginx-1
...
Strategie velkého pomalu úložiště
Pokud vaše pomalu úložiště bude větší než 50 TB, doporučujeme používat HBA SAS řadiče, SAS expandéry a JBOD jako optimální strategii pro škálování pomalu úložiště. SAS úložiště lze řetězit, aby bylo možné připojit velký počet disků. Externí JBOD skříně lze také připojit pomocí SAS pro uložení dalších disků.
RAID 6 vs RAID 5
RAID 6 i RAID 5 jsou typy RAID (redundantní pole nezávislých disků), které využívají stripování dat a paritu pro zajištění redundance dat a zvýšení výkonu.
RAID 5 používá stripování přes více disků, s jedním paritním blokem vypočítaným přes všechny disky. Pokud selže jeden disk, data lze stále obnovit pomocí paritních informací. Nicméně, data jsou ztracena, pokud druhý disk selže před výměnou prvního.
RAID 6 na druhou stranu používá stripování a dva nezávislé paritní bloky, které jsou uloženy na samostatných discích. Pokud selžou dva disky, data lze stále obnovit pomocí paritních informací. RAID 6 poskytuje vyšší úroveň ochrany dat ve srovnání s RAID 5. Nicméně, RAID 6 také zvyšuje náklady a snižuje kapacitu úložiště kvůli dvěma paritním blokům.
Co se týče pomalu úložiště, RAID 5 je obecně považován za méně bezpečný než RAID 6, protože logová data jsou obvykle zásadní a dva selhané disky by mohly způsobit ztrátu dat. RAID 6 je v tomto scénáři nejlepší, protože může přežít dva selhané disky a poskytuje více ochrany dat.
V RAID 5 je počet požadovaných disků (N-1) disků, kde N je počet disků v poli. To je proto, že jeden z disků je využitý pro paritní informace, které jsou použité pro obnovu dat v případě selhání jednoho disku. Například, pokud chcete vytvořit pole RAID 5 s kapacitou 54 TB, potřebujete alespoň čtyři (4) disky s kapacitou alespoň 18 TB každý.
V RAID 6 je počet požadovaných disků (N-2) disků. To je proto, že používá dva soubory paritních informací, které jsou uloženy na samostatných discích. V důsledku toho může RAID 6 přežít selhaní až dvou disků před ztrátou dat. Například, pokud chcete vytvořit pole RAID 6 s kapacitou 54 TB, potřebujete alespoň pět (5) disků s kapacitou alespoň 18 TB každý.
Je důležité poznamenat, že RAID 6 vyžaduje více místa na disku, protože používá dva paritní bloky, zatímco RAID5 používá pouze jeden. Proto RAID 6 vyžaduje další disky ve srovnání s RAID 5. Nicméně, RAID 6 poskytuje vyšší ochranu a může přežít dvě selhání disku.
Je třeba také zmínit, že data v pomalu úložišti jsou duplikována napříč clusterem (pokud je to relevantní) pro zajištění další ochrany dat.
Tip
Použijte Online RAID Calculator pro výpočet požadavků na úložiště.
Systémové úložiště
Systémové úložiště je vyhrazeno pro operační systém, instalace softwaru a konfigurace. Žádná provozní data nejsou uložena na systémovém úložišti. Instalace na virtualizačních platformách často používají dostupný místně redundantní diskový prostor.
- Doporučená velikost: 250 GB a více
- Doporučený hardware: dva (2) lokální SSD disky v softwarovém RAID 1 (zrcadlení), SATA 2/3+, SAS 1/2/3+
Pokud je to relevantní, doporučuje se následující rozdělení úložiště:
- EFI oddíl, montážní bod
/boot/efi, velikost 1 GB - Swap oddíl, 64 GB
- Softwarový RAID1 (mdadm) přes zbytek místa
- Boot oddíl na RAID1, montážní bod
/boot, velikost 512 MB, souborový systém ext4 - LVM oddíl na RAID1, zbytek dostupného místa s objemovou skupinou
systemvg - LVM logický oddíl
rootlv, montážní bod/, velikost 50 GB, souborový systém ext4 - LVM logický oddíl
loglv, montážní bod/var/log, velikost 50 GB, souborový systém ext4 - LVM logický oddíl
dockerlv, montážní bod/var/lib/docker, velikost 100 GB, souborový systém ext4 (pokud je to relevantní)
Strategie zálohování pro systémové úložiště
Doporučuje se pravidelně zálohovat všechny souborové systémy na systémovém úložišti, aby mohly být použity pro obnovení instalace v případě potřeby. Strategie zálohování je kompatibilní s většinou běžných zálohovacích technologií na trhu.
- Recovery Point Objective (RPO): plná záloha jednou týdně nebo po větších údržbových pracích, inkrementální záloha jednou denně.
- Recovery Time Objective (RTO): 12 hodin.
Poznámka
RPO a RTO jsou doporučené, vzhledem k vysoce dostupné konfiguraci klastru LogMan.io. To znamená tři a více uzlů, aby úplné odstávky jednoho uzlu neovlivnily dostupnost služby.
Archivní úložiště dat
Archivní úložiště dat je doporučené, ale nepovinné. Slouží pro velmi dlouhé období uchovávání dat a účely redundance. Také představuje ekonomický způsob dlouhodobého uložení dat. Data nejsou dostupná online v klastru, musí být obnovena zpět při potřebě, což je spojeno s určitou dobou "time-to-data".
Data jsou komprimována při kopírování do archivu, typický kompresní poměr je v rozpětí od 1:10 do 1:2, v závislosti na povaze logů.
Data jsou replikována do úložiště po počáteční konsolidaci na rychlém úložišti dat, prakticky okamžitě po ingestování do klastru.
- Doporučené technologie: SAN / NAS / Cloud cold storage (AWS S3, MS Azure Storage)
- Montovací bod:
/data/archive(pokud je relevantní)
Poznámka
Veřejné cloudy mohou být použity jako archivní úložiště dat. V takovém případě musí být povoleno šifrování dat pro ochranu dat před neoprávněným přístupem.
Vyhrazené archivační uzly
Pro velké archivy se doporučují vyhrazené archivační uzly (servery). Tyto uzly by měly používat HBA SAS konektivitu a úložiště orientované OS distribuce jako Unraid nebo TrueNAS.
Co NEPROVÁDĚT při správě úložiště dat
- NEdoporučujeme použití NAS / SAN úložiště pro úložiště dat
- NEdoporučujeme použití hardwarových RAID řadičů atd. pro úložiště dat
Správa úložiště
Tato kapitola poskytuje praktický příklad konfigurace úložiště pro TeskaLabs LogMan.io. Nemusíte konfigurovat nebo spravovat úložiště LogMan.io, pokud k tomu nemáte konkrétní důvod, LogMan.io je dodáván v plně nakonfigurovaném stavu.
Předpokládáme následující konfiguraci hardwaru:
- SSD disky pro rychlé úložiště dat:
/dev/nvme0n1,/dev/nvme1n1 - HDD disky pro pomalu úložiště dat:
/dev/sde,/dev/sdf,/dev/sdg
Tip
Použijte příkaz lsblk pro sledování aktuálního stavu úložných zařízení.
Vytvoření softwarového RAID1 pro rychlé úložiště dat
mdadm --create /dev/md2 --level=1 --raid-devices=2 /dev/nvme0n1 /dev/nvme1n1
mkfs.ext4 /dev/md2
mkdir -p /data/ssd
Přidejte montovací body do /etc/fstab:
/dev/md2 /data/ssd ext4 defaults,noatime 0 2
Připojte souborové systémy úložiště dat:
mount /data/ssd
Tip
Použijte cat /proc/mdstat pro kontrolu stavu softwarového RAID.
Vytvoření softwarového RAID5 pro pomalu úložiště dat
mdadm --create /dev/md1 --level=5 --raid-devices=3 /dev/sde /dev/sdf /dev/sdg
mkfs.ext4 /dev/md1
mkdir -p /data/hdd
Poznámka
Pro RAID6 použijte --level=6.
Přidejte montovací body do /etc/fstab:
/dev/md1 /data/hdd ext4 defaults,noatime 0 2
Připojte souborové systémy úložiště dat:
mount /data/hdd
Rozšíření velikosti úložiště dat
S neustále rostoucími objemy dat je vysoce pravděpodobné, že budete potřebovat rozšířit (neboli zvětšit) úložiště dat, a to buď na rychlém úložišti dat, nebo na pomalu úložišti dat. To se provádí přidáním nového datového svazku (např. fyzický disk nebo virtuální svazek) do stroje - nebo na některých virtualizovaných řešeních - zvětšením existujícího svazku.
Poznámka
Úložiště dat může být rozšířeno bez jakéhokoli výpadku.
Příklad rozšíření pomalu úložiště dat
Předpokládáme, že chcete přidat nový disk /dev/sdh do pomalu úložiště /dev/md1:
mdadm --add /dev/md1 /dev/sdh
Nový disk je přidán jako náhradní zařízení.
Stav pole RAID můžete zkontrolovat:
cat /proc/mdstat
Písmeno (S) za zařízením znamená náhradní zařízení.
Pro zvětšení RAID na náhradní zařízení:
mdadm --grow --raid-devices=4 /dev/md1
Číslo 4 musí být upraveno tak, aby odpovídalo aktuálnímu nastavení RAID.
Zvětšete souborový systém:
resize2fs /dev/md1
Síťování
Tato dokumentační sekce je navržena tak, aby vás provedla procesem nastavení a řízení síťování TeskaLabs LogMan.io. Aby byla zajištěna bezproblémová funkčnost, je důležité dodržovat předepsané síťové konfigurace popsané níže.

Schéma: Přehled sítě clusteru LogMan.io.
Fronting network
Fronting network je soukromý L2 nebo L3 segment, který slouží pro sběr logů. Z toho důvodu musí být přístupný ze všech zdrojů logů.
Každý uzel (server) má vyhrazenou IPv4 adresu v fronting network. IPv6 je také podporováno.
Fronting network musí být dostupný na všech místech clusteru LogMan.io.
Uživatelská s흶
Uživatelská síť je soukromý L2 nebo L3 segment, který slouží pro přístup uživatelů k webovému uživatelskému rozhraní. Z tohoto důvodu musí být přístupná pro všechny uživatele.
Každý uzel (server) má vyhrazenou IPv4 adresu v uživatelské síti. IPv6 je také podporováno.
Uživatelská síť musí být dostupná na všech místech clusteru LogMan.io.
Interní s흶
Interní síť je soukromý L2 nebo L3 segment, který se používá pro soukromou komunikaci mezi uzly clusteru. MUSÍ BÝT vyhrazena pro TeskaLabs LogMan.io bez externího přístupu k zachování bezpečnosti clusteru. Interní síť musí poskytovat šifrování, pokud je provozována ve sdíleném prostředí (např. jako VLAN). Toto je kritický požadavek pro bezpečnost clusteru.
Každý uzel (server) má vyhrazenou IPv4 adresu v interní síti. IPv6 je také podporováno.
Dále může být IPMI hardwarových uzlů vystaveno na této síti, na dodatečné IP adrese (jak IPv4, tak IPv6).
Interní síť musí být dostupná na všech místech clusteru LogMan.io.
Kontejnery běžící na uzlu používají "síťový režim" nastavený na "host" v interní síti. To znamená, že síťový stack kontejneru není izolován od uzlu (hostitele) a kontejner nezískává vlastní IP adresu.
Administrátoři MOHOU přistupovat k interní síti pomocí VPN.
Konektivita
Každý uzel (aka server) má následující požadavky na konektivitu:
Fronting network
- Minimální: 1Gbit NIC
- Doporučeno: 2x bonded 10Gbit NIC
Uživatelská s흶
- Minimální: sdíleno s fronting network
- Doporučeno: 1Gbit NIC
Interní s흶
- Minimální: Žádná NIC, interní pouze pro instalace s jedním uzlem, 1Gbit
- Doporučeno: 2x bonded 10Gbit NIC
- IPMI pokud je dostupné na úrovni serveru
Internetová konektivita (NAT, firewalled, za proxy serverem) pomocí Fronting network NEBO Interní sítě.
Komunikace
Fronting network
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| Uzel LogMan.io | DNS servery | udp | 53 | Na základě konfigurace |
| Uzel LogMan.io | DNS servery | tcp | 53 | Na základě konfigurace |
| Uzel LogMan.io | NTP servery | udp | 123 | Na základě konfigurace |
| Uzel LogMan.io | SMTP server | tcp | 25 | Nešifrovaný (plain text) provoz, nedoporučuje se |
| Uzel LogMan.io | SMTP server | tcp | 465 | Šifrováno pomocí STARTTLS |
| Uzel LogMan.io | SMTP server | tcp | 587 | Šifrováno pomocí SMTPS |
| Uzel LogMan.io | LDAP server | tcp | 389 | Nešifrovaný (plain text) provoz, nedoporučuje se |
| Uzel LogMan.io | LDAP server | tcp | 686 | Šifrováno pomocí LDAPS |
| Uzel LogMan.io | LDAP server | tcp | 3268 | Nešifrovaný (plain text) provoz, nedoporučuje se |
| Uzel LogMan.io | LDAP server | tcp | 3269 | Šifrováno pomocí LDAPS |
| Kolektor logů | Uzel LogMan.io | tcp | 443 | Šifrováno pomocí Mutual TLS 1.3 |
| Kolektor logů | Uzel LogMan.io | udp | 41194 | VPN (volitelně) |
| Uzel LogMan.io | Slack servery | tcp | 443 | Notifikace (volitelně) |
| Uzel LogMan.io | MS Teams servery | tcp | 443 | Notifikace (volitelně) |
| Uzel LogMan.io | Sentry.io | tcp | 443 | Systémová telemetrie (volitelně) |
| Uzel LogMan.io | Uptime Robot | tcp | 443 | Dostupnost systému (volitelně) |
| Uzel LogMan.io | Aktualizace softwaru | tcp | 443 | docker.teskalabs.com, pcr.teskalabs.com, rcr.teskalabs.com, registry-1.docker.io, auth.docker.io, production.cloudflare.docker.com, asabwebui.z16.web.core.windows.net, webappsreg.z6.web.core.windows.net, webappsreg-secondary.z6.web.core.windows.net |
| Uzel LogMan.io | Aktualizace obsahu | tcp | 443 | libsreg.z6.web.core.windows.net, libsreg-secondary.z6.web.core.windows.net, lmio.blob.core.windows.net |
| Uzel LogMan.io | Aktualizace OS | tcp | 443, 80 | archive.ubuntu.com, security.ubuntu.com, cz.archive.ubuntu.com |
Tip
Každá odchozí HTTPS komunikace může používat proxy server. Nakonfigurujte svůj proxy server, aby povoloval provoz na určené doménové názvy.
Uživatelská s흶
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| Uživatelé | Uzel LogMan.io | tcp | 443 | |
| Uživatelé | Uzel LogMan.io | tcp | 80 | Pouze pro přesměrování na HTTPS (volitelně) |
Tip
Přístup uživatelů je vyvážen pomocí Round-robin DNS.
Interní s흶
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| Uzel LogMan.io | Uzel LogMan.io | udp | 41194 | VPN |
| Administrátoři | Uzel LogMan.io | tcp | 22 | SSH (volitelně) |
| Administrátoři | IPMI | tcp | 443 | Na vyhrazeném ethernetovém portu / IP adrese (volitelně) |
Kolektor logů
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| Kolektor logů | DNS servery | udp | 53 | |
| Kolektor logů | DNS servery | tcp | 53 | |
| Kolektor logů | NTP servery | udp | 123 | |
| Kolektor logů | Uzel LogMan.io | tcp | 443 | Šifrováno pomocí Mutual TLS 1.3 |
| Kolektor logů | Uzel LogMan.io | udp | 41194 | VPN (volitelně) |
| Administrátoři | Kolektor logů | tcp | 22 | SSH přístup administrátorů (volitelně) |
| Kolektor logů | Aktualizace softwaru | tcp | 443 | docker.teskalabs.com, pcr.teskalabs.com, rcr.teskalabs.com, registry-1.docker.io, auth.docker.io, production.cloudflare.docker.com (volitelně) |
| Kolektor logů | Aktualizace OS | tcp | 443 | archive.ubuntu.com, security.ubuntu.com (volitelně) |
Syslog
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| Zdroje logů | Kolektor logů | tcp | 514 | Syslog |
| Zdroje logů | Kolektor logů | udp | 514 | Syslog |
| Zdroje logů | Kolektor logů | tcp | 1514 | Syslog |
| Zdroje logů | Kolektor logů | udp | 1514 | Syslog |
| Zdroje logů | Kolektor logů | tcp | 6514 | Syslog s SSL / TLS (autodetekce, může být použit také jako plain TCP) |
| Zdroje logů | Kolektor logů | udp | 6514 | Syslog s DTLS |
| Zdroje logů | Kolektor logů | udp | 20514 | REPL |
| Zdroje logů | Kolektor logů | tcp | 10000…14099 | Vlastní rozsah portů zdroje logů (volitelně) |
| Zdroje logů | Kolektor logů | udp | 10000…14099 | Vlastní rozsah portů zdroje logů (volitelně) |
Microsoft
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| MS Windows | Kolektor logů | tcp | 5986 | Sběr logů z Microsoft Windows pomocí WEF, HTTPS (volitelně) |
| MS Windows | Kolektor logů | tcp | 5985 | Sběr logů z Microsoft Windows pomocí WEF, Kerberos (volitelně) |
| MS Windows | Kolektor logů | tcp | 88 | Kerberos autorizace verze 5 pro WEF (volitelně) |
| MS Windows | Kolektor logů | udp | 88 | Kerberos autorizace verze 5 pro WEF (volitelně) |
| Kolektor logů | KDC, MS AD | tcp | 88 | Kerberos autorizace verze 5 pro WEF (volitelně) |
| Kolektor logů | KDC, MS AD | udp | 88 | Kerberos autorizace verze 5 pro WEF (volitelně) |
| Kolektor logů | Microsoft 365 | tcp | 443 | Sběr logů z Microsoft 365 (volitelně) |
ODBC
Pro sběr logů z databázových systémů se používá ODBC.
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| Kolektor logů | Oracle Database | tcp | 1521 | |
| Kolektor logů | Microsoft SQL | tcp | 1433 | |
| Kolektor logů | Microsoft SQL | udp | 1434 | |
| Kolektor logů | MySQL | tcp | 3306 | |
| Kolektor logů | PostgreSQL | tcp | 5432 |
SNMP
| Zdroj | Cíl | Protokol | Port | Poznámka |
|---|---|---|---|---|
| SNMP trap zdroje | Kolektor logů | udp | 161 | SNMP |
SSL serverový certifikát
Fronting network a uživatelská síť vystavují webová rozhraní přes HTTPS na portu TCP/443. Z tohoto důvodu potřebuje LogMan.io SSL serverový certifikát.
Může jít buď o:
- self-signed SSL serverový certifikát
- SSL serverový certifikát vydaný certifikační autoritou provozovanou interně uživatelem
- SSL serverový certifikát vydaný veřejnou (komerční) certifikační autoritou
Tip
Můžete použít nástroj XCA pro generování nebo ověřování vašich SSL certifikátů.
Self-signed certifikát
Tato možnost je vhodná pro velmi malé nasazení.
Uživatelé obdrží varování od svých prohlížečů při přístupu k webovému rozhraní LogMan.io.
Rovněž je potřeba použít insecure vlajky v kolektorech.
Vytvoření self-signed SSL certifikátu pomocí příkazového řádku OpenSSL
openssl req -x509 -newkey ec -pkeyopt ec_paramgen_curve:secp384p1 \
-keyout key.pem -out cert.pem -sha256 -days 3650 -nodes \
-subj "/CN=logman.int"
Tento příkaz vytvoří key.pem (soukromý klíč) a cert.pem (certifikát) pro interní doménové jméno logman.int.
Certifikát od certifikační autority
Parametry pro SSL serverový certifikát:
- Soukromý klíč: EC 384 bit, křivka secp384p1 (minimálně), alternativně RSA 2048 (minimálně)
- Subjekt Common Name
CN: Plně kvalifikované doménové jméno uživatele Web UI LogMan.io - X509v3 Subject Alternative Name: Plně kvalifikované doménové jméno uživatele Web UI LogMan.io nastavené na "DNS"
- Typ: End Entity, kritické
- X509v3 Subject Key Identifier nastaveno
- X509v3 Authority Key Identifier nastaveno
- X509v3 Key Usage: Digital Signature, Non Repudiation, Key Encipherment, Key Agreement
- X509v3 Extended Key Usage: TLS Web Server Authentication
Příklad SSL serverového certifikátu pro http://logman.example.com/
``` Certifikát: Data: Verze: 3 (0x2) Sériové číslo: 6227131463912672678 (0x566b3712dc2c4da6) Algoritmus pro podpis: ecdsa-with-SHA256 Vydavatel: CN = logman.example.com Platnost Ne dříve: Nov 16 11:17:00 2023 GMT
Cluster
TeskaLabs LogMan.io může být nasazeno na jednom serveru (tzv. "node") nebo v clusterovém nastavení. TeskaLabs LogMan.io také podporuje geo-clustering.
Geo-clustering
Geo-clustering je technika používaná k zajištění redundance proti selháním replikací dat a služeb v různých geografických lokalitách. Tento přístup se snaží minimalizovat dopad jakýchkoliv nepředvídaných selhání, katastrof nebo přerušení, která mohou nastat v jedné lokalitě, tím, že zajišťuje, že systém může pokračovat v provozu bez přerušení z jiné lokality.
Geo-clustering zahrnuje nasazení několika instancí LogMan.io v různých geografických regionech nebo datových centrech a jejich konfiguraci tak, aby pracovaly jako jeden logický celek. Tyto instance jsou propojeny pomocí dedikovaného síťového připojení, které jim umožňuje komunikovat a koordinovat své činnosti v reálném čase.
Jednou z hlavních výhod geo-clusteringu je, že poskytuje vysokou úroveň redundance proti selháním. V případě selhání na jednom místě zbylé instance systému přebírají a pokračují v provozu bez přerušení. To nejenže pomáhá zajistit vysokou dostupnost (HA) a uptime, ale také snižuje riziko ztráty dat a prostojů.
Další výhodou geo-clusteringu je, že může poskytovat lepší výkon a škálovatelnost umožněním vyvažování zátěže a sdílení zdrojů mezi několika lokalitami. To znamená, že zdroje mohou být dynamicky přidělovány a upravovány dle měnících se požadavků, čímž se zajišťuje, že systém je vždy optimalizován pro výkon a efektivitu.
Celkově je geo-clustering silnou technikou, která pomáhá zajišťovat vysokou dostupnost, odolnost a škálovatelnost jejich kritických aplikací a služeb. Replikací zdrojů v několika geografických lokalitách mohou organizace minimalizovat dopad selhání a přerušení, a zároveň zlepšit výkon a efektivitu.
Lokality
Lokalita "A"
Lokalita "A" je první lokalita, která se má postavit. V nastavení s jedním node je také jedinou lokalitou.
Node lma1 je první server, který se postaví v clusteru.
Nody v této lokalitě jsou pojmenovány "Node lmaX". X je sekvenční číslo serveru (např. 1, 2, 3, 4 a tak dále).
Pokud vám dojdou čísla, pokračujte malými písmeny (např. a, b, c a tak dále).
Podrobnosti o nodech naleznete v doporučené hardwarové specifikaci.
Lokalita B, C, D a tak dále
Lokalita B (a C, D atd.) jsou další lokality v clusteru.
Nody v těchto lokalitách jsou pojmenovány "Node lmLX".
L je malé písmeno, které představuje lokalitu v abecedním pořadí (např. a, b, c).
X je sekvenční číslo serveru (např. 1, 2, 3, 4 a tak dále).
Pokud vám dojdou čísla, pokračujte malými písmeny (např. a, b, c a tak dále).
Podrobnosti o nodech naleznete v doporučené hardwarové specifikaci.
Koordinační lokalita "X"
Cluster MUSÍ mít lichý počet lokalit, aby se předešlo Split-brain problému.
Z tohoto důvodu doporučujeme postavit malou, koordinační lokalitu s jedním nodem (Node lmx1).
Doporučujeme použít virtualizační platformu pro "Node x1", ne fyzické hardware.
V této lokalitě nejsou uchovávána žádná data (logy, události).
Typy nodů
Core node
První tři nody v clusteru se nazývají core node. Core nody tvoří konsenzus v rámci clusteru, zajišťují konzistenci a koordinují činnosti v clusteru.
Peripheral nodes
Peripheral nody jsou ty nody, které se neúčastní konsenzu v clusteru.
Rozvržení clusteru

Schéma: Příklad rozvržení clusteru.
Single node "cluster"
Node: lma1 (Lokalita a, Server 1).
Dva velké a jeden malý node
Nody: lma1, lmb1 a lmx1.
Tři nody, tři lokality
Nody: lma1, lmb1 a lmc1.
Čtyři velké a jeden malý node
Nody: lma1, lma2, lmb1, lmb2 a lmx1.
Šest nodů, tři lokality
Nody: lma1, lma2, lmb1, lmb2, lmc1 a lmc2.
Větší clustery
Větší clustery typicky zavádějí specializaci nodů.
Kolektor logů
TeskaLabs LogMan.io Collector
Toto je administrátorská příručka pro TeskaLabs LogMan.io Collector. Popisuje instalaci a správu Collectoru.
Možnosti konfigurace a podrobnosti o zdrojích logů viz referenční příručka.
Architektura
LogMan.io Collector je mikroslužba, která sbírá logy a další události z různých vstupů a odesílá je do LogMan.io Receiver. Obvykle běží jako kontejner na dedikovaném stroji a k Receiver se připojuje přes WebSocket a HTTPS.

Collector lze spouštět, zastavovat, restartovat a konfigurovat z webového rozhraní LogMan.io.
Identita kolektoru
Každý Collector je identifikován jedinečnou identitou — 16znakovým řetězcem písmen a číslic (například A3K9M2P7QW4R8T6X).
Identita se přiřadí automaticky při prvním startu Collectoru. Collector vytvoří jedinečné přihlašovací údaje a uloží je lokálně na stroji. Identita se z těchto údajů odvodí a zůstává stejná po celou životnost dané instalace Collectoru.
Identita není hostname, IP adresa ani jiný síťový atribut stroje. Každá instance Collectoru dostane vlastní identitu. Přeinstalace bez zachování přihlašovacích údajů vede k nové identitě.
Identitu najdete v logách Collectoru po prvním startu. Zobrazí se také ve webovém rozhraní LogMan.io po registraci u Receiver. Identitu potřebujete pro provisioning a pro odkazy v administrátorských úlohách.
Dokud Collector uchová lokální přihlašovací údaje, identita zůstává stejná při restartech i obnově certifikátů. Pokud údaje zmizí (například smazáním datového volume nebo přeinstalací bez zálohy), Collector vygeneruje nové údaje a novou identitu. Ze systémového hlediska jde o jiný Collector, který je třeba znovu provisionovat.
Při připojení k LogMan.io Receiver Collector předloží své přihlašovací údaje. Receiver podle identity zjistí, zda byl Collector provisionován a autorizován k přesměrování logů pro daného tenanta.
Instalace
Instalace Collectoru je popsána v instalační příručce.
Provisioning
Po instalaci musí být Collector provisionován, než může přesměrovávat logy. Provisioning autorizuje Collector k odesílání dat do LogMan.io Receiver pro daného tenanta. Provisionujte Collectory z webového rozhraní LogMan.io.
-
Otevřete Log sources >> Collectors ve webovém rozhraní LogMan.io. Stránka zobrazí všechny Collectory registrované u Receiver. Neprovisionované jsou označeny šedou tečkou.

-
Klikněte na Provision u Collectoru, který chcete autorizovat. Přejdete na stránku detailu Collectoru. Ověřte identitu a vyberte tenant, pro který může Collector logy přesměrovávat.

-
Po provisioningu je Collector označen zelenou tečkou. Můžete nastavit zobrazované jméno a zkontrolovat konfiguraci Collectoru.

Identita kolektoru v logách
Identita Collectoru je také v logách kontejneru Collector. Na stroji, kde Collector běží, v logách hledejte řetězec identity:
docker logs <collector-container> 2>&1 | grep identity
NOTICE lmiocollector.commlink.identity.service [sd url="https://example.domain.com/lmio-receiver/csr" identity="L4RXQCQXWFGFP2IP"] Requesting certificate from the server
Provisioning z příkazové řádky
Collector lze provisionovat i pomocí REST API LogMan.io Receiver a endpointu PUT /provision/<identity>?tenant=<tenant>.
Konfigurace
Collector konfigurujte z webového rozhraní LogMan.io. Otevřete Log sources >> Collectors, vyberte Collector a klikněte na Configure.
Samostatné záložky pokrývají běžné zdroje logů (Syslog, Windows Event Logs, Microsoft 365 a další). Vlastní zdroje se konfigurují na záložce Custom v YAML.
Více v referenční příručce.
Instalace TeskaLabs LogMan.io Kolektoru
Tento krátký návod vysvětluje, jak připojit nový kolektor logů běžící jako virtuální stroj.
Tip
Pokud používáte hardware TeskaLabs LogMan.io Kolektor, připojte monitor přes HDMI a přejděte přímo na krok 5.
-
Stáhněte si obraz virtuálního stroje.
Zvolte odkaz ke stažení na základě vaší virtualizační technologie:
-
Importujte stažený obraz do vaší virtualizační platformy.
-
Konfigurujte síťová nastavení nového virtuálního stroje
Požadavky:
- Virtuální stroj musí mít přístup k instalaci TeskaLabs LogMan.io.
- Virtuální stroj musí být dosažitelný z zařízení, která budou posílat logy do TeskaLabs LogMan.io.
-
Spusťte virtuální stroj.
-
Určete identitu TeskaLabs LogMan.io Kolektoru.
Identita se skládá z 16 písmen a číslic. Uložte si ji pro následující kroky.
-
Otevřete webovou aplikaci LogMan.io ve svém prohlížeči.
Postupujte podle tohoto odkazu nebo přejděte na "Collectors" a klikněte na tlačítko "Provisioning".
-
Zadejte identitu collectoru z kroku 4 do pole.
Poté klikněte na Provision pro připojení collectoru a zahájení sběru logů.
-
TeskaLabs LogMan.io Kolektor je úspěšně připojen a sbírá logy.
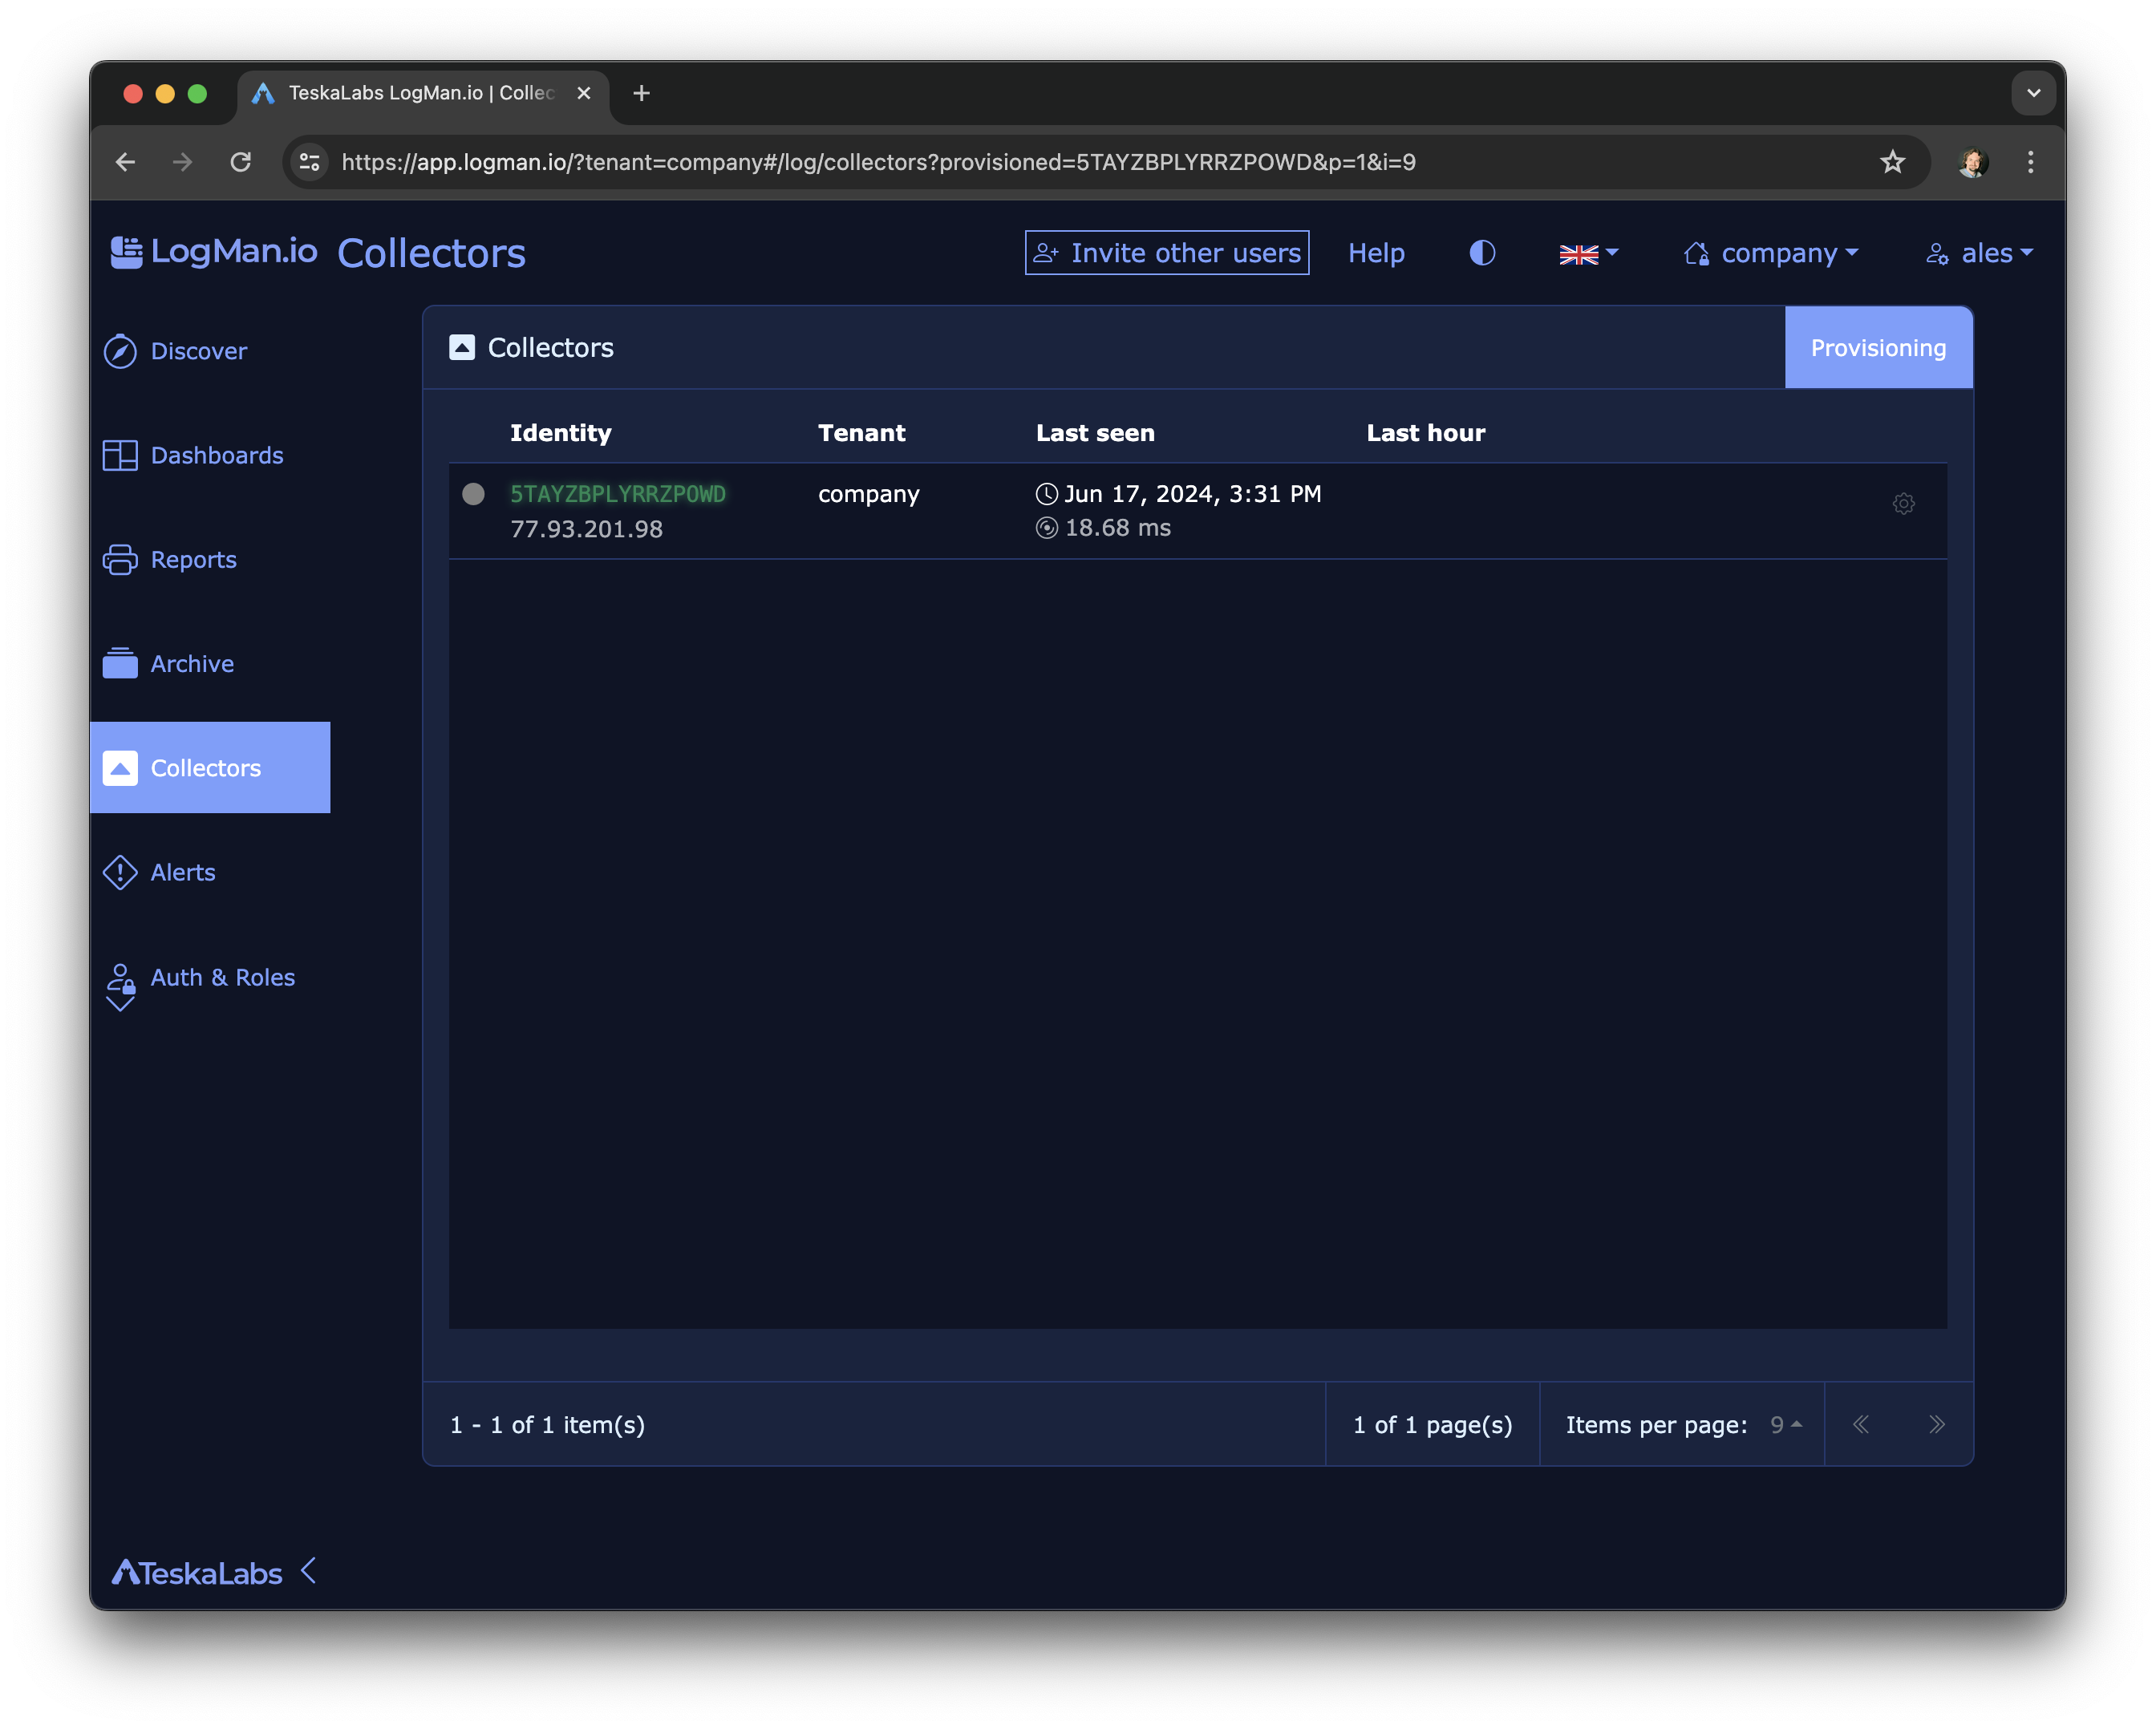
Tip
Zelený kruh vlevo označuje, že kolektor logů je online. Modrá linie označuje, kolik logů kolektor přijal za posledních 24 hodin.
Administrace uvnitř VM
Administrativní akce ve virtuálním stroji TeskaLabs LogMan.io Kolektoru jsou dostupné v menu. Stiskněte "M" pro přístup do menu. Použijte šipkové klávesy a Enter pro navigaci a výběr akcí.
Dostupné možnosti jsou:
- Vypnout
- Restartovat
- Konfigurace sítě
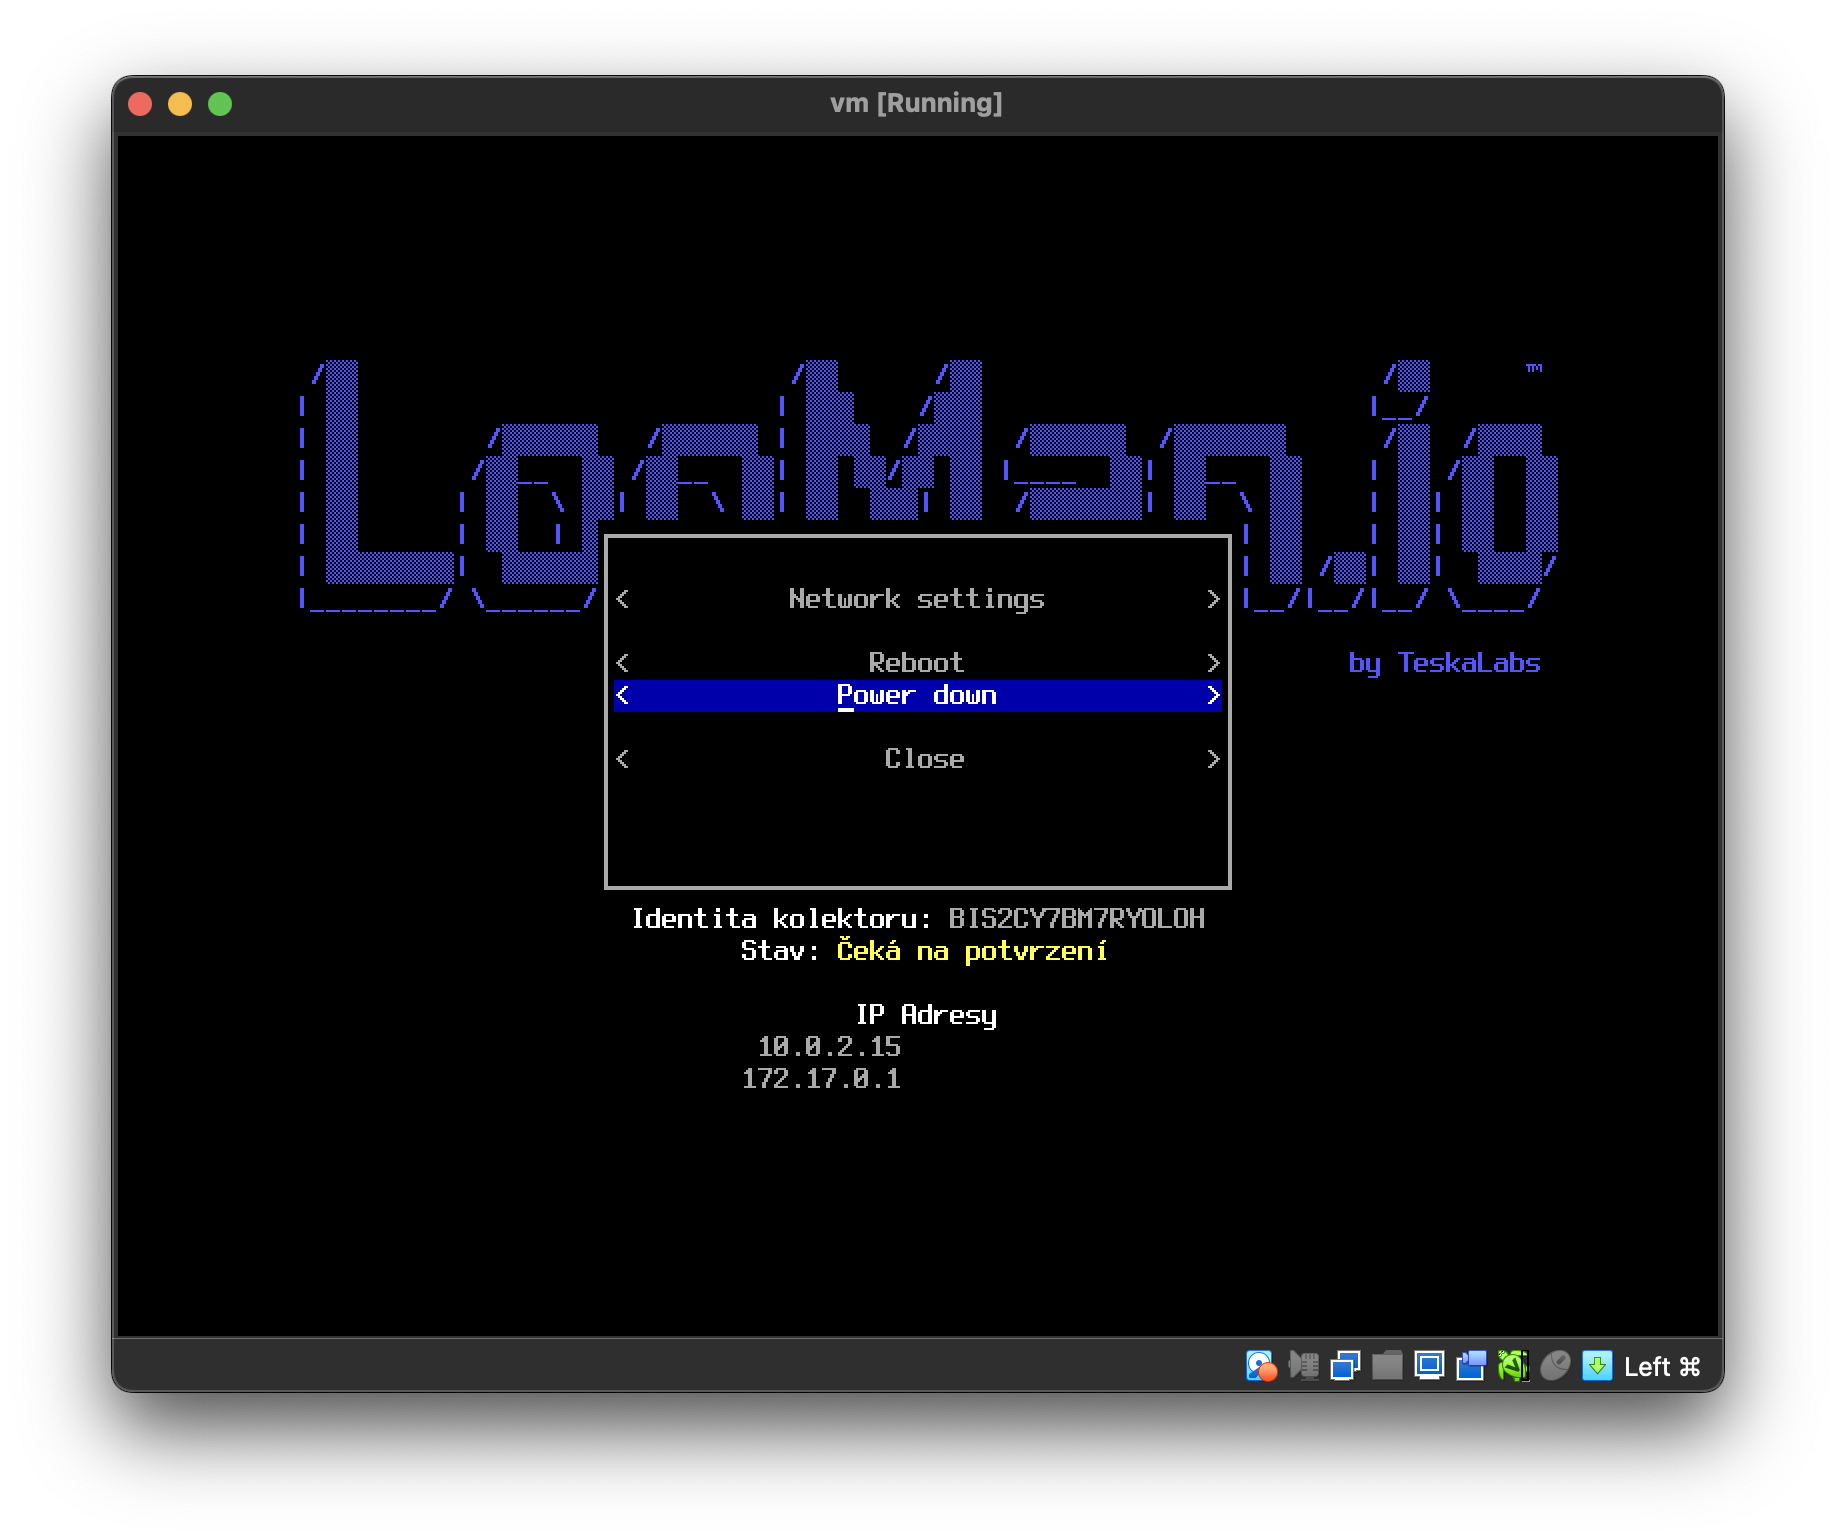
Tip
Doporučujeme použít funkci Vypnout pro bezpečné vypnutí virtuálního stroje collectoru.
Další poznámky
Můžete připojit neomezený počet kolektorů logů, např. pro sběr z různých zdrojů nebo pro sběr různých typů logů.
Podporované virtualizační technologie
TeskaLabs LogMan.io Kolektor podporuje následující virtualizační technologie:
- VMWare
- Oracle VirtualBox
- Microsoft Hyper-V
- Qemu
Virtuální stroj
TeskaLabs LogMan.io kolektor je poskytován jako předinstalovaný obraz virtuálního stroje (soubor OVA).
Minimální specifikace
- CPU: 2 vCPU
- RAM: 2 GB
- Úložiště dat OS: 15 GB, thick provisioning
- Úložiště dat: 10 - 500 GB (závisí na příchozím EPS), thin provisioning
- 1× NIC, nejlépe 1 Gbps
- OS: Linux
Oddělené úložiště OS a dat
Oddělený diskový prostor pro OS (připojený na /) a data (připojená na /data) je zásadní pro stabilitu instalace. Buď přidejte k VM dva samostatné disky, nebo zaveďte logické svazky při instalaci OS.
Note
Pro prostředí s vyšším zatížením je vhodné virtuální stroj odpovídajícím způsobem navýšit.
S흶
Kolektor se musí umět připojit k instalaci TeskaLabs LogMan.io přes HTTPS (WebSocket) pomocí její URL.
Doporučujeme virtuálnímu stroji kolektoru přidělit statickou IP adresu — používá se v mnoha konfiguracích zdrojů logů.
Vlastní instalace
TeskaLabs LogMan.io kolektor lze také nainstalovat do nového virtuálního stroje pomocí instalačního skriptu.
Podporované OS:
- Ubuntu Server 22.04 LTS, 24.04 LTS
- RedHat/CentOS 8, 9, 10
- Oracle Linux 8, 9
Pokročilá správa
Tato sekce popisuje správu předinstalovaného virtuálního stroje TeskaLabs LogMan.io Collector z příkazového řádku.
Spuštění a zastavení kolektoru
Pro spuštění zastaveného kolektoru zadejte:
service lmio-collector start
Pro zastavení kolektoru zadejte:
service lmio-collector stop
Upgrade na novou stabilní verzi
docker pull pcr.teskalabs.com/lmio/lmio-collector:stable
service lmio-collector restart
docker stop lmio-collector-cntrl
Note
Upgrade kolektoru se spouští automaticky každou noc.
Povolení SSH přístupu
service ssh start
Přístup: ssh tladmin@<collector-ip>
Tip
Ujistěte se, že je heslo nastaveno pro uživatele tladmin.
Spuštění kolektoru na popředí
service lmio-collector stop
docker run \
--rm \
--name lmio-collector \
-v /conf:/conf \
-v /data:/data \
--net=host \
pcr.teskalabs.com/lmio/lmio-collector:stable
Stiskněte Ctrl-C pro ukončení kolektoru.
Pro spuštění kolektoru na pozadí proveďte:
service lmio-collector start
Datové linky
Úvod do event lanes
Event lanes definují tok dat v TeskaLabs LogMan.io, od sběru logů po jejich uložení do databáze Elasticsearch. Specifikují pravidla pro analýzu, povolený obsah a klasifikaci dat.
Tok dat v TeskaLabs LogMan.io
Následující příklad ilustruje standardní tok logů (nebo událostí) v TeskaLabs LogMan.io.

- Sběr surových událostí: Logy (události) jsou sbírány Kolektor logů a odesílány do centrálního LogMan.io clusteru.
- Archivace surových událostí: LogMan.io Receiver ukládá surové události do Archivu. Archiv je neměnná databáze pro dlouhodobé ukládání příchozích logů. Surové logy lze odtud vyzvednout a použít pro další analýzu.
- Analýza událostí: Surové logy jsou odebírány z Archivu a odesílány k analýze. Nejprve přicházejí do Kafka
receivedtématu. LogMan.io Parsec odebírá surové logy zreceivedKafka tématu a aplikuje vybraná pravidla pro analýzu.- Úspěšně analyzované události pokračují do Kafka
eventstématu. LogMan.io Depositor odebírá analyzované události z Kafka a ukládá je do Elasticsearcheventsindexu. - Když analýza selže, události se stávají neanalyzovanými a pokračují do Kafka
otherstématu. LogMan.io Depositor odebírá neanalyzované události z Kafka a ukládá je do Elasticsearchothersindexu.
- Úspěšně analyzované události pokračují do Kafka
Event lanes
Když je připojen nový zdroj logů a je mu přiřazen nový datový tok, TeskaLabs LogMan.io automaticky vytvoří novou event lane pro něj. Event lane popisuje:
- jaká pravidla analýzy budou aplikována na datový tok
- jaké dashboardy, reporty a další obsah v Knihovně budou povoleny pro nájemce, který vlastní datový tok
- klasifikaci datového toku (dodavatel, produkt, kategorie atd.)
- zdroj dat používaný na obrazovce Discover
- jaká Kafka témata a Elasticsearch indexy budou použity pro tento datový tok
Každá event lane patří pouze jednomu nájemci. Dva nájemci nemohou sdílet stejnou event lane.
Profily event lanes
Profily event lanes definují životní cyklus dat pro event lanes. Profil specifikuje, jak dlouho jsou data ukládána v Archivu, Kafka a Elasticsearch a kdy jsou smazána.
Přečtěte si více o profilech event lanes zde.
Vytváření nových event lane
Zde se můžete naučit, jak vytvořit novou event lane a vybrat pro ni správná pravidla parsování.
Event lane a její vlastnosti (pravidla parsování, obsah, kategorizace logů atd.) jsou založeny na datových tocích. TeskaLabs LogMan.io automaticky přiřazuje event lane na základě názvu datového toku a šablon event lane.
Existují dva případy pro připojení nového logového zdroje:
-
Když připojíte logový zdroj, pro který je obsah již k dispozici v Knihovně, event lane je vytvořena na základě příslušné šablony event lane a názvu datového toku, který poskytnete.
-
Když připojíte logový zdroj, pro který obsah není poskytnut, event lane je vytvořena, ale neposkytuje žádný obsah, kategorizaci ani pravidla parsování. Tyto musí být vytvořeny a specifikovány v deklaraci event lane.
Datové toky
Data v TeskaLabs LogMan.io jsou organizována do datových toků. Datový tok je sbírka logů (událostí) z logového zdroje, které sdílejí stejný typ a strukturu.
Logy v jednom datovém toku nemusí být nutně spojeny s jedním logovým zařízením. Může existovat mnoho logových zařízení, která produkují logy stejného typu.
Například můžete mít pět různých logových zařízení, která produkují data ve stejném (nebo podobném) formátu (např. Linux servery):
<123> Dec 12 12:20:00 host-1 proces: ...
<123> Dec 12 12:20:00 host-2 proces: ...
<123> Dec 12 12:20:00 host-3 proces: ...
<123> Dec 12 12:20:00 host-4 proces: ...
<123> Dec 12 12:20:00 host-5 proces: ...
V tomto případě můžete vybrat jeden datový tok pro tato logová zařízení a považovat všechna logová zařízení za jeden logový zdroj. Avšak když jedno z logových zařízení produkuje logy jiného typu:
<123>1 2024-12-12T12:20:00.000001 host-x proces tag: ...
měli byste to považovat za jiný logový zdroj a vytvořit pro něj samostatný datový tok, aby mohla být aplikována různá pravidla parsování.
Jak pojmenovat datový tok? (1/2)
Názvy toků jsou používány jako reference pro LogMan.io k výběru správné event lane. Proto je výběr správného názvu toku zásadní!
Název toku se obvykle skládá z názvu dodavatele, technologie a číselné identifikace. Zde je několik příkladů názvů toků:
cisco-asa-1
cisco-asa-2
linux-rsyslog-1
microsoft-365-1
synology-nas-1
Přečtěte si více o tom, jak vybrat správný název toku níže.
Obecný datový tok
Po instalaci LogMan.io Collector a připojení logových zdrojů jsou všechna data shromážděna do jednoho obecného toku. Jsou uložena v Archivu a Elasticsearch. Na události v obecném toku se neuplatňují žádná specifická pravidla parsování.
Pro aplikaci specifických pravidel parsování a kategorizaci událostí vytvořte nové datové toky.
Jak vytvořit nový datový tok
V tomto příkladu vás provedeme, jak vytvořit nový datový tok.
Předpokládejme, že chcete vytvořit datový tok pro logy přicházející z IP adresy 127.0.0.1.
-
Otevřete webovou aplikaci TeskaLabs LogMan.io. Přejděte na Archiv.
-
Vyberte obecný tok. Uvidíte seznam surových logů z různých IP adres.
- Shromážděno: Čas, kdy byl log shromážděn LogMan.io Collector
- Přijato: Čas, kdy byl log přijat LogMan.io Receiver.
- Zdroj: Informace o původu logu, složené z IP adresy, portu a protokolu.
Hodnoty protokolu mohou být následující:
- S: Tok / TCP protokol
- D: Datagram / UDP protokol
- T: TLS / SSL protokol
-
Otevřete Logové zdroje >> Collectors. Najděte kolektor podle jeho štítku nebo identity.
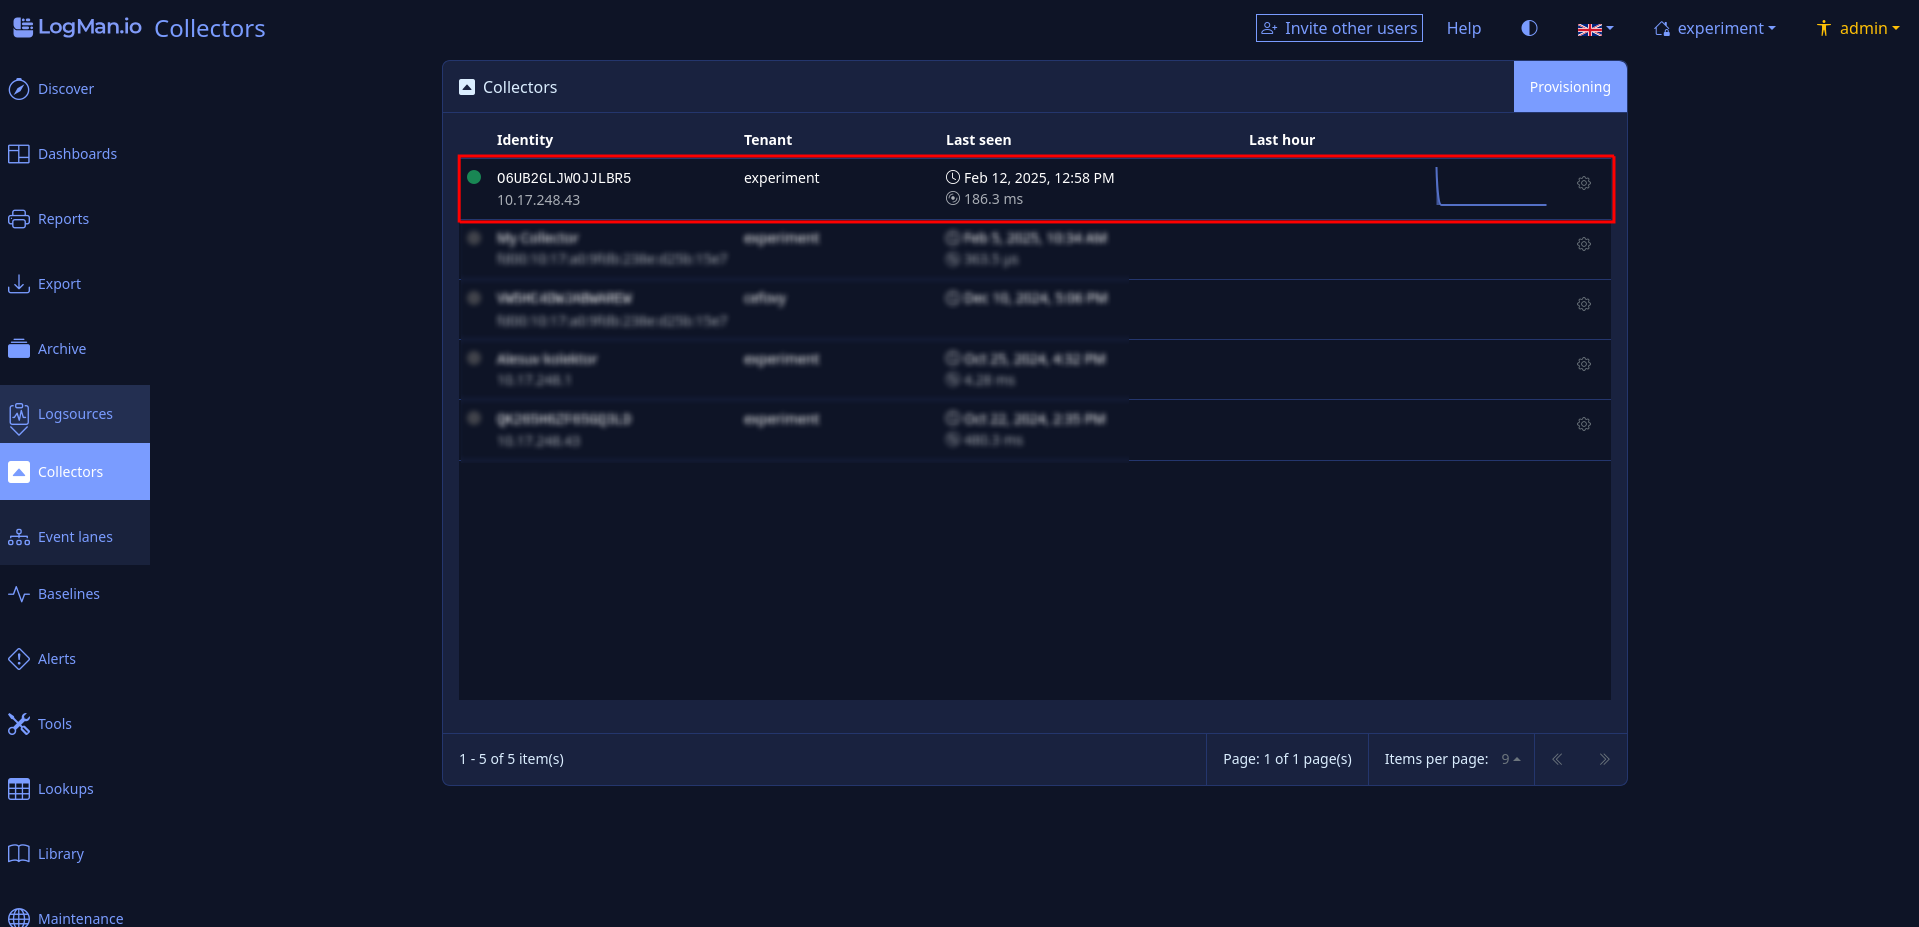
-
Otevřete kartu Vlastní. Zde můžete vybrat datové toky na základě IP adres, portů a protokolů. Sledujte tento odkaz pro podrobnosti o konfiguraci LogMan.io Collector. Všimněte si, že název toku je důležitý.
Příklad konfigurace LogMan.io Collectorclassification: syslog-1514: &syslog-1514 # Názvy toků my-stream-1: - { ip: 127.0.0.1 } input:SmartDatagram:smart-udp-1514: address: '1514' output: smart smart: *syslog-1514 input:SmartStream:smart-tcp-1514: address: '1514' output: smart smart: *syslog-1514 output:CommLink:smart: {}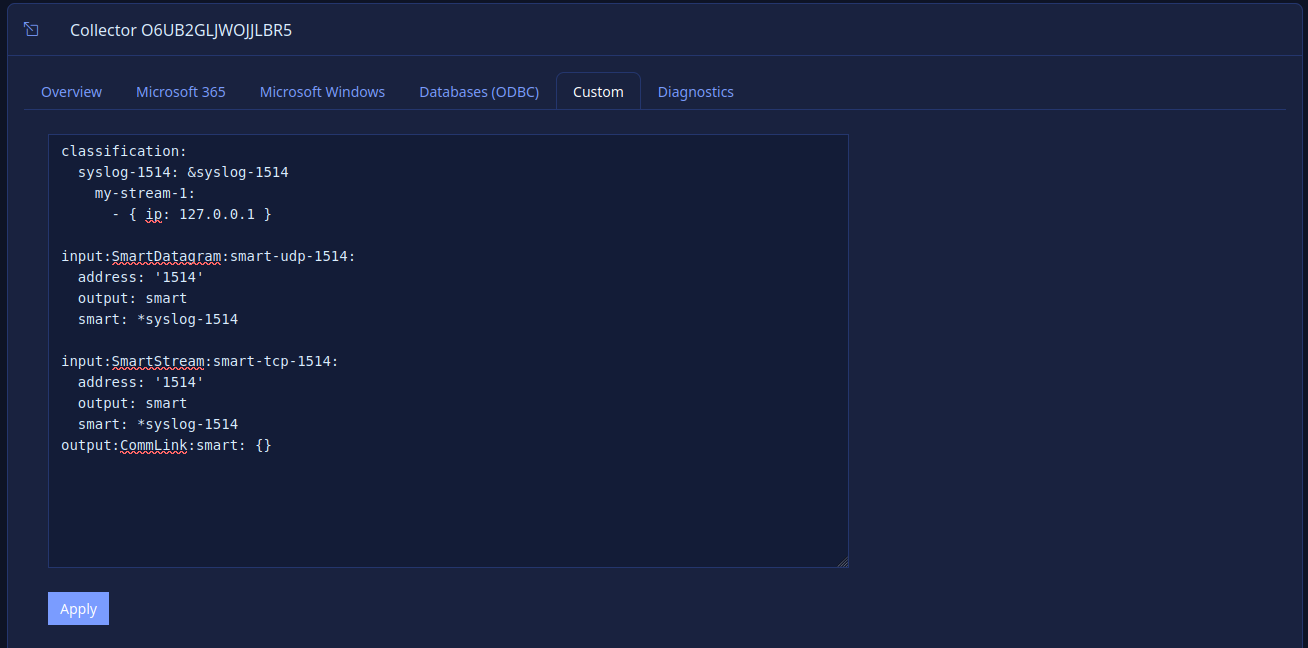
Klikněte na Použít.
-
Od nynějška jsou logy přicházející z IP adresy
127.0.0.1odesílány do datového tokumy-stream-1. Otevřete Archiv. Najděte tokmy-stream-1. Uvidíte přicházející logy z toku.
Info
Jakmile je log uložen v Archivu, nemůže být přesunut do jiného datového toku (Archiv je neměnná databáze).
Jak vytvořit event lane
Event lane jsou vytvářeny ze šablon event lane. Šablona event lane popisuje vlastnosti datového toku, které budou aplikovány na event lane. Má svou deklaraci v Knihovně:
---
define:
type: lmio/event-lane-template
name: Linux Rsyslog # Čitelný název datového toku
stream: linux-rsyslog-* # Reference na název toku
# Kategorizace logového zdroje
logsource:
product:
- linux
service:
- syslog
# Pravidla parsování, která se mají aplikovat na event lane
parsec:
name: /Parsers/Linux/Common/
# Obsah, který se má povolit při vytváření event lane
content:
dashboards: /Dashboards/Linux/Common/
Po nalezení nového datového toku je spárován s jednou z šablon event lane. Nová event lane bude vytvořena a zdědí vlastnosti této šablony. Nová deklarace pro event lane bude vytvořena v Knihovně:
---
define:
type: lmio/event-lane-template
name: Linux Rsyslog (1)
template: /Templates/EventLanes/Linux/linux-rsyslog.yaml
logsource:
product:
- linux
service:
- syslog
parsec:
name: /Parsers/Linux/Common/
instances: 2
content:
dashboards: /Dashboards/Linux/Common/
kafka:
received:
topic: received.company.linux-rsyslog-1
events:
topic: events.company.linux-rsyslog-1
others:
topic: others.company.linux-rsyslog-1
elasticsearch:
events:
index: lmio-company-events-linux-rsyslog-1
others:
index: lmio-company-others
Deklarace event lane kopíruje vlastnosti datového toku z jeho šablony a přidává informace o:
- jaké Kafka témata a Elasticsearch indexy budou použity
- kolik instancí mikroservisu LogMan.io Parsec poběží uvnitř clusteru LogMan.io
Jak pojmenovat datový tok? (2/2)
Když vyberete název toku, který odpovídá jedné z šablon event lane, odpovídající event lane zdědí její vlastnosti (pravidla parsování, obsah Knihovny, kategorizaci atd.).
Předpokládejme, že chcete připojit logový zdroj typu Linux Rsyslog. Můžete najít vhodnou technologii v šablonách event lane:
---
define:
type: lmio/event-lane-template
name: Linux Rsyslog # Čitelný název datového toku
stream: linux-rsyslog-* # Reference na název toku
Hvězdička * na konci možnosti stream odpovídá libovolnému číslu. Proto můžete pojmenovat svůj datový tok linux-rsyslog-1, linux-rsyslog-2 atd.
Odpovídající event lane pak zdědí název toku:
---
define:
type: lmio/event-lane
name: Linux Rsyslog (1)
template: /Templates/EventLanes/Linux/linux-rsyslog.yaml
Pravidla parsování a další vlastnosti event lane mohou být změněny ručně, takže není žádné riziko při výběru nesprávného názvu toku při prvním pokusu.
Obecné šablony
Když není nalezena žádná šablona event lane pro daný název datového toku, je event lane pro odpovídající datový tok vytvořena ze šablony Obecné event lane. Obecná šablona aplikuje pouze nejzákladnější pravidla parsování na datový tok a neposkytuje žádné konkrétní informace o logovém zdroji.
Když připojíte logový zdroj neznámého typu nebo typu, který neexistuje v šablonách event lane, event lane bude odvozena z obecné šablony. Vlastnosti této event lane můžete později upravit.
Správa datových linek
Uživatelský účet může upravovat a mazat datová linkay.
Úprava datových linek
datová linkay lze upravit v deklaraci Knihovny /EventLanes/tenant/eventlane.yaml. Například lze vybrat různé pravidla pro analýzu pro tento datový tok, nebo mu lze poskytnout novou sadu dashboardů.
Přečtěte si více o deklaracích datových linek zde.
Deaktivace a mazání datových linek
Datové linky lze deaktivovat a mazat.
Deaktivace datové linky
Chcete-li deaktivovat datovou linku, postupujte podle těchto kroků:
-
Zastavte všechny instance LogMan.io Parsec nastavením počtu instancí v deklaraci datové linky na nulu:
parsec: instances: 0 -
Ujistěte se, že všechny instance LogMan.io Parsec jsou zastaveny a odstraněny v sekci Údržba > Služby.
-
Deaktivujte datová linka změnou možnosti
define/typev deklaraci datové linky:define: type: lmio/event-lane-inactive -
Zastavte instanci LogMan.io Elman, aby se zabránilo vytvoření nového datové linky. Zastavte také všechny instance LogMan.io Receiver.
docker stop lmio-receiver-1 docker stop lmio-elman-1 -
Vstupte do Docker kontejneru Kafka. Ručně odstraňte témata
receivedaeventsdatové linky, který chcete odstranit.docker exec -it kafka-1 bash /bin/kafka-topics --bootstrap-server localhost:9092 --delete --topic received.tenant.stream /bin/kafka-topics --bootstrap-server localhost:9092 --delete --topic events.tenant.stream -
Restartujte LogMan.io Elman.
docker restart lmio-elman-1 -
Proveďte rollover v Elasticsearch pro index datové linky.
POST /lmio-tenant-events-stream/_rollover -
Odstraňte datový zdroj Discover pro datová linka v Konfigurace >> Discover >> lmio-tenant-events-stream.
-
Pokud chcete pouze deaktivovat datová linka, ale ponechat jeho data, restartujte všechny instance LogMan.io Receiver. Pokud chcete datová linka a jeho data smazat, pokračujte dále.
(node-1) $ docker restart lmio-receiver-1 (node-2) $ docker restart lmio-receiver-2 (node-3) $ docker restart lmio-receiver-3
Mazání neaktivního datové linky
-
Zastavte všechny instance LogMan.io Receiver. Přejděte do Zoonavigator, otevřete
lmio/receiver/dba odstraňte záznam datového toku. -
Ujistěte se, že Kafka topicy
receivedaeventsjsou odstraněna. Odstraňte deklaraci datové linky v Knihovně/EventLanes/tenant/stream.yaml. -
Pokud chcete smazat data datové linky, čtěte dále. Pokud ne, restartujte všechny instance LogMan.io Receiver.
Warning
Po smazání datové linky nejsou žádná data smazána z Archivu nebo databáze Elasticsearch, ale nelze k nim přistupovat z webové aplikace TeskaLabs LogMan.io.
Mazání dat datové linky
Danger
Mazání dat z TeskaLabs LogMan.io je možné, ale důrazně se nedoporučuje.
-
Otevřete Kibana >> Správa stacku >> Správa indexů. Odstraňte všechny indexy začínající na
lmio-tenant-events-stream. -
Otevřete Kibana >> Správa stacku >> Správa indexů >> Šablony indexů. Odstraňte šablonu indexu začínající na
lmio-tenant-events-stream. -
Otevřete Kibana >> Správa stacku >> Politiky životního cyklu indexu. Odstraňte ILM začínající na
lmio-tenant-events-stream. -
Ujistěte se, že všechny instance LogMan.io Receiver jsou zastaveny. Odstraňte všechna data streamu z horké, studené a teplé fáze na všech uzlech clusteru.
rm -rfv /data/ssd/lmio-receiver-x/hot/<stream> rm -rfv /data/hdd/lmio-receiver-x/warm/<stream> rm -rfv /data/hdd/lmio-receiver-x/cold/<stream> -
Restartujte všechny instance LogMan.io Receiver.
Profil datové linky
Profily datové linky definují životní cyklus dat pro datové linky. Profil specifikuje, jak dlouho jsou data uchovávána v Archive, Kafka a Elasticsearch v každé fázi a kdy jsou smazána.
Přiřazení profilu datové linky
Při vytváření nebo úpravě datové linky můžete přiřadit profil v souboru deklarace datové linky, který se nachází v Knihovně na /EventLanes/tenant/eventlane.yaml.
---
define:
type: lmio/event-lane
profile: /Profiles/EventLanes/Profile.yaml # Přiřaďte profil zde
Ve výchozím nastavení, pokud není profil specifikován, je použit profil /Profiles/EventLanes/Default.yaml.
Definice profilu
Profily jsou definovány v Knihovně pod /Profiles/EventLanes/. Každý profil je YAML soubor, který specifikuje politiky životního cyklu pro Archive streamy, Kafka témata a Elasticsearch indexy spojené s datovými linkami.
Každou sekci lze přepsat v deklaraci datové linky, což umožňuje přizpůsobení politik životního cyklu na základě jednotlivých datových linek.
Následující sekce mohou být definovány v profilu:
archive: Definuje politiky životního cyklu pro Archive streamy, včetně fází jako horká, teplá a studená, a akcí jako kopírovat, přesunout, komprimovat a smazat. Přečtěte si více o řízení životního cyklu Archive.kafka: Specifikuje nastavení uchovávání pro Kafka témata, včetněreceivedaevents.elasticsearch: Vystihuje politiky životního cyklu pro Elasticsearch indexy, včetně fází jako horká, teplá, studená a smazat, spolu s akcemi jako rollover, zmenšit, nastavit_prioritu a smazat. Přečtěte si více o řízení životního cyklu Elasticsearch.
Warning
Každá sekce musí být v profilu plně definována. Částečné definice nejsou podporovány. Například, pokud definujete sekci elasticsearch v profilu, musíte zahrnout všechny potřebné fáze a akce v této sekci.
---
define:
type: lmio/event-lane-profile
name: Default
archive:
lifecycle:
hot:
- copy:
phase: cold
- move:
age: 1d
phase: warm
warm:
- delete:
age: 3M
cold:
- compress:
preset: 6
threads: 4
type: xz
- delete:
age: 18M
kafka:
received:
settings:
retention: 1d
events:
settings:
retention: 1d
elasticsearch:
events:
lifecycle:
hot:
min_age: 0ms
actions:
rollover:
max_primary_shard_size: 16gb
max_age: 14d
set_priority:
priority: 100
warm:
min_age: 3d
actions:
shrink:
number_of_shards: 1
set_priority:
priority: 50
cold:
min_age: 14d
actions:
set_priority:
priority: 0
delete:
min_age: 180d
actions:
delete:
delete_searchable_snapshot: true
Životní cyklus dat
Životní cyklus dat v TeskaLabs LogMan.io zahrnuje několik fází navržených tak, aby efektivně spravovaly logová data během jejich cesty. Od počátečního ingestování, archivace a analýzy, indexování až po konečné smazání, je každá fáze pečlivě nakonfigurována pro optimalizaci výkonu, uchovávání dat a potřeby souladu. I když naše výchozí konfigurace poskytují rozumná nastavení pro většinu případů použití, což umožňuje plynulý provoz od prvního dne, pochopení fází životního cyklu může pomoci zpřesnit a přizpůsobit systém, jak se vaše požadavky vyvíjejí. Tato kapitola nabízí přehled těchto fází a zapojených databází, čímž klade základy pro pokročilou správu dat.
Data (např. logy, události, metriky) jsou uložena v několika fázích dostupnosti, v podstatě v chronologickém pořadí.
Existuje několik zastávek v toku dat, kde lze přizpůsobit životní cyklus nebo uchovávání dat:
- Archiv - Prvním komponentem, který shromažďuje data, je LMIO Receiver, který poskytuje Archiv. Data v Archivu jsou spravována prostřednictvím politiky životního cyklu nastavené pro každý stream.
Správa životního cyklu dat v Archivu
- Kafka - LMIO Receiver odesílá data do topicu
received.<tenant>.<stream>. Jakmile jsou data analyzována, dosahují topicuevents.<tenant>.<stream>neboothers.<tenant>, pokud analýza selže.
Nastavení politiky uchovávání v Kafce
- Elasticsearch - Analyzovaná data jsou uložena a indexována v Elasticsearch s jeho správou životního cyklu dat.
Správa životního cyklu indexu v Elasticsearch
Pro připomenutí toku dat prostřednictvím TeskaLabs LogMan.io si prosím prohlédněte Architektonický diagram.
Nastavení retenční politiky Kafka
TeskaLabs LogMan.io zajišťuje, že nastavení Kafka témat jsou udržována v určitých mezích.
- Topicy pro event lane jsou automaticky spravovány LogMan.io Event Lane Manager. Jejich retenční doba může být nastavena globálně.
- Retenci jakéhokoli Kafka topicu lze změnit ručně v Kafce.
Info
Následující řádky jsou relevantní pouze pro verze TeskaLabs LogMan.io starší než v25.28.
Od verze v25.28 je retenční politika pro topicy event lane automaticky spravována LogMan.io Event Lane Manager a může být nastavena v profilu Event Lane. Přečtěte si více o tom v profilu event lane.
Topicy pro event lane
LogMan.io Event Lane Manager automaticky nastavuje retenční politiku pro topicy event lane received.<tenant>.<stream>, events.<tenant>.<stream> a others.<tenant>. Je možné nastavit retenci globálně (pro všechny topicy) v konfiguraci:
services:
lmio-elman:
asab:
config:
kafka:
retention.ms_optimal: ... # výchozí: 3 dny
retention.ms_max: ... # výchozí: 7 dní
retention.ms_min: ... # výchozí: 1 den (24 hodin)
[kafka]
retention.ms_optimal=... ; výchozí: 3 dny
retention.ms_max=... ; výchozí: 7 dní
retention.ms_min=... ; výchozí: 1 den (24 hodin)
Když je vytvořen nový topic pro datovou linku, jeho retence je nastavena na retention.ms_optimal. Poté může být retence každého tématu event lane změněna ručně, ale musí být vyšší než retention.ms_min a nižší než retention.ms_max, jinak se automaticky vrátí na retention.ms_optimal.
Kontrola sanity
Warning
Následující řádky jsou relevantní pro neautomatizované nasazení TeskaLabs LogMan.io bez LMIO Event Lane Manager.
Pro instalace, kde není spuštěn LMIO Event Lane Manager, existuje podpůrný mechanismus, který nastavuje retenci pro topicy event lane.
LMIO Receiver kontroluje všechna Kafka topicy received.<tenant>.<stream> a zajišťuje, že jejich retence je mezi nakonfigurovanými minimem a maximem.
Výchozí minimální retence je 12 hodin a výchozí maximum je 7 dní.
Pokud je retence menší, je nastavena na nakonfigurovanou minimální hodnotu. Pokud je retence větší, je nastavena na nakonfigurovanou maximální hodnotu.
Můžete změnit konfiguraci v konfiguračním souboru LMIO Receiver. Použijte čas v milisekundách:
[kafka:sanity]
min.retention.ms=... # výchozí: 12 hodin
max.retention.ms=... # výchozí: 7 dní
LMIO Depositor implementuje stejnou logiku, používající stejnou konfiguraci, ovlivňující topicy events.<tenant>.<stream> a others.<tenant> a poskytující stejné výchozí hodnoty.
Mějte na paměti, že retenci lze řídit na základě jak stáří logů v frontě, tak velikosti topicy (v bajtech). Komponenty LogMan.io nekontrolují konfiguraci retence na základě velikosti indexu.
Nastavení retenční doby v Kafce
Retenci každého Kafka topiku lze změnit v Kafce.
Každý Docker kontejner Kafka je vybaven nástroji pro příkazový řádek Kafka, které lze použít.
-
Vstupte do shellu Docker kontejneru Kafka:
docker exec -it kafka-1 bash -
Zkontrolujte, že téma existuje a je dostupné:
/usr/bin/kafka-topics --bootstrap-server localhost:9092 --list | grep "<topic>"(Nahraďte
<topic>názvem vašeho topiku.) -
Nastavte retenci pro jednotlivé topiky pomocí příkazu:
/usr/bin/kafka-configs --bootstrap-server localhost:9092 \ --entity-type topics --entity-name "<topic>" \ --alter --add-config retention.ms=86400000(Nahraďte
<topic>názvem vašeho topicu aretention.msvaší hodnotou.)
Proč milisekundy?
Možná se ptáte, proč používáme milisekundy všude, kde konfigurujeme retenci Kafky. Proč prostě nepoužít hodiny nebo dny?
Ve skutečnosti existují konfigurační možnosti pro nastavení retence pomocí hodin nebo dní.
Ale volba retention.ms má vždy nejvyšší prioritu před všemi ostatními možnostmi.
Abychom předešli možným konfliktům s jinými službami, rozhodli jsme se používat milisekundy, což je také doporučeno společností Confluent.
Správa životního cyklu indexu Elasticsearch
Správa životního cyklu indexu (ILM) v Elasticsearch slouží k automatickému uzavření nebo odstranění starých indexů (tj. s daty staršími než tři měsíce), aby byla zachována výkonnost vyhledávání a úložiště dat bylo schopno uchovávat aktuální data.
TeskaLabs LogMan.io poskytuje výchozí politiku ILM pro každý index.
Výchozí politika ILM je zdokumentována zde. Můžete ji změnit pro každý index Elasticsearch v příslušném prohlášení Event Lane. Přečtěte si více o tom zde.
Architektura Hot-Warm-Cold (HWC)
HWC je rozšíření standardní rotace indexů poskytované ILM Elasticsearch a je dobrým nástrojem pro správu dat časových řad. Architektura HWC nám umožňuje přiřadit specifické uzly k jedné z fází. Při správném použití, spolu s architekturou clusteru, to umožní maximální výkon, využívající dostupný hardware na maximum.
Horká fáze
Obvykle existuje nějaké časové období (týden, měsíc atd.), kdy chceme intenzivně dotazovat indexy, zaměřujeme se na rychlost, spíše než na úsporu paměti (a dalších zdrojů). To je místo, kde přichází "Horká" fáze, která nám umožňuje mít index s více replikami, rozloženými a dostupnými na více uzlech pro optimální uživatelský zážitek.
Horké uzly
Horké uzly by měly využívat rychlé části dostupného hardwaru, využívající většinu CPU a rychlejší IO.
Teplá fáze
Jakmile toto období skončí a indexy již nejsou dotazovány tak často, budeme mít prospěch z jejich přesunu do "Teplé" fáze, která nám umožňuje snížit počet uzlů (nebo se přesunout na uzly s méně dostupnými zdroji) a replik indexů, čímž se sníží zátěž na hardware, přičemž stále zachováváme možnost vyhledávat data přiměřeně rychle.
Teplé uzly
Teplé uzly, jak název napovídá, stojí na křižovatce, mezi tím, aby byly výhradně pro účely ukládání, a přitom si zachovaly nějakou CPU sílu pro občasné dotazy.
Studená fáze
Někdy existují důvody pro uchovávání dat po delší dobu (diktované zákonem nebo nějakým interním pravidlem). Data se neočekávají, že budou dotazována, ale zároveň je nelze zatím smazat.
Studené uzly
Tady přicházejí do hry studené uzly, může jich být málo, s pouze malými CPU zdroji, nemají potřebu používat SSD disky, což je naprosto v pořádku s pomalejším (a volitelně větším) úložištěm.
Zálohování a obnovení Elasticsearch
Snapshoty
Nachází se pod Stack Management -> Snapshot and Restore. Snapshoty jsou uloženy na místě repozitáře. Struktura je následující. Samotný snapshot je pouze ukazatel na indexy, které obsahuje. Samotné indexy jsou uloženy v samostatném adresáři a jsou ukládány inkrementálně. To v podstatě znamená, že pokud vytvoříte snapshot každý den, starší indexy jsou v snapshotu pouze znovu odkazovány, zatímco pouze nové indexy jsou skutečně zkopírovány do záložního adresáře.
Repozitáře
Nejprve je třeba nastavit repozitář snapshotů. Určete umístění, kde se repozitář snapshotů nachází, například /backup/elasticsearch. Tato cesta musí být přístupná ze všech uzlů v clusteru. Pokud je Elasticsearch spuštěn v dockeru, zahrnuje to namontování prostoru uvnitř dockerových kontejnerů a jejich restartování.
Politiky
Aby bylo možné začít pořizovat snapshoty, je třeba vytvořit politiku. Politika určuje předponu názvu snapshotů, které vytváří, specifikuje repozitář, který bude používat pro vytváření snapshotů, a vyžaduje nastavení plánu, indexy (definované pomocí vzorů nebo konkrétních názvů indexů - například lmio-<tenant>-events-*).
Dále může politika specifikovat, zda ignorovat nedostupné indexy, povolit částečné indexy a zahrnout globální stav. Použití těchto závisí na konkrétním případě, ve kterém bude politika snapshotu použita, a není doporučeno jako výchozí. K dispozici je také nastavení pro automatické mazání snapshotů a definování expirace. Tyto také závisí na konkrétní politice, samotné snapshoty jsou však velmi malé (co se paměti týče), pokud neobsahují globální stav, což je očekávané, protože jsou to pouze ukazatele na jiné místo, kde jsou uložena skutečná data indexu.
Obnovení snapshotu
Pro obnovení snapshotu jednoduše vyberte snapshot obsahující index nebo indexy, které chcete obnovit, a vyberte "Obnovit". Poté musíte specifikovat, zda chcete obnovit všechny indexy obsažené v snapshotu, nebo pouze část. Můžete přejmenovat obnovené indexy, můžete také obnovit částečné snapshot indexy a upravit nastavení indexu při jejich obnovování. Nebo je resetovat na výchozí hodnoty. Indexy jsou poté obnoveny podle specifikací zpět do clusteru.
Upozornění
Při mazání snapshotů mějte na paměti, že musíte mít zálohované indexy pokryté snapshotem, abyste je mohli obnovit. To znamená, že pokud například vyčistíte některé indexy z clusteru a poté odstraníte snapshot, který obsahoval odkaz na tyto indexy, nebudete je moci obnovit.
Sledování systému
Systémové monitorování
Následující nástroje a techniky vám mohou pomoci pochopit, jak si váš systém TeskaLabs LogMan.io vede a prozkoumat jakékoliv vzniklé problémy.
Přednastavené dashboardy
LogMan.io zahrnuje přednastavené diagnostické dashboardy, které vám poskytnou přehled o výkonu vašeho systému. To je nejlepší místo, kde začít s monitorováním.
Příklad přednastaveného dashboardu
Preventivní kontroly
Preventivní kontroly jsou preventivní prohlídky vaší aplikace LogMan.io a výkonu systému. Navštivte náš manuál pro preventivní kontroly a naučte se, jak pravidelně provádět preventivní kontroly.
Metriky
Metriky jsou měření týkající se výkonu systému. Vyšetřování metrik může být užitečné, pokud již víte, kterou oblast svého systému potřebujete prozkoumat, což můžete zjistit analýzou přednastavených dashboardů nebo provedením preventivní kontroly.
Dashboardy Grafana pro diagnostiku systému
Prostřednictvím TeskaLabs LogMan.io můžete přistupovat k dashboardům v Grafana, které monitorují vaše datové pipelines. Tyto dashboardy používejte pro diagnostické účely.
Prvních několik měsíců nasazení TeskaLabs LogMan.io je stabilizační období, během kterého můžete vidět extrémní hodnoty produkované těmito metrikami. Tyto dashboardy jsou obzvlášť užitečné během stabilizace a mohou pomoci s optimalizací systému. Jakmile je váš systém stabilní, extrémní hodnoty obecně indikují problém.
Pro přístup k dashboardům:
- V LogMan.io, přejděte na Nástroje.


-
Klikněte na Grafana. Nyní jste bezpečně přihlášeni do Grafana pomocí vašich uživatelských přihlašovacích údajů pro LogMan.io.
-
Klikněte na tlačítko menu a přejděte na Dashboardy.
-
Vyberte dashboard, který si chcete prohlédnout.
Tipy
- Přejeďte myší nad jakýkoli graf, abyste viděli detaily v konkrétních časových bodech.
- Můžete změnit časový rámec jakéhokoli dashboardu pomocí nástrojů pro změnu časového rámce v pravém horním rohu obrazovky.
Dashboard LogMan.io
Dashboard LogMan.io monitoruje všechny datové pipelines ve vaší instalaci TeskaLabs LogMan.io. Tento dashboard vám může pomoci zjistit, pokud například vidíte méně logů, než očekáváte v LogMan.io. Viz Metiky pipeline pro hlubší vysvětlení.
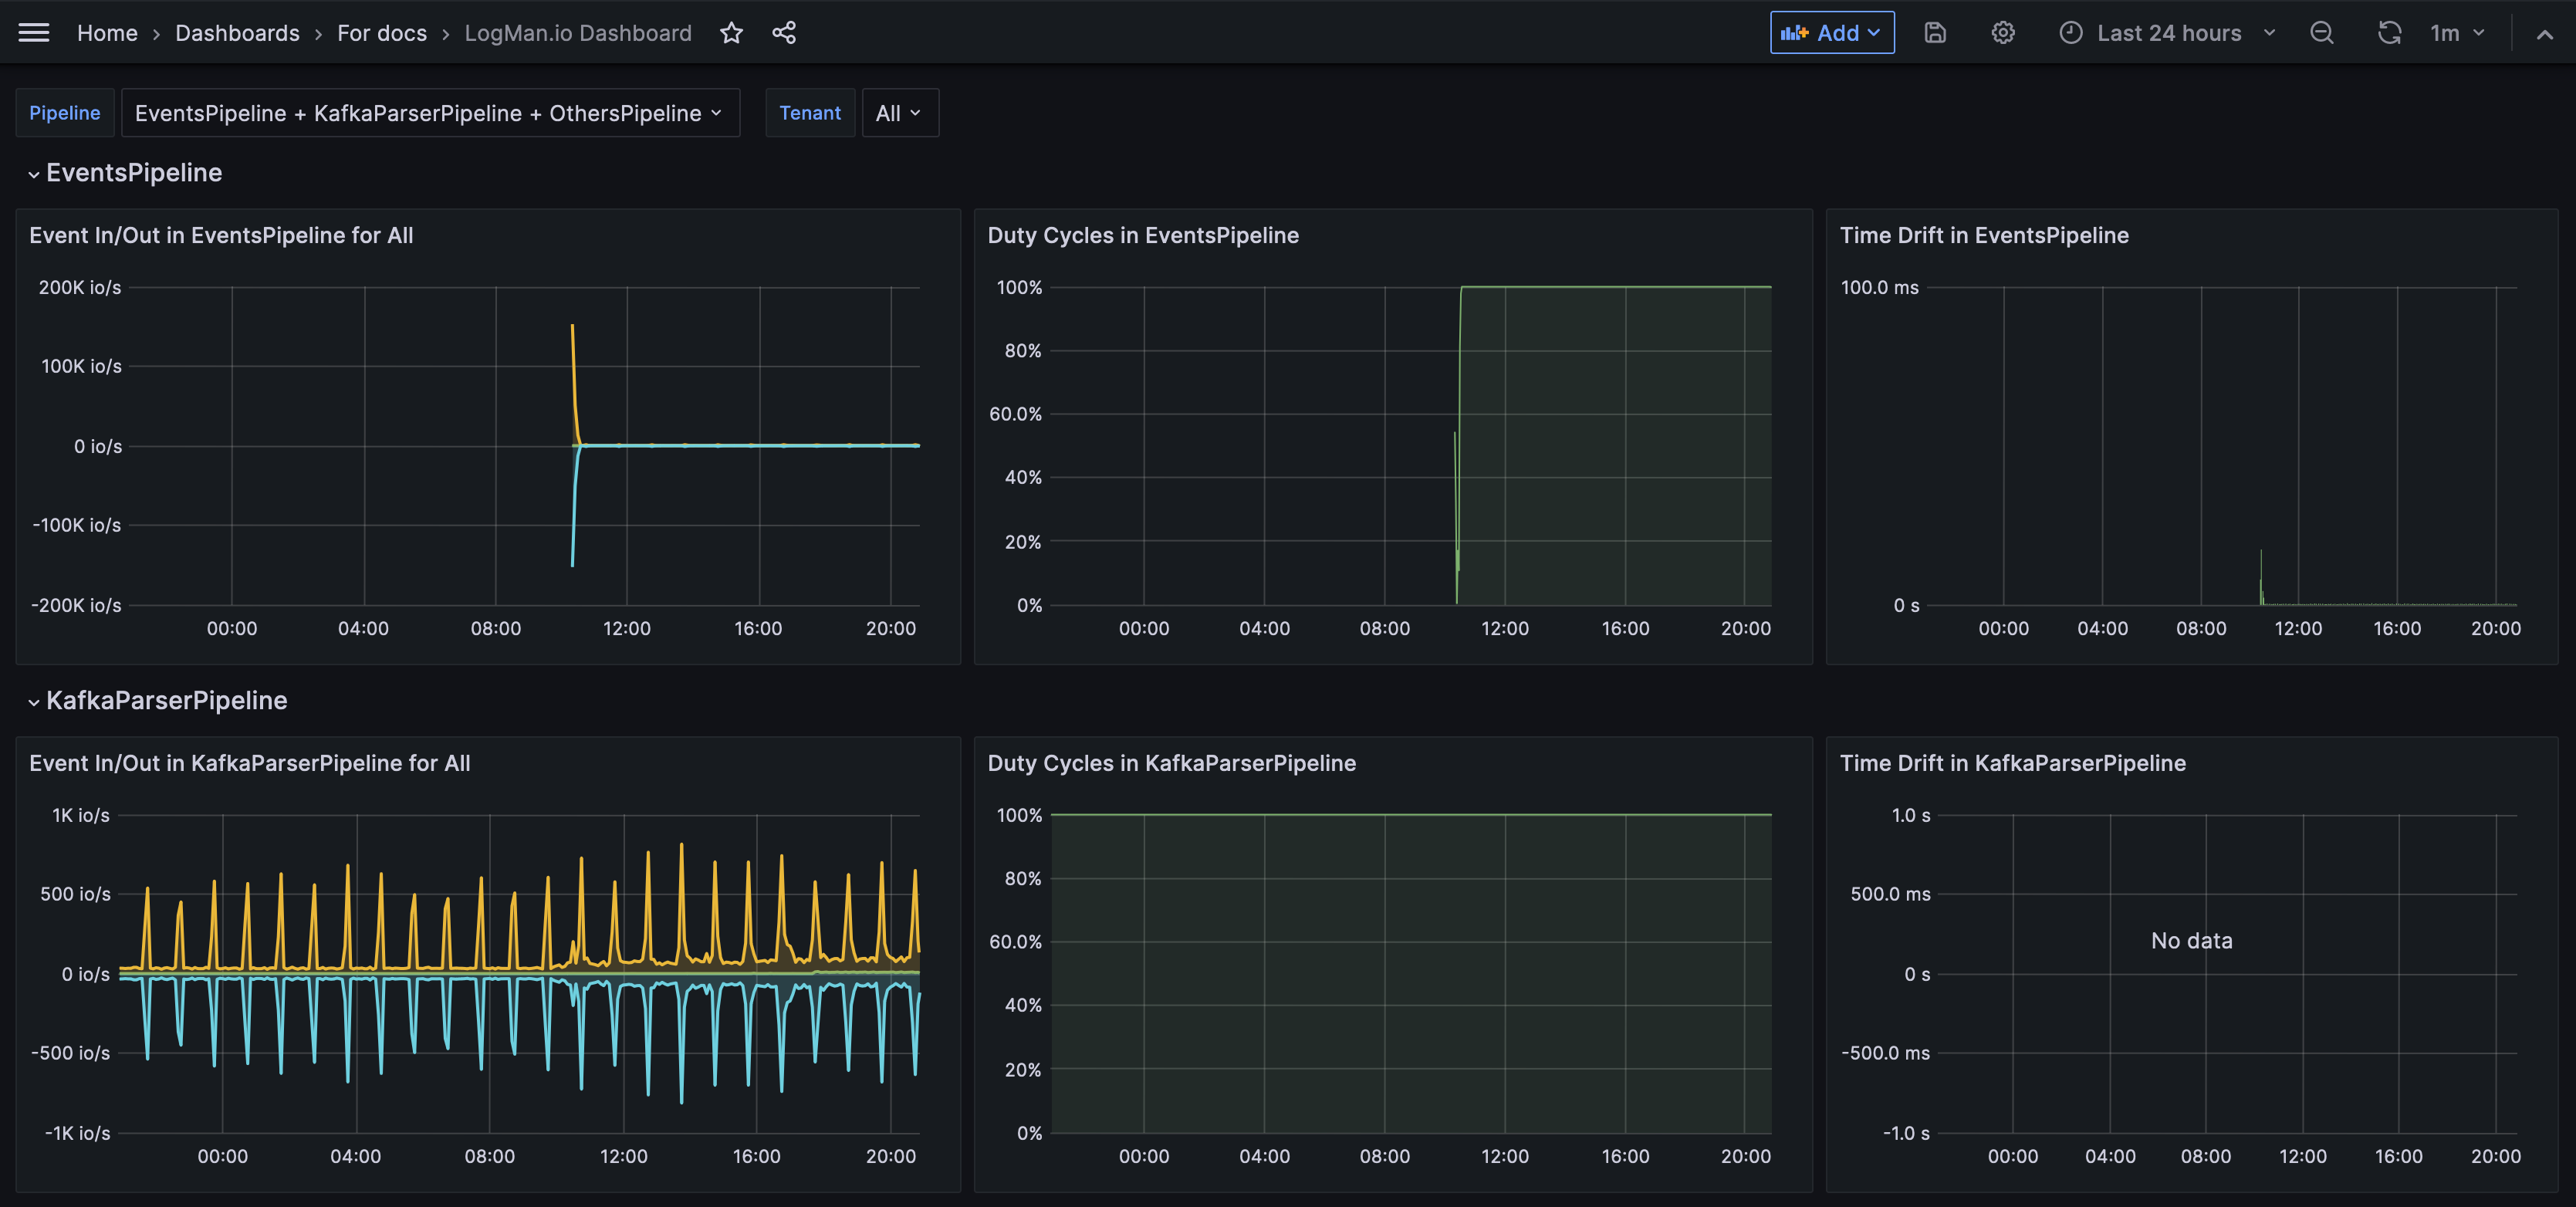
Zahrnuté metriky:
-
Event In/Out: Objem událostí procházejících každou datovou pipeline měřený v operacích vstup/výstup za sekundu (io/s). Pokud pipeline běží hladce, množství In a Out je stejné a linie Drop je nula. To znamená, že stejný počet událostí vstupuje a opouští pipeline a žádná není ztracena. Pokud graf ukazuje, že množství In je větší než množství Out a linie Drop je větší než nula, znamená to, že některé události byly ztraceny a může být problém.
-
Duty cycle: Zobrazuje procento zpracovávaných dat ve srovnání s daty čekajícími na zpracování. Pokud pipeline pracuje podle očekávání, duty cycle je 100%. Pokud je duty cycle nižší než 100%, znamená to, že někde v pipeline je zpoždění nebo překážka, která způsobuje frontu událostí.
-
Time drift: Ukazuje zpoždění nebo lag v zpracování událostí, což znamená, jak dlouho po doručení události je skutečně zpracována. Významné nebo zvýšené zpoždění ovlivňuje vaši kybernetickou bezpečnost, protože brání vaší schopnosti okamžitě reagovat na hrozby. Time drift a duty cycle jsou související metriky. Větší časový drift se objevuje, když je duty cycle pod 100%.
Dashboard přehledu na systémové úrovni
Dashboard přehledu na systémové úrovni monitoruje servery zapojené do vaší instalace TeskaLabs LogMan.io. Každý uzel instalace má svou vlastní sekci v dashboardu. Když narazíte na problém ve vašem systému, tento dashboard vám pomůže provést počáteční hodnocení vašeho serveru tím, že vám ukáže, zda je problém spojen s vstup/výstupem, CPU, sítí nebo místem na disku. Pro konkrétnější analýzu se však zaměřte na specifické metriky v Grafana nebo InfluxDB.
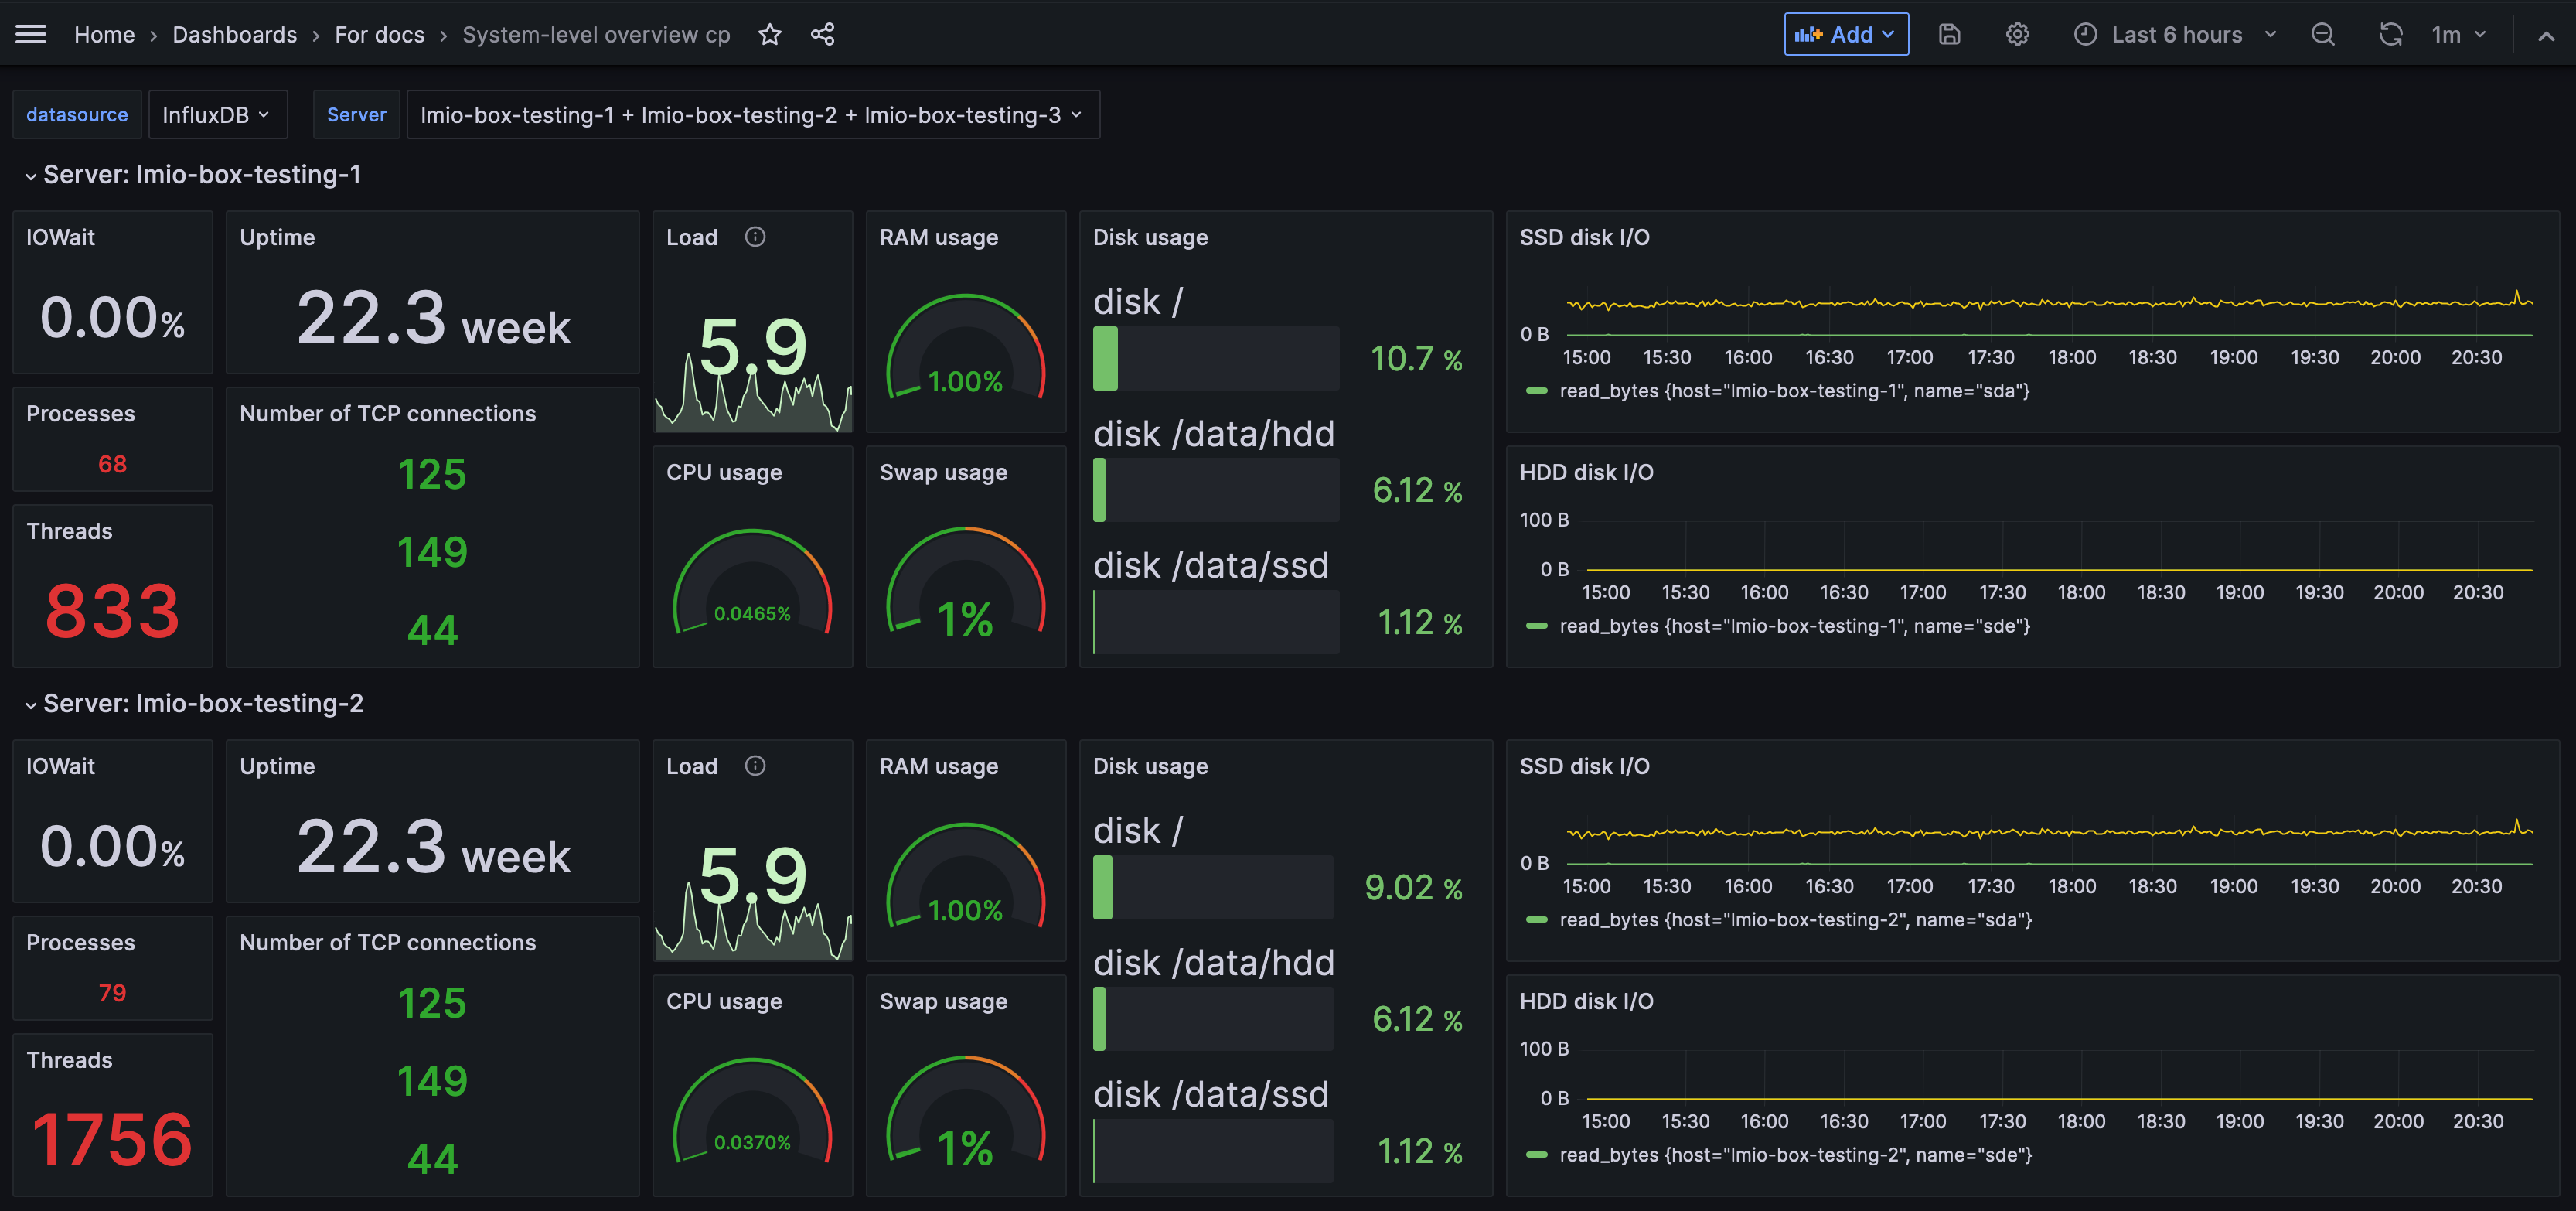
Zahrnuté metriky:
- IOWait: Procento času, kdy CPU zůstává nečinné, zatímco čeká na žádosti o diskový I/O (vstup/výstup). Jinými slovy, IOWait vám říká, kolik času zpracování je plýtváno čekáním na data. Vysoký IOWait, zejména pokud je kolem nebo přesahuje 20% (v závislosti na vašem systému), signalizuje, že rychlost čtení/zápisu disku se stává úzkým hrdlem systému. Rostoucí IOWait naznačuje, že výkon disku omezuje schopnost systému přijímat a ukládat více logů, což ovlivňuje celkovou propustnost a efektivitu systému.
- Uptime: Doba, po kterou server běží bez toho, aby byl vypnut nebo restartován.
- Load: Představuje průměrný počet procesů čekajících v frontě na CPU čas za posledních 5 minut. Je to přímý indikátor, jak zaneprázdněný váš systém je. V systémech s více jádry CPU by tato metrika měla být považována ve vztahu k celkovému počtu dostupných jader. Například zatížení 64 na systému se 64 jádry může být přijatelné, ale nad 100 indikuje vážný stres a neodpovídavost. Ideální zatížení se liší v závislosti na konkrétní konfiguraci a případu použití, ale obecně by nemělo přesahovat 80% celkového počtu jader CPU. Konzistentně vysoké hodnoty zatížení naznačují, že systém se potýká s efektivním zpracováním příchozích logů.
- RAM usage: Procento celkové paměti, která je aktuálně využívána systémem. Udržování využití RAM mezi 60-80% je obecně optimální. Využití nad 80% často vede ke zvýšenému využití swapu, což může zpomalit systém a vést k nestabilitě. Monitorování využití RAM je klíčové pro zajištění, že systém má dostatek paměti k efektivnímu zvládání pracovního zatížení bez použití swapu, který je výrazně pomalejší.
- CPU usage: Přehled procenta kapacity CPU, která je aktuálně používána. Průměruje využití mezi všemi jádry CPU, což znamená, že jednotlivá jádra mohou být pod nebo nadměrně využita. Vysoké využití CPU, zejména nad 95%, naznačuje, že systém čelí výzvám spojeným s kapacitou CPU, kde hlavním omezením je kapacita zpracování CPU. Tato metrika dashboardu pomáhá rozlišit mezi problémy s I/O (kde je úzkým hrdlem přenos dat) a problémy s CPU. Je to klíčový nástroj pro identifikaci úzkých hrdel zpracování, i když je důležité tuto metriku interpretovat společně s ostatními systémovými indikátory pro přesnější diagnostiku.
- Swap usage: Kolik swapového prostoru je využíváno. Swapová partition je vyhrazený prostor na disku použitý jako dočasná náhrada za RAM ("přetečení dat"). Když je RAM plná, systém dočasně ukládá data do swapového prostoru. Vysoké využití swapu, přes přibližně 5-10%, naznačuje, že systému dochází paměť, což může vést ke sníženému výkonu a nestabilitě. Trvalé vysoké využití swapu je znakem toho, že systém potřebuje více RAM, protože silné spoléhání na swapový prostor se může stát hlavním úzkým hrdlem výkonu.
- Disk usage: Měří, kolik kapacity úložiště je aktuálně využíváno. Ve vašem systému pro správu logů je klíčové udržovat využití disku pod 90% a činit opatření, pokud dosáhne 80%. Nedostatečný prostor na disku je častou příčinou selhání systému. Monitorování využití disku pomáhá v proaktivním řízení úložných zdrojů, což zajišťuje dostatek prostoru pro příchozí data a systémové operace. Vzhledem k tomu, že většina systémů je konfigurována k mazání dat po 18 měsících skladování, může se využití disku začít stabilizovat po 18 měsících provozu systému. Více si přečtěte o životním cyklu dat.
Dashboard metrik Elasticsearch
Dashboard metrik Elasticsearch monitoruje zdraví Elastic pipeline. (Většina uživatelů TeskaLabs LogMan.io používá databázi Elasticsearch pro ukládání log dat.)
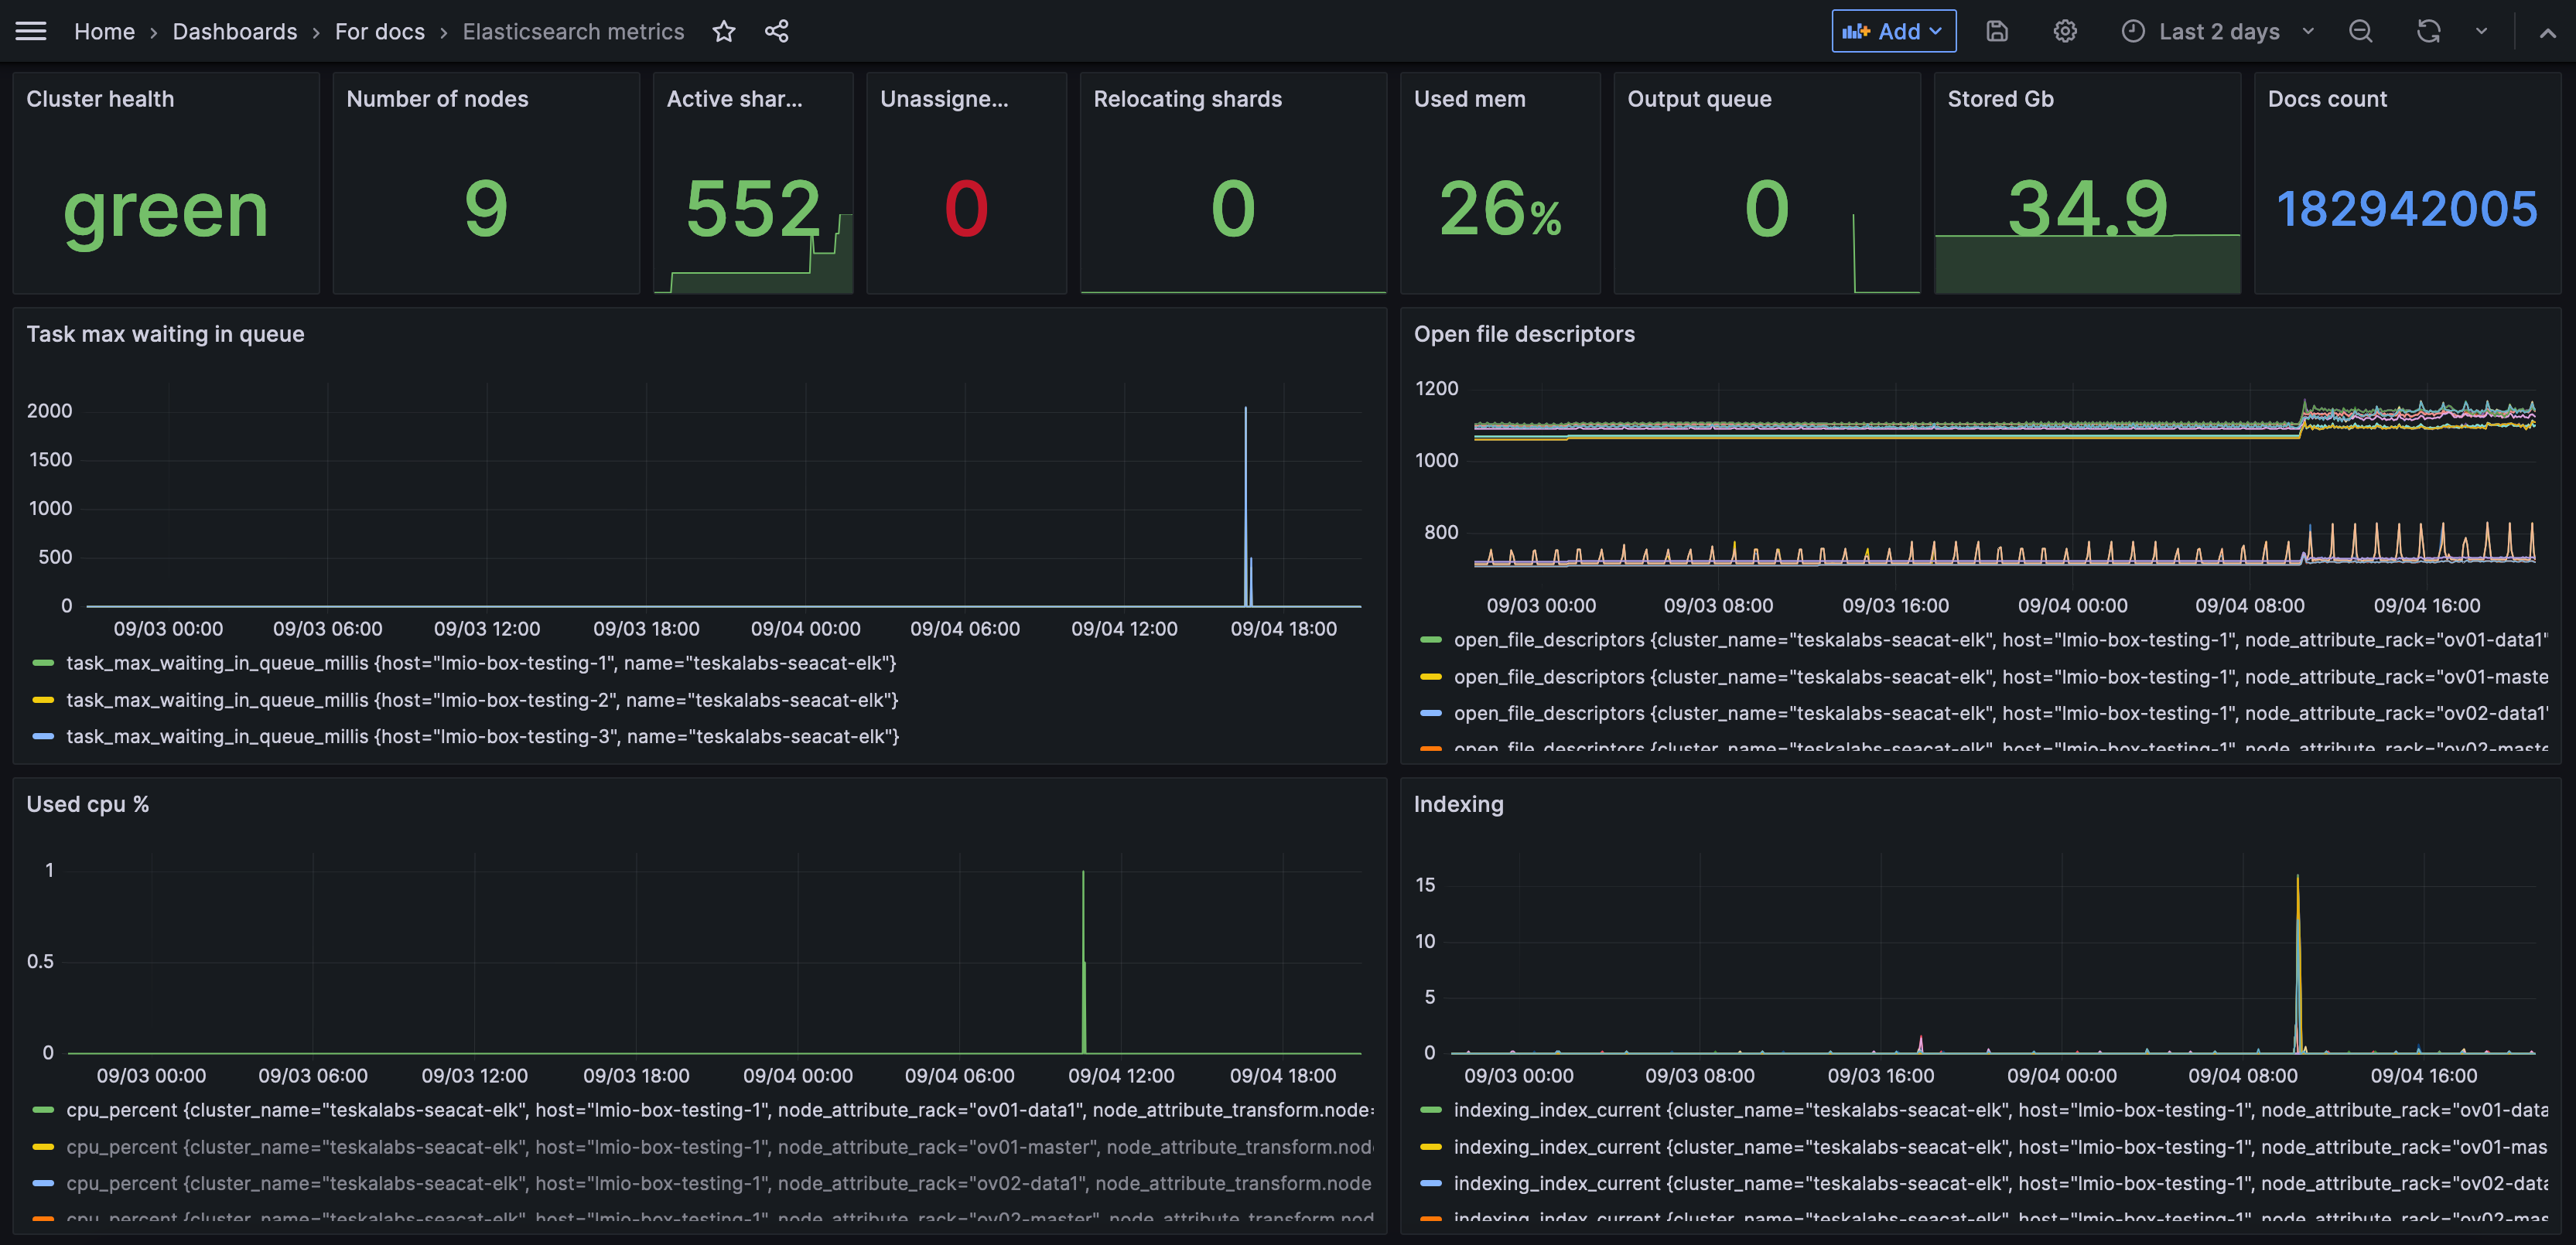
Zahrnuté metriky:
- Cluster health: Zelená je dobrá; žlutá a červená indikují problém.
- Number of nodes: Uzel je jedna instance Elasticsearch. Počet uzlů je, kolik uzlů je součástí vašeho clusteru Elasticsearch v LogMan.io.
- Shards
- Active shards: Počet celkem aktivních shardů. Shard je jednotka, ve které Elasticsearch distribuuje data po celém clusteru.
- Unassigned shards: Počet shardů, které nejsou k dispozici. Mohou být v uzlu, který je vypnutý.
- Relocating shards: Počet shardů, které jsou v procesu přesunu do jiného uzlu. (Možná budete chtít vypnout uzel kvůli údržbě, ale stále chcete, aby všechna vaše data byla dostupná, takže můžete přesunout shard do jiného uzlu. Tato metrika vám řekne, zda jsou nějaké shardy aktivně v tomto procesu a proto zatím nemohou poskytovat data.)
- Used mem: Použitá paměť. Použitá paměť na 100% by znamenala, že Elasticsearch je přetížený a vyžaduje vyšetřování.
- Output queue: Počet úkolů čekajících na zpracování ve výstupní frontě. Vysoký počet může naznačovat významné zpoždění nebo úzké hrdlo.
- Stored GB: Množství diskového prostoru používaného pro ukládání dat v clusteru Elasticsearch. Monitorování využití disku pomáhá zajistit dostatek volného prostoru a plánovat nezbytné rozšíření kapacity.
- Docs count: Celkový počet dokumentů uložených v indexech Elasticsearch. Monitorování počtu dokumentů může poskytnout přehled o růstu dat a požadavcích na správu indexů.
- Task max waiting in queue: Maximální doba, po kterou úkol čekal ve frontě na zpracování. Je užitečná pro identifikaci zpoždění ve zpracování úkolů, což může ovlivnit výkon systému.
- Open file descriptors: Popisovače souborů jsou handly, které umožňují systému spravovat a přistupovat k souborům a síťovým připojením. Monitorování počtu otevřených popisovačů souborů je důležité pro zajištění efektivního řízení systémových zdrojů a prevenci potenciálních úniků handle, které by mohly vést k nestabilitě systému.
- Used cpu %: Procento CPU zdrojů aktuálně používaných Elasticsearch. Monitorování využití CPU pomáhá pochopit výkon systému a identifikovat potenciální úzká místa v CPU.
- Indexing: Míra, jakou jsou nové dokumenty indexovány do Elasticsearch. Vyšší míra znamená, že váš systém může efektivněji indexovat více informací.
- Inserts: Počet nových dokumentů přidávaných do indexů Elasticsearch. Tato linie následuje pravidelný vzor, pokud máte konzistentní počet vstupů. Pokud linie nepravidelně stoupne nebo klesne, může být problém ve vaší datové pipeline, která zabraňuje událostem dosáhnout Elasticsearch.
Dashboard zpoždění konzumentů Burrow
Dashboard Burrow monitoruje konzumenty a partitiony Apache Kafka. Více se dozvíte o Burrow zde.
Termíny Apache Kafka:
- Consumers: Konzumenti čtou data. Předplácejí si jeden nebo více témat a čtou data v pořadí, ve kterém byla vyprodukována.
- Consumer groups: Konzumenti jsou obvykle organizováni do skupin konzumentů. Každý konzument ve skupině čte z exkluzivních partitionů témat, která si předplácejí, což zajišťuje, že každý záznam je zpracován skupinou pouze jednou, i když více konzumentů čte.
- Partitions: Témata jsou rozdělena na partitiony. Toto umožňuje distribuci dat po celém clusteru, což umožňuje současné čtení a zápis operací.
Zahrnuté metriky:
- Group status: Celkový zdravotní stav skupiny konzumentů. Stav OK znamená, že skupina funguje normálně, zatímco varování nebo chyba mohou indikovat problémy, jako jsou problémy s připojením, selhalí konzumenti nebo nesprávné konfigurace.
- Total lag: V tomto případě lze lag chápat jako frontu úkolů čekajících na zpracování mikroslužbou. Metrika total lag představuje počet zpráv, které byly vyprodukovány do tématu, ale ještě nebyly spotřebovány konkrétním konzumentem nebo skupinou konzumentů. Pokud je lag 0, vše je správně odesláno a není žádná fronta. Vzhledem k tomu, že Apache Kafka má tendenci seskupovat data do dávky, určité množství lagu je často normální. Nicméně, rostoucí lag nebo lag nad přibližně 300 000 (toto číslo závisí na kapacitě vašeho systému, konfiguraci a citlivosti) je důvodem k vyšetřování.
- Partitions lag: Lag jednotlivých partitionů v rámci tématu. Možnost vidět lagu jednotlivých partitionů odděleně vám říká, zda některé partitiony mají větší frontu nebo vyšší zpoždění než jiné, což může indikovat nerovnoměrnou distribuci dat nebo jiné specifické problémy s partitionem.
- Partition status: Stav jednotlivých partitionů. Stav OK naznačuje, že partition funguje normálně. Varování nebo chyby mohou naznačovat problémy jako zastavený konzument, který nečte z partitionu. Tato metrika pomáhá identifikovat specifické problémy s partitionem, které by nemusely být zjevné při pohledu na celkový stav skupiny.
Profylaktická kontrola
Profylaktická kontrola v TeskaLabs LogMan.io je strukturovaný, periodický přehled platformy prováděný na týdenní nebo měsíční bázi. Jejím cílem je proaktivně identifikovat problémy, jako jsou nesprávné konfigurace, degradovaný výkon nebo výpadky zdrojů logů, dříve než ovlivní stabilitu systému nebo integritu dat. Proces zahrnuje přezkoumání funkčnosti uživatelského rozhraní, systémových metrik, zdraví Elasticsearch a ověření, že všechny zdroje logů jsou aktivní a správně přijímají data.
Úvod
Profylaktické kontroly MUSÍ být prováděny pravidelně (týdně, měsíčně atd.), ideálně ve stejný den v týdnu a v konzistentní čas. Je zásadní zohlednit variace v množství a frekvenci příchozích událostí, které mohou kolísat na základě dne v týdnu, pracovní doby a státních svátků.
Doporučená periodicita profylaktických kontrol:
- 1x týdně v období "hypercare"; období hypercare je stabilizační období po počáteční instalaci produktu, trvající přibližně 3 měsíce.
- 1x měsíčně
Výsledky profylaktických kontrol by měly být zdokumentovány ve dvou samostatných reportech:
- Report dodavatele – Udržován pro interní sledování a eskalaci, a pro komunikaci s TeskaLabs, pokud je to nutné.
- Report klienta – Zjednodušený souhrn sdílený s klientem prostřednictvím jejich podpůrného kanálu (např. Slack, e-mail).
Note
Dbejte na to, abyste jasně vysvětlili a popsali zjištění, a zajistěte, že závažné problémy jsou již interně řešeny. Pokud je řešení na cestě, vždy to v reportu komunikujte.
Přerozdělení podpory
Seznam jednotlivců zapojených do konkrétních projektů lze nalézt v interní dokumentaci. Pokud nastane problém, eskalujte ho vhodně na základě zapojeného klienta, partnera nebo zákazníka.
Postup profylaktické kontroly
Požadavky
- Přístup (HTTPS, SSH) k příslušné instalaci TeskaLabs LogMan.io.
- Ujistěte se, že všechny tenanty, které máte k dispozici, jsou během těchto kontrol přezkoumány.
Funkčnosti TeskaLabs LogMan.io
Kontrola navigace a funkčnosti
- Prozkoumejte každý přiřazený tenant kontrolou všech komponent v postranním panelu:
- Objev: Ověřte přístupnost logů, výkon vyhledávání a provádění dotazů. Ujistěte se, že jsou logy správně indexovány a dostupné.
- Dashboardy: Zkontrolujte správnost vizualizace dat, aktualizované widgety a správné filtrování. Ujistěte se, že grafy a diagramy odrážejí očekávané metriky.
- Reporty: Ověřte generování reportů, jejich formátování a přesnost dat. Ujistěte se, že naplánované reporty jsou doručovány správně.
- Export: Otestujte extrakci dat a ujistěte se, že exportované soubory jsou správně formátovány a obsahují očekávaný obsah.
- Archiv: Ověřte, že archivované logy jsou dostupné a uloženy podle očekávání.
- Zdroje logů:
- Kolektory: Ujistěte se, že všechny kolektory jsou aktivní, přijímají data a jsou správně nakonfigurovány.
- Event Lanes: Ověřte správnou klasifikaci událostí a potvrďte, že nedochází k anomáliím v zpracování.
- Baseliner: Zkontrolujte základní metriky, abyste zajistili, že odpovídají očekávaným prahům, a přezkoumejte změny.
- Upozornění: Potvrďte, že mechanismy upozornění fungují, otestujte spouštěče upozornění a přezkoumejte eskalace.
- Nástroje: Ujistěte se, že vestavěné nástroje (např. Grafana, Kibana) fungují podle očekávání.
- Vyhledávání: Ověřte tabulky pro vyhledávání na přesnost a ujistěte se, že jsou správně odkazovány v zpracování událostí.
- Knihovna: Potvrďte dostupnost a správné verze sdílených zdrojů a obsahu.
- Údržba:
- Konfigurace: Ujistěte se, že systémová nastavení a konfigurace jsou správně udržovány a aktualizovány.
- Služby: Ověřte, že backendové služby jsou funkční a běží hladce.
-
Autentizace a role:
- Přihlašovací údaje: Zkontrolujte dostupné přihlašovací údaje a udržujte je aktuální.
- Tenanty: Potvrďte přístup k tenantům a zajistěte správnou izolaci dat.
- Relace: Přezkoumejte logy relací na anomálie nebo pokusy o neoprávněný přístup.
- Role: Ujistěte se, že kontroly přístupu na základě rolí jsou správně vynucovány.
- Zdroje: Ověřte dostupnost sdílených systémových zdrojů.
- Klienti: Ujistěte se, že konfigurace klientů jsou správně udržovány a aktuální.
-
Poznámka: Některé sekce mohou být omezeny na základě uživatelské role. Pokud nemáte dostatečná oprávnění, eskalujte požadavky na přístup ve své organizaci nebo kontaktujte TeskaLabs.
ASAB-IRIS - Testování šablon
- Otestujte odeslání e-mailu a zprávy na Slack prostřednictvím knihovny.
- Jakékoli problémy v této části by měly být hlášeny interně.
Monitorování zdrojů logů
Časové zóny logů
- Kde zkontrolovat: Obrazovka Objev TeskaLabs LogMan.io
- Zkontrolujte logy s
@timestampv budoucnosti (nyní+2H nebo více) - Hlášení problémů:
- Nesprávné časové zóny by měly být hlášeny interně.
- Pokud je problém způsoben nesprávnými nastaveními logovacího zařízení, hlaste to do podpůrného Slack kanálu klienta.
- Analyzujte zdroj (
host.hostname,lmio.sourcenebo IP adresa) a zahrňte to do profylaktického reportu.
Zdroje logů
- Kde zkontrolovat: Obrazovka Objev – Event Lanes, obrazovka Event lane a Baseliner
- Cíl: Zajistit, aby každý připojený zdroj logů byl aktuálně aktivní, prozkoumat všechny výpadky a anomálie v logování.
- Hlášení problémů:
- Komunikujte problémy na straně zdroje s klientem; eskalujte problémy související s LogMan.io na TeskaLabs.
Ostatní události
- Kde zkontrolovat: TeskaLabs LogMan.io - index
lmio-others-eventsna obrazovce Objev - Běžné zdroje chybových logů:
- Logy depository
- Nestrukturované logy
- Víceřádkové a fragmentované logy
- Hlášení problémů: Koordinujte s TeskaLabs, pokud jsou zjištěny chyby při analýze nebo neřešené formáty.
Systémové logy
- Kde zkontrolovat: TeskaLabs LogMan.io - Systémový tenant, index Události & Ostatní
- Hlášení problémů:
- Různé typy logů se mohou objevit zde; zaměřte se na chybové a varovné logy.
- Diskutujte o zjištěních s TeskaLabs, kde je to nutné, a informujte klienta o jakémkoli relevantním dopadu.
Baseliner
- Kde zkontrolovat: Obrazovka Baseliner TeskaLabs LogMan.io
- Zahrňte kontrolu přesměrování z obrazovky Objev na obrazovku Baseliner.
- Hlášení problémů: Pokud je Baseliner neaktivní, informujte TeskaLabs.
Monitorování Elasticsearch
- Kde zkontrolovat: Grafana, dedikovaný dashboard – Monitorování ElasticSearch a Kibana Stack
- Kontrola vzorových dat za posledních 24 hodin
- Ukazatele k monitorování:
- Neaktivní uzly → Měly by být nula
- Zdraví systému → Mělo by být zelené; okamžitě eskalujte, pokud je žluté nebo červené.
- Nepřiřazené shardy → Měly by být nula a zelené; žluté nebo nenulové vyžaduje monitorování a hlášení.
- JVM Heap → Monitorujte využití heapu, aby zůstalo pod 75 %, aby se předešlo nadměrnému garbage collection, což může zpomalit provádění dotazů. Pokud využití heapu často překračuje 85 %, zvažte zvýšení přidělené paměti nebo optimalizaci dotazů a indexování.
- Přiřazené ILM → Zkontrolujte, že politiky ILM jsou správně aplikovány na indexy, aby se zajistilo, že data jsou přesunována podle definovaných strategií uchovávání a výkonu. Nesprávně nakonfigurované ILM může vést k vyšším nákladům na úložiště a zhoršenému výkonu vyhledávání.
- Hlášení problémů: Hlášení problémů TeskaLabs, pokud je problém na úrovni platformy; jinak řešte obavy ohledně konfigurace ve svém týmu.
Přehled na systémové úrovni
- Kde zkontrolovat: Grafana, dedikovaný dashboard – Přehled na systémové úrovni
- Kontrola vzorových dat za posledních 24 hodin
- Metriky k monitorování:
- Využití disku: Nemělo by přesáhnout 80 % (kromě
/boot, který by neměl přesáhnout 95 %). - Zátěž: Neměla by přesáhnout 40 %; maximální zátěž by měla odpovídat počtu jader.
- CPU Nemělo by překročit 85 % využití po delší dobu.
- IOWait: Mělo by být pod 10 %; hodnoty nad 20 % naznačují významné zpoždění při čtení/zápisu na disk.
- Využití RAM: Nemělo by překročit 70 %; trvalé využití nad 80 % vyžaduje vyšetřování.
- Swap Měl by být minimální; časté nebo vysoké využití swapu naznačuje tlak na paměť a vyžaduje další analýzu.
- Hlášení problémů: Řešte místní problémy se zdroji ve svém infrastrukturním týmu. Pro nejasné chování systému kontaktujte TeskaLabs.
Přehled zpoždění Kafka
- Definice: Zpoždění v tomto kontextu se vztahuje na zpoždění mezi tím, kdy je zpráva vyprodukována do Kafka tématu, a kdy je zpracována příslušnou skupinou spotřebitelů. Vysoká hodnota zpoždění naznačuje, že spotřebitelé nezpracovávají zprávy dostatečně rychle, což může vést k potenciálním zpožděním zpracování dat a neefektivnostem systému.
- Kde zkontrolovat: Grafana, dedikovaný dashboard – Přehled zpoždění Kafka
- Skupiny k monitorování:
lmio parseclmio depositorlmio baselinerlmio correlator- Klíčová metrika: Hodnota zpoždění by se neměla zvyšovat v průběhu času.
- Hlášení problémů: Závažné zvýšení zpoždění by mělo být okamžitě eskalováno. Zapojte TeskaLabs, pokud neexistuje jasná cesta k řešení.
Monitorování velikosti indexů a životního cyklu
- Kde zkontrolovat: Kibana, Monitorování stacku nebo Správa stacku
- Kroky:
- Klikněte na Indexy.
- Seřaďte sloupec Dat od největšího po nejmenší.
- Prozkoumejte indexy větší než 200 GB.
- Kontrola ILM:
- Pokud index postrádá číselný suffix, není připojen k ILM.
- Zkontrolujte, zda jsou indexy správně klasifikovány jako hot/warm/cold.
- Shardování:
- Shardování by nemělo překročit 500-600 shardů na uzel, aby se předešlo nadměrnému využití zdrojů.
- Ověřte alokaci shardů napříč uzly clusteru, abyste zajistili vyvážené rozložení.
- Hlášení problémů: Pokud jsou zjištěny nadměrné růsty nebo nesprávné konfigurace ILM, koordinujte nápravu. Kontaktujte TeskaLabs, pokud jsou vyžadovány změny na úrovni aplikace.
Počítání EPS
- Definice: EPS se vztahuje na počet logových událostí přijatých za sekundu. Monitorování EPS pomáhá sledovat rychlost příjmu systému, detekovat anomálie a zajistit, aby systém mohl efektivně zvládat špičkové zatížení.
- Kde zkontrolovat: UI LogMan.io za posledních 7 dní
- Metriky k získání:
- PRŮMĚRNÁ hodnota
- MAXIMÁLNÍ hodnota
Metriky
Systémové monitorovací metriky
Když logy a události procházejí systémem TeskaLabs LogMan.io, jsou logy a události zpracovávány několika TeskaLabs mikroslužbami a také Apache Kafka, a většina nasazení ukládá data do Elasticsearch.
Protože mikroslužby a další technologie zpracovávají obrovské množství událostí, není praktické je monitorovat pomocí logů.
Místo toho sledují stav a zdraví každé mikroslužby a dalších částí vašeho systému metriky, nebo-li měření.
K metrikám můžete přistupovat v Grafana a/nebo InfluxDB s použitím přednastavených nebo vlastních vizualizací. Každá metrika každé mikroslužby se aktualizuje přibližně jednou za minutu.
Zobrazení metrik
K systémovým monitorovacím metrikám můžete přistupovat pomocí Grafana a/nebo InfluxDB prostřednictvím webové aplikace TeskaLabs LogMan.io na stránce Nástroje.
Použití Grafana pro zobrazení metrik
Přednastavené dashboardy
Deployujeme TeskaLabs LogMan.io s připravenou sadou monitorovacích a diagnostických dashboardů - podrobnosti a pokyny pro přístup zde. Tyto dashboardy vám poskytují širší přehled o tom, co se děje ve vašem systému. Doporučujeme nejprve konzultovat tyto dashboardy, pokud nevíte, které konkrétní metriky chcete zkoumat.
Použití nástroje Explore v Grafana
1. V Grafana klikněte na tlačítko (menu) a přejděte na Explore.
2. Nastavte zdroj dat na InfluxDB.
3. Použijte klikací tvůrce dotazů:
Tvůrce dotazů Grafana
FROM:
1. Measurement: Klikněte na select measurement a vyberte skupinu metrik. V tomto případě je skupina metrik bspump.pipeline.
2. Tag: Klikněte na znaménko plus vedle WHERE a vyberte tag. Protože tento příklad zobrazuje metriky z mikroslužby, je vybrán appclass::tag.
3. Tag value: Klikněte na select tag value a vyberte hodnotu. V tomto příkladu dotaz zobrazí metriky z mikroslužby Parsec.
Volitelně můžete přidat další filtry v sekci FROM, jako je pipeline a hostitel.
SELECT:
4. Fields: Přidejte pole pro přidání specifických metrik do dotazu.
5. Aggregation: Můžete si vybrat metodu agregace pro každou metriku. Uvědomte si, že Grafana nemůže zobrazit graf, ve kterém jsou některé hodnoty agregovány a jiné nejsou.
GROUP BY:
6. Fill: Můžete zvolit fill(null) nebo fill(none) pro rozhodnutí, jak vyplnit mezery mezi datovými body. fill(null) nevyplňuje mezery, takže výsledný graf bude mít datové body s mezerami mezi nimi. fill(none) spojí datové body čárou, takže je snazší vidět trendy.
4. Přizpůsobte časový rámec podle potřeby a klikněte na Run query.
Pro více informací o funkci Explore v Grafana, navštivte dokumentaci Grafana.
Použití InfluxDB pro zobrazení metrik
Pokud máte přístup k InfluxDB, můžete ji použít k prozkoumání dat. InfluxDB poskytuje tvůrce dotazů, který vám umožní filtrovat metriky, které chcete vidět, a získat vizualizace (grafy) těchto metrik.
Pro přístup k InfluxDB:
- V webové aplikaci LogMan.io přejděte na Nástroje.
- Klikněte na InfluxDB a přihlaste se.
Použití tvůrce dotazů:
Tento příklad vás provede zkoumáním metriky, která je specifická pro mikroslužbu, jako je metrika monitorování pipeline. Pokud hledáte metriku, která nezahrnuje mikroslužbu, začněte tagem _measurement, který pak filtrujte dalšími relevantními tagy.
-
V InfluxDB, v levém postranním panelu klikněte na ikonu pro přechod na Data Explorer. Nyní můžete vidět vizuální tvůrce dotazů InfluxDB.
-
V prvním boxu vyberte bucket. (Váš bucket metrik bude pravděpodobně pojmenován buď
metricsnebo podle vaší organizace.) -
V dalším filtru vyberte appclass z rozbalovacího menu, abyste viděli seznam mikroslužeb, které produkují metriky. Klikněte na mikroslužbu, ze které chcete zobrazit metriky.
-
V dalším filtru vyberte _measurement z rozbalovacího menu, abyste viděli seznam skupin metrik. Vyberte skupinu, kterou chcete vidět.
-
V dalším filtru vyberte _field z rozbalovacího menu, abyste viděli seznam dostupných metrik. Vyberte metriky, které chcete vidět.
-
Mikroslužba může mít více pipeline. Pro zúžení výsledků na konkrétní pipeline použijte další filtr. Vyberte pipeline z rozbalovacího menu a vyberte pipeline, kterou chcete reprezentovat.
- Volitelně také můžete vybrat hostitele v dalším filtru. Bez filtru InfluxDB zobrazuje data ze všech dostupných hostitelů, ale pravděpodobně máte pouze jednoho hostitele. Pro výběr hostitele zvolte host v rozbalovacím menu a vyberte hostitele.
-
Změňte časový rámec, pokud je to potřeba.
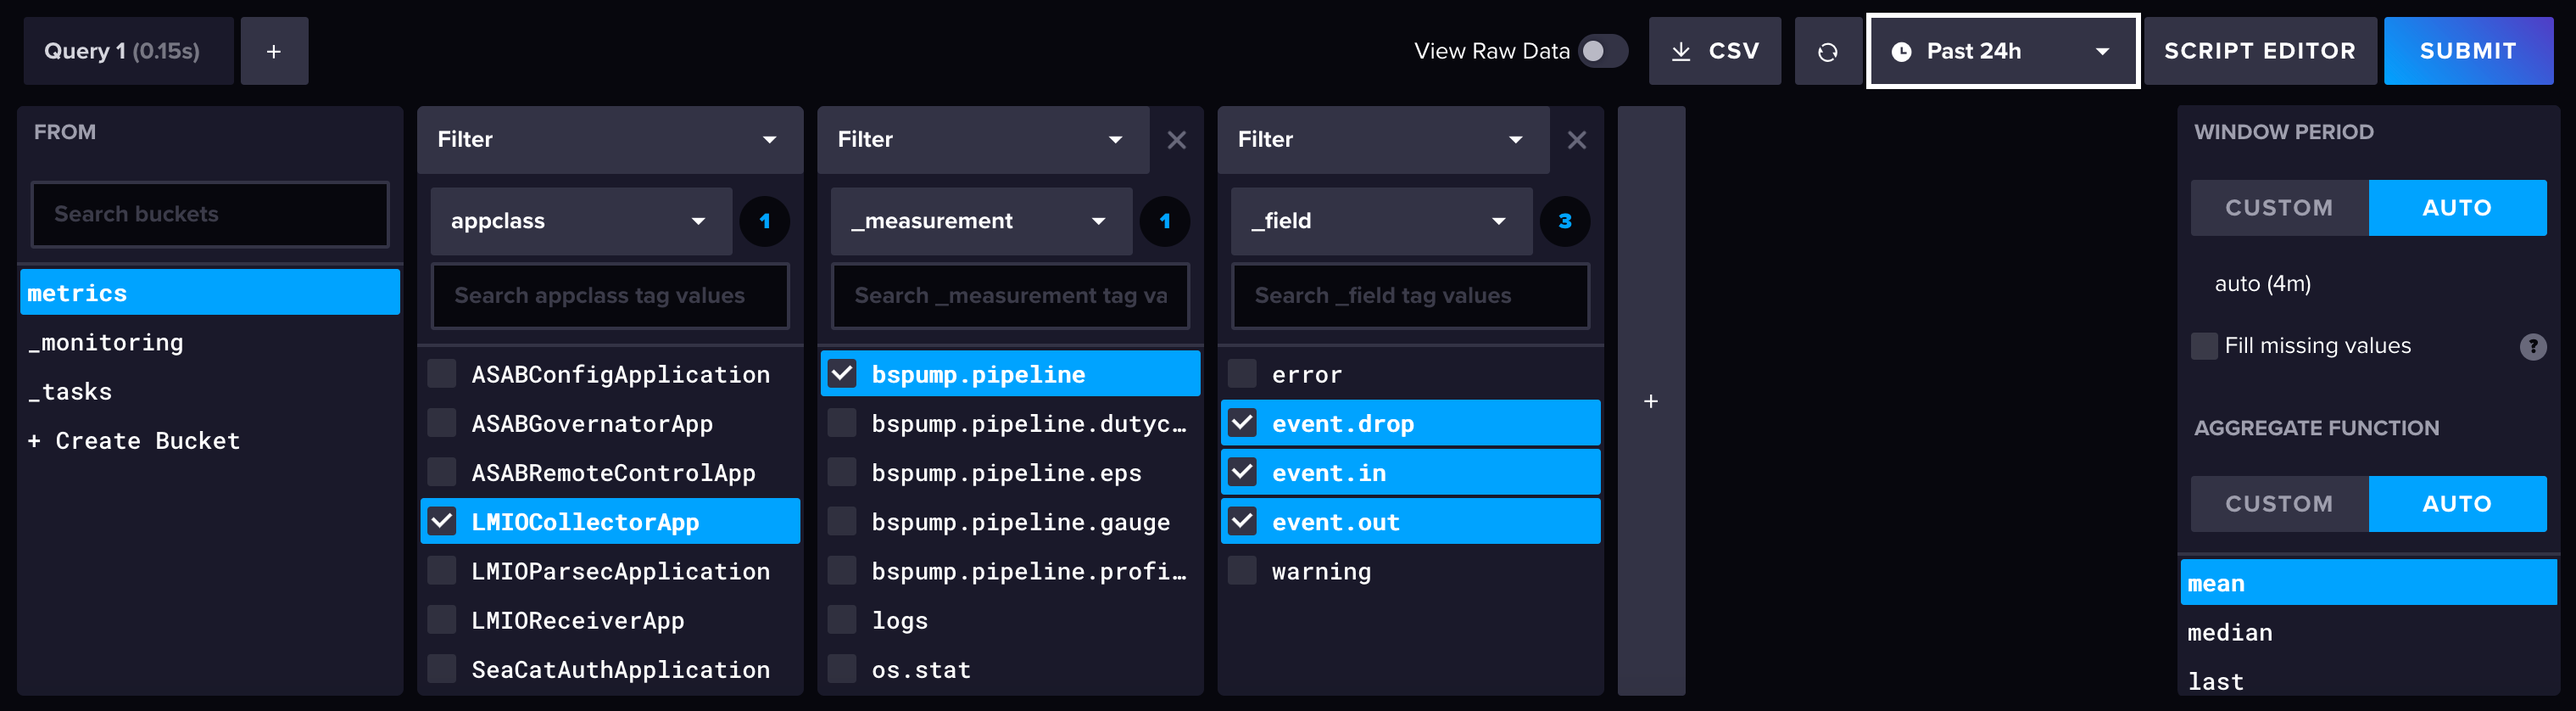
-
K načtení vizualizace klikněte na Submit.
Vizualizace vytvořená v tomto příkladě:
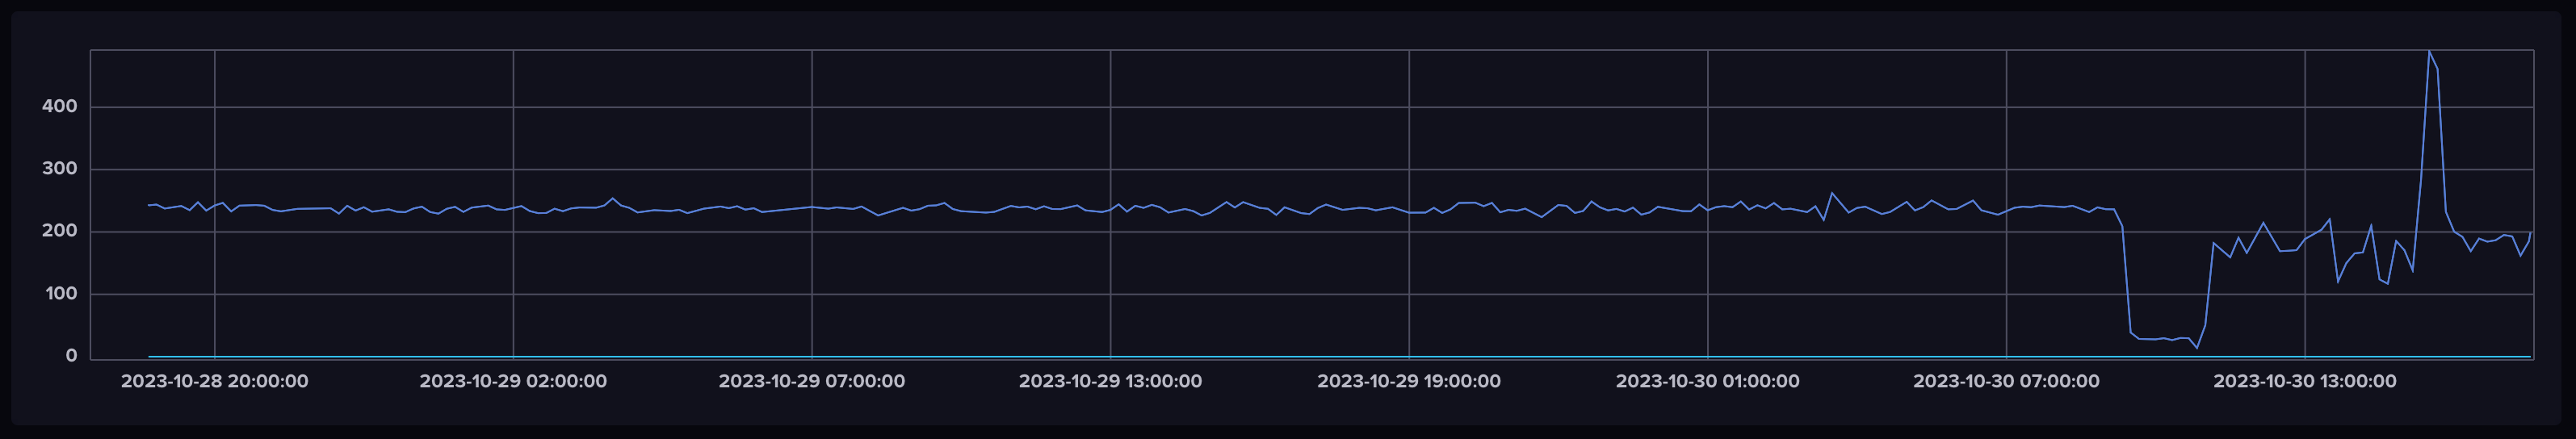
Pro více informací o funkci Data explorer v InfluxDB, navštivte dokumentaci InfluxDB.
Metriky potrubí
Metody měření pipeline, nebo měření, sledují propustnost logů a událostí v pipeleinech mikroservis. Tyto metody měření pipeline můžete použít k pochopení stavu a zdraví každé mikroservisy.
Data, která se pohybuje skrze mikroservisy, jsou rozdělena a měřena pomocí událostí. (Každá událost je jedna zpráva v Kafka a bude mít za následek jeden záznam v Elasticsearch.) Protože jsou události spočitatelné, metriky kvantifikují propustnost, což vám umožňuje posoudit stav a zdraví pipeline.
BSPump
Několik mikroslužeb TeskaLabs je postaveno na technologii BSPump, takže názvy metrik obsahují bspump.
Mikroslužby postavené na BSPumpu:
* [Collector](../../architecture/index.md#lmio-collector)
* [Ingestor](../../architecture/index.md#lmio-ingestor)
* [Parser/Parsec](../../architecture/index.md#lmio-parser)
* [Dispatcher](../../architecture/index.md#lmio-dispatcher)
* [Correlator](../../architecture/index.md#lmio-correlator)
* [Watcher](../../architecture/index.md#lmio-watcher)
* [Integrační služba](../../integ/index.md)
* Mirage
!!! tip „Architektura mikroslužeb“
Vnitřní architektura každé mikroslužby se liší a může ovlivnit vaši analýzu metrik. Navštivte naši stránku Architektura.
Mikroslužby, které pravděpodobně způsobí nerovnoměrné metriky počítadel event.in a event.out, aniž by skutečně došlo k chybě, jsou:
- Parser/Parsec - To je způsobeno jeho interní architekturou; parser posílá události do jiného pipeline (Enricher), kde události nejsou započítány v
event.out.- Correlator - Protože korelátor hodnotí události, když jsou zapojeny do vzorců, často má nižší počet
event.outneževent.in.
- Correlator - Protože korelátor hodnotí události, když jsou zapojeny do vzorců, často má nižší počet
Metriky
Pojmenování a štítky v Grafaně a InfluxDB
- Skupiny metrik pipeline jsou pod značkou
measurement. - Metriky pipeline jsou vytvářeny pro mikroservisy (značka
appclass) a mohou být dále filtrovány pomocí dalších značekhostapipeline. - Každá jednotlivá metrika (například
event.in) je hodnota ve značcefield.
Všechna měření se ve výchozím nastavení aktualizují automaticky jednou za minutu.
bspump.pipeline
event.in
Popis: Počítá počet událostí vstupujících do pipeline
Jednotka: Počet (událostí)
Interpretace: Sledování event.in v průběhu času vám může ukázat vzorce, špičky a trendy v tom, kolik událostí bylo přijato mikroservisem. Pokud žádné události nepřicházejí, event.in je čára na hodnotě 0. Pokud očekáváte průtok a event.in je 0, existuje problém v datovém kanálu.
event.out
Popis: Počítá počet událostí, které opustily potrubí úspěšně
Jednotka: Počet (událostí)
Interpretace: event.out by obvykle měl být stejný jako event.in, ale existují výjimky. Některé mikroservisy jsou konstruovány tak, aby měly buď více výstupů na jeden vstup, nebo aby přesměrovávaly data způsobem, který není tímto ukazatelem zaznamenán.
event.drop
Popis: Počítá počet událostí, které byly zahozeny, nebo zpráv, které byly ztraceny mikroservisem.
Jednotka: Počet (událostí)
Interpretace: Protože mikroservisy postavené na BSPump obecně nejsou navrženy tak, aby zahazovaly zprávy, jakékoliv zahazování je s největší pravděpodobností chybou.
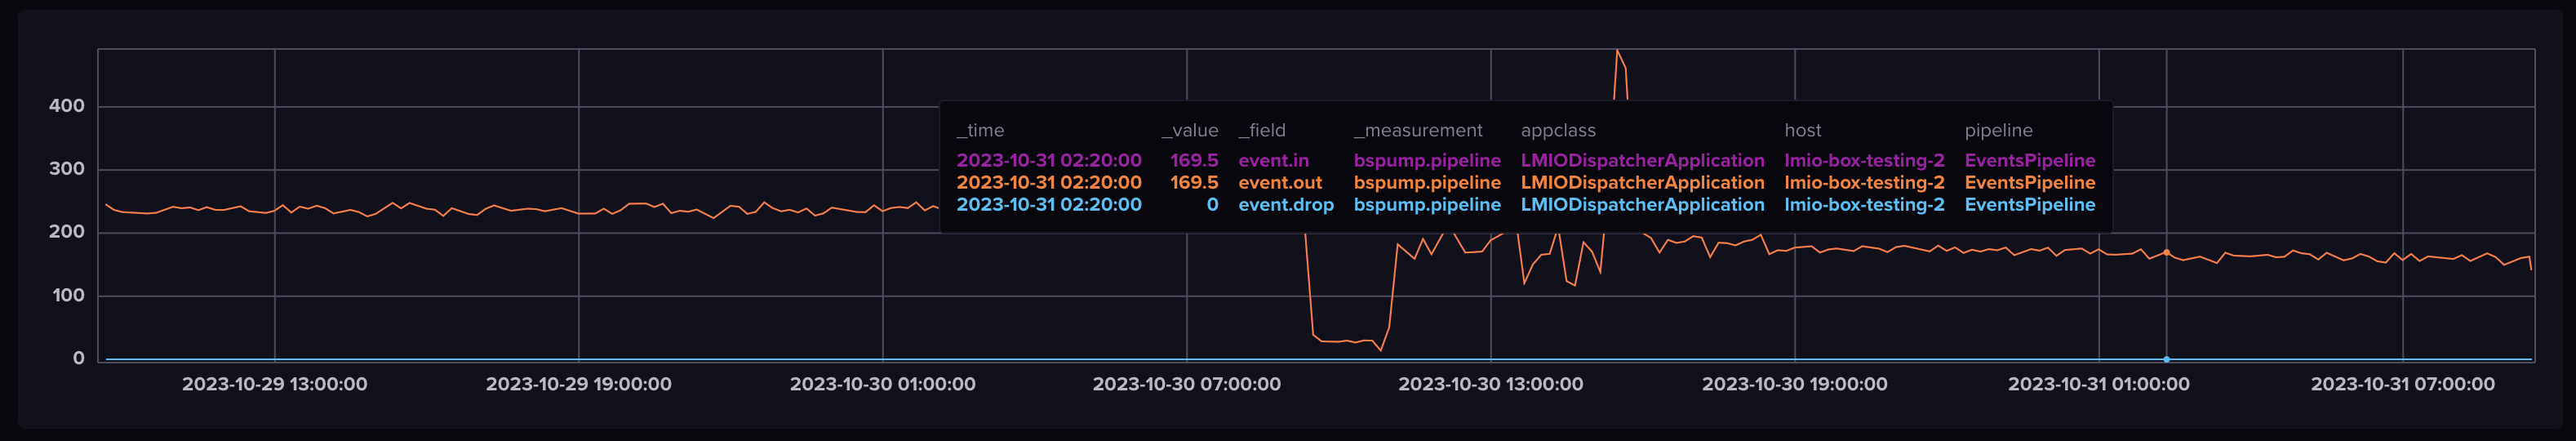 Když najedete myší na graf v InfluxDB, můžete vidět hodnoty každé linie v libovolném čase. V tomto grafu můžete vidět, že
event.out je rovno event.in a event.drop je rovno 0, což je očekávané chování mikroslužby. Stejný počet událostí opouští, kolik jich vstupuje do pipeline, a žádné události nejsou zahozeny.
varování
Popis: Počítá počet varování vzniklých v rámci pipeline.
Jednotka: Počet (varování)
Interpretace: Varování vám říká, že s daty je problém, ale pipeline je stále byla schopna zpracovat. Varování je méně závažné než chyba.
chyba
Popis: Počítá počet chyb v potrubí.
Jednotka: Počet (chyb)
Interpretace: Mikroslužby mohou vyvolat chyby z různých důvodů. Hlavním důvodem chyby je, že data neodpovídají očekávání mikroslužby a pipeline selhala při zpracování těchto dat.
bspump.pipeline.eps
EPS znamená události za sekundu.
eps.in
Popis: "Události za sekundu v" - Míra událostí úspěšně vstupujících do pipeline
Jednotka: Události za sekundu (míra)
Interpretace: eps.in by mělo zůstat konzistentní v průběhu času. Pokud se eps.in mikroslužby neočekávaně zpomaluje, může být problém v datovém potrubí před mikroslužbou.
eps.out
Popis: "Události za sekundu ven" - Míra událostí úspěšně opouštějících potrubí
Jednotka: Události za sekundu (míra)
Interpretace: Podobně jako event.in a event.out, eps.in a eps.out by měly být obvykle stejné, ale mohou se lišit v závislosti na mikroservisu. Pokud události vstupují do mikroservisu mnohem rychleji, než z něj odcházejí, a toto není očekávané chování tohoto pipeline, možná bude potřeba řešit chybu způsobující úzké hrdlo v mikroservisu.
eps.drop
Popis: "Počet událostí za sekundu, které byly zahozeny" - rychlost odhazování událostí v potrubí
Jednotka: Události za sekundu (míra)
Interpretace: Viz event.drop. Pokud eps.drop rychle roste a není to očekávané chování mikroslužby, znamená to, že jsou události vynechávány a v pipeline je problém.
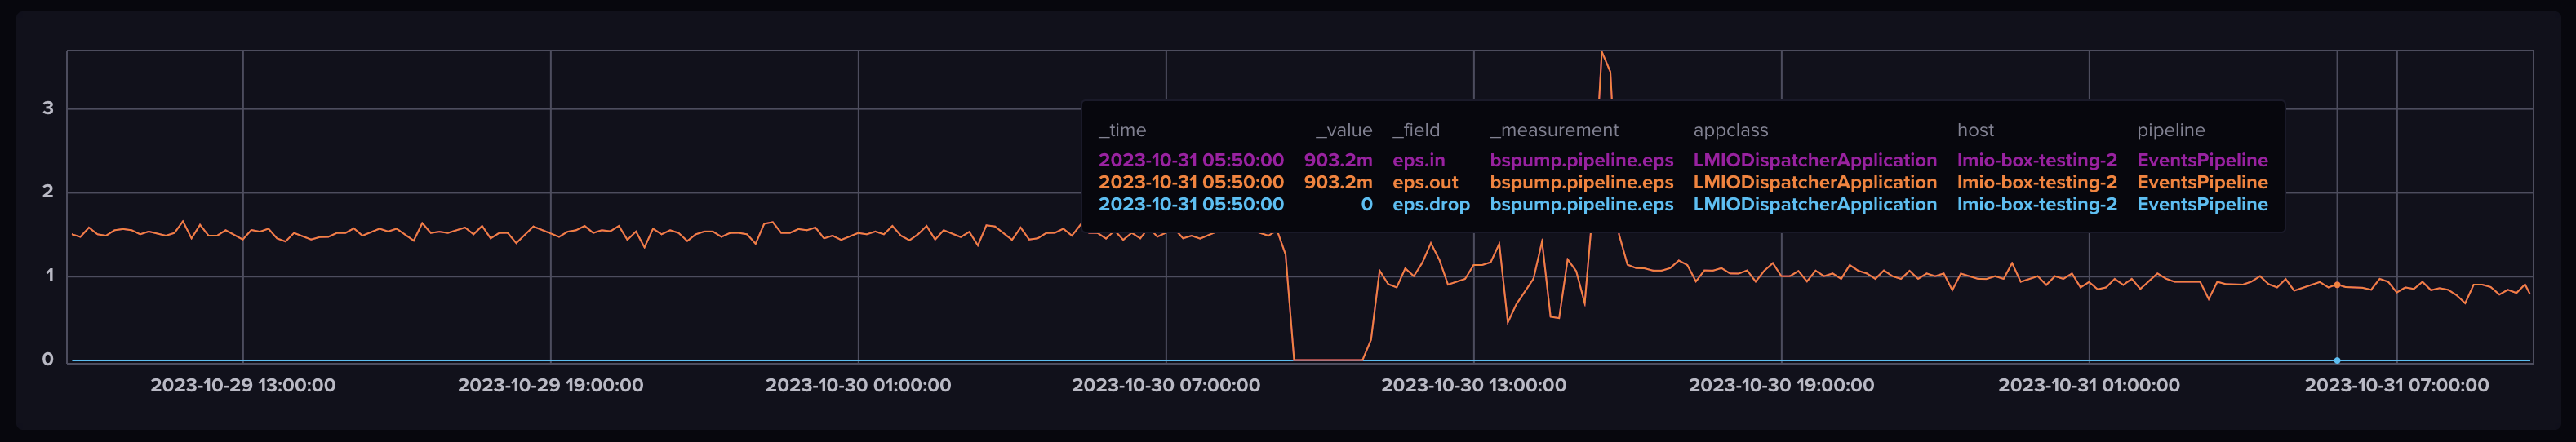 Podobně jako při grafickém znázornění
event.in a event.out, očekávané chování většiny mikroslužeb je, že eps.out bude rovno eps.in a drop bude rovno 0.
varování
Popis: Počítá počet varování vyprodukovaných v rámci pipeline ve specifikovaném časovém období.
Jednotka: Počet (varování)
Interpretace: Varování vám říká, že s daty je problém, ale pipeline je stále byla schopna zpracovat. Varování je méně závažné než chyba.
chyba
Popis: Počítá počet chyb v pipeline během určeného časového období.
Jednotka: Počet (chyb)
Interpretace: Mikroslužby mohou vyvolat chyby z různých důvodů. Hlavním důvodem chyby je, že data neodpovídají očekávání mikroslužby a pipeline selhala při zpracování těchto dat.
bspump.pipeline.gauge
Měřicí metrika, procento vyjádřené číslem od 0 do 1.
varování.poměr
Popis: Poměr událostí, které vyvolaly varování, k celkovému počtu úspěšně zpracovaných událostí.
Interpretace: Pokud se poměr varování neočekávaně zvýší, prozkoumejte potrubí kvůli problémům.
chyba.poměr
Popis: Poměr událostí, které se nepodařilo zpracovat, k celkovému počtu úspěšně zpracovaných událostí.
Interpretace: Pokud se poměr chyb neočekávaně zvýší, prozkoumejte tok zpracování dat kvůli problémům. Můžete vytvořit spouštěč, který vás upozorní, když error.ratio překročí například 5%.
bspump.pipeline.dutycycle
Pracovní cyklus (také nazývaný výkonový cyklus) popisuje, zda je potrubí připraveno přijímat zprávy (připraveno, hodnota 1) nebo není schopno zpracovávat nové zprávy (zaneprázdněno, hodnota 0).
Obecně:
- Hodnota 1 je přijatelná, protože potrubí může zpracovávat nové zprávy
- Hodnota 0 označuje problém, protože potrubí nemůže zpracovávat nové zprávy.
??? tip „Porozumění myšlence pracovní periody“
Můžeme použít lidskou produktivitu k vysvětlení konceptu pracovní periody. Pokud člověk vůbec není zaneprázdněn a nemá co dělat, jen čeká na úkol. Jeho hodnota pracovní periody je 100 % – veškerý čas tráví čekáním a může přijmout více práce. Pokud je člověk zaneprázdněn něčím a nemůže přijmout žádné další úkoly, jeho hodnota pracovní periody je 0 %.
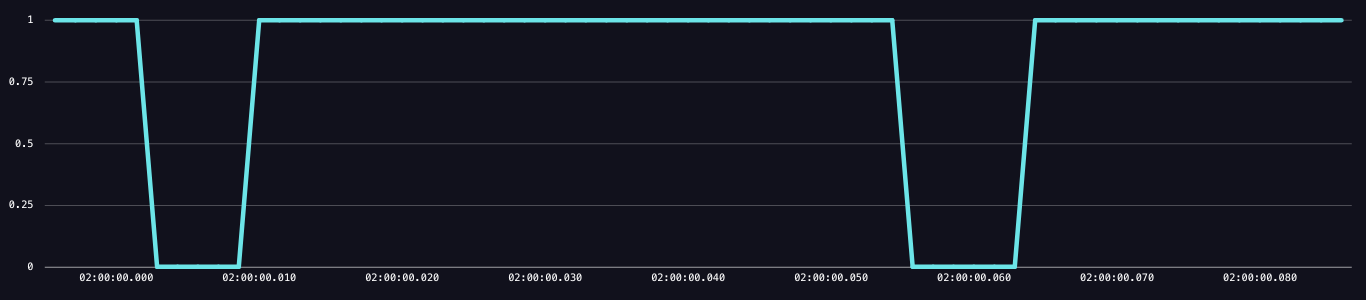 Výše uvedený příklad (nevzešel z InfluxDB) ukazuje, jak vypadá změna pracovní doby na velmi krátkém časovém měřítku. V tomto příkladu měla pipeline dvakrát stav 0, což znamená, že nebyla připravena a nemohla zpracovávat nové příchozí události. Mějte na paměti, že pracovní cyklus vašeho systému se může vybírat mezi 1 nebo 0 tisíckrát za sekundu; grafy pracovního cyklu
ready, které uvidíte v Grafaně nebo InfluxDB, budou již agregovány (více níže).
připravený
Popis: ready agreguje (průměruje) hodnoty poměru pracovní doby jednou za minutu. Zatímco poměr pracovní doby je vyjádřen jako 0 (false, pracuje) nebo 1 (true, čeká), metrika ready představuje procento času, kdy je poměr pracovní doby 0 nebo 1. Proto hodnota ready je procento mezi 0 a 1, takže graf nevypadá jako typický graf poměru pracovní doby.
Jednotka: Procento vyjádřené jako číslo, 0 až 1
Interpretace: Sledování pracovní cyklu je klíčové pro pochopení kapacity vašeho systému. Přestože je každý systém jiný, obecně by ready měla zůstat nad 70 %. Pokud ready klesne pod 70 %, znamená to, že pracovní cyklus klesl na 0 (zaneprázdněno) více než 30 % času v daném intervalu, což naznačuje, že systém je poměrně vytížený a vyžaduje nějakou pozornost nebo úpravu.
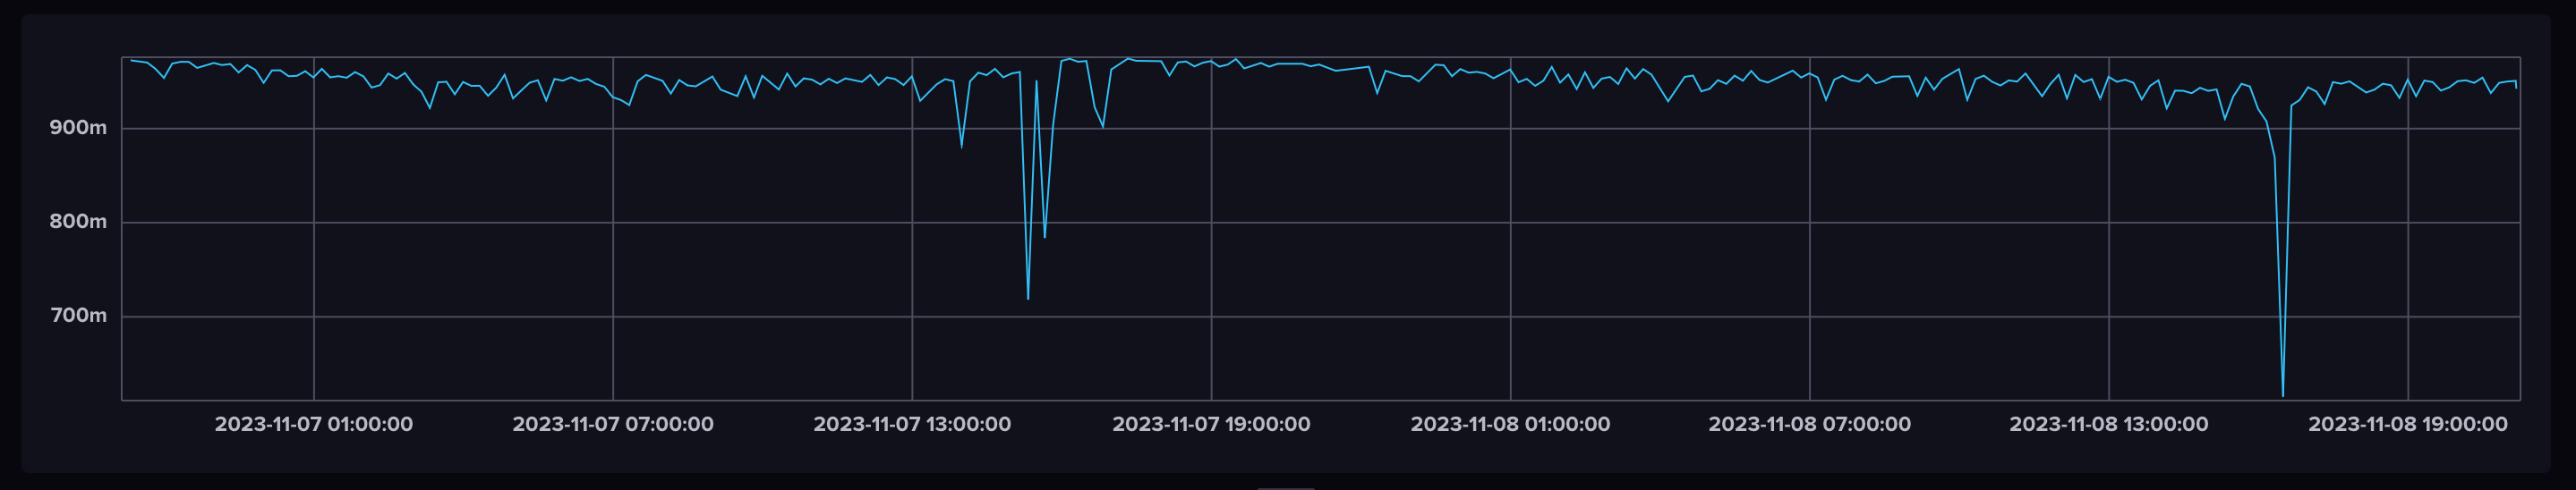 Nahoru uvedený graf ukazuje, že většinu času byl pracovní cyklus připraven více než 90 % času během těchto dvou dnů. Nicméně existují dva body, ve kterých klesl blízko a pod 70 %.
časový posun
Metrika timedrift slouží jako způsob, jak pochopit, do jaké míry se načasování původu událostí (obvykle @timestamp) liší od toho, co systém považuje za "aktuální" čas. To může být užitečné při identifikaci problémů, jako jsou zpoždění nebo nepřesnosti v mikroservisách.
Každá hodnota je ve výchozím nastavení vypočítána jednou za minutu:
průměr
medián
směrodatná odchylka
max
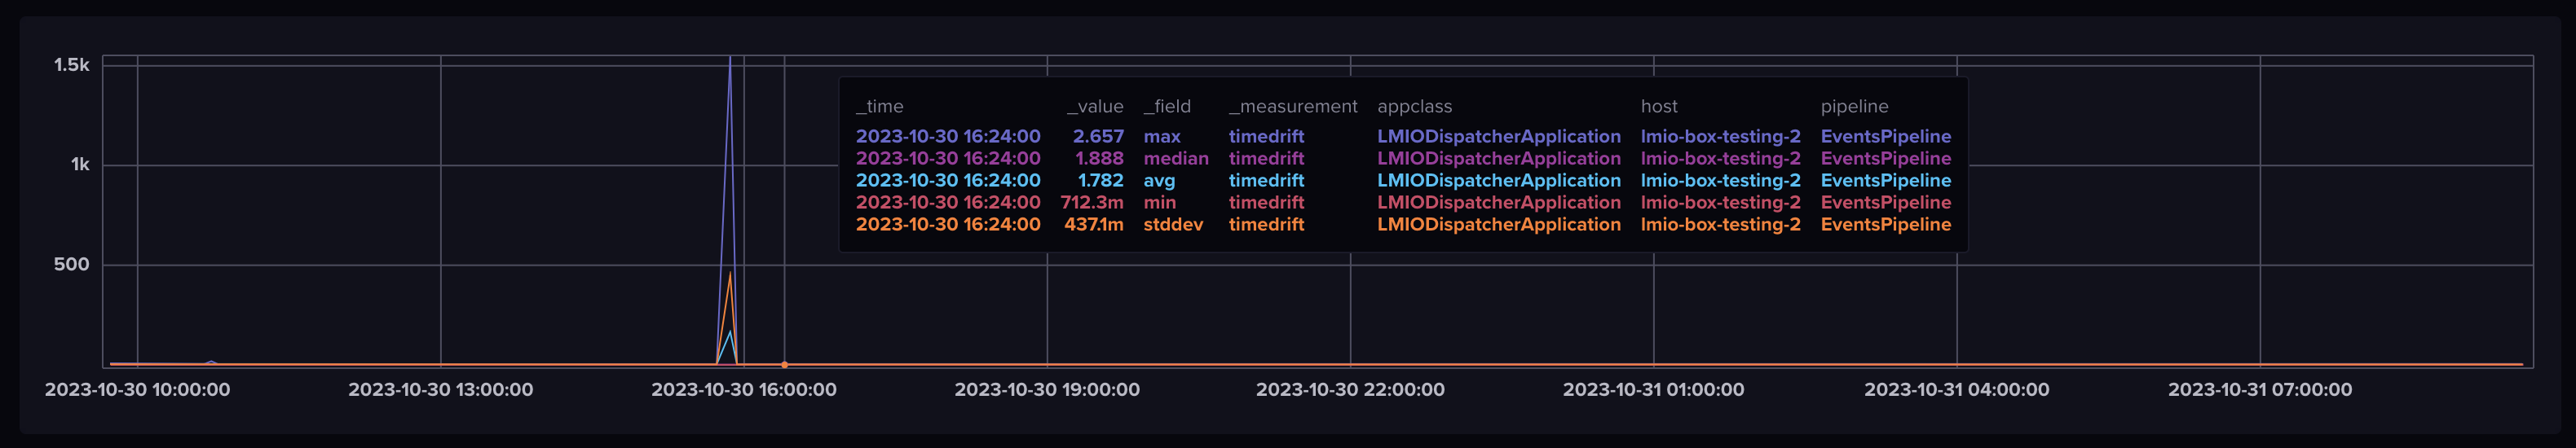 Na tomto grafu posunu času můžete vidět nárůst zpoždění, než se pipeline vrátí do normálu.
commlink
Štítky: ActivityState, appclass (pouze přijímač LogMan.io), host, identity, tenant
- bytes.in: bajty, které vstupují do přijímače LogMan.io
- event.in: události, které vstupují do přijímače LogMan.io
záznamy
Štítky: appclass, host, identity, instance_id, node_id, service_id, tenant
- kritické: Počet kritických záznamů
- chyby: Počet chybových záznamů
- varování: Počet varovných záznamů
Metriky využití disku
Monitorujte pečlivě využití disku, abyste předešli běžné příčině selhání systému.
disk
Metriky pro monitorování využití disku. Více informací naleznete v dokumentaci InfluxDB Telegraf pluginu.
Tagy: device, fstype (typ souborového systému), mode, node_id, path
- free: Celkové množství volného místa na disku, měřeno v bytech.
- inodes_free: Počet volných inode, což odpovídá počtu volných deskriptorů souborů dostupných na souborovém systému.
- inodes_total: Celkový počet inode nebo deskriptorů souborů, které souborový systém podporuje.
- inodes_used: Počet inode nebo deskriptorů souborů aktuálně používaných na souborovém systému.
- total: Celková kapacita disku nebo úložného zařízení, měřeno v bytech.
- used: Množství disku aktuálně používaného, měřeno v bytech.
- used_percent: Procento diskového prostoru, které je aktuálně používáno v poměru k celkové kapacitě.
diskio
Metriky pro monitorování diskového provozu a časování. Konzultujte dokumentaci InfluxDB Telegraf pluginu pro definici každé metriky.
Tagy: name, node_id, wwid
- io_time
- iops_in_progress
- merged_reads
- merged_writes
- read_bytes
- read_time
- reads
- weighted_io_time
- write_bytes
- write_time
- writes
Metriky výkonu systému
cpu
Metriky pro sledování CPU systému. Viz dokumentace InfluxDB Telegraf pluginu pro více informací.
Tagy: ActivityState, cpu, node_id
- time_active: Celkový čas, kdy byl CPU aktivní, vykonával úlohy kromě nečinnosti.
- time_guest: Čas strávený během virtuálního CPU pro hostované operační systémy.
- time_guest_nice: Čas, který CPU strávil běžícím niced guestem (guest s pozitivní hodnotou nices).
- time_idle: Celkový čas, kdy CPU nebyl používán (nečinný).
- time_iowait: Čas, kdy byl CPU nečinný a čekal na dokončení I/O operací.
- time_irq: Čas strávený řešením hardwarových přerušení.
- time_nice: Čas, který CPU strávil zpracováním uživatelských procesů s pozitivní hodnotou nices.
- time_softirq: Čas strávený řešením softwarových přerušení.
- time_steal: Čas, který virtuální CPU čekal na skutečný CPU, zatímco hypervisor servisoval jiný virtuální procesor.
- time_system: Čas, který CPU strávil běžícím systémovými (jádrovými) procesy.
- time_user: Čas strávený vykonáváním uživatelských procesů.
- usage_active: Procento času, kdy byl CPU aktivní, vykonával úlohy.
- usage_guest: Procento času CPU stráveného během virtuálních CPU pro hostované operační systémy.
- usage_guest_nice: Procento času CPU stráveného během niced guestů.
- usage_idle: Procento času, kdy byl CPU nečinný.
- usage_iowait: Procento času, kdy byl CPU nečinný z důvodu čekání na I/O operace.
- usage_irq: Procento času stráveného řešením hardwarových přerušení.
- usage_nice: Procento času CPU stráveného procesy s pozitivní hodnotou nices.
- usage_softirq: Procento času stráveného řešením softwarových přerušení.
- usage_steal: Procento času, kdy virtuální CPU čekal na skutečný CPU, zatímco hypervisor servisoval jiný procesor.
- usage_system: Procento času CPU stráveného na systémových (jádrových) procesech.
- usage_user: Procento času CPU stráveného vykonáváním uživatelských procesů.
mdstat
Statistiky o Linux MD RAID polích nakonfigurovaných na hostiteli. RAID (redundant array of inexpensive or independent disks) kombinuje více fyzických disků do jedné jednotky za účelem datové redundance (a tím bezpečnosti nebo ochrany před ztrátou v případě selhání disku) a výkonu systému (rychlejší přístup k datům). Navštivte dokumentaci InfluxDB Telegraf pluginu pro více informací.
Tagy: ActivityState (aktivní nebo neaktivní), Devices, Name, _field, node_id
- BlocksSynced: Počet bloků, které byly prohledány, pokud se pole obnovuje/kontroluje.
- BlocksSyncedFinishTime: Minuty zbývající do očekávaného dokončení obnovy skenování.
- BlocksSyncedPct: Procento zbývající obnovy skenování.
- BlocksSyncedSpeed: Aktuální rychlost, jakou probíhá obnovování, uvedená v K/sec.
- BlocksTotal: Celkový počet bloků v poli.
- DisksActive: Počet disků v poli, které jsou považovány za zdravé.
- DisksDown: Počet disků v poli, které jsou aktuálně nefunkční, nebo neoperativní.
- DisksFailed: Počet aktuálně selhaných disků v poli.
- DisksSpare: Počet náhradních disků v poli.
- DisksTotal: Celkový počet disků v poli.
processes
Všechny procesy, seskupené podle stavu. Najděte dokumentaci InfluxDB Telegraf pluginu zde.
Tagy: node_id
- blocked: Počet procesů ve zablokovaném stavu, čekající na zdroj nebo událost, která by se stala dostupnou.
- dead: Počet procesů, které dokončily exekuci, ale stále mají záznam v tabulce procesů.
- idle: Počet procesů ve stavu nečinnosti, obvykle znamenající, že aktivně nepracují.
- paging: Počet procesů, které čekají na stránkování, buď na swapování dovnitř nebo ven z disku.
- running: Počet procesů, které aktuálně pracují nebo jsou připraveny k vykonávání.
- sleeping: Počet procesů, které jsou ve spánkovém stavu, nečinné do chvíle, dokud nejsou splněny určité podmínky nebo nenastanou události.
- stopped: Počet procesů, které jsou zastaveny, obvykle kvůli přijmu signálu nebo debugování.
- total: Celkový počet procesů aktuálně existujících v systému.
- total_threads: Celkový počet vláken napříč všemi procesy, protože procesy mohou mít více vláken.
- unknown: Počet procesů v neznámém stavu, kde jejich stav nelze určit.
- zombies: Počet zombie procesů, které dokončily vykonání, ale stále mají záznam v tabulce procesů, protože nadřazený proces nečetl jejich exit status.
system
Tyto metriky poskytují obecné informace o systémovém zatížení, době provozu a počtu přihlášených uživatelů. Navštivte InfluxDB Telegraf plugin pro detaily.
Tagy: node_id
- load1: Průměrné systémové zatížení za poslední jednu minutu, indikující počet procesů v čekacím řetězci systému.
- load15: Průměrné systémové zatížení za posledních 15 minut, čímž poskytuje dlouhodobější pohled na nedávné systémové zatížení.
- load5: Průměrné systémové zatížení za posledních 5 minut, což nabízí krátkodobější perspektivu nedávného systémového zatížení.
- n_cpus: Počet dostupných jader CPU v systému.
- uptime: Celkový čas v sekundách, po který systém běžel od posledního spuštění nebo restartu.
temp
Odečty teplot zaznamenané senzory systému. Navštivte dokumentaci InfluxDB Telegraf pluginu pro detaily.
Tagy: node_id, sensor
- temp: Teplota
Specifické metriky sítě
net
Metriky pro použití síťového rozhraní a protokolů u Linuxových systémů. Monitorování objemu přenosu dat a možných chyb je důležité pro pochopení zdraví a výkonu sítě. Navštivte dokumentaci pluginu InfluxDB Telegraf pro podrobnosti.
Tagy: interface, node_id
bytes pole: Monitorování objemu přenosu dat, které je důležité pro správu šířky pásma a plánování kapacity sítě.
- bytes_recv: Celkový počet bajtů přijatých rozhraním
- bytes_sent: Celkový počet bajtů odeslaných rozhraním
drop pole: Zahozené pakety jsou často znakem síťového přetížení, hardwarových problémů nebo nesprávných konfigurací. Zahozené pakety mohou vést ke snížení výkonu.
- drop_in: Celkový počet přijatých paketů zahozených rozhraním
- drop_out: Celkový počet odeslaných paketů zahozených rozhraním
error pole: Vysoké míry chyb mohou signalizovat problémy s hardwarem sítě, interferencí nebo problémy s konfigurací.
- err_in: Celkový počet detekovaných chyb při příjmu rozhraním
- err_out: Celkový počet detekovaných chyb při odesílání rozhraním
packet pole: Počet odeslaných a přijatých paketů poskytuje indikaci provozu v síti a může pomoci identifikovat, zda je síť přetížena nebo zda existují problémy s přenosem paketů.
- packets_recv: Celkový počet paketů odeslaných rozhraním
- packets_sent: Celkový počet paketů přijatých rozhraním
nstat
Metriky sítě. Navštivte dokumentaci pluginu InfluxDB Telegraf pro další informace.
Tagy: name, node_id
ICMP pole
Metriky ICMP (internet control message protocol) se používají pro síťovou diagnostiku a kontrolní zprávy, jako například hlášení chyb a provozní dotazy. Navštivte tuto stránku pro další definice polí.
Klíčové pojmy:
- Echo requests/replies (ping): Používá se k testování dostupnosti a doby kolce (round-trip time).
- Destination unreachable: Indikuje, že daný cíl není dostupný.
- Parameter problems: Signalizuje problémy s parametry IP hlavičky.
- Redirect messages: Instrukce k použití jiného směru (route).
- Time exceeded messages: Indikuje, že čas k životu (TTL) pro paket vypršel.
IP pole
Metriky IP (internet protocol) monitorují hlavní protokol pro směrování paketů napříč internetem a lokálními sítěmi.
Navštivte tuto stránku pro další definice polí.
Klíčové pojmy:
- Address errors: Chyby spojené s nesprávnými nebo nedostupnými IP adresami.
- Header errors: Problémy v IP hlavičce, jako nesprávné kontrolní součty nebo chyby formátování.
- Delivered packets: Pakety úspěšně doručené na jejich cílové místo.
- Discarded packets: Pakety zahozené kvůli chybám nebo nedostatku prostoru v bufferu.
- Forwarded datagrams: Pakety směrované na jejich další skok směrem k cíli.
- Reassembly failures: Selhání při znovuskládání fragmentovaných IP paketů.
- IPv6 multicast/broadcast packets: Pakety zaslané více cílům nebo všem uzlům v segmentu sítě v IPv6.
TCP pole
Tyto metriky monitorují TCP, nebo transmission control protocol, který poskytuje spolehlivý, uspořádaný a chybově kontrolovaný přenos dat mezi aplikacemi. Navštivte tuto stránku pro další definice polí.
Klíčové pojmy:
- Connection opens: Zahájení nové TCP spojení.
- Segments: Jednotky přenosu dat v TCP.
- Reset segments (RST): Používá se k náhlému ukončení spojení.
- Retransmissions: Opětovné odesílání dat, která nebyla úspěšně přijata.
- Active/passive connection openings: Spojení zahájená aktivně (odchozí) nebo pasivně (příchozí).
- Checksum errors: Chyby zjištěné v kontrolním součtu segmentu TCP.
- Timeout retransmissions: Opětovné odesílání dat po časovém limitu, což indikuje možnou ztrátu paketů.
UDP pole
Tyto metriky monitorují UDP, nebo user datagram protocol, který umožňuje nízkolatenční (nízké zpoždění) ale méně spolehlivý přenos dat v porovnání s TCP. Navštivte tuto stránku pro další definice polí.
- Datagrams: Základní jednotky přenosu v UDP.
- Receive/send buffer errors: Chyby kvůli nedostatečnému prostoru v bufferu pro příchozí/odchozí data.
- No ports: Datagramy zaslané na port bez posluchače.
- Checksum errors: Chyby v poli pro kontrolní součet UDP datagramů.
Všechna pole nstat
- Icmp6InCsumErrors
- Icmp6InDestUnreachs
- Icmp6InEchoReplies
- Icmp6InEchos
- Icmp6InErrors
- Icmp6InGroupMembQueries
- Icmp6InGroupMembReductions
- Icmp6InGroupMembResponses
- Icmp6InMLDv2Reports
- Icmp6InMsgs
- Icmp6InNeighborAdvertisements
- Icmp6InNeighborSolicits
- Icmp6InParmProblems
- Icmp6InPktTooBigs
- Icmp6InRedirects
- Icmp6InRouterAdvertisements
- Icmp6InRouterSolicits
- Icmp6InTimeExcds
- Icmp6OutDestUnreachs
- Icmp6OutEchoReplies
- Icmp6OutEchos
- Icmp6OutErrors
- Icmp6OutGroupMembQueries
- Icmp6OutGroupMembReductions
- Icmp6OutGroupMembResponses
- Icmp6OutMLDv2Reports
- Icmp6OutMsgs
- Icmp6OutNeighborAdvertisements
- Icmp6OutNeighborSolicits
- Icmp6OutParmProblems
- Icmp6OutPktTooBigs
- Icmp6OutRedirects
- Icmp6OutRouterAdvertisements
- Icmp6OutRouterSolicits
- Icmp6OutTimeExcds
- Icmp6OutType133
- Icmp6OutType135
- Icmp6OutType143
- IcmpInAddrMaskReps
- IcmpInAddrMasks
- IcmpInCsumErrors
- IcmpInDestUnreachs
- IcmpInEchoReps
- IcmpInEchos
- IcmpInErrors
- IcmpInMsgs
- IcmpInParmProbs
- IcmpInRedirects
- IcmpInSrcQuenchs
- IcmpInTimeExcds
- IcmpInTimestampReps
- IcmpInTimestamps
- IcmpMsgInType3
- IcmpMsgOutType3
- IcmpOutAddrMaskReps
- IcmpOutAddrMasks
- IcmpOutDestUnreachs
- IcmpOutEchoReps
- IcmpOutEchos
- IcmpOutErrors
- IcmpOutMsgs
- IcmpOutParmProbs
- IcmpOutRedirects
- IcmpOutSrcQuenchs
- IcmpOutTimeExcds
- IcmpOutTimestampReps
- IcmpOutTimestamps
- Ip6FragCreates
- Ip6FragFails
- Ip6FragOKs
- Ip6InAddrErrors
- Ip6InBcastOctets
- Ip6InCEPkts
- Ip6InDelivers
- Ip6InDiscards
- Ip6InECT0Pkts
- Ip6InECT1Pkts
- Ip6InHdrErrors
- Ip6InMcastOctets
- Ip6InMcastPkts
- Ip6InNoECTPkts
- Ip6InNoRoutes
- Ip6InOctets
- Ip6InReceives
- Ip6InTooBigErrors
- Ip6InTruncatedPkts
- Ip6InUnknownProtos
- Ip6OutBcastOctets
- Ip6OutDiscards
- Ip6OutForwDatagrams
- Ip6OutMcastOctets
- Ip6OutMcastPkts
- Ip6OutNoRoutes
- Ip6OutOctets
- Ip6OutRequests
- Ip6ReasmFails
- Ip6ReasmOKs
- Ip6ReasmReqds
- Ip6ReasmTimeout
- IpDefaultTTL
- IpExtInBcastOctets
- IpExtInBcastPkts
- IpExtInCEPkts
- IpExtInCsumErrors
- IpExtInECT0Pkts
- IpExtInECT1Pkts
- IpExtInMcastOctets
- IpExtInMcastPkts
- IpExtInNoECTPkts
- IpExtInNoRoutes
- IpExtInOctets
- IpExtInTruncatedPkts
- IpExtOutBcastOctets
- IpExtOutBcastPkts
- IpExtOutMcastOctets
- IpExtOutMcastPkts
- IpExtOutOctets
- IpForwDatagrams
- IpForwarding
- IpFragCreates
- IpFragFails
- IpFragOKs
- IpInAddrErrors
- IpInDelivers
- IpInDiscards
- IpInHdrErrors
- IpInReceives
- IpInUnknownProtos
- IpOutDiscards
- IpOutNoRoutes
- IpOutRequests
- IpReasmFails
- IpReasmOKs
- IpReasmReqds
- IpReasmTimeout
- TcpActiveOpens
- TcpAttemptFails
- TcpCurrEstab
- TcpEstabResets
- TcpExtArpFilter
- TcpExtBusyPollRxPackets
- TcpExtDelayedACKLocked
- TcpExtDelayedACKLost
- TcpExtDelayedACKs
- TcpExtEmbryonicRsts
- TcpExtIPReversePathFilter
- TcpExtListenDrops
- TcpExtListenOverflows
- TcpExtLockDroppedIcmps
- TcpExtOfoPruned
- TcpExtOutOfWindowIcmps
- TcpExtPAWSActive
- TcpExtPAWSEstab
- TcpExtPAWSPassive
- TcpExtPruneCalled
- TcpExtRcvPruned
- TcpExtSyncookiesFailed
- TcpExtSyncookiesRecv
- TcpExtSyncookiesSent
- TcpExtTCPACKSkippedChallenge
- TcpExtTCPACKSkippedFinWait2
- TcpExtTCPACKSkippedPAWS
- TcpExtTCPACKSkippedSeq
- TcpExtTCPACKSkippedSynRecv
- TcpExtTCPACKSkippedTimeWait
- TcpExtTCPAbortFailed
- TcpExtTCPAbortOnClose
- TcpExtTCPAbortOnData
- TcpExtTCPAbortOnLinger
- TcpExtTCPAbortOnMemory
- TcpExtTCPAbortOnTimeout
- TcpExtTCPAutoCorking
- TcpExtTCPBacklogDrop
- TcpExtTCPChallengeACK
- TcpExtTCPDSACKIgnoredNoUndo
- TcpExtTCPDSACKIgnoredOld
- TcpExtTCPDSACKOfoRecv
- TcpExtTCPDSACKOfoSent
- TcpExtTCPDSACKOldSent
- TcpExtTCPDSACKRecv
- TcpExtTCPDSACKUndo
- TcpExtTCPDeferAcceptDrop
- TcpExtTCPDirectCopyFromBacklog
- TcpExtTCPDirectCopyFromPrequeue
- TcpExtTCPFACKReorder
- TcpExtTCPFastOpenActive
- TcpExtTCPFastOpenActiveFail
- TcpExtTCPFastOpenCookieReqd
- TcpExtTCPFastOpenListenOverflow
- TcpExtTCPFastOpenPassive
- TcpExtTCPFastOpenPassiveFail
- TcpExtTCPFastRetrans
- TcpExtTCPForwardRetrans
- TcpExtTCPFromZeroWindowAdv
- TcpExtTCPFullUndo
- TcpExtTCPHPAcks
- TcpExtTCPHPHits
- TcpExtTCPHPHitsToUser
- TcpExtTCPHystartDelayCwnd
- TcpExtTCPHystartDelayDetect
- TcpExtTCPHystartTrainCwnd
- TcpExtTCPHystartTrainDetect
- TcpExtTCPKeepAlive
- TcpExtTCPLossFailures
- TcpExtTCPLossProbeRecovery
- TcpExtTCPLossProbes
- TcpExtTCPLossUndo
- TcpExtTCPLostRetransmit
- TcpExtTCPMD5NotFound
- TcpExtTCPMD5Unexpected
- TcpExtTCPMTUPFail
- TcpExtTCPMTUPSuccess
- TcpExtTCPMemoryPressures
- TcpExtTCPMinTTLDrop
- TcpExtTCPOFODrop
- TcpExtTCPOFOMerge
- TcpExtTCPOFOQueue
- TcpExtTCPOrigDataSent
- TcpExtTCPPartialUndo
- TcpExtTCPPrequeueDropped
- TcpExtTCPPrequeued
- TcpExtTCPPureAcks
- TcpExtTCPRcvCoalesce
- TcpExtTCPRcvCollapsed
- TcpExtTCPRenoFailures
- TcpExtTCPRenoRecovery
- TcpExtTCPRenoRecoveryFail
- TcpExtTCPRenoReorder
- TcpExtTCPReqQFullDoCookies
- TcpExtTCPReqQFullDrop
- TcpExtTCPRetransFail
- TcpExtTCPSACKDiscard
- TcpExtTCPSACKReneging
- TcpExtTCPSACKReorder
- TcpExtTCPSYNChallenge
- TcpExtTCPSackFailures
- TcpExtTCPSackMerged
- TcpExtTCPSackRecovery
- TcpExtTCPSackRecoveryFail
- TcpExtTCPSackShiftFallback
- TcpExtTCPSackShifted
- TcpExtTCPSchedulerFailed
- TcpExtTCPSlowStartRetrans
- TcpExtTCPSpuriousRTOs
- TcpExtTCPSpuriousRtxHostQueues
- TcpExtTCPSynRetrans
- **TcpExtTCPTSRe
Metriky specifické pro autorizaci
TeskaLabs SeaCat Auth (jak je uvedeno v tagu appclass) zajišťuje veškerou autorizaci v LogMan.io, včetně přihlašovacích údajů, přihlášení a relací.
credentials
Tagy: appclass (pouze SeaCat Auth), host, instance_id, node_id, service_id
- default: Počet přihlašovacích údajů (uživatelských účtů) ve vašem nasazení TeskaLabs LogMan.io.
logins
Počet neúspěšných a úspěšných přihlášení přes TeskaLabs SeaCat Auth.
Tagy: appclass (pouze SeaCat Auth), host, instance_id, node_id, service_id
- failed: Počítá neúspěšné pokusy o přihlášení. Informuje v okamžiku přihlášení.
- successful: Počítá úspěšná přihlášení. Informuje v okamžiku přihlášení.
sessions
Relace začíná, když se uživatel přihlásí do LogMan.io, a metrika sessions počítá otevřené relace.
Tagy: appclass (pouze SeaCat Auth), host, instance_id, node_id, service_id
- sessions: Počet otevřených relací v daném okamžiku
Metriky paměti
Sledováním metrik využití paměti můžete pochopit, jak jsou paměťové prostředky využívány. To vám může poskytnout poznatky o oblastech, které mohou potřebovat optimalizaci nebo úpravu.
memory a os.stat
Tagy: appclass, host, identity, instance_id, node_id, service_id, tenant
VmPeak
Význam: Vrcholová velikost virtuální paměti. Toto je vrcholová nebo aktuální celková velikost virtuální paměti používané mikroslužbou. Virtuální paměť zahrnuje jak fyzickou RAM, tak diskový swap prostor (součet všech oblastí virtuální paměti zapojených do procesu).
Interpretace: Sledování vrcholu může pomoci identifikovat, zda služba nepoužívá více paměti, než se očekávalo, což může naznačovat únik paměti nebo potřebu optimalizace.
VmLck
Význam: Velikost uzamčené paměti. To označuje část paměti, která je uzamčena v RAM a nemůže být swapována na disk.
Interpretace: Vysoké množství uzamčené paměti může potenciálně snížit flexibilitu systému v řízení paměti, což může vést k problémům s výkonem.
VmPin
Význam: Velikost připnuté paměti. Toto je část paměti, která je "připnuta" na místě; fyzická lokalizace paměťové stránky v rámci RAM nemůže být automaticky změněna nebo swapována na disk.
Interpretace: Stejně jako uzamčená paměť, připnutá paměť nemůže být přesunuta, takže vysoká hodnota může také omezit flexibilitu systému.
VmHWM
Význam: Maximální velikost rezidentní sady ("high water mark"). Toto je maximální množství fyzické RAM, které mikroslužba použila.
Interpretace: Pokud je tato hodnota konzistentně vysoká, může to naznačovat, že služba potřebuje optimalizaci nebo že potřebujete přidělit více fyzické RAM.
VmRSS
Význam: Velikost rezidentní sady. To ukazuje část paměti mikroslužby, která je držena v RAM.
Interpretace: Vysoká hodnota RSS by mohla znamenat, že vaše služba používá hodně RAM, což by mohlo vést k problémům s výkonem, pokud začne používat swap.
VmData, VmStk, VmExe
Význam: Velikost segmentů dat, zásobníku a textu. Tyto hodnoty představují velikosti různých paměťových segmentů: data, zásobník a spustitelný kód.
Interpretace: Sledování těchto hodnot vám může pomoci pochopit paměťovou stopu vaší služby a může být užitečné při ladění nebo optimalizaci vašeho kódu.
VmLib
Význam: Velikost sdíleného knihovního kódu. Toto zahrnuje spustitelné stránky s odečteným VmExe a ukazuje množství paměti používané sdílenými knihovnami v procesu.
Interpretace: Pokud je toto vysoké, možná budete chtít ověřit, zda jsou všechny knihovny potřebné, protože přidávají k paměťové stopě.
VmPTE
Význam: Velikost položek stránkovací tabulky. To označuje velikost stránkovací tabulky, která mapuje virtuální paměť na fyzickou paměť.
Interpretace: Velká velikost může znamenat, že je používáno hodně paměti, což může být problém, pokud se příliš zvětšuje.
VmSize
Význam: Velikost dvouúrovňových stránkovacích tabulek. Toto je rozšíření VmPTE, které označuje velikost dvouúrovňových stránkovacích tabulek.
Interpretace: Stejně jako VmPTE pomáhá sledování této velikosti v identifikování potenciálních problémů s pamětí.
VmSwap
Význam: Velikost swapované virtuální paměti. To označuje množství virtuální paměti, která byla swapována na disk. shmem swap není zahrnut.
Interpretace: Časté swapování je obecně špatné pro výkon; pokud je tento metr vysoký, budete možná potřebovat přidělit více RAM nebo optimalizovat své služby.
mem
Další měření týkající se paměti. Navštivte dokumentaci pluginu InfluxDB Telegraf pro podrobnosti.
-
Tagy:
node_id -
active: Paměť aktuálně v použití nebo nedávno použitá, a tedy ne okamžitě k dispozici pro vysazení.
- available: Množství paměti, která je okamžitě k dispozici pro nové procesy bez swapování.
- available_percent: Procento celkové paměti, která je okamžitě k dispozici pro nové procesy.
- buffered: Paměť použitá jádrem pro věci jako metadata systému souborů, odlišná od cache.
- cached: Paměť použitá k ukládání nedávno použitých dat pro rychlý přístup, není okamžitě uvolněna, když ji procesy přestanou vyžadovat.
- commit_limit: Celkové množství paměti, které lze přidělit procesům, včetně RAM i swap prostoru.
- committed_as: Celkové množství paměti aktuálně přidělené procesy, i když není použita.
- dirty: Paměťové stránky, které byly modifikovány, ale ještě nebyly zapsány do svého datového umístění v úložišti.
- free: Množství paměti, které je aktuálně neobsazeno a k dispozici k použití.
- high_free: Množství volné paměti v oblasti vysoké paměti systému (paměť mimo přímý přístup jádra).
- high_total: Celkové množství systémové paměti v oblasti vysoké paměti.
- huge_page_size: Velikost každé velké stránky (větší než standardní paměťové stránky používané systémem).
- huge_pages_free: Počet velkých stránek, které nejsou aktuálně používány.
- huge_pages_total: Celkový počet velkých stránek dostupných v systému.
- inactive: Paměť, která nebyla nedávno použita a může být zpřístupněna pro jiné procesy nebo diskovou cache.
- low_free: Množství volné paměti v oblasti nízké paměti systému (paměť přímo přístupná jádrem).
- low_total: Celkové množství systémové paměti v oblasti nízké paměti.
- mapped: Paměť použitá pro mapované soubory, jako jsou knihovny a spustitelné soubory v paměti.
- page_tables: Paměť použitá jádrem k udržování mapování virtuální paměti na fyzickou paměť.
- shared: Paměť používaná více procesy nebo sdílená mezi procesy a jádrem.
- slab: Paměť použitá jádrem pro cache datových struktur.
- sreclaimable: Část slab paměti, která může být zpětně získána, například cache, které mohou být uvolněny v případě potřeby.
- sunreclaim: Část slab paměti, která nemůže být zpětně získána pod tlakem paměti.
- swap_cached: Paměť, která byla swapována na disk, ale stále je v RAM.
- swap_free: Množství swap prostoru, který aktuálně není používán.
- swap_total: Celkové množství dostupného swap prostoru.
- total: Celkové množství fyzické RAM dostupné v systému.
- used: Množství paměti, která je aktuálně používána procesy.
- used_percent: Procento celkové paměti, která je aktuálně používána.
- vmalloc_chunk: Největší souvislý blok paměti dostupný v prostoru vmalloc jádra.
- vmalloc_total: Celkové množství paměti dostupné v prostoru vmalloc jádra.
- vmalloc_used: Množství paměti aktuálně používané v prostoru vmalloc jádra.
- write_back: Paměť, která je aktuálně zapsána zpět na disk.
- write_back_tmp: Dočasná paměť použitá během operací zápisu zpět.
Metriky specifické pro kernel
kernel
Metriky pro monitorování Linuxového kernelu. Navštivte dokumentaci pluginu InfluxDB Telegraf pro více detailů.
Štítky: node_id
- boot_time: Čas, kdy byl systém naposledy spuštěn, měřený v sekundách od Unixového epochu (1. ledna 1970). To vám řekne dobu provozu systému a čas posledního restartu. Tento údaj můžete převést na datum pomocí (Unix epoch time converter).
- context_switches: Počet (integer) přepnutí kontextu, které kernel provedl. Přepnutí kontextu nastává, když se CPU přepne z jednoho procesu nebo vlákna na jiné. Vysoký počet přepnutí kontextu může naznačovat, že mnoho procesů soutěží o čas CPU, což může být znakem vysokého zatížení systému.
- entropy_avail: Množství (integer) dostupné entropie (náhodnosti, kterou lze generovat) v systému, což je zásadní pro bezpečné generování náhodných čísel. Nízká entropie může ovlivnit kryptografické funkce a bezpečnou komunikaci. Entropie je spotřebovávána různými operacemi a postupem času doplňována, takže sledování této metriky je důležité pro udržení bezpečnosti.
- interrupts: Celkový počet (integer) přerušení zpracovaných od spuštění systému. Přerušení je signál procesoru vyslaný hardwarem nebo softwarem, který označuje událost vyžadující okamžitou pozornost. Vysoký počet přerušení může naznačovat zaneprázdněný nebo možná přetížený systém.
- processes_forked: Celkový počet (integer) forků (vytvořených) procesů od spuštění systému. Sledování rychlosti vytváření procesů může pomoci při diagnostice výkonových problémů systému, zejména v prostředích, kde jsou procesy často spouštěny a zastavovány.
kernel_vmstat
Statistiky virtuální paměti kernelu shromážděné přes proc/vmstat. Navštivte dokumentaci pluginu InfluxDB Telegraf pro více detailů.
Relevantní termíny
- Aktivní stránky: Stránky, které jsou aktuálně používány nebo byly nedávno použity.
- Neaktivní stránky: Stránky, které nebyly nedávno použity, a proto je pravděpodobnější, že budou přesunuty na swap space nebo znovu použity.
- Anonymní stránky: Stránky paměti, které nejsou zálohovány souborem na disku; typicky se používají pro data, která není třeba ukládat, jako jsou programové zásobníky.
- Bounce buffer: Dočasná paměť používaná k usnadnění přenosu dat mezi zařízeními, která nemohou přímo adresovat vzájemnou paměť.
- Kompakce: Proces přeskupování stránek v paměti pro vytvoření větších souvislých volných prostorů, často užitečný pro alokaci obrovských stránek.
- Špinavé stránky: Stránky, které byly upraveny v paměti, ale dosud nebyly zapsány zpět na disk.
- Eviktování: Proces odstraňování stránek z fyzické paměti, buď jejich přesunutím na disk (swapování) nebo jejich odstraněním, pokud již nejsou potřeba.
- Stránky zálohované souborem: Stránky paměti, které jsou spojeny se soubory na disku, například spustitelné soubory nebo datové soubory.
- Volné stránky: Stránky paměti, které jsou k dispozici pro použití a nejsou aktuálně přiděleny žádnému procesu nebo datům.
- Obrovské stránky: Velké stránky paměti, které mohou být použity procesy, čímž se snižuje režie tabulek stránek.
- Prokládání: Proces distribuce stránek paměti mezi různé paměťové uzly nebo zóny, typicky za účelem optimalizace výkonu v systémech s nejednotným přístupem k paměti (NUMA).
- NUMA (nejednotný přístup k paměti): Návrh paměti, kde procesor přistupuje ke své vlastní lokální paměti rychleji než k nelokální paměti.
- Alokace stránek: Proces přiřazování volných stránek paměti k pokrytí požadavku procesu nebo kernelu.
- Výpadek stránky: Událost, která nastane, když program zkusí přistoupit ke stránce, která není ve fyzické paměti, což vyžaduje, aby to OS zpracoval alokací stránky nebo jejím vyzvednutím z disku.
- Tabulka stránek: Datová struktura používaná operačním systémem k ukládání mapování mezi virtuálními adresami a fyzickými adresami paměti.
- Sdílená paměť (shmem): Paměť, ke které mohou přistupovat více procesů.
- Slab stránky: Stránky paměti používané kernelem k ukládání objektů pevných velikostí, jako jsou struktury souborů nebo cache inodů.
- Swap space: Prostor na disku použitý k ukládání stránek paměti, které byly vyřazeny z fyzické paměti.
- THP (transparentní obrovské stránky): Funkce, která automaticky spravuje přidělení obrovských stránek pro zlepšení výkonu bez nutnosti změn v aplikacích.
- Vmscan: Kernelový proces, který skenuje stránky paměti a rozhoduje, které stránky vyřadit nebo swapovat na základě jejich použití.
- Zápis zpět: Proces zápisu špinavých stránek zpět na disk.
Štítky: node_id
- nr_free_pages: Počet volných stránek v systému.
- nr_inactive_anon: Počet neaktivních anonymních stránek.
- nr_active_anon: Počet aktivních anonymních stránek.
- nr_inactive_file: Počet neaktivních stránek zálohovaných souborem.
- nr_active_file: Počet aktivních stránek zálohovaných souborem.
- nr_unevictable: Počet stránek, které nelze vyřadit z paměti.
- nr_mlock: Počet stránek zamčených do paměti (mlock).
- nr_anon_pages: Počet anonymních stránek.
- nr_mapped: Počet stránek namapovaných do uživatelského prostoru.
- nr_file_pages: Počet stránek zálohovaných souborem.
- nr_dirty: Počet aktuálně špinavých stránek.
- nr_writeback: Počet stránek pod zápisem zpět.
- nr_slab_reclaimable: Počet stránek slabů, které lze znovu použít.
- nr_slab_unreclaimable: Počet stránek slabů, které nelze znovu použít.
- nr_page_table_pages: Počet stránek použitých pro tabulky stránek.
- nr_kernel_stack: Množství stránek zásobníku kernelu.
- nr_unstable: Počet nestabilních stránek.
- nr_bounce: Počet stránek bounce bufferů.
- nr_vmscan_write: Počet stránek zapsaných vmscan.
- nr_writeback_temp: Počet dočasných stránek pod zápisem zpět.
- nr_isolated_anon: Počet izolovaných anonymních stránek.
- nr_isolated_file: Počet izolovaných stránek souborů.
- nr_shmem: Počet stránek sdílené paměti.
- numa_hit: Počet stránek alokovaných v preferovaném uzlu.
- numa_miss: Počet stránek alokovaných v nepreferovaném uzlu.
- numa_foreign: Počet stránek určených pro jiný uzel.
- numa_interleave: Počet proložených stránek.
- numa_local: Počet stránek alokovaných v lokálním uzlu.
- numa_other: Počet stránek alokovaných v jiných uzlech.
- nr_anon_transparent_hugepages: Počet anonymních transparentních obrovských stránek.
- pgpgin: Počet kilobajtů přečtených z disku.
- pgpgout: Počet kilobajtů zapsaných na disk.
- pswpin: Počet stránek swapovaných dovnitř.
- pswpout: Počet stránek swapovaných ven.
- pgalloc_dma: Počet alokovaných stránek v DMA zóně.
- pgalloc_dma32: Počet alokovaných stránek v DMA32 zóně.
- pgalloc_normal: Počet alokovaných stránek v normální zóně.
- pgalloc_movable: Počet alokovaných stránek v mobilní zóně.
- pgfree: Počet uvolněných stránek.
- pgactivate: Počet aktivovaných neaktivních stránek.
- pgdeactivate: Počet deaktivovaných aktivních stránek.
- pgfault: Počet výpadků stránek.
- pgmajfault: Počet velkých výpadků stránek.
- pgrefill_dma: Počet doplněných stránek v DMA zóně.
- pgrefill_dma32: Počet doplněných stránek v DMA32 zóně.
- pgrefill_normal: Počet doplněných stránek v normální zóně.
- pgrefill_movable: Počet doplněných stránek v mobilní zóně.
- pgsteal_dma: Počet získaných stránek v DMA zóně.
- pgsteal_dma32: Počet získaných stránek v DMA32 zóně.
- pgsteal_normal: Počet získaných stránek v normální zóně.
- pgsteal_movable: Počet získaných stránek v mobilní zóně.
- pgscan_kswapd_dma: Počet naskenovaných stránek v DMA zóně přes kswapd.
- pgscan_kswapd_dma32: Počet naskenovaných stránek v DMA32 zóně přes kswapd.
- pgscan_kswapd_normal: Počet naskenovaných stránek v normální zóně přes kswapd.
- pgscan_kswapd_movable: Počet naskenovaných stránek v mobilní zóně přes kswapd.
- pgscan_direct_dma: Počet přímo naskenovaných stránek v DMA zóně.
- pgscan_direct_dma32: Počet přímo naskenovaných stránek v DMA32 zóně.
- pgscan_direct_normal: Počet přímo naskenovaných stránek v normální zóně.
- pgscan_direct_movable: Počet přímo naskenovaných stránek v mobilní zóně.
- zone_reclaim_failed: Počet neúspěšných pokusů o znovuzískání zóny.
- pginodesteal: Počet získaných stránek inodů.
- slabs_scanned: Počet naskenovaných stránek slabů.
- kswapd_steal: Počet stránek získaných kswapd.
- kswapd_inodesteal: Počet stránek inodů získaných kswapd.
- kswapd_low_wmark_hit_quickly: Frekvence, jak rychle kswapd zasáhl nízkou hladinu vody.
- kswapd_high_wmark_hit_quickly: Frekvence, jak rychle kswapd zasáhl vysokou hladinu vody.
- kswapd_skip_congestion_wait: Počet případů, kdy kswapd přeskočil čekání kvůli přetížení.
- pageoutrun: Počet zpracovaných stránek pageout.
- allocstall: Počet případů, kdy se allocation page zasekla.
- pgrotated: Počet rotovaných stránek.
- compact_blocks_moved: Počet bloků přesunutých během kompakce.
- compact_pages_moved: Počet stránek přesunutých během kompakce.
- compact_pagemigrate_failed: Počet neúspěšných migrací stránek během kompakce.
- compact_stall: Počet záseků během kompakce.
- compact_fail: Počet neúspěchů kompakce.
- compact_success: Počet úspěšných kompakcí.
- htlb_buddy_alloc_success: Počet úspěšných alokací HTLB buddy.
- htlb_buddy_alloc_fail: Počet neúspěšných alokací HTLB buddy.
- unevictable_pgs_culled: Počet zněmněných neevikovatelných stránek.
- unevictable_pgs_scanned: Počet naskenovaných neevikovatelných stránek.
- unevictable_pgs_rescued: Počet zachráněných neevikovatelných stránek.
- unevictable_pgs_mlocked: Počet zamčených neevikovatelných stránek.
- unevictable_pgs_munlocked: Počet odemčených neevikovatelných stránek.
- unevictable_pgs_cleared: Počet vymazaných neevikovatelných stránek.
- unevictable_pgs_stranded: Počet opuštěných neevikovatelných stránek.
- unevictable_pgs_mlockfreed: Počet neevikovatelných stránek uvolněných z mlocku.
- thp_fault_alloc: Počet výpadků, které způsobil alokace THP.
- thp_fault_fallback: Počet výpadků, které využily fallback z THP.
- thp_collapse_alloc: Počet alokací THP zkolabovaných.
- thp_collapse_alloc_failed: Počet neúspěšných alokací THP zkolabovaných.
- thp_split: Počet THP rozdělených.
Tenant metriky
Můžete zkoumat zdraví a stav mikroslužeb specifických pro jednotlivé tenanta, pokud máte ve svém systému více LogMan.io tenantů. Tenant metriky jsou specifické pro mikroslužby LogMan.io Parser, Dispatcher, Correlator a Watcher.
Pojmenování a tagy v Grafana a InfluxDB
- Skupiny tenant metrik jsou uvedeny pod tagem
measurement. - Tenant metriky jsou produkovány pro vybrané mikroslužby (tag
appclass) a mohou být dále filtrovány pomocí dodatečných tagůhostapipeline. - Každá jednotlivá metrika (například
eps.in) je hodnotou v tagufield.
Tagy jsou pipeline (ID pipeline), host (hostname mikroslužby) a tenant (jméno tenanta malými písmeny). Navštivte stránku Pipeline metriky pro podrobnější vysvětlení a návody pro interpretaci jednotlivých metrik.
bspump.pipeline.tenant.eps
Počítací metrika s následujícími hodnotami, aktualizována jednou za minutu:
eps.in: Počet událostí za sekundu vstupujících do pipeline pro tenanta.eps.aggr: Agregovaný počet událostí (hodnota je vynásobena atributemcntv událostech) za sekundu vstupujících do pipeline pro tenanta.eps.drop: Počet událostí za sekundu v pipeline pro tenanta, které byly zahozeny.eps.out: Počet událostí za sekundu úspěšně opouštějících pipeline pro tenanta.warning: Počet varování za definovaný časový interval v pipeline pro tenanta.error: Počet chyb za definovaný časový interval v pipeline pro tenanta.
V LogMan.io Parseru pocházejí nejrelevantnější metriky z ParsersPipeline (když data poprvé vstoupí do Parseru a jsou zpracována přes preprocessory a parsery) a EnrichersPipeline. V LogMan.io Dispatcheru pocházejí nejrelevantnější metriky z EventsPipeline a OthersPipeline.
bspump.pipeline.tenant.load
Počítací metrika s následujícími hodnotami, aktualizována jednou za minutu:
load.in: Velikost v bytech všech událostí vstupujících do pipeline pro tenanta za definovaný časový interval.load.out: Velikost v bytech všech událostí opouštějících pipeline pro tenanta za definovaný časový interval.
Korrelátorové metriky
Následující metriky jsou specifické pro LogMan.io Korrelátor. Detekce (známé také jako korelační pravidla) jsou založeny na mikroslužbě Korrelátor.
Pojmenování a tagy v Grafana a InfluxDB
- Skupiny korrelátorových metrik jsou pod tagem
measurement. - Korrelátorové metriky jsou produkovány pouze pro mikroslužbu Korrelátor (tag
appclass) a mohou být dále filtrovány pomocí dodatečných tagůcorrelatorpro izolaci jednoho korrelátoru ahost. - Každá jednotlivá metrika (například
in) je hodnota v tagufield.
correlator.predicate
Počítadlo, které počítá, kolik událostí prošlo sekcí predicate nebo filtrem detekce. Každá metrika se aktualizuje jednou za minutu, takže časový interval odkazuje na období přibližně jedné minuty.
in: Počet událostí vstupujících do predicate v časovém intervalu.hit: Počet událostí úspěšně odpovídajících predicate (splňující podmínky filtru) v časovém intervalu.miss: Počet událostí neprocházejících predicate v časovém intervalu (nesplňující podmínky filtru) a tudíž opouštějících Korrelátor.error: Počet chyb v predicate v časovém intervalu.
correlator.trigger
Počítadlo, které počítá, kolik událostí prošlo sekcí trigger korrelátoru. Trigger definuje a vykonává akci. Každá metrika se aktualizuje jednou za minutu, takže časový interval odkazuje na období přibližně jedné minuty.
in: Počet událostí vstupujících do triggeru v časovém intervalu.out: Počet událostí opouštějících trigger v časovém intervalu.error: Počet chyb v triggeru v časovém intervalu, měl by být roveninmínusout.
correlator.time
Počítadlo času zpracování v sekundách podle fáze detekce. Hodnoty jsou kumulativní v intervalu metrik (cca jedna minuta). Korelátor měří každou N tou událost (výchozí N = 10) a délku škáluje; přepsat lze [correlator] time_metrics_sample_interval.
Tagy: correlator, path (cesta v Library), tenant.
| Pole | Fáze |
|---|---|
total |
Celé zpracování pravidla |
predicate |
Filtr predicate |
evaluate |
evaluate (window) |
analyze |
analyze (window) |
trigger |
trigger |
V UI na obrazovce Detekce jako timetotal, timepredicate, atd. Analytik optimalizuje pravidla podle UI; v Grafaně sleduje Kafka lag instance, ne tato časová pole.
Plán kontinuity
Matice rizik
Matice rizik definuje úroveň rizika tím, že zvažuje kategorii "Pravděpodobnost" výskytu incidentu ve srovnání s kategorií "Dopad". Obě kategorie mají skóre mezi 1 a 5. Násobením skóre pro "Pravděpodobnost" a "Dopad" se vytvoří celkové rizikové skóre.
Pravděpodobnost
| Pravděpodobnost | Skóre |
|---|---|
| Zřídka | 1 |
| Nepravděpodobné | 2 |
| Možné | 3 |
| Pravděpodobné | 4 |
| Téměř jisté | 5 |
Dopad
| Dopad | Skóre | Popis |
|---|---|---|
| Nevýznamný | 1 | Funkcionalita není ovlivněna, výkon není snížen, prostoje nejsou potřeba. |
| Drobný | 2 | Funkcionalita není ovlivněna, výkon není snížen, prostoje u postiženého uzlu clusteru jsou potřeba. |
| Mírný | 3 | Funkcionalita není ovlivněna, výkon je snížen, prostoje u postiženého uzlu clusteru jsou potřeba. |
| Vážný | 4 | Funkcionalita je ovlivněna, výkon je výrazně snížen, prostoje clusteru jsou potřeba. |
| Katastrofální | 5 | Úplná ztráta funkcionality. |
Scénáře incidentů
Úplné selhání systému
Dopad: Katastrofální (5)
Pravděpodobnost: Zřídka (1)
Úroveň rizika: středně vysoká
Omezení rizika:
- Geograficky distribuovaný cluster
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Silná kybernetická bezpečnost
Obnova:
- Kontaktujte podporu a/nebo dodavatele a konzultujte strategii.
- Obnovte funkčnost hardwaru.
- Obnovte systém z zálohy konfigurace webu.
- Obnovte data z offline zálohy (začněte s nejnovějšími daty a pokračujte do historie).
Ztráta uzlu v clusteru
Dopad: Mírný (4)
Pravděpodobnost: Nepravděpodobné (2)
Úroveň rizika: středně nízká
Omezení rizika:
- Geograficky distribuovaný cluster
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
Obnova:
- Kontaktujte podporu a/nebo dodavatele a konzultujte strategii.
- Obnovte funkčnost hardwaru.
- Obnovte systém z zálohy konfigurace webu.
- Obnovte data z offline zálohy (začněte s nejnovějšími daty a pokračujte do historie).
Ztráta rychlého úložného disku v jednom uzlu clusteru
Dopad: Drobný (2)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně nízká
Rychlé disky jsou v RAID 1 poli, takže ztráta jednoho disku není kritická. Zajistěte rychlou výměnu selhávajícího disku, aby se předešlo druhé ztrátě rychlého disku. Druhá ztráta rychlého disku povede k "Ztrátě uzlu v clusteru".
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná výměna selhávajícího disku
Obnova:
- Vypněte postižený uzel clusteru
- Vyměňte selhávající rychlý úložný disk co nejdříve
- Zapněte postižený uzel clusteru
- Ověřte správnou rekonstrukci RAID1 pole
Note
Hot swap rychlého úložného disku je podporován na konkrétní žádost zákazníka.
Nedostatek rychlého úložného prostoru
Dopad: Mírný (3)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně vysoká
Tato situace je problematická, pokud nastane na více uzlech clusteru současně. Použijte monitorovací nástroje k identifikaci této situace před eskalací.
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
Obnova:
- Odstraňte zbytečná data z rychlého úložného prostoru.
- Upravte konfiguraci životního cyklu tak, aby se data přesunula do pomalého úložného prostoru dříve.
Ztráta pomalého úložného disku v jednom uzlu clusteru
Dopad: Nevýznamný (1)
Pravděpodobnost: Pravděpodobné (4)
Úroveň rizika: středně nízká
Pomalé disky jsou v RAID 5 nebo RAID 6 poli, takže ztráta jednoho disku není kritická. Zajistěte rychlou výměnu selhávajícího disku, aby se předešlo další ztrátě disku. Druhá ztráta disku v RAID 5 nebo třetí ztráta disku v RAID 6 povede k "Ztrátě uzlu v clusteru".
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná výměna selhávajícího disku
Obnova:
- Vyměňte selhávající pomalý úložný disk co nejdříve (hot swap)
- Ověřte správnou rekonstrukci pomalého úložného RAID
Nedostatek pomalého úložného prostoru
Dopad: Mírný (3)
Pravděpodobnost: Pravděpodobné (4)
Úroveň rizika: středně vysoká
Tato situace je problematická, pokud nastane na více uzlech clusteru současně. Použijte monitorovací nástroje k identifikaci této situace před eskalací.
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasné rozšíření velikosti pomalého datového úložiště
Obnova:
- Odstraňte zbytečná data z pomalého úložného prostoru.
- Upravte konfiguraci životního cyklu tak, aby se data odstranila z pomalého úložného prostoru dříve.
Ztráta systémového disku v jednom uzlu clusteru
Dopad: Drobný (2)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně nízká
Systémové disky jsou v RAID 1 poli, takže ztráta jednoho disku není kritická. Zajistěte rychlou výměnu selhávajícího disku, aby se předešlo druhé ztrátě rychlého disku. Druhá ztráta systémového disku povede k "Ztrátě uzlu v clusteru".
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná výměna selhávajícího disku
Obnova:
- Vyměňte selhávající rychlý úložný disk co nejdříve (hot swap)
- Ověřte správnou rekonstrukci RAID1 pole
Nedostatek systémového úložného prostoru
Dopad: Mírný (3)
Pravděpodobnost: Zřídka (1)
Úroveň rizika: nízká
Použijte monitorovací nástroje k identifikaci této situace před eskalací.
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
Obnova:
- Odstraňte zbytečná data ze systémového úložného prostoru.
- Kontaktujte podporu nebo dodavatele.
Ztráta síťového připojení v jednom uzlu clusteru
Dopad: Drobný (2)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Redundantní síťové připojení
Obnova:
- Obnovte síťové připojení
- Ověřte správný provoz clusteru
Selhání clusteru Elasticsearch
Dopad: Vážný (4)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně vysoká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná reakce na zhoršující se zdraví clusteru Elasticsearch
Obnova:
- Kontaktujte podporu a/nebo dodavatele a konzultujte strategii.
Selhání uzlu Elasticsearch
Dopad: Drobný (2)
Pravděpodobnost: Pravděpodobné (4)
Úroveň rizika: středně nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná reakce na zhoršující se zdraví clusteru Elasticsearch
Obnova:
- Sledujte automatické připojení uzlu Elasticsearch zpět do clusteru
- Kontaktujte podporu / dodavatele, pokud selhání přetrvává několik hodin.
Selhání clusteru Apache Kafka
Dopad: Vážný (4)
Pravděpodobnost: Zřídka (1)
Úroveň rizika: středně nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná reakce na zhoršující se zdraví clusteru Apache Kafka
Obnova:
- Kontaktujte podporu a/nebo dodavatele a konzultujte strategii.
Selhání uzlu Apache Kafka
Dopad: Drobný (2)
Pravděpodobnost: Zřídka (1)
Úroveň rizika: nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná reakce na zhoršující se zdraví clusteru Apache Kafka
Obnova:
- Sledujte automatické připojení uzlu Apache Kafka zpět do clusteru
- Kontaktujte podporu / dodavatele, pokud selhání přetrvává několik hodin.
Selhání clusteru Apache ZooKeeper
Dopad: Vážný (4)
Pravděpodobnost: Zřídka (1)
Úroveň rizika: středně nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná reakce na zhoršující se zdraví clusteru Apache ZooKeeper
Obnova:
- Kontaktujte podporu a/nebo dodavatele a konzultujte strategii.
Selhání uzlu Apache ZooKeeper
Dopad: Nevýznamný (1)
Pravděpodobnost: Zřídka (1)
Úroveň rizika: nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
- Včasná reakce na zhoršující se zdraví clusteru Apache ZooKeeper
Obnova:
- Sledujte automatické připojení uzlu Apache ZooKeeper zpět do clusteru
- Kontaktujte podporu / dodavatele, pokud selhání přetrvává několik hodin.
Selhání stateless datového mikroservisu (kolektor, parser, dispatcher, korelátor, watcher)
Dopad: Drobný (2)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
Obnova:
- Restartujte selhávající mikroservis.
Selhání stateless podpůrného mikroservisu (všechny ostatní)
Dopad: Nevýznamný (1)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně nízká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
Obnova:
- Restartujte selhávající mikroservis.
Významné snížení výkonu systému
Dopad: Mírný (3)
Pravděpodobnost: Možné (3)
Úroveň rizika: středně vysoká
Omezení rizika:
- Aktivní používání monitorování a alertování
- Prophylaktická údržba
Obnova:
- Identifikujte a odstraňte příčinu snížení výkonu
- Kontaktujte dodavatele nebo podporu, pokud je potřeba pomoc
Strategie zálohování a obnovy
Offline záloha pro příchozí logy
Příchozí logy jsou duplikovány do offline záložního úložiště, které není součástí aktivního clusteru LogMan.io (proto je "offline"). Offline záloha poskytuje možnost obnovit logy do LogMan.io po kritickém selhání atd.
Strategie zálohování pro rychlé datové úložiště
Příchozí události (logy) jsou kopírovány do archivačního úložiště, jakmile vstoupí do LogMan.io. To znamená, že vždy existuje způsob, jak "přehrát" události do TeskaLabs LogMan.in v případě potřeby. Data jsou také replikována na jiné uzly clusteru okamžitě po příjezdu do clusteru. Z tohoto důvodu se tradiční zálohování nedoporučuje, ale je možné.
Obnova je zajištěna komponenty clusteru replikací dat z jiných uzlů clusteru.
Strategie zálohování pro pomalé datové úložiště
Data uložená na pomalém datovém úložišti jsou VŽDY replikována na jiné uzly clusteru a také uložena v archivu. Z tohoto důvodu se tradiční zálohování nedoporučuje, ale je možné (zvažte obrovskou velikost pomalého úložiště).
Obnova je zajištěna komponenty clusteru replikací dat z jiných uzlů clusteru.
Strategie zálohování pro systémové úložiště
Doporučuje se pravidelně zálohovat všechny souborové systémy na systémovém úložišti, aby mohly být použity k obnovení instalace, když je to potřeba. Strategie zálohování je kompatibilní s většinou běžných zálohovacích technologií na trhu.
- Cíl obnovy dat (RPO): plná záloha jednou týdně nebo po větší údržbě, inkrementální záloha jednou denně.
- Cíl doby obnovy (RTO): 12 hodin.
Note
RPO a RTO jsou doporučovány, za předpokladu vysoce dostupného nastavení clusteru LogMan.io. To znamená tři a více uzlů, aby úplný výpadek jednoho uzlu neovlivnil dostupnost služby.
Obecná pravidla pro zálohování a obnovu
-
Zálohování dat: Pravidelně zálohujte na bezpečné místo, jako je cloudová úložná služba, záložní pásky, abyste minimalizovali ztrátu dat v případě selhání.
-
Plánování zálohování: Stanovte plán zálohování, který splňuje potřeby organizace, například denní, týdenní nebo měsíční zálohy.
-
Ověření zálohování: Pravidelně ověřujte integritu zálohovaných dat, abyste zajistili, že mohou být použita pro obnovu po katastrofě.
-
Testování obnovy: Pravidelně testujte obnovu zálohovaných dat, abyste zajistili, že proces zálohování a obnovy funguje správně a abyste identifikovali a vyřešili jakékoli problémy, než se stanou kritickými.
-
Politika uchovávání záloh: Stanovte politiku uchovávání záloh, která vyváží potřebu dlouhodobého uchovávání dat s náklady
AI
LogMan.io AI SIEM
TeskaLabs LogMan.io AI SIEM je agentní AI platforma integrovaná v TeskaLabs LogMan.io. Propojuje velké jazykové modely (LLM) s nástroji, skills a řízeným sandboxem, takže analytici a operátoři mohou vyšetřovat, psát detekce, dotazovat data a automatizovat SIEM práci přirozeným jazykem.
Platforma má dvě vrstvy:
| Vrstva | Role |
|---|---|
| Inference | Spouští jazykový model: chat completions, streamování tokenů a reasoning. |
| Harness | Vše kolem modelu: konverzace, nástroje, skills, sandbox, shares, human-in-the-loop a příkazy se lomítkem. |
Harness promění surový LLM v spolehlivého SIEM AI agenta. Model navrhuje akce; harness je provádí, streamuje průběh do UI, vynucuje bezpečnostní politiky, drží auditní stopu a udržuje kontext napříč relacemi.
Hint
Harness je implementován v mikroslužbě llm-microlink.
Běží u zákazníka on-premise, vedle zbytku LogMan.io a sandboxů.
Inference obvykle běží v TeskaLabs AI clusteru a je dostupná přes síť.

Diagram ukazuje rozdělení nasazení:
- TeskaLabs — LLM inference a routing. Harness posílá prompty a přijímá streamovaný výstup modelu; zákaznická data událostí nemusí být v AI clusteru.
- On-premise u zákazníka —
llm-microlink(harness), uživatelská relace a Sandbox. Skills a nástroje běží zde, takže přístup k LogMan.io a interním hostům zůstává v perimetru zákazníka. - Ze sandboxu může agent volat LogMan.io REST API a při potřebě skillu dosáhnout na externí hosty (např. přes SSH).
Vlastní inference
Harness můžete namířit na vlastní inference endpointy místo TeskaLabs AI clusteru. Tato možnost existuje pro speciální nasazení; výchozí a doporučená cesta je inference hostovaná u TeskaLabs. Viz Inference.
Typické použití
Většina každodenní práce je člověk u počítače, který chatuje s agentem v UI LogMan.io:
- Uživatel otevře konverzaci (nebo agenta) a popíše cíl.
- Harness sestaví instrukce z výchozího promptu, Soul, dostupných skills a nástrojů a volitelných faktů — kde je to relevantní, ze Knihovny.
- LLM streamuje reasoning a může emitovat tool calls.
- Harness spouští nástroje v on-prem sandboxu (shell, čtení knihovny, ask user, REST helpery, …), volitelně po vettingu.
- Výsledky se vrátí do konverzace; smyčka pokračuje, dokud úkol není hotový.
Stejný harness podporuje i plně autonomní běhy — agenty a plánované úlohy bez interaktivního chatu. Režimy můžete kombinovat: chat pro některé kroky, vetting pro citlivé nástroje a autonomii pro zbytek. Viz Human-in-the-loop a řízení a Konverzace.
Co můžete dělat
- Vyšetřovat — hledat a analyzovat události (
lmio-query) - Detection engineering — psát, unit-testovat a huntovat korelační pravidla (
lmio-detection-engineer) - Znalosti produktu — odpovídat „jak funguje X?“ z dokumentace a Common Library (
lmio-knowledge) - Provoz přes API — volat LogMan.io REST endpointy (
lmio-rest-api) - Infrastruktura — SSH a vzdálená administrace (
devops) - Paměť — Soul a trvalé fakty (
soul-bootstrap,facts) - Automatizace — cílově orientované agenty a plány
Inference
Inference je vrstva jazykového modelu LogMan.io AI SIEM. Odpovídá na prompty, streamuje reasoning a text a navrhuje tool calls. Nespouští shell příkazy, nevolá LogMan.io API ani nesahá na souborové systémy zákazníka — to je úkol harnessu a on-prem sandboxu.
Jak je inference poskytována
Nasazení volí, kde modely běží. Doporučené pořadí:
1. TeskaLabs AI cluster (výchozí)
TeskaLabs provozuje vzdálený AI cluster. On-prem harness se k němu připojí přes routing, posílá kontext konverzace a přijímá streamovaný výstup modelu.
Hlavní nabídka:
- Pro běžné použití neprovozujete GPU ani model servery on-site
- Modely a routing zůstávají pod provozem TeskaLabs
- Harness, sandboxy, Knihovna a data LogMan.io zůstávají u zákazníka
2. On-premise inference server
Pro zákazníky, kteří potřebují modely ve vlastní síti, TeskaLabs pomůže s on-premise inference serverem, ke kterému harness mluví stejným způsobem.
Řídicí rovina a agent runtime zůstávají llm-microlink on-site; mění se jen místo běhu GPU/model procesu.
3. Vlastní inference
Jako poslední možnost může harness použít zákaznické OpenAI-kompatibilní (nebo podobné) endpointy — např. vLLM, TensorRT-LLM nebo cloud API, které už provozujete.
Použijte, když politika nebo architektura zakazuje inference hostovanou nebo sestavenou TeskaLabs. Pak nesete odpovědnost za kvalitu modelu, kapacitu, dostupnost a kompatibilitu API.
Co inference dělá
| Inference dělá | Inference nedělá |
|---|---|
| Porozumět cíli uživatele a kontextu konverzace | Spouštět shell nebo kód |
| Streamovat text asistenta a (když je k dispozici) reasoning | Číst nebo zapisovat filesystem sandboxu |
| Rozhodnout, které nástroje nebo skills použít dál | Volat LogMan.io REST API nebo externí hosty |
| Psát dotazy, pravidla, reporty a vysvětlení | Vynucovat vetting nebo schválení člověkem |
| Hodnotit průběh k cíli (když harness požádá) | Persistovat konverzace, shares nebo audit |
Model jen navrhuje. Harness provádí, zaznamenává a brání.
Modely v UI
Po startu konverzace UI ukáže modely z nakonfigurovaných providerů. Model volíte pro každou konverzaci zvlášť. Harness pak:
- Streamuje tokeny do časové osy konverzace
- Převádí function calls modelu na spuštění nástrojů harnessu
- Může ukázat přibližné využití tokenů, když to provider poskytne
- Může držet wire-level traces pro evaluaci a podporu
Poznámka k návrhu
Inference je vyměnitelná; harness je produktový diferenciátor. Stejné skills, sandbox, obsah Knihovny a human-in-the-loop fungují, ať model běží v TeskaLabs AI clusteru, na on-prem inference serveru nebo na vlastním endpointu.
Harness
The harness is the agent runtime around the language model.
It runs on the customer premises as thellm-microlinkmicroservice, next to LogMan.io and the sandboxes.
The harness owns:
- Conversation lifecycle and streaming to the UI — see Conversations
- Tool discovery, activation, and execution
- Skill loading from the Library
- Sandbox containers and share mounts
- Human-in-the-loop controls (chat, vetting, autonomy)
- Slash commands
- Audit recording of conversations and executed actions
The model proposes; the harness decides what actually runs.
Conversations
Interactive chat runs in conversations: streaming sessions between users, the model, and tools. See Conversations for multiplayer visibility, context window management, renaming, and the web UI.
Tools
Tools are the model’s hands.
A small core set is always loaded for a conversation; other built-in tools are discovered by name and activated on demand withactivate_tool.
Built-in tools
| Tool | Purpose |
|---|---|
activate_tool |
Load the full schema of an optional tool (or an MCP server tool) into the conversation |
ask |
Ask the user one to three multiple-choice questions and wait for answers |
web_fetch |
Fetch a public HTTP(S) page into context (headless browser path) |
library_list |
List items under a Library path |
library_read |
Read Library content into the model context (skills, prompts, Soul, references) |
library_write |
Create or update a Library item (activate first if not loaded) |
library_delete |
Delete a Library item (activate first if not loaded) |
delegate |
Spawn a subagent in an isolated conversation; use silent: true for handoff to a fresh context window on the same sandbox |
schedule |
Create a delayed or recurring job |
shell_exec |
Run a bash command in the sandbox |
read_file |
Read a file from the sandbox workspace (or via /library/…) |
write_file |
Write a file under the sandbox workspace |
share_search |
Semantic or full-text search over an indexed share |
notify |
Send a notification through configured channels |
ping |
ICMP reachability check (preferred over sandbox ping) |
Optional tool sources
Beyond the built-in catalogue:
- MCP servers configured on the microservice (activate the server alias, then a concrete tool name)
- Tools advertised in the cluster (ZooKeeper)
Use only tools the harness exposes for that conversation. Invented tool names are rejected.
Sandbox
The sandbox is a dedicated Linux container for agent work on the customer premises.
Properties:
- The container filesystem is read-only except for writable mounts
- Task-local storage is
/workspace(working directory forshell_exec) - The LogMan.io Library is available read-only at
/library(FUSE mount viaasab-library) - Shares bind-mount at
/workspace/<share-id>when attached - Home for the container user is under
/home/ai- Common tooling is preinstalled (Python 3, DuckDB, curl, wget, jq, yq, git, OpenSSH client, dig, …)
The model never gets a free shell on the LogMan.io host. All execution goes through harness tools into this container. Operators browse produced files on the Sandboxes screens in the UI.
Typical flow: write scripts or outputs under/workspace, run them withshell_exec, keep durable material in a share or in the Library.
Shares and mounts
Three storage ideas meet inside the sandbox:
| Store | Mount in sandbox | Lifetime | Typical content |
|---|---|---|---|
| Workspace | /workspace |
Conversation / sandbox | Drafts, downloads, intermediate files |
| Shares | /workspace/<share-id> (for example /workspace/facts, /workspace/lmio, /workspace/lmio-kb) |
Survive conversations | Facts, instance credentials, knowledge bases |
| Library | /library (Library path /X → /library/X) |
Product / tenant Library layers | Prompts, skills, Soul, declarations |
Share mounts are usually attached automatically from skill frontmatter (shares:) or via the/sharecommand.
The same share can be mounted into many conversations.
Users can browse shares from the Shares UI even when no conversation is active.
Soul (/AI/Soul/SOUL.mdin the Library) holds personality.
Durable operational truths go to the facts share (/workspace/factswhen mounted), not into Soul.
Commands
Slash-style commands are harness controls (not LLM tools). Examples:
-/goal— set a persistent goal the harness uses to judge progress
-/summarize— generate a short conversation title
-/share— attach or manage shares
-/hitl— deliver human-in-the-loop responses
- Final-answer gating — for some models, a small judge scores whether the last reply is finished; if not, the harness nudges the agent to continue
Human-in-the-loop and control
Operator control is a core differentiator of the LogMan.io harness compared with ad-hoc “LLM + scripts” setups.
You choose how much of a human stays in the loop — and you can combine modes in one deployment or even one workflow:
| Mode | What happens |
|---|---|
| Chat | A user steers the agent turn by turn; the agent can also call ask when a missing parameter would change the outcome |
| Vetting | Policy marks sensitive tool calls (for example risky shell_exec patterns). The harness pauses, the operator approves or declines, then execution continues or stops |
| Fully autonomous | Agents and schedules run toward a goal with little or no interactive chat |
| Mixed | Chat for planning, autonomy for bulk work, vetting only on high-impact actions |
If the operator declines a vetted call, the tool returns a clear refusal (“User declined this tool call.”). The model must not bypass that gate — it is a hard stop enforced by the harness, not by prompt wording alone.
Stop, resume, model choice, and tool/skill visibility in the UI give further operational control.
Audit log
The harness keeps an audit trail of what the AI did:
- Conversations and every timeline item (user messages, assistant text, reasoning, tool calls, engine notices) are stored in the harness database
- Each tool execution is recorded with name, arguments, result or error, and status — including vetting outcomes
- Optional LLM traces capture wire-level request/response traffic for support and evaluation (with retention controls)
That trail supports compliance reviews, incident follow-up (“what did the agent change?”), and quality tuning. Autonomy does not mean invisibility: the same recording applies to interactive chats, agents, and scheduled runs.
In the web application
Screen overview: AI in the web application. Conversation detail (toasts, alerts, token indicator): Conversations.
Conversations
A conversation is a session between users (optional), the model, and tools. It is the primary interactive surface of the harness: messages, tool calls, reasoning, and engine notices form a live timeline; the UI connects over a WebSocket and receives tokens, tool status, and sandbox updates as they happen.
Conversations are tenant-scoped and can be resumed from the list. The same engine also backs agents and schedules that run with little or no live chatting.
Multiplayer and visibility
Conversations are multiplayer by default. A tenant-wide conversation behaves like a shared room: several analysts can work in it at the same time.
| Mode | Harness value | Who can access |
|---|---|---|
| Tenant-wide (default) | tenant |
Everyone in the tenant — read and send messages |
| Personal | private |
Only the user who started the conversation (the owner) |
In tenant-wide mode:
- Every user in the tenant sees the conversation in the list and can open it
- Anyone can read the timeline and send messages to steer the agent
- The UI shows who else is currently viewing the thread (Also here sidebar toast)
Use multiplayer for pair investigation, handoffs, and shared analyst work. Switch to personal mode when the work must stay with one person.
Only the owner can change visibility. Before the first message, the empty screen asks Who can see this conversation? (Only me / Everyone in tenant). After start, toggle visibility from the header icon (lock = private, chat bubble = tenant-wide); the harness asks for confirmation.
Context window size
Long conversations accumulate tokens from messages, tool output, and reasoning. Staying within a reasonable context window keeps responses fast and reliable.
Rule of thumb: aim to work below 100k tokens in the active conversation.
Token indicator
On the conversation detail screen, at the bottom of the chat card (near the message input), the harness shows token usage when the provider reports it:
- Tokens used and model context limit (for example
42k / 128k tokens used) - A progress bar — green below ~70%, yellow below ~90%, red above that
Watch this during heavy investigation or multi-step tasks.
Keeping the window small
| Approach | What it does |
|---|---|
delegate with silent: true (handoff) |
Spawn a subagent in a new conversation with a fresh context window. Write a handoff document under /workspace/ (goal, progress, decisions, open questions, next steps, file paths), attach it via delegate files, and tell the subagent to continue from there. The parent is not notified when the subagent finishes — work continues in the new thread. Same sandbox is shared. |
| New conversation from sandbox | On the sandbox detail screen, Start new conversation attaches an existing sandbox to a new conversation. Files under /workspace remain available; chat history starts empty. |
| Multiple conversations, one sandbox | Several conversations (or agents) can share a single sandbox — separate threads for separate phases or parallel work while reusing workspace files and share mounts. |
Intermediate tool output from a delegated subagent does not flood the parent context. Prefer handoff over letting one conversation grow without bound.
Renaming and summary
Each conversation has a title in the list and header.
| Method | How |
|---|---|
| Manual rename | Click the title in the conversation header, edit, confirm (Enter or click away) |
| Automatic summary | The harness generates a short title when the thread has enough messages and still has a default id-style title |
| Manual summarize | ⋯ menu → Commands → Summarize, or the /summarize command — the model produces a plain-text title (up to about eight words) |
Summarized titles help teammates find multiplayer threads after a long session.
In the web application
Navigation: Conversations in the AI area.
List view
Browse and resume past conversations for the tenant. Private conversations show a lock icon; tenant-wide conversations show a chat icon.

Detail screen
The conversation detail screen is the interactive harness UI:
- Streaming timeline (user, assistant, reasoning, tool calls, engine notices)
- Model selection and model settings
- Tools, skills, and commands (⋯ menu)
- Human-in-the-loop prompts (
ask) and vetting when a sensitive tool call pauses

Sidebar toasts
The right sidebar can show toasts (context panels) when relevant:
| Toast | When it appears | Content |
|---|---|---|
| Sandbox | A sandbox is attached | Link to the sandbox detail screen |
| Workspace browser | Same as above (below Sandbox toast) | File tree of /workspace |
| Scheduled Tasks | One or more schedules jobs linked to this conversation | Job link, instruction preview, schedule, periodic vs one-off, next run |
| Also here | Other users have this conversation open | List of those users (tenant-wide only) |
These toasts are informational; they do not block the chat.
AI ve webové aplikaci
LogMan.io AI SIEM je ve webové aplikaci v oblasti navigace AI. Tyto obrazovky slouží k chatu s agentem, spuštění autonomních běhů a kontrole sandboxů, shares a plánů.
Přehled
| Obrazovka | Navigace | Účel |
|---|---|---|
| AI home | AI landing | Nová konverzace, agenti nebo šablona (např. LogMan.io expert) |
| Conversations | Conversations | Živý agentní chat — viz Konverzace |
| Agents | Agents | Spuštění a kontrola autonomních běhů agentů |
| Sandboxes | Sandboxes | Procházení workspace kontejnerů a souborů od agenta |
| Shares | Shares | Správa trvalých adresářů mountovaných do sandboxů |
| Schedules | Schedules | Přehled a otevření plánovaných úloh z harnessu |
AI home
Vstupní bod pro AI práci: nová konverzace, seznam agentů nebo start ze šablony (např. chat s LogMan.io expertem, nebo bootstrap Soul, když chybí).
Agents
Spusťte cílově orientovaného agenta z New Agent, vyplňte parametry třídy a sledujte průběh na detailu agenta (konzole, konverzace, sandboxy, artefakty).
Viz Agenti.
Sandboxes
Prohlížejte on-prem workspace kontejnery pro konverzace a agenty: strom souborů pod /workspace, stahování a výstupy agenta.
Na detailu sandboxu můžete:
- Procházet a nahrávat soubory pod
/workspace - Otevřít vložený terminál, když sandbox běží
- Start new conversation — připojit sandbox k nové konverzaci (stejné soubory, prázdná historie chatu)
Viz Sandbox a Udržení malého okna.
Shares
Spravujte trvalé adresáře, které harness mountuje do sandboxů na /workspace/<share-id> (např. facts, lmio, lmio-kb).
Shares přežívají jednotlivé konverzace a mohou být připojeny k mnoha běhům.
Viz Shares a mounty.
Schedules
Seznam a otevření plánovaných úloh z UI nebo nástrojem schedule: výraz, stav, propojená konverzace a chyby.
Viz Plány.
AI obsah v Knihovně
Knihovna je centrální úložiště obsahu TeskaLabs LogMan.io. Parsery, korelační pravidla, dashboardy, site deskriptory — a AI obsah — vše tam žije.
Uživatelé, kteří už s Knihovnou pracují pro SIEM obsah, používají stejnou funkci pro AI:
- Procházení a hledání pod
/AI/ - Úpravy položek pro vlastní chování
- Psaní nových skills a promptů
- Vrstvené doručování z TeskaLabs Common Library
Viz také uživatelská příručka: Knihovna.
Proč je AI obsah v Knihovně
Prompty, skills a Soul v Knihovně znamenají:
- Jedno místo pro produktový obsah — operátoři už znají navigaci, kopírování a úpravy položek
- Přizpůsobení — přepsat dodaný skill nebo prompt na tenant nebo osobní vrstvě bez forku harnessu
- Distribuce — TeskaLabs dodává a aktualizuje AI obsah přes Common Library, stejný kanál jako detekce a parsery
- Auditovatelnost — změny chování agenta jsou změny Knihovny, revidovatelné jako jiné deklarace
V sandboxu je Knihovna také read-only na /library, takže skripty pod skillem mohou běžet jako python3 /library/AI/Skills/… bez kopírování do workspace.
Rozvržení pod /AI/
| Cesta | Role |
|---|---|
/AI/Prompts/ |
System prompty (výchozí chování agenta, summarize, goal, final-answer judge, …) |
/AI/Skills/ |
Agent skills (SKILL.md playbooky, reference, skripty) |
/AI/Soul/SOUL.md |
Osobnost a preference vztahu agenta |
/AI/Agents/ |
Prompt materiál specifický pro agenty, kde se používá |
/AI/Models/ |
Volitelný obsah Knihovny související s modely |
Jak je organizována znalost
Výchozí system prompt (cesta /AI/Prompts/default.md) učí striktní směrování trvalé znalosti.
Všechna tato místa jsou v Knihovně nebo skills aktivovaných z Knihovny:
| Druh znalosti | Cíl | Kde žije |
|---|---|---|
| Osobnost, tón, jazyk, časové pásmo | Soul | Knihovna /AI/Soul/SOUL.md (skill soul-bootstrap) |
| Fakta, konvence, poučení z chyb | Úložiště Facts | Share /workspace/facts po aktivaci skillu facts |
| Opakovatelné postupy | Skills | Knihovna /AI/Skills/<name>/SKILL.md (psát se skill-authoring) |
Toto oddělení drží harness předvídatelný: osobnost neznečišťuje provozní paměť a playbooky zůstávají verzovatelným obsahem Knihovny.
Přizpůsobení
Můžete:
- Upravovat dodané prompty nebo skills v Knihovně (s respektem k vrstvám)
- Přidat skill pod
/AI/Skills/<your-skill>/s frontmatter vSKILL.md - Bootstrap nebo aktualizovat Soul přes UI / skill
soul-bootstrap - Držet tenant-specifické postupy ve vlastních skills místo cpání do výchozího promptu
Warning
Změna položek Knihovny mění chování produktu — včetně AI agenta. Preferujte malé, revidovatelné úpravy; postupy do skills, trvalé pravdy do facts.
Dovednosti
Skills
Skills jsou specializované playbooky uložené v LogMan.io Knihovně pod /AI/Skills/.
Řídí se vzorem Agent Skills.
Protože skills žijí v Knihovně:
- TeskaLabs je distribuuje přes Common Library
- Můžete je upravit nebo psát vlastní stejnými postupy jako detekce a parsery
- Harness je objeví při startu konverzace bez cpání postupů do výchozího promptu
Jak skills fungují
- Při startu konverzace agent vidí jen název + popis každého skillu
- Když úkol sedí,
library_readna/AI/Skills/<name>/SKILL.md— to skill aktivuje - Skill může deklarovat shares k mountu, další tools k aktivaci, vnořené references a scripts pod
/library/AI/Skills/<name>/
Postupné odhalování drží kontext malý, dokud skill není potřeba.
LogMan.io skills
| Skill | Cesta v Knihovně | Role |
|---|---|---|
lmio-knowledge |
/AI/Skills/lmio-knowledge/ |
Produktová dokumentace, OpenAPI, reference Common Library (share lmio-kb) |
lmio-query |
/AI/Skills/lmio-query/ |
Analytické dotazy na log/event/metric data |
lmio-rest-api |
/AI/Skills/lmio-rest-api/ |
Autentizované HTTP volání na instanci LogMan.io |
lmio-detection-engineer |
/AI/Skills/lmio-detection-engineer/ |
Psaní, unit-test, hunt a publikace korelačních pravidel |
Podrobně: Knowledge base (lmio-kb), Query, REST API.
Hint
Seznam skills rychle roste — nepovažujte ho za finální. Skutečně není.
Další důležité skills
| Skill | Role |
|---|---|
devops |
SSH, vzdálená administrace, troubleshooting infrastruktury |
facts |
Trvalé úložiště faktů (share facts) |
soul-bootstrap |
Vytvořit nebo aktualizovat /AI/Soul/SOUL.md |
skill-authoring |
Psát nové skills do Knihovny |
llm-wiki |
Uživatelská research wiki na share |
gitlab |
GitLab workflow |
trace-investigation |
Vyšetřování harness / LLM traces |
Vývojové skills (dev-lmio-*, SchemaExpert, ShellGuru, …) se mohou objevit podle zapnutých vrstev Knihovny.
Psaní vlastních
- Vytvořte
/AI/Skills/<name>/SKILL.mdv Knihovně s YAML frontmatter (name,description, volitelněshares,tools,skills) - Přidejte
references/ascripts/podle potřeby - Preferujte citace faktů a cest Knihovny místo duplikace velkých postupů ve výchozím promptu
Pro plný návod použijte skill skill-authoring.
Knowledge base
Skill knowledge base učí agenta hledat a číst referenční materiál TeskaLabs bez volání živé instance LogMan.io.
| Název skillu | lmio-knowledge |
| Cesta v Knihovně | /AI/Skills/lmio-knowledge/SKILL.md |
| Share | lmio-kb → mount na /workspace/lmio-kb |
| Extra tool | share_search (aktivuje se se skillem) |
K čemu slouží
Použijte, když jde o pravdu produktu nebo dodaný obsah:
- „Jak funguje X v LogMan.io?“
- Konfigurace, architektura a nasazení z produktové dokumentace
- OpenAPI / API schema před psaním živého volání
- „Existuje už korelační pravidlo / parser / dashboard pro Y?“ proti snapshotu Common Library
- Kontrola chování proti oficiální referenci
Share je pro agenta read-only.
Nepište do /workspace/lmio-kb.
K čemu neslouží
| Potřeba | Použijte |
|---|---|
| Živé HTTP volání na instanci | lmio-rest-api |
| Dotaz na log/event data | lmio-query |
| Psaní nebo publikace detekčních pravidel | lmio-detection-engineer |
| Tenant-specifická paměť / gotchas | facts |
| Osobní research poznámky | llm-wiki |
Jak funguje recall
Aktivujte skill library_read na /AI/Skills/lmio-knowledge/SKILL.md (mountuje lmio-kb).
Pak preferujte nejlehčí cestu k odpovědi:
| Kdy | Jak |
|---|---|
| Orientace / najít cestu | read_file → /workspace/lmio-kb/index.zon (ZON katalog indexovaného obsahu) |
| Neznámá cesta, sémantické nebo keyword hledání | share_search na share lmio-kb, pak read_file hitů |
| Známá cesta souboru | read_file nebo grep pod /workspace/lmio-kb |
Užitečné globy pro share_search
| Glob | Obsah |
|---|---|
docs/**/*.md |
Produktová dokumentace |
docs/api/reference/openapi/* |
OpenAPI specifikace |
lmio-common-library/Correlations/**/*.yaml |
Korelační pravidla |
lmio-common-library/Parsers/** |
Parser pipeline |
lmio-common-library/Dashboards/** |
Dashboardy |
lmio-common-library/** |
Jakýkoli obsah Common Library |
Příklad — sémantické hledání v dokumentaci:
share_search
share: lmio-kb
similar: correlation rules
glob: docs/**/*.md
topk: 10
Pokud share není indexovaný (chybí .zvec), použijte grep pod /workspace/lmio-kb.
Nevymýšlejte obsah dokumentace.
Proč na tom záleží
lmio-kb drží těžký referenční materiál mimo system prompt a mimo živý cluster, dokud není potřeba.
Agent cituje cesty Knihovny / knowledge base, což odpovídá tomu, jak operátoři LogMan.io přemýšlí o obsahu.
Query (lmio-query)
Skill query učí agenta psát, validovat a spouštět analytické dotazy na log, event a metric data LogMan.io.
| Název skillu | lmio-query |
| Cesta v Knihovně | /AI/Skills/lmio-query/SKILL.md |
| Share | lmio (přihlašovací údaje instance a související soubory pod /workspace/lmio/) |
| Závisí na | lmio-rest-api pro HTTP přístup k Chart a souvisejícím API |
K čemu slouží
- Hledat, počítat, analyzovat nebo vizualizovat log data
- Bezpečnostní vyšetřování (lateral movement, brute force, exfiltrace, privilege escalation, …)
- Provozní otázky (počty událostí, top zdroje, časové osy)
- Detekce vzorů v síti, procesech, autentizaci, souborech, DNS a souvisejících ECS polích
Typické formulace: „najdi X v logách“, „kolik Y za posledních N hodin“, „huntuj …“, „ukaž mi …“.
K čemu neslouží
| Potřeba | Použijte |
|---|---|
| Správa alertů / ticketů | lmio-rest-api pro lmio-alerts |
| Psaní nebo publikace korelačních pravidel | lmio-detection-engineer |
| Konfigurace parserů | detection / parser workflow, ne tento skill |
| Čistá produktová dokumentace | lmio-knowledge |
Předpoklady
Před dotazováním agent potřebuje:
- Název instance — načte přihlašovací údaje z
/workspace/lmio/{instance}.json(BASE_URL+API_KEY) - Tenant na instanci — pokud neznáte, objevte helperem REST skillu:
python3 /library/AI/Skills/lmio-rest-api/scripts/lmio-api-get-tenants.py {instance}
Workflow (shrnutí)
Skill kóduje opakovatelnou smyčku:
- Seznam datasources —
GET /api/lmio-chart/{tenant}/datasources -
Volba datasource — pojmenování
<provider>.<name>:Provider Technologie Použití esElasticsearch Události a logy — téměř vždy začněte es.events(data lake)ixInfluxDB Časové řady metrik (často tenant system)dbDuckDB Agregované ingest / EPS metriky -
Průzkum schématu —
GET /api/lmio-chart/{tenant}/fields/{datasource}(autoritativní seznam polí; ECS orientace) - Autor query YAML — agregující nebo neagregující Chart query dokumenty
- Spuštění přes REST helpery / Chart API
- Iterace — upřesnění filtrů, časového rozsahu a agregací z reálných výsledků; ověřte naplnění polí před spoléháním na ně
Detailní gramatika filtrů, typy SP-Lang, poznámky k DuckDB analýze a cheatsheety jsou v referencích Knihovny pod /AI/Skills/lmio-query/references/.
Poznámky k návrhu
- Preferujte potvrzení schématu a přítomnosti dat před hádáním názvů polí
- Velké výsledky ukládejte do souborů v
/workspace, ne do kontextu konverzace - Citace by měly uvádět datasource, časový rozsah a identifikující pole události, aby analytik mohl najít v Discover / Chart
LogMan.io REST API (lmio-rest-api)
Skill REST API je obecný most ze sandboxu na živou instanci LogMan.io. Ostatní skills (query, detection engineering) na něm staví.
| Název skillu | lmio-rest-api |
| Cesta v Knihovně | /AI/Skills/lmio-rest-api/SKILL.md |
| Share | lmio → přihlašovací údaje na /workspace/lmio/{instance}.json |
K čemu slouží
- Autentizované HTTP volání na mikroslužby LogMan.io (přes URL instance / NGINX)
- Objev tenantů
- Úkoly „zavolej toto API“, které nepokrývá konkrétnější skill
- Podpůrné skripty pro
lmio-query, detection engineering a provoz
Přihlašovací údaje a soubory instance
Každá instance, kterou agent může volat, je popsána JSON souborem na share lmio:
/workspace/lmio/{instance}.json # BASE_URL + API_KEY
API klíč jde v hlavičce Authorization.
Klíče držte na share; nelepte je do chatu zbytečně.
Dodané skripty
Dokumentace a reference skillu jsou v Knihovně; spouštějte skripty z mountu Knihovny v sandboxu:
/library/AI/Skills/lmio-rest-api/scripts/
Nekopírujte skript přes library_read do /workspace jen kvůli spuštění.
| Skript | Role |
|---|---|
lmio-api-get-tenants.py |
Seznam tenantů (GET /api/seacat-auth/tenant) |
lmio-api.py |
Obecný autentizovaný CLI (metoda, cesta, tělo, formát výstupu) |
Příklad:
python3 /library/AI/Skills/lmio-rest-api/scripts/lmio-api-get-tenants.py mylmio
python3 /library/AI/Skills/lmio-rest-api/scripts/lmio-api.py mylmio \
GET /api/lmio-chart/mytenant/datasources
Výstup a náklady na kontext
CLI ve výchozím stavu používá výstup ZON (Zero Overhead Notation), aby velké API odpovědi spotřebovaly méně tokenů než pretty JSON.
Pretty JSON jen když musí číst člověk; velká těla pište do souborů v /workspace místo dumpu do výsledku nástroje.
Request body
Preferujte JSON těla přes stdin v shell_exec (nebo soubor z write_file) místo obřího JSON v řetězci příkazu.
Vyhnete se chybám uvozovek a příkazy zůstanou čitelné.
Reference v Knihovně
Pod /AI/Skills/lmio-rest-api/references/ skill dodává poznámky k endpointům, správě API klíčů a příklady (např. email přes messaging integrace).
Aktivujte skill a library_read těchto cest podle potřeby.
DevOps (devops)
Skill devops specializuje agenta na přístup k infrastruktuře: SSH, konektivita hostů, vzdálená administrace a troubleshooting serverů.
| Název skillu | devops |
| Cesta v Knihovně | /AI/Skills/devops/SKILL.md |
K čemu slouží
- Dosáhnout na vzdálené hosty ze sandboxu přes SSH / SCP
- Diagnostika sítě a služeb (
dig,curl, vzdálenýsystemctl, …) - Aplikovat změny konfigurace na serverech, když to operátor požádá
- Použít skriptování v sandboxu (jq/yq, Python, shell) jako část infra workflow
Není potřeba pro běžnou lokální práci jen se soubory pod /workspace.
Aktivujte ho, když úkol opustí sandbox a mluví s reálnou infrastrukturou.
Jak agent se skillem pracuje
- Analýza — jen lokálně vs. vzdáleně; hostname/IP; uživatel; přihlašovací údaje mimo výchozí klíč; požadovaný výsledek
- Sběr —
web_fetchpro veřejnou dokumentaci nebo šablony, když pomůže - Provedení —
shell_exec,read_file,write_file(skripty v/workspace, pak jednoduché vzdálené volání) - Ověření — exit kódy, znovu dotaz stavu, report úspěchu nebo selhání s důkazy
Sandbox a SSH
Obraz sandboxu obsahuje OpenSSH klienta. Klíč může být připraven pro automatizační SSH (viz konfigurace harnessu / sandboxu).
Doporučený vzor (vyhne se chybám vnořených uvozovek):
write_fileskript nebo payload pod/workspaceshell_execjednoduchý příkaz jakoscp/sshs tím souborem- Potvrzení stavu na vzdáleném hostu následným příkazem
Příklad:
scp /workspace/script.sh user@host:/tmp/
ssh user@host "bash /tmp/script.sh"
Bezpečnost a řízení
Vzdálená administrace má vysoký dopad.
Kombinujte skill s vettingem, aby destruktivní nebo široké vzory shell_exec čekaly na schválení operátora.
Preferujte read-only diagnostiku před zápisy; jasně popište, co se na vzdáleném hostu změní.
Site-specific reference
Nasazení mohou přidat poznámky k infrastruktuře pod references/ skillu (seznamy hostů, sítě, jump hosty) v Knihovně nebo na share.
Zákaznické inventáře držte mimo výchozí prompt; načtěte je, když skill potřebuje.
Související
- Sandbox harnessu — kde SSH skutečně běží
lmio-rest-api— pro operace LogMan.io produktu preferujte API, kde existuje
Agenti
Agenti jsou cílově orientované, dlouho běžící workflow harnessu. Na rozdíl od chatu ve volné formě je agent spuštěn s definovanou třídou a parametry, vlastní jednu nebo více konverzací a sandboxů a prochází explicitním stavovým strojem směrem k výstupu (artefakty, reporty, parsery a podobně).
Agenti jsou hlavní cesta k plné autonomii: mohou běžet s minimálním nebo bez interaktivního chatu, zatímco harness stále zaznamenává auditní stopu a může u citlivých nástrojů použít vetting.
Vztah agentů a konverzací
| Konverzace | Agent | |
|---|---|---|
| Zahájení | Uživatel (nebo plán / delegate) | Uživatel z New Agent, nebo automatizace |
| Řízení | Otevřené chatové tahy | Stavový stroj s pojmenovanými fázemi |
| Úspěch | Uživatel rozhodne, že vlákno je hotové | Agent dosáhne koncového stavu a může publikovat artefakty |
| Sandbox | Na vyžádání, když to nástroje potřebují | Často vytvořen při nastavení agenta |
Agent může interně otevírat konverzace, když potřebuje LLM reasoning nebo nástroje. Záznam agenta v UI zobrazuje výstup konzole, propojené konverzace, sandboxy a artefakty.
Třídy agentů
Produkt dodává několik tříd agentů (dostupnost závisí na verzi a konfiguraci):
| Agent | Účel |
|---|---|
| Parser Builder | Autonomně generovat a validovat log parsery ze vzorových logů |
| Detection Agent | Autonomní práce zaměřená na detekce |
| Triage Agent | Obohacení a prioritizace alertů v širším kontextu |
| Hunting Agent | Strukturované threat-hunting běhy |
| Response Agent | Playbooky zaměřené na reakci |
Každá třída má schéma parametrů (a UI schéma), takže operátor před spuštěním vyplní požadované vstupy.
Životní cyklus
- Operátor zvolí třídu agenta a vyplní parametry (model, vstupy, …)
- Harness vytvoří záznam agenta a spustí ho na pozadí
- Agent podle potřeby vytváří sandboxy / konverzace, spouští nástroje a skills a loguje průběh
- Po úspěchu uloží artefakty (soubory ze sandboxu nebo zapsané agentem)
- Sandboxy mohou být označeny k ukončení; záznam agenta zůstane pro kontrolu
Chyby jsou uloženy na agentu (error + čas dokončení), aby operátor viděl, co běh zastavilo.
Agent vs. chat
- Použijte konverzaci, když chcete řídit, zkoumat nebo řešit ad-hoc otázky
- Použijte agenta, když jde o známý, ohraničený workflow, který by měl bez dohledu každého tahu skončit artefakty
- Kombinujte: začněte v chatu a předejte hromadnou práci agentu; nebo spusťte agenta a zasáhněte jen při vettingu nástroje
V UI
- New Agent — výběr třídy a konfigurace parametrů
- Agents — seznam běžících a dokončených agentů, detail (konzole, konverzace, artefakty)
Plány (Schedules)
Plány nechávají harness spouštět práci bez interaktivní chat relace. Jsou opakující se část autonomního provozu vedle agentů.
Co je plán
Plán je úloha harnessu, která se spustí jednou nebo periodicky:
- Schedule expression — cron-like řetězec nebo zpoždění
- Timezone — časové pásmo pro výraz (výchozí UTC)
- Instructions — co má agent udělat při spuštění
- Conversation — úloha může být vázaná na konverzaci, kterou harness vytvoří nebo pokračuje
- Status — scheduled, running, finished nebo error, s počtem běhů a časy last/next run
Úlohy vytváří operátoři v UI nebo agent přes nástroj schedule v konverzaci.
Typické použití
- Periodické kontroly zdraví nebo pokrytí („každé pondělí shrň nové neúspěšné log sources“)
- Opakované hunty nebo koncepty reportů
- Follow-up po zpoždění („za 24 h znovu zkontroluj tento IOC“)
- Údržba, která nesmí záviset na tom, že někdo sedí v chatu
Autonomie a řízení
Plány běží pod stejnými pravidly harnessu jako chat:
- Nástroje stále jdou přes sandbox
- Vetting může pozastavit citlivé volání
- Audit log zaznamená položky konverzace a spuštění nástrojů z úlohy
Plán může zůstat plně autonomní, nebo ho kombinovat s vettingem a pozdější kontrolou v Conversations / Schedules.
V UI
- Schedules — seznam úloh, detail (výraz, stav, propojená konverzace, chyby)
- Z živé konverzace agent může vytvořit úlohu nástrojem
schedule; pak se objeví v seznamu
Reference
TeskaLabs LogMan.io Referenční příručka
Vítejte v Referenční příručce. Zde naleznete definice a detaily o každé komponentě LogMan.io.
Kolektor
LogMan.io Collector
TeskaLabs LogMan.io Collector je mikroslužba zodpovědná za sběr logů a dalších událostí z různých vstupů a jejich odesílání do LogMan.io Receiver.
- Pro nastavení sběru událostí z dalších zdrojů logů viz podkapitolu Log sources.
- Pro popis konfigurace viz Configuration.
- Pro podrobné možnosti konfigurace viz Inputs, Transformations a Outputs.
- Pro přesměrování logů do jiných systémů viz Forwarding Logs.
- Pro vytvoření simulátoru logů viz Mirage.
- Pro podrobnosti komunikace mezi Collectorem a Receiverem viz dokumentaci LogMan.io Receiver.
Zdroje logů
Syslog
Shromažďování logů ze Syslog
Pro shromažďování logů z různých Syslog zdrojů, TeskaLabs LogMan.io Collector poskytuje možnost nastavit TCP a/nebo UDP příjmový port, který vyhovuje široké škále Syslog protokolů. Můžete jednoduše nakonfigurovat zdroj logů (například Linux server nebo síťové zařízení), aby posílal logy do kolektoru, typicky na port 514 (TCP a/nebo UDP) a TeskaLabs LogMan.io Collector tyto logy zpracuje.
Tip
Syslog protokol typicky používá port 514, TCP nebo UDP, ale TeskaLabs LogMan.io Collector může být nakonfigurován tak, aby používal i jiné porty.
Pro využití této funkce nakonfigurujte své zdroje logů, aby přeposílaly logy na port 514, 1514 nebo 6514, UDP, TCP nebo SSL TeskaLabs LogMan.io Collector. TeskaLabs LogMan.io Collector automaticky detekuje původ příchozích dat a podle toho je kategorizuje do proudů (event lanes).
Chytrá klasifikace
TeskaLabs LogMan.io Collector klasifikuje příchozí logy pomocí chytré funkce. To umožňuje pohodlnou schopnost nakonfigurovat všechny zdroje logů, aby posílaly logy na IP adresu TeskaLabs LogMan.io Collector a konkrétní port, včetně velmi jednoduché konfigurace síťové cesty.
TeskaLabs LogMan.io Collector používá klasifikační mapu ve své YAML konfiguraci.
Konfigurace
Tento příklad ukazuje konfiguraci TeskaLabs LogMan.io Collector pro použití Syslog a chytrou klasifikaci příchozích logů na portu 514 UDP a TCP.
Název proudu je důležitý
Název proudu specifikovaný v konfiguraci LogMan.io Collector je důležitý. LogMan.io vybírá správná pravidla pro analýzu, obsah a další komponenty související se zdrojem logů na základě názvu proudu. Přečtěte si více o názvech proudů zde.
Zde je příklad minimální konfigurace, ve které budou všechny příchozí logy odeslány do proudu generic.
classification:
smart_syslog: &smart_syslog # YAML anchor referencing to both SmartDatagram and SmartStream inputs
# Všechny události jsou odeslány do proudu 'generic'
generic:
- ip: "*"
# Poslouchat na UDP 514
input:SmartDatagram:UDP514:
address: 514
smart: *smart_syslog
output: smart
# Poslouchat na TCP 514
input:SmartStream:TCP514:
address: 514
smart: *smart_syslog
output: smart
# Poslouchat na SSL 6514
input:SmartStream:SSL6514:
address: 6514
ssl: on
smart: *smart_syslog
output: smart
# Připojení k LogMan.io
output:CommLink:smart: {}
Zde je příklad konfigurace se čtyřmi proudy linux-syslog-rfc5424-1, fortinet-fortigate-1, fortinet-fortigate-2 a linux-rsyslog-1
s různými možnostmi, jak můžete klasifikovat příchozí IP adresy, porty a protokoly.
classification:
smart514: &smart514 # YAML anchor referencing to both SmartDatagram and SmartStream inputs
linux-syslog-rfc5424-1: # název proudu
- ip: "192.168.0.1" # Jedna IPv4 adresa
port: 80 # Jeden port
protocol: TCP # TCP protokol
- ip: "2001:db8::1" # Jedna IPv6 adresa
port: "1000-2000" # Rozsah portů
protocol: UDP # UDP protokol
fortinet-fortigate-1:
- ip: "10.0.0.0/8" # IPv4 rozsah
port: 14000
protocol: UDP
- ip: "fd00::/8" # IPv6 rozsah
port: "*" # Libovolný port
protocol: UDP
fortinet-fortigate-2:
- ip: "*" # Libovolná IP adresa
port: "*" # Libovolný port
protocol: UDP
linux-rsyslog-1:
- ip: "::1" # Lokální IP adresy
# Poslouchat na UDP 514
input:SmartDatagram:UDP514:
address: 514
smart: *smart514
output: smart
# Poslouchat na TCP 514 s automatickou detekcí SSL
input:SmartStream:TCP514:
address: 514
ssl: auto
smart: *smart514
output: smart
# Logy jsou přeposílány do LogMan.io pomocí CommLink
output:CommLink:smart: {}
Warning
Chytrá klasifikace funguje pouze s výstupem CommLink.
SmartDatagram a SmartStream
SmartDatagram (pro UDP) a SmartStream (pro TCP) zdroje jsou podobné Datagram/TCP a Stream/UDP zdrojům,
s další možností smart, která odkazuje na příslušnou podsekci v classification.
Poslouchání na UDP
Konfigurace pro poslouchání na UDP portu 514.
input:SmartDatagram:UDP514:
address: 514
smart: *smart_syslog
output: smart
Poslouchání na TCP
Konfigurace pro poslouchání na TCP portu 514.
input:SmartStream:TCP514:
address: 514
smart: *smart_syslog
output: smart
Poslouchání na SSL/TLS
TLS/SSL může být povoleno na input:SmartStream (TCP) pomocí konfigurační možnosti ssl.
input:SmartStream:SSL6514:
address: 6514
ssl: on
key: key.pem
cert: cert.pem
smart: *smart_syslog
output: smart
Možné hodnoty pro ssl možnosti jsou auto / on / off, výchozí je auto.
auto znamená, že jsou akceptovány jak obyčejné TCP, tak SSL/TLS, s automatickou detekcí.
Pokud není poskytnut soukromý klíč (key) a příslušný certifikát (cert), interní certifikační autorita kolektoru vygeneruje self-signed SSL certifikát.
Tip
Pokročilejší nastavení TCP/SSL jsou popsána níže.
Klasifikační mapa
Sekce classification může obsahovat jednoho nebo více klasifikátorů.
Warning
Sekce classification musí být specifikována PŘED sekcemi input:..., jinak není reference (tj. *smart_syslog) rozpoznána.
Každý klasifikátor specifikuje kombinaci rozsahů IP adres, rozsahů portů a protokolů;
a převádí je do proudu. Každý log, který dorazí do TeskaLabs LogMan.io Collector chytrého syslogu, je porovnán s těmito klasifikátory a výsledný proud je použit jako jeho cíl v LogMan.io.
Pokud není nalezen žádný shodný, log jde do generic stream (pojmenovaného generic).
Tip
Proudy lze najít v komponentě Archiv TeskaLabs LogMan.io.
linux-syslog-rfc5424-1:
- ip: "192.168.0.1"
port: 80
protocol: TCP
- ip: "2001:db8::1"
port: "1000-2000"
protocol: UDP
linux-syslog-rfc5424-1 je název proudu.
ip
- Jedna IPv4/IPv6 adresa:
92.168.0.1,2001:db8::1 - Rozsah IPv4/IPv6 adres:
10.0.0.0/8,fd00::/8 - Zástupný znak
*pro všechny IPv4/IPv6 adresy
port
- Jeden port:
5400 - Rozsah portů:
4000-8000 - Když není specifikováno nebo
*, používá se rozsah0-65535
protokol
TCP/UDP- Když není specifikováno, používají se oba TCP a UDP
* zástupný znak může být příliš široký
Ujistěte se, že zástupný znak * je uzavřen v uvozovkách v YAML "*". Asterisk bez uvozovek by porušil syntaxi YAML.
Překrývající se IP adresy a porty
IP adresy a porty se mohou překrývat.
V takovém případě je vybrán nejkonkrétnější shodný.
V následujícím příkladu je 25400 shodován s fortinet-fortigate-3, 25100 s fortinet-fortigate-2 a 24000 s fortinet-fortigate-1:
fortinet-fortigate-1:
- ip: "192.168.0.1"
port: 24000-30000
fortinet-fortigate-2:
- ip: "192.168.0.1"
port: 25000-26000
fortinet-fortigate-3:
- ip: "192.168.0.1"
port: 25400
Totéž platí pro IP adresy.
Generic stream
Pokud není během klasifikace identifikován cílový proud, log je přeposlán do proudu generic.
Příklad klasifikace proudu
Představte si, že připojujete nové zdroje logů z rozsahu IP adres 192.168.0.0/24.
Bez klasifikátoru jsou události shromažďovány do proudu generic a ukládány v Archivu.
Po prozkoumání proudů v Archivu jste zjistili, že existuje zdroj typu logsox.
Klasifikujete proud, abyste jej oddělili od ostatních příchozích dat:
logsox-1:
- ip: "192.168.0.0/24"
Při vytváření pravidel pro analýzu pro proud zjistíte, že příchozí události logsox z IP 192.168.0.68 mají jinou formu než ostatní.
Můžete tento proud izolovat a aplikovat na něj různá pravidla pro analýzu:
logsox-1:
- ip: "192.168.0.0/24"
logsox-2:
- ip: "192.168.0.68"
Názvy proudů
Výběr správného názvu proudu je důležitý, protože TeskaLabs LogMan.io určuje technologii, vybírá správná pravidla pro analýzu, dashboardy a další obsah, na základě názvu proudu.
Aby bylo možné připojit zdroj logů, který existuje v Knihovně a automaticky přiřadit správný event lane, musí název proudu odpovídat jednomu z šablon event lane umístěných ve složce /Templates/EventLanes/ v Knihovně.
Níže je tabulka, která popisuje názvy proudů používané různými technologiemi při připojování k LogMan.io Collector.
Nahraďte hvězdičku "*" na konci názvu proudu libovolným číslem.
Například můžete použít čítač (fortinet-fortigate-1, fortinet-fortigate-2, linux-rsyslog-1, ...) nebo číslo portu (fortinet-fortigate-10000, fortinet-fortigate-20000, linux-rsyslog-30000, ...).
| Název technologie | Název proudu |
|---|---|
| Apache HTTP Server | apache-http-server-* |
| Bitdefender Cloud Security | bitdefender-cloud-* |
| Bitdefender GravityZone | bitdefender-gravityzone-* |
| Blue Coat Secure Web Gateway | broadcom-blue-coat-swg-* |
| Broadcom Brocade Switch | broadcom-brocade-switch-* |
| CEF | cef-* |
| Check Point Firewall | check-point-firewall-* |
| Cisco ACI | cisco-aci-* |
| Cisco ASA | cisco-asa-* |
| Cisco FTD | cisco-ftd-* |
| Cisco IOS | cisco-ios-* |
| Cisco ISE | cisco-ise-* |
| Cisco MDS | cisco-mds-* |
| Cisco Switch Catalyst | cisco-switch-catalyst-* |
| Cisco Switch Nexus | cisco-switch-nexus-* |
| Cisco UCS | cisco-ucs-* |
| Cisco WLC | cisco-wlc-* |
| Citrix | citrix-* |
| Dell iDRAC | dell-idrac-* |
| Dell PowerVault | dell-powervault-* |
| Dell Switch | dell-switch-* |
| Devolutions Web Server | devolutions-web-server-* |
| EATON UPS | eaton-ups-* |
| ESET Protect | eset-protect-* |
| F5 | f5-* |
| FileZilla | filezilla-* |
| Fortinet FortiClient | fortinet-forticlient-* |
| Fortinet FortiGate | fortinet-fortigate-* |
| Fortinet FortiMail | fortinet-fortimail-* |
| Fortinet FortiSwitch | fortinet-fortiswitch-* |
| Generic | generic |
| Gordic Ginis | gordic-ginis-* |
| HAProxy | haproxy-* |
| Helios | helios-* |
| HPE Aruba ClearPass | hpe-aruba-clearpass-* |
| HPE Aruba IAP | hpe-aruba-iap-* |
| HPE Aruba IAP | hpe-aruba-switch-* |
| HPE iLO | hpe-ilo-* |
| HPE LaserJet Series | hpe-laserjet-* |
| HPE Primera | hpe-primera-* |
| HPE StoreOnce | hpe-storeonce-* |
| IBM QRADAR | ibm-qradar-* |
| IBM Tape Library | ibm-tape-library-* |
| IceWarp | icewarp-mailserver-* |
| Ivanti Security | ivanti-security-* |
| Kubernetes | kubernetes-* |
| Lenovo XClarity Controller | lenovo-xcc-* |
| Linux Auditd | linux-auditd-* |
| Linux Rsyslog | linux-rsyslog-* |
| Linux Syslog RFC 3164 | linux-syslog-rfc3164-* |
| Linux Syslog RFC 5424 | linux-syslog-rfc5424-* |
| ManageEngine AD Audit Plus | manageengine-ad-audit-plus-* |
| McAfee Webwasher | mcafee-webwasher-* |
| Microsoft DHCP | microsoft-dhcp-* |
| Microsoft DNS | microsoft-dns-* |
| Microsoft Exchange | microsoft-exchange-* |
| Microsoft IIS | microsoft-iis-* |
| Microsoft SQL Server | microsoft-sql-server-* |
| MikroTik | mikrotik-* |
| Minolta Bizhub | minolta-bizhub-* |
| NetApp FAS | netapp-fas-* |
| NetApp Storage | netapp-storage-* |
| Nginx | nginx-* |
| Ntopng | ntopng-* |
| OpenStack Audit HTTP Request | openstack-* |
| OpenVPN | openvpn-* |
| Oracle Cloud | oracle-cloud-* |
| Oracle Listener | oracle-listener-* |
| Oracle Spark | oracle-spark-* |
| PaloAlto | palo-alto-* |
| PfSense | pfsense-* |
| QNAP NAS | qnap-nas-* |
| Samba Active Directory Domain Controller | samba-ad-dc-* |
| SentinelONE | sentinelone-* |
| Siemens Scalance | siemens-scalance-* |
| Sophos Device Standard Format | sophos-device-standard-format-* |
| Sophos Standard Syslog Protocol | sophos-standard-syslog-protocol-* |
| Sophos Unstructured Format | sophos-unstructured-* |
| Squid Proxy | squid-proxy-* |
| Synology NAS | synology-nas-* |
| Syslog RFC 3164 | syslog-rfc3164-* |
| Syslog RFC 5424 | syslog-rfc5424-* |
| Ubiquiti UniFi | ubiquiti-unifi-* |
| Veeam Backup & Replication | veeam-backup-replication-* |
| VMware Cloud Director | vmware-vcloud-director-* |
| VMware ESXi | vmware-esxi-* |
| VMware vCenter | vmware-vcenter-* |
| Whalebone | whalebone-* |
| Microsoft Windows Events (via Winlogbeat) | winlogbeat |
| Wowza Streaming Engine | wowza-* |
| ySoft SafeQ | ysoft-safeq-* |
| ZyXEL Firewall | zyxel-firewall-* |
| ZyXEL Switch | zyxel-switch-* |
Example
Příklad konfigurace tří zdrojů logů přes TCP/UDP:
- Dva zdroje Fortinet FortiGate na portech 10000 a 20000
- Jeden zdroj Linux Rsyslog na portu 30000
# Fortinet FortiGate on port 10000
input:TCP:fortinet-fortigate-1:
address: 10000
output: fortinet-fortigate-1
output:CommLink:fortinet-fortigate-1: {}
# Fortinet FortiGate on port 20000
input:TCP:fortinet-fortigate-2:
address: 20000
output: fortinet-fortigate-2
output:CommLink:fortinet-fortigate-2: {}
# Linux Rsyslog on port 30000
input:TCP:linux-rsyslog-1:
address: 30000
output: linux-rsyslog-1
output:CommLink:linux-rsyslog-1: {}
Dedikované syslog porty
TeskaLabs LogMan.io Collector lze nakonfigurovat tak, aby poskytoval dedikovaný port(y) pro konkrétní Syslog / TCP / UDP / SSL zdroj logů. Užitečné v složitějších nasazeních.
Syslog má (alespoň) dvě varianty: starší BSD syslog / RFC3164 a novější IETF / RFC5424.
TCP vs UDP
TCP (Transmission Control Protocol) a UDP (User Datagram Protocol) jsou protokoly pro odesílání dat po síti.
TCP je stream — spolehlivé, uspořádané doručení s kontrolou chyb.
UDP je datagram — pakety nezávisle, rychlejší přenos, menší spolehlivost a bez garantovaného pořadí.
Logy posílejte přes TCP. UDP použijte jen pokud TCP není možné.
Tip
Pro diagnostiku použijte tcpdump pro zachycení síťového provozu a Wireshark pro analýzu.
Příklad zachycení provozu na TCP/10008:
$ sudo tcpdump -i any tcp port 10008 -s 0 -w /tmp/capture.pcap -v
Po zachycení dostatečného provozu stiskněte Ctrl-C a použijte soubor /tmp/capture.pcap se zachyceným provozem.
Soubor otevřete ve Wireshark.
Naslouchání na dedikovaném TCP
input:TCP:syslogtcp:
address: 514
output: syslog
Alternativní název sekce
input:TCP má ekvivalent input:Stream pro logy na stream socket včetně UNIX socket.
Naslouchání na dedikovaném UDP
input:UDP:syslogudp:
address: 514
output: syslog
Alternativní název sekce
input:UDP má ekvivalent input:Datagram pro datagram socket včetně UNIX socket.
Další volby:
max_packet_size: Maximální velikost paketů v bajtech (výchozí: 65536)receiver_buffer_size: Limit velikosti receive bufferu v bajtech (výchozí: 0)
address
Možné formy address:
8080nebo*:8080: Port 8080 na všech rozhraních IPv4 a IPv60.0.0.0:8080: Port 8080 na všech rozhraních IPv4:::8080: Port 8080 na všech rozhraních IPv61.2.3.4:8080: Port 8080 na konkrétním rozhraní IPv4::1:8080: Port 8080 na konkrétním rozhraní IPv6/tmp/unix.sock: UNIX socket/tmp/unix.sock
Syslog framing
Na rozdíl od UDP, kde každý datagram je jedna zpráva, TCP doručuje kontinuální byte stream. Kolektor musí znát framing odesílatele pro rozdělení streamu na události.
input:TCP (a input:Stream) používá newline-delimited framing: řádek ukončený LF (výchozí) je jedna událost.
Funguje pro line-oriented logy, ale nerozumí syslogu.
Dedikované syslog TCP vstupy používají handlery s syslog framingem. Použijte je, když zdroj posílá syslog přes TCP s RFC 6587 octet counting nebo BSD newline-delimited syslog.
| Input | Framing | Kdy použít |
|---|---|---|
input:TCP |
Newline-delimited (LF výchozí, delimiter) |
Nelogové line-oriented zdroje nebo syslog bez vnořených newline |
input:TCPBSDSyslogRFC6587 |
RFC 6587 octet counting | RFC 6587 odesílatelé (FortiGate, Palo Alto) |
input:TCPBSDSyslogNoFraming |
Newline s detekcí hranic syslog | BSD / RFC 3164 syslog přes TCP (rsyslog, syslog-ng plain TCP) |
Framing musí odpovídat odesílateli
Nesoulad framingu rozdělí zprávy špatně nebo uzavře spojení.
RFC 6587 na input:TCPBSDSyslogNoFraming dá rozbité události; newline odesílatel na input:TCPBSDSyslogRFC6587 uzavře spojení, pokud length prefix není číslo.
Pro smart syslog na TCP (input:SmartStream) je výchozí framing newline (line).
Per-stream framing v mapě: framing: syslog-rfc6587 nebo framing: syslog-noframing (viz RFC 3164, section 4.1.1).
RFC 6587 octet counting (input:TCPBSDSyslogRFC6587)
RFC 6587 definuje non-transparent framing: délka v bajtech, mezera, payload. Payload může obsahovat newline; kolektor čte přesně deklarovaný počet bajtů.
Příklad na wire:
<N> <syslog message payload>
Například 65b payload: 65 <134>1 2020-10-11T22:14:15.003Z host - - - An example message.
Oproti input:TCP:
- Hranice zprávy určuje length prefix, ne newline.
- Víceřádkový syslog je jedna událost.
- Neplatný length prefix uzavře spojení.
input:TCPBSDSyslogRFC6587:syslogrfc6587:
address: 514
output: <stream-name>
Volitelné:
max_sane_msg_len: Maximální velikost syslog zprávy v bajtech (výchozí: 10000)
BSD newline syslog (input:TCPBSDSyslogNoFraming)
Syslog přes TCP s newline ukončením podle RFC 3164, section 4.1.1.
Lepší než input:TCP — hranice pomocí PRI a timestamp heuristik.
Řádek, který nevypadá jako začátek syslog zprávy, se připojí k předchozí zprávě.
input:TCPBSDSyslogNoFraming:syslognoframes:
address: 514
output: <stream-name>
Volitelné:
buffer_size: Maximální buffer při reassemblaci (výchozí: 64 * 1024)variant: Detekce hranic (výchozí:auto):standard,nopri,auto
TLS/SSL
Libovolný TCP vstup může použít TLS/SSL přes key, cert a/nebo ssl u smart syslog.
Příklad TLS vyžadujícího klientský certifikát od důvěryhodné CA:
input:TCP:ssl-syslog:
address: 6514
output: <stream-name>
cert: /conf/server_cert_chain.pem
key: /conf/server_key.pem
verify_mode: CERT_REQUIRED
cafile: ./conf/ca.pem
TLS volby:
cert: Server SSL certifikát (řetězec) PEMkey: Soukromý klíč PEMkey_password: Heslo klíče (volitelné)cafile,capath,cadata: CA pro ověření klientaverify_mode:CERT_NONE,CERT_OPTIONALneboCERT_REQUIREDciphers,dh_params
Tip
V kontejneru je prefix cest k PEM /conf/, mapovaný na host konfiguraci.
Příklad syslog přes TLS s RFC 6587:
input:TCPBSDSyslogRFC6587:sslsyslog:
address: 6514
output: syslog
cert: ./etc/server-cert.pem
key: ./etc/server-key.pem
Shromažďování logů pomocí rsyslog
rsyslog je vysoce výkonný, open-source, modulární syslog démon běžně instalovaný na Linuxových systémech, navržený pro shromažďování, analýzu a odesílání systémových a aplikačních logů. Je základem spolehlivých logových pipeline, protože podporuje moderní protokoly a formáty, silnou bezpečnost přenosu (TLS) a robustní vyrovnávací paměť s diskově asistovanými frontami, které zabraňují ztrátě dat během přerušení sítě. Se svým flexibilním pravidlovým enginem může rsyslog obohacovat události, odstraňovat šum, označovat zdroje a rozdělovat je na více cílů – což ho činí ideálním pro předávání logů do TeskaLabs LogMan.io ve velkém měřítku.
Instalace
Linux Ubuntu
# sudo apt install rsyslog rsyslog-gnutls
Konfigurace
Následující sekce představuje konfiguraci rsyslog připravenou pro produkční prostředí pro předávání logů do TeskaLabs LogMan.io přes TLS.
/etc/rsyslog.d/to-logman.conf:
*.* action(
type="omfwd"
protocol="tcp"
target="<IP adresa kolektoru>"
port="514"
KeepAlive="on"
queue.type="LinkedList"
queue.size="10000"
# Následující řádky povolují šifrování TLS/SSL
# výchozí port smart syslog na TeskaLabs LogMan.io automaticky detekuje příchozí TLS/SSL připojení.
StreamDriver="gtls"
StreamDriverMode="1"
StreamDriverAuthMode="anon"
)
Změny se aplikují pomocí:
# sudo systemctl restart rsyslog.service
Otestujte konfiguraci pomocí:
# logger -t rsyslog-test "Ahoj z $(hostname)"
Tip
Povolte modul MARK v /etc/rsyslog.conf, aby se periodicky vysílaly zprávy -- MARK --, což usnadňuje rozpoznání tichých nebo odpojených odesílatelů.
module(load="immark")
Microsoft Windows
Sběr logů z Microsoft Windows
Existuje více způsobů sběru logů nebo Windows Events z Microsoft Windows.
Windows Event Collector (WEC/WEF)
Agent-less Windows Event Collector (WEC) odesílá logy z Windows počítačů přes službu Windows Event Forwarding (WEF) do TeskaLabs LogMan.io Collector. TeskaLabs LogMan.io Collector pak funguje jako Windows Event Collector (WEC). Konfiguraci WEF lze nasadit pomocí Group Policy, centrálně spravované řadičem Active Directory nebo pomocí Local Group Policy. S Active Directory nejsou na jednotlivých Windows strojích další požadavky na konfiguraci.
Tip
Tuto metodu doporučujeme pro sběr Windows Events. Snadno tak implementujeme standardní připojení Windows logů s Advanced Auditing a Advanced Audit Policy.
Sysmon
Sysmon poskytuje telemetrii procesů, sítě, registru a souborů, na které závisí Windows Sigma pravidla v TeskaLabs LogMan.io Common Library a Sysmon korelace.
Nainstalujte doporučenou konfiguraci (sysmon-config-lmio.xml), povolte WEF číst kanál Sysmon a sbírejte přes WEC/WEF. Collector zahrnuje kanál Sysmon ve výchozích dotazech.
Pokračujte na konfiguraci Sysmon.
Winlogbeat
Winlogbeat je lehký shipper Windows Event logů od Elastic. Lze ho nainstalovat jako agent na Windows stroje pro sběr a přesměrování Windows Events do TeskaLabs LogMan.io Collector.
Pokračujte na nastavení Winlogbeat.
Windows Remote Management
Agent-less vzdálené připojení ke Windows počítači přes Windows Remote Management (WinRM) a spuštění sběrného příkazu jako samostatného procesu pro čtení standardního výstupu.
Pokračujte na nastavení WinRM.
Agent na Windows počítači
V této metodě TeskaLabs LogMan.io Collector běží jako agent na požadovaném Windows počítači (počítačích) a sbírá Windows Events.
Sběr z Microsoft Windows pomocí WEC/WEF
Bezagentový Windows Event Collector (WEC) odesílá logy z Windows počítačů přes službu Windows Event Forwarding (WEF) do TeskaLabs LogMan.io Collector. TeskaLabs LogMan.io Collector poté funguje jako Windows Event Collector (WEC). Konfiguraci WEF lze nasadit pomocí Group Policy, buď centrálně spravovanou serverem Active Directory nebo pomocí Local Group Policy. S Active Directory nejsou na jednotlivých Windows strojích potřeba žádné další konfigurační požadavky.

Schéma: Tok událostí sběru WEC/WEF v TeskaLabs LogMan.io.
Předpoklady
- Microsoft Active Directory Domain Controller, v tomto příkladu poskytuje doménové jméno
domain.int/DOMAIN.int - TeskaLabs LogMan.io Collector, v tomto příkladu s IP adresou
10.0.2.101a hostitelským jménemlmio-collector, běží ve stejné síti jako Windows počítače včetně Active Directory - IP adresa TeskaLabs LogMan.io Collector MUSÍ být fixní (tj. rezervovaná DHCP serverem)
- Datum a čas TeskaLabs LogMan.io Collector MUSÍ být synchronizovány pomocí NTP
- TeskaLabs LogMan.io Collector BY MĚL používat DNS server Active Directory
- TeskaLabs LogMan.io Collector MUSÍ být schopen vyřešit hostitelská jména serverů doménových kontrolerů Active Directory
- TeskaLabs LogMan.io Collector MUSÍ být schopen dosáhnout na
udp/88atcp/88porty (autentizace Kerberos verze 5) na Microsoft Active Directory Domain Controller, příslušný KDC - Všechny Windows stanice a servery MUSÍ být schopny dosáhnout na TeskaLabs LogMan.io Collector's
tcp/5985atcp/5986pro WEF audp/88,tcp/88(autentizace Kerberos) porty
Tip
Toto nastavení využívá autentizaci Kerberos. Autentizace Kerberos používá Kerberos tickety specifické pro doménu Active Directory vydávané doménovým kontrolerem pro autentizaci a šifrování přeposílání logů. Je to optimální volba pro Windows počítače, které jsou spravovány prostřednictvím domény.
Active Directory
1.1. Vytvoření nového uživatele v Active Directory
Projděte Windows Administrative Tools > Active Directory Users and Computers > DOMAIN.int > Users
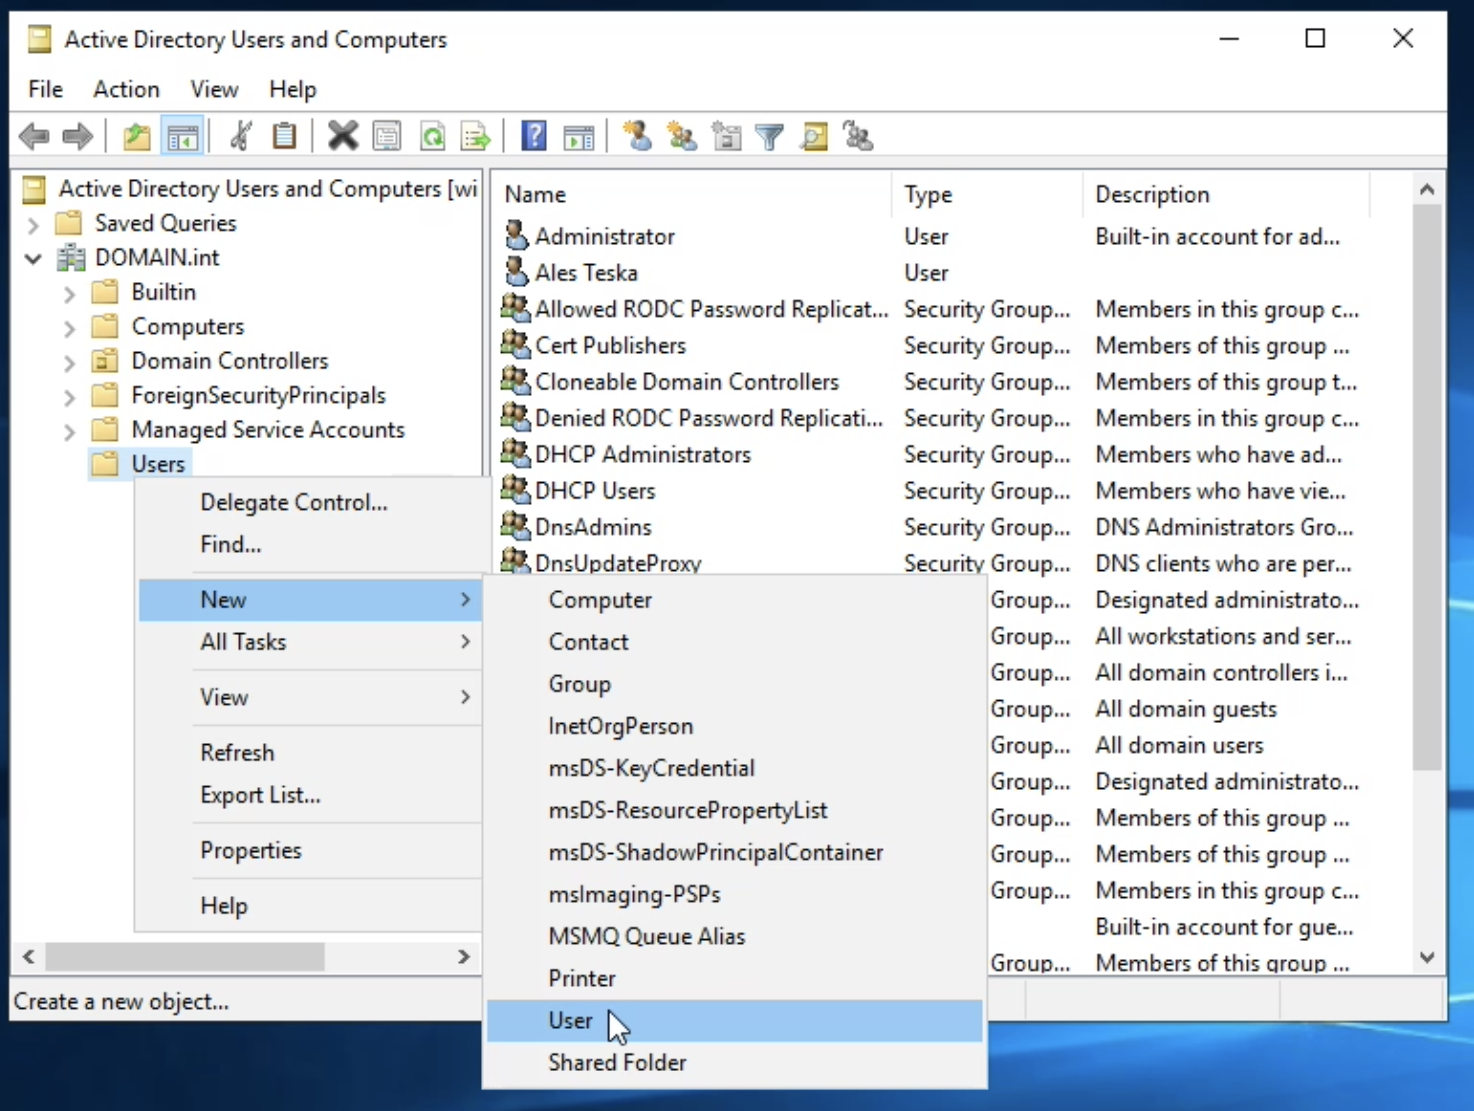
Klikněte pravým tlačítkem a vyberte New > User
Zadejte následující informace:
- Full name:
TeskaLabs LogMan.io - User logon name:
lmio-collector
Warning
Přihlašovací jméno uživatele musí být stejné jako jméno počítače TeskaLabs LogMan.io Collector. Najdete ho na obrazovce nastavení TeskaLabs LogMan.io collector.
Klikněte na "Next".
Nastavte heslo pro uživatele.
Tento příklad používá Password01!.
Warning
Použijte silné heslo podle vaší politiky. Toto heslo bude použito v pozdějším kroku tohoto postupu.
Odškrtněte "User must change password at next logon".
Zaškrtněte "Password never expires".
Klikněte na Next a poté na tlačítko Finish pro vytvoření uživatele.
Nakonec klikněte pravým tlačítkem na nového uživatele, klikněte na Properties a otevřete záložku Account.
- Zaškrtněte "This account supports Kerberos AES 128 bit encryption".
- Zaškrtněte "This account supports Kerberos AES 256 bit encryption".

Nový uživatel lmio-collector je nyní připraven.
1.2. Vytvoření A záznamu v DNS serveru pro TeskaLabs LogMan.io Collector
Použití DHCP pro rezervaci IP adresy kolektoru
Pevná IP adresa MUSÍ být přidělena TeskaLabs LogMan.io Collector. To může být provedeno "rezervováním" IP adresy v DHCP serveru Active Directory.
Projděte Windows Administrative Tools > DNS > Forward Lookup Zones > DOMAIN.int
Klikněte pravým tlačítkem a vyberte "New Host (A or AAAA)…"
Přidejte záznam s názvem lmio-collector a IP adresou 10.0.2.101.
Upravte tento záznam podle IP adresy vašeho TeskaLabs LogMan.io Collector.
Klikněte na tlačítko Add Host pro dokončení.
Tip
Nastavení DNS můžete ověřit pomocí příkazu ping.
1.3. Vytvoření hostitelského principálu
Vytvořte hostitelský principál a přidružený keytab soubor pro hostitele TeskaLabs LogMan.io Collector. Spusťte následující příkaz na příkazovém řádku serveru Active Directory Domain Controller (cmd.exe):
ktpass /princ host/lmio-collector.domain.int@DOMAIN.INT /pass Password01! /mapuser DOMAIN\lmio-collector -pType KRB5_NT_PRINCIPAL /out host-lmio-collector.keytab /crypto AES256-SHA1
Proces je citlivý na velikost písmen
Ujistěte se, že jste KAPITALIZOVALI vše, co je kapitalizováno v našich příkladech (například host/lmio-collector.domain.int@DOMAIN.INT).
Musí být KAPITALIZOVÁNO i v případě, že vaše doména obsahuje malá písmena.
Keytab soubor host-lmio-collector.keytab je vytvořen.
1.4. Vytvoření http principálu
Vytvořte servisní principál a přidružený keytab soubor pro službu:
ktpass /princ http/lmio-collector.domain.int@DOMAIN.INT /pass Password01! /mapuser DOMAIN\lmio-collector -pType KRB5_NT_PRINCIPAL /out http-lmio-collector.keytab /crypto AES256-SHA1
Keytab soubor http-lmio-collector.keytab je vytvořen.
1.5. Sběr keytab souborů ze serveru Windows
Sesbírejte dva keytab soubory z výše uvedených kroků. Nahrajete je do TeskaLabs LogMan.io v pozdějším kroku.
Skupinové politiky
2.1. Otevřete konzoli pro správu skupinových politik
Projděte Windows Administrative Tools > Group Policy Management, vyberte svou doménu, v tomto příkladu DOMAIN.int.
2.2. Vytvoření objektu skupinové politiky
V konzoli správy skupinových politik vyberte svou doménu, například DOMAIN.int.
Klikněte pravým tlačítkem na doménu a vyberte "Create a GPO in this domain, and Link it here....
Zadejte název nového GPO, "TeskaLabs LogMan.io Windows Event Forwarding", poté vyberte OK.
2.3. Konfigurace objektu skupinové politiky
Nové GPO je vytvořeno a připojeno k vaší doméně. Pro konfiguraci nastavení politiky klikněte pravým tlačítkem na vytvořené GPO a vyberte "Edit...".
Otevře se "Group Policy Management Editor" pro přizpůsobení GPO.
2.4. Konfigurace politiky přeposílání událostí v sekci Konfigurace počítače
V "Group Policy Management Editor" projděte Computer Configuration > Policies > Administative Templates > Windows Components a vyberte Event Forwarding.
Vyberte "Configure target Subscription Manager".
Povolte nastavení a vyberte Show.
Vyplňte umístění TeskaLabs LogMan.io Collector:
Server=http://lmio-collector.domain.int:5985/wsman/SubscriptionManager/WEC,Refresh=60
Stiskněte OK pro uložení nastavení.
2.5. Použití
Spusťte gpupdate /force v cmd.exe na serveru Windows.
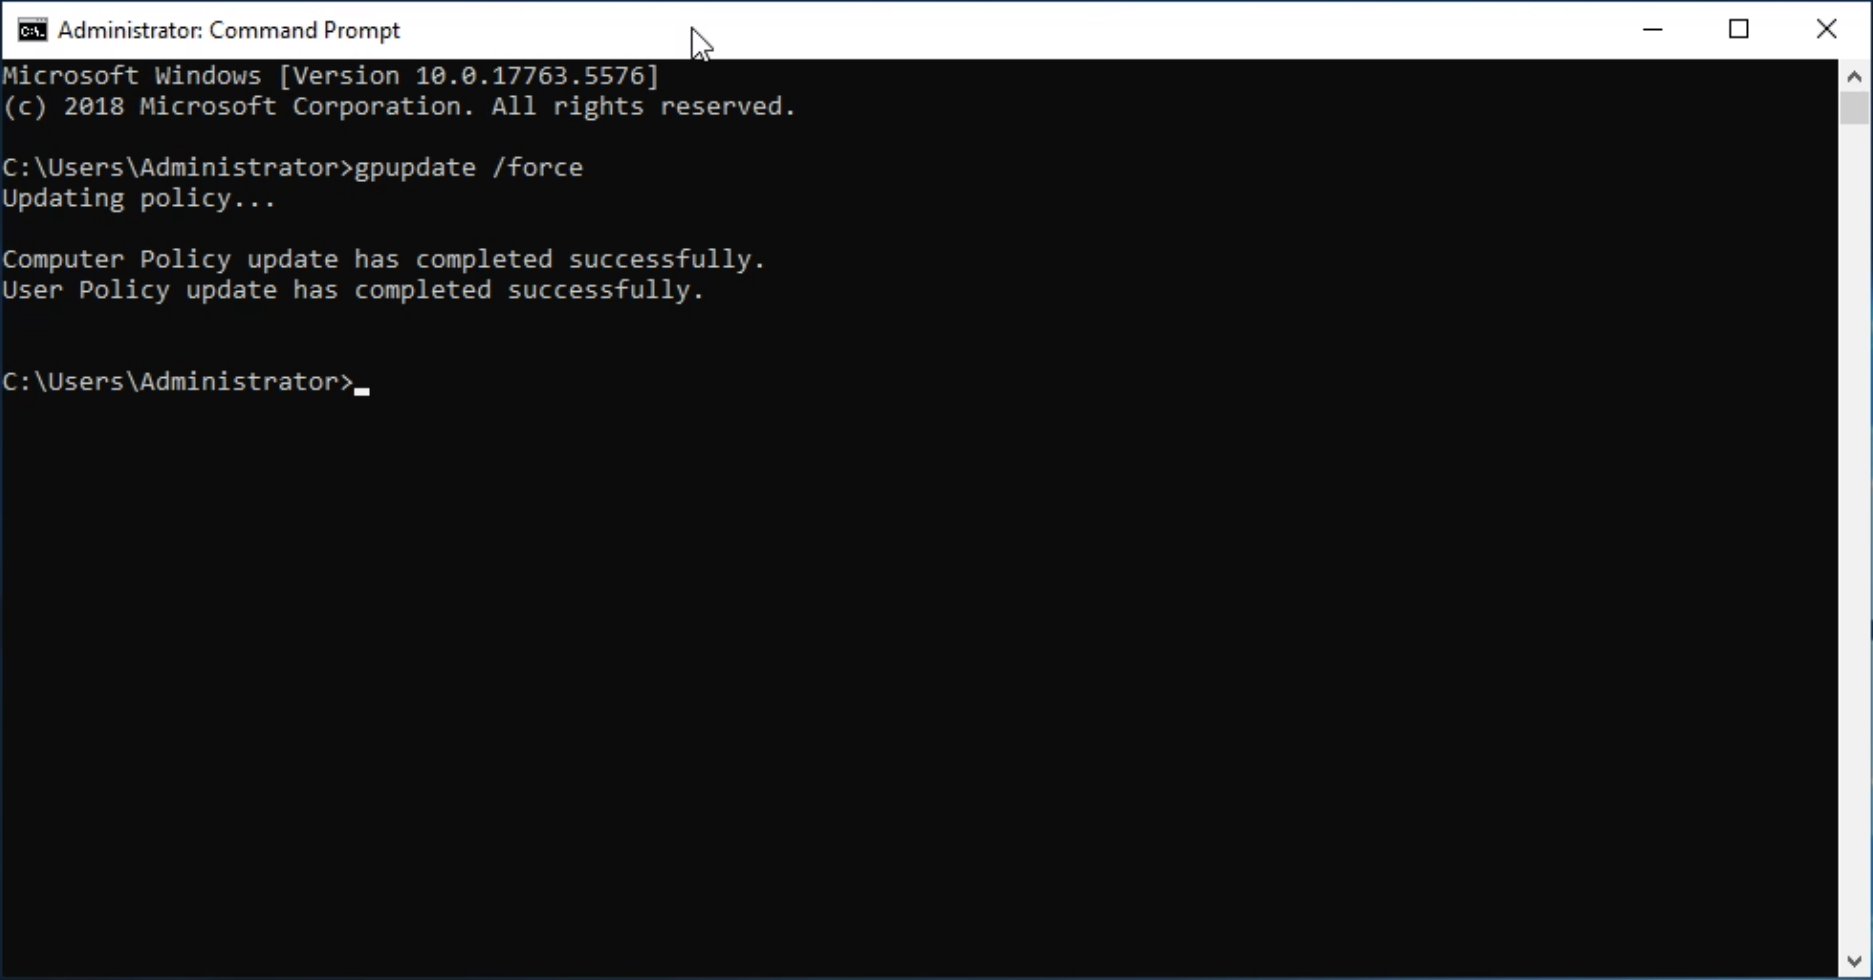
Bezpečnostní log
WEF nemůže přistupovat k bezpečnostnímu logu Windows ve výchozím nastavení.
Pro povolení přeposílání bezpečnostního logu přidejte Network Service do WEF.
Tip
Bezpečnostní log Windows je nejdůležitějším zdrojem informací o kybernetické bezpečnosti a musí být nakonfigurován.
3.1. Otevřete konzoli pro správu skupinových politik
Projděte Windows Administrative Tools > Group Policy Management, vyberte svou doménu, v tomto příkladu DOMAIN.int.
Klikněte pravým tlačítkem a vyberte "Edit...".
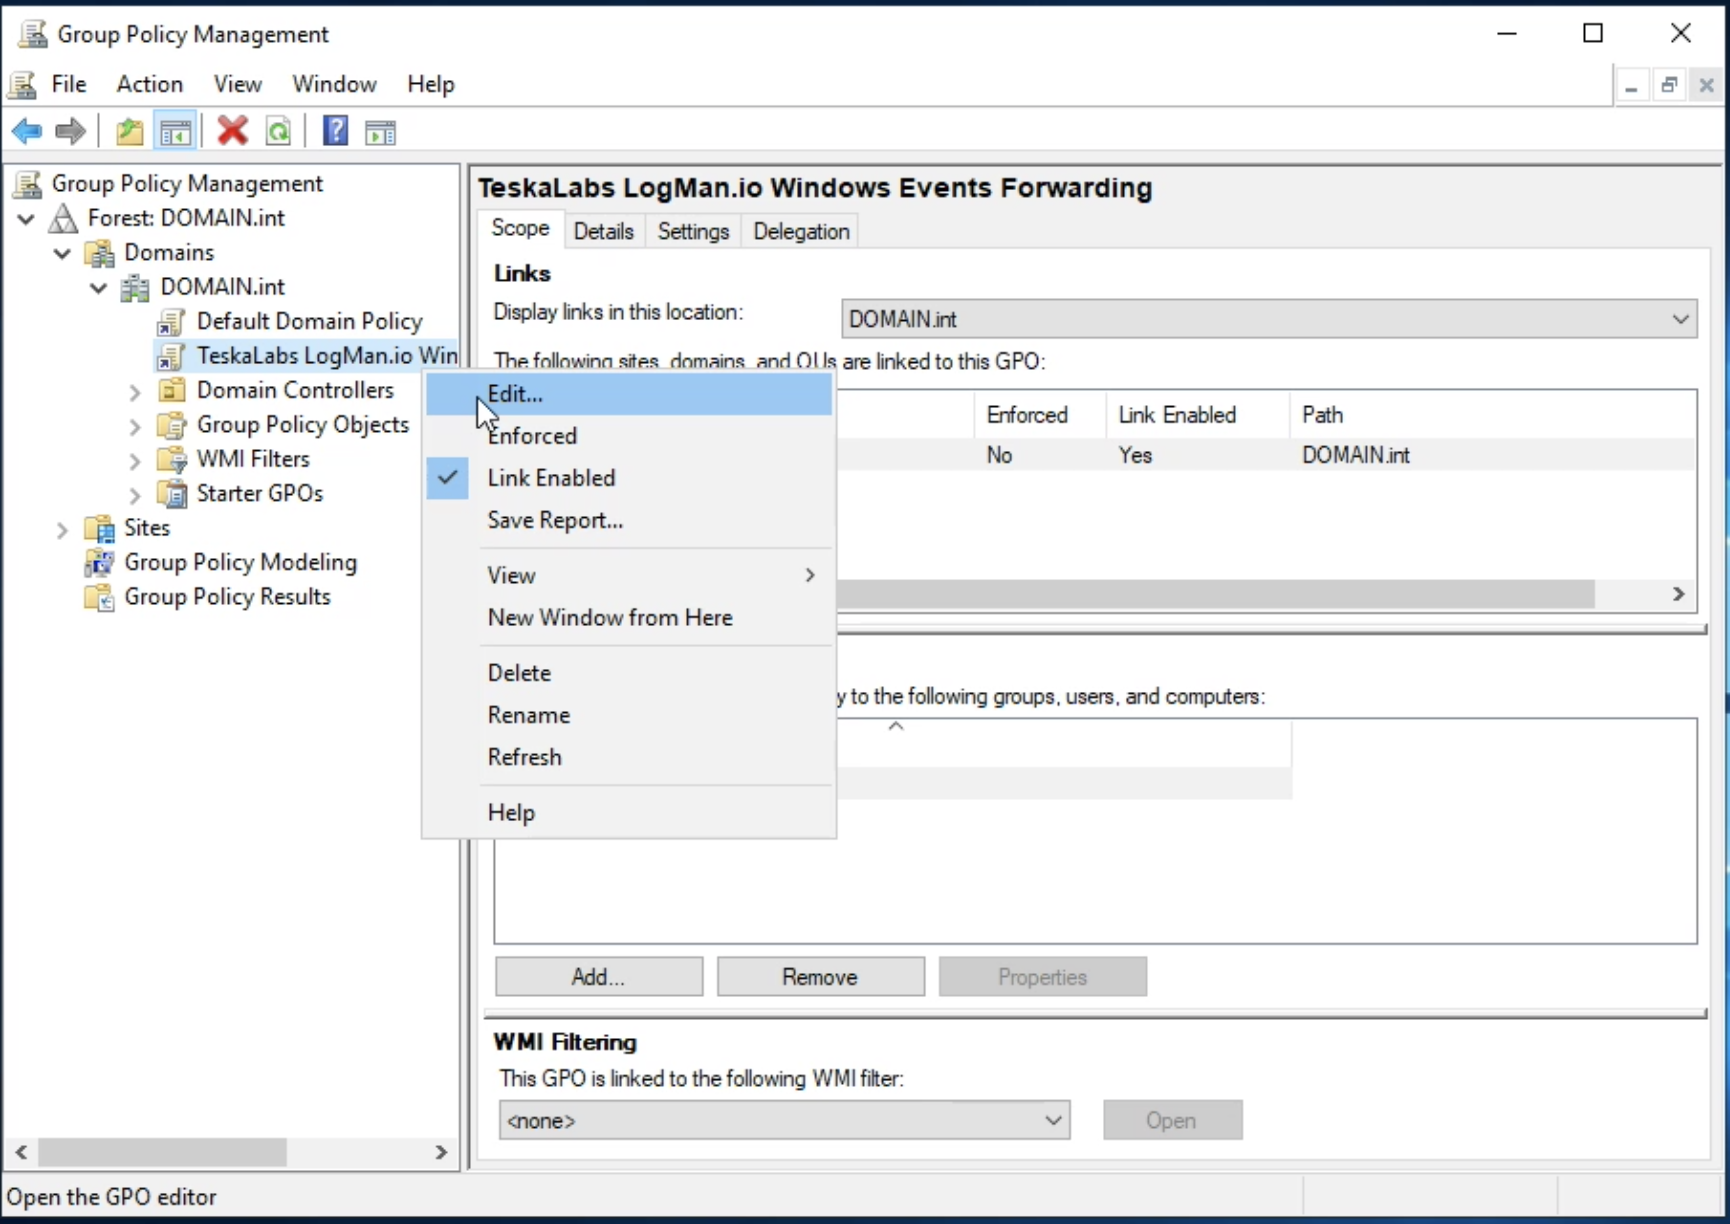
Projděte Computer Configuration > Administrative Templates > Windows Components > a vyberte Event Log Service.
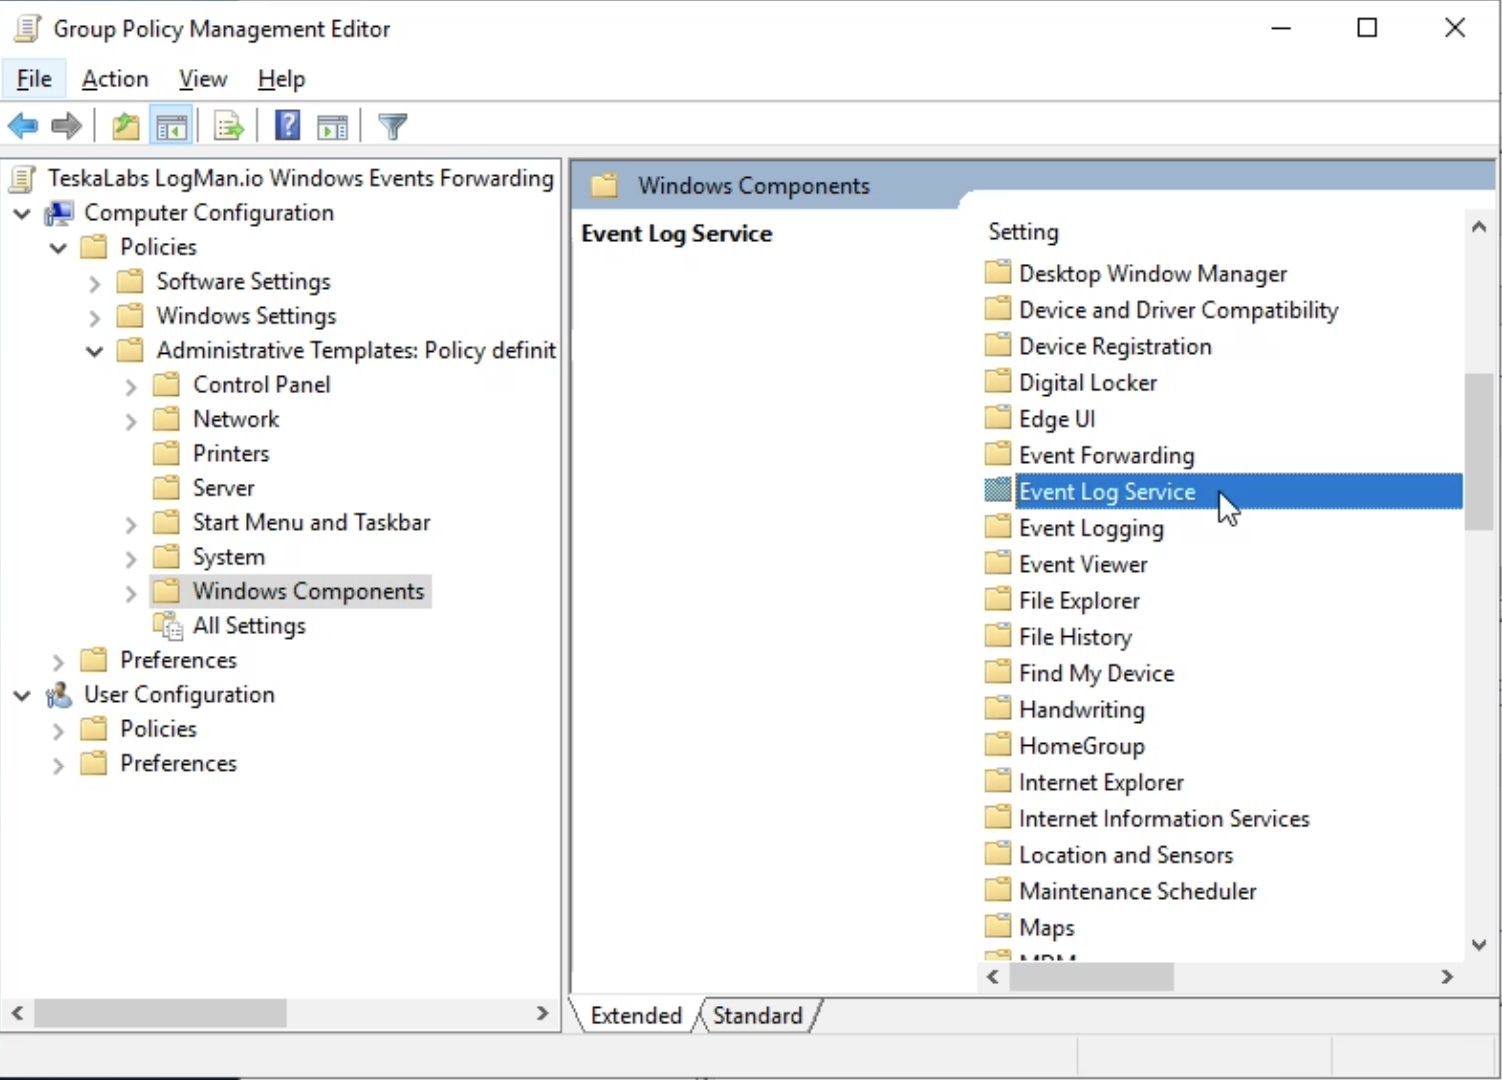
Potom vyberte Security.
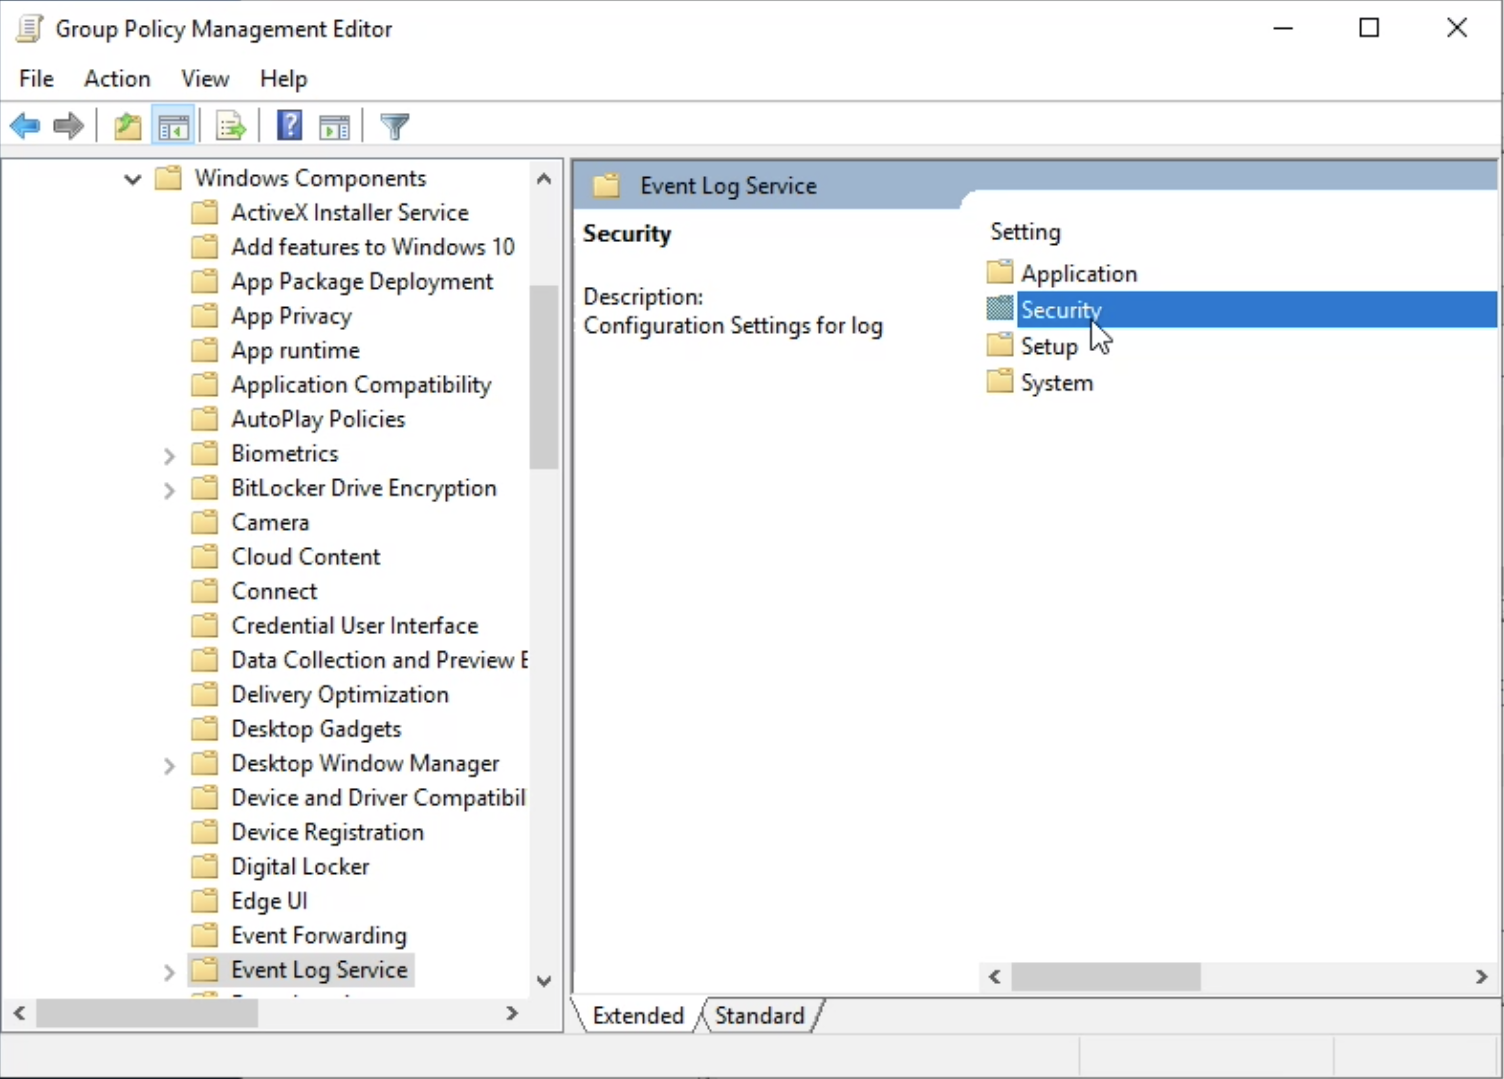
Vyberte Configure log access.
3.2. Nastavení přístupu k logu
Do pole "Log Access" zadejte:
O:BAG:SYD:(A;;0xf0005;;;SY)(A;;0x5;;;BA)(A;;0x1;;;S-1-5-32-573)(A;;0x1;;;S-1-5-20)
Vysvětlení
- O:BA: Určuje, že vlastníkem objektu je Built-in Administrators group.
- G:SY: Určuje, že primární skupina je SYSTEM.
-
D:: Označuje, že následující část definuje Discretionary Access Control List (DACL).
-
Built-in Administrators (BA): Oprávnění pro čtení a zápis.
- SYSTEM (SY): Plná kontrola s oprávněními pro čtení a zápis a speciální oprávnění pro správu logů událostí.
- Builtin\Event Log Readers (S-1-5-32-573): Oprávnění pouze pro čtení.
- Network Service (S-1-5-20): Oprávnění pouze pro čtení.
Stiskněte OK.
3.3. Použití
Spusťte gpupdate /force v cmd.exe na serveru Windows.
Odstraňování problémů
Uživatel Network Service musí být součástí skupiny Event Log Readers, aby měl přístup k bezpečnostním logům.
Postupujte podle těchto kroků pro konfiguraci přístupu:
-
Otevřete příkazový řádek RUN pomocí Windows Key + R
-
Zadejte pro otevření Místního správce uživatelů: lusrmgr.msc (pro edici Windows Home použijte gpedit.msc)
-
Otevřete: Skupiny
-
Vyberte: Event Log Readers
-
Přidejte uživatele NT AUTHORITY\NETWORK SERVICE
- Klikněte na "Add"
- Zadejte přesný název: NT AUTHORITY\NETWORK SERVICE
- Klikněte na "Check Names" pro ověření
-
Pro autentizaci Kerberos:
- Přidejte doménový servisní účet (např.
DOMAIN\lmio-collector) - Pouze pokud používáte doménovou autentizaci
- Přidejte doménový servisní účet (např.
-
Klikněte na OK pro uložení změn
-
Otevřete příkazový řádek (
cmd.exe) jako správce -
Restartujte službu WinRM:
net stop winrm timeout /t 5 net start winrm
Poznámka: Tato konfigurace musí být aplikována na všech počítačích odesílajících bezpečnostní logy. Pro podnikové prostředí použijte nasazení pomocí skupinové politiky místo ruční konfigurace.
Standardní logování
Pro LogMan.io doporučujeme povolit pokročilé auditování a pokročilé nastavení politiky auditu jako standardní způsob nastavení logování Windows. Tento standardní způsob je založen na LogMira nastavení skupinové politiky.
Nahrání XML reportu skupinové politiky přímo
- Stáhněte si soubory Group Policy Report.
- Otevřete skupinovou politiku TeskaLabs LogMan.io Windows Event Forwarding, kterou jste vytvořili dříve v Group Policy Management Console (
gpmc.msc). - Klikněte pravým tlačítkem na politiku a vyberte Import Settings.
- V průvodci vyberte umístění, kde byla záloha uložena (pokud již není vybrána).
- Klikněte na Next přes kroky, dokud se nezobrazí tlačítko Finish, poté klikněte na Finish pro dokončení importu.
Ruční povolení pokročilého auditování a nastavení politiky auditu
Pokročilé auditování
Computer Configuration> Policies> Windows Settings> Security Settings> Local Policies> Security Options- Povolit nastavení podkategorií politiky auditu
- Povolit logování příkazového řádku
- Velikosti logů událostí
Computer Configuration> Policies> Windows Settings> Security Settings> Event Log- Nastavte následující hodnoty z tabulky níže:
| Property | Value |
|---|---|
| Application Log Size | 256k (nebo větší) |
| Security Log Size Workstations | 1,024,000kb (minimálně) |
| Security Log Size Servers | 2,048,000kb (minimálně) |
| System Log Size | 256k (nebo větší) |
Pokročilá nastavení politiky auditu
- Nakonfigurujte pokročilé politiky auditu
Computer Configuration> Policies> Windows Settings> Security Settings> Advanced Audit Policy Configuration> Audit Policies- Nastavte hodnoty z tabulek níže:
| Account Logon | Suggested Values |
|---|---|
| Credential Validation | Success and Failure |
| Kerberos Authentication Service | Success and Failure |
| Kerberos Service Ticket Operations | Success and Failure |
| Other Account Logon Events | Success and Failure |
| Account Management | Suggested Values |
|---|---|
| Application Group Management | Success and Failure |
| Computer Account Management | Success and Failure |
| Distribution Group Management | Success and Failure |
| Other Account Management Events | Success and Failure |
| Security Group Management | Success and Failure |
| User Account Management | Success and Failure |
| Detailed Tracking | Suggested Values |
|---|---|
| DPAPI Activity | No Auditing |
| PNP (Plug and Play) | Success |
| Process Creation | Success and Failure |
| Process Termination | No Auditing |
| RPC Events | Success and Failure |
| Token Right Adjusted | Success |
| DS Access | Suggested Values |
|---|---|
| Detailed Directory Service Replication | No Auditing |
| Directory Service Access | No Auditing |
| Directory Service Changes | Success and Failure |
| Directory Service Replication | No Auditing |
| Logon/Logoff | Suggested Values |
|---|---|
| Account Lockout | Success |
| Group Membership | Success |
| IPsec Extended Mode | No Auditing |
| IPsec Main Mode | No Auditing |
| IPsec Quick Mode | No Auditing |
| Logoff | Success |
| Logon | Success and Failure |
| Network Policy Server | Success and Failure |
| Other Logon/Logoff Events | Success and Failure |
| Special Logon | Success and Failure |
| User / Device Claims | No Auditing |
| Object Access | Suggested Values |
|---|---|
| Application Generated | Success and Failure |
| Central Access Policy Staging | No Auditing |
| Certification Services | Success and Failure |
| Detailed File Share | Success |
| File Share | Success and Failure |
| File System | Success |
| Filtering Platform Connection | Success |
| Filtering Platform Packet Drop | No Auditing |
| Handle Manipulation | No Auditing |
| Kernel Object | No Auditing |
| Other Object Access Events | No Auditing |
| Registry | Success |
| Removable Storage | Success and Failure |
| SAM | Success |
| Policy Change | Suggested Values |
|---|---|
| Audit Policy Change | Success and Failure |
| Authentication Policy Change | Success and Failure |
| Authorization Policy Change | Success and Failure |
| Filtering Platform Policy Change | Success |
| MPSSVC Rule-Level Policy Change | No Auditing |
| Other Policy Change Events | No Auditing |
| Privilege Use | Suggested Values |
|---|---|
| Non Sensitive Privilege Use | No Auditing |
| Other Privilege Use Events | No Auditing |
| Sensitive Privilege Use | Success and Failure |
| System | Suggested Values |
|---|---|
| IPsec Driver | Success |
| Other System Events | Failure |
| Security State Change | Success and Failure |
| Security System Extension | Success and Failure |
| System Integrity | Success and Failure |
| Global Object Access Auditing | Suggested Values |
|---|---|
| File System | No Auditing |
| Registry | No Auditing |
TeskaLabs LogMan.io
4.1. Konfigurace sběru Microsoft Events
V TeskaLabs LogMan.io přejděte na Log Sources >> Collectors >> váš Collector >> Microsoft Windows.
Vyplňte Realm a FQDN řadiče domény, přidejte keytab soubory pro host a http a stiskněte Apply.
4.2. Sběr logů je nakonfigurován
Řešení problémů
Keytab neobsahuje vhodné klíče
kinit: Keytab contains no suitable keys for http/lmio-collector.domain.int@DOMAIN.INT while getting initial credentials
Chyba znamená, že keytab použitý pro Kerberos autentizaci neobsahuje správné klíče pro zadaný principal.
Možné příčiny:
* Nesprávný název principal v příkazu ktpass při vytváření keytab
* Nesprávný název principal v konfiguraci kolektoru
* Keytab neobsahuje očekávané typy šifrování (AES256, AES128)
Doporučujeme ověřit názvy principal a typy šifrování v příkazu ktpass i v konfiguraci kolektoru a že keytab je správně vygenerován s očekávanými klíči.
Nelze kontaktovat žádný KDC pro realm
kinit: Cannot contact any KDC for realm 'DOMAIN.LOCAL' while getting initial credentials
Chyba znamená, že kolektor nedosáhne na řadič domény Active Directory pro získání Kerberos tiketů.
Možné příčiny:
- Síťové problémy mezi kolektorem a řadičem domény
- Nesprávná DNS konfigurace — kolektor nerozpozná hostname řadiče domény
- Firewall blokuje přístup na řadič domény na porty UDP/TCP 88 (Kerberos)
- Nesprávný realm nebo FQDN řadiče domény v konfiguraci kolektoru
Lokální doména
Doména .local je rezervovaná. V konfiguraci kolektoru klikněte na Advanced options a vyberte jiné Key Distribution Center (KDC), které kolektor dosáhne, nebo použijte IP adresu řadiče domény místo hostname.
Příkazem nltest /dsgetdc ověřte správný řadič domény a informace o realmu.
Pokročilá témata
Alternativy
- Použití HTTPS / SSL certifikátů místo Active Directory a Kerberos
- Použití lokální skupinové politiky místo Active Directory Group Policy
Forwarding Event Log
Kanál událostí Eventlog-forwardingPlugin/Operational loguje relevantní informace o strojích nastavených pro přesměrování logů na kolektor.
Obsahuje také informace o možných problémech s WEF subscription.
Prozkoumejte ho v aplikaci Event Viewer.
Vysoká dostupnost se dvěma kolektory
Pro vysokou dostupnost můžete nasadit dva LogMan.io Collectory tak, aby Windows stroje přešly z jednoho na druhý bez zdvojení provozu a bez deduplikátoru.
Nastavení:
- Oba kolektory používají stejné keytaby a stejného AD uživatele (např.
lmio-collector). - Existuje jeden DNS A záznam a jeden SPN pro toto jméno (např.
lmio-collector.domain.int). Jméno resolvuje na obě IP kolektorů přes DNS round-robin; doporučené TTL je 15 minut, aby po opětovném resolvu Windows stroj mohl dostat IP druhého kolektoru. - Oba kolektory používají stejné subscription ID ve WEC konfiguraci, aby události nebyly považovány za duplicity při přepnutí stroje mezi kolektory.
Po vypršení DNS TTL se Windows stroj může znovu připojit k druhému kolektoru. Z pohledu Kerberos je to v pořádku: tikety se získávají jednou na stroj; mezi kolektory není konflikt. Úspěšný failover jednotlivých Windows strojů byl pozorován v produkci.
Note
Tento vzor nasazení je jedna z možností HA pro WEF a měl by být monitorován ve vašem prostředí. Při duplicitních událostech nebo problémech s připojením zkontrolujte DNS TTL, subscription ID a konfiguraci kolektorů.
Sběr z více domén
Pro sběr Windows Events z více domén Active Directory je třeba nakonfigurovat Kerberos autentizaci pro každou doménu a sloučit keytab soubory.
Předpoklady
- Přístup k řadičům domény všech domén, ze kterých chcete sbírat
- Keytab soubory pro každou doménu (host a http principaly)
- Možnost upravit Kerberos konfiguraci na kolektoru
Konfigurace kolektoru
Nakonfigurujte WEC vstup v /conf/lmio-collector.yaml:
input:WEC:WECKerberosInput:
listen: 5985 # Just to be explicit
output: microsoft-windows-events-v1
output:CommLink:microsoft-windows-events-v1: {}
Konfigurace proměnné prostředí
Kolektor musí mít nastavenou proměnnou prostředí KRB5CCNAME pro adresářový credential cache.
Umožní to uložit více Kerberos tiketů (pro každou doménu) současně.
Pro Docker/kontejnerová nasazení přidejte do docker-compose.yaml:
services:
lmio-collector:
environment:
KRB5CCNAME: "DIR:/tmp/krb5cc_wef"
Pro ostatní typy nasazení nastavte proměnnou prostředí před startem služby kolektoru.
Konfigurace Kerberos
Nakonfigurujte /conf/kerberos/krb5.conf pro více domén:
[libdefaults]
default_realm = DOMAIN2.COM
dns_lookup_realm = false
dns_lookup_kdc = true
ticket_lifetime = 24h
renew_lifetime = 7d
forwardable = true
rdns = false
[domain_realms]
.DOMAIN1.COM = DOMAIN1.COM
DOMAIN1.COM = DOMAIN1.COM
.DOMAIN2.COM = DOMAIN2.COM
DOMAIN2.COM = DOMAIN2.COM
.domain1.com = DOMAIN1.COM
domain1.com = DOMAIN1.COM
domain2.com = DOMAIN2.COM
.domain2.com = DOMAIN2.COM
[realms]
DOMAIN1.COM = {
# kdc = domain1.com
admin_server = domain1.com
}
DOMAIN2.COM = {
# kdc = domain2.com
admin_server = domain2.com
}
Tip
Nahraďte DOMAIN1.COM a DOMAIN2.COM skutečnými názvy domén.
Sekce domain_realms mapuje názvy domén (bez ohledu na velikost písmen) na realmy.
Sekce realms definuje KDC a admin server pro každý realm.
Sloučení keytab souborů
Sloučte keytaby ze všech domén do jednoho souboru pomocí ktutil:
ktutil
ktutil: rkt /conf/kerberos/domain1-host-lmio-collector.keytab
ktutil: rkt /conf/kerberos/domain1-http-lmio-collector.keytab
ktutil: rkt /conf/kerberos/domain2-host-lmio-collector.keytab
ktutil: rkt /conf/kerberos/domain2-http-lmio-collector.keytab
ktutil: wkt /conf/kerberos/krb5.keytab
ktutil: q
Vytvoří se sloučený keytab /conf/kerberos/krb5.keytab se všemi principaly z obou domén.
Inicializace Kerberos tiketů
Inicializujte tikety pro každou doménu:
export KRB5CCNAME=DIR:/tmp/krb5cc_wef
kinit -kt /conf/kerberos/krb5.keytab http/lmio-collector.domain2.com@DOMAIN2.COM
kinit -kt /conf/kerberos/krb5.keytab http/lmio-collector.domain1.com@DOMAIN1.COM
Proč DIR: místo FILE:?
Prefix DIR: určuje adresářový credential cache — více tiketů v samostatných souborech v adresáři.
Je to nutné při sběru z více domén; každý kinit vytvoří samostatný soubor tiketu.
FILE: by znamenal jeden souborový cache, který drží jen jeden tiket a další kinit by ho přepsal.
Ověřte správnou inicializaci tiketů:
klist -A
Měli byste vidět tikety pro obě domény.
Warning
Cesta k keytab v příkazech kinit musí odpovídat skutečnému umístění sloučeného keytab.
Kolektor se musí umět autentizovat do obou domén pomocí sloučeného keytab.
Ruční konfigurace
Sběr z Microsoft Windows pomocí Windows Remote Management
Ovládání bez agentů se připojí k požadovanému počítači se systémem Windows přes Windows Remote Management (známé také jako WinRM) a spustí příkaz pro sběr dat tam jako samostatný proces, aby se získal jeho standardní výstup.
Specifikace vstupu: input:WinRM:
Vstup WinRM se připojí ke vzdálenému serveru Windows, kde zavolá specifikovaný příkaz.
Poté periodicky kontroluje nový výstup na stdout a stderr, takže se chová podobně jako input:SubProcess.
Konfigurační možnosti LogMan.io Collector WinRM
endpoint: # URL koncového bodu API správy Windows vzdáleného počítače se systémem Windows (např. http://MyMachine:5985/wsman)
transport: ntlm # Typ autentizace
server_cert_validation: # Specifikujte ověření certifikátu (výchozí: ignore)
cert_pem: # (volitelné) Uveďte cestu k certifikátu (při použití HTTPS)
cert_key_pem: # (volitelné) Uveďte cestu k soukromému klíči
username: # (volitelné) Při použití autentizace uživatelského jména (např. přes ntlm), specifikujte uživatelské jméno ve formátu <DOMAIN>\<USER>
password: # Heslo výše autentizovaného uživatele
output: # Do kterého výstupu poslat příchozí události
Následující konfigurace objasňuje příkaz, který by měl být vzdáleně volán:
# Přečtěte 1000 systémových logů jednou za 2 sekundy
command: # Specifikujte příkaz, který by měl být vzdáleně volán (např. wevtutil qe system /c:1000 /rd:true)
chilldown_period: # Jak často v sekundách by měl být vzdálený příkaz volán, pokud skončí (výchozí: 5)
duplicity_check: # Specifikujte, zda kontrolovat duplicity na základě času (true/false)
duplicity_reverse_order: # Specifikujte, zda kontrolovat duplicity v obráceném pořadí (např. logy přicházejí v sestupném pořadí)
last_value_storage: # Trvalé úložiště pro aktuální poslední hodnotu při kontrole duplicity (výchozí: ./var/last_value_storage)
Sběr agentem na Windows stroji
TeskaLabs LogMan.io Collector běží jako agent na požadovaném Windows stroji a sbírá Windows Events.
Specifikace vstupu: input:WinEvent
Poznámka: input:WinEvent funguje pouze na stroji s Windows.
Tento vstup periodicky čte Windows Events ze zadaného typu událostí.
Možnosti konfigurace LogMan.io Collector WinEvent
server: # (volitelné) Zdroj událostí (výchozí: localhost, tj. celý lokální stroj)
event_type: # (volitelné) Typ událostí (výchozí: System)
buffer_size: # (volitelné) Kolik událostí číst v jednom dotazu (výchozí: 1024)
event_block_size: # (volitelné) Po kolika událostech následuje idle čas pro ostatní operace (výchozí: 100)
event_idle_time: # (volitelné) Idle čas v sekundách (výchozí: 0.01)
last_value_storage: # Trvalé úložiště aktuální last value (výchozí: ./var/last_value_storage)
output: # Kam odesílat příchozí události
Typ události lze zadat pro každý typ Windows Event logu, včetně:
Applicationpro aplikační logySystempro systémové logySecuritypro security logy atd.
Microsoft365
## Sbírání logů z Microsoft 365
TeskaLabs LogMan.io může sbírat logy z [Microsoft 365](https://en.wikipedia.org/wiki/Microsoft_365), dříve známého jako Microsoft Office 365.
Existují následující třídy logů Microsoft 365:
* **Audit logy**: Obsahují informace o různých uživatelských, administrátorských, systémových a politikových akcích a událostech z Azure Active Directory, Exchange a SharePoint.
* **Message Trace**: Umožňuje získat přehled o e-mailovém provozu procházejícím přes Microsoft Office 365 Exchange mail server.
## Aktivace auditu Microsoft 365
Ve výchozím nastavení je auditní logování aktivováno pro podnikovou organizaci Microsoft 365 a Office 365.
Při nastavování logování pro organizaci Microsoft 365 nebo Office 365 byste však měli ověřit stav auditu Office 365.
**1) Přejděte na [https://compliance.microsoft.com/](https://compliance.microsoft.com) a přihlaste se**
**2) V levém navigačním panelu Microsoft 365 compliance centra klikněte na Audit**
**3) Klikněte na banner Spustit záznam uživatelské a administrátorské aktivity**
Změna může trvat až 60 minut, než se projeví.
Pro více informací, viz [Zapnout nebo vypnout audit](https://docs.microsoft.com/en-us/microsoft-365/compliance/turn-audit-log-search-on-or-off?view=o365-worldwide).
## Konfigurace Microsoft 365
Než budete moci sbírat logy z Microsoft 365, musíte konfigurovat Microsoft 365. Uvědomte si, že konfigurace zabere značné množství času.
**1) Nastavte si předplatné na Microsoft 365 a předplatné na Azure**
Potřebujete předplatné na Microsoft 365 a předplatné na Azure, které je přidruženo k vašemu předplatnému na Microsoft 365.
Můžete využít zkušební předplatné na obojí, Microsoft 365 a Azure, pro začátek.
Pro více informací, viz [Vítejte v Office 365 Developer Program](https://docs.microsoft.com/en-us/office/developer-program/office-365-developer-program).
**2) Zaregistrujte TeskaLabs LogMan.io kolektor v Azure AD**
To vám umožní vytvořit identitu pro TeskaLabs LogMan.io a přiřadit specifická oprávnění, která potřebuje pro sbírání logů z Microsoft 365 API.
Přihlaste se do [Azure portálu](https://portal.azure.com/) pomocí přihlašovacích údajů z vašeho předplatného na Microsoft 365, které chcete použít.
**3) Navigujte do Azure Active Directory**
<img src="../msoffice-azureportal1.jpg" width="500" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**4) Na stránce Azure Active Directory vyberte "App registrations" (1) a poté "New registration" (2)**
<img src="../msoffice-azureportal2.jpg" width="436" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**5) Vyplňte registrační formulář pro TeskaLabs LogMan.io aplikaci**
* Název: "TeskaLabs LogMan.io"
* Podporované typy účtů: "Účet v tomto organizačním adresáři"
* URL přesměrování: Žádné
Stiskněte "Register" pro dokončení procesu.
<img src="../msoffice-azureportal3.jpg" width="518" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**6) Sbírejte důležité informace**
Uložte následující informace ze stránky registrované aplikace v Azure portálu:
* Application (client) ID aka `client_id`
* Directory (tenant) ID aka `tenant_id`
<img src="../msoffice-azureportal4.jpg" width="656" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**7) Vytvořte klientské tajemství**
Klientské tajemství se používá pro bezpečné autorizování a přístup TeskaLabs LogMan.io.
Po zobrazení stránky vaší aplikace, vyberte v levém panelu záložku Certifikáty & tajemství (1).
Pak vyberte záložku "Client secrets" (2).
Na této záložce vytvořte nové klientské tajemství (3).
<img src="../msoffice-azureportal5.jpg" width="594" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**8) Vyplňte informace o novém klientském tajemství**
* Popis: "TeskaLabs LogMan.io Client Secret"
* Vyprší: 24 měsíců
Stiskněte "Add" pro pokračování.
<img src="../msoffice-azureportal6.jpg" width="390" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**9) Klikněte na ikonu se schránkou, aby se hodnota klientského tajemství zkopírovala do schránky**
<img src="../msoffice-azureportal7.jpg" width="900" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
Uložte *Value* (ne Secret ID) pro konfiguraci TeskaLabs LogMan.io, bude použito jako `client_secret`.
**10) Určete oprávnění pro TeskaLabs LogMan.io, aby mohlo přistupovat k Microsoft 365 Management API**
Přejděte na App registrations > All applications v Azure portálu a vyberte "TeskaLabs LogMan.io".
<img src="../msoffice-azureportal8.jpg" width="656" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**11) Vyberte API Permissions (1) v levém panelu a potom klikněte na Add a permission (2)**
<img src="../msoffice-azureportal9.jpg" width="575" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**12) Na záložce Microsoft APIs vyberte Microsoft 365 Management APIs**
<img src="../msoffice-azureportal10.jpg" width="567" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**13) Na rozbalovací stránce vyberte všechny typy oprávnění**
* Delegovaná oprávnění
* `ActivityFeed.Read`
* `ActivityFeed.ReadDlp`
* `ServiceHealth.Read`
* Aplikační oprávnění
* `ActivityFeed.Read`
* `ActivityFeed.ReadDlp`
* `ServiceHealth.Read`
Klikněte na "Add permissions" pro dokončení.
<img src="../msoffice-azureportal11.jpg" width="565" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
<img src="../msoffice-azureportal12.jpg" width="570" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**14) Přidejte oprávnění "Microsoft Graph"**
* Delegovaná oprávnění
* `AuditLog.Read.All`
* Aplikační oprávnění
* `AuditLog.Read.All`
Vyberte "Microsoft Graph", "Delegovaná oprávnění", najděte a vyberte "AuditLog.Read.All" v "Audit Log".
Pak znovu vyberte "Microsoft Graph", "Aplikační oprávnění", najděte a vyberte "AuditLog.Read.All" v "Audit Log".
<img src="../msoffice-azureportal12.jpg" width="571" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**15) Přidejte oprávnění "Office 365 Exchange online" pro sbírání Message Trace reportů**
Klikněte na "Add a permission" znovu.
Pak přejděte na "APIs my organization uses".
Zadejte "Office 365 Exchange Online" do vyhledávacího pole.
Nakonec vyberte položku "Office 365 Exchange Online".
<img src="../msoffice-azureportal-exchange1.jpg" width="570" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
Vyberte "Aplikační oprávnění".
Zadejte "ReportingWebService" do vyhledávacího pole.
Zaškrtněte políčko "ReportingWebService.Read.All".
Nakonec klikněte na tlačítko "Add permissions".
<img src="../msoffice-azureportal-exchange2.jpg" width="570" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**16) Udělte souhlas admina**
<img src="../msoffice-azureportal13.jpg" width="904" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**17) Navigujte zpět do Azure Active Directory**
<img src="../msoffice-azureportal1.jpg" width="500" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**18) Navigujte na Role a administrátory**
<img src="../msoffice-azureportal15.jpg" width="500" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
**19) Přidělte TeskaLabs LogMan.io roli Global Reader**
Zadejte "Global Reader" do vyhledávacího pole.
Pak klikněte na položku "Global Reader".
<img src="../msoffice-azureportal16.jpg" width="500" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
Vyberte "Add assignments".
Zadejte "TeskaLabs LogMan.io" do vyhledávacího pole. Alternativně použijte "Application (client) ID" z předchozích kroků.
Vyberte položku "TeskaLabs LogMan.io"; položka se objeví v "Selected items".
Stiskněte tlačítko "Add".
<img src="../msoffice-azureportal17.jpg" width="904" style="box-shadow: 0 4px 8px 0 rgba(0, 0, 0, 0.2), 0 6px 20px 0 rgba(0, 0, 0, 0.19);" />
__Gratulujeme!__ Vaše Microsoft 365 je nyní připravena pro sběr logů.
## Konfigurace TeskaLabs LogMan.io
### Příklad
```yaml
connection:MSOffice365:MSOffice365Connection:
client_id: xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
tenant_id: xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx
client_secret: xxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxxx
# Sbírání Microsoft 365 Audit.General
input:MSOffice365:MSOffice365Source1:
connection: MSOffice365Connection
content_type: Audit.General
output: ms-office365-01
# Sbírání Microsoft 365 Audit.SharePoint
input:MSOffice365:MSOffice365Source2:
connection: MSOffice365Connection
content_type: Audit.SharePoint
output: ms-office365-01
# Sbírání Microsoft 365 Audit.Exchange
input:MSOffice365:MSOffice365Source3:
connection: MSOffice365Connection
content_type: Audit.Exchange
output: ms-office365-01
# Sbírání Microsoft 365 Audit.AzureActiveDirectory
input:MSOffice365:MSOffice365Source4:
connection: MSOffice365Connection
content_type: Audit.AzureActiveDirectory
output: ms-office365-01
# Sbírání Microsoft 365 DLP.All
input:MSOffice365:MSOffice365Source5:
connection: MSOffice365Connection
content_type: DLP.All
output: ms-office365-01
output:XXXXXX:ms-office365-01: {}
# Sbírání Microsoft 365 Message Trace logů
input:MSOffice365MessageTraceSource:MSOffice365MTSource1:
connection: MSOffice365Connection
output: ms-office365-message-trace-01
output:XXXXXX:ms-office365-message-trace-01: {}
Připojení
Připojení k Microsoft 365 musí být nakonfigurováno jako první v sekci connection:MSOffice365:....
connection:MSOffice365:MSOffice365Connection:
client_id: # Application (client) ID z Azure Portálu
tenant_id: # Directory (tenant) ID z Azure Portálu
client_secret: # Hodnota klientského tajemství z Azure Portálu
resources: # (volitelné) zdroje, ze kterých chcete získávat data, oddělené čárkou (,) (výchozí: https://manage.office.com,https://outlook.office365.com)
Danger
Pole client id, tenant_id a client secret MUSÍ být zadaná pro úspěšné připojení k Microsoft 365.
Sbírání z Microsoft 365 activity logs
Konfigurační možnosti pro nastavení sběru Audit logů (Audit.AzureActiveDirectory, Audit.SharePoint, Audit.Exchange, Audit.General a DLP.All):
input:MSOffice365:MSOffice365Source1:
connection: # ID MSOffice365 připojení
output: # Kam posílat příchozí události
content_type: # (volitelné, ale doporučené) Typ obsahu získávaných logů (výchozí: Audit.AzureActiveDirectory Audit.SharePoint Audit.Exchange Audit.General DLP.All)
refresh: # (volitelné) Interval obnovování v sekundách pro získání zpráv z API (výchozí: 600)
last_value_storage: # (volitelné) Perzistentní úložiště pro aktuální poslední hodnotu (výchozí: ./var/last_value_storage)
Sbírání z Microsoft 365 Message Trace
Konfigurační možnosti pro nastavení zdroje dat pro Microsoft 365 Message Trace:
input:MSOffice365MessageTraceSource:MSOffice365MessageTraceSource1:
connection: # ID MSOffice365 připojení
output: # Kam odesílat příchozí události
refresh: # (volitelné) Interval obnovení v sekundách (výchozí: 600)
last_value_storage: # (volitelné) Trvalé úložiště last value (výchozí: ./var/last_value_storage)
Throttling
Microsoft Graph Message Trace API má limit 100 požadavků za 5 minut na tenant,
sdílený pro Message Trace a Message Trace Detail.
Výchozí refresh drží TeskaLabs LogMan.io v limitu.
Při kratším refresh sledujte celkovou frekvenci požadavků.
Obnovení client secret
Client secret vyprší po 24 měsících a je třeba ho periodicky obnovovat.
1) Přejděte do Microsoft Entra ID.
2) Otevřete „App registrations“ a vyberte „TeskaLabs LogMan.io“.
3) Vytvořte nový client secret.
Přejděte na „Certificates & secrets“.
V záložce „Client secrets“ klikněte na „New client secret“.
Do Description zadejte „TeskaLabs LogMan.io Client Secret 2“ (čísla navyšujte).
Expiration „730 days (24 months)“.
Klikněte na „Add“.
4) Překonfigurujte TeskaLabs LogMan.io na nový client secret.
5) Smažte starý client secret.
Vysvětlení atributů Microsoft 365
| Attribute | Description | Values as an example | Notes | Full list (ext) | |
|---|---|---|---|---|---|
| o365.audit.ActorContextId | ID of the user or service account that performed the action. | 571c8d2c-1ae2-486d-a17c-81bf54cbaa15 | |||
| o365.audit.ApplicationId | Application identifier (unique letter+number string) | 89bee1f7-5e6e-4d8a-9f3d-ecd601259da7 | |||
| o365.audit.AzureActiveDirectoryEventType | The type of Azure Active Directory event. The following values indicate the type of event. | 0 - Indicates an account login event. 1 - Indicates an Azure application security event. |
|||
| o365.audit.DeviceProperties | Source device properties such as OS, browser type etc. | Name:"OS" Value:"Linux" } {2 items Name:"BrowserType" Value:"Firefox" } {2 items Name:"IsCompliantAndManaged" Value:"False" } {2 items Name:"SessionId" Value:"e94ad17c-354f-4009-a9ee-34900770e997" |
Parcing of these properties is still in progress | ||
| o365.audit.ErrorNumber | An error code string that can be used to classify types of errors that occur, and should be used to react to errors. | 0, 50140, 501314 ... | https://learn.microsoft.com/en-us/azure/active-directory/develop/reference-aadsts-error-codes | ||
| o365.audit.ExtraProperties | Not defined yet | // | |||
| o365.audit.FileSizeBytes | FIle size in bytes | 23301 | |||
| o365.audit.InterSystemsId | Unique inter system ID string | acc33436-ee63-4d81-b6ee-544998a1c7d9 | |||
| o365.audit.IntraSystemId | Unique intra system ID string | 01dd20c0-edb9-4aaa-a51b-2bf38e1a8900 | |||
| o365.audit.ItemName | Unique item name | b1379a75-ce5e-4fa3-80c6-89bb39bf646c | |||
| o365.audit.LogonError | Error message displayed after failed login | InvalidUserNameOrPassword, TriggerBrowserCapabilitiesInterrupt, InvalidPasswordExpiredPassword | |||
| o365.audit.ObjectId | URL path to accesed file | https://telescopetest.sharepoint.com/sites/Shared Documents/Docs/o365 - logs.xlsx | |||
| o365.audit.RecordType | The type of operation indicated by the record. This property indicates the service or feature that the operation was triggered in. | 6 | https://learn.microsoft.com/en-us/office/office-365-management-api/office-365-management-activity-api-schema#auditlogrecordtype | ||
| o365.audit.ResultStatus | Triggered response | Success, Fail | |||
| o365.audit.SourceFileExtension | Accessed file extension (format type). | .xlsx, .pdf, .doc etc. | |||
| o365.audit.SourceFileName | Name of file user accessed | "o365.attributesexplained.xlsx" | |||
| o365.audit.SupportTicketId | ID of the potential Support ticket, after user opened a support request in Azure Active Directory. | // | The customer support ticket ID for the action in "act-on-behalf-of" situations. | ||
| o365.audit.TargetContextId | The GUID of the organization that the targeted user belongs to. | 571c8d2c-1ae2-486d-a17c-81bf54cbaa15 | |||
| o365.audit.UserKey | An alternative ID for the user identified in the UserID property. For example, this property is populated with the passport unique ID (PUID) for events performed by users in SharePoint. This property also might specify the same value as the UserID property for events occurring in other services and events performed by system accounts. | i:0h.f|membership|1003200224fe6604@live.com | |||
| o365.audit.UserType | The type of user that performed the operation. The following values indicate the user type. | 0 - A regular user. 2 - An administrator in your Microsoft 365 organization.1 3 - A Microsoft datacenter administrator or datacenter system account. 4 - A system account. 5 - An application. 6 - A service principal. 7 - A custom policy. 8 - A system policy. |
|||
| o365.audit.Version | Indicates the version number of the activity (identified by the Operation property) that's logged. | 1 | |||
| o365.audit.Workload | The Microsoft 365 service where the activity occurred. | AzureActiveDirectory | |||
| o365.message.id | This is the Internet message ID (also known as the Client ID) found in the message header in the Message-ID: header field. | 08f1e0f6806a47b4ac103961109ae6ef@server.domain | This ID should be unique; however, not all sending mail systems behave the same way. As a result, there's a possibility that you may get results for multiple messages when querying upon a single Message ID. | ||
| o365.message.index | Value of MessageTrace Index | 1, 2, 3 ... | |||
| o365.message.size | Size of the sent/received message in bytes. | 33489 | |||
| o365.message.status | Following action after sending the message. | Delivered, FilteredAsSpam, Expanded | https://learn.microsoft.com/en-us/exchange/monitoring/trace-an-email-message/run-a-message-trace-and-view-results | ||
| o365.message.subject | Message subject; can be written uniquely. | "Binding Offer Letter for Ms. Smith" | |||
URL používané touto integrací
LogMan.io Collector se připojuje na tyto URL:
- https://manage.office.com
- https://outlook.office365.com
- https://login.microsoftonline.com
Sběr událostí z Apache Kafka
TeskaLabs LogMan.io Collector je schopen sbírat události z Apache Kafka, konkrétně z jejích topics. Události uložené v Kafka mohou obsahovat data zakódovaná v bytech, jako jsou logy o různých uživatelských, administrativních, systémových, zařízeníových a politických akcích.
Předpoklady
Aby bylo možné vytvořit Kafka spotřebitele, je nutné znát bootstrap_servers, tedy umístění Kafka uzlů, stejně jako topic, ze kterého se budou data číst.
Konfigurace LogMan.io Collector
LogMan.io Collector poskytuje input:Kafka: vstupní sekci, kterou je třeba specifikovat v YAML konfiguraci. Konfigurace vypadá následujícím způsobem:
input:Kafka:KafkaInput:
bootstrap_servers: <BOOTSTRAP_SERVERS>
topic: <TOPIC>
group_id: <GROUP_ID>
...
Tato vstupní sekce vytvoří Kafka spotřebitele pro specifické topic(y).
Konfigurační možnosti týkající se navázání spojení:
bootstrap_servers: # Kafka uzly, ze kterých se budou číst zprávy (například `kafka1:9092,kafka2:9092,kafka3:9092`)
Konfigurační možnosti týkající se nastavení Kafka Spotřebitele:
topic: # Název topiců, ze kterých se budou číst zprávy (například `lmio-events` nebo `^lmio.*`)
group_id: # Název spotřebitelské skupiny (například: `collector_kafka_consumer`)
refresh_topics: # (nepovinné) Pokud se očekává vytvoření více topiců během spotřeby, tato volba specifikuje v sekundách, jak často má proběhnout obnovení odběrů topiců (například: `300`)
Volby bootstrap_servers, topic a group_id jsou vždy povinné!
topic může být název, seznam názvů oddělených mezerami nebo jednoduchý regex (pro přizpůsobení všech dostupných topics použijte ^.*).
Pro více konfiguračních možností prosím odkažte na librdkafka konfigurační příručku.
Shromažďování z Beats nebo Logstash
Podporované Beats
TeskaLabs LogMan.io podporuje shromažďování logů z široké škály Elastic Beats, což jsou lehké datové přepravce pro různé zdroje logů a platformy. Mezi nejčastěji používané Beats patří:
- Winlogbeat: Shromažďuje Windows Event, včetně aplikací, systému, zabezpečení a mnoha dalších kanálů. Užitečné pro monitorování Windows serverů a pracovních stanic.
- Filebeat: Shromažďuje a přepravuje logy z souborů. Běžné případy použití zahrnují:
- Microsoft DHCP: Shromažďuje logy DHCP serveru z Windows serverů.
- Microsoft DNS: Shromažďuje debug logy DNS z Windows DNS serverů.
- Microsoft IIS: Shromažďuje logy webového serveru z Microsoft IIS.
- Logy vlastních aplikací: Shromažďuje logy z jakékoli aplikace nebo služby, která zapisuje do souboru.
- Auditbeat: Shromažďuje auditní logy z Linuxových systémů, jako je monitorování integrity souborů a uživatelská aktivita.
- Další Beats: Jakékoli další komunitní nebo oficiální Beats (např. Metricbeat, Packetbeat) mohou být také integrovány.
Beats posílají svá data do LogMan.io Kolektoru pomocí protokolu Lumberjack (stejný protokol, který používá Logstash). To umožňuje bezpečné a spolehlivé přepravování logů z různých zdrojů a platforem.
Konfigurace TeskaLabs LogMan.io
Základní konfigurační úryvek LogMan.io Collectoru:
input:Lumberjack:logstash:
output: ...
logstash je identifikovaný vstup a může být nahrazen čímkoli jedinečným v konfiguračním souboru.
address specifikuje síťové rozhraní a/nebo port, který bude použit pro naslouchání.
Výchozí hodnota je '5044', pro naslouchání na tcp/5044.
Volitelný atribut smart může být použit k určení chytré mapy, když je připojen k output:CommLink.
Tip
Protokol používaný pro tuto extrakci se nazývá Lumberjack a ve výchozím nastavení běží na tcp/5044 s volitelným SSL.
Třídy zdrojů logů input:Lumberjack:, input:Logstash: a input:Beats: jsou ve skutečnosti synonyma.
Konfigurace SSL
Příchozí SSL je detekováno automaticky.
Následující konfigurační možnosti specifikují SSL připojení:
cert: Cesta k SSL certifikátu klientakey: Cesta k soukromému klíči SSL certifikátu klientapassword: Heslo k souboru soukromého klíče (volitelné, výchozí: žádné)cafile: Cesta k PEM souboru s certifikátem(y) CA pro ověření SSL serveru (volitelné, výchozí: žádné)capath: Cesta k adresáři s certifikátem(y) CA pro ověření SSL serveru (volitelné, výchozí: žádné)cadata: jeden nebo více PEM-encoded certifikátů CA pro ověření SSL serveru (volitelné, výchozí: žádné)ciphers: SSL šifry (volitelné, výchozí: žádné)dh_params: Parametry výměny klíčů Diffie–Hellman (D-H) (TLS) (volitelné, výchozí: žádné)verify_mode: Jeden z CERT_NONE, CERT_OPTIONAL nebo CERT_REQUIRED (volitelné); pro více informací viz: github.com/TeskaLabs/asab
Příklad konfigurace Beats
Tento zdroj logů může být použit k shromažďování logů pomocí rodiny nástrojů Beats. Beats jsou lehké datové přepravce od Elastic.
Konfigurační úryvek:
output.logstash:
hosts: ["<collector>:5044"]
Winlogbeat
output.logstash:
hosts: ["<collector>:5044"]
winlogbeat.event_logs:
- name: Application
ignore_older: 72h
- name: System
ignore_older: 72h
- name: Security
ignore_older: 72h
- name: Setup
ignore_older: 72h
- name: Microsoft-Windows-Sysmon/Operational
ignore_older: 72h
- name: Microsoft-Windows-Windows Defender/Operational
ignore_older: 72h
- name: Microsoft-Windows-GroupPolicy/Operational
ignore_older: 72h
- name: Microsoft-Windows-TaskScheduler/Operational
ignore_older: 72h
- name: Microsoft-Windows-Windows Firewall With Advanced Security/Firewall
ignore_older: 72h
- name: Windows PowerShell
event_id: 400, 403, 600, 800
ignore_older: 72h
- name: Microsoft-Windows-PowerShell/Operational
event_id: 4103, 4104, 4105, 4106
ignore_older: 72h
- name: ForwardedEvents
tags: [forwarded]
logging.to_files: true
logging.files:
rotateeverybytes: 10485760 # = 10MB
Logy zabezpečení
Ujistěte se, že uživatel, pod kterým služba Winlogbeat běží, má oprávnění k přístupu k Security logům.
Aby to bylo možné, musí být uživatel součástí skupiny Event Log Readers.
Krok za krokem (přes lusrmgr.msc)
-
Otevřete dialog pro spuštění:
-
Stiskněte
Win + Rna klávesnici. -
Zadejte
lusrmgr.msca stiskněteEnter. -
Přejděte na Skupiny:
-
V levém panelu klikněte na
Groups. -
Najděte a otevřete skupinu:
-
V pravém panelu dvakrát klikněte na Event Log Readers.
-
Přidejte nového člena:
-
V okně, které se objeví, klikněte na tlačítko Add....
-
Vyberte uživatele nebo službu:
-
V poli Enter the object names to select zadejte jméno uživatele nebo služebního účtu, který chcete přidat.
- Pro služební účet jako Winlogbeat můžete použít:
* Pro běžného místního uživatele jednoduše zadejte uživatelské jméno (např.NT SERVICE\Winlogbeatwinlogbeat_user). -
Zkontrolujte a potvrďte:
-
Klikněte na Check Names pro ověření vstupu.
-
Klikněte na OK pro potvrzení.
-
Použijte a zavřete:
-
Klikněte na Apply a poté na OK, abyste zavřeli všechna okna.
-
Restartujte službu Winlogbeat:
-
Otevřete PowerShell nebo Příkazový řádek jako administrátor.
-
Spusťte:
Restart-Service winlogbeat
Filebeat
output.logstash:
hosts: ["<collector>:5044"]
filebeat.inputs:
- type: filestream
fields:
stream: <stream name>
paths:
- /path/to/the/file.log
Tip
<stream name> je například my-app-log.
Nemusíte zahrnovat nájemce nebo jakýkoli jiný prefix.
Microsoft DHCP
output.logstash:
hosts: ["<collector>:5044"]
filebeat.inputs:
# Microsoft DHCP IPv4
- type: filestream
id: microsoft-dhcp-ipv4
fields:
stream: microsoft-dhcp-filebeat-v1
prospector.scanner.fingerprint:
enabled: true
offset: 1780
length: 64
file_identity.fingerprint: ~
paths:
- C:\Windows\System32\DHCP\DhcpSrvLog-*.log
include_lines:
- "^[0-9]+,"
# Microsoft DHCP IPv6
- type: filestream
id: microsoft-dhcp-ipv6
fields:
stream: microsoft-dhcp-filebeat-v1
prospector.scanner.fingerprint:
enabled: true
offset: 1238
length: 64
file_identity.fingerprint: ~
paths:
- C:\Windows\System32\DHCP\DhcpV6SrvLog-*.log
include_lines:
- "^[0-9]+,"
Microsoft DNS
output.logstash:
hosts: ["<collector>:5044"]
filebeat.inputs:
# Microsoft DNS Debug Log
- type: filestream
id: microsoft-dns
fields:
stream: microsoft-dns-filebeat-v1
prospector.scanner.fingerprint:
enabled: true
offset: 1052
length: 64
file_identity.fingerprint: ~
paths:
- C:\Windows\System32\dns\debug.log
include_lines:
- "^[0-9]+[/-:][0-9]+"
Microsoft IIS
output.logstash:
hosts: ["<collector>:5044"]
filebeat.inputs:
# Microsoft IIS log
- type: filestream
id: microsoft-iis
fields:
stream: microsoft-iis-filebeat-v1
prospector.scanner.fingerprint:
enabled: true
offset: 1052
length: 64
file_identity.fingerprint: ~
paths:
- C:\inetpub\logs\LogFiles\W3SVC*\*.log
Shromažďování událostí z Google Cloud PubSub
Info
Tato možnost je dostupná od verze v23.27 a dále.
TeskaLabs LogMan.io Kolektor může shromažďovat události z Google Cloud PubSub pomocí nativního asynchronního konzumenta.
Dokumentace Google Cloud PubSub
Vysvětlení Pull Subscription Google Cloudu
Předpoklady
V Pub Sub je třeba shromáždit následující informace:
1.) Název projektu, ze kterého mají být zprávy spotřebovány
2.) Název předplatného vytvořeného v tématu, ze kterého mají být zprávy spotřebovány
Jak vytvořit PubSub předplatné
3.) Soubor účtu služby se soukromým klíčem pro autorizaci k danému tématu a předplatnému
Nastavení vstupu pro LogMan.io kolektor
Vstup pro Google Cloud PubSub
Vstup nazvaný input:GoogleCloudPubSub: musí být uveden v konfiguračním souboru YAML kolektoru LogMan.io:
input:GoogleCloudPubSub:GoogleCloudPubSub:
subscription_name: <NÁZEV_PŘEDPLATNÉHO_V_TÉMATU>
project_name: <NÁZEV_PROJEKTU_PRO_SPOTŘEBU>
service_account_file: <CESTA_K_SOUBORU_UČTU_SLŽBY>
output: <VÝSTUP>
<NÁZEV_PŘEDPLATNÉHO_V_TÉMATU>, <NÁZEV_PROJEKTU_PRO_SPOTŘEBU> a <CESTA_K_SOUBORU_UČTU_SLŽBY> musí být poskytnuty z Google Cloud Pub Sub.
Výstupem jsou události jako byte stream s následujícími metainformacemi: publish_time, message_id, project_name a subscription_name.
Potvrzení
Potvrzení/uznání je prováděno automaticky po zpracování každé jednotlivé dávky zpráv, aby nebyly stejné zprávy opakovaně posílány PubSub.
Výchozí dávka je 5 000 zpráv a může být změněna v konfiguraci vstupu pomocí možnosti max_messages:
max_messages: 10000
Sběr z Bitdefender GravityZone
TeskaLabs LogMan.io podporuje příjem bezpečnostních a provozních událostí z Bitdefender GravityZone pomocí push mechanismu popsaného v oficiální dokumentaci GravityZone API. To umožňuje organizacím bezproblémově integrovat data o ochraně koncových bodů do jejich centralizovaného SIEM pro korelaci, analýzu a reportování shody.
Požadovaná konfigurace
Bitdefender GravityZone je navržen tak, aby posílal události přes HTTPS do externího systému. Místo dotazování nebo periodického získávání dat, GravityZone aktivně odesílá logové zprávy, kdykoli dojde k relevantním bezpečnostním událostem. Pro povolení této integrace musíte nakonfigurovat GravityZone tak, aby směřoval na veřejnou IP adresu, kterou ovládáte. Na přijímací straně musí být LogMan.io Collector nasazen a správně nakonfigurován, aby naslouchal na této IP adrese a přijímal HTTPS připojení.
Tato konfigurace zajišťuje:
- Doručení bezpečnostních událostí v reálném čase bez zpoždění.
- Bezpečný přenos logových dat pomocí šifrovaného HTTPS.
- Přímou integraci do pipeline LogMan.io, kde jsou události analyzovány, normalizovány a zpřístupněny pro korelaci s ostatními zdroji logů.
V praxi to znamená, že Collector by měl být přístupný na internetu (nebo prostřednictvím potřebných pravidel firewall/NAT), aby GravityZone mohl úspěšně dosáhnout a doručit události.
Konfigurace Bitdefender GravityZone
Pro povolení sběru logů na bázi push musíte nejprve vytvořit a nakonfigurovat API klíč v cloudovém portálu Bitdefender GravityZone. Tento klíč je nutný pro autentizaci služby push notifikací a správu konfigurace doručování událostí. Také poskytuje přístup k statistikám a informacím o stavu služby push.
Postupujte podle těchto kroků:
1) Přihlaste se do portálu GravityZone
Přejděte na stránku podrobností o vašem účtu v portálu Bitdefender GravityZone.
2) Najděte sekci API klíče
Klikněte na ikonu uživatele v pravém horním rohu konzole a vyberte Můj účet.
Pokud má váš účet dostatečné administrativní oprávnění, uvidíte sekci „API klíče“ blízko spodní části stránky.
3) Vytvořte nový klíč
Klikněte na „Přidat“ pro vytvoření nového API klíče.
- Zadejte smysluplný popis (např. "TeskaLabs LogMan.io Event Push").
- Ujistěte se, že zaškrtnete políčko označené „Event Push Service API“ a „Network“. Tato možnost konkrétně umožňuje použití klíče pro konfiguraci a získávání nastavení push notifikací.
4) Zkopírujte hodnotu klíče
Po vytvoření klíče klikněte na modrou hodnotu klíče, aby se zobrazila. Poté klikněte na ikonu schránky, abyste zkopírovali API klíč do schránky vašeho počítače.
5) Uložte klíč bezpečně
Uložte API klíč na bezpečné místo. Budete ho potřebovat později během konfigurace LogMan.io Collector pro autentizaci a dokončení integrace.
Konfigurace LogMan.io Collector
Jakmile máte připravený API klíč v GravityZone, dalším krokem je nakonfigurovat LogMan.io Collector, aby mohl bezpečně přijímat a zpracovávat příchozí proud událostí.
Danger
Bitdefender GravityZone posílá push notifikace přes TCP port 443 (HTTPS). Ujistěte se, že je tento port přístupný z Internetu, nebo že jsou nastavena potřebná pravidla firewall/NAT, aby LogMan.io Collector mohl přijímat příchozí připojení. V současnosti neexistuje způsob, jak nastavit jiný port než 443. Pokud je to nutné, použijte proxy (např. NGINX) před Collectorem.
Níže je ukázka konfiguračního úryvku pro LogMan.io Collector:
input:Bitdefender:GravityZone:
listen: 443 ssl
authorization: "Bearer <The secret token>"
output: bitdefender-gz
output:CommLink:bitdefender-gz: {}
Hlavní body konfigurace:
listen: 443 ssl
Nastavuje Collector, aby naslouchal na příchozí HTTPS připojení na portu 443. SSL/TLS je vyžadováno pro vytvoření bezpečného kanálu pro doručování logů. Bitdefender GravityZone vyžaduje alespoň TLS 1.2.
authorization
Specifikuje token, který GravityZone musí předložit, aby mohla odesílat data.
Danger
Nahraďte <The secret token> unikátním, dostatečně dlouhým a bezpečným tokenem.
Tento token slouží jako autentizační mechanismus, aby bylo zajištěno, že pouze vaše důvěryhodná instance GravityZone může doručovat události.
Tip
Doporučujeme omezit přístup k tomuto konektoru pouze z IP whitelistu.
Povolení integrace
Jakmile jsou oba GravityZone a LogMan.io Collector nakonfigurovány, musíte povolit službu push, aby GravityZone začal doručovat události na váš koncový bod Collector. To se provádí vyvoláním pomocného skriptu, který je součástí kontejneru LogMan.io Collector.
$ docker exec \
-e API_KEY="<API key>" \
lmio-collector \
python3 bitdefender.py set \
--auth-header "Bearer <The secret token>" \
--url https://<Collector IP address>/bitdefender-gz
Vysvětlení parametrů
API_KEY
API klíč, který jste vytvořili dříve v portálu GravityZone (s povoleným Event Push Service API). Tento klíč autorizuje LogMan.io Collector k konfiguraci nastavení push notifikací v GravityZone.
--auth-header "Bearer <The secret token>"
Stejný token, který jste nakonfigurovali v poli autorizace Collectoru. GravityZone zahrne tuto hodnotu do každého HTTPS požadavku, což umožní LogMan.io Collector ověřit zdroj.
--url https://<Collector IP address>/bitdefender-gz
Veřejně přístupná URL vašeho LogMan.io Collector.
Nahraďte <Collector IP address> skutečnou veřejnou IP nebo DNS jménem vašeho LogMan.io Collector.
Cesta /bitdefender-gz je koncový bod, který bude zpracovávat push události z GravityZone.
Očekávaná odpověď
Pokud je nastavení úspěšné, GravityZone odpoví potvrzením ve formátu JSON-RPC:
{
"id": "1",
"jsonrpc": "2.0",
"result": true
}
To naznačuje, že služba push byla povolena a že GravityZone nyní začne přímo odesílat události na váš LogMan.io Collector. Může trvat až 10 minut, než se první logy objeví v TeskaLabs LogMan.io.
Řešení problémů
Skripty zahrnuté v balíčku poskytují více možností pro řešení problémů s integrací Bitdefender GravityZone:
get: Získat aktuální nastavení push událostí (getPushEventSettings)get-stats: Získat statistiky push událostí (getPushEventStats)reset-stats: Resetovat statistiky push událostí (resetPushEventStats)test: Odeslat testovací push událost (sendTestPushEvent)
Příklad:
$ docker exec -e
-e API_KEY="<API key>" \
lmio-collector \
python3 bitdefender.py test
Webový server
Konfigurace Kolektoru LogMan.io
Na serveru LogMan.io, kam jsou logy odesílány prostřednictvím HTTP(S), spusťte instanci Kolektoru LogMan.io s následující konfigurací. Všechny HTTP metody jsou podporovány.
V sekci listen nastavte odpovídající port nakonfigurovaný v přesměrování logů v konfiguraci zdrojového zařízení.
Konfigurace webového serveru
input:WebServer:WebServer:
listen: 0.0.0.0 <PORT_SET_IN_FORWARDING> ssl
cert: <PATH_TO_PEM_CERT>
key: <PATH_TO_PEM_KEY_CERT>
cafile: <PATH_TO_PEM_CA_CERT>
encoding: utf-8
output: <OUTPUT_ID>
stream_name_from_path: # false/true, true pokud by první část URL měla být jako název streamu, jinak je výchozí false
output:xxxxxx:<OUTPUT_ID>:
...
Sběr z zařízení Cisco IOS
Tato metoda sběru je navržena pro sběr logů z produktů Cisco, které provozují IOS, jako je například přepínač Cisco Catalyst 2960 nebo router Cisco ASR 9200.
Konfigurace logu
Nakonfigurujte vzdálenou adresu kolektoru a úroveň logování:
CATALYST(config)# logging host <hostname nebo IP kolektoru LogMan.io> transport tcp port <číslo-portu>
CATALYST(config)# logging trap informational
CATALYST(config)# service timestamps log datetime year msec show-timezone
CATALYST(config)# logging origin-id <hostname>
Formát logu obsahuje následující pole:
-
timestamp ve formátu UTC s:
- rokem, měsícem, dnem
- hodinou, minutou a sekundou
- milisekundou
-
hostname zařízení
-
log level je nastaven na informational
Příklad výstupu
<189>36: CATALYST: Aug 22 2022 10:11:25.873 UTC: %SYS-5-CONFIG_I: Configured from console by admin on vty0 (10.0.0.44)
Synchronizace času
Je důležité, aby čas zařízení Cisco byl synchronizován pomocí NTP.
Předpoklady jsou: * Internetové připojení (pokud používáte veřejný NTP server) * Konfigurovaná volba name-server (pro rozlišení DNS dotazu)
LAB-CATALYST(config)# no clock timezone
LAB-CATALYST(config)# no ntp
LAB-CATALYST(config)# ntp server <hostname nebo IP NTP serveru>
Příklad konfigurace s NTP serverem Google:
CATALYST(config)# no clock timezone
CATALYST(config)# no ntp
CATALYST(config)# do show ntp associations
%NTP je zakázáno.
CATALYST(config)# ntp server time.google.com
CATALYST(config)# do show ntp associations
adresa ref clock st when poll reach delay offset disp
*~216.239.35.4 .GOOG. 1 58 64 377 15.2 0.58 0.4
* master (synchronizováno), # master (nesynchronizováno), + vybráno, - kandidát, ~ konfigurováno
CATALYST(config)# do show clock
10:57:39.110 UTC Mon Aug 22 2022
Sbírání z Citrix
TeskaLabs LogMan.io může sbírat Citrix logy pomocí Syslog prostřednictvím přesměrování logů přes TCP (doporučeno) nebo UDP komunikaci.
Citrix ADC
Pokud jsou Citrix zařízení připojena přes ADC, existuje následující návod na to, jak povolit Syslog přes TCP. Ujistěte se, že vyberete správný server a port LogMan.io pro přesměrování logů.
F5 BIG-IP
Pokud jsou Citrix zařízení připojena k F5 BIG-IP, použijte následující návod. Ujistěte se, že vyberete správný server a port LogMan.io pro přesměrování logů.
Konfigurace LogMan.io Kolektoru
Na serveru LogMan.io, kam jsou logy přesměrovány, spusťte instance LogMan.io Kolektoru s následující konfigurací.
Přesměrování logů přes TCP
input:TCPBSDSyslogRFC6587:Citrix:
address: 0.0.0.0:<PORT_SET_IN_FORWARDING>
output: WebSocketOutput
output:WebSocket:WebSocketOutput:
url: http://<LMIO_SERVER>:<YOUR_PORT>/ws
tenant: <YOUR_TENANT>
debug: false
prepend_meta: false
Přesměrování logů přes UDP
input:Datagram:Citrix:
address: 0.0.0.0:<PORT_SET_IN_FORWARDING>
output: WebSocketOutput
output:WebSocket:WebSocketOutput:
url: http://<LMIO_SERVER>:<YOUR_PORT>/ws
tenant: <YOUR_TENANT>
debug: false
prepend_meta: false
Sbírání logů z Fortinet FortiGate
TeskaLabs LogMan.io může sbírat logy Fortinet FortiGate přímo nebo skrze FortiAnalyzer pomocí přeposílání logů přes TCP (doporučeno) nebo UDP komunikaci.
Přeposílá logy do LogMan.io
Jak ve FortiGate, tak ve FortiAnalyzer musí být zvolen typ Syslog spolu s odpovídajícím portem.
Pro precizní návody, viz následující odkaz:
Konfigurace Kolektoru LogMan.io
Na serveru LogMan.io, kam jsou logy přeposílány, spusťte LogMan.io Collector instance s následující konfigurací.
V sekci address nastavte odpovídající port, který je nastaven v přeposílání logů ve FortiAnalyzer.
Přeposílání logů přes TCP
input:TCPBSDSyslogRFC6587:Fortigate:
address: 0.0.0.0:<PORT_SET_IN_FORWARDING>
output: <OUTPUT_ID>
output:xxxxxxx:<OUTPUT_ID>:
...
Přeposílání logů přes UDP
input:Datagram:Fortigate:
address: 0.0.0.0:<PORT_SET_IN_FORWARDING>
output: <OUTPUT_ID>
output:xxxxxxx:<OUTPUT_ID>:
...
Sběr událostí z Microsoft Azure Event Hub
Tato možnost je dostupná od verze v22.45 výše
TeskaLabs LogMan.io Collector může sbírat události z Microsoft Azure Event Hub pomocí nativního klienta nebo Kafka. Události uložené v Azure Event Hub mohou obsahovat jakákoli data kódovaná v bajtech, jako jsou logy o různých akcích uživatelů, administrátorů, systémů, zařízení a politik.
Nastavení Microsoft Azure Event Hub
Pro to, aby LogMan.io Collector mohl číst události, je třeba získat následující přihlašovací údaje: connection string, event hub name a consumer group.
Získání connection string z Microsoft Azure Event Hub
1) Přihlaste se do Azure portálu s administrátorskými právy do příslušného Azure Event Hubs Namespace.
Namespace Azure Event Hubs je k dispozici v sekci Resources.
2) V vybraném Azure Event Hubs Namespace klikněte na Shared access policies v sekci Settings v levém menu.
Klikněte na tlačítko Add, zadejte název politiky (doporučený název je: LogMan.io Collector) a v pravém vyskakovacím okně by se měly objevit podrobnosti o politice.
3) V vyskakovacím okně vyberte možnost Listen, aby tato politika měla právo číst z event hubů spojených s daným namespace.
Viz následující obrázek.
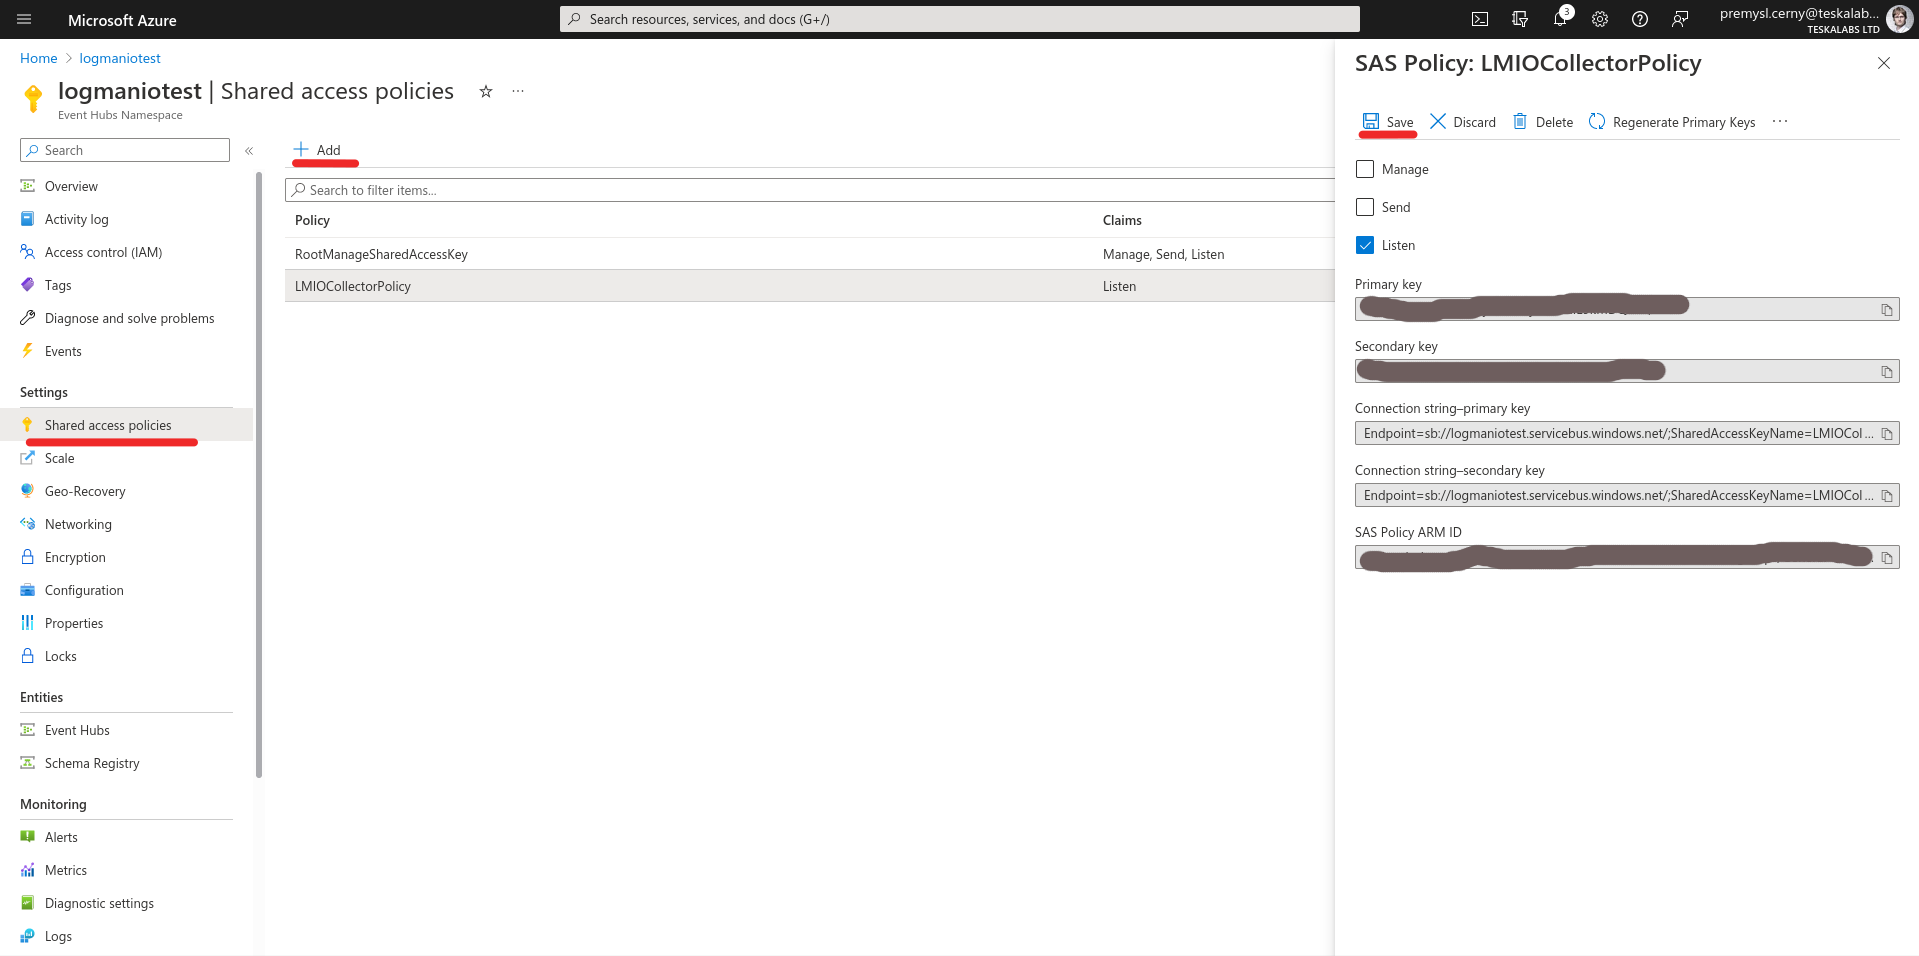
4) Zkopírujte Connection string-primary key a klikněte na Save.
Politika by měla být viditelná v tabulce uprostřed obrazovky.
Connection string začíná předponou Endpoint=sb://.
Získání consumer group
5) V namespace Azure Event Hubs vyberte možnost Event Hubs z levého menu.
6) Klikněte na event hub, který obsahuje události určené ke sběru.
7) V event hubu klikněte na tlačítko + Consumer group uprostřed obrazovky.
8) V pravém vyskakovacím okně zadejte název consumer group (doporučená hodnota je lmio_collector) a klikněte na Create.
9) Tento postup opakujte pro všechny event huby určené ke sběru.
10) Zapište si název consumer group a všechny event huby pro následnou konfiguraci LogMan.io Collector.
Nastavení vstupu LogMan.io Collector
Azure Event Hub Input
Vstup s názvem input:AzureEventHub: musí být zadán v YAML konfiguraci LogMan.io Collector:
input:AzureEventHub:AzureEventHub:
connection_string: <CONNECTION_STRING>
eventhub_name: <EVENT_HUB_NAME>
consumer_group: <CONSUMER_GROUP>
output: <OUTPUT>
<CONNECTION_STRING>, <EVENT_HUB_NAME> a <CONSUMER_GROUP> jsou poskytovány podle výše uvedeného průvodce.
Následující meta možnosti jsou k dispozici pro parser: azure_event_hub_offset, azure_event_hub_sequence_number, azure_event_hub_enqueued_time, azure_event_hub_partition_id, azure_event_hub_consumer_group a azure_event_hub_eventhub_name.
Výstupem jsou události jako byte stream, podobně jako vstup Kafka.
Azure Monitor Through Event Hub Input
Azure Monitor Through Event Hub Input načítá události z Azure Event Hub, načítá Azure Monitor JSON log a rozkládá jednotlivé záznamy na logové linky, které jsou poté odesílány na definovaný výstup.
Vstup s názvem input:AzureMonitorEventHub: musí být zadán v YAML konfiguraci LogMan.io Collector:
input:AzureMonitorEventHub:AzureMonitorEventHub:
connection_string: <CONNECTION_STRING>
eventhub_name: <EVENT_HUB_NAME>
consumer_group: <CONSUMER_GROUP>
encoding: # výchozí: utf-8
output: <OUTPUT>
<CONNECTION_STRING>, <EVENT_HUB_NAME> a <CONSUMER_GROUP> jsou poskytovány podle výše uvedeného průvodce.
Následující meta možnosti jsou k dispozici pro parser: azure_event_hub_offset, azure_event_hub_sequence_number, azure_event_hub_enqueued_time, azure_event_hub_partition_id, azure_event_hub_consumer_group a azure_event_hub_eventhub_name.
Výstupem jsou události jako byte stream, podobně jako vstup Kafka.
Alternativa: Kafka Input
Azure Event Hub také poskytuje (s výjimkou uživatelů základní vrstvy) rozhraní Kafka, takže lze použít standardní Kafka vstup LogMan.io Collector.
Existuje několik možností autentizace v Kafka, včetně OAuth atd.
Nicméně, pro účely dokumentace a opětovné použití connection string, preferujeme jednoduchou autentizaci SASL pomocí connection string z výše uvedeného průvodce.
input:Kafka:KafkaInput:
bootstrap_servers: <NAMESPACE>.servicebus.windows.net:9093
topic: <EVENT_HUB_NAME>
group_id: <CONSUMER_GROUP>
security.protocol: SASL_SSL
sasl.mechanisms: PLAIN
sasl.username: "$ConnectionString"
sasl.password: <CONNECTION_STRING>
output: <OUTPUT>
<CONNECTION_STRING>, <EVENT_HUB_NAME> a <CONSUMER_GROUP> jsou poskytovány podle výše uvedeného průvodce, <NAMESPACE> je název zdroje Azure Event Hub (také zmíněn v průvodci výše).
Následující meta možnosti jsou k dispozici pro parser: kafka_key, kafka_headers, _kafka_topic, _kafka_partition a _kafka_offset.
Výstupem jsou události jako byte stream.
Sbírejte logy z SQL databáze pomocí ODBC
Úvod
Doporučený způsob získávání logů a dalších událostí z databází je pomocí ODBC. ODBC poskytuje jednotný způsob, jak připojit TeskaLabs LogMan.io k různým databázovým systémům.
ODBC ovladače
Obrázek kontejneru TeskaLabs LogMan.io kolektoru je dodáván s následujícími ODBC ovladači:
- ODBC Driver 18 pro SQL Server (Microsoft SQL Server)
- ODBC Driver 17 pro SQL Server (Microsoft SQL Server)
- PostgreSQL, Unicode a ANSI
- FreeTDS pro Microsoft SQL Server a Sybase databáze.
- MariaDB funguje také pro MySQL
- Oracle (funguje pro všechny nedávné verze Oracle Database)
- Firebird 2
ODBC ovladače pro jiné databáze mohou být snadno přidány do TeskaLabs LogMan.io kolektoru. Příslušný ODBC ovladač musí být kompatibilní s Debian GNU/Linux 12 (bookworm), x86-64. Kolektor používá unixODBC pro správu ODBC ovladačů.
Konfigurace ODBC se provádí v souboru /etc/odbcinst.ini, který je přítomen v kontejneru TeskaLabs LogMan.io kolektoru.
Obsah předem vytvořeného souboru /etc/odbcinst.ini
[ODBC Driver 18 for SQL Server]
Description=Microsoft ODBC Driver 18 for SQL Server
Driver=/opt/microsoft/msodbcsql18/lib64/libmsodbcsql-18.5.so.1.1
UsageCount=1
[ODBC Driver 17 for SQL Server]
Description=Microsoft ODBC Driver 17 for SQL Server
Driver=/opt/microsoft/msodbcsql17/lib64/libmsodbcsql-17.10.so.6.1
UsageCount=1
[PostgreSQL Unicode]
Description=PostgreSQL ODBC driver (Unicode verze)
Driver=psqlodbcw.so
Setup=libodbcpsqlS.so
Debug=0
CommLog=1
UsageCount=1
[FreeTDS]
Description=TDS ovladač (Sybase/MS SQL)
Driver=libtdsodbc.so
Setup=libtdsS.so
CPTimeout=
CPReuse=
UsageCount=1
[MariaDB Unicode]
Driver=libmaodbc.so
Description=MariaDB Connector/ODBC (Unicode)
Threading=0
UsageCount=1
[Oracle 19]
Description=Oracle ODBC ovladač pro Oracle 19
Driver=/usr/lib/oracle/19.19/client64/lib/libsqora.so.19.1
Setup=/usr/lib/oracle/19.19/client64/lib/libsqora.so.19.1
UsageCount=1
[Firebird 2]
Description=Firebird 2 (pro verzi 2.5 a starší) ODBC ovladač
Driver=libOdbcFb.so
Setup=libOdbcFb.so
UsageCount=1
Konfigurace inputu kolektoru
Specifikace zdroje inputu je input:ODBC:.
Příklad konfigurace ODBC collectoru:
input:ODBC:ODBCInput:
dsn: Driver={FreeTDS};Server=MyServer;Port=1433;Database=MyDatabase;TDS_Version=7.3;UID=MyUser;PWD=MyPassword
query: SELECT * FROM mytable WHERE {increment_where_clause} ORDER BY insertion_time;
increment_strategy: date
increment_first_value: "2020-10-01 00:00:00.000"
increment_column_name: "insertion_time"
chilldown_period: 30
last_value_storage: /data/var/last_value_storage
output: smart
Note
Můžete specifikovat více sekcí input:ODBC: (input:ODBC:MyDatabase01:, input:ODBC:MyDatabase02: a tak dále) pro konfiguraci více než jednoho ODBC extrakce.
Alternativně můžete nasadit nový kontejner kolektoru, který bude věnován každému ODBC zdroji.
DSN
DSN (Data Source Name) se používá k popisu připojení k datovému zdroji. Termín DSN se překrývá s "ODBC připojovacím řetězcem".
Příklad DSN:
Driver={FreeTDS};Server=MyServer;Port=1433;Database=MyDatabase;UID=MyUser;PWD=MyPassword
TeskaLabs LogMan.io doporučuje, aby DSN zahrnoval specifikaci Driver.
Seznam dostupných ovladačů lze získat pomocí příkazu odbcinst:
$ docker run -it lmio-collector odbcinst -q -d
[ODBC Driver 18 for SQL Server]
[ODBC Driver 17 for SQL Server]
[PostgreSQL Unicode]
[FreeTDS]
[MariaDB]
[Oracle 19]
[Firebird 2]
Oracle DSN
DRIVER={Oracle 19};Dbq=//<host>:<port>/<SID>;UID=<user>;PWD=<password>;
PostgreSQL DSN
Driver={PostgreSQL Unicode};Server=<host>;Port=<port>;Database=<database>;Uid=<user>;Pwd=<password>;
Tip
Další příklady ODBC DSN naleznete zde.
Řešení problémů
Prozkoumat strukturu databáze
Kontejner TeskaLabs LogMan.io kolektoru poskytuje jednoduchý nástroj příkazového řádku pro provádění SQL dotazů přes ODBC. Tento nástroj může být použit k ověření konektivity k cílové databázi a k prozkoumání struktury databáze.
$ docker run -it lmio-collector odbccli.py "DRIVER={Oracle};..."
TeskaLabs LogMan.io ODBC CLI - Interaktivní režim
Připojování k databázi ...
Úspěch!
Zadejte SQL SELECT dotazy (napište 'quit' nebo 'exit' pro ukončení):
SQL> SELECT * from dual;
Výsledky (1 řádek):
+---------+
| DUMMY |
+=========+
| X |
+---------+
Přidání ODBC Trace
Pokud potřebujete větší přehled o ODBC konektivitě, můžete povolit ODBC sledování.
Přidejte tuto sekci do souboru /etc/odbcinst.ini :
[ODBC]
Trace = yes
TraceFile = /tmp/trace.log
Když je kolektor spuštěn, výstup sledování ODBC systému je uložen do souboru /tmp/trace.log.
Tento soubor je dostupný také mimo kontejner.
Ověření konfigurace ODBC
Příkaz odbcinst -j (spuštěný uvnitř kontejneru) lze použít k ověření připravenosti ODBC:
$ odbcinst -j
unixODBC 2.3.6
DRIVERS............: /etc/odbcinst.ini
SYSTEM DATA SOURCES: /etc/odbc.ini
FILE DATA SOURCES..: /etc/ODBCDataSources
USER DATA SOURCES..: /root/.odbc.ini
SQLULEN Size.......: 8
SQLLEN Size........: 8
SQLSETPOSIROW Size.: 8
Shromažďování SNMP trapů
SNMP trapy jsou nevyžádané, událostmi řízené notifikace, které zařízení posílají příjemci trapů (Kolektor logů TeskaLabs LogMan.io). Na rozdíl od dotazování (SNMP GET/WALK) trapy posílají změny v téměř reálném čase - změny rozhraní, chyby spojení, alarmy PSU/teploty, selhání ventilátorů, změny stavu UPS, VPN tunely nahoru/dolů a další; což z nich činí cenný signál pro TeskaLabs LogMan.io. Trapy existují ve verzích v1, v2c a v3.
Každý trap nese podnikový OID a sadu varbindů (páry klíč-hodnota), které popisují kontext události. Řešení těchto OID s odpovídajícími MIB přetváří neprůhledná čísla na lidsky čitelné pole, která mohou vaši analytici vyhledávat, korelovat a na která mohou upozorňovat. V TeskaLabs LogMan.io zpracovatelském pipeline jsou trapy normalizovány (závažnost, zařízení, komponenta, příčina) a obohaceny (role zařízení, místo, vlastník) před uložením, detekcí a upozorňováním.
Konfigurace kolektoru
Toto umožňuje zachytávání SNMP trapů na výchozím portu UDP/162.
input:Datagram:udp-snmp-162:
address: 162
output: snmp-162
output:CommLink:snmp-162: {}
Shromažďování logů z Oracle Cloud
Můžete shromažďovat logy z Oracle Cloud Infrastructure (OCI).
Více o OCI Logging naleznete zde.
Pro konfiguraci LogMan.io Collector budete potřebovat:
- Generovat nový API klíč spolu s novými veřejnými a soukromými klíči v OCI konzoli
- Vytvořit nový vyhledávací dotaz pro API požadavky
Generování API klíče v OCI konzoli
-
Přihlaste se do své OCI konzole.
-
Zvolte Nastavení uživatele z nabídky v pravém horním rohu.
-
Přejděte na Zdroje, vyberte API klíče a klikněte na Přidat API klíč.
-
Ujistěte se, že je vybraná možnost Generovat pár API klíčů. Klikněte na Stáhnout soukromý klíč a poté Stáhnout veřejný klíč. Poté klikněte na Přidat.
-
Bude vytvořen konfigurační soubor se všemi potřebnými přihlašovacími údaji. Vložte obsah textového pole do souboru
data/oci/config.
-
Vyplňte
key_filecestou k vašemu soukromému klíčovému souboru.
Important
Nikdy nesdílejte svůj soukromý klíč s nikým jiným. Uchovávejte ho v tajnosti ve vlastním souboru. Možná budete muset změnit oprávnění veřejného a soukromého klíče po jejich stažení.
Jak funguje proces požadavku?
Soukromé a veřejné klíče jsou součástí asymetrického šifrovacího systému. Veřejný klíč je uložen u Oracle Cloud Infrastructure a používá se k ověření identity klienta. Soukromý klíč, který uchováváte v bezpečí a nikdy jej nesdílíte, se používá k podepisování vašich API požadavků.
Když vytvoříte požadavek na OCI API, klientský software použije soukromý klíč k vytvoření digitálního podpisu pro požadavek. Tento podpis je unikátní pro každý požadavek a je generován na základě dat požadavku. Klient potom odešle API požadavek společně s tímto digitálním podpisem do Oracle Cloud Infrastructure.
Po obdržení požadavku Oracle použije veřejný klíč (který již má), aby ověřil digitální podpis. Pokud je podpis platný, potvrzuje to, že požadavek skutečně odeslal držitel odpovídajícího soukromého klíče (vy) a že nebyl během přenosu změněn. Tento proces je důležitý pro zachování integrity a autenticity komunikace.
Soukromý klíč sám o sobě nikdy není odesílán po síti. Zůstává na straně klienta. Bezpečnost celého procesu závisí na tom, že soukromý klíč zůstane důvěrný. Pokud by byl kompromitován, ostatní by mohli předstírat vaši službu a odesílat požadavky na OCI vaším jménem.
Specifikace vyhledávacího dotazu pro logování
Prosím, obraťte se na oficiální dokumentaci pro vytvoření nových dotazů.
Budete potřebovat následující informace:
- Compartment OCID
- Log group OCID
- Log OCID
Příklad vyhledávacího dotazu pro logování
search "<compartment_OCID>/<log_group_OCID>/<log_OCID>" | where level = 'ERROR' | sort by datetime desc
Konfigurace
Níže je uvedena požadovaná konfigurace pro LogMan.io Collector:
input:Oracle:OCIInput:
oci_config_path: ./data/oci/config # Cesta k vašemu OCI konfiguračnímu souboru (povinné)
search_query: search '<compartment_OCID>/<log_group_OCID>/<log_OCID>' | where level = 'ERROR' # (povinné)
encoding: utf-8 # Kódování eventů (volitelné)
interval: 10 # Počet sekund mezi požadavky na OCI (volitelné)
output: <output_id> # (povinné)
Vývoj
Warning
LogMan.io Collector Oracle Source je postaven na OCI integraci pro API, která používá synchronní požadavky. Může dojít k problémům, pokud je velký TCP vstup.
Sběr událostí ze Zabbix
TeskaLabs LogMan.io Collector může sbírat události ze Zabbix prostřednictvím Zabbix API.
Zdroj Zabbix Metrics
Zdroj Zabbix Metrics pravidelně odesílá požadavky event.get a history.get.
Požadavek event.get se používá k vyhledání dat událostí ze serveru Zabbix. Události v Zabbix představují významné události v monitorovaném prostředí, jako jsou spuštění triggerů, akce průzkumníka nebo interní události Zabbix.
Požadavek history.get se používá k vyhledání historických dat ze Zabbix, která obsahují různé typy monitorovacích dat, jako jsou číselné hodnoty, textové logy a další.
Konfigurace
Příklad minimální požadované konfigurace:
input:ZabbixMetrics:<SOURCE_ID>:
url: https://192.0.0.5/api_jsonrpc.php # URL pro Zabbix API
auth: b03.......6f # Autorizační token pro Zabbix API
output: <output_id>
output:<type>:<output_id>:
...
Volitelně můžete konfigurovat vlastnosti požadavků:
interval: 60 # (volitelné, výchozí: 60) Časový interval mezi požadavky v sekundách
max_requests: 100 # (volitelné, výchozí: 50) Počet současných požadavků
request timeout: 10 # (volitelné, výchozí: 10) Timeout pro požadavky v sekundách
sleep_on_error: 10 # (volitelné, výchozí: 10) Když dojde k chybě, LMIO Collector počká určitou dobu a pak požadavky odešle znovu
Můžete také změnit kódování příchozích událostí:
encoding: utf-8 # (volitelné) Kódování příchozích událostí
Typy historie
V Zabbix objekt historie představuje zaznamenaný kus dat spojený s metrikou v čase. Tyto objekty historie jsou základní pro analýzu výkonu a stavu monitorovaných entit, neboť ukládají skutečné sbírané datové body. Každý objekt historie je spojen se specifickou položkou a obsahuje časové razítko, které označuje, kdy byla data sesbírána. Objekty historie se používají ke sledování a analýze trendů, generování grafů a spouštění alertů na základě historických dat.
Mnoho různých typů objektů historie může být vráceno v událostech. Další informace najdete v oficiální dokumentaci.
| Typ objektu historie | Název | Využití |
|---|---|---|
| 0 | číselné plovoucí číslo | metriky jako zatížení CPU, teplota, atd. |
| 1 | znakový | záznamy logů, statusy služeb, atd. |
| 2 | log | systémové a aplikační logy |
| 3 | (výchozí) číselné bez znaménka | volné místo na disku, síťový provoz, atd. |
| 4 | text | popisy, zprávy, atd. |
| 5 | binární | binární zprávy |
Typy historie jsou konfigurovány následujícím způsobem:
histories_to_return: "0,1,3" # (volitelné, výchozí: '0,3') Seznam typů historie
Položky metrik
Položka metriky v Zabbix specifikuje typ dat, který má být sesbíraný z monitorovaného hostu. Každá položka je spojena s klíčem, který jednoznačně identifikuje data, která mají být sesbírána, stejně jako další atributy, jako typ dat, frekvenci sběru a jednotky měření. Položky mohou představovat různé typy dat, včetně číselných hodnot, textů, záznamů logů a další.
Server Zabbix typicky obsahuje velké množství hostů, od kterých bude historie sbírána. Chcete-li filtraci podle specifických položek metrik, postupujte takto:
- Vytvořte CSV soubor se seznamem typů metrik, každou na samostatném řádku:
Uptime
Number of processes
Number of threads
FortiGate: System uptime
VMware: Uptime
CPU utilization
CPU user time
...
- Konfigurujte cestu k souboru v konfiguraci Zabbix Metrics Source v LogMan.io Collector:
items_list_filename: conf/items.csv
Tip
Doporučujeme filtrovat menší podmnožinu typů metrik, aby nedošlo k přetížení serveru Zabbix.
Zdroj Zabbix Security
Zdroj Zabbix Security pravidelně odesílá požadavky event.get a alert.get.
Požadavek event.get se používá k vyhledání dat událostí ze serveru Zabbix. Události v Zabbix představují významné události v monitorovaném prostředí, jako jsou spuštění triggerů, akce průzkumníka nebo interní události Zabbix.
Požadavek alert.get se používá k vyhledání dat alertů ze serveru Zabbix. Alerty v Zabbix jsou oznámení generovaná v reakci na určité podmínky nebo události, jako jsou změny stavu triggeru, akce průzkumníka nebo interní systémové události. Tyto alerty mohou být konfigurovány k upozorňování administrátorů nebo provádění automatizovaných akcí k řešení problémů.
Požadovaná konfigurace
Příklad minimální požadované konfigurace:
input:ZabbixSecurity:<SOURCE_ID>:
url: https://192.0.0.5/api_jsonrpc.php # URL pro Zabbix API
auth: b03.......6f # Autorizační token pro Zabbix API
output: <output_id>
output:<type>:<output_id>:
...
Volitelně můžete konfigurovat vlastnosti požadavků:
interval: 60 # (volitelné, výchozí: 60) Časový interval mezi požadavky v sekundách
request timeout: 10 # (volitelné, výchozí: 10) Timeout pro požadavky v sekundách
sleep_on_error: 10 # (volitelné, výchozí: 10) Když dojde k chybě, LMIO Collector počká určitou dobu a pak požadavky odešle znovu
Můžete také změnit kódování příchozích událostí:
encoding: utf-8 # (volitelné) Kódování příchozích událostí
ESET Connect API Zdroj
ESET Connect je API brána mezi klientem a kolekcí backendových služeb ESET. Funguje jako reverzní proxy, která přijímá všechna volání aplikačního programového rozhraní (API), agreguje různé služby potřebné k jejich splnění a vrací odpovídající výsledek.
Vytvoření nového API klienta
Warning
Pro vytvoření nového uživatele musíte mít superuser oprávnění v ESET Business Account.
- Přihlašte se jako superuser (Administrátor) do ESET Business Account.
-
Otevřete Správu uživatelů a klikněte na tlačítko Nový uživatel dole.
-
Vytvořte účet s oprávněním read-only a zapněte přepínač Integrace.
-
Nový uživatelský účet by měl být úspěšně vytvořen s možností čtení z ESET Connect API.
Sbírání detekcí z připojených zařízení
Připojená zařízení jsou organizována v skupinách zařízení. Každá skupina může mít své podskupiny. Jedno zařízení může být členem různých podskupin. Je možné monitorovat detekce z vybraných zařízení nebo vybraných skupin zařízení. Pokud tyto nejsou specifikovány, všechna zařízení jsou monitorována.
Konfigurace Kolektoru logů LogMan.io
'input:ESET:EsetSource':
client_id: john.doe@domain.com # (povinné) E-mail API Klienta
client_secret: client_secret # (povinné) Heslo pro API Klienta
interval: 10 # (volitelné, default: 10) Interval mezi požadavky v sekundách.
Konfigurace LogMan.io Collectoru
Konfigurace LogMan.io Collectoru obvykle sestává ze dvou souborů.
- Konfigurace Collectoru (
/conf/lmio-collector.conf, formát INI) specifikuje cestu ke konfiguračnímu souboru pipeline a případně dalším volbám na úrovni aplikace. - Konfigurace Pipeline (
/conf/lmio-collector.yaml, formát YAML) specifikuje, ze kterých vstupů se data sbírají (inputs), jak se data transformují (transforms) a jak se data dále posílají (outputs).
Konfigurace Collectoru
[config]
path=/conf/lmio-collector.yaml
Konfigurace Pipeline
Konfigurace pipeline je ve formátu YAML. Více pipeline může být konfigurováno ve stejném konfiguračním souboru pipeline.
Každá sekce představuje jednu komponentu pipeline. Vždy začíná buď input:, transform:, output: nebo connection: a má formu:
input|transform|output:<TYPE>:<ID>
kde <TYPE> určuje typ komponenty. <ID> se používá pro referenci a může být libovolně zvoleno.
- Input specifikuje zdroj/vstup logů.
- Output specifikuje výstup, kam se logy odesílají.
- Connection specifikuje připojení, které může používat
output. - Transform specifikuje transformační akci, která se aplikuje na logy (volitelné).
Typická konfigurace pipeline pro LogMan.io Receiver:
# Připojení k LogMan.io (centrální část)
connection:CommLink:commlink:
url: https://recv.logman.example.com/
# Vstup
input:Datagram:udp-10002-src:
address: 0.0.0.0 10002
output: udp-10002
# Výstup
output:CommLink:udp-10002: {}
Podrobné možnosti konfigurace každé komponenty naleznete v kapitolách Inputs, Transformations a Outputs. Podrobnosti připojení CommLink viz dokumentace LogMan.io Receiver.
Dynamická konfigurace z webového rozhraní
Collector lze konfigurovat dynamicky z webového rozhraní. Konfigurace Collectoru je uložena na stroji Collectoru a lze ji aktualizovat bez restartu Collectoru přes komunikační kanál CommLink s LogMan.io Receiver.
Vstupy LogMan.io Collector
Note
Tato kapitola se týká nastavení zdrojů logů sbíraných přes síť, syslog, soubory atd. Pro nastavení sběru událostí z různých zdrojů logů viz podtéma Zdroje logů.
Subprocess
Sekce: input:SubProcess
Vstup SubProcess spouští příkaz jako podproces kolektoru LogMan.io, přičemž
pravidelně kontroluje jeho výstup na stdout (řádky) a stderr.
Možnosti konfigurace zahrnují:
command: # Zadejte příkaz, který má být spuštěn jako podproces (např. tail -f /data/tail.log)
output: # Na který výstup odeslat příchozí události
line_len_limit: # (volitelné) Limit délky jednoho přečteného řádku (výchozí: 1048576)
ok_return_codes: # (volitelné) Které návratové kódy znamenají běžný stav příkazu (výchozí: 0)
Sledování souboru
Sekce: input:SmartFile
Smart File Input se používá pro sběr událostí z více souborů, jejichž obsah může být dynamicky změněn,
nebo soubory mohou být odstraněny jiným procesem, podobně jako příkaz tail -f v shellu.
Smart File Input vytváří monitorovaný souborový objekt pro každou cestu k souboru, která je zadána v konfiguraci v možnosti path.
Monitorovaný soubor pravidelně kontroluje nové řádky v souboru, a pokud se objeví, řádek je přečten v bajtech a předán dál do pipeline, včetně meta informací, jako je název souboru a extrahované části cesty k souboru, viz sekce parametry extrakce.
Různé protokoly se používají pro čtení z různých formátů logových souborů:
- Protokol řádků pro řádkově orientované logové soubory
- XML protokol pro XML-orientované logové soubory
- W3C Extended Log File Protocol pro logové soubory ve formátu W3C Extended Log File Format
- W3C DHCP Server Protocol pro logové soubory DHCP serveru
Povinné možnosti konfigurace:
input:SmartFile:MyFile:
path: | # Cesty k souborům oddělené novými řádky
/prvni/cesta/k/logum/*.log
/druha/cesta/k/logum/*.log
/dalsi/cesta/*s
protocol: # Protokol, který má být použit pro čtení
Volitelné možnosti konfigurace:
recursive: # Rekurzivní skenování zadaných cest (výchozí: True)
scan_period: # Období skenování souborů v sekundách (výchozí: 3 sekundy)
preserve_newline: # Zachovat nový řádek v výstupu (výchozí: False)
last_position_storage: # Perzistentní úložiště pro aktuální pozice ve čtených souborech (výchozí: ./var/last_position_storage)
Tip
Při složitějším setupu, jako je extrakce logů ze sdílené složky Windows, můžete využít rsync pro synchronizaci logů ze sdílené složky do lokální složky na kolektoru LogMan.io. Potom Smart File Input čte logy z lokální složky.
Warning
Vnitřně je aktuální pozice v souboru uložena ve last position storage v proměnné pozice. Pokud je soubor last position storage smazán nebo není specifikován, všechny soubory jsou čteny znovu po restartu LogMan.io Collectoru, to znamená, že absence perzistence znamená resetování čtení při restartování.
Můžete konfigurovat cestu pro last position storage:
last_position_storage: "./var/last_position_storage"
Warning
Pokud je velikost souboru menší než předchozí zapamatovaná velikost souboru, soubor je znovu čten a zaslán do pipeline rozdělený na řádky.
Cesty k souborům
Globy cest k souborům jsou odděleny novými řádky. Mohou obsahovat zástupné znaky (např. *, ** atd.).
path: |
/prvni/cesta/*.log
/druha/cesta/*.log
/dalsi/cesta/*
Ve výchozím nastavení jsou soubory čteny rekurzivně. Rekurzivní čtení můžete zakázat pomocí:
recursive: False
Protokol řádků
protocol: line
line/C_separator: # (volitelné) Znak používaný jako oddělovač řádků. Výchozí: '\n'.
Protokol řádků se používá pro čtení zpráv z řádkově orientovaných logových souborů.
XML protokol
protocol: xml
tag_separator: '</msg>' # (povinné) Tag pro oddělovač.
XML protokol se používá pro čtení zpráv z XML-orientovaných logových souborů.
Parametr tag_separator musí být zahrnut v konfiguraci.
Example
Příklad XML logového souboru:
...
<msg time='2024-04-16T05:47:39.814+02:00' org_id='orgid'>
<txt>Log message 1</txt>
</msg>
<msg time='2024-04-16T05:47:42.814+02:00' org_id='orgid'>
<txt>Log message 2</txt>
</msg>
<msg time='2024-04-16T05:47:43.018+02:00' org_id='orgid'>
<txt>Log message 3</txt>
</msg>
...
Konfigurační příklad:
input:SmartFile:Alert:
path: /xml-logs/*.xml
protocol: xml
tag_separator: "</msg>"
W3C Extended Log File Protocol
protocol: w3c_extended
W3C Extended Log File Protocol se používá pro sběr událostí z logových souborů ve formátu W3C Extended Log File Format a jejich serializaci do formátu JSON.
Příklad sběru událostí z Microsoft Exchange Server
Příklad konfigurace LogMan.io Collector:
input:SmartFile:MSExchange:
path: /MicrosoftExchangeServer/*.log
protocol: w3c_extended
extract_source: file_path
extract_regex: ^(?P<file_path>.*)$
Příklad obsahu logového souboru:
#Software: Microsoft Exchange Server
#Version: 15.02.1544.004
#Log-type: DNS log
#Date: 2024-04-14T00:02:48.540Z
#Fields: Timestamp,EventId,RequestId,Data
2024-04-14T00:02:38.254Z,,9666704,"SendToServer 122.120.99.11(1), AAAA exchange.bradavice.cz, (query id:46955)"
2024-04-14T00:02:38.254Z,,7204389,"SendToServer 122.120.99.11(1), AAAA exchange.bradavice.cz, (query id:11737)"
2024-04-14T00:02:38.254Z,,43150675,"Send completed. Error=Success; Details=id=46955; query=AAAA exchange.bradavice.cz; retryCount=0"
...
W3C DHCP Server Format
protocol: w3c_dhcp
W3C DHCP protokol se používá pro sběr událostí z logových souborů DHCP serveru. Je velmi podobný W3C Extended Log File Format s rozdílem v hlavičce logového souboru.
Tabulka identifikace událostí W3C DHCP
| Event ID | Význam |
|---|---|
| 00 | Log byl spuštěn. |
| 01 | Log byl zastaven. |
| 02 | Log byl dočasně pozastaven kvůli nízkému volnému místu na disku. |
| 10 | Klientovi byla přidělena nová IP adresa. |
| 11 | Klient obnovil pronájem. |
| 12 | Klient uvolnil pronájem. |
| 13 | Na síti byla nalezena používaná IP adresa. |
| 14 | Požadavek na pronájem nemohl být splněn, protože pool adres v rozsahu byl vyčerpán. |
| 15 | Pronájem byl odmítnut. |
| 16 | Pronájem byl smazán. |
| 17 | Pronájem vypršel a DNS záznamy pro vypršené pronájmy nebyly smazány. |
| 18 | Pronájem vypršel a DNS záznamy byly smazány. |
| 20 | BOOTP adresa byla přidělena klientovi. |
| 21 | Dynamická BOOTP adresa byla přidělena klientovi. |
| 22 | Požadavek na BOOTP nemohl být splněn, protože pool adres pro BOOTP v rozsahu byl vyčerpán. |
| 23 | BOOTP IP adresa byla smazána po ověření, že není používána. |
| 24 | Začátek operace čištění IP adres. |
| 25 | Statistika operace čištění IP adres. |
| 30 | Požadavek na aktualizaci DNS na určený DNS server. |
| 31 | Aktualizace DNS selhala. |
| 32 | Aktualizace DNS byla úspěšná. |
| 33 | Paket byl zahozen kvůli politice NAP. |
| 34 | Požadavek na aktualizaci DNS selhal, protože byla překročena mezní hodnota fronty požadavků na aktualizaci DNS. |
| 35 | Požadavek na aktualizaci DNS selhal. |
| 36 | Paket byl zahozen, protože server je v roli záložního serveru pro failover nebo hash ID klienta nesedí. |
| 50+ | Kódy nad 50 jsou používány pro informace o detekci rogue serveru. |
Příklad sběru událostí z DHCP serveru
Příklad konfigurace LogMan.io Collector:
input:SmartFile:DHCP-Server-Input:
path: /DHCPServer/*.log
protocol: w3c_dhcp
extract_source: file_path
extract_regex: ^(?P<file_path>.*)$
Příklad obsahu logového souboru DHCP serveru:
DHCP Service Activity Log
Event ID Význam
00 Log byl spuštěn.
01 Log byl zastaven.
...
50+ Kódy nad 50 jsou používány pro informace o detekci rogue serveru.
ID,Datum,Čas,Popis,IP Adresa,Název Hostitele,MAC Adresa,Uživatelské Jméno, TransactionID, ...
24,04/16/24,00:00:21,Začátek čištění databáze,,,,,0,6,,,,,,,,,0
24,04/16/24,00:00:22,Začátek čištění databáze,,,,,0,6,,,,,,,,,0
...
Například limit ignore_older_than pro soubory, které se mají číst, může být nastaven na ignore_older_than: 20d nebo ignore_older_than: 100s.
Parametry extrakce
Existují také možnosti pro extrakci informací z názvu souboru nebo cesty k souboru pomocí regulárního výrazu.
Extrahované části jsou poté uloženy jako meta data (která implicitně zahrnují unikátní meta ID a název souboru).
Možnosti konfigurace začínají prefixem extract_ a zahrnují následující:
extract_source: # (volitelné) file_name nebo file_path (výchozí: file_path)
extract_regex: # (volitelné) regex pro extrakci názvů polí ze zdroje extrakce (ve výchozím stavu zakázáno)
extract_regex musí obsahovat pojmenované skupiny. Názvy skupin se používají jako klíče polí pro extrahované informace.
Nepojmenované skupiny nevytvářejí žádná data.
Příklad extrakce metadat z regexu
Sběr z souboru /data/myserver.xyz/tenant-1.log
Následující konfigurace:
extract_regex: ^/data/(?P<dvchost>\w+)/(?P<tenant>\w+)\.log$
vytvoří metadata:
{
"meta": {
"dvchost": "myserver.xyz",
"tenant": "tenant-1"
}
}
Následující je pracovní příklad konfigurace vstupu SmartFile s extrakcí
atributů z názvu souboru pomocí regexu a souvisejícího výstupu File:
input:SmartFile:SmartFileInput:
path: ./etc/tail.log
extract_source: file_name
extract_regex: ^(?P<dvchost>\w+).log$
output: FileOutput
output:File:FileOutput:
path: /data/my_path.txt
prepend_meta: true
debug: true
Přidání informací
prepend_meta: true
Přidá meta informace, jako jsou extrahované názvy polí, k logové řádce/události jako páry klíč-hodnota oddělené mezerami.
Ignorování starých změn
Následující možnosti konfigurace umožňují zkontrolovat, že čas poslední modifikace souborů, které se čtou, není starší než stanovený limit.
ignore_older_than: # (volitelné) Limit v dnech, hodinách, minutách nebo sekundách pro čtení pouze souborů, které byly upraveny po limitu (výchozí: "", např. "1d", "1h", "1m", "1s")
Soubor
Sekce: input:File, input:FileBlock, input:XML
Tyto vstupy čtou specifikované soubory po řádcích (input:File) nebo jako celý blok (input:FileBlock, input:XML)
a předávají jejich obsah dále do pipeline.
V závislosti na režimu mohou být soubory přejmenovány na <FILE_NAME>-processed
a pokud je jich více specifikováno pomocí zástupného znaku, další soubor bude otevřen,
přečten a zpracován stejným způsobem.
Dostupné možnosti konfigurace pro otevírání, čtení a zpracování souborů zahrnují:
path: # Zadejte cestu k souboru, mohou být použity také zástupné znaky (např. /data/lines/*)
chilldown_period: # Pokud je použito více souborů nebo zástupný znak v cestě, zadejte, jak často v sekundách kontrolovat nové soubory (výchozí: 5)
output: # Na který výstup odeslat příchozí události
mode: # (volitelné) Režim, kterým bude soubor čten (výchozí: 'rb')
newline: # (volitelné) Oddělovač řádků souboru (výchozí je hodnota os.linesep)
post: # (volitelné) Co se stane po čtení — delete (smazat), noop (bez přejmenování), move (přejmenovat na `<FILE_NAME>-processed`, výchozí)
exclude: # (volitelné) Cesty souborů k vyloučení (má přednost před 'include')
include: # (volitelné) Cesty souborů k zahrnutí
encoding: # (volitelné) Kódování obsahu souboru
move_destination: # (volitelné) Cílová složka pro post 'move', musí být mimo výše uvedenou path
lines_per_event: # (volitelné) Počet řádků, po kterých read vstoupí do idle stavu (výchozí: 10000)
event_idle_time: # (volitelné) Délka idle stavu v sekundách (výchozí: 0.01)
HTTP / HTTPS Server
Sekce: input:WebServer
Umožňuje příjem logů nebo událostí přes HTTP/HTTPS server. Webhook; událost se bere z těla příchozího HTTP/HTTPS požadavku. Webhook akceptuje libovolnou HTTP metodu (POST, PUT, GET atd.).
URL může volitelně obsahovat název streamu jako poslední část cesty (připojenou k base). Pokud stream není uveden, událost se objeví ve streamu „generic“.
Příklad doručení události webhookem do my-stream
$ curl -k -X PUT https://my-collector:8080/my-stream -d @event-file.json
Příklad konfigurace:
input:WebServer:https:
output: ...
listen: 8443 ssl
base: /subpath
cert: /conf/mycert.pem
key: /conf/mykey.pem
listen
8080nebo*:8080: Naslouchat na portu 8080 na všech síťových rozhraních IPv4 a IPv60.0.0.0:8080: Naslouchat na portu 8080 na všech rozhraních IPv4:::8080: Naslouchat na portu 8080 na všech rozhraních IPv61.2.3.4:8080: Naslouchat na portu 8080 na konkrétním rozhraní (1.2.3.4) IPv4::1:8080: Naslouchat na portu 8080 na konkrétním rozhraní (::1) IPv6
Připojíte-li k hodnotě listen ssl, zapne se TLS/SSL šifrování.
Tip
U listen jsou podporovány víceřádkové hodnoty pro více síťových rozhraní.
base (volitelné)
Základní cesta pro URL požadavky sbírající události.
Výchozí je /.
cert (volitelné)
Při zapnutém TLS/SSL serverový SSL certifikát (PEM). Bez uvedení použije interní CA certifikát pro SSL.
key (volitelné)
Při zapnutém TLS/SSL soukromý klíč k serverovému certifikátu. Bez uvedení použije interní CA klíč pro SSL.
Apache Kafka
Sekce: input:Kafka
Dostupné od verze v22.32
Vytvoří Kafka consumera pro zadané topic(y).
Možnosti související s připojením:
bootstrap_servers: # Kafka uzly (např. `kafka1:9092,kafka2:9092,kafka3:9092`)
Možnosti Kafka Consumer:
topic: # Názvy topiců (např. `lmio-events` nebo `^lmio.*`)
group_id: # Consumer group (např. `collector_kafka_consumer`)
refresh_topics: # (volitelné) Interval v sekundách pro obnovu subscription topiců (např. `300`)
bootstrap_servers, topic a group_id jsou vždy povinné.
topic může být název, seznam názvů oddělených mezerami nebo jednoduchý regex (všechny topic: ^.*)
Další možnosti: https://github.com/edenhill/librdkafka/blob/master/CONFIGURATION.md
Elasticsearch
Sekce: input:Elasticsearch
Vstup dotazuje Elasticsearch na nové záznamy. Neustálé scrollování pomocí SEARCH API s search after. Viz https://www.elastic.co/docs/reference/elasticsearch/rest-apis/paginate-search-results
url: # URL master nebo data uzlu Elasticsearch, např. http://lm1:9200
index: # Index ke čtení, může být pattern jako lmio-standard-events*
username: # (volitelné) Uživatel Elasticsearch
password: # (volitelné) Heslo Elasticsearch
source: # (volitelné) Pokud se pole source v hitu liší od výchozího _source
sort_by: # (volitelné) Pole pro řazení, výchozí _id — nutné pro search after
timestamp: # (volitelné) Pokud se timestamp liší od výchozího @timestamp
start_from: # (volitelné) Od kdy číst existující logy, výchozí now-1h
request_body: # (volitelné) Vlastní tělo požadavku — pak se nepoužijí timestamp a start_from
output: # Kam odesílat příchozí události
CSV
Sekce: input:CSV
Čte CSV ze disku, parsuje řádky do slovníku a serializuje do JSON před odesláním do pipeline.
Možnosti zahrnují standardní file input (path, chilldown_period, post, include, exclude, encoding, move_destination atd.) a CSV volby:
path: # Cesty k souborům; wildcards
output: # Kam odesílat příchozí události
chilldown_period: # (volitelné) Interval kontroly nových souborů v sekundách (výchozí: 5)
delimiter: # (volitelné) Oddělovač polí (výchozí: ',')
dialect: # (volitelné) CSV dialect (výchozí: 'excel')
fieldnames: # (volitelné) Názvy sloupců pro CSV bez hlavičky (řetězec nebo JSON pole)
quotechar: # (volitelné) Znak uvozovek (výchozí: '"')
quoting: # (volitelné) Režim quoting (výchozí: csv.QUOTE_MINIMAL)
Example
input:CSV:MyCsvInput:
path: /data/exports/*.csv
fieldnames: timestamp,host,message
output: MyOutput
output:CommLink:MyOutput: {}
HTTP client
Sekce: input:HTTPClientLineSource, input:HTTPClientTextSource
Periodicky provádějí HTTP požadavek a předávají tělo odpovědi do pipeline.
input:HTTPClientLineSourcerozdělí text po řádcích — jedna událost na řádek.input:HTTPClientTextSourceemituje celé tělo jako jednu událost.
url: # URL požadavku (povinné)
output: # Kam odesílat příchozí události
method: # (volitelné) HTTP metoda (výchozí: GET)
response_code: # (volitelné) Očekávané HTTP kódy, např. '200' nebo '200, 301' (výchozí: '200')
headers: # (volitelné) JSON objekt s hlavičkami
verify: # (volitelné) 'none' pro vypnutí ověření TLS certifikátu
encoding: # (volitelné) Kódování textu odpovědi
max_failed_retries: # (volitelné) Maximum neúspěšných pokusů (výchozí: 3)
fail_chilldown: # (volitelné) Sekundy čekání po chybě (výchozí: 30)
chilldown_period: # (volitelné) Sekundy mezi cykly sběru (závisí na triggeru)
Řádkově orientovaná HTTP odpověď
input:HTTPClientLineSource:RemoteLogLines:
url: https://example.com/api/logs
method: GET
headers: '{"Authorization": "Bearer <token>"}'
output: MyOutput
output:CommLink:MyOutput: {}
Celé tělo HTTP odpovědi
input:HTTPClientTextSource:RemoteJson:
url: https://example.com/api/status
encoding: utf-8
output: MyOutput
output:CommLink:MyOutput: {}
LogMan.io Collector Výstupy
Výstup collectoru je specifikován následovně:
output:<typ-výstupu>:<jméno-výstupu>:
debug: false
...
Společné volby výstupu
V každém výstupu mohou být meta informace specifikovány jako slovník v atributu meta.
meta:
my_meta_tag: my_meta_tag_value # (volitelné) Vlastní meta informace, které budou později dostupné v LogMan.io Parseru v kontextu události
tenant mohou být specifikovány přímo v konfiguraci výstupu.
Ladění
debug (volitelné)
Specifikujte, zda se má výstup také zapisovat do logu pro ladění.
Výchozí: false
Předřazení meta informací
prepend_meta (volitelné)
Předřadí meta informace příchozí události jako páry klíč-hodnota oddělené mezerami.
Výchozí: false
Poznámka
Meta informace zahrnují název souboru nebo z něj extrahované informace (v případě vstupu Smart File), vlastní definovaná pole (viz níže) atd.
TCP Výstup
Odesílá události přes TCP na server specifikovaný IP adresou a Portem.
output:TCP:<jméno-výstupu>:
address: <IP adresa>:<Port>
...
Adresa
address
Adresa serveru se skládá z IP adresy a portu.
Tip
Jsou podporovány adresy IPv4 i IPv6.
Maximální velikost paketů
max_packet_size (volitelné)
Specifikuje maximální velikost paketů v bytech.
Výchozí: 65536
Velikost přijímacího bufferu
receiver_buffer_size (volitelné)
Omezuje velikost přijímacího bufferu v bytech.
Výchozí: 0
UDP Výstup
Odesílá události přes UDP na specifikovanou IP adresu a Port.
output:UDP:<jméno-výstupu>:
address: <IP adresa>:<Port>
...
Adresa
address
Adresa serveru se skládá z IP adresy a portu.
Tip
Jsou podporovány adresy IPv4 i IPv6.
Maximální velikost paketů
max_packet_size (volitelné)
Specifikuje maximální velikost paketů v bytech.
Výchozí: 65536
Velikost přijímacího bufferu
receiver_buffer_size (volitelné)
Omezuje velikost přijímacího bufferu v bytech.
Výchozí: 0
WebSocket Výstup
Odesílá události přes WebSocket na specifikovanou URL.
output:WebSocket:<jméno-výstupu>:
url: <Server URL>
...
URL
url
Specifikujte cílovou WebSocket URL. Například http://example.com/ws
Tenant
tenant
Jméno tenantu, LogMan.io Collector, jméno tenantu je forwardováno do LogMan.io parseru a přidáno k události.
Neaktivní čas
inactive_time (volitelné)
Specifikuje neaktivní čas v sekundách, po které budou nečinné Web Sockets uzavřeny.
Výchozí: 60
Velikost výstupní fronty
output_queue_max_size (volitelné)
Specifikujte velikost paměťové výstupní fronty pro každý Web Socket
Cesta pro ukládání perzistentních souborů
buffer (volitelné)
Cesta pro ukládání perzistentních souborů, když je Web Socket spojení offline.
Volby konfigurace SSL
Následující konfigurační volby specifikují SSL (HTTPS) připojení:
cert: Cesta k SSL certifikátu klientakey: Cesta k privátnímu klíči SSL certifikátu klientapassword: Heslo privátního klíče (volitelné, výchozí: žádné)cafile: Cesta k PEM souboru s CA certifikátem k ověření SSL serveru (volitelné, výchozí: žádné)capath: Cesta k adresáři s CA certifikátem k ověření SSL serveru (volitelné, výchozí: žádné)ciphers: SSL šifry (volitelné, výchozí: žádné)dh_params: Diffie–Hellman (D-H) parametry výměny klíčů (TLS) (volitelné, výchozí: žádné)verify_mode: Jedna z možností CERT_NONE, CERT_OPTIONAL nebo CERT_REQUIRED (volitelné); pro více informací viz: github.com/TeskaLabs/asab
Souborový Výstup
Odesílá události do specifikovaného souboru.
output:File:<jméno-výstupu>:
path: /data/output.log
...
Cesta
path
Cesta výstupního souboru.
Tip
Ujistěte se, že umístění výstupního souboru je dostupné uvnitř Docker kontejneru při použití Dockeru.
Příznaky
flags (volitelné)
Jedna z možností O_CREAT a O_EXCL, kde první možnost povoluje vytvoření souboru, pokud neexistuje.
Výchozí: O_CREAT
Režim
mode (volitelné)
Režim, kterým bude soubor zapsán.
Výchozí: ab (připojené bajty).
Unix Socket (datagram)
Odesílá události do datagramově orientovaného Unix Domain Socket.
output:UnixSocket:<jméno-výstupu>:
address: <cesta>
...
Adresa
address
Cesta k Unix socket souboru, např. /data/myunix.socket.
Maximální velikost paketů
max_packet_size (volitelné)
Specifikuje maximální velikost paketů v bytech.
Výchozí: 65536
Unix Socket (stream)
Odesílá události do streamově orientovaného Unix Domain Socket.
output:UnixStreamSocket:<jméno-výstupu>:
address: <cesta>
...
Adresa
address
Cesta k Unix socket souboru, např. /data/myunix.socket.
Maximální velikost paketů
max_packet_size (volitelné)
Specifikuje maximální velikost paketů v bytech.
Výchozí: 65536
Unix Socket (stream)
Odesílá události do streamového Unix Domain Socket.
output:UnixStreamSocket:<output-name>:
address: <path>
...
Adresa
address
Cesta k Unix socket souboru, např. /data/myunix.socket.
Maximální velikost paketů
max_packet_size (volitelné)
Maximální velikost paketů v bajtech.
Výchozí: 65536
Print Výstup
Pomocný výstup, který vypisuje události do terminálu.
output:Print:<jméno-výstupu>:
...
Null Výstup
Pomocné výstupy, které zahazují události.
output:Null:<jméno-výstupu>:
...
LogMan.io Collector — transformace
Transformace slouží k předzpracování příchozí události uživatelsky definovanou deklarací před předáním do zadaného výstupu.
Dostupné transformace
transform:Declarative:poskytuje deklarativní procesor konfigurovaný deklarativní konfigurací (YAML)transform:XMLToDict:se typicky používá pro XML soubory a Windows Events z WinRM.
LogMan.io Collector Mirage
LogMan.io Collector má schopnost vytvářet mock logy a posílat je skrze datový kanál, hlavně pro testovací a demonstrační účely. Zdroj, který produkuje mock logy, se nazývá Mirage.
Mirage používá LogMan.io Collector Library jako úložiště pro sesbírané logy od různých poskytovatelů. Logy v této knihovně jsou odvozeny z reálných logů.
Konfigurace vstupu Mirage
# Konfigurační YAML soubor pro vstupy
[config]
path=./etc/lmio-collector.yaml
# Připojení ke Knihovně, kde jsou uloženy logy Mirage
[library]
providers=git+http://user:password@gitlab.example.com/lmio/lmio-collector-library.git
[web]
listen=0.0.0.0 8088
input:Mirage:MirageInput:
path: /Mirage/<cesta>/
eps: <počet logů odeslaných za sekundu>
output: <output_id>
Průchodnost logů
Můžete definovat počet logů produkovaných každou sekundu (EPS - events per second).
Následující konfigurace bude produkovat 20 logů každou sekundu:
input:Mirage:MirageInput:
eps: 20
Tato konfigurace také přidá odchylku, takže každou sekundu bude počet mezi 10 a 40 logy:
input:Mirage:MirageInput:
eps: 20
deviation: 0.5
Aby bylo možné vytvořit realističtější zdroj logů a změnit EPS během dne, můžete použít scénáře.
input:Mirage:MirageInput:
eps: dayshift
deviation: 0.5
Dostupné možnosti jsou:
- normal
- gaussian
- dayshift
- nightshift
- tiny
- peak
Nakonec můžete vytvořit vlastní scénář. Můžete nastavit EPS každou minutu:
input:Mirage:MirageInput:
eps:
"10:00": 10
"12:00": 20
"15:10": 10
"15:11": 12
"16:00": 5
"23:00": 0
deviation: 0.5
Přidání nových zdrojů logů do Knihovny
- Vytvořte nový repozitář pro sběr logů nebo klonujte stávající.
- Vytvořte nový adresář. Pojmenujte adresář po zdroji logů.
- Vytvořte nový soubor pro každý log v adresáři zdrojů. Mirage může stejný log použít vícekrát při odesílání logů skrze kanál. (Nemusíte mít 100 samostatných logových souborů pro odeslání 100 logů - Mirage bude opakovat stejné logy.)
Ve výchozím nastavení, při odesílání logů skrze kanál, vybírá Mirage z vašich logových souborů náhodně a přibližně rovnoměrně, ale můžete přidat váhu logům k jejich změně.
Šablonování logů
K získání více unikátních logů bez nutnosti vytvářet více logových souborů, šablonujte vaše logy. Můžete si vybrat, která pole v logu budou mít proměnné hodnoty, poté vytvořit seznam hodnot, které chcete tím polem naplnit, a Mirage náhodně vybere hodnoty.
-
Ve vašem logu vyberte pole, které byste chtěli mít s proměnnými hodnotami. Nahraďte hodnoty pole za
${nazevPole}, kdenazevPoleje to, čím budete pole ve vašem seznamu nazývat."user.name":${user.name}, "id":${id}, "msg":${msg} -
Vytvořte soubor nazvaný
values.yamlve vašem adresáři zdrojů logů. -
V novém souboru
values.yamluveďte možné hodnoty pro každé šablonované pole. Pole ve vašem souboruvalues.yamlmusí odpovídat názvům polí ve vašich logových souborech.values: user.name: - Albus Brumbál - Harry Potter - Hermiona Grangerová id: - 171 - 182 - 193 msg: - Spojení ukončeno - Spojení přerušeno - Spojení úspěšné - Spojení selhalo
Formáty datumu a času
Mirage může generovat aktuální časové razítko pro každý log. K tomu musíte zvolit formát, ve kterém bude časové razítko. Pro přidání časového razítka do vašeho mock logu přidejte ${datetime: <format>} do textu ve vašem souboru.
Example
${datetime: %y-%m-%d %H:%M:%S} vygeneruje časové razítko 23-06-07 12:55:26
${datetime: %Y %b %d %H:%M:%S:%f} vygeneruje časové razítko 2023 Jun 07 12:55:26:002651
Direktivy datumu a času
Direktivy datumu a času jsou odvozeny od Python modulu datetime.
| Direktiv | Význam | Příklad |
|---|---|---|
%a |
Den týdne jako zkrácený název dle místnímu nastavení. | Ne, Po, ..., So (cs_CZ); |
%A |
Den týdne jako plné jméno dle místnímu nastavení. | Neděle, Pondělí, ..., Sobota (cs_CZ); |
%w |
Den týdne jako desetinné číslo, kde 0 je neděle a 6 je sobota. | 0, 1, ..., 6 |
%d |
Den v měsíci jako desetinné číslo doplněné nulou. | 01, 02, ..., 31 |
%b |
Měsíc jako zkrácený název dle místnímu nastavení. | Led, Úno, ..., Pro (cs_CZ); |
%B |
Měsíc jako plné jméno dle místnímu nastavení. | Leden, Únor, ..., Prosinec (cs_CZ); |
%m |
Měsíc jako desetinné číslo doplněné nulou. | 01, 02, ..., 12 |
%y |
Rok bez století jako desetinné číslo doplněné nulou. | 00, 01, ..., 99 |
%Y |
Rok se stoletím jako desetinné číslo. | 0001, 0002, ..., 2013, 2014, ..., 9998, 9999 |
%H |
Hodina (24hodinový cyklus) jako desetinné číslo doplněné nulou. | 00, 01, ..., 23 |
%I |
Hodina (12hodinový cyklus) jako desetinné číslo doplněné nulou. | 01, 02, ..., 12 |
%p |
Místní ekvivalent buď AM nebo PM. | AM, PM (en_US); am, pm (de_DE) |
%M |
Minuta jako desetinné číslo doplněné nulou. | 00, 01, ..., 59 |
%S |
Sekunda jako desetinné číslo doplněné nulou. | 00, 01, ..., 59 |
%f |
Mikrosekunda jako desetinné číslo, doplněné nulou na 6 číslic. | 000000, 000001, ..., 999999 |
%z |
UTC offset ve formě ±HHMM[SS[.ffffff]] (prázdný řetězec, pokud je objekt naivní). | (prázdný), +0000, -0400, +1030, +063415, -030712.345216 |
%Z |
Název časového pásma (prázdný řetězec, pokud je objekt naivní). | (prázdný), UTC, GMT |
%j |
Den v roce jako desetinné číslo doplněné nulou. | 001, 002, ..., 366 |
%U |
Číslo týdne v roce (neděle jako první den týdne) jako desetinné číslo doplněné nulou. Všechny dny v novém roce před první nedělí jsou považovány za týden 0. | 00, 01, ..., 53 |
%W |
Číslo týdne v roce (pondělí jako první den týdne) jako desetinné číslo doplněné nulou. Všechny dny v novém roce před prvním pondělím jsou považovány za týden 0. | 00, 01, ..., 53 |
%c |
Místní vhodné zobrazení data a času. | Út 16 Srp 21:30:00 1988 (cs_CZ); Di 16 Aug 21:30:00 1988 (de_DE) |
%x |
Místní vhodné zobrazení data. | 16.08.88 (cs_CZ); 16.08.1988 (de_DE) |
%X |
Místní vhodné zobrazení času. | 21:30:00 (cs_CZ); 21:30:00 (de_DE) |
%% |
Doslovný znak '%'. | % |
Váha logů
Pokud chcete, aby Mirage vybrala některé logy častěji a některé méně často, můžete dát určitým logovým souborům větší váhu. Váha znamená, jak mnohem častěji nebo méně často je logový soubor vybrán v porovnání s ostatními.
Chcete-li změnit váhu, přidejte číslo na začátek názvu logového souboru. Toto číslo vytvoří poměr s ostatními logovými soubory. Pokud soubor nezačíná číslem, Mirage jej považuje za 1.
Example
5-priklad1.log2-priklad2.log3-priklad3.logpriklad4.log
Mirage by tyto logy posílal v poměru 5:2:3:1.
Shromažďování do vyhledávání
Soubory
Chcete-li pravidelně sbírat vyhledávání ze souborů, jako jsou CSV, použijte vstup input:FileBlock: s následující konfigurací:
path: # Určete složku vyhledávání, kde bude uložen soubor vyhledávání (např. /data/lookups/mylookup/*)
chilldown_period: # Určete, jak často v sekundách kontrolovat nové soubory (výchozí: 5)
FileBlock čte všechny soubory v jednom bloku (jedna událost je celý obsah souboru) a předává je na nakonfigurovaný výstup, což je obvykle output:WebSocket.
Tímto způsobem je vyhledávání předáváno do LogMan.io Receiver, a nakonec do LogMan.io Parser, kde může být vyhledávání zpracováno a uloženo v Elasticsearch. Viz Parsování vyhledávání pro více informací.
Vzorová konfigurace
input:FileBlock:MyLookupFileInput:
path: /data/lookups/mylookup/*
chilldown_period: 10
output: LookupOutput
output:WebSocket:LookupOutput:
url: https://lm1/files-ingestor-ws
...
Výchozí konfigurace kolektoru LogMan.io
TeskaLabs LogMan.io Collector je vybaven výchozí konfigurací navrženou pro rychlou a efektivní integraci s typickými zdroji logů, optimalizující počáteční nastavení a poskytující robustní konektivitu ihned po vybalení.
Výchozí síťové porty pro zdroje logů
Níže je uvedena tabulka s výchozími síťovými porty používanými různými technologiemi při připojování ke LogMan.io Collectoru. Oba UDP (User Datagram Protocol) a TCP (Transmission Control Protocol) porty jsou k dispozici pro podporu různých potřeb síťové komunikace.
| Dodavatel Technologie |
Produkt Varianta |
Rozsah portů | Název proudu | Poznámka |
|---|---|---|---|---|
| Linux | Syslog RFC 3164 | 10000 10009 |
linux-syslog-rfc3164 |
BSD Syslog Protocol |
| Linux | Syslog RFC 5424 | 10020 10029 |
linux-syslog-rfc5424 |
IETF Syslog Protocol |
| Linux | rsyslog | 10010 10019 |
linux-rsyslog |
|
| Linux | syslog-ng | 10030 10039 |
linux-syslogng |
|
| Linux | Auditd | 10040 10059 |
linux-auditd |
|
| Fortinet | FortiGate | 10100 10109 |
fortinet-fortigate |
RFC6587 Framing on TCP |
| Fortinet | FortiGate | 10110 10119 |
fortinet-fortigate |
|
| Fortinet | FortiSwitch | 10120 10129 |
fortinet-fortiswitch |
No Framing on TCP |
| Fortinet | FortiSwitch | 10130 10139 |
fortinet-fortiswitch |
|
| Fortinet | FortiMail | 10140 10159 |
fortinet-fortimail |
|
| Fortinet | FortiClient | 10160 10179 |
fortinet-forticlient |
|
| Fortinet | FortiAnalyzer | 10180 10199 |
fortinet-fortianalyzer |
|
| Cisco | ASA | 10300 10319 |
cisco-asa |
|
| Cisco | FTD | 10320 10339 |
cisco-ftd |
|
| Cisco | IOS | 10340 10359 |
cisco-ios |
|
| Cisco | ISE | 10360 10379 |
cisco-ise |
|
| Cisco | Switch Nexus | 10380 10399 |
cisco-switch-nexus |
|
| Cisco | WLC | 10400 10419 |
cisco-wlc |
|
| Dell | Switch | 10500 10519 |
dell-switch |
|
| Dell | PowerVault | 10520 10539 |
dell-powervault |
|
| Dell | iDRAC | 10540 10559 |
dell-idrac |
|
| HPE | Aruba Clearpass | 10600 10619 |
hpe-aruba-clearpass |
|
| HPE | Aruba IAP | 10620 10639 |
hpe-aruba-iap |
|
| HPE | Aruba Switch | 10640 10659 |
hpe-aruba-switch |
|
| HPE | Integrated Lights-Out (iLO) | 10660 10679 |
hpe-ilo |
|
| HPE | Primera | 10680 10699 |
hpe-primera |
|
| HPE | StoreOnce | 10700 10719 |
hpe-storeonce |
|
| Bitdefender | Gravity Zone | 10740 10759 |
bitdefender-gravityzone |
|
| Broadcom | Brocade Switch | 10760 10779 |
broadcom-brocade-switch |
|
| Devolutions | Devolutions Web Server | 10800 10819 |
devolutions-web-server |
|
| ESET | Protect | 10840 10859 |
eset-protect |
|
| F5 | 10860 10879 |
f5 |
||
| FileZilla | 10880 10899 |
filezilla |
||
| Gordic | Ginis | 10900 10919 |
gordic-ginis |
|
| IceWarp | Mail Server | 10920 10939 |
icewarp-mailserver |
|
| Kubernetes | 10940 10959 |
kubernetes |
||
| McAfee WebWasher | 10960 10979 |
mcafee-webwasher |
||
| MikroTik | 10980 10999 |
mikrotik |
||
| Oracle | Listener | 11000 11019 |
oracle-listener |
|
| Oracle | Spark | 11020 11039 |
oracle-spark |
|
| Ntopng | 11060 11079 |
ntopng |
||
| OpenVPN | 11080 11099 |
openvpn |
||
| SentinelOne | 11100 11119 |
sentinelone |
||
| Squid | Proxy | 11120 11139 |
squid-proxy |
|
| Synology | NAS | 11140 11159 |
synology-nas |
|
| Veeam | Backup & Replication | 11160 11179 |
veeam-backup-replication |
|
| ySoft | SafeQ | 11180 11199 |
ysoft-safeq |
|
| Ubiquiti | UniFi | 11200 11219 |
ubiquiti-unifi |
|
| VMware | vCenter | 11300 11319 |
vmware-vcenter |
|
| VMware | vCloud Director | 11320 11339 |
vmware-vcloud-director |
|
| VMware | ESXi | 11340 11359 |
vmware-esxi |
|
| ZyXEL | Switch | 11440 11459 |
zyxel-switch |
|
| Sophos | Standard Syslog Protocol | 11500 11519 |
sophos-standard-syslog-protocol |
Preferovaný formát protokolování. |
| Sophos | Syslog Devide Standard Format | 11520 11539 |
sophos-device-standard-format |
Standardní formát protokolování zařízení je zastaralý. |
| Sophos | Unstructured Format | 11540 11559 |
sophos-unstructured |
Ne strukturovaný formát protokolování je zastaralý. |
| Custom | 14000 14099 |
custom |
Receiver
LogMan.io Receiver
TeskaLabs LogMan.io Receiver je mikroslužba zodpovědná za příjem logů a jiných událostí od LogMan.io kolektoru, jejich přeposílání do centrálního systému LogMan.io a archivaci surových logů. LogMan.io Receiver přeposílá příchozí logy do příslušných tenantů.
Note
LogMan.io Receiver nahrazuje LogMan.io Ingestor.
Komunikační spojení
Komunikace mezi lmio-collector a lmio-receiver se nazývá "commlink", což je zkratka pro Komunikační Spojení.
Jako primární komunikační protokol je použit websocket, ale také jsou využívány HTTPS volání z kolektoru. Kolektor udržuje websocket spojení s přijímačem otevřené po dlouhou dobu. Když je komunikační spojení z kolektoru ukončeno, kolektor se pokouší pravidelně znovu navázat spojení.
Pozor
Websocket spojení využívá serverem generované PING pakety k udržení websocketu otevřeného.
Komunikační Spojení je chráněno vzájemné SSL autorizací. To znamená, že každý lmio-collector je vybaven soukromým klíčem a klientským SSL certifikátem. Soukromý klíč a klientský SSL certifikát jsou generovány automaticky během provisioningu nového kolektoru. Soukromý klíč a klientský SSL certifikát se používají k autentizaci kolektoru. Tento mechanismus také poskytuje silné šifrování provozu mezi kolektorem a centrální částí LogMan.io.
Produkční nastavení
Produkční nastavení je, že LogMan.io Kolektor (lmio-collector) se připojuje přes HTTPS přes NGINX server k LogMan.io Přijímači (lmio-receiver).
graph LR
lmio-collector -- "websocket & SSL" --> n[NGINX]
n[NGINX] --> lmio-receiverDiagram: Produkční nastavení
Pro více informací pokračujte na sekci NGINX.
Nesprodukční nastavení
Přímé spojení z lmio-collector na lmio-receiver je také podporováno. Je vhodné pro nesprodukční nastavení, jako je testování nebo vývoj.
graph LR
lmio-collector -- "websocket & SSL" --> lmio-receiverDiagram: Nesprodukční nastavení
Vysoká dostupnost
TeskaLabs LogMan.io Receiver je navržen tak, aby byl spuštěn v několika instancích, nezávisle na Tenantech LogMan.io. Doporučené nastavení je provozovat jeden TeskaLabs LogMan.io Receiver na každém uzlu centrálního LogMan.io clusteru s nasazeným NGINX.
TeskaLabs LogMan.io Collector používá DNS round-robin balancování pro připojení k jednomu z NGINX serverů. NGINX přesměruje příchozí komunikační odkazy na instanci receiveru, s preferencí receiveru běžícího na stejném uzlu jako NGINX.
Více než jedna lmio-receiver instance může být provozována na uzlu clusteru, například pokud se výkon jediné instance lmio-receiver stane úzkým hrdlem.
Příklad konfigurace vysoké dostupnosti
graph LR
c1[lmio-collector] -.-> n1[NGINX]
c1[lmio-collector] --> n2[NGINX]
c1[lmio-collector] -.-> n3[NGINX]
subgraph Node 3
n1[NGINX] --> r1[lmio-receiver]
end
subgraph Node 2
n2[NGINX] --> r2[lmio-receiver]
end
n2[NGINX] -.-> r1[lmio-receiver]
n2[NGINX] -.-> r3[lmio-receiver]
subgraph Node 1
n3[NGINX] --> r3[lmio-receiver]
endScénáře obnovy po selhání
- Instance
lmio-receiverje ukončena: NGINX přerozděluje commlinks na další instance receiveru na jiných uzlech. - NGINX je ukončen: kolektor se znovu připojí k jinému NGINX v clusteru.
- Celý uzel clusteru je ukončen: kolektor se znovu připojí k jinému NGINX v clusteru.
Konfigurace LogMan.io Receiveru
LogMan.io Receiver vyžaduje následující závislosti:
- Apache ZooKeeper
- NGINX (pro produkční nasazení)
- Apache Kafka
Model
Chcete-li aplikaci spustit, zahrňte ji do modelu a klikněte na tlačítko Aplikovat.
define:
type: rc/model
services:
lmio-receiver:
- <node> # Nahraďte názvem uzlu
Příklad
Toto je minimalistický příklad konfigurace LogMan.io Receiveru:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[lifecycle]
hot=/data/ssd/receiver
warm=/data/hdd/receiver
cold=/data/nas/receiver
Apache ZooKeeper
Určete umístění serveru Zookeeper v clusteru.
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Nápověda
Pro neprodukční nasazení je možné použít jediný server Zookeeper.
Životní cyklus
Každá fáze životního cyklu musí být specifikována, obvykle určením cest v souborovém systému.
[lifecycle]
hot=/data/ssd/receiver
warm=/data/hdd/receiver
cold=/data/nas/receiver
tasks_limit=6
Název fáze životního cyklu (tj. 'hot', 'warm', 'cold') nesmí obsahovat znak '_'.
Podrobnější informace naleznete v kapitole Životní cyklus.
Možnost tasks_limit určuje maximální počet současně běžících úkolů životního cyklu na tomto uzlu. Výchozí hodnota je 6.
Varování
Neměňte cesty životního cyklu poté, co příjemce již uložil data. Změna cest se nebude vztahovat zpětně a příjemce nebude schopen najít data pro fázi životního cyklu.
Webové API
Přijímač poskytuje dvě webová rozhraní API: veřejné a soukromé.
Veřejné webové API
Veřejné webové API je navrženo pro komunikaci se sběrateli.
[web:public]
listen=3080
Výchozí port veřejného webového API je tcp/3080.
Tento port je navržen tak, aby sloužil jako NGINX upstream pro připojení od sběračů. Jedná se o doporučené produkční nastavení.
Samostatné veřejné webové API
Můžete provozovat lmio-receiver bez NGINX v samostatném neprodukčním nastavení.
Varování
Nepoužívejte tento režim pro produkční nasazení.
Je ideální pro vývojové a testovací prostředí, protože nepotřebujete NGINX.
Toto je příklad konfigurace:
[web:public]
listen=3443 ssl:web:public
[ssl:web:public]
key=${THIS_DIR}/server-key.pem
cert=${THIS_DIR}/server-cert.pem
verify_mode=CERT_OPTIONAL
Toto je způsob, jak vygenerovat samo-podepsaný serverový certifikát pro výše uvedenou konfiguraci:
$ openssl ecparam -genkey -name secp384r1 -out server-key.pem
$ openssl req -new -x509 -subj "/OU=LogMan.io Receiver" -key server-key.pem -out server-cert.pem -days 365
Soukromé webové API
[web]
listen=0.0.0.0 8950
Výchozí port soukromého webového API je tcp/8950.
Certifikační autorita
Příjemce automaticky vytváří Certifikační autoritu používanou pro poskytování kolektoru.
Artefakty CA jsou uloženy v Zookeeperu ve složce /lmio/receiver/ca.
./lmio-receiver.py -c ./etc/lmio-receiver.conf
29-Jun-2023 19:43:50.651408 NOTICE asab.application is ready.
29-Jun-2023 19:43:51.716978 NOTICE lmioreceiver.ca.service Certificate Authority created
...
Výchozí konfigurace CA:
[ca]
curve=secp384r1
auto_approve=no
Možnost auto_approve automatizuje proces registrace sběrače, každý přijatý CSR je automaticky schválen, když je nastaveno na yes.
Webový socket
Výchozí konfigurace websocketu (pro kolektory)
[websocket]
timeout=30
compress=yes
max_msg_size=4M
Apache Kafka
Připojení k Apache Kafka lze nakonfigurovat:
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Pokud konfigurace není přítomna, pak se události nepřeposílají do Apache Kafka.
Archiv
Archiv je ve výchozím nastavení povolen. Chcete-li deaktivovat funkci archivu, nastavte možnost archiv na ne.
[general]
archive=yes
Metriky
Přijímač vytváří vlastní telemetrii a také přeposílá telemetrii od sběračů do nakonfigurovaného úložiště telemetrických dat, například InfluxDB.
[asab:metrics]
...
Podepisovací klíče
Podepisovací klíč se používá k digitálnímu podepisování nepropracovaných archivů protokolů.
Můžete specifikovat křivku EC, která se má použít pro podpisové klíče. Výchozí je prime256v1, také známá jako secp256r1.
[signing]
curve=prime256v1
Kolektor
Poskytnutí kolektoru
Instance kolektoru musí být poskytnuta před tím, než je kolektoru povoleno odesílat logy do TeskaLabs LogMan.io. Poskytnutí je provedeno pouze jednou během životního cyklu kolektoru.
Note
TeskaLabs LogMan.io Receiver provozuje Certifikační autoritu. Poskytnutí je proces schválení CSR, který je ukončený vydáním klientského SSL certifikátu pro kolektor. Tento klientský certifikát je použit kolektorem k autentizaci.
Poskytnutí začíná na straně kolektoru. Minimální YAML konfigurace kolektoru specifikuje URL zprávového bodu LogMan.io pro komunikační linky.
connection:CommLink:commlink:
url: https://recv.logman.example.com/
Když se kolektor spustí, odešle svou žádost o zápis příjemci. Kolektor také vytiskne výstup podobný tomuto:
...
Čeká se na schválení, identita: 'ABCDEF1234567890'
Čeká se na schválení, identita: 'ABCDEF1234567890'
To znamená, že kolektor má jedinečnou identitu ABCDEF1234567890 a že příjemce čeká na schválení tohoto kolektoru.
Na straně příjemce je schválení uděleno následujícím voláním:
curl -X 'PUT' \
http://lmio-receiver/provision/ABCDEF1234567890 \
-H 'Content-Type: application/json' \
-d '{"tenant": "mytenant"}'
Warning
Uvedete správný tenant ve žádosti, místo hodnoty mytenant.
Hint
Schválení může být uděleno také přes webový prohlížeč na "Schválit CSR přijaté od kolektoru" na http://lmio-receiver/doc
Mějte na paměti, že ABCDEF1234567890 musí být nahrazen skutečnou identitou z výstupu kolektoru.
Tenant musí být specifikován také v žádosti.
Když je toto volání provedeno, kolektor informuje, že je poskytnut a připraven:
Čeká se na schválení, identita: 'ABCDEF1234567890'
29-Jun-2023 02:05:35.276253 NOTICE lmiocollector.commlink.identity.service The certificate received!
29-Jun-2023 02:05:35.277731 NOTICE lmiocollector.commlink.identity.service [sd identity="ABCDEF1234567890"] Ready.
29-Jun-2023 02:05:35.436872 NOTICE lmiocollector.commlink.service [sd url="https://recv.logman.example.com/commlink/v2301"] Connected.
Certifikáty poskytnutých klientů jsou uloženy v ZooKeeper v /lmio/receiver/clients.
Info
Název tenanta je uložen v generovaném klientském SSL certifikátu.
CSRs, které nejsou poskytnuty do 2 dnů, jsou odstraněny. Poskytnutí může být restartováno, pokud kolektor odešle nový CSR.
Odstranění kolektoru
Pro odstranění poskytnutého kolektoru na straně příjemce, smažte příslušný záznam z adresáře ZooKeeper /lmio/receiver/clients.
To znamená, že jste odvolali povolení kolektoru připojovat se k přijímači.
Warning
Smazání neovlivní aktuálně připojené kolektory. Automatické odpojení je na produktové roadmapě.
Pro odstranění na straně kolektoru, smažte ssl-cert.pem a ssl-key.pem, když je kolektor zastavený.
Kolektor zahájí nový zápis pod novou identitou, když bude znovu spuštěn.
Tato akce se nazývá reset identity kolektoru.
Konfigurace kolektoru
connection:CommLink:commlink:
url: https://recv.logman.example.com/
input:..:LogSource1:
output: logsource-1
output:CommLink:logsource-1: {}
...
Sekce connection:CommLink:commlink:
Tato sekce konfiguruje komunikační linku do centrální části TeskaLabs LogMan.io.
Konfiguraci lze také poskytnout v konfiguračním souboru aplikace.
Pokud je sekce [commlink] přítomna, položky z ní jsou načteny před aplikací hodnot z YAML.
Example
Prázdná YAML specifikace:
connection:CommLink:commlink: {}
...
URL je použito z konfiguračního souboru aplikace:
[commlink]
url=https://recv.logman.example.com/
...
Možnost url
Povinná hodnota s URL centrální části LogMan.io.
Musí použít protokol https://, ne http://.
Typické hodnoty jsou:
https://recv.logman.example.com/- pro dedikovaný NGINX server pro příjem logůhttps://logman.example.com/lmio-receiver- pro jeden DNS doménu na NGINX serveru
Může být také poskytnuto v proměnné prostředí LMIO_COMMLINK_URL.
Možnost insecure
Volitelná (výchozí: no) Booleovská hodnota, která při nastavení na yes umožňuje nezabezpečené připojení k serveru.
Tato možnost umožňuje použití self-signed SSL certifikátů serveru.
Danger
Nepoužívejte možnost insecure v produkčních konfiguracích.
Tip
Toto je jednoduchý způsob, jak můžete specifikovat důvěryhodný vlastní CA certifikát, abyste nemuseli nastavovat insecure: yes.
connection:CommLink:commlink: {}
url: https://recv.logman.example.com/
cadata: |
-----BEGIN CERTIFICATE-----
<PEM form of the CA certificate>
-----END CERTIFICATE-----
...
Můžete specifikovat více než jeden CA certifikát. Mind the proper YAML formating, you need to indent the PEM block.
Můžete také použít cafile a capath k určení cest k vašemu CA.
Pokročilé možnosti konfigurace SSL
Následující konfigurační možnosti specifikují SSL (HTTPS) připojení:
cert: Cesta ke klientskému SSL certifikátukey: Cesta k privátnímu klíči klientského SSL certifikátupassword: Heslo souboru s privátním klíčem (volitelné, výchozí: žádné)cafile: Cesta k PEM souboru s CA certifikátem(i) pro ověření SSL serveru (volitelné, výchozí: žádné)capath: Cesta k adresáři s CA certifikátem(i) pro ověření SSL serveru (volitelné, výchozí: žádné)cadata: jeden nebo více PEM-encoded CA certifikátů pro ověření SSL serveru (volitelné, výchozí: žádné)verify_mode: Jedna z CERT_NONE, CERT_OPTIONAL nebo CERT_REQUIRED (volitelné); pro více informací, viz: github.com/TeskaLabs/asabciphers: SSL ciphers (volitelné, výchozí: žádné)dh_params: Parametry pro výměnu klíčů Diffie–Hellman (D-H) (TLS) (volitelné, výchozí: žádné)
Sekce output:CommLink:<stream>:
<stream> Název streamu v archivu a v tématech Apache Kafka.
Logy budou přiváděny do názvu streamu received.<tenant>.<stream>.
{} znamená na konci, že pro tento výstup nejsou žádné možnosti.
Note
Platí také obecné možnosti pro output:.
Jako například debug: true pro ladění.
Více zdrojů
Kolektor může zpracovávat více zdrojů logů (event lanes) z jedné instance.
Pro každý zdroj přidejte sekce input:.. a output:CommLink:... do konfigurace.
Example
connection:CommLink:commlink:
url: https://recv.logman.example.com/
# První (TCP) zdroj logů
input:Stream:LogSource1:
address: 8888 # Poslouchá na TCP/8888
output: tcp-8888
output:CommLink:tcp-8888: {}
# Druhý (UDP) zdroj logů
input:Datagram:LogSource2:
address: 8889 # Poslouchá na UDP/8889
output: udp-8889
output:CommLink:udp-8889: {}
# Třetí (UDP + TCP) zdroj logů
input:Stream:LogSource3s:
address: 8890 # Poslouchá na TCP/8890
output: p-8890
input:Datagram:LogSource3d:
address: 8890 # Poslouchá na UDP/8890
output: p-8890
output:CommLink:p-8890: {}
Warning
Zdroje logů shromažďované jednou instancí kolektoru musí sdílet jeden tenant.
Způsoby doručení
Když je kolektor online, logy a další události jsou doručeny okamžitě přes Websocket.
Když je kolektor offline, logy jsou uloženy v offline bufferu a jakmile se kolektor znovu připojí, buffered logy jsou synchronizovány zpět. Tento způsob doručení se nazývá syncback. Buffered logy jsou nahrány pomocí HTTP PUT žádosti.
Offline buffer
Když není kolektor připojen k příjemci, logy jsou uloženy v lokálním bufferu kolektoru a nahrány k příjemci ihned po obnovení konektivity.
Buffered logy jsou při uložení v offline bufferu komprimovány pomocí xz.
Lokální buffer je adresář na souborovém systému, umístění této složky lze konfigurovat:
[general]
buffer_dir=/var/lib/lmio-receiver/buffer
Warning
Kolektor sleduje dostupnou kapacitu disku v této složce a přestane bufferovat logy, pokud je volné méně než 5% místa na disku.
Připojení během údržby
Kolektor se připojuje každý den během údržby - obvykle ve 4:00 ráno. Toto je k obnovení vyvážené distribuce připojených kolektorů napříč clusterem.
Archiv
LogMan.io Receiver archiv je neměnný, sloupcově orientovaný a pouze přídavný úložiště dat z přijatých surových logů.
Každý komunikační kanál dodává data do streamu.
Stream je nekonečná tabulka s poli.
Název streamu je složen z předpony received., názvu tenanta a komunikačního kanálu (např. received.mytenant.udp-8889).
Archivní stream obsahuje následující pole pro každý logový záznam:
raw: Surový log (řetězec, digitálně podepsaný)row_id: Primární identifikátor řádku unikátní napříč všemi streamy (64bitové neznaménkové celé číslo)collected_at: Datum a čas sběru logu na Kolektorureceived_at: Datum a čas přijetí logu na přijímačisource: Popis zdroje logu (řetězec)
Pole source obsahuje:
- pro TCP vstupy:
<ip adresa> <port> S(S označuje stream) - pro UDP vstupy:
<ip adresa> <port> D(D označuje datagram) - pro souborové vstupy: název souboru
- pro ostatní vstupy: volitelná specifikace zdroje
Pole source pro log doručený přes UDP
192.168.100.1 61562 D
Log byl nasbírán z IP adresy 192.168.100.1 a portu UDP/61562.
Partice
Každý stream je rozdělen na partice. Partice stejného streamu mohou být umístěny na různých instancích přijímače.
Info
Partice mohou sdílet identická časová období. To znamená, že záznamy dat ze stejného časového rozmezí mohou být nalezeny ve více než jedné partici.
Každá partice má své číslo (part_no), začínající od 0.
Toto číslo se monotónně zvyšuje pro nové partice v archivu, napříč streamy.
Číslo partice je globálně unikátní v rámci clusteru.
Číslo partice je zakódováno do názvu partice.
Název partice je 6 znakový název, který začíná aaaaaa (tedy partice #0) a pokračuje aaaaab (partice #1) a tak dále.
Partici lze prozkoumat v Zookeeperu:
/lmio/receiver/db/received.mytenant.udp-8889/aaaaaa.part
partno: 0 # Číslo partice se překládá na aaaaaa
count: 4307 # Počet řádků v této partici
size: 142138 # Velikost partice v bajtech (nekomprimováno)
created_at:
iso: '2023-07-01T15:22:53.265267'
unix_ms: 1688224973265267
closed_at:
iso: '2023-07-01T15:22:53.283168'
unix_ms: 1688224973283167
extra:
address: 192.168.100.1 49542 # Adresa Kolektoru
identity: ABCDEF1234567890 # Identita Kolektoru
stream: udp-8889
tenant: mytenant
columns:
raw:
type: string
collected_at:
summary:
max:
iso: '2023-06-29T20:33:18.220173'
unix_ms: 1688070798220173
min:
iso: '2023-06-29T18:25:03.363870'
unix_ms: 1688063103363870
type: timestamp
received_at:
summary:
max:
iso: '2023-06-29T20:33:18.549359'
unix_ms: 1688070798549359
min:
iso: '2023-06-29T18:25:03.433202'
unix_ms: 1688063103433202
type: timestamp
source:
summary:
token:
count: 2
type: token:rle
Tip
Protože je název partice globálně unikátní, je možné partici přesunout na sdílené úložiště, např. NAS nebo cloudové úložiště z různých uzlů clusteru. Celoživotní cyklus je navržen tak, aby se názvy particí nekolidovaly, takže data nebudou přepsána různými přijímači, ale správně sestavena na "sdíleném" úložišti.
Životní cyklus
Životní cyklus partice je definován pomocí fází.
Ingest partice jsou partice, které přijímají data. Jakmile je příjem dokončen, tedy přestane se do této partice zapisovat, je uzavřena. Partice nemohou být znovu otevřeny.
Když je partice uzavřena, začíná její životní cyklus. Každá fáze je konfigurována tak, aby ukazovala na specifický adresář na souborovém systému.
Životní cyklus je definován na úrovni streamu, ve vstupu /lmio/receiver/db/received... v ZooKeeperu.
Tip
Partice lze také ručně přesunout do požadované fáze pomocí API volání.
Výchozí životní cyklus
Výchozí životní cyklus se skládá ze tří fází: hot, warm a cold.
graph LR
I(Ingest) --> H[Hot];
H --1 den--> W[Warm];
W --2 týdny--> D(Smazání);
H --ihned-->C[Cold];
C --18 měsíců--> CD(Smazání);Příjem je prováděn ve hot fázi. Jakmile je příjem dokončen a partice uzavřena, je partice zkopírována do cold fáze. Po 1 dni je partice přesunuta do warm fáze. To znamená, že partice je duplikována - jedna kopie je ve úložišti cold fáze, druhá kopie je ve úložišti warm fáze.
Partice v úložišti warm fáze je smazána po 2 týdnech.
Partice v úložišti cold fáze je komprimována pomocí xz/LZMA. Partice je smazána z cold fáze po 18 měsících.
Definice výchozího životního cyklu
define:
type: jizera/stream
ingest: # (1)
phase: hot
rotate_size: 30G
rotate_time: daily
lifecycle:
hot:
- move: # (2)
age: 1d
phase: warm
- copy: # (3)
phase: cold
warm:
- delete: # (4)
age: 2w
cold:
- compress: # (5)
type: xz
preset: 6
threads: 4
- delete: # (6)
age: 18M
- Příjem nových logů do hot fáze.
- Po jednom dni přesunout partici z hot do warm fáze.
- Ihned po uzavření příjmu zkopírovat partici do cold fáze.
- Smazat partici po 2 týdnech.
- Partici komprimovat okamžitě po příchodu do cold fáze.
- Smazat partici po 18 měsících z cold fáze.
Doporučení pro ukládání fází:
- Hot fáze by měla být umístěna na SSD
- Warm fáze by měla být umístěna na HDD
- Cold fáze je archiv, může být umístěna na NAS nebo pomalých HDD.
Note
Pro více informací navštivte Administrativní manuál, kapitolu o Diskovém úložišti.
Pravidla životního cyklu
move: Přesunout partici ve specifikovanémagedo specifikovanéphase.copy: Zkopírovat partici ve specifikovanémagedo specifikovanéphase.delete: Smazat partici ve specifikovanémage.
age může být např. "3h" (tři hodiny), "5M" (pět měsíců), "1y" (jeden rok) a podobně.
Podporované postfixy age:
y: rok, resp. 365 dníM: měsíc, resp. 31 dníw: týdend: denh: hodinam: minuta
Note
Pokud není age zadáno, pak je věk nastaven na 0, což znamená, že akce životního cyklu je provedena ihned.
Pravidlo komprese
compress: Komprimovat data při příjmu do fáze.
Aktuálně je podporován type: xz s následujícími možnostmi:
preset: Xz kompresní úroveň.
Komprese může být zhruba rozdělena do tří kategorií:
0...2
Rychlé úrovně s relativně nízkou paměťovou náročností. 1 a 2 by měly poskytnout kompresní rychlost a poměr srovnatelný s bzip2 1 a bzip2 9, resp.
3...5
Dobré kompresní poměry s nízkou až střední paměťovou náročností. Tyto úrovně jsou výrazně pomalejší než úrovně 0-2.
6...9
Vynikající komprese se střední až vysokou paměťovou náročností. Tyto úrovně jsou také pomalejší než nižší úrovně.
Výchozí je úroveň 6.
Pokud nechcete maximalizovat kompresní poměr, pravděpodobně nechcete použít úroveň vyšší než 7 kvůli rychlosti a paměťové náročnosti.
threads: Maximální počet CPU vláken použitých pro kompresi.
Výchozí je 1.
Nastavte na 0 pro použití tolika vláken, kolik je jader procesoru.
Manuální dekomprese
Můžete použít xz --decompress nebo unxz z XZ Utils.
Můžete použít 7-Zip pro dekompresi souborů archivu na Windows.
Vždy pracujte s kopiemi souborů v archivu; nejprve zkopírujte všechny soubory z archivu a neměňte (dekomprimujte) soubory v archivu.
Pravidlo replikace
replica: Určuje počet kopií dat (replik), které by měly být přítomny ve fázi.
Repliky jsou uloženy na různých instancích přijímače, takže počet replik by NEMĚL být vyšší než počet přijímačů v clusteru, který provozuje danou fázi. Jinak "nadměrné" repliky nebudou vytvořeny, protože se nenalezne dostupná instance přijímače.
Replikace ve fázi hot
define:
type: jizera/stream
lifecycle:
hot:
- replica:
factor: 2
...
factor: Počet kopií dat ve fázi, výchozí hodnota je 1.
Rotace
Partice rotace je mechanismus, který uzavírá partice pro příjem za specifických podmínek. Když je partice pro příjem uzavřena, nová data jsou ukládána do nově vytvořené další partice pro příjem. Tím je zajištěno více či méně rovnoměrné rozdělení nekonečného proudu dat.
Rotace je konfigurována na úrovni streamu pomocí:
rotate_time: období (např.daily), po které může být partice v režimu příjmurotate_size: maximální velikost partice; postfixyT,G,Makjsou podporovány pomocí základu 10.
Obě možnosti mohou být použity současně.
Výchozí rotace streamu je daily a 30G.
Plán
Pouze možnost daily je momentálně dostupná pro rotate_time.
Vydávání dat
Data mohou být extrahována z archivu (např. pro zpracování třetími stranami, migraci a podobně) kopírováním adresáře dat particí v rámci vydávání.
Použijte Zookeeper k identifikaci, které partice jsou v rámci vydávání a kde jsou fyzicky umístěny na úložištích.
Sloupec raw může být přímo zpracován nástroji třetích stran.
Pokud jsou data komprimována konfigurací životního cyklu, může být potřeba dekomprese.
Note
To znamená, že nemusíte partici přesouvat například z cold fáze do warm nebo hot fáze.
Přehrávání dat
Archivované logy lze přehrát do následných centrálních komponent.
Nenapadnutelnost
Archiv je kryptograficky zabezpečený, navržený pro sledovatelnost a nenapadnutelnost. Digitální podpisy se používají k ověření autenticity a integrity dat, což poskytuje jistotu, že logy nebyly pozměněny a byly skutečně vygenerovány uvedeným zdrojem logu.
Tento přístup založený na digitálních podpisech k udržování logů je zásadním prvkem bezpečných logovacích praktik a pilířem robustního informačního bezpečnostního management systému. Tyto logy jsou klíčové nástroje pro forenzní analýzu během reakcí na incidenty, detekci anomálií nebo škodlivých aktivit, auditování a dodržování předpisů.
K zajištění bezpečnosti logů používáme následující kryptografické algoritmy: SHA256, ECDSA.
Hashovací funkce, SHA256, je aplikována na každý surový logový záznam. Tato funkce vezme vstupní surový logový záznam a vytvoří řetězec bajtů pevné délky. Výstup (nebo hash) je unikátní pro vstupní data; mírná změna ve vstupu vytvoří dramaticky odlišný výstup, což je charakteristika známá jako "efekt laviny".
Tento unikátní hash je poté podepsán pomocí privátního podpisového klíče prostřednictvím ECDSA algoritmu, který generuje digitální podpis, který je unikátní jak pro data, tak pro klíč. Tento digitální podpis je uložen spolu se surovými logovými daty, což certifikuje, že data logu pocházejí z daného zdroje logu a nebyla během uložení pozměněna.
Digitální podpisy sloupců raw jsou uloženy v ZooKeeperu (kanonické umístění) a v souborovém systému pod názvem col-raw.sig.
Každá partice je také vybavena jedinečným SSL podpisovým certifikátem, pojmenovaným signing-cert.der.
Tento certifikát, ve spojení s digitálním podpisem, může být použit k ověření, že col-raw.data (původní surové logy) nebyly pozměněny, což zajišťuje integritu dat.
Important
Uvědomte si, že přidružený privátní podpisový klíč není uložen nikde, kromě procesní paměti, z bezpečnostních důvodů. Privátní klíč je odstraněn, jakmile partice dokončí svůj příjem dat.
Podpisový certifikát je vydáván
Odesílání do Kafka
Pokud je Apache Kafka konfigurováno v nastavení, každá přijatá log událost je přeposlána LogMan.io Receiverem do Kafka topic. Topic je vytvořen automaticky, když je přeposlána první zpráva.
Název Apache Kafka topic je odvozen od názvu streamu: received.<tenant>.<stream>, je stejný jako název v archivu.
Příklad Kafka topiců
received.mytenant.udp-8889
received.mytenant.tcp-7781
Surová log událost je odeslána v těle Kafka zprávy.
Následující informace jsou přidány do hlavičky zprávy:
row_id: Row Id, globálně unikátní identifikátor události v archivu. Není přítomen, pokud je archiv deaktivován. 64bit binární big endian unsigned integer.collected_at: Datum a čas sběru události, Unix timestamp v mikrosekundách jako řetězec.received_at: Datum a čas přijetí události, Unix timestamp v mikrosekundách jako řetězec.source: Zdroj události, řetězec.tenant: Název tenant, který tuto zprávu přijal, řetězec. (ZASTARALÉ)
Plán
Automatizované nastavení Kafka topicu (jako je počet Kafka partitions) bude implementováno v budoucích verzích.
Konfigurace NGINX
Doporučujeme použít dedikovaný virtuální server v NGINX pro LogMan.io Receiver respektive komunikační odkazy z LogMan.io Collector na LogMan.io Receiver.
Tento server sdílí proces NGINX serveru a IP adresu a je provozován na dedikované DNS doméně, odlišné od LogMan.io Web UI.
Například, LogMan.io Web UI běží na http://logman.example.com/ a receiver je dostupný na https://recv.logman.example.com/.
V tomto příkladu logman.example.com a recv.logman.example.com mohou být přeloženy na stejnou IP adresu.
Více NGINX serverů může být nakonfigurováno na různých uzlech clusteru, aby zvládaly příchozí spojení od kolektorů, sdílející stejný DNS název. Doporučujeme implementovat tuto možnost pro vysoce dostupné clustery.
upstream lmio-receiver-upstream {
server 127.0.0.1:3080; # (1)
server node-2:3080 backup; # (2)
server node-3:3080 backup;
}
server {
listen 443 ssl; # (3)
server_name recv.logman.example.com;
ssl_certificate recv-cert.pem; # (4)
ssl_certificate_key recv-key.pem;
ssl_client_certificate conf.d/receiver/client-ca-cert.pem; # (5)
ssl_verify_client optional;
ssl_session_timeout 1d;
ssl_session_cache shared:SSL:50m;
ssl_session_tickets off;
ssl_protocols TLSv1.3;
ssl_ciphers 'EECDH+AESGCM:EECDH+AES:AES256+EECDH:AES256+EDH';
ssl_prefer_server_ciphers on;
ssl_stapling on;
ssl_stapling_verify on;
server_tokens off;
add_header Strict-Transport-Security "max-age=15768000; includeSubdomains; preload";
add_header X-Frame-Options DENY;
add_header X-Content-Type-Options nosniff;
location / { # (8)
proxy_pass http://lmio-receiver-upstream;
proxy_http_version 1.1;
proxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection "Upgrade";
proxy_set_header Host $host;
proxy_set_header X-SSL-Verify $ssl_client_verify; # (6)
proxy_set_header X-SSL-Cert $ssl_client_escaped_cert;
client_max_body_size 500M; # (7)
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
}
}
-
Odkazuje na lokálně běžící
lmio-receiver, veřejný Web API port. Toto je primární destinace, protože šetří síťový provoz. -
Záložní odkazy na receivery běžící na jiných uzlech clusteru, které běží
lmio-receiver, v tomto příkladunode-2anode-3. Zálohy budou použity, když lokálně běžící instance není dostupná. V instalaci na jednom uzlu tyto položky zcela přeskočte. -
Toto je dedikovaný HTTPS server běžící na https://recv.logman.example.com.
-
Musíte poskytnout SSL serverový klíč a certifikát. Můžete použít samopodepsaný certifikát nebo certifikát poskytovaný certifikační autoritou.
-
Certifikát
client-ca-cert.pemje automaticky vytvořenlmio-receiver. Viz část "Client CA certifikát". -
Toto ověřuje SSL certifikát klienta (
lmio-collector) a předává tuto informacilmio-receiver. -
lmio-collectormůže nahrávat části buffered logů. -
URL cesta, kde je vystavena API
lmio-collector.
Ověření SSL web serveru
Po dokončení konfigurace NGINX vždy ověřte kvalitu konfigurace SSL pomocí např. Qualsys SSL Server test. Měli byste získat celkové hodnocení "A+".
Příkaz OpenSSL pro generování samopodepsaného serverového certifikátu
openssl req -x509 -newkey ec -pkeyopt ec_paramgen_curve:secp384r1 \
-keyout recv-key.pem -out recv-cert.pem -sha256 -days 380 -nodes \
-subj "/CN=recv.logman.example.com" \
-addext "subjectAltName=DNS:recv.logman.example.com"
Tento příkaz generuje samopodepsaný certifikát pomocí kryptografie eliptické křivky se zakřivením secp384r1.
Certifikát je platný 380 dní a obsahuje SAN rozšíření pro specifikaci názvu hostitele recv.logman.example.com.
Soukromý klíč a certifikát jsou uloženy do recv-key.pem a recv-cert.pem respektive.
Client CA certifikát
NGINX potřebuje soubor client-ca-cert.pem pro možnost ssl_client_certificate.
Tento soubor je generován lmio-receiver během prvního spuštění, je to export certifikátu klientské CA z Zookeeper od lmio/receiver/ca/cert.der.
Z tohoto důvodu musí být lmio-receiver spuštěn před tím, než je vytvořena konfigurace tohoto virtuálního serveru NGINX.
lmio-receiver vygeneruje tento soubor do složky ./var/ca/client-ca-cert.pem.
docker-compose.yaml
lmio-receiver:
image: docker.teskalabs.com/lmio/lmio-receiver
volumes:
- ./nginx/conf.d/receiver:/app/lmio-receiver/var/ca
...
nginx:
volumes:
- ./nginx/conf.d:/etc/nginx/conf.d
...
Jedna DNS doména
lmio-receiver může být alternativně umístěn na stejné doméně a portu jako LogMan.io Web IU.
V tomto případě je API lmio-receiver vystaveno na podcestě: http://logman.example.com/lmio-receiver
Ukázka z konfigurace NGINX pro HTTPS server "logman.example.com".
upstream lmio-receiver-upstream {
server 127.0.0.1:3080;
server node-2:3080 backup;
server node-3:3080 backup;
}
...
server {
listen 443 ssl;
server_name logman.example.com;
...
ssl_client_certificate conf.d/receiver/client-ca-cert.pem;
ssl_verify_client optional;
...
location /lmio-receiver {
rewrite ^/lmio-receiver/(.*) /$1 break;
proxy_pass http://lmio-receiver-upstream;
proxy_http_version 1.1;
proxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection "Upgrade";
proxy_set_header Host $host;
proxy_set_header X-SSL-Verify $ssl_client_verify;
proxy_set_header X-SSL-Cert $ssl_client_escaped_cert;
client_max_body_size 500M;
proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
}
}
V tomto případě musí být nastavení lmio-collector CommLink:
connection:CommLink:commlink:
url: https://logman.example.com/lmio-receiver/
...
Load balancing a vysoká dostupnost
Load balancing je nakonfigurován pomocí sekce upstream konfigurace NGINX.
upstream lmio-receiver-upstream {
server node-1:3080;
server node-2:3080 backup;
server node-3:3080 backup;
}
Kolektor se připojuje k příjemci prostřednictvím NGINX pomocí dlouhotrvajícího WebSocket spojení (Commlink). NGINX se nejprve pokusí předat příchozí spojení na "node-1". Pokud to selže, pokusí se předat jednoho ze záloh: "node-2" nebo "node-3". "node-1" je přednostně "localhost", takže síťový provoz je omezen, ale může být překonfigurován jinak.
Protože spojení WebSocket je trvalé, webový socket zůstane připojen k "záložnímu" serveru, i když se primární server stane znovu online. Kolektor se znovu připojí "při údržbě" (denně, během noci) k obnovení správného vyvážení.
Tento mechanismus také poskytuje funkci vysoké dostupnosti instalace. Když je NGINX nebo instance příjemce dole, kolektory se připojí k jiné instanci NGINX a tato instance předá tato spojení dostupným příjemcům.
Pro rozložení příchozího webového provozu mezi dostupné instance NGINX se doporučuje vyvážení DNS round-robin. Ujistěte se, že hodnota TTL DNS souvisejících záznamů (A, AAAA, CNAME) je nastavena na nízkou hodnotu, například 1 minutu.
Interní Architektura Přijímače
Architektura

Commlink
MessagePack je použit pro doručování logů/událostí jak v instant tak syncback režimu.
Commlink je také použit pro obousměrné doručování JSON zpráv, jako jsou metriky kolektoru, které jsou zasílány do InfluxDB v centrálním clusteru.
Struktura Archivu
- Stream: identifikovaný podle Stream Name
- Partition: identifikovaná podle Partition Number
- Row: identifikovaná podle Row Number, respektive podle Row Id
- Column: identifikovaná podle názvu.
- Row: identifikovaná podle Row Number, respektive podle Row Id
- Partition: identifikovaná podle Partition Number
Stream je nekonečná datová struktura rozdělená na partitiony. Partition se vytváří a naplňuje během ingestování řádků. Jakmile partition dosáhne určité velikosti nebo věku, je rotována, což znamená, že partition je uzavřena a vytvoří se nová ingestující partition. Jakmile je partition uzavřena, nemůže být znovu otevřena a zůstává pouze pro čtení po zbytek svého životního cyklu.
Partition obsahuje řádky, které jsou dále rozděleny na sloupce. Struktura sloupců je fixní v jedné partition, ale může být odlišná v jiných partition ve stejném streamu.
Archívní Soubory
Data streamů a konkrétních partition jsou uložena na souborovém systému ve složkách, které jsou specifikovány fázemi životního cyklu.
Obsah adresáře /data/ssd/receiver (hot fáze)
+ received.mytenant.udp-8889
+ aaaaaa.part
+ summary.yaml
+ signing-cert.der
+ col-raw.data
+ col-raw.pos
+ col-raw.sig
+ col-collected_at.data
+ col-received_at.data
+ col-source.data
+ col-source-token.data
+ col-source-token.pos
+ aaaaab.part
+ summary.yaml
+ ...
+ aaaaac.part
+ summary.yaml
+ ...
+ received.mytenant.tcp-7781
...
Adresář partition aaaaaa.part obsahuje celý obsah partition.
Struktura je stejná pro každou fázi životního cyklu.
Soubor summary.yaml obsahuje ne-kanonické informace o partition.
Kanonická verze informací je v Zookeeper.
Soubor signing-cert.der obsahuje SSL certifikát pro ověření digitálních podpisů col-*.sig.
Certifikát je jedinečný pro každou partition.
Soubory col-*.data obsahují data pro dané pole.
Číslo Partition / part_no
Nezáporné 24bitové celé číslo, rozsah 0..16,777,216, max. 0xFF_FF_FF.
Číslo partition je dodáváno pomocí sdíleného čítače v Zookeeper, umístěného na /lmio/receiver/db/part.counter.
To znamená, že každá partition má jedinečné číslo bez ohledu na to, ke kterému streamu patří.
Důvod
10[let] * 365[dní v roce] * 24[hodin denně] * 10[bezpečnost] = 876000 partition (5% z max.)
Číslo partition je často zobrazeno jako řetězec o 6 znacích, například aaaaaa.
Je to Base-16 zakódovaná verze tohoto celého čísla, používající znaky abcdefghijklmnop.
Číslo Řádku / row_no
Pozice v rámci partition.
Nezáporné 40bitové celé číslo 0xFF_FF_FF_FF_FF (rozsah 0..1,099,511,627,775)
Důvod
1.000.000 EPS za 24 hodin * 10[bezpečnost] = 860,400,000,000
Id Řádku / row_id
Globální jedinečný 64bitový identifikátor řádku (logu, události).
Protože row_id je složen z part_no, zaručuje svou globální jedinečnost nejen v rámci jednoho streamu, ale napříč všemi streamy.
Výpočet
row_id = (part_no << 24) | row_no
row_id:
+------------------------+--------------------------+
| part_no | row_no |
+------------------------+--------------------------+
Typ Sloupce string
Typ sloupce string používá dva typy souborů:
-
col-<column name>.data: Surová bajtová data vstupů ve sloupci. Každý vstup je sekvenčně přidáván na konec souboru, což z něj činí soubor pouze pro přidávání. Vstupy tak nejsou ukládány s explicitními oddělovači nebo značkami záznamů. Místo toho je poloha každého vstupu sledována v doprovodném souborucol-<column name>.pos. -
col-<column name>.pos: Počáteční bajtové pozice každého vstupu v odpovídajícím souborucol-<column name>.data. Každá pozice je uložena jako 32bitové nezáporné celé číslo. Pozice jsou ukládány sekvenčně v pořadí, v jakém jsou přidávány docol-<column name>.data. N-té celé číslo v souborucol-<column name>.posoznačuje počáteční pozici N-tého vstupu v souborucol-<column name>.data. Délka N-tého vstupu je rozdíl mezi N-tým celým číslem a (N+1)-tým celým číslem v souborucol-<column name>.pos.

Sekvenční Přístup k Datům
Sekvenční přístup k datům zahrnuje čtení dat v pořadí, v jakém jsou uložena v souborech sloupce.
Níže jsou kroky k sekvenčnímu přístupu k datům:
-
Otevřete oba soubory
col-<column name>.posacol-<column name>.data. Přečtěte první 32bitové celé číslo ze souborucol-<column name>.pos. Inicializujte aktuální pozici s hodnotou 0. -
Přečtěte další 32bitové celé číslo, zde označované jako hodnota pozice, ze souboru
col-<column name>.pos. Výpočet délky vstupu dat je proveden odečtením aktuální pozice od hodnoty pozice. Poté aktualizujte aktuální pozici na nově přečtenou hodnotu pozice. -
Přečtěte data ze souboru
col-<column name>.datapomocí délky vypočtené v kroku 2. Tato délka dat odpovídá skutečnému obsahu databázového řádku. -
Opakujte kroky 2 a 3 pro čtení dalších řádku. Pokračujte v tomto procesu, dokud nedosáhnete konce souboru
col-<column name>.pos, což by znamenalo, že všechny řádky dat byly přečteny.
Náhodný Přístup k Datům
Pro přístup k N-tému řádku ve sloupci postupujte takto:
-
Přesuňte se na (N-1)-tého pozici v souboru
col-<column name>.posnebo na 0, pokud je N == 0. Každá pozice odpovídá 32bitovému celému číslu, takže N-tá pozice odpovídá N-tému 32bitovému číslu. Například pro přístup k 6. řádku se přesuňte na 5. celé číslo (20 bajtů od začátku, protože každé celé číslo má 4 bajty). -
Přečtěte jedno nebo dvě 32bitová celá čísla ze souboru
col-<column name>.pos. Pokud N == 0, přečtěte pouze jedno celé číslo, pozice je předpokládaná jako 0. První celé číslo označuje počáteční pozici požadovaného vstupu v souborucol-<column name>.data. Pro N > 0, přečtěte dvě celá čísla. Druhé celé číslo označuje počáteční pozici dalšího vstupu. Rozdíl mezi druhým a prvním číslem dává délku požadovaného vstupu. -
Přesuňte se na pozici v souboru
col-<column name>.dataoznačenou prvním číslem přečteným v předchozím kroku. -
Přečtěte vstup ze souboru
col-<column name>.datapomocí vypočtené délky z kroku 2.
Typ Sloupce timestamp
Typ sloupce timestamp používá jeden typ souboru: col-<column name>.data.
Každé záznam v tomto sloupci je 64bitový Unixový časový razítko představující datum a čas v přesnosti mikrosekund.
Info
Unixový časový razítko je způsob sledování času jako celkového počtu sekund, které uplynuly od 1970-01-01 00:00:00 UTC, bez započítání přestupných sekund.
Přesnost na úrovni mikrosekundy umožňuje sledovat čas ještě přesněji.
Sloupec timestamp shrnuje minimální a maximální časový razítko v každé partition.
Toto shrnutí je v Zookeeper a v souboru summary.yaml na souborovém systému.
Sekvenční Přístup k Datům
Sekvenční přístup ke sloupci timestamp zahrnuje čtení každého časového razítka v pořadí, v jakém jsou uložena:
- Otevřete soubor
col-<column name>.data. - Přečtěte 64bitové celé číslo ze souboru
col-<column name>.data. Toto celé číslo je váš Unixový časový razítko v mikrosekundách. - Opakujte krok 2, dokud nedosáhnete konce souboru, což znamená, že jste přečetli všechna časová razítka.
- Zavřete soubor.
Náhodný Přístup k Datům
Pro přístup k časovému razítku na specifické pozici řádku (Nth pozice):
- Přesuňte se na N-tou pozici v souboru
col-<column name>.data. Jelikož každé časové razítko je 64bitové (nebo 8bajtové) celé číslo, pro přístup k N-tému časovému razítku se přesuňte na N * 8. bajt. - Přečtěte 64bitové celé číslo ze souboru
col-<column name>.data. Toto je váš Unixový časový razítko v mikrosekundách pro N-tý řádek.
Typ Sloupce token
Sloupec typu token je navržen pro ukládání textových dat v optimalizovaném formátu. Je obzvláště vhodný pro scénáře, kde sloupec obsahuje relativně malý počet odlišných, opakujících se hodnot.
Místo přímého ukládání skutečných textových dat kóduje typ sloupce token každý řetězec na celé číslo. Tento kódovací proces je realizován indexem, který je sestaven na základě všech jedinečných textových hodnot v partišním sloupci. Každému jedinečnému řetězci je v tomto indexu přiřazen jedinečný celočíselný identifikátor a tyto identifikátory nahrazují původní řetězce ve sloupci token.
Samotný index je reprezentován pozicí řetězce v páru přidružených souborů: col-<column name>-token.data a col-<column name>-token.pos.
Viz typ sloupce string pro více podrobností.
Tento přístup poskytuje významné úspory úložného prostoru a zvyšuje efektivitu dotazů pro sloupce s omezeným množstvím často se opakujících hodnot. Kromě toho umožňuje rychlejší operace porovnávání, protože porovnání celých čísel je obvykle rychlejší než porovnání řetězců.
Nebezpečí
Uvědomte si, že tento přístup nemusí přinést výhody, pokud je počet unikátních textových hodnot velký nebo pokud jsou textové hodnoty většinou jedinečné. Režie na udržování indexu by mohla převážit výhody úspory místa a výkonu pomocí kompaktního úložiště celých čísel.
Typ sloupce token používá tři typy souborů:
col-<column name>.data: Index hodnot sloupce, každý reprezentovaný jako 16bitové nezáporné celé číslo.col-<column name>-token.dataacol-<column name>-token.pos: Index používá stejnou strukturu jako typ sloupce string. Pozice řetězce v těchto souborech představuje kódovanou hodnotu řetězce ve sloupci token.
Sekvenční Přístup k Datům
Sekvenční přístup ke sloupci token zahrnuje čtení každého tokenu v pořadí, v jakém jsou uloženy.
To se provádí pomocí indexů uložených v souboru col-<column name>.data a jejich překladem na skutečné textové hodnoty pomocí souborů col-<column name>-token.data a col-<column name>-token.pos.
Zde jsou kroky k sekvenčnímu přístupu k datům:
- Otevřete soubor
col-<column name>.data. Tento soubor obsahuje 16bitová nezáporná celá čísla, která slouží jako indexy do seznamu tokenů. - Přečtěte 16bitové nezáporné celé číslo ze souboru
col-<column name>.data. To je index vašeho tokenového řetězce. - Použijte "Náhodný přístup k datům" z typu sloupce string na souborech
col-<column name>-token.dataacol-<column name>-token.posk získání textové hodnoty. - Opakujte kroky 2 a 3, dokud nedosáhnete konce souboru
col-<column name>.data, což naznačuje, že všechny tokeny byly přečteny. - Zavřete všechny soubory.
Náhodný Přístup k Datům
Náhodný přístup ve sloupci token umožňuje získat jakýkoliv záznam bez potřeby procházet předchozí záznamy. To může být zvláště výhodné ve scénářích, kde je potřeba získat pouze konkrétní záznamy, nikoli celý dataset.
Pro přístup k tokenu na specifické pozici řádku (Nth pozice):
- Přesuňte se na N-tou pozici v souboru
col-<column name>.data. Každý záznam indexu je 16bitové (nebo 2bajtové) celé číslo, proto se pro dosažení N-tého záznamu přesuňte na N * 2. bajt. - Přečtěte 16bitové celé číslo ze souboru
col-<column name>.data. Toto je váš indexový záznam pro N-tý řádek. - Použijte "Náhodný přístup k datům" z typu sloupce string na souborech
col-<column name>-token.dataacol-<column name>-token.posk získání textové hodnoty.
Typ Sloupce token:rle
Sloupec typu token:rle rozšiřuje typ sloupce token přidáním Run-Length Encoding (RLE) pro další optimalizaci úložiště. Tento typ je obzvl
Parsec
LogMan.io Parsec
TeskaLabs LogMan.io Parsec je mikroservis zodpovědný za parsování logů z různých Kafka témat. LogMan.io Parsec vkládá logy do jednoho EVENTS Kafka tématu, pokud parsování uspěje, a do OTHERS Kafka tématu, pokud parsování selže.
Parsování je proces analyzování původního logu (který je typicky ve formátu jednoho/víceřádkového řetězce, JSON, nebo XML) a transformace do seznamu dvojic klíč-hodnota, které popisují log data (jako například kdy se původní událost stala, priorita a závažnost logu, informace o procesu, který log vytvořil, atd.).
Note
LogMan.io Parsec nahrazuje LogMan.io Parser.
Jednoduchý příklad parsování
Parsování vezme syrový log, jako například tento:
<30>2023:12:04-15:33:59 hostname3 ulogd[1620]: id="2001" severity="info" sys="SecureNet" sub="packetfilter" name="Packet dropped" action="drop" fwrule="60002" initf="eth2.3009" outitf="eth6" srcmac="e0:63:da:73:bb:3e" dstmac="7c:5a:1c:4c:da:0a" srcip="172.60.91.60" dstip="192.168.99.121" proto="17" length="168" tos="0x00" prec="0x00" ttl="63" srcport="47100" dstport="12017"
@timestamp: 2023-12-04 15:33:59.033
destination.ip: 192.168.99.121
destination.mac: 7c:5a:1c:4c:da:0a
destination.port: 12017
device.model.identifier: SG230
dns.answers.ttl 63
event.action: Packet dropped
event.created: 2023-12-04 15:33:59.033
event.dataset: sophos
event.id: 2001
event.ingested: 2023-12-04 15:39:10.039
event.original: <30>2023:12:04-15:33:59 hostname3 ulogd[1620]: id="2001" severity="info" sys="SecureNet" sub="packetfilter" name="Packet dropped" action="drop" fwrule="60002" initf="eth2.3009" outitf="eth6" srcmac="e0:63:da:73:bb:3e" dstmac="7c:5a:1c:4c:da:0a" srcip="172.60.91.60" dstip="192.168.99.121" proto="17" length="168" tos="0x00" prec="0x00" ttl="63" srcport="47100" dstport="12017"
host.hostname: hostname3
lmio.event.source.id: hostname3
lmio.parsing: parsec
lmio.source: mirage
log.syslog.facility.code: 3
log.syslog.facility.name: daemon
log.syslog.priority: 30
log.syslog.severity.code: 6
log.syslog.severity.name: information
message id="2001" severity="info" sys="SecureNet" sub="packetfilter" name="Packet dropped" action="drop" fwrule="60002" initf="eth2.3009" outitf="eth6" srcmac="e0:63:da:73:bb:3e" dstmac="7c:5a:1c:4c:da:0a" srcip="172.60.91.60" dstip="192.168.99.121" proto="17" length="168" tos="0x00" prec="0x00" ttl="63" srcport="47100" dstport="12017"
observer.egress.interface.name: eth6
observer.ingress.interface.name: eth2.3009
process.name: ulogd
process.pid: 1620
sophos.action: drop
sophos.fw.rule.id: 60002
sophos.prec: 0x00
sophos.protocol: 17
sophos.sub: packetfilter
sophos.sys: SecureNet
sophos.tos: 0x00
source.bytes: 168
source.ip: 172.60.91.60
source.mac: e0:63:da:73:bb:3e
source.port: 47100
tags: lmio-parsec:v23.47
tenant: default
_id: e1a92529bab1f20e43ac8d6caf90aff49c782b3d6585e6f63ea7c9346c85a6f7
_prev_id: 10cc320c9796d024e8a6c7e90fd3ccaf31c661cf893b6633cb2868774c743e69
_s: DKNA
Konfigurace LogMan.io Parsec
Závislosti
Závislosti LogMan.io Parsec:
- Apache Kafka: Zdroj vstupních neparsovaných událostí a cílové místo pro parsované události.
- Apache Zookeeper: Obsah knihovny, hlavně pravidla pro parsování, ale také jiné sdílené informace o clusteru.
Model
Chcete-li aplikaci spustit, zahrňte ji do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-parsec:
instances:
<instance-id>: # Replace with a unique identification of instance
node: <node> # Replace with name of the node
asab:
config:
eventlane:
name: /EventLanes/<tenant>/<event-lane>.yaml # Replace with path to the event lane
tenant:
name: <tenant> # Replace with name of your tenant
Tip
Instance LMIO Parsec jsou automaticky vytvářeny a spravovány LMIO Elmanem. V typické situaci není potřeba nastavovat vlastní konfiguraci.
Minimální konfigurace s jízdním pruhem událostí
LogMan.io Parsec lze nakonfigurovat jak s event lane, tak bez něj. Doporučujeme použít první možnost.
Když je použita událostní linka, LogMan.io Parsec z ní čte témata Kafka, cestu k pravidlům pro parsování a volitelně znakovou sadu, schéma a časové pásmo.
Toto je minimální konfigurace pro LogMan.io Parsec s událostním pásmem:
[tenant]
name=<tenant> # (1)
[eventlane]
name=/EventLanes/<tenant>/<eventlane>.yaml #(2)
[library]
providers=
zk:///library
...
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092 # (3)
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181 # (4)
- Jméno tenantu, pod kterým služba běží.
- Jméno event lane používaného pro témata Kafka, cesta pro pravidla parsování a volitelně znaková sada, schéma a časové pásmo.
- Adresy serverů Kafka v clusteru
- Adresy serverů Zookeeper v clusteru
Apache Zookeeper
Každá microservice LogMan.io by se měla zaregistrovat do Zookeeperu.
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Knihovna
Konfigurace knihovny určuje, odkud jsou načítány deklarace (definice) Parsec.
Knihovna může sestávat z jednoho nebo více poskytovatelů, typicky Zookeeperu nebo git repozitářů.
[library]
providers=
zk:///library
# other library layers can be included
Poznámka
Pořadí vrstev je důležité. Vrchní vrstvy přepisují vrstvy pod nimi. Pokud je jeden soubor přítomen ve více vrstvách, načte se pouze ten, který je zahrnut ve vrstvě nejvyšší.
Apache Kafka
Připojení k Apache Kafka musí být nakonfigurováno tak, aby bylo možné přijímat události z Apache Kafka a odesílat je do Apache Kafka:
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Bez této konfigurace nelze správně navázat spojení s Apache Kafka.
Minimální konfigurace bez jízdního pruhu pro události
Když není použita událostní linka, pravidla parsování, časové pásmo a schéma musí být zahrnuty v konfiguraci.
Toto je konfigurace vyžadovaná pro LogMan.io Parsec, když není použita událostní dráha:
[pipeline:ParsecPipeline:KafkaSource]
topic=received.<tenant>.<stream> # (1)
[pipeline:ParsecPipeline:KafkaSink]
topic=events.<tenant>.<stream> # (2)
[pipeline:ErrorPipeline:KafkaSink]
topic=others.<tenant> # (3)
[tenant]
name=<tenant> # (5)
schema=/Schemas/ECS.yaml # (6)
[parser]
name=/Parsers/<parsing rule> # (4)
[library]
providers=
zk:///library
...
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092 # (7)
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181 # (8)
- Název přijatého tématu, ze kterého se spotřebovávají události.
- Název událostního tématu, do kterého se zapisují úspěšně zpracované události.
- Název ostatního tématu, do kterého se zapisují neúspěšně zpracované události.
- Určete pravidlo parsování, které se má použít.
- Název nájemce, pod kterým tato instance Parsec běží.
- Schéma by mělo být uloženo ve složce
/Schemas/v Knihovně. - Adresy Kafka serverů v clusteru
- Adresy Zookeeper serverů v clusteru
Pravidlo analyzování
Každý parsec musí vědět, jaké pravidlo parsování použít.
[parser]
name=/Parsers/<parsing rule>
Název parseru určuje cestu, ze které jsou načítány deklarace pravidel parsování. MUSÍ být uložen v adresáři /Parsers/. Pravidla parsování jsou soubory YAML.
Standardní formát cesty je <vendor>/<type>, např. Microsoft/IIS nebo Oracle/Listener, ale pokud je použita pouze jedna technologie, může být použit jen název poskytovatele, např. Zabbix nebo Devolutions.
Konfigurace pruhu události
Tato sekce volitelně specifikuje významné atributy zpracovaných událostí.
[eventlane]
timezone=Europe/Prague
charset=iso8859_2
timezone: Pokud zdroj záznamů vytváří záznamy v konkrétním časovém pásmu, odlišném od výchozího časového pásma nájemce, musí být zde specifikováno.
Název časového pásma musí být v souladu s IANA Databází časových pásem. Interně jsou všechny časové značky převedeny na UTC.
charset: Pokud zdroj logů produkuje logy v znakové sadě (nebo kódování) odlišné od UTF-8, je třeba zde specifikovat znakovou sadu. Seznam podporovaných znakových sad je zde. Interně je každý text kódován v UTF-8.
Kafka témata
Specifikace tématu, ze kterého pocházejí původní protokoly, a témat, kam jsou zasílány úspěšně zpracované a neúspěšně zpracované protokoly.
Doporučený způsob výběru témat je vytvořit jedno téma 'received' a jedno téma 'events' pro každý běh událostí, jedno téma 'others' pro každého nájemce.
[pipeline:ParsecPipeline:KafkaSource]
topic=received.<tenant>.<stream>
[pipeline:ParsecPipeline:KafkaSink]
topic=events.<tenant>.<stream>
[pipeline:ErrorPipeline:KafkaSink]
topic=events.<tenant>
Varování
Název pipeline ParsecPipeline byl zaveden ve verzi Parsec v23.37. Název KafkaParserPipeline používaný v předchozích verzích je zastaralý. Konec životnosti je 30. ledna 2024.
Spotřebitelská skupina Kafky
LogMan.io Parsec často běží ve více instancích v clusteru. Sada instancí, které odebírají ze stejného přijatého tématu, se nazývá Spotřebitelská skupina. Tato skupina je identifikována jedinečným group.id. Každá událost je konzumována jedním a pouze jedním členem skupiny.
LogMan.io Parsec vytváří group.id automaticky následovně:
- Když je použita event lane,
group.idmá formátlmio-parsec-<tenant>-<eventlane>. - Když event lane není použita,
group.idmá formátlmio-parsec-<tenant>-<parser name>. group.idmůže být přepsáno v konfiguraciParsecPipelinenásledujícím způsobem:
[pipeline:ParsecPipeline:KafkaSource]
group_id=lmio-parsec-<stream>
Varování
Změnou group.id bude vytvořena nová skupina spotřebitelů a začne číst události od začátku. (To závisí na parametru auto.offset.reset klastru Kafka, který je ve výchozím nastavení earliest.)
Stream aktivit (inventura aktiv)
Každá instance Parsec může vysílat kompaktní události aktivit do Kafka topicu aktivit nájemce (events.<tenant>.activity ve výchozím nastavení) pro LogMan.io Assets. To se konfiguruje v Knihovně (/Schemas/Mappings/Asset_<schema>.yaml) a pro každou lane událostí pod parsec.asset (identita, activity.identity, záloha, heartbeat). Reportování aktivit je ve výchozím nastavení povoleno; pro jeho vypnutí nastavte na linii parsec.asset.heartbeat: off.
Viz Správa majetku a tok aktivit.
Metriky
Parsec vytváří vlastní telemetrii pro monitorování a také předává telemetrii od sběračů do nakonfigurovaného úložiště telemetrických dat, například InfluxDB. Přečtěte si více o metrikách.
Zahrnout do konfigurace:
[asab:metrics]
...
Správa aktiv a tok činností
Instance Parsceku, který analyzuje událostní linku, může vysílat kompaktní události aktivit do vyhrazeného tématu Kafka. Služba LogMan.io Assets (lmio-assets) toto téma odebírá a aktualizuje inventář aktiv (poslední záznam, identity, zdrojové jméno v štítcích). Také odebírá složitou linku nájemce, aby udržovala časově degradované rizikové skóre entity pro každého principála. Viz LogMan.io Assets a Rizikové skóre entity.
To je oddělené od hlavního tématu událostí: parsované logy stále putují do kafka.events.topic na lince. Reportování aktivit používá jiné téma, které je určeno z deklarace linky událostí tenantů activity (/EventLanes/<tenant>/activity.yaml, výchozí název tématu events.<tenant>.activity).
Jak to funguje v Parsec
Při spuštění Parsec načítá /Schemas/Mappings/Asset_<schema>.yaml (například Asset_ECS.yaml pro ECS) a mapuje názvy polí na dva procesory v lmioparsec/processors/asset/:
- AssetIdentityProcessor provádí kontrolu identity a volitelný záložní postup, poté vyplní
context["asset"]při každé zpracované události. - IndicatorOfActivityProcessor (IOA, indikátor aktivity) čte tento kontext a vysílá události aktivity do Kafka tématu aktivity.
Oba procesory jsou připojeny na konci ParsecPipeline, po parsování, obohacení a kontrole typu, a před tím, než je událost zakódována a zapsána do výstupu events.
Sdílený ActivityPipeline je vytvořen jednou pro každou aplikaci Parsec. Procesor IOA posílá události aktivit do svého interního zdroje; pipeline kóduje JSON a zapisuje do Kafka tématu aktivit.
Mapování aktiv (Asset_<schema>.yaml)
Knihovní soubor s define.type: asset/mapping (zastaralá cesta Assets_<schema>.yaml je stále načítána jako záložní).
Mapování má tři části:
- Normalizace identity (
identity+fallback): vyřeštehost.id/user.idz polí události pomocí vyhledávání; na analyzovanou událost se zapíše nejvýše jedno ID principála. - Identity pouze pro aktivitu (
activity.identity+ sdílenýfallback): další pole se hlásí do streamu aktivit, aniž by se změnila analyzovaná událost (viz Pole identity pouze pro aktivitu). - Payloady aktivit (
mapping): mapujte vyřešené identity na názvy polí u aktivit v Kafka událostech.
Vlastní pole identity pouze pro aktivitu patří do activity.identity (mapování knihovny nebo sled událostí). Vlastní názvy polí payload patří do sekce mapping nebo přepsání sledů událostí.
Normalizace identity
Každý vyhledávací název uvádí pole událostí, jejichž hodnoty se používají jako klíče pro vyhledávání. Parsec volá odpovídající vyhledávací tabulku a z výsledku čte host.id nebo user.id.
---
define:
type: asset/mapping
identity:
ips2hostid:
- host.ip
macs2hostid:
- host.mac
hostnames2hostid:
- host.hostname
usernames2userid:
- user.name
useremails2userid:
- user.email
fallback:
host.hostname: lowercase_and_domain_removal
user.name: lowercase_and_domain_removal
source.address: lowercase_and_domain_removal
activity:
identity:
hostnames2hostid:
- host.hostname
- source.address
mapping:
tags: tags
event_lane: observer.name
observer_type: observer.type
aux_hosts: related.hosts
aux_ips: related.ip
aux_macs: related.mac
aux_users: related.user
Soubor knihovny ECS /Schemas/Mappings/Asset_ECS.yaml obsahuje toto uspořádání. host.hostname se objevuje jak v identity, tak v activity.identity; Parsec ho zpracovává jednou na hlavní cestě a přeskočí duplicitní výskyt v activity.identity. source.address je jen pro aktivitu a při jeho vyřešení pomocí vyhledávání nebo náhradní hodnoty produkuje další host.id na tématu aktivity.
| Vyhledat jméno | Řeší | Typická pole událostí (ECS) |
|---|---|---|
ips2hostid |
host.id |
host.ip |
macs2hostid |
host.id |
host.mac |
hostnames2hostid |
host.id |
host.hostname |
usernames2userid |
user.id |
user.name |
useremails2userid |
user.id |
user.email |
Specifická pole pro událostní linku (například client.ip nebo dns.question.name) patří do konfigurace událostní linky, nikoli do globálního mapování.
Vyhledávací tabulky (hostnames2hostid, ips2hostid a další) jsou deklarovány v Knihovně pod /Lookups/. Podívejte se na Lookups pro obecné nastavení vyhledávání.
Záložní metody
Fallback se spouští pouze tehdy, když žádné pole pro vyhledání identity nevyřešilo host.id nebo user.id na události. Poté jsou vyzkoušeny nakonfigurované fallback metody na polích hostname / username (v pořadí polí).
| Metoda | Účinek |
|---|---|
lowercase_and_domain_removal |
Odstraňte předponu 'DOMAIN\' malými písmeny; u hostitelských jmen také přidejte doménu z 'ips2domain', pokud název nemá tečku |
Která pole dostanou záložní hodnotu: pouze pole uvedená pod fallback v mapování knihovny nebo event lane. Výchozí pokrytí mapování ECS zahrnuje host.hostname, user.name a source.address. Pole přidaná přes identity.<lookup>+ (například dns.question.name) běží pouze vyhledávání, dokud nepřidáte explicitní položku, například dns.question.name: lowercase_and_domain_removal.
Událostní sekce parsec.asset.fallback slučuje se s mapováním knihovny; nenahrazuje jej. Prazdné fallback: {} ponechává výchozí nastavení mapování beze změny.
Zakázání záložní možnosti pro pole, které již má výchozí mapování: nastavte false nebo null. Vyhledávání stále probíhá.
parsec:
asset:
fallback:
host.hostname: false
user.name: false
Neexistuje žádný globální přepínač pro okamžité vypnutí všech záloh.
Chcete-li přeskočit pouze hodnoty, které jsou samotnou IP adresou (a zachovat fallback pro skutečné doménová jména), použijte místo toho parsec.asset.skip.host.ip: true — viz Přeskočit IP adresy používané jako doménové názvy.
Mapování oblastí činnosti
Sekce mapping definuje názvy polí událostí používané v datech Kafka aktivit. Hlavní názvy polí (host.id, user.id, service.id) pocházejí ze schématu nájemce (define.principal_hostid, define.principal_userid, define.principal_serviceid; starší principal_host / principal_user / principal_service stále fungují).
| Klíč | Výchozí (ECS) | Role |
|---|---|---|
tags |
tags |
Technický seznam značek hlavních událostí |
event_lane |
observer.name |
Řetězec cesty zdrojové / událostní stopy |
observer_type |
observer.type |
Vždy nastavte na lmio-parsec při událostech aktivity |
aux_hosts |
related.hosts |
Identita hostitele, když host.id chybí |
aux_ips |
related.ip |
Seznam IP na událostech pomocného hostitele |
aux_macs |
related.mac |
Seznam MAC na událostech pomocného hostitele |
aux_users |
related.user |
Identita uživatele, když user.id chybí |
mapping:
tags: tags
event_lane: observer.name
observer_type: observer.type
aux_hosts: related.hosts
aux_ips: related.ip
aux_macs: related.mac
aux_users: related.user
Konfigurace jízdního pruhu události (parsec.asset)
Přepsání pro jednotlivé linky pro vyhledávání identity, záložní variantu a hlášení aktivit se nachází pod parsec.asset v YAML souboru linky událostí. Hodnoty se slučují s /Schemas/Mappings/Asset_<schema>.yaml (včetně výchozího activity.identity na ECS).
---
define:
type: lmio/event-lane
parsec:
name: /Parsers/MyVendor/MyProduct/
asset:
# Activity Kafka flush (default: enabled, 60s unless overridden).
heartbeat: 120s # or ``off`` / ``false``
# Drop host/user identities from the activity stream (case-insensitive).
skip:
host:
exact:
- localhost
prefixes:
- temp-
suffixes:
- .local
contains:
- -dhcp-
ip: true # host.hostname (or other host identity) is a bare IPv4/IPv6
user:
exact:
- SYSTEM
prefixes:
- "NT AUTHORITY\\"
suffixes:
- "$"
contains:
- svc_
ip: true
identity:
hostnames2hostid+: # append to mapping list
- dns.question.name
ips2hostid+: # append
- client.ip
- source.ip
hostnames2hostid: [] # overwrite mapping list (empty = none from lane)
fallback:
dns.question.name: lowercase_and_domain_removal
user.name: false
# Extra fields for the activity stream only (never written on the parsed event).
activity:
identity:
hostnames2hostid:
- source.address
usernames2userid:
- source.user.name
| Klíč | Výchozí | Účinek |
|---|---|---|
heartbeat |
povoleno, výchozí hodnota procesoru 60 s |
Minimální počet sekund mezi flushi v Kafce; off zakazuje IndicatorOfActivityProcessor |
skip.host / skip.user |
(žádný) | exact (full string; names alias), prefixes, suffixes, contains, and/or ip: true to drop from activity (principals and related host/user) and to skip default fallback into host.id / user.id; case-insensitive |
identity.<lookup> |
(žádný) | Nahraďte seznam polí mapování pro tento vyhledávací dotaz |
identity.<lookup>+ |
(žádný) | Přidejte pole do seznamu mapování |
fallback.<field> |
z mapování | Název záložní metody, nebo false / null pro deaktivaci pro tuto větev (použije se výchozí mapování, pokud je vynecháno) |
activity.identity.<lookup> |
(žádný) | Další pole událostí pro tok aktivit; pole již v identity (včetně výchozích mapování) jsou přeskočena |
activity.identity.<lookup>+ |
(žádný) | Přidat pole do seznamu pouze pro vyhledávání aktivit |
Komplementární filtr v Astatech
Událostní linka skip zastavuje identity před aktivitou Kafka topic. Chcete-li odstranit host/uživatelská jména v inventáři (včetně prefixů / sufixů / obsahuje / minimální počet pomlček / ip), použijte Knihovnu /Assets/Skip/ v nastavení Asetů.
Přeskočit IP adresy používané jako názvy hostitelů
Některé zdroje vloží samotnou IPv4 nebo IPv6 adresu do host.hostname (nebo jiného pole identity hostitele). Výchozí mapování ECS potom spustí záložní lowercase_and_domain_removal a tuto adresu zkopíruje do host.id.
Pro přeskočení pouze hostitelských identit ve tvaru IP a zachování záložní možnosti pro skutečné názvy hostitelů (FQDN, krátký název):
parsec:
asset:
skip:
host:
ip: true
Stejná vlajka existuje pro uživatele, když je user.name IP (skip.user.ip: true).
Efekt ip: true:
- fallback nekopíruje identitu do
host.id/user.id - Parsec nevysílá tuto identitu na Kafka téma aktivit
- vyhledávání názvů hostitele / uživatelských jmen stále probíhá (
hostnames2hostid,usernames2userid) - vyhledávání IP na speciálních polích IP (
host.ip→ips2hostid) zůstává beze změny
Chcete-li zakázat všechny záložní hostnames na lince (nejen IP adresy), nastavte místo toho fallback.host.hostname: false — viz Metody zálohování.
Pole identity pouze pro aktivitu
Použijte parsec.asset.activity.identity, když protokol obsahuje více než jednu identitu hostitele nebo uživatele a chcete, aby každá z nich byla zaznamenána v inventáři aktiv, ale na samotné parsované události má být pouze jedno hlavní ID.
Typický příklad: host.hostname je pozorovaný host (server1) a source.address je jiný související host (server2). Výchozí nastavení ECS v Asset_ECS.yaml již oba uvádějí pod activity.identity.hostnames2hostid; host.hostname je přeskočeno při průchodu pouze aktivitami, protože je v identity.
Přepisování událostních pruhů se slučuje s knihovním mapováním stejným způsobem jako identity:
parsec:
asset:
activity:
identity:
hostnames2hostid+:
- client.hostname
Parsec provádí stejná vyhledávání a záložní metody jako pro identity, ale:
- pole již uvedená v
identity(včetně výchozích hodnot zAsset_<schema>.yaml) jsou přeskočena vactivity.identity - vyřešené hodnoty specifické pro aktivitu nejsou zapisovány do
host.id/user.idv zpracované události - každá zbývající vyřešená hodnota generuje další hlavní událost aktivity (
host.id/user.idv payloadu aktivity Kafka) - duplicitní ID již vyslaná z hlavní cesty
identityjsou přeskočena jako druhé opatření
Pokud vyhledávání i náhradní možnost selžou, pole je hlášeno jako pomocná aktivita (related.hosts, related.user a tak dále) místo host.id.
Více hodnot host.id z jedné analyzované události
Když záznam obsahuje dvě identity hostitele (například host.hostname=server1 a source.address=server2), Parsec může vygenerovat dva hlavní události aktivity, zatímco analyzovaná událost si zachovává jedno host.id:
| Krok | Zpracovaná událost | Téma aktivity Kafka |
|---|---|---|
Hlavní identity na host.hostname |
může nastavit host.id (první úspěšný vyhledávací pokus/náhradní řešení) |
1× aktivita s tímto host.id |
activity.identity on source.address |
nezměněno | 1× další aktivita s host.id pro server2 |
Obě zprávy o aktivitě obsahují @timestamp, tenant, observer.name, observer.type a značky Parsec. Jsou deduplikovány samostatně v IOA bufferu (klíčováno podle host.id:<hodnota>) a v rámci okna heartbeat.
Viz také Event Lanes pro obecnou konfiguraci eventové dráhy (Kafka témata, cesta parseru, schéma a časové pásmo).
Pracovní pruh události
Udalosti aktivit ze všech instancí Parsec pro nájemce sdílejí jedno téma Kafka. Název tématu pochází z deklarace kanálu událostí aktivity nájemce, obvykle /EventLanes/<tenant>/activity.yaml:
---
define:
type: lmio/event-lane
kafka:
events:
topic: events.mytenant.activity
Parsec řeší tuto cestu při spuštění (get_activity_kafka_topic). Výchozí název tématu je events.<tenant>.activity. Tento kanál není stejný jako zdrojová témata events.<tenant>.<stream>: analyzované logy stále jdou do kanálu deklarovaného na každé instanci Parsec; aktivita je samostatný kompaktní proud konzumovaný LogMan.io Assets.
Podívejte se na Kafka topics pro řádek aktivit v tabulce výchozích témat.
Co je extrahováno z každé analyzované události
AssetIdentityProcessor provádí vyhledávání z sloučených seznamů identit, poté volitelný záložní postup, a vyplňuje context["asset"]:
- Když je
host.id/user.idznám z hlavní cestyidentity: hlavní řádekkind: idpro aktivitu (maximálně jedno ID zapsané v analyzované události). - Pole pod
activity.identitypřidávají další hlavní nebo pomocné řádky, aniž by měnily analyzovanou událost. - Když hlavní ID není známo: pouze pomocné řádky (
hostsskindhostname|ip|mac;usersskindname|email, žádný řádekkind: id).
IndicatorOfActivityProcessor čte pouze tento kontext (plus služební účet z události):
host_id/user_idpřítomen → hlavní aktivita (schéma hlavních polí v Kafka payload)- hostname
namebezhost_id→mapping.aux_hosts - sirotčí
ip/macbezhost_id→ kombinovaná událostmapping.aux_ips/mapping.aux_macs name/emailbezuser_id→mapping.aux_users
Existující host.id / user.id na zpracované události
Pokud parser nebo obohacovač již nastavili pole principal, AssetIdentityProcessor jej nepřepíše. Vyhledávání se stále provádí a výsledky jsou uloženy do context["asset"]. Fallback se spustí pouze tehdy, když žádné vyhledávání nevyřešilo principal id a pole bylo prázdné.
Pořadí vyhledávání hostitele: nejprve pole hostnames2hostid, potom ips2hostid, poté macs2hostid; pokud všechny vyhledávání selžou, použijí se pole uvedená v fallback. Identity odpovídající skip.host nejsou zálohováním kopírovány do host.id.
Uživatel vyhledává objednávku: pole usernames2userid, poté useremails2userid; poté se použijí záložní nakonfigurovaná pole uživatelského jména. Identity odpovídající skip.user nejsou do user.id zkopírovány záložní cestou.
Tip
Odstraňte schéma enrich u polí hostname / username při používání těchto procesorů (stejné vyhledávání jako u DefaultLookupEnricher, ale zde sjednocené).
Seskupování a odstraňování duplicit
Události aktivit se hromadí v paměti, přičemž klíčem je identita (hlavní, pomocný host, pomocný uživatel). Při Application.tick/60!, po nakonfigurovaném intervalu heartbeat, jsou čekající události serializovány, přiřazeno jim deterministické _id a zapsány do Kafka.
Příklady dat aktivit
Hlavní činnost
{
"host.id": "server01.example.com",
"@timestamp": 1710000000000,
"tenant": "mytenant",
"tags": ["lmio-parsec:1.2.3", "instance-abc"],
"observer.name": "/EventLanes/mytenant/fortinet.yaml",
"observer.type": "lmio-parsec",
"_id": 281474976710657
}
Druhý hlavní host z activity.identity
Stejná rozparsovaná událost jako výše, ale source.address vyřešil jiný hostitel (pole pouze pro aktivitu):
{
"host.id": "server02.example.com",
"@timestamp": 1710000000000,
"tenant": "mytenant",
"tags": ["lmio-parsec:1.2.3", "instance-abc"],
"observer.name": "/EventLanes/mytenant/fortinet.yaml",
"observer.type": "lmio-parsec",
"_id": 281474976710660
}
Pomocná uživatelská aktivita
{
"related.user": ["jdoe", "jdoe@example.com"],
"@timestamp": 1710000000000,
"tenant": "mytenant",
"observer.name": "/EventLanes/mytenant/ad.yaml",
"observer.type": "lmio-parsec",
"_id": 281474976710658
}
Aktivita pomocného hostitele (IP a MAC, bez názvu hostitele)
{
"related.ip": [{"h": 0, "l": 3232235777}],
"related.mac": [11259375],
"@timestamp": 1710000000000,
"tenant": "mytenant",
"observer.name": "/EventLanes/mytenant/dhcp.yaml",
"observer.type": "lmio-parsec",
"_id": 281474976710659
}
Pomocné hodnoty related.ip jsou v IndicatorOfActivityProcessor normalizovány na {h, l}. Hodnoty related.mac jsou celá čísla typu ui64.
Downstream: LogMan.io Assets
Aktivity zpráv Kafka jsou konzumovány LogMan.io Assets (lmio-assets), které provádějí upsert dokumentů Mongo s klíčem {tenant}:{kind}:{value} a aktualizují first_seen / last_seen.
Stejná služba se přihlašuje k nájemcovské komplexní událostní dráze (detekce korelátoru), aby spojila skóre rizika entity s exponenciálním poklesem. Toto chování je dokumentováno samostatně:
- LogMan.io Assets: přehled služby, pole aktiv, HTTP API
- Konfigurace aktiv: hostitelské a uživatelské filtry knihovny
/Assets/Skip/ - Skóre rizika entity: model rozpadu a rozlišení od skóre rizika
event.risk_scorepro každé zjištění
Ohodnocení rizika detekce v korelátoru je popsáno v Ohodnocení rizika.
Dráhy událostí
Relation to LogMan.io Parsec
TeskaLabs LogMan.io Parsec čte důležitou část své konfigurace z event lane. Tato konfigurace zahrnuje:
- Kafka témata, ze kterých jsou brány události a do kterých jsou odesílány rozparsované a chybové události
- pravidla parsování (deklarace)
- (volitelně) časové pásmo, znaková sada a schéma
group.idpro konzumaci z tématureceived
Proto každá instance LogMan.io Parsec běží přesně v jedné událostní lince (přesně pod jedním nájemcem).
Prohlášení
Toto je minimální požadované definice událostní dráhy, umístěná v adresáři /EventLanes/<tenant> v Knihovně:
---
define:
type: lmio/event-lane
parsec:
name: /Parsers/path/to/parser/ # (1)
kafka:
received:
topic: received.tenant.stream
events:
topic: events.tenant.stream
others:
topic: others.tenant
- Cesta pro pravidlo zpracování. Musí začínat
/Parsers. Standardní formát cesty je<vendor>/<type>, např.Microsoft/IISneboOracle/Listener, ale v případě, že je použita pouze jedna technologie, může být použito pouze jméno poskytovatele, např.ZabbixneboDevolutions.
Když je spuštěn Parsec a je načtena událostní stopa, jsou vytvořeny dva potrubí:
ParsecPipelinemezi tématy received a eventsErrorPipelinecílený na téma others
group.id používané pro konzumaci z received tématu má formu: lmio-parsec-<tenant>-<eventlane>
Časové pásmo, schéma, znaková sada
Časové pásmo, schéma a znaková sada jsou ve výchozím nastavení načteny z konfigurace nájemce, ale tyto vlastnosti lze přepsat v událostní lince:
---
define:
type: lmio/event-lane
schema: /Schemas/CEF.yaml
timezone: UTC
charset: utf-16
schema: Jaké schéma se používá pro parsování. Mapování a obohacovače jsou specifické pro schéma a schema musí být nastaveno v deklaraci. Pokud je použito jiné schéma, jsou tyto deklarace vynechány.
timezone: Pokud zdroj záznamů vytváří záznamy v konkrétním časovém pásmu, odlišném od výchozího časového pásma nájemce, musí být zde specifikováno.
Název časového pásma musí být v souladu s IANA Databází časových pásem. Interně jsou všechny časové značky převedeny na UTC.
charset: Pokud zdroj logů produkuje logy v znakové sadě (nebo kódování) odlišné od UTF-8, je třeba zde specifikovat znakovou sadu. Seznam podporovaných znakových sad je zde. Interně je každý text kódován v UTF-8.
Možnosti analýzy
Další možnosti parsování jsou uvedeny také v událostním pruhu.
parsec:
name: /Parsers/path/to/parser/
event:
extract:
ip_addresses: true # Regex extraction of IPv4 and IPv6 addresses
mac_addresses: true # Regex extraction of MAC addresses
drop:
empty: true # Empty events are not processed
Správa aktiv a tok činností
Parsec může hlásit aktivitu hostitele a uživatele do inventáře aktiv prostřednictvím vyhrazeného Kafka activity tématu (events.<tenant>.activity). Konfigurace zahrnuje:
/Schemas/Mappings/Asset_<schema>.yaml: výchozíidentity,activity.identity,fallbacka názvy polí aktivity (ECS zahrnujesource.addressjako pole hostname pouze pro aktivitu).parsec.assetna každé zdrojové událostní linii: přepisy podle linie, heartbeat, volitelnýskip(exact/prefixes/suffixes/contains/ippro hostitele a uživatele — také přeskočí výchozí fallback dohost.id/user.id), a další poleactivity.identity.
parsec:
asset:
heartbeat: 120s
skip:
host:
exact:
- localhost
prefixes:
- temp-
suffixes:
- .local
contains:
- -dhcp-
ip: true
user:
exact:
- SYSTEM
suffixes:
- "$"
contains:
- svc_
ip: true
identity:
ips2hostid+:
- client.ip
activity:
identity:
hostnames2hostid+:
- client.hostname
fallback:
user.name: false
Podívejte se na Správu aktiv a tok aktivit pro názvy při vyhledávání, více host.id z jedné události, metody zálohování, pravidla přeskočení aktivit (včetně skip.host.ip, když host.hostname je IP), linii událostí aktivit, dávkování a ukázkové payloady.
Výstup z analýzy
Když používáte LogMan.io Parsec k analýze logů, výsledkem tohoto procesu je to, co označujeme jako „parsovaná událost“. Tento výstup je zásadním aspektem správy logů, protože transformuje surová data z logů do strukturovaného formátu, který je snazší pochopit, analyzovat a jednat na jeho základě.
Parsovaná událost není jen jakákoli sbírka dat; je to pečlivě strukturovaný výstup, který prezentuje informace ve formátu plochého seznamu. To znamená, že každý kus informace z původního logu je extrahován a prezentován jako pár klíč-hodnota. Tyto páry jsou přímočaré, což usnadňuje identifikaci toho, co každá část dat představuje.
Pary klíč-hodnota
-
Klíč: Toto je jedinečný identifikátor, který popisuje typ informace obsažené v hodnotě. Klíče jsou předdefinované štítky, které představují konkrétní aspekty logových dat, jako jsou časová razítka, chybové kódy, uživatelská ID apod. Klíče jsou definovány ve schématu.
-
Hodnota: Toto jsou vlastní data nebo informace spojené s klíčem. Hodnoty se mohou velmi lišit, od číselných kódů a časových značek po textové popisy nebo uživatelské vstupy. Typ hodnoty je definován ve schématu.
Výstupní událost je typicky serializována jako JSON objekt.
Příklad parsované události
{
"@timestamp": 12345678901,
"event.created": 12345678902,
"event.ingested": 12345678903,
"event.original": "<1> 2023-03-01 myhost myapp: Hello world!",
"key1": "value1",
"key2": "value2",
}
Běžná pole parsovaných událostí
Warning
Tato kapitola používá ECS schéma!
Z parsec (implicitní):
@timestamp: Pokud není časová značka parsována, toto pole je automaticky vytvořeno s časem parsování.
Od kolektoru:
event.original: Původní událost ve svém surovém formátu.event.created: Čas, kdy byla událost zachycena LogMan.io Kolektorem.lmio.source: Název zdroje logu (vytvořeno LogMan.io Kolektorem).
Od příjemce:
event.ingested: Čas, kdy byla událost zpracována LogMan.io Příjemcem.tenant: Název rentiera LogMan.io, ve kterém Parsec zpracoval tuto událost, specifikované v konfiguraci._id: Jedinečný identifikátor události.
Štítky
Plán
Bude zde možnost přidávat libovolné štítky k události, což umožní vlastní filtrování.
V tuto chvíli je jediný štítek, který je automaticky přidán do pole tags, verze LogMan.io Parsec.
Chybové události
Když parsování selže nebo dojde k neočekávané chybě, událost je odeslána do jiné Event lane (ErrorPipeline),
kde je obohacena o informace o tom, kdy a proč se to stalo.
Každá chybová událost obsahuje:
@timestamp: Čas, kdy byla událost zpracována s chybou v UNIX časovém razítku (počet sekund od epochy).event.original: Původní událost ve svém surovém formátu.error.message: Chybová zpráva.error.stack_trace: Data o tom, kde v kódu došlo k výjimce.event.dataset: Název datasetu specifikovaného v mapování nebo cesta pro parser v Knihovně.event.created: Čas, kdy byla událost vytvořena LogMan.io Kolektorem.event.ingested: Čas, kdy byla událost zpracována LogMan.io Příjemcem.tenant: Název tenanta, kterému byla tato událost určena.
Parsing rules
Deklarace
Deklarace popisují, jak by měl být event parsován. Jsou uloženy jako soubory YAML v knihovně. LogMan.io Parsec interpretuje tyto deklarace a vytváří z nich parsovací procesory.
Existují tři typy deklarací:
- Deklarace parseru: Parser bere jako vstup původní event nebo konkrétní pole částečně parsovaného eventu, analyzuje jeho jednotlivé části a ukládá je jako páry klíč-hodnota do eventu.
- Deklarace mapování: Mapování bere jako vstup částečně parsovaný event, přejmenuje názvy polí a eventuálně převádí datové typy. Funguje spolu se schématem (ECS, CEF).
- Deklarace doplňovače: Doplňovač doplňuje částečně parsovaný event o další data.
Tok dat
Typická, doporučená sekvence parsování je řetězec deklarací:
- První hlavní deklarace parseru zahajuje řetězec a další parsery (nazývané sub-parsery) extrahují podrobnější data z polí vytvořených předchozím parserem.
- Poté (jediná) deklarace mapování přejmenuje klíče parsovaných polí podle schématu a filtruje pole, která nejsou potřeba.
- Nakonec deklarace doplňovače doplňuje event o další data. Ačkoli je možné použít více souborů doplňovače, doporučuje se použít pouze jeden.
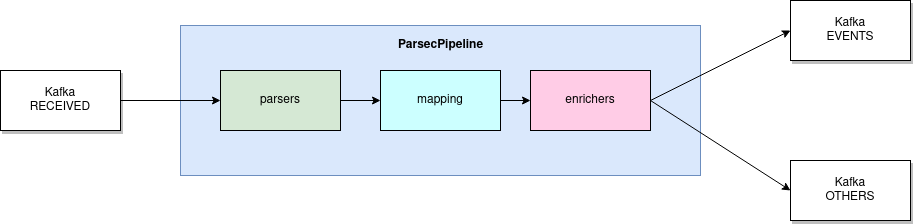
Důležité: Názvoslovné konvence
LogMan.io Parsec načítá deklarace v abecedním pořadí a vytváří odpovídající procesory ve stejném pořadí. Proto vytvářejte seznam souborů deklarací podle těchto pravidel:
-
Začněte všechny názvy souborů deklarací očíslovanou předponou:
10_parser.yaml,20_parser_message.yaml, ...,90_enricher.yaml.Doporučuje se "nechat si místo" v číslování pro budoucí deklarace pro případ, že budete chtít přidat novou deklaraci mezi dvě stávající (např.
25_new_parser.yaml). -
Do názvů souborů zahrňte typ deklarace:
20_parser_message.yamlspíše než10_message.yaml. - Do názvů souborů mapování zahrňte typ použitého schématu:
40_mapping_ECS.yamlspíše než40_mapping.yaml.
Příklad:
/Parsers/MůjParser/:
- 10_parser.yaml
- 20_parser_username.yaml
- 30_parser_message.yaml
- 40_mapping_ECS.yaml
- 50_enricher_lookup.yaml
- 60_enricher.yaml
Parsers
Parsery
Deklarace parseru bere jako vstup původní událost nebo konkrétní pole částečně zpracované události, analyzuje její jednotlivé části a ukládá je jako páry klíč-hodnota do události.
LogMan.io Parsec aktuálně podporuje tyto typy deklarací parserů:
Deklarace
Aby bylo možné určit typ deklarace, je nutné specifikovat sekci define.
define:
type: parsec/parser/<declaration_type>
Parser-combinátor (Parsec)
Technika parser-combinátoru se používá pro parsování událostí ve formátu prostého textu. Je založena na SP-Lang Parsec výrazech.
Pro parsování původních událostí použijte následující deklaraci:
define:
name: Můj Parser
type: parsec/parser
parse:
!PARSE.KVLIST
- ...
- ...
- ...
define:
name: Můj Parser
type: parsec/parser
field: <custom_field>
parse:
!PARSE.KVLIST
- ...
- ...
- ...
Když je field specifikováno, parsování se aplikuje na toto pole, jinak se aplikuje na původní událost. Proto musí být přítomno v každém sub-parseru.
Typy specifikace field:
-
field: <custom_field>- běžné pole předparsované předchozím parserem. -
field: json /key/foo- JSON klíč/key/fooz předparsovaného JSON objektujson. Název JSON objektu a JSON klíč musí být odděleny mezerou. JSON klíč vždy začíná s/, a každá další úroveň je oddělena/. -
JSON klíč se specifikovaným typem, ve výchozím nastavení předpokládáme typ
string.field: json: /key/foo type: int -
field: xml /key/foo/@attribute- XML klíč/key/foo/@attributez předparsovaného XML objektuxml. Název XML objektu a XML klíč musí být odděleny mezerou. XML klíč vždy začíná s/, a každá další úroveň je oddělena/. Atribut třídy je označen@.
JSON parser
JSON parser se používá k analýze událostí (nebo částí událostí) se strukturou JSON.
define:
name: JSON parser
type: parsec/parser/json
field: <custom_field>
target: <custom_target>
Když je field specifikován, analýza se aplikuje na toto pole; ve výchozím nastavení se aplikuje na původní událost.
Když je target specifikován, analyzovaný objekt je uložen do určeného cílového pole; ve výchozím nastavení je uložen s klíčem json. Cílové pole musí vyhovovat regulárnímu výrazu json[0-9a-zA-Z] (začínající "json" následované jakýmkoli alfanumerickým znakem).
Example
-
Následující původní událost se strukturou JSON je analyzována JSON parserem s výchozími nastaveními:
{ "key": { "foo": 1, "bar": 2 } }10_parser.yamldefine: name: JSON parser type: parsec/parser/jsonVýsledná událost bude:
{ "json": <JSON object>, } -
Následující událost obsahuje část JSON uvnitř, takže JSON parser může být aplikován na toto předanalyzované pole a výsledek bude uložen do vlastního pole
jsonMessage:<14>1 2023-05-03 15:06:12 {"key": {"foo": 1, "bar": 2}}20_parser_message.yamldefine: name: JSON parser type: parsec/parser/json field: message target: jsonMessageVýsledná událost bude:
```json { "log.syslog.priority": 14, "@timestamp": 140994182325993472, "message": "{"key": {"foo": 1, "bar": 2}}", "jsonMessage": <JSON object> } ```
XML parser
XML parser se používá k analýze událostí (nebo částí událostí) se strukturou XML.
define:
name: XML parser
type: parsec/parser/xml
field: <custom_field>
target: <custom_target>
Když je field specifikován, analýza se aplikuje na toto pole; ve výchozím nastavení se aplikuje na původní událost.
Když je target specifikován, analyzovaný objekt je uložen do určeného cílového pole; ve výchozím nastavení je uložen s klíčem xml. Cílové pole musí vyhovovat regulárnímu výrazu xml[0-9a-zA-Z] (začíná na "json" následované jakýmkoli alfanumerickým znakem).
Example
-
Následující původní událost se strukturou XML je analyzována XML parserem s výchozími nastaveními:
<?xml version="1.0" encoding="utf-8"?> <AuditMessage xmlns:xsd="http://www.w3.org/2001/XMLSchema" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"> <EventIdentification EventActionCode="E" EventDateTime="2025-01-01T10:00:00Z" EventOutcomeIndicator="0"> <EventID csd-code="110100" codeSystemName="DCM" originalText="Application Activity" /> <EventTypeCode csd-code="110120" codeSystemName="DCM" originalText="Application Start" /> </EventIdentification> </AuditMessage>10_parser.yamldefine: name: XML parser type: parsec/parser/xmlVýsledná událost bude:
{ "xml": <XML object>, }
Parser událostí Windows
Parser událostí Windows se používá k analýze událostí, které jsou generovány systémem Microsoft Windows ve formátu XML.
define:
name: Parser událostí Windows
type: parsec/parser/windows-event
Toto je kompletní parser událostí Windows, který analyzuje události z Microsoft Windows a odděluje pole do párů klíč-hodnota.
Stashing parser
Stashing parser spojuje logy, které jsou rozloženy přes více řádků.
Deklarace
Stashing procesor shromažďuje logy se stejným identifier v seřazeném seznamu délky total_parts, počínaje 0 až total_parts - 1, přičemž indexová pozice je získána z current_part. Když jsou všechny logy shromážděny, je vytvořena jediná událost s shromážděnou částí content.
---
define:
type: parsec/parser/stashing
stash:
identifier: <PROCESS_ID> # jaké pole se používá jako identifikátor
total_parts: <TOTAL_LOG_PARTS> # jaké pole se používá pro celkový počet očekávaných logů
current_part: <LOG_PART> # jaké pole se používá pro počítání aktuální části
content: <MESSAGE> # jaký obsah je uložen
# volitelné
max_age: 15m # po této době je neúplná událost odeslána ostatním
max_size: 50000 # když je číslo překročeno, neúplná událost je odeslána ostatním
Example
Vstupní logy:
-------timestamp------- identifier current_part/total_parts -----content-----
2025-09-01T12:00:00.000 1024 0/3 user: harry_potter,
2025-09-01T12:00:00.100 1024 1/3 ip: 120.10.20.30,
2025-09-01T12:00:00.200 1024 2/3 action: login
Výstup:
2025-09-01T12:00:00.000 1024 0/3 user: harry_potter, ip: 120.10.20.30, action: login
Mapování
Po získání všech deklarovaných polí z analyzátorů musí být pole obvykle přejmenována podle nějakého schématu (ECS, CEF) v procesu nazývaném mapování.
Proč je mapování nezbytné?
Pro uložení dat událostí v Elasticsearch je důležité, aby názvy polí v logech odpovídaly Elastic Common Schema (ECS), standardizované, otevřené kolekci názvů polí kompatibilních s Elasticsearch. Proces mapování přejmenuje pole z analyzovaných logů podle tohoto schématu. Mapování zajišťuje, že logy z různých zdrojů mají jednotné a konzistentní názvy polí, což umožňuje Elasticsearch je správně interpretovat.
Důležité
Ve výchozím nastavení pracuje mapování jako filtr. Ujistěte se, že do deklarace mapování zahrnete všechna pole, která chcete v analyzovaném výstupu. Jakékoliv pole, které není specifikováno v mapování, bude z události odstraněno.
Psaní deklarace mapování
Deklarace mapování napište v YAML. (Deklarace mapování nepoužívají výrazy SP-Lang.)
define:
type: parser/mapping
schema: /Schemas/ECS.yaml
mapping:
<original_key>: <new_key>
<original_key>: <new_key>
...
Specifikujte parser/mapping jako type v sekci define. V poli schema specifikujte cestu k souboru schématu, který používáte. Pokud používáte Elasticsearch, použijte Elastic Common Schema (ECS).
Standardní mapování
Pro přejmenování klíče a změnu datového typu hodnoty:
Warning
Nový datový typ musí odpovídat datovému typu specifikovanému ve schématu pro toto pole.
Specifikací type: auto bude datový typ automaticky určen ze schématu na základě názvu pole.
mapping:
<original_key>:
field: <new_key>
type: <new_type>
Dostupné datové typy najdete zde.
Pro přejmenování klíče a úpravu hodnoty:
mapping:
<original_key>:
field: <new_key>
apply: <new_type>
apply, musíte specifikovat typ analyzované hodnoty a název argumentu VALUE.
mapping:
<original_key>:
field: <new_key>
value_type: <type>
apply: <new_type>
Example
Upravení hodnoty řetězce na hodnotu IP pomocí výrazu PARSE.IP a přejmenování na nový klíč:
'json /client-ip':
field: client.ip
apply: !PARSE.IP
Upravení hodnoty řetězce na malá písmena a přejmenování na nový klíč:
Uveďte počáteční typ hodnoty a použijte jej jako argument VALUE ve funkci apply.
'json /client-hostname':
field: client.address
value_type: str
apply: !LOWER
what: !ARG VALUE
Pro přejmenování klíče bez změny datového typu hodnoty:
mapping:
<original_key>: <new_key>
Mapování z JSON
Pro přejmenování klíče uloženého v objektu JSON:
mapping:
<jsonObject> <jsonPointer>: <new_key>
/ a každá další úroveň je oddělena znakem /.
Pro přejmenování klíče uloženého v objektu JSON se specifickým párem klíč-hodnota:
mapping:
<jsonObject> <jsonPointer/[key:value]/jsonPointer>: <new_key>
Název objektu JSON a JSON ukazatel musí být odděleny mezerou. JSON ukazatel vždy začíná znakem / a každá další úroveň je oddělena znakem /.
Specifikovaný pár klíč-hodnota umožňuje vybrat požadovaný objekt JSON (viz příklad níže).
Pro přejmenování klíče uloženého v objektu JSON a změnu datového typu hodnoty:
mapping:
<jsonObject> <jsonPointer>:
field: <new_key>
type: <new_type>
Jak bylo uvedeno dříve, je možné změnit datový typ specifikací pole type.
Příklad
Příklad 1: Mapování z JSON
Pro účely příkladu si představme, že chceme analyzovat jednoduchou událost ve formátu JSON:
{
"act": "user login",
"ip": "178.2.1.20",
"usr": "harry_potter",
"id": "6514-abb6-a5f2"
}
a chtěli bychom, aby finální výstup vypadal takto:
{
"event.action": "user login",
"source.ip": "178.2.1.20",
"user.name": "harry_potter"
}
Všimněte si, že názvy klíčů v původní události se liší od názvů klíčů v požadovaném výstupu.
Pro počáteční deklaraci parseru v tomto případě můžeme použít jednoduchý JSON parser:
define:
type: parser/json
Tento parser vytvoří objekt JSON a uloží jej do pole json.
Pro změnu názvů jednotlivých polí vytvoříme tento soubor deklarace mapování, 20_mapping_ECS.yaml, ve kterém popíšeme, která pole mapovat a jak:
---
define:
type: parser/mapping # určete typ deklarace
schema: /Schemas/ECS.yaml # které schéma je použito
mapping:
json /act: 'event.action'
json /ip:
field: 'source.ip'
type: auto
json /usr: 'user.name'
Tato deklarace vytvoří požadovaný výstup. Datový typ pole source.ip bude automaticky určen na základě schématu a odpovídajícím způsobem změněn.
Příklad 2: Mapování z JSON se specifickým párem klíč-hodnota
Dalším příkladem je mapování pro složitou událost ve formátu JSON, která se skládá z objektu JSON se specifickým párem klíč-hodnota:
{
"CreationTime": "2022-01-19T11:07:41",
"ExtendedProperties": [
{
"Name": "ResultStatusDetail",
"Value": "Redirect"
},
{
"Name": "UserAgent",
"Value": "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) MicrosoftTeams-Preview/1.4.00.26453 Chrome/85.0.4183.121 Electron/10.4.7 Safari/537.36"
},
{
"Name": "RequestType",
"Value": "OAuth2:Authorize"
}
],
}
Abychom získali pole z objektu JSON, který obsahuje specifický pár klíč-hodnota, použijte následující syntaxi:
---
define:
type: parser/mapping # určete typ deklarace
schema: /Schemas/ECS.yaml # které schéma je použito
mapping:
json /ExtendedProperties/[Name:ResultStatusDetail]/Value: 'o365.audit.ExtendedProperties.ResultStatusDetail'
json /ExtendedProperties/[Name:UserAgent]/Value: 'o365.audit.ExtendedProperties.UserAgent'
json /ExtendedProperties/[Name:RequestType]/Value: 'o365.audit.ExtendedProperties.RequestType'
Obohacovače
Obohacovače doplňují analyzované události o extra data.
Obohacovač může:
- Vytvořit nové pole v události.
- Přetransformovat hodnoty pole nějakým způsobem (změna velikosti písmen, provedení výpočtu apod.).
- Smazat existující pole, pokud je splněna zadaná podmínka.
Obohacovače se nejčastěji používají k:
- Určení datasetu, kde budou logy uloženy v ElasticSearch (přidání pole
event.dataset). - Získání facility a severity z pole se syslog prioritou.
define:
type: parsec/enricher
enrich:
event.dataset: <dataset_name>
new.field: <expression>
...
delete:
existing.field: <expression>
- Obohacovače píšeme v YAML.
- Specifikuj
parsec/enricherv polidefine.
Note
Obě sekce enrich a delete jsou volitelné, ale musíte použít alespoň jednu z nich.
Příklad 1: Obohaťte událost o nová pole
Následující příklad je obohacovač používaný pro události ve formátu syslog. Předpokládejme, že máte parser pro události ve formě:
<14>1 2023-05-03 15:06:12 server pid: Username 'HarryPotter' logged in.
{
"log.syslog.priority": 14,
"user.name": "HarryPotter"
}
Chcete získat syslog severity a facility, které jsou vypočteny standardním způsobem:
(facility * 8) + severity = priority
Také byste chtěli snížit jméno HarryPotter na harrypotter, aby uživatelé byli jednotní napříč různými logovými zdroji.
Proto vytvoříte obohacovač:
define:
type: parsec/enricher
enrich:
event.dataset: 'dataset_name'
user.id: !LOWER { what: !GET {from: !ARG EVENT, what: user.name} }
# facility a severity jsou vypočteny ze 'syslog.pri' standardním způsobem
log.syslog.facility.code: !SHR
what: !GET { from: !ARG EVENT, what: log.syslog.priority }
by: 3
log.syslog.severity.code: !AND [ !GET {from: !ARG EVENT, what: log.syslog.priority}, 7 ]
Příklad 2: Smazat nevhodné pole z události
Následující obohacovač smaže pole host.name z události, pokud jeho hodnota obsahuje řetězec SRV:
define:
type: parsec/enricher
delete:
host.name: !IN
what: "SRV"
where: !GET {from: !ARG EVENT, what: host.name}
Datum/časová pole
Zpracování dat a časů (časových razítek) je klíčové při analýze událostí.
Aby byly události zobrazeny v aplikaci LogMan.io, musí události obsahovat pole @timestamp s odpovídajícím datem, časem a časovým pásmem.
Datumová a časová pole, v souladu s ECS:
| Pole | Význam |
|---|---|
@timestamp |
Čas, kdy původní událost nastala. Musí být zahrnuto v deklaracích. |
event.created |
Čas, kdy byla původní událost zaznamenána Kolektorem LogMan.io. |
event.ingested |
Čas, kdy byla původní událost přijata Přijímačem LogMan.io. |
Za normálních podmínek, pokud nedošlo k žádnému zásahu do dat, by hodnoty časových razítek měly být chronologické: @timestamp < event.created < event.ingested.
Užitečné odkazy a nástroje
- UNIX časový konvertor
- Formát datum/času jazyka SP-Lang: toto je výstupní formát všech rozparsovaných časových razítek produkovaných Parsecem.
LogMan.io Parsec Klíčové termíny
Důležité termíny relevantní pro LogMan.io Parsec.
Událost
Jednotka dat, která prochází procesem parsingu, je označována jako událost. Původní událost přichází do LogMan.io Parsec jako vstup a následně je parsnuta procesory. Pokud je parsing úspěšný, vyprodukuje parsovanou událost, a pokud parsing selže, vyprodukuje chybovou událost.
Původní událost
Původní událost je vstup, který LogMan.io Parsec přijímá - jinými slovy, neparnutý log. Může být reprezentován neopracovaným (případně kódovaným) řetězcem nebo strukturou ve formátu JSON nebo XML.
Parsovaná událost
Parsovaná událost je výstup z úspěšného parsingu, formátovaný jako neuspořádaný seznam párů klíč-hodnota serializovaný do struktury JSON. Parsovaná událost vždy obsahuje unikátní ID, původní událost a obvykle informaci o tom, kdy byla událost vytvořena zdrojem a přijata Apache Kafka.
Chybová událost
Chybová událost je výstup z neúspěšného parsingu, formátovaný jako neuspořádaný seznam párů klíč-hodnota serializovaný do struktury JSON. Je vytvořena, když parsing, mapování nebo obohacování selže, nebo když dojde k jiné výjimce v LogMan.io Parsec. Vždy obsahuje původní událost, informaci o tom, kdy byla událost neúspěšně parsnuta, a chybovou zprávu popisující důvod, proč proces parsingu selhal. Navzdory neúspěšnému parsingu bude chybová událost vždy ve formátu JSON, páry klíč-hodnota.
Knihovna
Vaše TeskaLabs LogMan.io Knihovna obsahuje všechny vaše deklarace (a mnoho dalších typů souborů). Své deklarace můžete upravovat ve vaší Knihovně prostřednictvím Zookeeper.
Deklarace
Deklarace popisují, jak bude událost transformována. Deklarace jsou soubory YAML, které LogMan.io Parsec umí interpretovat k vytvoření deklarativních procesorů. V LogMan.io Parsec existují tři typy deklarací: parsování, obohacování a mapování. Více viz Deklarace.
Parser
Parser je typ deklarace, který bere původní událost nebo specifické pole částečně parsované události jako vstup, analyzuje její jednotlivé části a poté je ukládá jako páry klíč-hodnota do události.
Mapování
Deklarace mapování je typ deklarace, který bere částečně parsovanou událost jako vstup, přejmenovává názvy polí a případně konvertuje datové typy. Pracuje spolu se schématem (ECS, CEF). Také funguje jako filtr, který vynechává data, která nejsou potřebná ve finální parsované události.
Obohacování
Obohacovač je typ deklarace, která doplňuje částečně parsovanou událost o dodatečná data.
Migrace na Parsec s event lanes
Pro migraci z LogMan.io Parser nebo LogMan.io Parsec verze menší než v24.14, která nepoužívá event lanes, použijte následující migrační příručku.
Předpoklady
- LogMan.io Depositor >
v24.11-beta - LogMan.io Baseliner >
v24.11-beta - LogMan.io Correlator >
v24.11-beta
Kroky migrace
-
Vytvořte nový event lane YAML soubor
/EventLanes/<tenant>/<eventlane>.yamlv Knihovně. -
Přidejte následující vlastnosti do eventlane:
/EventLanes/tenant/eventlane.yaml--- define: type: lmio/event-lane parsec: name: /Parsers/path/to/parser kafka: received: topic: received.<tenant>.<stream> events: topic: events.<tenant>.<stream> others: topic: others.<tenant> elasticsearch: events: index: lmio-<tenant>-events-<eventlane> others: index: lmio-<tenant>-others(Nahraďte
<tenant>,<stream>,<eventlane>a/path/to/parserspecifickými hodnotami.) -
Vytvořte konfiguraci pro LogMan.io Parsec:
lmio-parsec.conf[tenant] name=<tenant> [eventlane] name=/EventLanes/<tenant>/<eventlane>.yaml [library] providers= zk:///library ... [kafka] bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092 [zookeeper] servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181 -
Použijte buď starou Consumer group nebo vytvořte novou. Nejprve otevřete kafdrop, vyhledejte odpovídající
receivedtopic, podívejte se na Consumers a najděte Group ID staré LMIO Parser/LMIO Parsec. Rozhodněte se, zda budete používat starégroup.idnebo vytvoříte nové.Warning
Při vytvoření nového
group.idse vytvoří nová consumer group a začne číst události od začátku. (To závisí na parametruauto.offset.resetKafka clusteru, který je ve výchozím nastaveníearliest.)V případě, že chcete zachovat starý
group.id, přidejte do konfigurace následující sekci:lmio-parsec.conf[pipeline:ParsecPipeline:KafkaSource] group_id=<your group id>Jinak se
group.idautomaticky vytvoří na základě názvu event lane:lmio-parsec-<tenant>-<eventlane>. -
Spusťte službu. Ujistěte se, že běží, tak že se podíváte na její logy.
Neměly by se objevit žádné chybové logy. Pokud ano, podívejte se na troubleshooting. Měli byste také vidět upozorňující logy podobné těmto:
NOTICE lmioparsec.app Event Lane /EventLanes/default/linux-syslog-rfc3164-10001.yaml loaded successfully. NOTICE lmioparsec.app [sd timezone="Europe/Prague" charset="utf-8" schema="/Schemas/ECS.yaml" parser="/Parsers/Linux/Common"] Configuration loaded. NOTICE lmioparsec.declaration_loader [sd parsers="3" mappings="1" enrichers="1"] Declarations loaded. NOTICE lmioparsec.parser.pipeline [sd source_topic="received.default.linux-syslog-rfc3164-10001" events_topic="events.default.linux-syslog-rfc3164-10001" others_topic="others.default" group.id="custom-group-id"] ParsecPipeline is ready.Zde byste měli vidět správné Kafka topics,
group.id,charset,schemaatimezone. -
Ujistěte se, že služba spotřebovává zprávy z správného topicu se správným group id. Znovu otevřete kafdrop a najděte received topic. Zkontrolujte, zda byla vytvořena nová consumer group nebo zda Combined Lag staré skupiny začíná klesat.
-
Zkontrolujte, zda nové zprávy přicházejí do Kafky events topic.
events topic není vytvořen
Zkontrolujte others topic. Pokud tam přicházejí nové zprávy, pravidlo pro parsování není správné. Znovu zkontrolujte, zda používáte správný název parseru v event lane:
yaml "eventlane.yaml"
parsec:
name: /Parsers/path/to/parser
Pokud ano, pak jsou pravidla pro parsování nesprávná a měla by být změněna.
-
Zkontrolujte, zda LogMan.io Depositor běží. Otevřete events topic a zkontrolujte, zda z něj Depositor spotřebovává zprávy (v Combined Lag).
-
Zkontrolujte, zda jsou zprávy viditelné na obrazovce Průzkumník v uživatelském rozhraní LogMan.io.
Zprávy nejsou vůbec viditelné
Pokud nemůžete najít data na obrazovce Průzkumník, počkejte nějaký čas (cca 1-2 minuty), proces může nějakou dobu trvat. Potom zkontrolujte, zda existuje správný events topic a zda je event lane správně nakonfigurován. Pokud ano, zkontrolujte, zda zprávy nepřicházejí v nesprávném časovém pásmu nastavením časového rozsahu na (-1 den, +1 den).
Zprávy jsou viditelné ve špatném časovém pásmu
Pokud je časové pásmo nebo použitá schéma nesprávná, můžete ji přepsat v event lane:
```yaml title="/EventLanes/<tenant>/<eventlane>.yaml"
define:
type: lmio/event-lane
timezone: UTC
schema: /Schemas/ECS.yaml
```
Řešení problémů pro LogMan.io Parsec
Časová zóna
Kritické logy
CRITICAL lmio-parsec.app Chybí sekce 'zookeeper' v konfiguraci.
Přidejte sekci [zookeeper] do konfigurace:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
CRITICAL lmioparsec.app Chybí konfigurační možnost '[tenant] name'.
Přidejte jméno tenanta do konfigurace:
[tenant]
name=my-tenant
CRITICAL lmioparsec.app Konfigurační možnost '[eventlane] name' musí začínat '/EventLanes/'.
Upravte jméno event lane tak, aby začínalo /EventLanes:
[eventlane]
name=/EventLanes/<tenant>/<eventlane>.yaml
CRITICAL lmioparsec.app Konfigurační možnost '[parser] name' musí začínat '/Parsers/'.
Ujistěte se, že cesta pro parsing rules začíná /Parsers.
define:
type: lmio/event-lane
parsec:
name: /Parsers/path/to/parsers
CRITICAL lmioparsec.app Nelze najít soubor '/EventLanes/tenant/eventlane.yaml' v knihovně, ukončuji.
Ujistěte se, že soubor /EventLanes/tenant/eventlane.yaml existuje a je povolen pro daného tenanta.
CRITICAL lmioparsec.app Nelze přečíst deklaraci '/EventLanes/tenant/eventlane.yaml': <popis chyby>, ukončuji.
V souboru /EventLanes/tenant/eventlane.yaml je syntaktická chyba. Zkuste ji opravit inspirován popisem chyby.
Chybové logy
ERROR: lmioparsec.declaration_loader Nelze sestavit pipeline: žádné deklarace nenalezeny.
Ujistěte se, že máte v konfiguračním souboru event lane správně nastavenou cestu pro parsing rules.
Varovné logy
WARNING lmioparsec.declaration_loader Chybí sekce 'schema' v /Parsers/Linux/Common/50_enricher.yaml
Každé enricher rule, které stojí za mapping, by mělo obsahovat schema v sekci define:
define:
type: parser/enricher
schema: /Schemas/ECS.yaml
Parser
Cascade Parser
Příklad
---
define:
name: Syslog RFC5424
type: parser/cascade
field_alias: field_alias.default
encoding: utf-8 # none, ascii, utf-8 ... (výchozí: utf-8)
target: parsed # volitelné, specifikujte cíl parsované události (výchozí: parsed)
predicate:
!AND
- !CONTAINS
what: !EVENT
substring: 'ASA'
- !INCLUDE predicate_filter
parse:
!REGEX.PARSE
what: !EVENT
regex: '^(\w{1,3}\s+\d+\s\d+:\d+:\d+)\s(?:(\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3})|([^\s]+))\s%ASA-\d+-(.*)$'
items:
- rt:
!DATETIME.PARSE
value: !ARG
format: '%b %d %H:%M:%S'
flags: Y
- dvchost
Sekce define
Tato sekce obsahuje obecné definice a metadata.
Položka name
Kratší název této deklarace, srozumitelný pro člověka.
Položka type
Typ této deklarace musí být parser/cascade.
Položka field_alias
Název aliasu pole, který bude načten, aby mohly být v deklaraci použity alias názvy atributů události spolu s jejich kanonickými názvy.
Položka encoding
Kódování příchozí události.
Položka target (volitelné)
Výchozí cílový pipeline parsované události, pokud není specifikováno jinak v context.
Možnosti zahrnují: parsed, lookup, unparsed
Položka description (volitelné)
Delší, případně vícelinkový, srozumitelný popis deklarace.
Sekce predicate (volitelná)
Sekce predicate filtruje příchozí události pomocí výrazu.
Pokud výraz vrátí hodnotu True, událost vstoupí do sekce parse.
Pokud výraz vrátí hodnotu False, událost je přeskočena.
Jiné návratové hodnoty jsou nedefinované.
Tato sekce může být použita ke zrychlení parsování přeskočením řádků s evidentně nerelevantním obsahem.
Vložení vnořených predikátových filtrů
Predikátové filtry jsou výrazy umístěné ve vyhrazeném souboru, které mohou být zahrnuty v mnoha různých predikátech jako jejich části.
Pokud chcete zahrnout externí predikátový filtr, umístěný buď v adresáři include nebo filters
(tento je globální adresář umístěný v horní hierarchii knihovny LogMan.io),
použijte příkaz !INCLUDE:
!INCLUDE predicate_filter
kde predicate_filter je název souboru plus přípona .yaml.
Obsah souboru predicate_filter.yaml je výraz, který má být zahrnut, například:
---
!EQ
- !ITEM EVENT category
- "MyEventCategory"
Sekce parse
Tato sekce specifikuje vlastní parsovací mechanismus.
Očekává se, že vrátí slovník nebo None, což znamená, že parsování nebylo úspěšné.
Typické příkazy v sekci parse
Příkaz !FIRST umožňuje specifikovat seznam parsovacích deklarací, které budou vyhodnocovány v pořadí (shora dolů), první deklarace, která vrátí nenulovou hodnotu, zastaví iteraci a tato hodnota je vrácena.
Příkaz !REGEX.PARSE umožňuje transformovat řádek logu do struktury slovníku. Také umožňuje připojení podparátorů pro další dekompozici podřetězců.
Směrování výstupu
Aby bylo jasné, že parser nebude parsovat událost, kterou doposud obdržel,
je potřeba nastavit atribut target na unparsed v rámci context.
Poté mohou jiní parsery v pipeline obdržet a parsovat událost.
Stejně tak může být cíl nastaven na různé cílové skupiny,
jako například parsed.
Pro nastavení target v context, se používá !CONTEXT.SET:
- !CONTEXT.SET
what: <... výrok ...>
set:
target: unparsed
Příklad použití v parseru. Pokud žádný regulární výraz neodpovídá příchozí události,
událost je odeslána na cíl unparsed, takže ji mohou zpracovat jiní parsery v řadě.
!FIRST
- !REGEX.PARSE
what: !EVENT
regex: '^(one)\s(two)\s(three)$'
items:
- one
- two
- three
- !REGEX.PARSE
what: !EVENT
regex: '^(uno)\s(duo)\s(tres)$'
items:
- one
- two
- three
# Zde začíná zpracování částečně parsované události
- !CONTEXT.SET
set:
target: unparsed
- !DICT
set:
unparsed: !EVENT
Komplexní parser událostí
Komplexní parser událostí zpracovává příchozí komplexní události, jako jsou události hledání (např. vytvoření, aktualizace, smazání hledání) a přidává je do tématu lmio-output v rámci Kafka.
Odtud jsou rozparsované komplexní události také zaslány do tématu input instancemi LogMan.io Watcher, takže korelátory a dispečeři mohou na tyto události také reagovat.
Ukázková deklarace
Ukázková YAML deklarace pro události hledání v rámci Komplexního parseru událostí může vypadat následovně:
p00_json_preprocessor.yaml
---
define:
name: Preprocesor pro JSON s extrakcí tenant
type: parser/preprocessor
tenant: JSON.tenant
function: lmiopar.preprocessor.JSON
p01_lookup_event_parser.yaml
---
define:
name: Parser událostí hledání
type: parser/cascade
predicate:
!AND
- !ISNOT
- !ITEM CONTEXT JSON.lookup_id
- !!null
- !ISNOT
- !ITEM CONTEXT JSON.action
- !!null
parse:
!DICT
set:
"@timestamp": !ITEM CONTEXT "JSON.@timestamp"
end: !ITEM CONTEXT "JSON.@timestamp"
deviceVendor: TeskaLabs
deviceProduct: LogMan.io
dvc: 172.22.0.12
dvchost: lm1
deviceEventClassId: lookup:001
name: !ITEM CONTEXT JSON.action
fname: !ITEM CONTEXT JSON.lookup_id
fileType: lookup
categoryObject: /Host/Application
categoryBehavior: /Modify/Configuration
categoryOutcome: /Success
categoryDeviceGroup: /Application
type: Base
tenant: !ITEM CONTEXT JSON.tenant
customerName: !ITEM CONTEXT JSON.tenant
Deklarace by měly být vždy součástí LogMan.io knihovny.
Konfigurace Parseru LogMan.io
Nejprve je potřeba specifikovat, ze které knihovny se mají načítat deklarace, může to být buď ZooKeeper nebo Soubor.
Také každá běžící instance parseru musí vědět, které skupiny načíst z knihoven, viz níže:
# Deklarace
[declarations]
library=zk://zookeeper:12181/lmio/library.lib ./data/declarations
groups=cisco-asa@syslog
include_search_path=filters/parser;filters/parser/syslog
raw_event=event.original
count=count
tenant=tenant
timestamp=end
groups - názvy skupin, které budou použity z knihovny, oddělené mezerami; pokud skupina
je umístěna v podsložce, použijte jako oddělovač lomítko, např. parsers/cisco-asa@syslog
Pokud je knihovna prázdná nebo nejsou specifikovány skupiny,
všechny události, včetně jejich kontextových položek, budou uloženy
do Kafka tématu lmio-others a zpracovány Dispatcherem LogMan.io,
jako by nebyly parsovány.
include_search_path - specifikuje složky pro hledání YAML souborů, které budou později použity v příkazu !INCLUDE
(výraz jako !INCLUDE myFilterYAMLfromFiltersCommonSubfolder) v deklaracích, oddělené ;.
Pokud se po lomítku uvede hvězdička *, budou všechny podsložky rekurzivně zahrnuty.
!INCLUDE příkaz očekává název souboru bez cesty a bez přípony jako vstup.
Chování je podobné atributu -I při sestavování C/C++ kódu.
raw_event - název pole vstupní zprávy logu (aka raw)
tenant - název pole pro tenant/klienta
count - název pole pro počet událostí, výchozí hodnota je 1
timestamp - název pole atributu časového razítka
Dále je potřeba vědět, která Kafka témata použít pro vstup a výstup, pokud bylo parsování úspěšné nebo neúspěšné. Je také potřeba nakonfigurovat připojení ke Kafce, aby bylo jasné, ke kterým Kafka serverům se připojit.
# Kafka připojení
[connection:KafkaConnection]
bootstrap_servers=lm1:19092;lm2:29092;lm3:39092
[pipeline:ParsersPipeline:KafkaSource]
topic=collected
# group_id=lmioparser
# Kafka výstupy
[pipeline:EnrichersPipeline:KafkaSink]
topic=parsed
[pipeline:ParsersPipeline:KafkaSink]
topic=unparsed
Poslední povinná sekce specifikuje, které Kafka téma použít pro informace o změnách v lookupech (tj. referenčních seznamech) a který ElasticSearch instance je má načítat.
# Trvalé úložiště lookup
[asab:storage] # tato sekce je použita pro lookupy
type=elasticsearch
[elasticsearch]
url=http://elasticsearch:9200
# Update pipelines pro lookupy
[pipeline:LookupChangeStreamPipeline:KafkaSource]
topic=lookups
[pipeline:LookupModificationPipeline:KafkaSink]
topic=lookups
Instalace
Docker Compose
lmio-parser:
image: docker.teskalabs.com/lmio/lmio-parser
volumes:
- ./lmio-parser:/data
Konfigurace nového LogMan.io Parser instance
Pro vytvoření nové parser instance pro nový zdroj dat (soubory, online pomoc, SysLog atd.) je potřeba provést následující tři kroky:
- Vytvoření nového Kafka topicu pro nahrání sesbíraných dat
- Konfigurace příslušných LogMan.io Parser instancí v site-repository
- Nasazení
Vytvoření nového Kafka topicu pro nahrání sesbíraných dat
Nejprve je potřeba vytvořit nový topic pro sesbírané události.
Topic sesbíraných událostí jsou specifické pro každý typ zdroje dat a tenant (zákazníka). Standard pro pojmenování takovýchto Kafka topic je následující:
collected-<tenant>-<type>
kde tenant je název tenant v malých písmenách a type je typ zdroje dat. Příklady zahrnují:
collected-railway-syslog
collected-ministry-files
collected-johnandson-databases
collected-marksandmax-lookups
Topic pro sesbíraná data pro všechny tenanty může mít následující formát:
collected-default-lookups
Pro vytvoření nového Kafka topic:
1.) Vstupte do libovolného Kafka kontejneru přes docker exec -it o2czsec-central_kafka_1 bash
2.) Použijte následující příkaz pro vytvoření topicu pomocí /usr/bin/kafka-topics:
/usr/bin/kafka-topics --zookeeper lm1:12181,lm2:22181,lm3:32181 --create --topic collected-company-type -partitions 6 --replication-factor 1
Počet partition závisí na očekávaném množství dat a počtu instancí LogMan.io Parser. Vzhledem k tomu, že ve většině nasazení jsou tři běžící servery v clusteru, doporučuje se použít alespoň tři partition.
Konfigurace příslušných LogMan.io Parser instancí v site-repository
Vstupte do site repository s konfiguracemi pro LogMan.io cluster. Pro více informací o site repository se podívejte na sekci Naming Standards v části Reference.
Poté v každé složce serveru (jako je lm1, lm2, lm3) vytvořte následující záznam v souboru docker-compose.yml:
<tenant>-<type>-lmio-parser:
restart: on-failure:3
image: docker.teskalabs.com/lmio/lmio-parser
network_mode: host
depends_on:
- kafka
- elasticsearch-master
volumes:
- ./<tenant>-<type>/lmio-parser:/data
- ../lookups:/lookups
- /data/hdd/log/<tenant>-<type>/lmio-parser:/log
- /var/run/docker.sock:/var/run/docker.sock
nahraďte <tenant> názvem tenantu/zákazníka (například railway) a <type> typem dat (například online pomoc), příklady zahrnují:
railway-lookups-lmio-parser
default-lookups-lmio-parser
hbbank-syslog-lmio-parser
Když je záznam pro Docker Compose zahrnut v souboru docker-compose.yml, postupujte podle těchto kroků:
1.) V každé složce serveru (lm1, lm2, lm3) vytvořte složku <tenant>-<type>
2.) Ve složkách <tenant>-<type> vytvořte složku lmio-parser
3.) V vytvořených složkách lmio-parser vytvořte soubor lmio-parser.conf
4.) Upravte lmio-parser.conf a zadejte následující konfiguraci:
[asab:docker]
name_prefix=<server_name>-
socket=/var/run/docker.sock
# Deklarace
[declarations]
library=zk://lm1:12181,lm2:22181,lm3:32181/lmio/library.lib ./data/declarations
groups=<group>
raw_event=raw_event
count=count
tenant=tenant
timestamp=@timestamp
# API
[asab:web]
listen=0.0.0.0 0
[lmioparser:web]
listen=0.0.0.0 0
# Logování
[logging:file]
path=/log/log.log
backup_count=3
rotate_every=1d
# Připojení k Kafka
[connection:KafkaConnection]
bootstrap_servers=lm1:19092,lm2:29092,lm3:39092
[pipeline:ParsersPipeline:KafkaSource]
topic=collected-<tenant>-<type>
group_id=lmio_parser_<tenant>_<type>
# Kafka sinks
[pipeline:EnrichersPipeline:KafkaSink]
topic=lmio-events
[pipeline:ParsersPipeline:KafkaSink]
topic=lmio-others
[pipeline:ErrorPipeline:KafkaSink]
topic=lmio-others
[asab:zookeeper]
servers=lm1:12181,lm2:22181,lm3:32181
path=/lmio/library.lib
[zookeeper]
urls=lm1:12181,lm2:22181,lm3:32181
servers=lm1:12181,lm2:22181,lm3:32181
path=/lmio/library.lib
# Perzistentní úložiště lookups
[asab:storage] # tato sekce je používána lookups
type=elasticsearch
[elasticsearch]
url=http://<server_name>:9200/
username=<secret_username>
password=<secret_password>
# Aktualizace lookups pipelines
[pipeline:LookupChangeStreamPipeline:KafkaSource]
topic=lmio-lookups
group_id=lmio_parser_<tenant>_<type>_<server_name>
[pipeline:LookupModificationPipeline:KafkaSink]
topic=lmio-lookups
# Metriky
[asab:metrics]
target=influxdb
[asab:metrics:influxdb]
url=http://lm4:8086/
db=db0
username=<secret_username>
password=<secret_password>
kde nahraďte každé z použití:
<group> skupinou deklarací parseru načtenou v ZooKeeper; pro více informací se podívejte na sekci Library v části Reference této dokumentace
<server_name> s názvem kořenové složky serveru, jako je lm1, lm2, lm3
<tenant> s názvem vašeho tenantu, jako je hbbank, default, railway atd.
<type> s typem vašeho zdroje dat, jako je online pomoc, syslog, soubory, databáze atd.
<secret_username> a <secret_password> s technickými údaji účtu ElasticSearch a InfluxDB,
které lze vidět v jiných konfiguracích ve site repository
Pro více informací o tom, co každá sekce konfigurace znamená, prosím podívejte se na sekci Configuration v postranním menu.
Nasazení
Pro nasazení nového parseru, prosím:
1.) Jděte na každý z LogMan.io serverů (lm1, lm2, lm3)
2.) Proveďte git pull ve složce site repository, která by měla být umístěna ve /opt adresáři
3.) Spusťte příkaz docker-compose up -d <tenant>-<type>-lmio-parser pro spuštění instance LogMan.io Parser
4.) Nasadit a nakonfigurovat SyslogNG, LogMan.io Ingestor atd. pro odeslání sesbíraných dat do Kafka topicu collected-<tenant>-<type>
4.) Zkontrolujte logy ve složce /data/hdd/log/<tenant>-<type>/lmio-parser pro jakékoliv chyby k opravě
(nahraďte <tenant> a <type> odpovídajícím způsobem)
Poznámky
Pro vytvoření datového streamu pro online pomoc, prosím použijte lookups jako typ a podívejte se na sekci Lookups v postranním menu
pro správné vytvoření skupiny deklarací pro parsing.
DNS Enricher
DNS Enricher obohacuje události o informace získané z DNS serverů, jako jsou názvy hostitelů.
Příklad
Deklarace
---
define:
name: DNSEnricher
type: enricher/dns
dns_server: 8.8.8.8,5.5.4.8 # volitelné
attributes:
device.ip:
hostname: host.hostname
source.ip:
hostname:
- host.hostname
- source.hostname
Vstup
{
"source.ip": "142.251.37.110",
}
Výstup
{
"source.ip": "142.251.37.110",
"host.hostname": "prg03s13-in-f14.1e100.net",
"source.hostname": "prg03s13-in-f14.1e100.net"
}
Sekce define
Tato sekce definuje název a typ obohacovače,
což je v případě DNS Enricher vždy enricher/dns.
Položka name
Kratší, lidsky čitelný název této deklarace.
Položka type
Typ této deklarace, musí být enricher/dns.
Položka dns_server
Seznam DNS serverů, ze kterých se budou získávat informace, oddělený čárkou ,.
Sekce attributes
Specifikujte slovník s atributy pro načtení IP adresy nebo jiných informací z DNS.
Každý atribut by měl být následován dalším slovníkem se seznamem klíčů pro extrakci z DNS serveru.
Hodnota každého klíče je buď řetězec s názvem atributu události, do kterého má být hodnota uložena, nebo seznam, pokud má být hodnota vložena do více než jednoho atributu události.
Vyhledávání aliasů polí & Obohacovač
Vyhledávání
Vyhledávání aliasů polí obsahuje informace o kanonických názvech atributů událostí, spolu s jejich možnými aliasy (např. krátkými názvy atd.).
ID vyhledávání aliasů polí musí obsahovat následující podřetězec: field_alias
Záznam vyhledávání má následující strukturu:
key: canonical_name
value: {
"aliases": [
alias1, # např. krátký název
alias2, # např. dlouhý název
...
]
}
Aliasy polí mohou být specifikovány v sekci definic parserů, standardních obohacovačů a korelátorů,
takže aliasové názvy použité v deklarativním souboru (např. !ITEM EVENT alias)
jsou přeloženy na kanonické názvy při přístupu k existujícímu prvku
(tj. !ITEM EVENT alias nebo !ITEM EVENT canonical_name).
Také by mělo být vyhledávání použito v obohacovači aliasů polí k transformaci všech aliasů na kanonické názvy po úspěšném parsování v LogMan.io Parseru.
Obohacovač
Obohacovač aliasů polí obohacuje událost kanonickými názvy existujících atributů, které jsou pojmenovány jedním ze specifikovaných aliasů, zatímco maže aliasové atributy v události.
Deklarace
---
define:
name: FieldAliasEnricher
type: enricher/fieldalias
lookup: field_alias.default
Sekce define
Tato sekce definuje název a typ obohacovače,
který v případě Obohacovače aliasů polí je vždy enricher/fieldalias.
Položka name
Kratší lidsky čitelný název této deklarace.
Položka type
Typ této deklarace, musí být enricher/fieldalias.
IP2Location Enricher (NEAKTUÁLNÍ)
Tento obohacovač je zastaralý, prosím používejte místo něj IPEnricher.
IP2Location obohacuje událost o specifikované atributy lokace na základě hodnot IPV4 nebo IPV6.
Příklad
Deklarace
---
define:
name: IP2Location
type: enricher/ip2location
zones:
- myLocalZone
- ip2location
- ...
attributes:
ip_addr1:
country_short: firstCountry
city: firstCity
L: firstL
ip_addr2:
country_short: secondCountry
city: secondCity
L: secondL
...
Vstup
Feb 5 10:50:01 0:0:0:0:0:ffff:1f1f:e001 %ASA-1-105043 test
Výstup
{
'rt': 1580899801.0,
'msg': 'test',
'ip_addr1': '0:0:0:0:0:ffff:1f1f:e001',
'firstCountry': 'CZ',
'firstCity': 'Brno',
'firstL': {
'lat': 49.195220947265625,
'lon': 16.607959747314453
}
}
Sekce define
Tato sekce definuje název a typ obohacovače,
což v případě IP2Location je vždy enricher/ip2location.
Položka name
Kratší, lidsky čitelný název této deklarace.
Položka type
Typ této deklarace, musí být enricher/ip2location.
Hodnota enricher/geoip je zastaralý ekvivalent.
Sekce zones
Specifikujte seznam zón (databázových souborů nebo streamů), které budou použity obohacovačem. První zóna, která úspěšně provede vyhledávání, je použita, takže je uspořádejte podle priority.
Sekce attributes
Specifikujte slovník s atributy události IPV6, na které bude vyhledávání provedeno, jako například dvchost.
Uvnitř slovníku uveďte pole/atributy z vyhledávání, které mají být načteny
a atributový název v události po načtení. Například:
ip_addr1:
country_short: firstCountry
city: firstCity
L: firstL
provede vyhledávání IP do GEO pro IP uloženou v event["ip_addr1"],
načte country_short, city, L z vyhledávání (pokud jsou přítomny) a mapuje je na
event["firstCountry"], event["firstCity"], event["firstL"]
Vyhledávací atributy
Následující vyhledávací atributy, pokud jsou přítomny ve vyhledávací zóně, mohou být použity pro další mapování:
country_short: string
country_long: string
region: string
city: string
isp: string
L: dictionary (includes: lat: float, lon: float)
domain: string
zipcode: string
timezone: string
netspeed: string
idd_code: string
area_code: string
weather_code: string
weather_name: string
mcc: string
mnc: string
mobile_brand: string
elevation: float
usage_type: string
Vysokovýkonné Parsování
Vysokovýkonné parsování je parsování, které je přímo zkompilováno do strojového kódu, čímž se zajišťuje co nejvyšší rychlost parsování příchozích událostí.
Všechny vestavěné předzpracovatele, stejně jako deklarativní výrazy !PARSE a !DATETIME.PARSE, nabízejí vysokovýkonné parsování.
Procedurální parsování
Aby mohl být strojový/instrukční kód kompilován pomocí LLVM a C, všechny výrazy musí poskytovat definici procedurálního parsování, což znamená, že každý znak(y) v parsovacím vstupním řetězci musí mít definovanou délku výstupu a typ výstupu.
Zatímco u předzpracovatelů je tento postup transparentní a uživateli se nezobrazuje,
u výrazů !PARSE a !DATETIME.PARSE musí být přesný postup s typy a formátem definován v atributu format:
!DATETIME.PARSE
what: "2021-06-11 17"
format:
- year: {type: ui64, format: d4}
- '-'
- month: {type: ui64, format: d2}
- '-'
- day: {type: ui64, format: d2}
- ' '
- hour: {type: ui64, format: d2}
První položka v atributu format odpovídá prvním znakům v příchozí zprávě,
zde year se tvoří z prvních čtyř znaků a je převeden na celé číslo (2021).
Pokud je specifikován pouze jeden znak, je přeskočen a není uložen ve výstupní parsované struktuře.
Vysokovýkonné Výrazy
!DATETIME.PARSE
!DATETIME.PARSE implicitně vytváří datetime z parsované struktury,
která má následující atributy:
-
year -
month -
day -
hour(volitelně) -
minute(volitelně) -
second(volitelně) -
microsecond(volitelně)
Formát - dlouhá verze
Atributy musí být specifikovány v inletu format:
!DATETIME.PARSE
what: "2021-06-11 1712X000014"
format:
- year: {type: ui64, format: d4}
- '-'
- month: {type: ui64, format: d2}
- '-'
- day: {type: ui64, format: d2}
- ' '
- hour: {type: ui64, format: d2}
- minute: {type: ui64, format: d2}
- 'X'
- microsecond: {type: ui64, format: dc6}
Formát - krátká verze
Atribut format může využívat zkrácenou notaci se zástupnými znaky %Y, %m, %d, %H, %M, %S a %u (mikrosekundy),
které představují nezáporná čísla podle formátu v uvedeném příkladu:
!DATETIME.PARSE
what: "2021-06-16T11:17Z"
format: "%Y-%m-%dT%H:%MZ"
Výraz format může být zjednodušen, pokud je formát datetime standardizovaný, jako je RFC3339 nebo iso8601:
!DATETIME.PARSE
what: "2021-06-16T11:17Z"
format: iso8601
Pokud se časové pásmo liší od UTC, musí být také explicitně specifikováno:
!DATETIME.PARSE
what: "2021-06-16T11:17Z"
format: iso8601
timezone: Europe/Prague
Dostupné typy
Celé číslo
-
{type: ui64, format: d2}- přesně 2 znaky na nezáporné celé číslo -
{type: ui64, format: d4}- přesně 4 znaky na nezáporné celé číslo -
{type: ui64, format: dc6}- 1 až 6 znaků na nezáporné celé číslo
IP Enricher
IP Enricher rozšiřuje události o geografické a další údaje spojené s danou IPv6 nebo IPv4 adresou. Tento modul nahrazuje IP2Location Enricher a GeoIP Enricher, které jsou nyní zastaralé.
Deklarace
Sekce define
Tato sekce definuje název a typ obohacovače.
Položka name
Krátký, dobře čitelný název této deklarace.
Položka type
Existují čtyři typy IP Enricher, které se liší verzí IP (IPv4 nebo IPv6) a reprezentací IP adresy (číslo nebo řetězec). Použití číslovaného vstupu je rychlejší a preferovaná možnost.
enricher/ipv6zpracovává IPv6 adresy v 128bitové dekadické číselné formě (například 281473902969579).enricher/ipv4zpracovává IPv4 adresy v 32bitové dekadické číselné formě (například 3221226219).enricher/ipv6strzpracovává IPv6 adresy v hexadecimální řetězcové formě oddělené dvojtečkami (například 2001:db8:0:0:1:0:0:1) jak je definováno v RFC 5952. Může také převádět a zpracovávat řetězcové adresy IPv4 (jakoenricher/ipv4str).enricher/ipv4strzpracovává IPv4 adresy v čtyřdílném dekadickém řetězci (například 192.168.16.0) jak je definováno v RFC 4001.
Položka base_path
Specifikuje základní URL cestu, která obsahuje soubory zón pro vyhledávání.
Může ukazovat na:
* lokální souborový systém, např. /path/to/files/
* umístění v zookeeper, např. zk://zookeeper-server:2181/path/to/files/
* umístění HTTP, např. http://localhost:3000/path/to/files/
Sekce tenants
IP Enricher může být nastaven pro multitenantní konfigurace. Tato sekce seznamuje tenanty, které by měly být zohledněny obohacovačem při vytváření specificních vyhledávání podle tenantů. Události označené tenantem, který není uveden v této sekci, budou obohaceny pouze globálními obohaceními (viz níže).
Sekce zones
Specifikuje seznam vyhledávacích zón, které mají být použity obohacovačem, plus informaci, zda jsou globální nebo specifické pro tenant.
Globální vyhledávání může obohatit jakoukoliv událost, bez ohledu na jejího tenanta. Specifické pro tenant mohou obohatit pouze události s odpovídajícím kontextem tenanta.
Vyhledávací zóny by měly být seřazeny podle priority, od nejvyšší k nejnižší, protože vyhledávání probíhá přes zóny sekvenčně a končí, jakmile je nalezena první shoda.
zones:
- tenant: lookup-zone-1.pkl.gz
- tenant: lookup-zone-2.pkl.gz
- global: lookup-zone-glob.pkl.gz
Názvy zón musí odpovídat odpovídajícím názvům souborů včetně přípony.
Soubory pro globální vyhledávání musí být přímo v adresáři base_path.
Soubory specifické pro tenant musí být uspořádány pod base_path do složek
podle jejich tenanta. Například, předpokládejme, že jsme deklarovali
first_tenant a second_tenant, deklarace zón výše očekává
následující strukturu souborů:
/base_path/
- first_tenant/
- lookup-zone-1.pkl.gz
- lookup-zone-2.pkl.gz
- second_tenant/
- lookup-zone-1.pkl.gz
- lookup-zone-2.pkl.gz
- lookup-zone-glob.pkl.gz
Příchozí událost, jejíž kontext je second_tenant, se první pokusí o shodu
ve vyhledávání second_tenant/lookup-zone-1.pkl.gz, pak ve
second_tenant/lookup-zone-2.pkl.gz a nakonec ve lookup-zone-glob.pkl.gz.
Sekce attributes
Tato sekce specifikuje, které atributy události obsahují IP adresu a které atributy budou přidány do události, pokud bude nalezena shoda. Má následující strukturu slovníku:
ip_address:
lookup_attribute_name: event_attribute_name
IP adresa je extrahována z atributu události ip_address.
Pokud odpovídá nějaké vyhledávací zóně, hodnota lookup_attribute_name je uložena
do atributu události event_attribute_name. Například:
source_ip:
country_code: source_country
Tím se událost zkouší porovnat na základě jejího atributu source_ip a
uložit odpovídající hodnotu country_code do pole události nazvaného source_country.
Obohacení názvu zóny
Může být užitečné zaznamenat název vyhledávací zóny, ve které došlo ke shodě.
Pro přidání názvu zóny do události použijte zone jako název atribu pro vyhledávání, např.:
source_ip:
zone: source_zone_name
Tím se přidá název odpovídajícího vyhledávání do pole události source_zone_name.
Mějte na paměti, že pokud ve vyhledávání existuje pole nazvané "zone", jeho hodnota bude použita místo jména vyhledávání.
Název vyhledávání je nastaven při vytváření souboru vyhledávací zóny.
Výchozí hodnota je název zdrojového souboru, ale může být nakonfigurována na jinou hodnotu.
Viz příkaz lmiocmd ipzone from-csv v LogMan.io Commander pro podrobnosti.
Příklad použití
Deklarační soubor
---
define:
name: IPEnricher
type: enricher/ipv6
tenants:
- some-tenant
- another-tenant
zones:
- tenant: lookup-zone-1.pkl
- global: ip2location.pkl.gz
attributes:
ip_addr1:
country_code: sourceCountry
city_name: sourceCity
L: sourceLocation
ip_addr2:
country_code: destinationCountry
city_name: destinationCity
L: destinationL
...
Zde obohacovač čte IP adresu z atributu události ip_addr1.
Pak se pokusí najít adresu ve svých vyhledávacích objektech: nejdříve ve
lookup-zone-1.pkl, poté v ip2location.pkl.gz.
Pokud najde shodu, získá vyhledávací hodnoty country_code,
city_name a L a uloží je do příslušných polí události
sourceCountry, sourceCity a sourceLocation.
Analogicky postupuje pro druhou adresu ip_addr2.
Výsledek lze vidět níže.
Vstup
Feb 5 10:50:01 0:0:0:0:0:ffff:1f1f:e001 %ASA-1-105043 test
Řádek výše může být parsován do následujícího slovníku.
{
'rt': 1580899801.0,
'msg': 'test',
'ip_addr1': '0:0:0:0:0:ffff:1f1f:e001'
}
To je předáno IP Enricheru, které jsme deklarovali výše.
Výstup
{
'rt': 1580899801.0,
'msg': 'test',
'ip_addr1': '0:0:0:0:0:ffff:1f1f:e001',
'sourceCountry': 'CZ',
'sourceCity': 'Brno',
'sourceLocation': (49.195220947265625, 16.607959747314453)
}
Soubor pro vyhledávání IP zón
Soubor pro vyhledávání IP je pickleovaný Python slovník.
Může být jednoduše vytvořen ze souboru CSV pomocí příkazu lmiocmd ipzone from-csv
naleznutelného v LogMan.io Commander.
CSV musí obsahovat řádek s hlavičkami s názvy sloupců.
Musí obsahovat sloupce ip_from a ip_to, a alespoň jeden další
sloupec s požadovanými hodnotami pro vyhledávání.
Například:
ip_from,ip_to,zone_info,latitude,longitude
127.61.100.0,127.61.111.255,my secret base,48.224673,-75.711505
127.61.112.0,127.61.112.255,my submarine,22.917923,267.490378
POZNÁMKA Zóny definované v jednom souboru pro vyhledávání nesmí překrývat.
POZNÁMKA IP zóny v souboru CSV jsou považovány za uzavřené intervaly, tj. obě pole ip_from a ip_to jsou
zahrnuta v zóně, kterou vymezují.
IP2Location
Tímto příkazem lze také vytvořit soubor pro vyhledávání z IP2Location™ CSV databází. Všimněte si, že tyto soubory neobsahují názvy sloupců, takže řádek s hlavičkami musí být do souboru CSV přidán ručně před vytvořením vyhledávacího souboru.
IP Resolve Enricher & Expression
IP Resolve obohacuje událost o kanonický název hostitele a/nebo IP na základě buď IP adresy A síťového prostoru, nebo jakéhokoli názvu hostitele A sítě připojené k IP adrese v lookupu.
Lookup ID pro IP Resolve musí obsahovat následující podřetězec: ip_resolve
Záznam lookupu má následující strukturu:
key: [IP, network]
value: {
"hostnames": [
canonical_hostname,
hostname2,
hostname3
...
]
}
Příklad
Deklarace #1 - Enricher
---
define:
name: IPResolve
type: enricher/ipresolve
lookup: lmio_ip_resolve # nepovinné
source:
- ip_addr_and_network_try1
- ip_addr_and_network_try2
- hostname_and_network_try3
- [!IP.PARSE ip4, !ITEM EVENT network4]
...
ip: ip_addr_try1
hostname: host_name
Deklarace #2 - Expression
!IP.RESOLVE
source:
- ip_addr_and_network_try1
- ip_addr_and_network_try2
- hostname_and_network_try3
- [!IP.PARSE ip4, !ITEM EVENT network4]
...
ip: ip_addr_try1
hostname: host_name
with: !EVENT
lookup: lmio_ip_resolve # nepovinné
Vstup
Feb 5 10:50:01 0:0:0:0:0:ffff:1f1f:e001 %ASA-1-105043 test
Výstup
{
'rt': 1580899801.0,
'msg': 'test',
'ip_addr_try1': 281471203926017,
'host_name': 'my_hostname'
}
Sekce define
Tato sekce definuje název a typ enrichta, což je v případě IP Resolve vždy enricher/ipresolve.
Prvek name
Kratší název této deklarace, který je snadno čitelný pro lidi.
Prvek type
Typ této deklarace, musí být enricher/ipresolve.
Sekce source
Specifikuje seznam atributů pro lookup. Každý atribut by měl být ve formátu:
[IP, network]
[hostname, network]
Pokud není síť specifikována, bude použita global.
První úspěšný lookup vrátí výstupní hodnoty (ip, hostname).
Sekce ip
Specifikuje atribut, kam se uloží lookuped IP adresa.
Sekce hostname
Specifikuje atribut, kam se uloží lookuped kanonický název hostitele.
Kanonický název hostitele je první v hostnames hodnoty lookupu.
Načítání lookupu ze souboru
Data lookupu pro IP Resolve mohou být načtena ze souboru pomocí Kolektoru LogMan.io
input:FileBlock.
Data budou dostupná v Parseru LogMan.io, kde by měla být
poslána na cíl lookup. Lookup se tedy nedostane do tématu input,
ale do tématu lookups, odkud bude zpracován
Watcherem LogMan.io pro aktualizaci dat v ElasticSearch.
Watcher LogMan.io očekává následující formát události:
{
'action': 'full',
'data': {
'items': [{
'_id': [!IP.PARSE 'MyIP', 'MyNetwork'],
'hostnames': ['canonical_hostname', 'short_hostname', 'another_short_hostname']
}
]
},
'lookup_id': 'customer_ip_resolve'
}
kde action rovno full značí, že existující obsah lookupu by měl být
nahrazen items v data.
Pro vytvoření této struktury použijte následující deklarativní příklad Cascade Parseru:
---
define:
name: Demo of IPResolve parser
type: parser/cascade
target: lookup
parse:
!DICT
set:
action: full
lookup_id:
!JOIN
items:
- !ITEM CONTEXT filename
- ip_resolve
delimiter: '_'
data:
!DICT
set:
items:
!FOR
each:
!REGEX.SPLIT
what: !EVENT
regex: '\n'
do:
!FIRST
- !CONTEXT.SET
set:
_temp:
!REGEX.SPLIT
what: !ARG
regex: ';'
- !DICT
set:
_id:
- !IP.PARSE
value: !ITEM CONTEXT _temp.0
- MyNetworkOrSpace
hostnames:
!LIST
append:
- !ITEM CONTEXT _temp.1
- !ITEM CONTEXT _temp.2
Parsování lookups
Když je lookup přijat z LogMan.io Kolektor logů přes LogMan.io Ingestor, může se jednat buď o celý obsah lookupu (full frame), nebo jen jeden záznam (delta frame).
Předzpracování
Na základě formátu vstupního lookup souboru by měl být použit předzpracovatel, aby se zjednodušily následující deklarace a optimalizovala rychlost načítání lookupu. Obvykle bude použit buď JSON, XML nebo CSV předzpracovatel:
---
define:
name: Předzpracovatel pro CSV
type: parser/preprocessor
function: lmiopar.preprocessor.CSV
Tímto způsobem je obsah analyzovaného souboru uložen v CONTEXT, odkud k němu lze přistupovat.
Full frame
Aby bylo možné uložit celý lookup do ElasticSearch prostřednictvím LogMan.io Watcher
a informovat jiné instance LogMan.io Parser a LogMan.io Correlator o změně
v celém lookup, měla by být použita deklarace Cascade Parser s konfigurací target: lookup.
Takový lookup nevstoupí do tématu input,
ale do tématu lookups, odkud bude zpracován
LogMan.io Watcher, aby aktualizoval data v ElasticSearch.
LogMan.io Watcher očekává následující formát události:
{
'action': 'full',
'data': {
'items': [{
'_id': 'myId',
...
}
]
},
'lookup_id': 'myLookup'
}
kde hodnota action rovna full znamená, že existující obsah lookupu by měl být
nahrazen položkami v data.
K vytvoření této struktury použijte následující deklarativní příklad Cascade Parseru.
Ukázková deklarace
---
define:
name: Ukázka parseru načítání lookupu
type: parser/cascade
target: lookup
parse:
!DICT
set:
action: full
lookup_id: myLookup
data:
!DICT
set:
items:
!FOR
each: !ITEM CONTEXT CSV
do:
!DICT
set:
_id: !ITEM ARG myId
...
Když obsah lookup vstoupí do LogMan.io Parser, parsované lookup je posíláno do LogMan.io Watcher, aby bylo uloženo v ElasticSearch.
Delta frame
Aby bylo možné aktualizovat JEDNU položku v existujícím lookupu v ElasticSearch prostřednictvím LogMan.io Watcher
a informovat jiné instance LogMan.io Parser a LogMan.io Correlator o změně
v lookup, měla by být použita deklarace Cascade Parser s konfigurací target: lookup.
Taková položka lookupu nevstoupí do tématu input,
ale do tématu lookups, odkud bude zpracována
LogMan.io Watcher, aby aktualizovala data v ElasticSearch.
LogMan.io Watcher očekává následující formát události:
{
'action': 'update_item',
'data': {
'_id': 'existingOrNewItemId',
...
},
'lookup_id': 'myLookup'
}
kde hodnota action rovna update_item znamená, že obsah existující položky lookupu by měl být
nahrazen položkami v data, nebo by měla být vytvořena nová položka lookupu.
K vytvoření této struktury použijte následující deklarativní příklad Cascade Parseru.
Ukázková deklarace
---
define:
name: Ukázka parseru načítání položek lookupu
type: parser/cascade
target: lookup
parse:
!DICT
set:
action: update_item
lookup_id: myLookup
data:
!DICT
set:
_id: !ITEM CONTEXT CSV.0.myID
...
Když obsah lookup vstoupí do LogMan.io Parser, parsované lookup je posíláno do LogMan.io Watcher, aby bylo uloženo v ElasticSearch.
MAC Vendor Enricher
MAC Vendor obohacuje události o specifické atributy dodavatele na základě jejich hodnoty MAC adresy (pro detekci dodavatele se zohledňuje pouze prvních 6 znaků).
Příklad
Deklarace
---
define:
name: MACVendor
type: enricher/macvendor
lookup: lmio_mac_vendor # volitelné
attributes:
MAC1: detectedVendor1
MAC2: detectedVendor2
...
Vstup
Feb 5 10:50:01 0:0:0:0:0:ffff:1f1f:e001 %ASA-1-105043 5885E9001183
Výstup
{
'rt': 1580899801.0,
'MAC1': '5885E9001183',
'detectedVendor1': 'Realme Chongqing Mobile Telecommunications Corp Ltd',
}
Sekce define
Tato sekce definuje název a typ obohacovače,
který je v případě Mac Vendor vždy enricher/macvendor.
Položka name
Kratší, lidsky čitelný název této deklarace.
Položka type
Typ této deklarace, musí být enricher/macvendor.
Sekce attributes
Specifikujte slovník s MAC atributy eventu, ve kterých se vyhledává, jako například MAC1.
Uvnitř slovníku zmíněte název atributu v události, kam bude uložen detekovaný dodavatel.
Například:
MAC1:
detectedVendor1
prohledá MAC Vendor lookup pro MAC uložený v event["MAC1"],
nahraje dodavatele do event["detectedVendor1"], pokud je úspěšně nalezen.
Lookup soubory
Lookup soubory pro MAC Vendor obohacovač jsou založeny na standardu OUI: standards-oui.ieee.org/oui.txt
Soubory jsou uloženy v výchozím adresáři (/lookups/macvendor),
který může být přepsán v konfiguraci:
[lookup:lmio_mac_vendor]
path=...
lmio_mac_vendor je poskytované ID lookupu v definici obohacovače, které se výchozí nastavuje na lmio_mac_vendor.
Parser Builder
Builder je nástroj pro snadné vytváření deklarací parseru/enricheru.
Pro spuštění builderu spusťte:
python3 builder.py -w :8081 ./example/asa-parser
Argument cesty specifikuje složku (nebo složky) se deklaracemi parserů a enrichers (tedy YAML soubory). Doporučuje se směřovat do YAML knihovny.
YAML soubory jsou načteny v pořadí, které je specifikováno příkazovou řádkou, a poté se seřadí podle abecedního pořadí soubory *.yaml, které jsou nalezeny v příslušném adresáři.
Argument -I umožňuje specifikovat složky, které budou použity jako základ pro direktivu !INCLUDE. Povoleno je více záznamů.
Argument -w určuje HTTP port.
Preprocessor
---
title: Parser preprocessor
---
# Parser preprocessor
*Parser preprocessor* umožňuje předzpracovat vstupní událost pomocí imperativního kódu, např. v Pythonu, Cythonu, C atd.
## Příklad

---
title: Parser preprocessor
---
# Parser preprocessor
*Parser preprocessor* umožňuje předzpracovat vstupní událost pomocí imperativního kódu, např. v Pythonu, Cythonu, C atd.
## Příklad
define: name: Demo vestavěného Syslog předzpracování type: parser/preprocessor tenant: Syslog_RFC5424.STRUCTURED_DATA.soc@0.tenant # (volitelné) count: CEF.cnt # (volitelné)
function: lmiopar.preprocessor.Syslog_RFC5424
`tenant` specifikuje atribut tenant, který bude přečten a předán do `context['tenant']`
pro další distribuci zpracovaných i nezpracovaných událostí do specifických
ukazatelů/úložišť v LogMan.io Dispatcher
`count` specifikuje atribut count
s počtem událostí, které mají být přečteny a předány do `context['count']`
## Vestavěné preprocessory
Modul `lmiopar.preprocessor` obsahuje následující běžně používané preprocessory.
Tyto preprocessory jsou optimalizovány pro nasazení s vysokým výkonem.
### Syslog RFC5425 vestavěný preprocessor
`function: lmiopar.preprocessor.Syslog_RFC5424`
Toto je preprocessor pro protokol Syslog (nový) podle [RFC5425](https://tools.ietf.org/html/rfc5424).
Vstup pro tento preprocessor je platný Syslog záznam, např.:
Výstupem je, část zprávy v logu v události a parsované prvky v `context.syslog_rfc5424`.
context: Syslog_RFC5424: PRI: 165 FACILITY: 20 PRIORITY: 5 VERSION: 1 TIMESTAMP: 2003-10-11T22:14:15.003Z HOSTNAME: mymachine.example.com APP_NAME: evntslog PROCID: 10 MSGID: ID47 STRUCTURED_DATA: exampleSDID@32473: iut: 3 eventSource: Application eventID: 1011 ...
### Syslog RFC3164 vestavěný preprocessor
`function: lmiopar.preprocessor.Syslog_RFC3164`
Toto je preprocessor pro protokol _BSD syslog_ (starší) podle [RFC3164](https://tools.ietf.org/html/rfc3164).
Syslog RFC3164 preprocessor lze nakonfigurovat v sekci `define`:
`year` specifikuje číselné označení roku, které bude aplikováno na časovou značku logů.
Také můžete specifikovat `smart` (výchozí) pro pokročilý výběr roku založený na měsíci.
`timezone` specifikuje časové pásmo logů, výchozí je `UTC`.
Vstup pro tento preprocessor je platný Syslog záznam, např.:
Výstupem je, část zprávy v logu v události a parsované prvky v `context.syslog_rfc3164`.
context: Syslog_RFC3164: PRI: 34 PRIORITY: 2 FACILITY: 4 TIMESTAMP: '2003-10-11T22:14:15.003Z' HOSTNAME: mymachine TAG: su PID: 10
`TAG` a `PID` jsou volitelné parametry.
### CEF vestavěný preprocessor
`function: lmiopar.preprocessor.CEF`
Toto je preprocessor pro _CEF_ nebo Common Event Format.
`year` specifikuje číselné označení roku, které bude aplikováno na časovou značku logů.
Také můžete specifikovat `smart` (výchozí) pro pokročilý výběr roku založený na měsíci.
`timezone` specifikuje časové pásmo logů, výchozí je `UTC`.
Vstup pro tento preprocessor je platný CEF záznam, např.:
Výstupem je, část zprávy v logu v události a parsované prvky v `context.CEF`:
eventId: '1234'
app: ssh
categorySignificance: /Informational/Warning
categoryBehavior: /Authentication/Verify
CEF může také obsahovat hlavičku Syslog.
To je podporováno řetězením relevantního preprocessoru Syslog s preprocesorem CEF.
Prosím, odkažte se na kapitolu o řetězení preprocessorů pro detaily.
### Vestavěné preprocessory formátů logů Apache HTTP serveru
Existují vysoce výkonné preprocessory pro běžné přístupy logů Apache HTTP serveru.
`function: lmiopar.preprocessor.Apache_Common_Log_Format`
Toto je preprocessor pro _Apache Common Log Format_.
`function: lmiopar.preprocessor.Apache_Combined_Log_Format`
Toto je preprocessor pro _Apache Combined Log Format_.
#### Příklad Apache Common Log
Vstup:
Výstup:
#### Příklad Apache Combined Log
Vstup:
Výstup:
### Microsoft ULS vestavěný preprocessor
`function: lmiopar.preprocessor.Microsoft_ULS`
Toto je preprocessor pro Microsoft_ULS podle [Microsoft Docs](https://docs.microsoft.com/cs-cz/archive/blogs/sharepoint_scott/ulsviewer-filters-performance-filters).
Pro Microsoft SharePoint ULS logy, které neobsahují názvy serverů ani korelaci polí,
je poskytnut vyhrazený preprocessor:
`function: lmiopar.preprocessor.Microsoft_ULS_Sharepoint`
Preprocessor Microsoft SharePoint ULS lze nakonfigurovat v sekci define:
`year` specifikuje číselné označení roku, které bude aplikováno na časovou značku logů.
Také můžete specifikovat `smart` (výchozí) pro pokročilý výběr roku založený na měsíci.
`timezone` specifikuje časové pásmo logů, výchozí je `UTC`.
Vstup pro tento preprocessor je platný záznam Microsoft ULS Sharepoint, např.:
Výstupem je, část zprávy v logu v události a parsované prvky v `context.Microsoft_ULS`.
context: Microsoft_ULS: TIMESTAMP: 1619613117.69 PROCESS: mssdmn.exe (0x38E0) THREAD: 0x4D10 PRODUCT: SharePoint Server Search CATEGORY: Connectors:SharePoint EVENTID: dvt6 LEVEL: High
### Query String preprocessor
`function: lmiopar.preprocessor.Query_String`
Toto je preprocessor pro Query String (key=value&key=value...) jako je meta informace z LogMan.io Collector
Příklad vstupu:
Výstupem je, část zprávy v logu v události a parsované prvky v `context.QUERY_STRING`.
context: QUERY_STRING: file_name: log.log search: true
### JSON vestavěný preprocessor
`function: lmiopar.preprocessor.JSON`
Toto je preprocessor pro formát JSON.
Očekává vstup ve formátu binárním nebo textovém, výstupní slovník je umístěn v události.
Vstupem pro tento preprocessor je tedy platný JSON záznam.
### XML vestavěný preprocessor
`function: lmiopar.preprocessor.XML`
Toto je preprocessor pro formát XML.
Očekává vstup ve formátu binárním nebo textovém, výstupní slovník je umístěn v události.
Vstupem pro tento preprocessor je tedy platný XML záznam, např.:
Výstup preprocessoru v `event`:
### CSV vestavěný preprocessor
`function: lmiopar.preprocessor.CSV`
Toto je preprocessor pro formát CSV.
Očekává vstup ve formátu binárním nebo textovém, výstupní slovník je umístěn v události.
Vstupem pro tento preprocessor je tedy platný CSV záznam, např.:
Výstup preprocessoru v `context["CSV"]`:
#### Parametry
V sekci `define` CSV preprocessoru, mohou být nastaveny následující parametry pro čtení CSV:
## Vlastní preprocessory
Vlastní preprocessory mohou být vyvolány z parseru, příslušný kód musí být přístupný mikroservisu parseru přes běžný způsob importu v Pythonu.
define: name: Demo vlastního Python preprocessoru type: parser/preprocessor
function: mypreprocessors.preprocessor
`mypreprocessors` je modul odpovídající složce s `__init__.py`, která obsahuje funkci `preprocessor()`.
Parser specifikuje `function` ke spuštění.
Používá notaci Pythonu a automaticky importuje modul.
Signatura funkce:
Preprocessor může (1) modifikovat událost (`!EVENT`) a/nebo (2) modifikovat kontext (`!CONTEXT`).
Výstup funkce `preprocessor` bude předán do následných parserů.
Preprocessor parser nevytváří zpracované události přímo.
Pokud funkce vrátí None, zpracování události je potichu ukončeno.
Pokud funkce vyvolá výjimku, výjimka bude zaznamenána a událost bude přeposlána do výstupu `unparsed`.
## Řetězení preprocessorů
Preprocessory mohou být řetězeny za účelem parsování složitějších vstupních formátů.
Výstup (neboli událost) z prvního preprocessoru je předán jako vstup druhému preprocessoru (a tak dále).
Například vstup je ve formátu CEF s hlavičkou Syslog RFC3164:
Standardní Obohacovač
Standardní Obohacovač obohacuje parsovanou událost o další pole. Obohacení probíhá po úspěšném přiřazení a parsování původního vstupu jedním z kaskádových parserů v rámci skupiny parsování.
Příklad
---
define:
name: Příklad standardního obohacovače
type: enricher/standard
field_alias: field_alias.default
enrich:
- !DICT
with: !EVENT
set:
myEnrichedField:
!LOWER
what: "Byli jste obohaceni"
Sekce define
Tato sekce obsahuje obecnou definici a metada.
Položka name
Stručný, lidsky čitelný název deklarace obohacovače.
Položka type
Typ této deklarace, musí být enricher/standard.
Položka field_alias
Název vyhledávání aliasů polí, které mají být načteny, aby bylo možné použít aliasy názvů atributů událostí v deklaraci spolu s jejich kanonickými názvy.
Položka description (volitelné)
Delší, případně víceřádkový, lidsky čitelný popis deklarace.
Sekce enrich
Tato sekce specifikuje samotné obohacení příchozí události. Očekává se, že bude vrácen slovník.
Typické příkazy v sekci enrich
Příkaz !DICT umožňuje přidat pole / atributy k již parsované události.
Testování parserů
Je důležité testovat parsery, aby byla ověřena jejich funkčnost s různými vstupy. LogMan.io nabízí nástroje pro manuální a automatizované testování parserů.
LogMan.io Utility pro Parsování
Tento nástroj je určen pro ruční spuštění parserů z příkazového řádku. Je užitečný pro testování, protože aplikuje vybrané skupiny parserů na vstup a nezpracované události jsou uloženy do speciálního souboru, aby mohl být parser vylepšen, dokud tento „neparsovaný“ výstup nebude prázdný. Je navržen pro parsování velmi velkých vstupů.
Utility pro parsování je program příkazového řádku. Spouští se následujícím příkazem:
python3 ./parse.py -i input-syslog.txt -u unparsed-syslog.txt ./example/syslog_rfc5424-parser
-i, --input-file určuje soubor se vstupními řádky k parsování
-u, --unparsed-file určuje soubor pro uložení neparcovaných událostí ze vstupu
a dále následují skupiny parserů z knihovny, odkud se načítají deklarativní parsery.
Následující aplikace provádí parsování na zadaném vstupním souboru s řádky oddělenými novými řádky, například:
Feb 5 10:50:01 192.168.1.1 %ASA-1-105043 test1
Feb 5 10:55:10 192.168.1.1 %ASA-1-105043 test2
Feb 10 8:25:00 192.168.A1.1 X %ASA-1-105044 test3
a produkuje soubor pouze s neparcovanými událostmi, který má stejnou strukturu:
Feb 10 8:25:00 192.168.A1.1 X %ASA-1-105044 test3
Jednotkové Testy Parserů
LogMan.io poskytuje nástroj pro spuštění jednotkových testů nad knihovnou deklarací parserů a obohacovačů.
Chcete-li spustit:
python3 ./test.py ./example [--config ./config.json]
Nástroj hledá testy v knihovně, načítá je a poté je provádí v pořadí.
Formát jednotkových testů
Soubor jednotkového testu musí být umístěn v adresáři test a název souboru musí odpovídat šabloně test*.yaml. Jeden YAML testovací soubor může obsahovat jeden nebo více YAML dokumentů se specifikací testu.
---
input: |
řádek 1
řádek 2
...
groups:
# To znamená, že vše ze vstupu bude parsováno
unparsed: []
parsed:
- msg: řádek
num: 1
- msg: řádek
num: 2
Rozšíření parsovacího pipeline
Dodáváme LogMan.io knihovnu se standardními parsery, které jsou organizovány do předdefinovaných skupin. Někdy však můžete chtít rozšířit proces parsování vlastními parsers nebo obohacovači.
Zvažte následující vstupní událost, která bude parsována pomocí parserů z knihovny LogMan.io se skupinovým ID lmio_parser_default_syslog_rfc3164:
<163>Feb 22 14:12:56 vmhost01 2135: ERR042: Něco se pokazilo.
Tato událost bude parsována do strukturované události, která vypadá takto:
{
"@timestamp": 1614003176,
"ecs.version": "1.6.0",
"event.kind": "event",
"event.dataset": "syslog.rfc3164",
"message": "ERR042: Něco se pokazilo.\n",
"host.name": "vmhost01",
"tenant": "default",
"log.syslog.priority": 163,
"log.syslog.facility.code": 20,
"log.syslog.severity.code": 3,
"event.ingested": 1614004510.4724128,
"_s": "SzOe",
"_id": "[ID]",
"log.original": "<163>Feb 22 14:12:56 vmhost01 2135: ERR042: Něco se pokazilo.\n"
}
Vstupní událost však obsahuje další klíčové slovo - chybový kód "ERR042", který není součástí strukturované události. Můžeme extrahovat tuto hodnotu do vlastního pole strukturované události přidáním obohacovače (typ parseru), který rozdělí část "message" události a vybere chybový kód.
Najděte Skupinu Parserů k Rozšíření
V výše uvedeném příkladu používáme parsery s ID skupiny lmio_parser_default_syslog_rfc3164. Takže se pojďme přesunout do složky této skupiny v knihovně LogMan.io:
$ cd /opt/lmio-ecs # ... nebo vaše jiná umístění lmio-ecs
$ cd syslog_rfc3164-parser
Vytvoření Nového Deklaračního Souboru
Ve výchozím nastavení, bez rozšíření, jsou ve složce skupiny parserů tyto soubory:
$ ls -l
p01-parser.YAML p02-parser.YAML
Tyto soubory obsahují deklarace parserů.
Pro deklaraci nového obohacovače vytvořte soubor e01-enricher.yaml.
- "e" znamená "enricher" (obohacovač)
- "01" znamená prioritu, kterou tento obohacovač získá
- "-enricher" může být nahrazeno čímkoliv, co vám dává smysl
- "yaml" je povinná přípona
Přidání Obsahu do Deklaračního Souboru
Definice
Deklarace je YAML soubor s YAML záhlavím (v našem případě prázdným) a povinným blokem definice. Přidáváme standardní obohacovač s názvem "Error Code Enricher".
Přidejte následující do dekleračního souboru:
---
define:
name: Error Code Enricher
type: enricher/standard
Predikát
Chceme, aby náš obohacovač byl aplikován pouze na vybrané zprávy, takže musíme deklarovat predikát pomocí deklarativního jazyka.
Aplikujme obohacení na zprávy z hosta vmhost01.
Přidejte následující do dekleračního souboru:
predicate:
!EQ
- !ITEM EVENT host.name
- "vmhost01"
Obohacení
Když se podíváme na "message" výše uvedené události, chceme zprávu rozdělit podle dvojteček, vzít hodnotu prvního prvku výsledků a uložit ji jako "error.code" (nebo jiné ECS pole).
Toho můžeme dosáhnout opět pomocí deklarativního jazyka.
Přidejte následující do dekleračního souboru:
enrich:
!DICT
with: !EVENT
set:
error.code: !CUT
what: !ITEM EVENT message
delimiter: ':'
field: 0
Výsledná událost předaná do parsovacího pipeline bude obsahovat všechna pole z původní události a jedno další pole "error.code", jehož hodnota je výsledkem !CUT "message" pole z původní události (!ITEM EVENT message) pomocí : jako oddělovače a vybráním prvku na indexu 0.
Takto vypadá obsah souboru e01-enricher.yaml:
---
define:
name: Error Code Enricher
type: enricher/standard
predicate:
!EQ
- !ITEM EVENT host.name
- "vmhost01"
enrich:
!DICT
with: !EVENT
set:
error.code: !CUT
what: !ITEM EVENT message
delimiter: ':'
field: 0
Aplikování změn
Nová deklarace by měla být udržována ve verzi řízení. lmio-parser instance, která používá ID skupiny parserů, musí být restartována.
Závěr
Přidali jsme nový obohacovač do lmio_parser_default_syslog_rfc3164's parsovací pipeline.
Nové události z hosta vmhost01 nyní budou parsovány a obohaceny s následujícím výstupem události:
{
"@timestamp": 1614003176,
"ecs.version": "1.6.0",
"event.kind": "event",
"event.dataset": "syslog.rfc3164",
"message": "ERR042: Něco se pokazilo.\n",
"host.name": "vmhost01",
"tenant": "default",
"log.syslog.priority": 163,
"log.syslog.facility.code": 20,
"log.syslog.severity.code": 3,
"event.ingested": 1614004510.4724128,
"_s": "SzOe",
"_id": "[ID]",
"log.original": "<163>Feb 22 14:12:56 vmhost01 2135: ERR042: Něco se pokazilo.\n",
"error.code": "ERR042"
}
Depositor
LogMan.io Depositor
TeskaLabs LogMan.io Depositor je mikroslužba zodpovědná za ukládání událostí v Elasticsearch a nastavování Elasticsearch artefaktů (jako jsou indexové šablony a ILM politiky) na základě deklarací event lane.
LogMan.io Depositor ukládá úspěšně zpracované nebo korelované události a další události do jejich příslušných Elasticsearch indexů.
Poznámka
LogMan.io Depositor nahrazuje LogMan.io Dispatcher.
Důležité poznámky
Požadavky a konfigurace
- Depositor vyžaduje specifické nastavení Elasticsearch s definovanými rolami uzlů, viz Požadavky
- Depositorova výchozí životnostní politika vyžaduje nastavení rolí uzlů v konfiguraci Elasticsearch, viz Požadavky
- Depositor výchozí přestane posílat data do Elasticsearch, pokud je zdraví clusteru pod
50 %, viz Konfigurace - Depositor bere v úvahu všechny event lane soubory bez ohledu na to, zda jsou pro daného tenanta v UI deaktivovány či nikoli
Správa indexů
- Depositor vytváří svou vlastní indexovou šablonu a životnostní politiku (ILM) pro každý index specifikovaný v sekcích
eventsaothersuvnitř deklarace event lane, viz Event Lane - Depositorova výchozí indexová šablona má 6 shardů a 1 repliku
- Mapování polí (typy polí) v indexové šabloně vychází ze schématu event lane, viz Event Lane
Podrobnosti o životnostní politice
- Depositorova výchozí životnostní politika má limit 16 GB na primární shard na index (výchozí maximální velikost indexu je tedy 6 shardů * 16 GB * 2 pro repliku = 192 GB)
- Depositorova výchozí životnostní politika má povoleno zmenšování při vstupu do teplé fáze
- Depositorova výchozí životnostní politika smaže data po 180 dnech
Migrace
- Při migraci z LogMan.io Dispatcher na LogMan.io Depositor, viz sekci Migrace
Požadavky na Depositor
LogMan.io Depositor má následující závislosti:
- Elasticsearch
- Apache ZooKeeper
- Apache Kafka
- LogMan.io Knihovna s
/EventLanessložkou a schéma ve složce/Schemas
Konfigurace Elasticsearch
Elasticsearch cluster musí být nakonfigurován následovně, aby LogMan.io Depositor správně fungoval.
Níže je záznam Docker Compose pro Elasticsearch uzly, použitím architektury 3-uzlového clustera s lm1, lm2 a lm3 serverovými uzly.
Poznámka
Vezměte, prosím, na vědomí, že v souboru Docker Compose mají Elasticsearch uzly přiřazené příslušné role uzlů na základě ILM. Například hot uzly pro ILM horkou fázi musí obsahovat role uzlu data_hot a data_content.
Při vytváření záznamů Docker Compose pro Elasticsearch uzly je třeba změnit následující atributy:
- NODE_ID: Název serveru, na kterém instance Elasticsearch běží
- INSTANCE_ID: Název instance Elasticsearch. Ujistěte se, že jeho postfix
-1je při této druhé instanci této služby změněn na-2atd. INSTANCE_ID je tedy jedinečný identifikátor pro každou z instancí. - network.host: Název serveru, na kterém instance Elasticsearch běží
- node.attr.rack_id: Název serverového racku (pro velké nasazení) nebo název serveru, na kterém instance Elasticsearch běží
- discovery.seed_hosts: Názvy serverů a porty všech Elasticseach hlavních uzlů
- xpack.security.transport.ssl.certificate: Cesta k certifikátu specifickému pro danou instanci Elasticsearch
- xpack.security.transport.ssl.key: Cesta ke klíči certifikátu specifickému pro danou instanci Elasticsearch
- volumes: Cesta k datům dané instance Elasticsearch
elasticsearch-master-1:
network_mode: host
user: "1000:1000"
image: docker.elastic.co/elasticsearch/elasticsearch:7.17.9
environment:
- NODE_ID=lm1
- SERVICE_ID=elasticsearch
- INSTANCE_ID=elasticsearch-master-1
- network.host=lm1 # (1)
- node.attr.rack_id=lm1 # (2)
- node.name=elasticsearch-master-1
- node.roles=master,ingest
- cluster.name=lmio-es # (3)
- cluster.initial_master_nodes=elasticsearch-master-1,elasticsearch-master-2,elasticsearch-master-3 # (6)
- discovery.seed_hosts=lm1:9300,lm2:9300,lm3:9300
- http.port=9200
- transport.port=9300 # (4)
- "ES_JAVA_OPTS=-Xms4g -Xmx4g" # (5)
- ELASTIC_PASSWORD=$ELASTIC_PASSWORD
- xpack.security.enabled=true
- xpack.security.transport.ssl.enabled=true
- xpack.security.transport.ssl.verification_mode=certificate
- xpack.security.transport.ssl.certificate_authorities=certs/ca/ca.crt
- xpack.security.transport.ssl.certificate=certs/elasticsearch-master-1/elasticsearch-master-1.crt
- xpack.security.transport.ssl.key=certs/elasticsearch-master-1/elasticsearch-master-1.key
volumes:
- /data/ssd/elasticsearch/elasticsearch-master-1/data:/usr/share/elasticsearch/data
- ./elasticsearch/certs:/usr/share/elasticsearch/config/certs
restart: always
-
Uzel se připojí na veřejnou adresu a také ji použije jako svoji publikovanou adresu.
-
Rack ID nebo název datového centra. To má za účel umožnit ES efektivně a bezpečně spravovat repliky. Pro menší instalace je dostačující název hostitele.
-
Název Elasticsearch clusteru. V LogMan.io je pouze jeden Elasticsearch cluster.
-
Porty pro interní komunikaci mezi uzly.
-
Paměť přidělená pro tuto instanci Elasticsearch. 31 GB je maximální doporučená hodnota a server musí mít dostatečnou dostupnou paměť (pokud jsou tři Elasticsearch uzly s 31 GB a jeden master uzel se 4 GB, musí být k dispozici alespoň 128 GB).
-
Počáteční master uzly jsou instance ID všech Elasticsearch hlavních uzlů dostupných v LogMan.io clusteru. Názvy hlavních uzlů musí být sladěny s node.name. V LogMan.io (jak je definováno Maestro), je totožný s INSTANCE_ID.
elasticsearch-hot-1:
network_mode: host
user: "1000:1000"
image: docker.elastic.co/elasticsearch/elasticsearch:7.17.9
depends_on:
- es-master
environment:
- NODE_ID=lm1
- SERVICE_ID=elasticsearch
- INSTANCE_ID=elasticsearch-hot-1
- network.host=lm1 # (1)
- node.attr.rack_id=lm1 # (2)
- node.attr.data=hot # (3)
- node.name=elasticsearch-hot-1
- node.roles=data_hot,data_content # (6)
- cluster.name=lmio-es # (4)
- cluster.initial_master_nodes=elasticsearch-master-1,elasticsearch-master-2,elasticsearch-master-3 # (8)
- discovery.seed_hosts=lm1:9300,lm2:9300,lm3:9300
- http.port=9201
- transport.port=9301 # (5)
- "ES_JAVA_OPTS=-Xms31g -Xmx31g" # (7)
- ELASTIC_PASSWORD=$ELASTIC_PASSWORD
- xpack.security.enabled=true
- xpack.security.transport.ssl.enabled=true
- xpack.security.transport.ssl.verification_mode=certificate
- xpack.security.transport.ssl.certificate_authorities=certs/ca/ca.crt
- xpack.security.transport.ssl.certificate=certs/elasticsearch-hot-1/elasticsearch-hot-1.crt
- xpack.security.transport.ssl.key=certs/elasticsearch-hot-1/elasticsearch-hot-1.key
volumes:
- /data/ssd/elasticsearch/elasticsearch-hot-1/data:/usr/share/elasticsearch/data
- ./elasticsearch/certs:/usr/share/elasticsearch/config/certs
-
Uzel se připojí na veřejnou adresu a také ji použije jako svoji publikovanou adresu.
-
Rack ID nebo název datového centra. To má za účel umožnit ES efektivně a bezpečně spravovat repliky. Pro menší instalace je dostačující název hostitele.
-
Atributy
node.attr.datajsou v konfiguraci kvůli zpětné kompatibilitě pro starší verze ILM, kde se používá vlastní alokace pomocínode.attr.data. Toto platí pro instalace LogMan.io před 01/2024. -
Název Elasticsearch clusteru. V LogMan.io je pouze jeden Elasticsearch cluster.
-
Porty pro interní komunikaci mezi uzly.
-
Role uzlů jsou zde kvůli správnému fungování výchozí alokace ILM.
-
Paměť přidělená pro tuto instanci Elasticsearch. 31 GB je maximální doporučená hodnota a server musí mít dostatečnou dostupnou paměť (pokud jsou tři Elasticsearch uzly s 31 GB a jeden master uzel se 4 GB, musí být k dispozici alespoň 128 GB).
-
Počáteční master uzly jsou instance ID všech Elasticsearch hlavních uzlů dostupných v LogMan.io clusteru. Názvy hlavních uzlů musí být sladěny s node.name. V LogMan.io (jak je definováno Maestro), je totožný s INSTANCE_ID.
elasticsearch-warm-1:
network_mode: host
user: "1000:1000"
image: docker.elastic.co/elasticsearch/elasticsearch:7.17.9
depends_on:
- es-master
environment:
- NODE_ID=lm1
- SERVICE_ID=elasticsearch
- INSTANCE_ID=elasticsearch-warm-1
- network.host=lm1 # (1)
- node.attr.rack_id=lm1 # (2)
- node.attr.data=warm # (3)
- node.name=elasticsearch-warm-1
- node.roles=data_warm # (6)
- cluster.name=lmio-es # (4)
- cluster.initial_master_nodes=elasticsearch-master-1,elasticsearch-master-2,elasticsearch-master-3 # (8)
- discovery.seed_hosts=lm1:9300,lm2:9300,lm3:9300
- http.port=9202
- transport.port=9302 # (5)
- "ES_JAVA_OPTS=-Xms31g -Xmx31g" # (7)
- ELASTIC_PASSWORD=$ELASTIC_PASSWORD
- xpack.security.enabled=true
- xpack.security.transport.ssl.enabled=true
- xpack.security.transport.ssl.verification_mode=certificate
- xpack.security.transport.ssl.certificate_authorities=certs/ca/ca.crt
- xpack.security.transport.ssl.certificate=certs/elasticsearch-warm-1/elasticsearch-warm-1.crt
- xpack.security.transport.ssl.key=certs/elasticsearch-warm-1/elasticsearch-warm-1.key
volumes:
- /data/hdd/elasticsearch/elasticsearch-warm-1/data:/usr/share/elasticsearch/data
- ./elasticsearch/certs:/usr/share/elasticsearch/config/certs
-
Uzel se připojí na veřejnou adresu a také ji použije jako svoji publikovanou adresu.
-
Rack ID nebo název datového centra. To má za účel umožnit ES efektivně a bezpečně spravovat repliky. Pro menší instalace je dostačující název hostitele.
-
Atributy
node.attr.datajsou v konfiguraci kvůli zpětné kompatibilitě pro starší verze ILM, kde se používá vlastní alokace pomocínode.attr.data. Toto platí pro instalace LogMan.io před 01/2024. -
Název Elasticsearch clusteru. V LogMan.io je pouze jeden Elasticsearch cluster.
-
Porty pro interní komunikaci mezi uzly.
-
Role uzlů jsou zde kvůli správnému fungování výchozí alokace ILM.
-
Paměť přidělená pro tuto instanci Elasticsearch. 31 GB je maximální doporučená hodnota a server musí mít dostatečnou dostupnou paměť (pokud jsou tři Elasticsearch uzly s 31 GB a jeden master uzel se 4 GB, musí být k dispozici alespoň 128 GB).
-
Počáteční master uzly jsou instance ID všech Elasticsearch hlavních uzlů dostupných v LogMan.io clusteru. Názvy hlavních uzlů musí být sladěny s node.name. V LogMan.io (jak je definováno Maestro), je totožný s INSTANCE_ID.
elasticsearch-cold-1:
network_mode: host
user: "1000:1000"
image: docker.elastic.co/elasticsearch/elasticsearch:7.17.9
depends_on:
- es-master
environment:
- NODE_ID=lm1
- SERVICE_ID=elasticsearch
- INSTANCE_ID=elasticsearch-cold-1
- network.host=lm1
- node.attr.rack_id=lm1 # (2)
- node.attr.data=cold # (3)
- node.name=elasticsearch-cold-1
- node.roles=data_cold # (6)
- cluster.name=lmio-es # (4)
- cluster.initial_master_nodes=elasticsearch-master-1,elasticsearch-master-2,elasticsearch-master-3 # (8)
- discovery.seed_hosts=lm1:9300,lm2:9300,lm3:9300
- http.port=9203
- transport.port=9303 # (5)
- "ES_JAVA_OPTS=-Xms31g -Xmx31g" # (7)
- ELASTIC_PASSWORD=$ELASTIC_PASSWORD
- xpack.security.enabled=true
- xpack.security.transport.ssl.enabled=true
- xpack.security.transport.ssl.verification_mode=certificate
- xpack.security.transport.ssl.certificate_authorities=certs/ca/ca.crt
- xpack.security.transport.ssl.certificate=certs/elasticsearch-cold-1/elasticsearch-cold-1.crt
- xpack.security.transport.ssl.key=certs/elasticsearch-cold-1/elasticsearch-cold-1.key
volumes:
- /data/hdd/elasticsearch/elasticsearch-cold-1/data:/usr/share/elasticsearch/data
- ./elasticsearch/certs:/usr/share/elasticsearch/config/certs
-
Uzel se připojí na veřejnou adresu a také ji použije jako svoji publikovanou adresu.
-
Rack ID nebo název datového centra. To má za účel umožnit ES efektivně a bezpečně spravovat repliky. Pro menší instalace je dostačující název hostitele.
-
Atributy
node.attr.datajsou v konfiguraci kvůli zpětné kompatibilitě pro starší verze ILM, kde se používá vlastní alokace pomocínode.attr.data. Toto platí pro instalace LogMan.io před 01/2024. -
Název Elasticsearch clusteru. V LogMan.io je pouze jeden Elasticsearch cluster.
-
Porty pro interní komunikaci mezi uzly.
-
Role uzlů jsou zde kvůli správnému fungování výchozí alokace ILM.
-
Paměť přidělená pro tuto instanci Elasticsearch. 31 GB je maximální doporučená hodnota a server musí mít dostatečnou dostupnou paměť (pokud jsou tři Elasticsearch uzly s 31 GB a jeden master uzel se 4 GB, musí být k dispozici alespoň 128 GB).
-
Počáteční master uzly jsou instance ID všech Elasticsearch hlavních uzlů dostupných v LogMan.io clusteru. Názvy hlavních uzlů musí být sladěny s node.name. V LogMan.io (jak je definováno Maestro), je totožný s INSTANCE_ID.
Šablony Indexů
LogMan.io Depositor vytváří své vlastní šablony indexů s indexem events z konfigurace elasticsearch event lane, přidává postfix -template. Všechny předchozí šablony indexů, pokud jsou přítomny, musí mít jiné jméno a jejich priorita nastavena na 0.
Konfigurace vkladatele
Model
Chcete-li aplikaci spustit, zahrňte ji do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-depositor:
- <node> # Replace with name of the node
Vzor konfigurace
Toto je nejzákladnější konfigurace vyžadovaná pro LogMan.io Depositor:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[elasticsearch]
url=http://es01:9200
Ošetřovatel zvířat
Určete umístění serveru Zookeeper v clusteru.
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Nápověda
Pro nepředprodukční nasazení je možné použít jediný server Zookeeper.
Knihovna
Uveďte cestu/cesty k knihovně, ze které se mají načíst deklarace.
[library]
providers=zk:///library
Nápověda
Jelikož je výchozí ECS.yaml schéma v /Schemas využíváno, zvažte použití společné knihovny LogMan.io.
Kafka
Uveďte bootstrap servery clusteru Kafka.
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Nápověda
Pro nasazení mimo produkci je možné použít jeden server Kafka.
Elasticsearch
Určete URL adresy hlavních uzlů Elasticsearch.
Sekce ESConnection se používá pro nastavování pokročilých parametrů připojení (viz níže).
Sekce elasticsearch se používá pro ukládání URL a položek autorizace.
Sekce asab:storage se používá k explicitnímu povolení inicializace úložiště.
[asab:storage]
type=elasticsearch
[connection:ESConnection]
precise_error_handling=true
bulk_out_max_size=1582912
output_queue_max_size=5
loader_per_url=1
cluster_status_throttle=yellow
cluster_status_unthrottle=green
active_shards_percent_throttle=50
retry_errors=unavailable_shards_exception
throttle_errors=circuit_breaking_exception
[elasticsearch]
url=http://es01:9201
username=MYUSERNAME
password=MYPASSWORD
Nápověda
URL by mělo směřovat na Elasticsearch hot node na stejném serveru, na kterém je nasazen Depositor.
Pokročilé nastavení připojení Elasticsearch
přesné_zpracování_chyb
Určuje, že Elasticsearch by měl vrátit informace o tom, které události způsobily problém, spolu s chybou.
maximální_velikost_hromadného_výstupu
Velikost jednoho hromadného záznamu odesílaného do Elasticsearch v bytech.
Události jsou seskupeny do bloků, aby se snížil počet požadavků odesílaných do Elasticsearch.
maximální_velikost_výstupní_fronty
Maximální velikost fronty pro hromadné operace Elasticsearch.
Pokud je číslo překročeno, daný potrubní systém je omezen.
načítací_program_pro_URL
Počet úkolů/nakladačů na URL. Určuje počet požadavků, které lze současně odeslat na každou URL uvedenou v atributu URL.
omezovač_stavu_klastru
Stav, do kterého musí cluster vstoupit, aby zastavil/omezil vkladatele. Lze nastavit na none.
Výchozí: žlutá
Možnosti: červená, žlutá, žádná
stav_klastru_odblokovat
Stav, do kterého musí cluster vstoupit, aby mohl pokračovat/odblokovat vkladatele, pokud je omezen.
Výchozí: zelená
Možnosti: červená, žlutá, zelená
procento_aktivních_částí_omezeno
Minimální procento celkového počtu shardů, které musí být aktivní/dostupné, aby mohl vkladatel odesílat události.
Hodnota, která je vyjádřena v procentech, by měla být nastavena na 100 / (počet replik + 1).
Výchozí: 50
štítek_horkého_uzlu
Podřetězec se shodoval v názvech uzlů _cat/shards při počítání horkých úseků, které nejsou STARTED, pro unassigned_shards_tolerance.
Výchozí: horký
Nastavte na none (nebo prázdné), aby se kontrola shardů v horké vrstvě úplně přeskočila. Při nouzových výpadcích více lokalit je to jednodušší než hádat velkou hodnotu unassigned_shards_tolerance. Viz Nouzová nastavení clusteru Elasticsearch.
tolerance_nepřiřazených_úseků
Maximální počet shardů, které nejsou STARTED, na uzlech, jejichž název obsahuje hot_node_tag, než Depositor považuje hot tier za nepřipravený a zpomalí příjem dat.
Výchozí: 32
Během výpadku na více místech zůstává mnoho shardů na selhané lokalitě v stavu non STARTED. Tuto hodnotu můžete zvýšit (například na 100000) při zachování hot_node_tag: hot, nebo nastavit hot_node_tag: none a přeskočit kontrolu. Nemá žádný efekt, když je hot_node_tag none nebo prázdný.
selhání_opakovaného_přesměrování_klastru
Když je stav clusteru red a unassigned_shards je větší než nula, Depositor pravidelně volá POST /_cluster/reroute?retry_failed=true na dostupnou aktivní URL. Tím se vyresetují vyčerpané čítače pokusů o přiřazení, takže zaseknuté primární shardy (například po neúspěšném ILM shrink / zámku shardu) mohou být přiřazeny znovu bez manuálního přesměrování.
Výchozí: ano
Nastavte na no pro deaktivaci. Vyžaduje přihlašovací údaje Elasticsearch, které mohou spravovat přesměrování clusteru. Volání je přeskočeno, pokud je zdravotní stav sám o sobě nedostupný (bez mastera).
interval_neúspěšného_opakovaného_přesměrování_klastru
Minimální počet sekund mezi pokusy o přesměrování retry_failed. Odpovídá frekvenci kontrolního cyklu stavu indexu (1800 = 30 minut).
Výchozí: 1800
opakovat_chyby
Seznam typů chyb Elasticsearch pro jednotlivé dokumenty (oddělených ;), které způsobí, že bude událost znovu zpracována na stejném pipeline místo toho, aby byla přesměrována na jiné.
Výchozí: unavailable_shards_exception;cluster_block_exception;node_not_connected_exception
Poznámka
Tato konfigurační možnost je ve většině případů zbytečná, proto se doporučuje ji vyloučit ze svého konfiguračního souboru.
opakovat_http_stav
Seznam stavových kódů HTTP pro úplné hromadné selhání (oddělené ;), která způsobují, že události budou zkoušeny znovu ve stejném pipeline místo toho, aby byly přesměrovány do jiných.
Použijte toto pro dočasné výpadky clusteru / brány. Problémy na úrovni dokumentu (mapování, špatný payload) by měly stále jít jinam.
Ve výchozím nastavení: 500;502;503
Příklad: HTTP 503 s cluster_block_exception / no master během údržby nebo odpojení datového centra nesmí zaplavit ostatní indexy.
chyby škrcení
Seznam typů chyb Elasticsearch na dokument (oddělených ;), které pozastaví (omezí) ingest dokud se zdraví clusteru neobnoví.
Ve výchozím nastavení: circuit_breaking_exception
Poznámka
Tato konfigurační možnost je ve většině případů zbytečná, proto se doporučuje ji vyloučit ze svého konfiguračního souboru.
stav_http_uplynutí
Seznam HTTP stavových kódů pro úplné hromadné selhání (oddělené ;), které také pozastaví příjem dat, dokud se nezotaví stav clusteru (stejný mechanismus jako omezení stavu clusteru). Pozastavení se automaticky uvolní při další kontrole stavu, jakmile již nejsou podmínky omezení splněny.
Výchozí: 503
Nastavte na prázdné (throttle_http_status= v INI, nebo throttle_http_status: "" v modelu) pro deaktivaci této pauzy. Neúspěšné dávky se stále pokusí znovu, když je stav uveden v retry_http_status. Viz Elasticsearch Cluster Emergency Settings.
Prohlášení
Volitelná sekce pro určení, odkud načíst deklarace proudů událostí a který schéma bude použito jako výchozí (pokud není specifikováno v dané deklaraci proudu událostí).
[declarations]
path=/EventLanes/
schema=/Schemas/ECS.yaml
Nápověda
Ujistěte se, že změníte schéma, pokud ve svém nasazení používáte jiné schéma než ECS jako výchozí. Změna cesty pro event lanes se nedoporučuje.
Dráhy událostí
TeskaLabs LogMan.io Depositor čte všechny event řady z knihovny a vytváří pipeline z Kafka do Elasticsearch na základě sekcí kafka a elasticsearch.
Poznámka
Všechny nasazené instance TeskaLabs LogMan.io Depositor sdílejí stejné ID skupiny v rámci Kafka. Všechny instance rozdělují konzumaci z Kafka partičí mezi sebe a tím poskytují škálovatelnost nativně.
Prohlášení
Toto je příklad sekcí událostního pásu relevantních pro LogMan.io Depositor:
---
define:
type: lmio/event-lane
kafka:
events:
topic: events.<tenant>.<stream> # Kafka topic for parsed events
others:
topic: others.<tenant>.<stream> # Kafka topic for unparsed events
elasticsearch:
events:
index: lmio-<tenant>-events-<stream> # Index alias for events
others:
index: lmio-<tenant>-others # Index alias for others
Když je spuštěn LogMan.io Depositor a je načtena událostní dráha, jsou vytvořeny dva pipeline. Pipeline událostí spotřebovává zprávy z Kafka tématu definovaného v možnosti kafka/events/topic a ukládá je do Elasticsearch indexu, přičemž používá alias indexu definovaný v možnosti elasticsearch/events/index.
Pipeline Others podobně spotřebovává zprávy z tématu definovaného v kafka/others/topic a ukládá je do indexu pomocí aliasu definovaného v elasticsearch/others/index.
Index vs. alias indexu
V Elasticsearch je index sbírkou dokumentů, které sdílejí stejnou strukturu a jsou uloženy společně. Je to základní jednotka pro ukládání a vyhledávání dat.
Indexový alias je virtuální název, který může ukazovat na jeden nebo více indexů. Umožňuje zobrazovat a manipulovat s daty stejného logického toku.
V událostním kanálu je specifikován alias indexu. LogMan.io Depositor vytváří indexy na základě tohoto aliasu.
Například, když je alias indexu definován jako lmio-tenant-events-stream, _LogMan.io Depositor vytváří indexy
```
lmio-tenant-events-stream-000001
lmio-tenant-events-stream-000002
lmio-tenant-events-stream-000003
...
```
Komplexní událostní pruhy
LogMan.io Depositor nativně nečte z Kafka tématu events.<tenant>.complex a přeskočuje složité událostní linie.
Poznámka
Depozitář bere v úvahu VŠECHNY soubory jízdních pruhů událostí, bez ohledu na to, zda jsou pro daného nájemce v rozhraní UI zakázány nebo ne. Depozitář není služba specifická pro konkrétního nájemce.
Sdílení dat mezi nájemci
Vkladatel vytváří globální mapu Kafka tématu → Elasticsearch index z událostních linií všech nájemců. Při načítání nedochází k žádnému směrování podle nájemce: rozhoduje pouze samotné téma. Pokud dva nájemci deklarují různé indexy (nebo jiné cíle) pro stejné Kafka téma, poslední načtená deklarace tiše zvítězí.
Kdy to použít
Používejte sdílená témata a indexy, když několik nájemníků by mělo vidět stejný proud událostí v Elasticsearch (stejná data, stejná schémata).
Jak nakonfigurovat
- Zkopírujte stejnou událostní linku do složky knihovny každého nájemce, například:
/EventLanes/tenant-a/microsoft-windows.yaml/EventLanes/tenant-b/microsoft-windows.yaml- V každé kopii nastavte stejné:
kafka.events.topicelasticsearch.events.index- schéma (
define.schemanebo výchozí schéma nájemce, ale zachovejte jejich sladění) - Explicitně uveďte
othersv událostní lince (kafka.others.topicaelasticsearch.others.index) a nasměrujte je na sdílený topic a index pro ostatní.
---
define:
type: lmio/event-lane
schema: /Schemas/ECS.yaml
kafka:
events:
topic: events.shared.microsoft-windows
others:
topic: others.shared
elasticsearch:
events:
index: lmio-shared-events-microsoft-windows
others:
index: lmio-shared-others
Proč musí být others nastaveno v událostním kanálu
Pokud jsou kafka.others / elasticsearch.others vynechány, Depositor používá vyhrazenou lane událostí ostatních tohoto tenanta (type: …/others nebo define.others: true).
Přesměrování při chybě a selhání pipeline používá globální mapu events_topic → others_topic. Při sdíleném tématu událostí a různých drahách others pro jednotlivé nájemce vyhraje cíl others posledního nájemce. Umístění sdíleného others do dráhy událostí tomu zabrání.
Chování a upozornění
- Dokumenty od všech sdílených nájemců jsou ukládány ve stejných indexech Elasticsearch. Pokud potřebujete pohled na konkrétního nájemce v Kibana, filtrovat podle pole
tenantv události (pokud jej parsery nastaví). - Zachovejte stejné schéma, filtry a nastavení ILM napříč kopiemi, aby přestavby artefaktů neměnily konfliktní šablony.
- Producenti (Parsec a další) pro každého sdíleného nájemce musí publikovat na tyto sdílené Kafka topic.
- Depositor nedupikuje Kafka konzumenty pro stejné topic; jedno předplatné obslouží všechny sdílené nájemce.
Šablona indexu
LogMan.io Depositor vytváří a aktualizuje šablonu indexu pro každý proud událostí.
Mapování v šabloně indexu je založeno na schématu event lane. Výchozí schéma pro event lane je /Schemas/ECS.yaml. Lze jej změnit v deklaraci event lane:
---
define:
type: lmio/event-lane
schema: /Schemas/CEF.yaml
Je také možné specifikovat number_of_shards a number_of_replicas v sekci nastavení v elasticsearch:
---
define:
type: lmio/event-lane
elasticsearch:
events:
settings:
number_of_shards: 6
number_of_replicas: 1
refresh_interval: 30s
Výchozí hodnota number_of_shards je 6, number_of_replicas je 1 a refresh_interval je 30s.
Poznámka
Pečlivě zvažte změnu výchozího nastavení a schématu. Změna výchozích hodnot obvykle způsobuje problémy, například neshodující se detekční pravidla pro danou událostní cestu, která používá jiné schéma.
Varování
Změny šablony indexu se projeví až po dalším přechodu indexu, pokud v Elasticsearch již existuje nějaký index.
Filtrování
Chcete-li filtrovat konkrétní atributy z příchozích událostí, které nemají být ukládány do Elasticsearch, použijte možnost filter se seznamem atributů, které mají být odstraněny z příchozích zpracovaných událostí. Tato možnost se nachází v sekci elasticsearch pro index events.
elasticsearch:
events:
index: lmio-<tenant>-events-<stream> # Index alias for events
filter:
- event.original
Politika životního cyklu
LogMan.io Depositor konfiguruje Index Lifecycle Policy každého proudu událostí.
Výchozí
Výchozí politika životního cyklu obsahuje čtyři fáze: hot, warm, cold a delete.
-
Výchozí horká fáze pro daný index končí, když velikost primární části přesáhne 16 GB nebo je starší než 7 dní.
-
Výchozí teplá fáze pro daný index začíná buď po skončení horké fáze, nebo po 7 dnech, a zapíná smršťování.
-
Výchozí studená fáze pro daný index začíná po 14 dnech.
-
Fáze mazání odstraní index po 180 dnech.
Vlastní
Výchozí ILM lze změnit, i když to není doporučeno pro většinu případů. Můžete tak učinit zadáním sekce lifecycle v rámci sekce elasticsearch u dané event lane:
---
define:
type: lmio/event-lane
elasticsearch:
events:
lifecycle:
hot:
min_age: "0ms"
actions:
rollover:
max_primary_shard_size: "25gb" # We want bigger primary shards than default
max_age: "30d"
set_priority:
priority: 100
warm:
min_age: "7d"
actions:
shrink:
number_of_shards: 1
set_priority:
priority: 50
cold:
min_age: "14d"
actions:
set_priority:
priority: 0
delete:
min_age: 180d
actions:
delete:
delete_searchable_snapshot: true
!!! varování „Nastavte kompletní ILM politiku.“
I když se snažíte změnit jen jednu z fází, musíte specifikovat celou politiku životního cyklu. Vlastní ILM zcela přepisuje výchozí konfiguraci.
!!! tip „Fáze bez mazání“
Pokud nechcete nastavit fázi delete, prostě vynechte sekci delete v událostní lince. Použijte to pouze, pokud opravdu víte, co děláte!
Migrace dispečera na vkladatele
Varování
Tato sekce je relevantní pro neautomatizované instalace TeskaLabs LogMan.io, které fungují s LogMan.io Dispatcher.
Migrace z LogMan.io Dispatcher na LogMan.io Depositor musí být provedena po jedné událostní linii najednou podle níže uvedených kroků.
Varování
Než začnete s migrací, musíte dodržet Požadavky a ujistit se, že správně nakonfigurujete role uzlů pro uzly Elasticsearch v clusteru.
Kroky migrace
Vyberte jednu událostní dráhu k migraci a řiďte se tímto průvodcem:
-
V Kibana přejděte na Správa > Správa stacku, poté Správa indexů. Klikněte na Šablony indexů a najděte šablonu indexu spojenou s migrovaným event lane. Obvykle je název ve formátu
lmio-tenant-events-eventlane-template. Ve sloupci Akce (tři tečky) napravo klikněte na Klonovat. -
V Klonovat změňte Název na
backup-lmio-tenant-events-eventlane-templatea nastavte Prioritu na0. -
Přejděte na Zkontrolovat šablonu a klikněte na Vytvořit šablonu.
-
Zkontrolujte, že šablona
backup-lmio-tenant-events-eventlane-templateexistuje na kartě Index Template. -
Odstraňte původní
lmio-tenant-events-eventlane-templatea ponechte pouze zálohu, kterou jste právě vytvořili. -
Přejděte do uživatelského rozhraní LogMan.io, do sekce Knihovna a do složky
/EventLanes -
Pokud soubor událostní dráhy ještě neexistuje, vytvořte nový soubor událostní dráhy s názvem
fortigate.yaml(nahraďte „fortigate“ názvem vaší událostní dráhy) ve složce/EventLanes/tenant(nahraďte „tenant“ názvem vašeho tenant). Pokud složka/EventLanes/tenantještě neexistuje, je potřeba ji vytvořit v ZooKeeper UI. -
Vytvořte sekce
kafkaaelasticsearchpro daný event lane s oběma sekcemieventsaothersuvedenými (viz Event Lane). Výchozí schéma pro mapování polí je/Schemas/ECS.yaml, pokud není v event lane specifikováno jinak. -
Pokud není nasazeno, nasadit LogMan.io Depositor s určenými sekcemi
kafka,elasticsearch,zookeeperalibrary(viz Konfigurace). -
Zkontrolujte logy depositoru LogMan.io na varování. Zkontrolujte prosím jak Docker logy, tak souborové logy (pokud jsou souborové logy nakonfigurovány). Docker logy lze získat pomocí následujícího příkazu:
docker logs -f -n 1000 <lmio-depositor>
Nahraďte <lmio-depositor> názvem Docker kontejneru LogMan.io Depositor ve vašem nasazení.
-
V Kibana přejděte na Management > Stack Management, poté na Index Management a zkontrolujte, že nové šablony indexů
lmio-tenant-events-eventlane-templatealmio-tenant-others-templatebyly vytvořeny uživatelem Depositor. Klikněte na šablonu indexu a zkontrolujte její nastavení a mapování. Výchozí nastavení zahrnují 1 shard a 1 repliku (viz Event Lane). -
V Kibana přejděte na Správa > Správa stacku a poté na Politiky životního cyklu indexu a zkontrolujte, zda byly vytvořeny
lmio-tenant-events-eventlane-ilmalmio-tenant-others-ilm. Klikněte na jejich název a zkontrolujte nastavení fází hot, warm, cold a delete. -
Pokud LogMan.io pro tento účel není již nasazen nebo nakonfigurován, nasajte nebo nakonfigurujte Parsec tak, aby odesílal data do tématu událostí Kafka specifikovaného v deklaraci událostní linky (zde:
fortigate.yaml). Viz sekce Konfigurace Parsec. -
V Kibana přejděte na Správa > Nástroje pro vývojáře a spusťte přechod indexu, přičemž
tenantaeventlanenahraďte názvem vašeho nájemce a vaší událostní dráhy:
POST /lmio-tenant-eventlane/_rollover
-
Zkontrolujte, že nový index uvedený v odpovědi v poli na pravé straně obrazovky byl vytvořen. Přejděte do Správa > Správa zásobníku, poté Správa indexů, na kartu Indexy a najděte index
lmio-tenant-events-eventlane-0000x. -
Klikněte na
lmio-tenant-events-eventlane-0000x, zkontrolujte, že je připojen k správné politice životního cyklu, která by měla býtlmio-tenant-events-eventlane-ilm, a také zkontrolujte, že aktuální fáze je hot. Poté klikněte na Nastavení a Mapování a zkontrolujte počet shardů (výchozí je 1) a mapování polí, které je načteno ze schématu. Výchozí schéma je/Schemas/ECS.yaml, pokud není v event lane specifikováno jinak. -
V Kibana přejděte na Analýza > Objevovat a zkontrolujte, zda data přicházejí do zadaného kanálu událostí.
-
V uživatelském rozhraní LogMan.io přejděte na Discover a zkontrolujte, že data přicházejí do dané událostní linie.
-
Opakujte kroky 1 až 18 pro všechny zbývající událostní dráhy (jejich indexy událostí). Teprve potom můžete dokončit migraci tím, že provedete stejný postup pro indexy
others.
Nápověda
V následujících dnech periodicky kontrolujte, zda jsou všechny indexy připojeny k životnímu cyklu politiky (krok 16). Také se ujistěte, že indexy ve fázi hot jsou přiřazeny k hot uzlům Elasticsearch, což lze vidět v Kibana v Správa > Monitorování stacku > Indexy.
Poznámka
Až budete moci potvrdit, že vše funguje správně po týdnu, můžete smazat původní šablonu indexu zálohy backup-lmio-tenant-events-eventlane-template.
Řešení problémů
Rady pro řešení nejčastěji se vyskytujících problémů:
Mnoho událostí končí u ostatních s HTTP 503 / cluster_block_exception / no master
To obvykle znamená, že Elasticsearch měl dočasný výpadek clusteru (například odpojení datového centra), nikoli že samotné události byly neplatné.
Vkladatel znovu zpracovává plnou hromadnou HTTP chybu 500, 502 a 503 na stejném kanálu a zpomaluje příjem při 503, dokud se zdraví clusteru neobnoví. Nesmí tyto chyby přesměrovávat na jiné.
Totéž platí, když zápis selže, protože primární shard cílového indexu je na nefunkčním místě (unavailable_shards_exception / HTTP 503): Depositor se pokusí znovu ve stejném pipeline (výchozí retry_errors zahrnuje unavailable_shards_exception) a tyto události neposílá jinam. Čekají v Kafce, dokud Elasticsearch nepřejde na repliku nebo se místo nevrátí. Viz Nastavení nouzového clusteru Elasticsearch.
Pokud toto stále vidíte po upgradu přes opravu, zkontrolujte verzi Depositor a [connection:ESConnection] retry_http_status / throttle_http_status.
Po přetočení trvá obvykle několik minut, než Elasticsearch zobrazí data.
Jakmile uplyne několik minut, zkontrolujte data lmio-tenant-others v sekci Discover v Kibana nebo v UI Discover v LogMan.io. Pokud žádná relevantní data nejsou, zkontrolujte téma others.tenant v Kafka UI. Chybové hlášky v logu by měly být dostatečně konkrétní, aby popsaly, proč nebylo možné data uložit do Elasticsearch. Obvykle to znamená, že je používáno nesprávné schéma. Viz sekce Event Lane nebo krok 8 v sekci Migrace.
Pro pokročilé uživatele: Když nastavíte prioritu šablony indexu v backup-lmio-tenant-events-eventlane-template (z kroku 4 v Migraci) z 0 na 2 nebo vyšší a provedete převrácení indexu, tato stará záložní šablona indexu bude použita k vytvoření nových indexů, zatímco nová šablona indexu vytvořená Depozitářem bude ignorována. To by vám mělo poskytnout více času na vyšetření problému v produkčních prostředích. Nezapomeňte potom snížit prioritu v backup-lmio-tenant-events-eventlane-template zpět na 0.
Úložiště SSD se kvůli Elasticsearchu plní
V tomto případě je potřeba upravit politiku životního cyklu v daném deklaraci event lane (například fortigate.yaml), aby se data přesunula z fáze hot do fáze warm dříve. Ve výchozím nastavení se data stávají teplými (warm) za 3 dny. Pro více informací o tom, jak nastavit vlastní politiku životního cyklu, viz sekce Event Lane.
Jaká je maximální velikost indexu a jak ji mohu změnit?
Výchozí životní politika selhání vkladatele má limit 16 GB na primární shard na index, takže výchozí maximální velikost indexu je tedy 1 shard * 16 GB * 2 pro repliku = 32 GB na index.
Chcete-li změnit maximální velikost indexu, musíte uvést vlastní životní cyklus v rámci deklarace event lane (například fortigate.yaml), kde specifikujete atribut max_primary_shard_size. Pro více informací o nastavení vlastního životního cyklu viz sekce Event Lane.
Existuje pouze index lmio-tenant-events bez číselného postfixu a není propojen s žádnou životním cyklem politiky
Každý index spravovaný vkladatelem musí končit na -00000x, například lmio-tenant-events-eventlane-000001.
Pokud tomu tak není, zkontrolujte prosím jak Docker logy, tak souborové logy (pokud jsou souborové logy nakonfigurovány). K Docker logům lze přistoupit pomocí následujícího příkazu:
docker logs -f -n 1000 <lmio-depositor>
Varování
Neexistuje jednoduchý způsob, jak přejmenovat existující index s názvem lmio-tenant-events, který nemá žádnou životní politiku, na lmio-tenant-events-eventlane-000001. Proto zastavte Depositor, smažte index lmio-tenant-events a poté znovu spusťte Depositor. Při každém restartu Depositoru vždy kontrolujte protokoly.
Existuje index s "Chybou životního cyklu indexu" a "no_node_available_exception", co se stalo?
Tento problém obvykle nastává, když je Elasticsearch restartován během fáze zmenšování indexu. Přesná zpráva je pak: NoNodeAvailableException[cidly se nenašel žádný uzel, na který by bylo možné přiřadit index [myindex] před zmenšením]
Aby bylo možné problém vyřešit:
-
V Kibana přejděte na Správa > Správa stacku > Správa indexů, poté na Indexy a vyberte svůj index kliknutím na jeho název.
-
V detailu indexu klikněte na Upravit nastavení.
-
Uvnitř nastavte následující hodnoty na null:
index.routing.allocation.require._name: null
index.routing.allocation.require._id: null
-
Klikněte na Uložit.
-
Přejděte na Správa > Nástroje pro vývojáře a spusťte následující příkaz, přičemž
myindexnahraďte názvem svého indexu:
POST /myindex/_ilm/retry
- Vraťte se do Správa stacku > Správa indexů, Indexy a zkontrolujte, zda chyba ILM u daného indexu zmizela.
V others je mnoho záznamů a nemohu najít ty, které mají atribut interface
Kafka Console Consumer lze použít k získávání událostí z více témat, zde ze všech témat začínajících na events.
Dále můžete vyhledat pole v uvozovkách:
/usr/bin/kafka-console-consumer --bootstrap-server localhost:9092 --whitelist "events.*" | grep '"interface"'
Tento příkaz vám poskytuje všechny příchozí záznamy s atributem interface ze všech témat events.
Others Schema
Others schéma určuje schéma pro chyby, které nastaly během procesu parsování nebo ukládání. Je odvozeno z pojmenování schéma ECS.
---
define:
name: Others Schema
type: lmio/schema
fields:
_id:
type: "str"
representation: "base85"
docs: Unikátní identifikátor události, kódovaný ve formátu base85
'@timestamp':
type: "datetime"
docs: Časová značka, kdy došlo k ostatní události (to by mělo být aktuální čas)
event.ingested:
type: "datetime"
docs: Časová značka, kdy byla událost přijata
event.created:
type: "datetime"
docs: Časová značka, kdy byla událost vytvořena
event.original:
type: "str"
elasticsearch:
type: "text"
docs: Původní nezparsovaná zpráva události
event.dataset:
type: "str"
docs: Název datasetu pro událost
error.code:
type: "str"
docs: https://www.elastic.co/guide/en/ecs/current/ecs-error.html#field-error-code
error.id:
type: "str"
docs: Unikátní identifikátor chyby
error.message:
type: "text"
elasticsearch:
type: "text"
docs: Podrobnosti chybové zprávy
error.stack_trace:
type: "text"
elasticsearch:
type: "text"
docs: Informace o zásobníku chyb (stack trace)
error.type:
type: "str"
docs: Typ chyby
tenant:
type: "str"
docs: Identifikátor pro tenanta
Interní struktura Depositoru
Překladová tabulka
Překladová tabulka z typů SP-Lang na typy ElasticSearch je součástí repozitáře a kontejneru Depositoru ve lmiodepositor/elasticsearchartifacts/translation_table.json.
Konverze datumu a času
Depositor kontroluje pole v událostech, která mají v schématu typ datetime.
Pokud má pole hodnotu ve formátu SP-Lang datetime integer, datum se převede na formát ISO vhodný pro ElasticSearch.
Před nasazením se ovšem ujistěte, že výše zmíněná překladová tabulka obsahuje správnou definici formátu.
Baseliner
LogMan.io Baseliner
TeskaLabs LogMan.io Baseliner je mikroslužba, která na základě deklarací detekuje odchylku od vypočtené aktivity baseline.
Baseline je soubor vypočtených statistických metrik o aktivitě dané entity v daném časovém období.
Příklady entit: uživatel, zařízení, host server, dataset a podobně.
Analýza porovnává aktuální aktivitu s naučenou baseline pomocí jednoho statistického modelu (baseline.model: normal, poisson nebo negbin). Primární skóre anomálie je vždy !ARG SIGMA na společné normal-equivalent škále rarity. Pro surové hodinové počty událostí preferujte model: negbin (Negative Binomial s automatickým Poisson fallbackem). Viz Definice baseline a Detekce anomálií aktivity uživatele.
Note
Po upgradu baselineru na v24.07-beta nebo novější Baseliner znovu spustí learning fázi. Je to nutné kvůli změně přístupu k databázi. Další updaty z v24.07-beta learning znovu nespouští.
Konfigurace LogMan.io Baselineru
LogMan.io Baseliner vyžaduje následující závislosti:
- Apache ZooKeeper
- NGINX (pro produkční nasazení)
- Apache Kafka
- MongoDB se složkou
/data/dbnamapovanou na SSD (/data/ssd/mongo/data) - Elasticsearch
- SeaCat Auth
- Knihovna LogMan.io se složkou
/Baselinesa schématem ve složce/Schemas
Umístění složky s daty MongoDB
Při používání Baselinera MUSÍ mít MongoDB svou složku s daty umístěnou na SSD/rychlém disku, nikoliv na HDD. Umístění složky s daty MongoDB na HDD povede ke zpomalení všech služeb, které MongoDB používají.
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Apply.
define:
type: rc/model
services:
lmio-baseliner:
instances:
<tenant>-1: # Nahraďte názvem vašeho tenant
node: <node> # Nahraďte názvem uzlu
asab:
config:
tenant:
name: <tenant> # Nahraďte názvem vašeho tenant
Příklad
Toto je nejzákladnější konfigurace požadovaná pro každou instanci LogMan.io Baselineru:
[declarations]
# /Baselines je výchozí cesta
groups=/Baselines
[tenants]
ids=default
[pipeline:BaselinerPipeline:KafkaSource]
topic=^events.tenant.*
[pipeline:OutputPipeline:KafkaSink]
topic=complex.tenant
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[elasticsearch]
url=http://es01:9200/
[mongodb.storage]
mongodb_uri=mongodb://mongodb1,mongodb2,mongodb3/?replicaSet=rs0
mongodb_database=baseliners
[auth]
multitenancy=yes
public_keys_url=http://localhost:8081/openidconnect/public_keys
Zookeeper
Specifikujte umístění serverů Zookeeperu v clusteru:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Hint
Pro neprodukční nasazení je možné použít jediný Zookeeper server.
Knihovna
Specifikujte cestu (cesty) ke Knihovně pro načtení deklarací:
[library]
providers=zk:///library
Hint
Protože je výchozí schéma ECS.yaml ve složce /Schemas, zvažte použití LogMan.io Common Library.
Kafka
Definujte bootstrap servery Kafka clusteru:
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Hint
Pro neprodukční nasazení je možné použít jediný Kafka server.
Elasticsearch
Specifikujte URL hlavních uzlů Elasticsearch.
Elasticsearch je nezbytný pro používání vyhledávání, např. jako výraz !LOOKUP nebo spouštěcí mechanismus vyhledávání.
[elasticsearch]
url=http://es01:9200
username=MYUSERNAME
password=MYPASSWORD
MongoDB
Specifikujte URL MongoDB clusteru s replikou sady.
MongoDB ukládá baseliny a čítače příchozích událostí.
[mongodb.storage]
mongodb_uri=mongodb://mongodb1,mongodb2,mongodb3/?replicaSet=rs0
mongodb_database=baseliners
Auth
Sekce Auth umožňuje multitenance, což omezuje přístup k baselinám pouze na uživatele s přístupem ke specifikovanému tenantovi:
[auth]
multitenancy=yes
public_keys_url=http://localhost:8081/openidconnect/public_keys
Input
Události pro baseliny jsou čteny z Kafka témat:
[pipeline:BaselinerPipeline:KafkaSource]
topic=^events.tenant.*
Deklarace (volitelné)
Definujte cestu pro deklarace baselinu. Výchozí cesta je /Baselines a výchozí záložní schéma je /Schemas/ECS.yaml.
Pokud používáte schéma jiné než ECS (Elastic Common Schema), můžete přizpůsobit cestu ke schématu.
[declarations]
groups=/Baselines
schema=/Schemas/ECS.yaml
Tenanti
Specifikujte tenanta, pro kterého chcete vytvořit baseliny. Můžete uvést více tenantů, oddělených čárkami, ale doporučuje se mít jeden tenant pro jeden baseline.
[tenants]
ids=tenant1
tenant_url=http://localhost:8080/tenant
Doporučuje se provozovat alespoň jednu instanci Baselinera na každého tenanta. Ve většině případů je vhodná jedna instance na tenanta.
Výstup
Pokud jsou použity triggery, můžete změnit výchozí téma pro výstupní pipeline:
[pipeline:OutputPipeline:KafkaSink]
topic=complex.tenant
Web APIs
Baseliner poskytuje jedno webové API.
Webové API je navrženo pro komunikaci s uživatelským rozhraním.
[web]
listen=0.0.0.0 8999
Výchozí port veřejného webového API je tcp/8999.
Tento port je určen k tomu, aby sloužil jako upstream NGINX pro připojení od Kolektorů.
Deklarace pro definování základních linií
Deklarace pro základní linie jsou načítány z Knihovny ze složky určené v konfiguraci, například /Baseliners.
Poznámka
Baseliner ve výchozím nastavení používá /Schemas/ECS.yaml, takže /Schemas/ECS.yaml musí být také přítomen v Knihovně.
Prohlášení
Toto je příklad základní definice, umístěné ve složce /Baseliners v Knihovně:
---
define:
name: Dataset
description: Creates baseline for each dataset and trigger alarms if the actual number deviates
type: baseliner
baseline:
region: Czech Republic
period: day
learning: 4
classes: [workdays, weekends, holidays]
max_history_days: 180 # (optional) Maximum days of counter history to retain
model: negbin
evaluate:
key: event.dataset
timestamp: "@timestamp"
analyze:
when: 1h # How often to perform the analysis (1 hour is the default)
test:
!AND
- !LT
- !ARG VALUE
- 1
- !GT
- !ARG MEDIAN
- 0
- !GT
- !ARG SIGMA
- 5.0
trigger:
  - event:
# Threat description
# https://www.elastic.co/guide/en/ecs/master/ecs-threat.html
threat.framework: "MITRE ATT&CK"
threat.indicator.sightings: !ITEM EVENT value
threat.indicator.confidence: "High"
threat.indicator.name: !ITEM EVENT dimension
- notification:
type: email
to: ["myemail@example.co"]
template: "/Templates/Email/Notification_baseliner_dimension.md"
variables:
name: "Logs are not coming to the dataset within the given UTC hour."
dimension: !ITEM EVENT dimension
hour: !ITEM EVENT hour
Sections
základní úroveň
baseline: # (1)
region: Czech Republic #(2)
period: day # (3)
learning: 4 # (4)
classes: [workdays, weekends, holidays] # (5)
max_history_days: 180 # (6)
model: normal # (7)
- Defines how the given baseline is built.
- Defines in which region the activity is happening (for calculating holidays and so on).
- Defines the timespan for the baseline. The period can be either
dayorweek. - Defines the number of periods (here day) that occur from the baseliner beginning to receive input until the user can see the baseline analysis. Additional details below.
- Define which days in the week we want to monitor. Classes can include any/all:
workdays,weekends, andholidays. max_history_days(optional): Maximum number of days of counter history to retain for baseline building. Counter records older than this limit are automatically deleted to prevent memory leaks and excessive storage usage. If not specified, defaults to the configuration valuemax_baseline_history_days(default: 60 days if not configured). This parameter helps manage long-term data retention while ensuring sufficient history for accurate baseline calculations. Optionalmax_history_days_per_classoverrides the window per temporal class (see below).model(optional): Statistical model used when scoring the current hour against the learned mean and variance. One ofnormal(default),poisson, ornegbin(Negative Binomial with automatic Poisson fallback). See Statistical model.
learning
Pole learning definuje fázi učení.
Fáze učení je čas od prvního výskytu hodnoty dimenze ve vstupu instance Baseliner až do okamžiku, kdy je uživateli zobrazena základní linie a proběhne analýza. V deklaraci je learning počet období. Fáze učení se počítá zvlášť pro svátky, víkendy a pracovní dny. Základní linie jsou obnovovány přes noc (údržba).
V tomto příkladu je period den, takže learning je 4 dny. S ohledem na kalendář znamená fáze učení trvající 4 dny začínající v pátek 4 pracovní dny, a tedy končí ve středu večer.
max_history_days
Pole max_history_days určuje maximální počet dní historie čítače, které se mají uchovávat pro tvorbu základní linie. Tento parametr pomáhá předcházet únikům paměti a nadměrnému využívání úložiště tím, že automaticky maže záznamy čítače starší než je stanovený limit.
- Výchozí chování: Pokud není uvedeno v deklaraci základní linie, systém používá konfigurační hodnotu
max_baseline_history_daysz konfigurace baselineru (výchozí: 60 dní, pokud není nakonfigurováno). - Automatické čištění: Během sestavování základní linie (obvykle přes noc) jsou záznamy čítače starší než
max_history_daysautomaticky odstraněny z MongoDB. - Dopad na základní linii: Pro výpočty základní linie se používají pouze záznamy čítače v rámci okna
max_history_days. Starší data jsou vyloučena, aby byla základní linie relevantní vůči nedávným vzorcům aktivit. - Doporučení: Nastavte tuto hodnotu podle požadavků na základní linii. Například:
- 60–90 dní: Vhodné pro většinu případů použití, poskytuje dobrý poměr mezi historií a výkonem
- 180 dní (6 měsíců): Pro základní linie vyžadující dlouhodobé vzorce, například sezónní změny
- 30 dní: Pro prostředí s vysokým objemem, kde je omezená kapacita úložiště
Správa úložiště
Parametr max_history_days je obzvláště důležitý pro baseliny s vysokým objemem nebo pro dlouhodobě běžící systémy. Bez tohoto omezení se mohou záznamy počítadla hromadit neomezeně, což vede ke zvýšenému využití úložiště a pomalejším výpočtům baselinu.
max_history_days_per_class (volitelné)
Přepište okno historie pro jednotlivé časové třídy. workdays a weekends mají výchozí hodnotu max_history_days. holidays má výchozí hodnotu 400 dní (~13 měsíců), takže celý rok státních svátků se vejde, pokud je globální okno 60 dní. Uchovávání počítadel používá nejdelší nastavené okno.
baseline:
max_history_days: 60
# optional override; holidays already default to 400:
# max_history_days_per_class:
# holidays: 400
merge_holidays_into_weekends (volitelné, výchozí false)
Pokud je nastaveno na true, státní svátky v kalendáři jsou klasifikovány jako víkendy pro tvorbu a analýzu základního mixu. Použijte toto nastavení, pokud jsou svátky příliš vzácné na samostatnou třídu v okně historie (běžné u max_history_days: 60). Preferujte kombinaci classes: [workdays, weekends] spolu s tímto přepínačem.
baseline:
classes: [workdays, weekends]
merge_holidays_into_weekends: true
Statistický model
baseline.model vybírá jeden pravděpodobnostní model pro analýzu aktuální hodiny. Vypočítávají se pouze skóre toho modelu.
Výběr modelu
| Model | Doporučené použití | Vhodné příklady |
|---|---|---|
normal (default) |
Přibližně symetrické spojené hodnoty, zejména podepsaná měření, nekoncentrovaná poblíž tvrdé hranice | Chyba měření nebo reziduum, posun hodin, odchylka teploty od nastaveného bodu, odchylka frekvence nebo napětí od nominální hodnoty |
poisson |
Počty událostí s relativně stabilní odchylkou kolem jejich průměru | Pravidelná plánovaná činnost, stabilní počet transakcí, periodické stavové události |
negbin |
Počet událostí, které jsou nárazové nebo více proměnlivé než Poisson, mohou reprezentovat | Objemy záznamů, autentizační události, síťové události |
Pokyny: použijte normal pro přibližně symetrická spojitá měření. Použijte poisson nebo negbin pro počet událostí. Pokud modelujete hrubé počty událostí a nejste si jisti, zda je vhodný Poisson, použijte negbin: je to Negative Binomial model počtů s automatickým přepnutím na Poisson pro profily, které nevykazují dostatečnou overdisperzi.
Nepoužívejte normal pro surové počty událostí. Normální model může někdy přiblížit ohraničená nebo zkosená data mimo hranici, ale počty blízko nule jsou lépe řešeny pomocí poisson nebo negbin.
baseline:
region: Czech Republic
period: week
learning: 2
classes: [workdays, weekends, holidays]
model: negbin
Pochopení výstupů analýzy
Konfigurace (baseline.*) určuje, jak je baseline vytvořena a který model hodnotí aktuální hodinu. Níže uvedené atributy jsou vypočítané hodnoty dostupné v analyze.test.
| Atribut | Laskavý | Význam |
|---|---|---|
VALUE |
Pozorování | Aktuální aktivita pro toto analytické okno (počet událostí nebo norma vektoru při aggregation: vector) |
MEAN, STDEV, VARIANCE, MEDIAN, MIN, MAX, SUM |
Naučená historie | Souhrnné statistiky srovnatelných minulých hodin pro stejnou třídu |
SIGMA |
Skóre modelu | Velikost anomálie na běžné normálně-ekvivalentní škále vzácnosti (viz níže) |
DIRECTION |
Skóre modelu | Zda je pozorování nezvykle nízké, vysoké nebo ani jedno (viz níže) |
LOG_P0 |
Skóre modelu | Přirozený logaritmus P(X ≤ 0) podle nastaveného modelu (viz níže) |
MODEL |
Kontext | Nakonfigurovaný název modelu (normal, poisson nebo negbin) |
HOUR, KEY, CLASS, TENANT |
Kontext | Slot, který je analyzován |
SIGMA
SIGMA vyjadřuje, jak vzácný je pozorovaný jev podle nakonfigurovaného modelu, na běžné škále ekvivalentní normálnímu rozdělení. Větší hodnota znamená vzácnější pozorování.
- S
model: normalse jedná o konvenční absolutní z-skóre|VALUE − MEAN| / STDEV. - S
model: poissonnebomodel: negbinje pravděpodobnost pozorovaného počtu převedena na ekvivalentní jednostranné normální z-skóre.
To umožňuje zachovat použitelnost existujících prahů SIGMA napříč modely, i když se liší základní pravděpodobnostní model.
Jednostranná pravděpodobnost ocasu popisuje pozorování, která jsou alespoň stejně extrémní v jednom určeném směru. U pravidla nezávislého na směru je pravděpodobnost dosažení stejné vzácnosti v jakémkoli ocasu přibližně dvojnásobkem jednostranné pravděpodobnosti:
SIGMA |
Jednostranná pravděpodobnost ocasu | Pravděpodobnost obou ocásků | Přibližná frekvence s hodinovým vyhodnocením |
|---|---|---|---|
| 3 | 1.35×10⁻³ | 2.70×10⁻³ | jednou za 370 hodin (~dvakrát za měsíc) |
| 4 | 3.17×10⁻⁵ | 6.33×10⁻⁵ | jednou za 15 800 hodin (~jednou za 1,8 roku) |
| 5 | 2.87×10⁻⁷ | 5.73×10⁻⁷ | jednou za 1,74 milionu hodin (~jednou za 199 let) |
Například SIGMA = 3 znamená jednostrannou pravděpodobnost v ocasu přibližně 0.00135. Hodnota alespoň takto neobvyklá v kterémkoli směru má pravděpodobnost přibližně 0.0027, což je zhruba jeden výskyt na 370 hodnocení. Při hodinovém hodnocení to je v průměru asi dvakrát za měsíc.
Jedná se o pravděpodobnostní ekvivalence, nikoli o předpovědi běžného rozvrhu. Interpretace frekvence předpokládá, že model je dobře kalibrován a že porovnatelné evaluační intervaly jsou dostatečně nezávislé. Směrové pravidlo, jako například DIRECTION: LOW, používá jednostrannou pravděpodobnost; pravidlo, které se zaměřuje na stejně extrémní hodnoty v obou směrech, používá oboustrannou pravděpodobnost.
Začněte s prahovými hodnotami kolem 5, když jsou falešně pozitivní výsledky nákladné; použijte 4, pokud je důležitější dřívější detekce. Prahovou hodnotu zvyšte, pokud jsou upozornění příliš hlučná.
SMĚR
LOW— pozorovaná hodnota je neobvykle nízkáHIGH— pozorovaná hodnota je neobvykle vysokáNEUTRAL— pozorování není jasně spojeno s žádnou stranou rozdělení
SIGMA popisuje velikost anomálie; DIRECTION popisuje, zda je na nízké nebo vysoké straně základní hodnoty. To usnadňuje psaní pravidel, která rozlišují ticho od náhlých nárůstů provozu.
MODEL
MODEL uvádí konfigurovaný statistický model. Při model: negbin může individuální základní profil interně použít Poissonovu náhradu, když není přítomna nadměrná disperze.
LOG_P0
LOG_P0 = ln(P0) kde P0 = P(X ≤ 0) podle nakonfigurovaného modelu.
- U modelů počtu událostí (
poisson,negbin) je to pravděpodobnost pozorování nulového počtu událostí. - U
normalje to pravděpodobnost, že hodnota spadne na nebo pod nulovou hranici (pro spojitá data platíP(X ≤ 0)stejně jakoP(X < 0)).
Více záporných hodnot znamená, že dosažení nuly je při normálním provozu méně pravděpodobné. U většiny detekčních pravidel upřednostněte SIGMA; použijte LOG_P0, když potřebujete přesný pravděpodobnostní práh nebo bayesovskou posteriéri pravděpodobnosti výpadku.
LOG_P0 |
P0 |
Rovnocenné SIGMA při nule |
|---|---|---|
| −6.61 | ≈ 1.35×10⁻³ | 3 |
| −10.36 | ≈ 3.17×10⁻⁵ | 4 |
| −15.06 | ≈ 2.87×10⁻⁷ | 5 |
Pro vektorové základní linie a kódy událostí na hostitelích Windows viz Detekce anomálií uživatelské aktivity.
Detekce ticha nebo výpadku
Hlavní vzorec používá VALUE, MEDIAN a SIGMA:
baseline:
model: negbin
analyze:
test:
!AND
- !LT
- !ARG VALUE
- 1
- !GT
- !ARG MEDIAN
- 0
- !GT
- !ARG SIGMA
- 5.0
Toto se spustí, když je aktuální hodina tichá, srovnatelné historické hodiny obvykle nejsou prázdné (MEDIAN > 0) a ticho je výjimečně neobvyklé podle konfigurovaného modelu počtu. SIGMA = 5 je konzervativní výchozí příklad; snižte ji (například na 4), pokud je důležitější dřívější detekce, nebo ji zvyšte, pokud je příliš mnoho falešně pozitivních výsledků. Použijte výše uvedenou tabulku vzácnosti k interpretaci přibližné hodinové frekvence této volby.
Profily s MEDIAN == 0 (historicky často tiché) by obvykle neměly automaticky upozorňovat; výše uvedená ochrana MEDIAN to řeší.
Pokročilé: pravidla výpadků založená na pravděpodobnosti
Baseliner nevypočítává Bayesovský posterior výpadku. LOG_P0 popisuje, jak překvapivý je ticho během zdravého provozu. Posterior také závisí na tom, jak běžné jsou výpadky a jak spolehlivě výpadek způsobí úplné ticho.
Nechť:
O— sledovaný zdroj je v režimu výpadkuH— funguje normálněq = P(O)— apriorní pravděpodobnost, že srovnatelné hodnotící okno je ovlivněno výpadkemr = P(X=0 | O)— pravděpodobnost pozorování žádných událostí během výpadkup0 = P(X=0 | H)— pravděpodobnost nulového počtu událostí podle nakonfigurovaného modelu zdravého stavu (exp(LOG_P0)pro modely počtu)
Po pozorování nulových událostí:
P(O | X=0) = (q · r) / (q · r + (1 − q) · p0)
Předchozí q by mělo představovat výskyt výpadků na srovnatelné časové okno analýzy, nikoli libovolné nastavení důvěry. Pro úplný výpadek zdroje může být r = 1 rozumné; pro částečné nebo přerušované výpadky je realističtější r < 1.
Pro požadovaný posteriorní práh a se podmínka převádí na práh pro pravděpodobnost nulového stavu zdraví:
P(O | X=0) ≥ a ⇔ p0 ≤ (q · r · (1 − a)) / (a · (1 − q))
LOG_P0 ≤ ln( (q · r · (1 − a)) / (a · (1 − q)) )
Příklad. Předpokládejme q = 0,001, úplné ticho během výpadku (r = 1) a požadovaný posterior a = 0,95. Pak p0 ≤ 5,2684×10⁻⁵ a LOG_P0 ≤ −9,8512. Při VALUE = 0 je to přibližně SIGMA ≥ 3,878. Praktické pravidlo může použít více přístupné rozhraní SIGMA:
analyze:
test:
!AND
- !EQ
- !ARG VALUE
- 0
- !GE
- !ARG SIGMA
- 3.878
Prahová hodnota platí pouze pro uvedené předpoklady. Pokud se q nebo r změní, přepočítejte ji. Při nulové hodnotě jsou SIGMA, LOG_P0 a posteriorní pravděpodobnost monotónní transformace stejného důkazu modelu pro pevné q a r — nejde o tři nezávislé signály.
zdroj protokolu (volitelné)
Sekce logsource určuje typy událostních kanálů, ze kterých by měly být příchozí události čteny. Používá se k třídění zdroje záznamů a je odvozen z Sigma pravidel.
logsource:
vendor:
- microsoft
product:
- windows
Sekce logsource může obsahovat:
vendor: Dodavatel zdroje protokolu (např.microsoft,linux,cisco)product: Název produktu (např.windows,exchange,fortigate)service(volitelné): Název služby (např.syslog,audit,activitylogs)
Každé pole přijímá seznam hodnot. Události z událostních pruhů, které odpovídají některé ze specifikovaných hodnot dodavatele, produktu nebo služby, budou zohledněny pro základní linii.
!!! příklad "Příklad: Základní nastavení událostí Windows"yaml
logsource:
vendor:
- microsoft
product:
- windows
This configuration will process events from event lanes that are categorized as Microsoft Windows logs.
!!! příklad "Příklad: Více produktů"yaml
logsource:
vendor:
- microsoft
product:
- windows
- exchange
- office365
This configuration will process events from Microsoft Windows, Exchange, or Office 365 event lanes.
signál (volitelný)
Volitelná sekce signal kontroluje, zda základní linie (baseline) odesílá signál do Správy upozornění a jak jsou tikety seskupovány. Použijte signal: default: false, když je základní linie určena pouze pro analýzu nebo jako vstup pro korelaci (bez přímého vytváření tiketů). Použijte signal: grouping:, abyste nastavili, které atributy se používají pro seskupování tiketů. Podrobnosti naleznete v Signal.
predikát (volitelný)
Sekce predicate filtruje příchozí události, aby byly považovány za aktivitu v základní úrovni.
Pište filtry pomocí TeskaLabs SP-Lang. Podrobnosti najdete v sekci Predikáty nebo v dokumentaci SP-Lang.
Kombinace logsource a predicate
Sekce logsource filtruje události na úrovni řetězce událostí (které řetězce událostí číst), zatímco sekce predicate filtruje jednotlivé události v těchto řetězcích. Oba filtry se aplikují, takže událost musí splňovat jak kritéria logsource, tak výraz predicate, aby byla zahrnuta do základní linie.
hodnotit
Tato sekce specifikuje, které atributy z události budou použity ve výchozí sestavě.
evaluate:
key: event.dataset # (1)
timestamp: "@timestamp" # (2)
- Určuje atribut/entity, kterou je třeba sledovat.
- Určuje atribut, ve kterém je uložen časový rozměr aktivity události.
key_aliases (volitelné, od verze v25.47.02)
V sekci evaluate můžete přidat key_aliases pro mapování hodnot dimenzí na jediný klíč. To normalizuje různé hodnoty událostí, takže jsou počítány pod jedním klíčem dimenze.
evaluate:
key: myuser
key_aliases:
myuser1: myuser
myuser2: myuser
myuser3: myuser
timestamp: "@timestamp"
- Událost s
myuser: "myuser1"je započítána pod klíčemmyuser. - Událost s
myuser: "myuser2"je také započítána pod klíčemmyuser. - Hodnoty, které nejsou uvedeny v
key_aliases, zůstávají nezměněny (např.myuser4zůstávámyuser4).
Přezdívky se aplikují na všechny typy hodnot dimenzí (řetězec, celé číslo, seznam po spojení, IP po převodu): hodnota je převedena na řetězec a poté se aplikuje mapování key_aliases.
analyzovat
Sekce test v analyze určuje, kdy spustit spouštěč, pokud se skutečná aktivita (!ARG VALUE) odchýlí od základní hodnoty. Testy pište v SP-Lang.
Během analýzy Baseliner porovnává aktuální aktivitu pro daný rozměr (klíč), hodinu a časovou třídu (pracovní dny, víkendy, svátky) se získanými statistikami pro stejný časový úsek.
Ve výchozím nastavení (analyze.when: 1h) watcher běží přibližně jednou za hodinu a hodnotí předchozí dokončenou UTC hodinu vůči čítačům uloženým v té době. Spouštěče se aktivují pouze, pokud analyze.test pro tento snímek projde. Tato hodina není později znovu analyzována.
Vypočtené skóre (SIGMA, DIRECTION, LOG_P0, MODEL) a výběr modelu jsou popsány v sekci Statistical model. Vzor ticha / výpadku s využitím VALUE, MEDIAN a SIGMA je doporučeným výchozím bodem pro počítané základy.
Pozdní události vs. uživatelské rozhraní analýzy
API pro základní hodnoty (a analýza grafu v uživatelském rozhraní) přepočítává SIGMA pro historické hodiny z čítačů, které existují nyní. To se může lišit od toho, co pozorovatel viděl, když byla hodina uzavřena.
Příklad. Základní nastavení hostitele používá model: negbin a !GT !ARG SIGMA 5. Krátce po 11:00 UTC analyzuje watcher období 10:00–11:00. Pokud jsou události za tuto hodinu v pipeline stále zpožděné, je čítač stále 0, takže SIGMA zůstává nízká a nevytvoří se žádná složitá událost ani signál. Později stejná hodina ukazuje v UI actual: 95 a SIGMA: 100 — čítače dorazily po analýze. Watcher se pro tuto hodinu již nespustí znovu, takže se zpětně žádné upozornění nevytvoří.
Při vyšetřování chybějícího upozornění porovnejte záznamy sledovače za tu hodinu s tím, zda čítače již existovaly v době analýzy; vysoké SIGMA v grafu samotném neznamená, že spouštěč běžel.
Příklad: absolutní prahy
analyze:
test:
!AND #(1)
- !LT #(2)
- !ARG VALUE # (3)
- 1
- !GT # (4)
- !ARG MEAN # (5)
- 10.0
- Všechny výrazy zanořené pod
ANDmusí být pravdivé, aby test prošel. Zde, pokud je hodnota menší než 1 a průměr je větší než 10, spustí se spouštěč. - „Menší než“
- Získej (
!ARG) hodnotu (VALUE). Pokud je hodnota menší než1, jak je specifikováno, výraz!LTje pravdivý. - „Větší než“
- Získej (
!ARG) průměr (MEAN). Pokud je průměr větší než10.0, jak je specifikováno, výraz!GTje pravdivý.
Příklad: práh sigma (špička nebo ticho)
baseline:
model: negbin # or normal / poisson
analyze:
when: 1h
test:
!GT
- !ARG SIGMA
- 5
Kombinujte s DIRECTION, když vás zajímá pouze jedna strana (například hroty):
analyze:
test:
!AND
- !EQ
- !ARG DIRECTION
- HIGH
- !GT
- !ARG SIGMA
- 5
Ticho / příklad stažení datového souboru (stejně jako v Detekce ticha nebo výpadku):
baseline:
model: negbin
analyze:
test:
!AND
- !LT
- !ARG VALUE
- 1
- !GT
- !ARG MEDIAN
- 0
- !GT
- !ARG SIGMA
- 5.0
Dostupné atributy !ARG
Následující atributy jsou dostupné v notaci SP-Lang uvnitř analyze.test:
TENANT: "str",
VALUE: "ui64",
STDEV: "fp64",
MEAN: "fp64",
SIGMA: "fp64",
DIRECTION: "str",
LOG_P0: "fp64",
MODEL: "str",
MEDIAN: "fp64",
VARIANCE: "fp64",
MIN: "ui64",
MAX: "ui64",
SUM: "ui64",
HOUR: "ui64",
KEY: "str",
CLASS: "str",
Možnost when určuje, jak často provádět analýzu.
spoušť
Sekce trigger definuje aktivitu, která se spustí po úspěšné analýze. (Více o triggerech.)
Baseliner vytváří události
Při každé analýze (každou hodinu) Baseliner vytvoří událost, která shrnuje jeho analýzu. Tyto události vytvořené Baselinerem jsou k dispozici k použití (jako EVENT) s výrazy jako !ARG a !ITEM, což znamená, že z událostí můžete získávat hodnoty pro své spouštěcí aktivity.
Tyto události vytvořené Baselinerem zahrnují pole:
nájemce Jméno nájemce, ke kterému základní úroveň patří.
rozměr
Rozměr, ke kterému základní linie patří, jak je určeno v evaluate.
třída
Třída, ze které byla vypočítána základní hodnota.
Možnosti zahrnují: pracovní dny, víkendy a svátky
hodina Počet UTC hodiny, ve které analýza proběhla.
hodnota Hodnota aktuálního čítače událostí pro danou hodinu UTC.
Analytické skóre pro stejnou událost (použitelné přes !ITEM EVENT …) zahrnuje mean, stdev, sigma, direction, log_p0 a model.
Spouštěč oznámení
Spouštěč oznámení odesílá zprávu, například e-mail. Podrobnější informace o odesílání e-mailových oznámení a používání e-mailových šablon naleznete v části E-mailová oznámení.
Příklad spouštěče oznámení:
trigger:
- notification:
type: email #(1)
to: ["myemail@example.co"] # (2)
template: "/Templates/Email/Notification_baseliner_dimension.md" # (3)
variables: # (4)
name: "Logs are not coming to the dataset within the given UTC hour."
dimension: !ITEM EVENT dimension # (5)
hour: !ITEM EVENT hour
- Určuje emailové upozornění
- Adresa příjemce
- Cesta k souboru šablony emailu v knihovně LogMan.io
- Začíná sekci, která poskytuje pokyny, jak vyplnit prázdná pole v emailové šabloně. Prázdná pole v šabloně používané v tomto příkladu jsou
name,dimensionahour. - Používá SP-Lang k získání informací (
!ITEM) z Baselinerem vytvořenéhoEVENT(podrobněji níže). V tomto případě bude pole šablonydimensionvyplněno hodnotoudimensionpřevzatou z Baselinerem vytvořeného eventu.
Spouštěč události
Můžete použít spouštěč události k vytvoření záznamu nebo události, kterou budete moci vidět v rozhraní TeskaLabs LogMan.io.
Příklad spouštěče události:
- event: # (1)
threat.framework: "MITRE ATT&CK"
threat.indicator.sightings: !ITEM EVENT value
threat.indicator.confidence: "High"
threat.indicator.name: !ITEM EVENT dimension
- Tato nová událost je popis hrozby používající pole hrozby z Elasticsearch
Analýza v uživatelském rozhraní
Ve výchozím nastavení poskytuje uživatelské rozhraní LogMan.io zobrazení analýz pro user a host.
Určete analýzu ve schématu (výchozí: /Schemas/ECS.yaml) takto:
host.id:
type: "str"
analysis: host
user.id:
type: "str"
analysis: user
...
Pokud je pak nájemce nakonfigurován tak, aby používal tento schéma (ECS ve výchozím nastavení), pole host.id a user.id v Discover budou zobrazovat odkaz na danou referenční hodnotu.
Analýza host používá ve výchozím nastavení základní linii nazvanou Host:
---
define:
name: Host
Analýza user ve výchozím nastavení používá základní linii nazvanou User:
---
define:
name: User
Pokud konkrétní analýza nemůže najít svůj přidružený základní vzor, uživatelské rozhraní zobrazí pro tuto analýzu prázdnou obrazovku.
Poznámka
Obě základní linie potřebné pro analýzu jsou distribuovány jako součást Knihovny LogMan.io Common Library.
Aktiva
LogMan.io Assets
TeskaLabs LogMan.io Assets (lmio-assets) je mikroservis, který udržuje inventář aktiv pro jednotlivé nájemce: hostitele, uživatele a služby identifikované hlavními poli ze schématu nájemce. Inventář zpřístupňuje přes HTTP (výchozí tcp/8965) a uchovává dokumenty v MongoDB.
Služba spotřebovává dva Kafka streamy na každého nájemce:
| Potok | Zdroj | Vliv na aktiva |
|---|---|---|
| Aktivita | Téma aktivity Parsec (ve výchozím nastavení events.<tenant>.activity) |
Aktualizace first_seen / last_seen, volitelné značky z dat o aktivitě |
| Složitý | Výstup korelátoru na lince složitých událostí nájemce (events.<tenant>.complex ve výchozím nastavení) |
Aktualizuje skóre rizika entity pomocí modelu s časovým útlumem (viz Skóre rizika entity) |
Aktivita a složité zpracování sdílejí stejnou spotřebitelskou skupinu (lmio_assets ve výchozím nastavení). Názvy témat a mapování polí schématu se obnovují při změně Knihovny pod /EventLanes/ nebo /Schemas/.
Dokument aktiva
Každý řádek aktiva používá Mongo _id {tenant}:{kind}:{value}, kde kind je host, user nebo service.
| Pole | Význam |
|---|---|
tenant, kind, value |
Identita (zrcadlí části _id) |
first_seen, last_seen |
Unix ms z hlavního pole data a času schématu na událostech aktivit |
risk_score |
Celé číslo představující skóre rizika entity (rozpadá se při čtení; viz Rozpad skóre rizika) |
alert_after |
Volitelný práh upozornění na zastaralá data v sekundách (HTTP API); když je ≥ 1, je to také okno pro aktivní |
active |
Vypočítáno (není uloženo): true, když now − last_seen ≤ threshold (viz níže) |
Uživatelem definované štítky se nacházejí v samostatné kolekci tags (ve výchozím nastavení asset_tags) se stejným _id jako majetek.
Filtr štítků a událostí
Štítky jsou volně definované páry klíč/hodnota na sidecaru (například label → prod). Používejte je pro seskupování aktiv a pro omezení Discover nebo Chart na tyto principy.
| Cíl | Koncový bod |
|---|---|
| Vypsat aktiva podle štítku | GET /{tenant}/asset?atag=field:value |
| CSV export označených aktiv | GET /{tenant}/asset/export?atag=field:value |
| Objevte / Filtr grafu pro jejich události | GET /{tenant}/asset/events-filter?atag=field:value |
- Preferovaný parametr dotazu:
atag=field:value(napříkladatag=label:prod). Samotná hodnota používá poletags. - Volitelný
akind/kindomezuje nahost,usera/neboservice. - Porovnávání je v aplikačním kódu nerozlišující velikost písmen (ne v Mongo
$regex). events-filterne dotazuje Elasticsearch. Vracídata.filterv jazyce filtrů Discover (napříkladhost.id:(a, b) OR user.id:(…)). Graf může toto automaticky aplikovat, když datový zdroj Elasticsearch nastavíspecification.asset_tag. Viz Události pro aktiva podle tagu.
Vyžaduje lmio:asset:access.
Aktivní vs neaktivní
Seznam, detail a export do CSV používají stejné pravidlo jako zelená/červená ikona Aktivita v webovém rozhraní:
active ⇔ (now_ms − last_seen_ms) ≤ threshold_sec × 1000
alert_after on the document |
Prah |
|---|---|
| Celé číslo ≥ 1 | Ta hodnota (v sekundách), stejné okno jako Zastaralé po (upozornění) |
Chybí, null nebo < 1 (upozornění odstraněno / vypnuto) |
7 dní (604800 s) |
Chybějící nebo neplatný last_seen → neaktivní (active: false).
Tento odznak je nezávislý na nonactive / nonactive_since (ty označují, že byl již odeslán zastaralý signál up do Správy upozornění). Vymazání Stale after (alert) zastaví tikety, ale aktivum může stále být zobrazováno jako neaktivní po 7 dnech bez aktivity.
Pro analytiky: Správa aktiv - Aktivní vs neaktivní.
Zastaralé signály aktiv
Když alert_after ≥ 1 a aktivum zůstane delší dobu neaktivní než toto období, StaleAssetAlertService vysílá signál Správy upozornění (direction: up). Na up obsahuje signál attributes sekundy bez aktivity ve schématu označeném tímto způsobem (sourozenec pole alert:):
event.duration:
type: fp64
format: humanize
alert:
grouping:
method: log10
description: Groups large values into magnitude buckets
asset:
inactive_seconds: true
Pokud žádné pole není označeno, atribut délky trvání je ze signálu vynechán. Obnova používá direction: down (stejný titul/skupina; bez atributu délky trvání).
Pro analytiky: Správa aktiv - Upozornění na neaktivní aktiva.
Související dokumentace
- Konfigurace: model, nastavení ASAB
[assets], knihovna/Assets/Defaults/(výchozíalert_after),/Assets/Skip/, oznámení o nových aktivech - Skóre rizik entity: co analytici vidí v aktivech, chování rozpadu, volitelná váha skóre rizika
- Správa aktiv (Manuál analytika): uživatelské rozhraní inventáře, značky, zastaralá upozornění, oznámení
- Zdrojová data grafu: události podle značky aktiva: Discover omezeno na hostitele / uživatele / služby s označením
- Správa aktiv Parsec: produkce aktivity streamu a
parsec.asset.skip - Skórování rizik v Correlatoru:
event.risk_scorepro jednotlivá detekce u složitých událostí - Kafka témata:
events.<tenant>.activity - Síťové porty:
lmio-assetsna tcp/8965
LogMan.io Assets configuration
LogMan.io Assets vyžaduje následující závislosti:
- Apache ZooKeeper
- Apache Kafka
- MongoDB
- SeaCat Auth
- Knihovna LogMan.io s
/EventLanes/(aktivity a komplexní dráhy) a schématy nájemců v/Schemas/ - LogMan.io Watcher (volitelné, pro vyhledávání váhy rizikového skóre pro jednotlivé zdroje)
Model
Zahrňte službu do modelu stránky a klikněte na Použít:
define:
type: rc/model
services:
lmio-assets:
instances:
<tenant>-1:
node: <node>
asab:
config:
tenant:
name: <tenant>
Příklad
Minimální konfigurace ASAB:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[asab:storage]
type=mongodb
mongodb_uri=mongodb://mongodb1,mongodb2,mongodb3/?replicaSet=rs0
mongodb_database=assets
[auth]
multitenancy=yes
public_keys_url=http://seacat-auth.service_id.asab/.well-known/jwks.json
[pipeline:ActivityAssetsPipeline:KafkaSource]
group.id=lmio_assets
[pipeline:ComplexAssetsPipeline:KafkaSource]
group.id=lmio_assets
Témata nejsou v INI pevně zadána: po připravení knihovny služba objeví každý tenantův soubor activity.yaml a complex.yaml a přihlásí se k jejich tématům událostí v Kafka.
Zprávy o aktivitě jsou generovány LogMan.io Parsec IndicatorOfActivityProcessor (hlavní host.id / user.id, pomocné related.*, observer.name, observer.type). Název hlavních polí a vyhledávání identity pochází z /Schemas/Mappings/Asset_<schema>.yaml sloučeného s parsec.asset u každé Parsec události. Viz Správa aktiv Parsec.
sekce [assets]
| Klíč | Výchozí | Popis |
|---|---|---|
mongo_collection |
assets |
Mongo kolekce pro řádky aktiv |
mongo_tags_collection |
asset_tags |
Sbírka značkového přívěsku |
mongo_suppress_collection |
asset_suppress |
Sdílené slučování/mazání potlačit (víceinstanční) |
activity_mongo_batch_max |
100 |
Aktualizace aktivit před bulk_write |
activity_mongo_batch_max_age |
60 |
Maximální počet sekund před částečným vyprázdněním aktivity (0 = pouze velikost) |
complex_mongo_batch_max |
100 |
Vzorky skóre rizika před vyprázdněním Mongo |
complex_mongo_batch_max_age |
60 |
Maximální počet sekund před částečným vyprázdněním rizika |
default_alert_after_host |
3d |
alert_after on first host insert when Library does not override (0 = disabled) |
default_alert_after_user |
7d |
alert_after on first user insert when Library does not override (0 = disabled) |
default_alert_after_service |
3d |
alert_after on first service insert when Library does not override (0 = disabled) |
stale_alert_cooldown_sec |
1h |
Minimální interval mezi opakováním up, zatímco je stále zastaralé (v paměti) |
stale_alert_reopen_cooldown_sec |
1d |
Po zotavení down zablokujte další up, dokud neuplyne tato doba (stale_reopen_after u aktiva) |
risk_score_decay_half_life |
24h |
Poloviční doba rizika entity (viz Skóre rizika entity) |
risk_score_decay_clear_below |
0.5 |
Vymazat zkažené skóre pod tímto |
risk_score_cas_retries |
8 |
Optimistické opakování souběžného zpracování pro sloučení skóre rizika |
deleted_activity_suppress_ttl |
600 |
Ignorovat Kafka upsert po HTTP delete (0 = vypnuto); Mongo TTL |
bulk_asset_ids_max |
(žádný) | Maximální počet hodnot asset_id na požadavek hromadného mazání / hromadné úpravy (0 nebo prázdné = bez omezení) |
Výchozí nastavení knihovny (/Assets/Defaults/)
Přepište nastavení alert_after pro každý typ, které se uplatňuje při vytvoření nového aktiva (vložením aktivity nebo vytvořením přes HTTP bez explicitně zadaného alert_after). Složité / události s hodnotou rizika nevytvářejí aktiva. Existující řádky nejsou změněny.
Umístěte YAML do /Assets/Defaults/ (například settings.yaml) s define.type: assets/defaults:
define:
type: assets/defaults
alert_after:
host: 3d
user: 7d
service: 3d
| Klíč | Význam |
|---|---|
alert_after.host / .user / .service |
Doba trvání (3d, 7d, 2h) nebo sekundy; 0 zakáže výchozí hodnotu pro tento typ |
Priorita: Klíč typu knihovny (pokud je přítomen) → [assets] default_alert_after_<kind> → vestavěný (3d / 7d / 3d). Vynechte typ v YAML, aby se zachovala hodnota INI pro tento typ. Vrstva knihovny nájemce přepisuje soubor Common Library.
Knihovna Common Library dodává /Assets/Defaults/settings.yaml se stejnými hodnotami jako výchozí hodnoty INI.
Knihovna přeskočit (/Assets/Skip/)
Filtrovat hostitelské a uživatelské zdroje (aktivitu a komplexní). Porovnávání je bez rozlišování velikosti písmen (kromě min_hyphens, který počítá znaky -).
| Klíč | Zápas |
|---|---|
names / exact |
Celý řetězec |
prefixes |
Začíná s |
suffixes |
Končí (příponou) |
contains |
Podřetězec |
min_hyphens |
Název obsahuje alespoň tolik znaků - (0 = vypnuto) |
ip |
Titulek je čistá adresa IPv4 nebo IPv6 (true / false) |
define:
type: assets/skip
host:
names:
- localhost
prefixes:
- temp-
contains:
- "-dhcp-"
user:
names:
- SYSTEM
- LOCAL SERVICE
prefixes:
- "urn:"
- "NT AUTHORITY\\"
suffixes:
- "$"
contains:
- svc_
min_hyphens: 4
ip: true
Výchozí hodnoty Common Library zahrnují předponu uživatele urn:, min_hyphens: 4, Windows příponu účtu počítače $, zástupné znaky (n/a, -, unknown) a ip: true.
Chcete-li odfiltrovat stejné vzory dříve, než dosáhnou tématu aktivit Kafka, nakonfigurujte událostní linku Parsec parsec.asset.skip (viz Správa aktiv Parsec). Parsec skip nepodporuje min_hyphens; podporuje ip.
Když zdroj zapíše holou IP do host.hostname a vy nechcete, aby došlo k záloze a kopírování do host.id, nastavte parsec.asset.skip.host.ip: true na této událostní linii (Přeskočit IP adresy používané jako názvy hostitelů). To je platné pro jednotlivou linii a nenahrazuje /Assets/Skip/ host.ip.
Oznámení o nových aktivech (okamžité + naplánované)
Aktiva LogMan.io mohou vysílat oznámení asab-iris (stejná cesta JSON Kafka jako lmio-alerts) pro aktiva zjištěná ze streamu aktivit. Rutinní aktualizace last_seen nezasílají oznámení. Komplexní / risk-score cesta nevytváří aktiva.
- Okamžitě: když je dokument aktiva poprvé vložen (Mongo
upserted_ids); jakýkoli instance může odeslat, deduplikováno pro každé aktivum přes Mongonotification_sent. - Plánovaný přehled: pouze vedoucí ZooKeeper; pro
(tenant, channel)v okně sledovače. Po vypršeníperiod(Knihovna nebo INI) jeden souhrn uvádí aktiva sfirst_seenpo offsetu sledovače.
sekce [notifications]
| Klíč | Výchozí | Popis |
|---|---|---|
topic |
notifications |
Kafka téma pro JSON zprávy asab-iris |
enabled |
yes |
Hlavní vypínač; no zakáže všechna oznámení o nových aktivech |
tracker_collection |
notification_trackers |
Mongo kolekce pro naplánované posuny souhrnu |
sent_collection |
notification_sent |
Mongo dedup markery pro okamžitá oznámení (jeden řádek na asset _id) |
digest_max_assets |
50 |
Maximální počet řádků aktiv v šabloně digestu new_assets (celkový počet je vždy v new_assets_count) |
Doručení kanálu (INI volitelné, Knihovna na nájemníka)
Sekce INI [notification:*] poskytují globální výchozí hodnoty (náhradní řešení, když soubor Knihovny nájemce nenastaví doručení). Pro e-mail můžete nakonfigurovat from, to a period zcela v souboru /Assets/Notifications/settings.yaml nájemce bez jakékoli INI sekce kanálu.
Volitelné výchozí hodnoty INI:
[notification:email]
from=noreply@example.com
to=soc@example.com
period=1h
[notification:slack]
period=3600
[notification:sms]
phone=+420000000000
[notification:push]
topic=assets
Nastavení knihovny
Pro každého nájemce umístěte YAML do /Assets/Notifications/ (například settings.yaml) s define.type: assets/notifications:
instant:umožňuje jednorázové zprávy pro tento kanálscheduled:umožňuje periodické souhrny pro tento kanál- volitelné nastavení na úrovni kanálu
from,to,period(e-mail),phone(sms),topic(push) - volitelné nastavení na úrovni kanálu
schedule:tichá období (atcron,duration,action: delay|discard), stejné jako u lmio-alerts - volitelné
params/excludeuvnitřinstant/scheduled(attribute/op/value, operátoryeq/gt/gte/lt/lte)
define:
type: assets/notifications
email:
from: noreply@example.com
to:
- soc@example.com
period: 1h
instant:
params:
template: /Templates/Email/Asset Created.md
exclude:
- attribute: type
op: eq
value: user
scheduled:
params:
template: /Templates/Email/Asset Summary.md
exclude:
- attribute: type
op: eq
value: user
schedule:
- at: "0 16 * * *"
duration: 14h
action: delay
slack:
scheduled: {}
Výchozí cesty šablon (nasadit samostatně v Knihovně):
- Okamžité:
/Templates/{Email,Slack,SMS,Push}/Asset Created.md - Naplánované:
/Templates/{Email,Slack,SMS,Push}/Asset Summary.md
Okamžité parametry: tenant, asset_id, type, title, first_seen / last_seen (ISO UTC), name, description.
Plánované parametry: tenant, name, description, new_assets_count, new_assets (seznam {asset_id, type, title, first_seen}).
HTTP API
Služba standardně poslouchá na tcp/8965. Odpovědi obsahující seznam aktiv a detaily zahrnují zdecimované risk_score, first_seen, last_seen, a vypočítané active.
active není Mongo pole. Je true, když now − last_seen je v rozmezí alert_after sekund (pokud alert_after ≥ 1), jinak je to během 7 dní. Podrobnosti: Aktivní vs neaktivní a Manuál analytika.
Seřadit podle rizika entity s parametrem dotazu srisk_score.
Volitelné přepsání váhy skóre rizika pro jednotlivý majetek se spravuje z detailního rozhraní majetku (a prostřednictvím HTTP API pro automatizaci). Viz Skóre rizika entity.
Skóre rizika entity
LogMan.io používá dva související koncepty hodnocení rizik:
| Koncept | Kde to vidíš | Význam |
|---|---|---|
| Skóre rizika detekce | Složitá události, upozornění, Objevovat | Skóre jednoho zjištění po pravidlech korelace a vyhledávání |
| Skóre rizika entity | Seznam aktiv a detail aktiva | Jak rizikový je tento uživatel, hostitel nebo služba právě teď, na základě nedávných detekcí |
Hodnocení detekce je popsáno v Hodnocení rizik v Korelátoru. Tato stránka vysvětluje skóre rizika entity u aktiv.
Kde hledat v uživatelském rozhraní
| Místo | Co vidíte | Co vám to říká |
|---|---|---|
| Tabulka aktiv | Sloupec skóre rizika | Porovnejte hlavní částky na první pohled; seřaďte podle rizika |
| Podrobnosti o majetku postranní panel | Průměrné skóre rizika | Aktuální skóre entity po úbytku |
| Podrobnosti o majetku graf | Řádek skóre rizika | Skóre detekce vrcholů v průběhu času (není to stejné číslo jako na postranním panelu) |
!!! tip „SOC třídění v pondělí ráno“
Otevřete Aktiva a seřaďte podle skóre rizika sestupně. Pracovní stanice s hodnotou 72 po několika neúspěšných přihlášeních během víkendu zůstává na vrcholu, i když byla poslední výstraha před několika hodinami. Server, který měl včera jednu výstrahu 85, ale od té doby nic, může již ukazovat 40, protože skóre slábne, když aktivita ustane.
Jedno hlasité upozornění vs mnoho tichých
Uživatel jsmith spustí jedno pravidlo s rizikem detekce 80. Jejich skóre entity se posune směrem k 80. Následující den přijdou tři menší detekce po 20: skóre entity se nestane 140. Směruje spíše k novým hodnotám (přibližně 40, pokud dorazily blízko sebe). Starý šum se nesčítá neomezeně.
!!! tip „Postranní panel vs graf“
Postranní panel Průměrné skóre rizika odpovídá: „Měl bych se o tohoto ředitele nyní obávat?“
Graf skóre rizika odpovídá na otázku: „Kdy došlo k nárůstu detekcí?“
Po klidném týdnu může boční panel zobrazovat 0 nebo být prázdný, zatímco graf stále ukazuje nárůst z minulého úterý.
Jak se vytváří skóre entity
LogMan.io Assets zpracovává detekce korelací pro každého nájemce. Když detekce obsahuje event.risk_score a identifikuje hostitele, uživatele nebo službu, tato hodnota aktualizuje skóre entity pro daný subjekt pokud aktivum již existuje (vytvořeno ze streamu aktivit nebo HTTP). Komplexní detekce nevytvářejí řádky inventáře.
Skóre je vážený průměr s časovým útlumem nedávných hodnot detekce (styl UEBA), ne průběžný součet. Pro přesný model viz Útlum rizikového skóre (podrobně).
Na vysoké úrovni:
- Nová zjištění zvyšují skóre (nebo snižují, pokud je nová hodnota nižší).
- Doba bez zjištění snižuje skóre (výchozí poločas 24 hodin).
- Mnoho slabých upozornění se nesčítá nekonečně stejným způsobem, jako by se sčítal jejich prostý součet.
Příklad (zjednodušeně): Skóre entity bylo 80 z jednoho upozornění. Okamžitě přijde nové zjištění s rizikem 20: smíšené skóre se stane přibližně 50, ne 100. Po 24 hodinách bez dalších zjištění se skóre znovu zmenší přibližně na 25, pak nová aktivita může skóre opět posunout.
!!! tip „Proč průměr, a ne součet?“
Deset upozornění s nízkou prioritou rozložených v průběhu týdne by uživatele nemělo posunout na stejnou úroveň jako deset kritických incidentů. Skóre entity odráží nedávnou relevanci, podobně jako u produktů UEBA, kde zastaralé riziko slábne místo toho, aby žilo navždy v běžícím součtu.
Pokles skóre rizika (podrobně)
Tato sekce popisuje přesný model rizika entit používaný lmio-assets při slučování složitých detekcí jízdních pruhů.
Vstup
Důležité jsou pouze události komplexního pruhu. Pro každé zjištění služba čte:
| Vstup | Zdroj |
|---|---|
| Ředitel | ID hostitele, uživatele nebo služby ze schématu nájemce (stejná pole jako u aktiv aktivit) |
Příspěvek c |
event.risk_score on the detection (must be > 0 to change state) |
Čas události t |
Hlavní datum a čas u složité události (obvykle @timestamp), jako Unix milisekundy |
Detekce s c ≤ 0 jsou pro hodnocení ignorovány.
Vnitřní stav v MongoDB
Celé číslo risk_score zobrazené v uživatelském rozhraní je odvozeno ze tří interních polí na dokumentu aktiva:
| Pole | Role |
|---|---|
risk_score_sum (S) |
Vážený součet minulých hodnot detekce |
risk_score_weight (W) |
Součet vah (každé zjištění přidá 1 po rozkladu) |
risk_score_at |
Unix ms, kdy byly akumulátory naposledy posunuty na čas události |
Skóre entity v kterýkoli okamžik:
score = S / W (rounded to integer for API / list sort)
Odpovědi API a exporty nezobrazují risk_score_sum, risk_score_weight nebo risk_score_at; pouze vypočtené risk_score.
Rozpad mezi detekcemi
Když čas postupuje od předchozí aktualizace (risk_score_at) k novému času události t bez začlenění nového zjištění, oba akumulátory jsou vynásobeny stejným faktorem:
decay(Δt) = 0.5 ^ (Δt_hours / half_life_hours)
S ← S × decay(Δt)
W ← W × decay(Δt)
Výchozí half_life_hours = 24 ([assets] risk_score_decay_half_life, výchozí 24h).
Po jedné celé polovině života bez nových detekcí se S i W zmenší na polovinu, takže score = S/W zůstává stejné až do doby, než bude sloučena nová detekce.
Intuice: poločas nesnižuje zobrazené skóre, zatímco se nic nového neděje (S a W se zmenšují stejně, takže S/W zůstává konstantní). Řídí, jak moc starší detekce započítávají, když je další detekce sloučena — po 24 hodinách nečinnosti přispívá předchozí historie poloviční vahou, než je nová hodnota smíchána.
!!! poznámka „Nečinná vs. nová zjištění“
Žádné nové složité události: postranní panel a seznam risk_score zůstávají na poslední hodnotě (např. 80 zůstává 80).
Nová detekce po nečinnosti: historie je nejprve snížena, poté zprůměrována s novým event.risk_score — tehdy se číslo posune dolů (nebo nahoru).
Tipy analytiků, které popisují, že skóre „vybledne“ během klidného víkendu, předpokládají další nižší záznamy nebo kombinaci minulých vzorků, nikoli jen samovolné slábnutí ze starého upozornění.
Sloučení nového zjištění
Když detekce s hodnotou c > 0 dorazí v čase t:
- Pokud
t ≥ risk_score_at: aplikujte pokles odrisk_score_atdot, potom nastavterisk_score_at = t. - Pokud
t < risk_score_at(pozdní událost): přidejtecdo S a +1 do W, ale neposouvejterisk_score_atzpět. - Aktualizujte akumulátory:
S ← S × decay(Δt) + c (Δt = 0 when late event)
W ← W × decay(Δt) + 1
score = round(S / W)
Bufferované detekce z Kafky jsou před zápisem sloučeny v pořadí podle času události pro každý prostředek.
Odstraňování nízkých skóre
Pokud po snížení nebo sloučení score < risk_score_decay_clear_below (výchozí 0,5), jsou všechna pole rizika odstraněna z Mongo (risk_score, risk_score_sum, risk_score_weight). Aktivum pak v uživatelském rozhraní nezobrazuje žádné riziko entity až do další kvalifikující detekce.
Když je aplikováno rozklad
| Okamžik | Chování |
|---|---|
| Komplexní proplach jízdního pruhu | Detekce sloučeny do Mongo; akumulátory posunuty na nejnovější čas události v dávce |
| HTTP GET (seznam, detail, export) | risk_score recomputed at now from stored S, W, and risk_score_at (passive decay) |
| Pozadí cvaknutí | Každých 10 minut (Application.tick/600!) se uložené S, W a risk_score zachovají po pasivním úbytku, takže třídění podle risk score v seznamu aktiv zůstává zarovnané, aniž by bylo třeba číst každý řádek při každém požadavku |
Mezi značkami se seznam/podrobnosti stále zobrazují správnou zmenšenou hodnotu při čtení, i když Mongo stále uchovává mírně zastaralé celé čísla.
Bezpečnost více instancí
Několik instancí lmio-assets může spotřebovávat stejné složité téma. Sloučení používá porovnej-a-nastav na risk_score_at: aktualizace se aplikuje pouze tehdy, pokud risk_score_at v Mongo stále odpovídá přečtené hodnotě. Konfliktní zápisy se opakují (výchozí 8 pokusů, [assets] risk_score_cas_retries). Pasivní úloha degradace používá stejnou ochranu, takže současné sloučení detekce není přepsáno.
Číselný příklad
Konfigurace: poločas 24 h, clear_below = 0,5.
- T0: První detekce
c = 80→ S = 80, W = 1, skóre = 80. - T0 + 1 h: Druhá detekce
c = 20→ decay(1 h) ≈ 0,971, S ≈ 80×0,971 + 20 ≈ 97,7, W ≈ 1,971, skóre ≈ 50. - T0 + 25 h (žádné další detekce): pokud stále neaktivní, skóre zůstává ≈ 50 (S a W se rozpadají stejně).
- T0 + 25 h s novou detekcí
c = 10: historie s poloviční váhou se mísí směrem k 10 — zobrazené skóre klesá, protože přišel nový vzorek, ne jen vzhledem k době nečinnosti.
Postranní panel vs graf skóre rizika
Tyto pohledy odpovídají na různé otázky a využívají různá data:
| Zobrazit | Data | Otázka |
|---|---|---|
| Průměrné skóre rizika (postranní panel, sloupec seznamu) | Model rozložené entity nahoře | Jak rizikový je tento princip právě teď? |
| Graf skóre rizika (podrobnosti o majetku) | max(event.risk_score) per time bucket on complex lane events only |
Kdy jednotlivá zjištění vrcholila v každém období? |
Graf může ukázat nárůst z minulého úterý, zatímco postranní panel je už 0 po klidném týdnu.
Volitelná váha rizikového skóre
Na stránce s podrobnostmi o aktivu můžete nastavit váhu skóre rizika (0 až 100). Použijte to, když vaše nasazení upravuje, jak silně by měly budoucí detekce zahrnující daného uživatele skórovat (například řadič domény nebo známý servisní účet).
Toto přepsání je oddělené od Průměrného skóre rizika v postranním panelu, které stále vychází z reálných detekcí na tomto majetku.
Pro úpravu vyhledávání potřebujete oprávnění. Použijte Vymazat váhu k odstranění přepsání.
Skóre v průběhu času
- Detekce používají čas události na komplexní události (obvykle
@timestamp). - Otevření seznamu nebo detailu aktiva zobrazuje skóre tak, jak je nyní, včetně pasivního rozpadu od poslední detekce (viz Rozpad skóre rizika (podrobně)).
- Služba také na pozadí každých 10 minut aktualizuje uložená skóre, aby řazení v seznamu aktiv zůstalo v souladu s modelem.
- Velmi nízká skóre (pod 0,5 ve výchozím nastavení) se z UI ztrácejí.
Pokud detekce dorazí pozdě (čas události starší než poslední aktualizace), její hodnota stále přispívá do průměru, ale rozpady se nevrací zpět v čase.
Konfigurace (správci)
[assets] key |
Výchozí | Popis |
|---|---|---|
risk_score_decay_half_life |
24h |
Polovina života při snižování váhy minulých detekcí před sloučením nové |
risk_score_decay_clear_below |
0.5 |
Skrýt a vymazat skóre pod touto hodnotou |
risk_score_cas_retries |
8 |
Optimistické opakování při slučování zjištění napříč instancemi |
complex_mongo_batch_max |
100 |
Vyrovnaná detekce před uložením |
complex_mongo_batch_max_age |
60 |
Maximální počet sekund před částečným vyprázdněním vyrovnávací paměti |
Viz Konfigurace pro nastavení služby a závislosti.
Související dokumentace
- Hodnocení rizik v Correlator: podle detekce
event.risk_score - Přehled aktiv LogMan.io
Graf
LogMan.io Chart
TeskaLabs LogMan.io Chart je mikroslužba pro dotazování, agregaci a vizualizaci dat v platformě LogMan.io Observability. Je backendovým datovým enginem pro Discover, Explore, Dashboards a Reports ve webové aplikaci.
Mikroslužba se připojuje k více datovým backendům, překládá dotazy do formátů specifických pro backend a streamuje výsledky do frontendu přes HTTP API a WebSocket.
Datové backendy
| Provider | Předpona | Popis |
|---|---|---|
| Elasticsearch | es. |
Primární úložiště log událostí a bezpečnostních dat |
| InfluxDB | ix. |
Časové řady metrik a výkonu |
| DuckDB | db. |
In-memory analytika pro odvozené metriky (ingest rates, EPS) |
Reference
Konfigurace LogMan.io Chart
LogMan.io Chart vyžaduje tyto závislosti:
- Apache ZooKeeper (konfigurace tenantů)
- ASAB Library (schémata a deklarace datových zdrojů)
- Elasticsearch (data událostí)
- InfluxDB (volitelné, metriky)
- SeaCat Auth (autorizace)
Model
LogMan.io Chart je nasazen na všech uzlech v clusteru.
Pro start aplikace ji zahrňte do modelu a klikněte na Apply.
define:
type: rc/model
services:
lmio-chart:
- <node> # Replace with name of the node
- <node> # Replace with name of the node
- <node> # Replace with name of the node
Generovaná konfigurace
Většinu INI sekcí skládá automaticky ASAB Maestro z technologií clusteru:
| Sekce | Technologie |
|---|---|
[zookeeper] |
ZooKeeper |
[library] |
ASAB |
[elasticsearch] |
Elasticsearch |
[influxdb], [asab:metrics], [asab:metrics:influxdb] |
InfluxDB |
Možnosti specifické pro Chart
Přepište tyto sekce v modelu podle potřeby. Viz Konfigurace ASAB služeb z modelu.
Discover
Řídí automatický výpočet časových bucketů, když group_by používá buckets: "config".
[discover]
buckets=120
Nižší hodnoty = hrubší grafy a rychlejší odpověď. Výchozí je 120.
Export
Limit maximálního počtu řádků z export endpointů (PUT /{tenant}/json/query, /{tenant}/parquet/query, /{tenant}/csv/query).
[export]
max_size=10000
Výchozí je 10000.
Ticket
Nejranější timestamp pro řešení časových rozsahů investigation ticketů.
[ticket]
min_timestamp=2026-02-20
Tickety se cacheují 10 minut.
Metrics
[asab:metrics]
...
Zdroj dat
Datové zdroje jsou pojmenované propojení s datovými sadami v rámci backendu. Každý zdroj je zpřístupněn API s předponou poskytovatele:
| Předpona | Backend | Příklad ID |
|---|---|---|
es. |
Elasticsearch | es.events |
ix. |
InfluxDB | ix.cpu |
db. |
DuckDB | db.ingest |
Objev
Datové zdroje jsou shromážděny z několika zdrojů:
Knihovna (/DataSources/)
Deklarace YAML s define.type typu datasource/elasticsearch nebo datasource/influxdb a sekcí discover. Při změně knihovny se znovu načítají.
Automatické zjišťování InfluxDB
Všechny měření v nakonfigurované databázi jsou zpřístupněny pod nájemcem system (žádné RBAC zdroje).
DuckDB (vestavěný)
Paměťové zdroje pro jednotlivé nájemce: db.ingest (míry příjmu) a db.eps (události za sekundu). Není nakonfigurováno v knihovně.
Vlastnosti API
Každý zdroj dat poskytuje:
| Vlastnost | Popis |
|---|---|
type |
elasticsearch, influxdb, or duckdb |
label |
Zobrazované jméno |
order |
Priorita třídění (nižší = první) |
tenant |
Vlastnící nájemce |
resources |
RBAC zdroje vyžadované pro přístup (nevrací se v API; používá se pro filtrování) |
Vypsat zdroje dat: GET /{tenant}/datasources?types=elasticsearch,influxdb
Rozvržení knihovny
Datové zdroje jsou definovány v Knihovně. Každá definice datového zdroje musí být na cíli global, ne na tenant.
Cesty jsou: /DataSources/<tenant>/<datasource>.yaml nebo /DataSources/<datasource>.yaml.
- Datové zdroje specifické pro nájemce — soubor umístěný v
/DataSources/<tenant>/. Dostupné pouze pro tohoto nájemce. - Globální datové zdroje — soubor přímo v
/DataSources/(nájemce*). Tyto datové zdroje jsou kopírovány do každého nájemce. Parametry jako{{tenant}}jsou nahrazovány pro každého nájemce.
Pro graf (Discover/Explore UI) jsou načteny pouze deklarace s částí discover.
Elasticsearch
define:
type: datasource/elasticsearch
discover:
name: Events
order: 100
resources:
- "lmio:dataset:events"
specification:
index: "lmio-{{tenant}}-events-*"
schema: /Schemas/ECS.yaml # optional; defaults to tenant schema
restrict: # optional static filter on every query
event.dataset: linux
define:
type: datasource/elasticsearch
discover:
name: Fortinet Fortigate 1
order: 1100
specification:
index: "lmio-{{tenant}}-fortinet-fortigate-1-*"
schema: /Schemas/ECS.yaml
define
type— musí býtdatasource/elasticsearch
objevit
name— zobrazovaný štítek (povinné)order— pořadí řazení (výchozí1000)resources— seznam RBAC zdrojů; uživatel musí mít alespoň jeden. Uživatelé slmio:dataset:readallvidí všechny zdroje.
Vlastní zdroj RBAC
Vytvořte vlastní prostředek v SeaCat Auth (například lmio:dataset:fortinet-fortigate-1) a přiřaďte ho rolím pro kontrolu přístupu ke konkrétnímu datovému zdroji. Uveďte ho v discover.resources v deklaraci datového zdroje.
specifikace
index— vzor indexu Elasticsearch; podporuje{{tenant}}schema— cesta ke schématu knihovny; pokud není uvedena, použije se výchozí tenant ze ZooKeeperu; záložní/Schemas/ECS.yaml.restrict— statické filtry polí aplikované na každý dotaz. Každý filtr je dvojice klíč-hodnota.asset_tag— volitelné; viz Události pro aktiva podle značkyasset_kinds— volitelný seznam použitý sasset_tag(host,user,service)
!!! tip „Jiný zdroj dat“
Datový zdroj Ostatní používá vyhrazené schéma umístěné v knihovně na /Schemas/Others.yaml.
Vzdálené vzory indexů clusteru mohou zahrnovat alias clusteru, např. {{tenant}}:lmio-{{tenant}}-events*. Viz Elasticsearch vzdálený cluster.
Události pro aktiva podle štítku
Použijte toto, když by Discover nebo Chart měly zobrazit pouze události, jejichž principálové patří k aktivům nesoucím daný štítek (například všechny hosty s label=prod). Elasticsearch nemůže připojit doplněk štítku aktiv v MongoDB, takže Chart požádá LogMan.io Assets o připravený filtr Discover a aplikuje ho na každý dotaz.
Jak to funguje
- Nastavíte
specification.asset_tagna zdroji dat Elasticsearch (nebo předáteprompt.asset_tagpři jednotlivém dotazu). - Graf volá Assets
GET /{tenant}/asset/events-filters tímto tagem (a volitelnými druhy). - Assets vyhledá odpovídající aktiva a vrátí filtrovací jazyk, například
host.id:(web01, web02). - Graf spojí tento řetězec pomocí AND do
prompt.filterspřed vyhledáváním v Elasticsearch.
Toto je stejný vzorec jako při převodu upozornění ticketu na ID událostí, ale místo ticketů na značky.
Oprávnění
Služba Chart musí dosáhnout lmio-assets přes Discovery. Volající potřebuje lmio:asset:access, aby mohl běžet konec filtru událostí.
Příklad knihovny (hostitelé s label=prod)
Knihovna Common Library obsahuje připravené prohlášení, které můžete zkopírovat nebo upravit:
define:
type: datasource/elasticsearch
discover:
name: Events (hosts tag=prod)
order: 150
specification:
index: lmio-{{tenant}}-events-*
# UI chip under key "tags". For API key/value tags use "label:prod".
asset_tag: "prod"
asset_kinds:
- host
asset_tag formy
- Název čipu v surovém uživatelském rozhraní (nejběžnější):
prod→ poletags, hodnotaprod. Webové UI pro Assets ukládá čipy jako seznam řetězců pod klíčemtags. - Forma klíč/hodnota
field:value, napříkladlabel:prod→ klíčlabel=prod(API nebo doplňkové tagy aktivit). Pokud tento klíč chybí, Assets také odpovídá UI čipu, jehož text je přesnělabel:prod. - Mapovací forma:
asset_tag: { field: label, value: prod }.
druhy_aktiv
Nepovinný seznam host, user a/nebo service. Každý typ odpovídá jednomu poli ECS:
| Laskavý | Pole události ve filtru |
|---|---|
host |
host.id |
user |
user.id |
service |
service.id |
Vynechte asset_kinds, abyste zahrnuli všechny tři. Zachovejte pouze host, pokud chcete záznamy pouze pro označené hostitele.
Ad hoc dotaz
Bez vyhrazeného zdroje dat nastavte prompt.asset_tag (stejný řetězec field:value) na dotaz Chart nebo Discover proti es.events. Zdroj dat asset_kinds se stále používá, pokud je přítomen; jinak se používají všechny druhy.
Prázdný výsledek
Pokud žádný prostředek neodpovídá značce, Chart vloží filtr, který neodpovídá žádným dokumentům, takže náhodou neuvidíte celý proud událostí.
Související
- Uživatelské rozhraní analytika: Správa aktiv: Štítky a události v Discover
- Přehled služby aktiv: LogMan.io Aktiva
InfluxDB
define:
type: datasource/influxdb
discover:
name: CPU
order: 200
specification:
measurement: cpu
restrict:
host: "{{tenant}}"
define
type— musí býtdatasource/influxdb
objevit
Stejné jako Elasticsearch (name, order, resources).
specifikace
measurement— název měření InfluxDBrestrict— statické filtry tagů/polí; podporuje nahrazení{{tenant}}
Schéma (štítky a pole) je automaticky vytvořeno z SHOW TAG KEYS / SHOW FIELD KEYS na měření.
DuckDB
Vestavěné pro jednotlivého nájemce; není deklarováno v knihovně.
Zdroje DuckDB zpřístupňují odvozené provozní metriky vypočítané v paměti z dat InfluxDB commlink. Používejte je pro monitorovací grafy platformy (průtok zpracování a statistiky EPS) bez ukládání dodatečných dat do Elasticsearch.
| ID | Štítek | Popis |
|---|---|---|
db.ingest |
Požít | Rychlosti příjmu (bytes.in, event.in) na proud a oddíl |
db.eps |
EPS | Agregáty událostí za sekundu (min, max, průměr, medián, 95. percentil) |
Šablonové proměnné
{{tenant}}— nahrazen aktuálním identifikátorem nájemce vespecification.index,specification.restricta hodnotáchrestrictv InfluxDB.
Řešení schématu
Pro zdroje Elasticsearch je schéma řešeno v pořadí:
specification.schemaz deklarace datového zdroje- Výchozí schéma nájemce ze ZooKeeperu (
/lmio/tenants/{tenant}.yaml) - Náhradní schéma je
/Schemas/ECS.yaml
Autorizace
Seznam zdrojů dat a dotazy jsou filtrovány pomocí RBAC. Nakonfigurujte discover.resources v deklaracích Knihovny, nebo udělte lmio:dataset:readall pro neomezený přístup.
Correlator
LogMan.io Correlator
TeskaLabs LogMan.io Correlator je mikroslužba odpovědná za provádění detekcí a hledání vzorců v datech na základě korelačních pravidel.
LogMan.io Correlator je vždy nasazen pro daného nájemce.
Na shlucích s Tenant Rex jsou instance korelátoru automaticky vytvářeny ze selekce Detections. Viz Tenant Rex.
Důležité poznámky
-
Každý korelátor má v konfiguračních souborech povinné sekce, viz sekce Konfigurace.
-
Korelátor nemůže fungovat bez korelačních pravidel. Další informace o tom, jak vytvářet korelační pravidla, naleznete v části Window Correlator.
-
Pro
logsourcev pravidlech (skalární vs objekt a hodnoty sladěné s šablonami událostí), viz Logsource v korelačních pravidlech.
Výchozí signály
Každý korelátor odesílá signál pro upozornění managementu (používající výchozí spouštěč signálu) k vytvoření tiketů; jsou seskupeny podle atributů specifikovaných v sekci evaluate, jinak se pro seskupování používá cesta pravidla. Pro úplné odkazy na sekci signal (seskupování, výchozí spouštěč) viz Signal. Souhrn:
Chcete-li použít různé atributy seskupování, přidejte sekci signal do deklarace korelátoru:
signal:
grouping:
- user.name
Chcete-li výchozí spouštěč signálu úplně vypnout, použijte možnost default:
signal:
default: false
LogMan.io Correlator Configuration
Nejprve je potřeba specifikovat, z které knihovny načíst deklarace, což může být buď ZooKeeper, nebo File.
Model
Chcete-li aplikaci spustit, zahrňte ji do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-correlator:
instances:
<tenant>-1: # Replace with name of your tenant
node: <node> # Replace with name of the node
asab:
config:
tenant:
name: <tenant> # Replace with name of your tenant
correlator:
groups: # Specify paths for correlations, each on a separate line
/Correlations/Bitdefender/
/Correlations/Complex/
/Correlations/Firewall/
/Correlations/Fortinet/
/Correlations/Microsoft/
Nájemce Rex (automatické modely)
Na clusterech, které používají LogMan.io Tenant Rex (lmio-trex), jsou instance korelátoru generovány automaticky z výběru Detections nájemce.
Úplné chování (umístění, rozdělení zpoždění, HA, čištění Kafka, konfigurace) je zdokumentováno v Tenant Rex.
Příklad
[library]
providers=zk://library
Vrstva knihovny ZooKeeper vyžaduje konfigurační sekci zookeeper.
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Také každý běžící proces parseru musí vědět, které skupiny načíst z knihoven a ke kterému nájemci patří, viz níže:
[tenant]
ids=mytenant
[declarations]
groups=Firewall Common Authentication
# Complex event lane (optional)
[eventlane]
path=/EventLanes/mytenant/complex.yaml
groups- názvy skupin, které mají být použity z knihovny, oddělené mezerami; pokud se skupina nachází ve podsložce složky, použijte jako oddělovač lomítko, například/Correlators/Firewall
Dále je třeba vědět, které Kafka témata použít na výchozím záložním vstupu a výstupu (pokud není uvedeno v korelacích v sekci zdrojů záznamů a složité událostní trase).
Připojení k Kafka musí být také nakonfigurováno, aby vědělo, k jakým serverům Kafka se má připojit.
# Kafka connection
[kafka]
bootstrap_servers=lm1:19092;lm2:29092;lm3:39092
# The default Kafka topic to read from when no logsource is specified in the correlation rule (optional)
[pipeline:CorrelatorsPipeline:KafkaSource]
topic=lmio-events
group_id=lmio_correlator_firewall
# The default kafka topic for event trigger unless there is a complex event specified (optional)
[pipeline:OutputPipeline:KafkaSink]
topic=lmio-output
Poslední povinná sekce specifikuje, která nastavení Elasticsearch umožňují práci s vyhledáváními (Lookups). Pro více informací viz sekce Lookups.
# Lookup persistent storage
[elasticsearch]
url=http://elasticsearch:9200
Docker Compose
services:
lmio-correlator:
image: docker.teskalabs.com/lmio/lmio-correlator:VERSION
volumes:
- ./lmio-correlator:/conf
- /data/ssd/lookups:/lookups
- /data/hdd/log/lmio-correlator:/log
- /data/ssd/correlators/lmio-correlator:/data
Nahraďte lmio-correlator názvem instance korelátoru.
Korelator potřebuje znát svou konfigurační cestu, cestu k vyhledávacím tabulkám (složka může být prázdná, záleží na tom, zda se vyhledávací tabulky používají), cestu pro logování a cestu pro ukládání svých dat.
Varování
Cesta k datům je povinná a musí být umístěna na rychlém disku, tedy SSD.
Zdroj protokolu v korelačních pravidlech
Sekce logsource korelační (detekční) pravidla říká LogMan.io Correlator které kanály událostí má odebírat. Korelator porovnává logsource pravidla s logsource v deklaracích kanálů událostí nájemců pod /EventLanes/<tenant>/. Pokud není nic shodné, pravidlo je načteno, ale nekonzumuje témata Kafka a nespustí se.
Když uvidíte tuto Pozornost / chybu
Zpráva (krátká forma):
Sekce Logsource definovaná tímto detekčním pravidlem neodpovídá žádnému kanálu událostí v knihovně …
Maják pozornosti uživatelského rozhraní je umístěn na řádku logsource v YAML pravidle. Zpráva uvádí několik příkladů bloků logsource, které byly převzaty z existujících událostních linek nájemce.
Co dělat
- Otevřete Knihovnu a přejděte do
/EventLanes/<your-tenant>/. - Otevřete event lane, která by měla poskytovat tato detekce (stream, jehož události chcete korelovat).
- Najděte sekci
logsourcev deklaraci tohoto event lane (nebo v šabloně event lane, ze které byl vytvořen, v/Templates/EventLanes/). - Zkopírujte tento
logsourcedo korelačního pravidla (stejné klíče a hodnoty:vendor,product,category,service, …). - Uložte pravidlo. Po restartu Knihovny by korelátor měl vyřešit Kafka téma a maják Pozornosti pro tento problém by měl zmizet.
Příklad — událostní dráha:
# /EventLanes/mytenant/fortinet-fortigate-1.yaml
define:
type: lmio/event-lane
name: FortiGate
logsource:
vendor:
- fortinet
product:
- fortigate
category:
- firewall
kafka:
events:
topic: events.mytenant.fortinet-fortigate-1
Stejný logsource na pravidle:
# /Correlations/.../My FortiGate Rule.yaml
define:
name: My FortiGate Rule
type: correlator/match
# ...
logsource:
vendor:
- fortinet
product:
- fortigate
category:
- firewall
predicate:
# ...
Tip
Pouhé přejmenování souboru pravidla není dostatečné, pokud define.name koliduje s jiným pravidlem. U nesouladů logsource je opravou vždy sladit logsource s existující událostní linií, nikoli vymýšlet nové řetězce vendor/product, pokud zároveň neaktualizujete linii (nebo šablonu).
Pokud zpráva uvádí, že pod cestou nájemce nejsou žádné událostní linie s logsource, nejprve vytvořte nebo opravte událostní linie (z šablon), poté zkopírujte logsource do pravidla.
Jak logsource vypadá v šabloně
Typická šablona v /Templates/EventLanes/ definuje logsource takto:
logsource:
vendor:
- microsoft
product:
- windows
category:
- authentication
Každý klíč obvykle obsahuje jedno nebo více řetězců. Několik šablon vůbec nepředefinuje logsource.
Klíče v objektu logsource
| Klíč | Co to vybírá |
|---|---|
vendor |
Prodejce nebo značka (např. microsoft, cisco) |
product |
Produkt nebo platforma (např. windows, fortigate) |
category |
Široká oblast událostí (např. firewall, autentizace) |
service |
Jemnější označení úrovně služby tam, kde jej šablony používají (neobvyklé) |
kategorie (abecedně)
řízení-přístupu, anomálie, detekce-anomálií, antivirus, aplikace, audit, autentizace, záloha, cloud, komunikace, výpočet, připojení, kontejnerizace, databáze, dhcp, dns, edr, e-mail, koncový bod, bezpečnost-koncového-bodu, soubor, přístup-k-souboru, firewall, ftp, hardware, zdravotnická-informatika, ids, detekce-vniknutí, detekce_vniknutí, malware, správa, lékařské-snímkování, monitorování, síť, síťově-připojené-úložiště, oob, napájení, tisk, proxy, scada, bezpečnost, sharepoint, spam, úložiště, switch, systém, telefonie, detekce-hrozeb, ups, virtualizace, voip, vpn, webový-server, wifi
dodavatel (abecedně)
alcatel-lucent, apache, apc, barracuda, bitdefender, bluecoat, broadcom, brother, check-point, cisco, citrix, dell, devolutions, eaton, eset, f5, fidelis, filezilla, flowmon, fortinet, gfi, gordic, haproxy, helios, hp, hpe, ibm, icewarp, innovaphone, ivanti, juniper, kerio, lenovo, manageengine, mcafee, microsoft, mikrotik, minolta, netgate, netgear, openstack, oracle, palo-alto-networks, philips, philips-healthcare, purestorage, qnap, samba, schneider-electric, sentinelone, siemens, socomec, sophos, symantec, synology, teskalabs, ubiquiti, veeam, vmware, whalebone, wowza, ysoft, zabbix, zeek, zyxel
produkt (abecedně)
advanced-threat-analytics, advanced-visualization-workspace, advanced-visualization-workspace-15, apache-http-server, apc-ups, avw, bitdefender-cloud-security, bitdefender-gravityzone, brother-mfc, check-point-firewall, cisco-aci, cisco-asa, cisco-catalyst, cisco-ftd, cisco-ios, cisco-ise, cisco-mds, cisco-meraki, cisco-nexus, cisco-ucs, cisco-wlc, defender, defender-for-endpoint, dell-idrac, dell-powervault, diris, diskstation-manager, dna-center, dsm, eaton-ups, ecs, elastic-cloud-storage, eset-protect, ex-series, fidelis-endpoint, fidelis-network, flashsystem, flowmon-ads, fortianalyzer, fortiauthenticator, forticlient, fortigate, fortimail, fortimanager, fortiswitch, helios, hp-laserjet, hpe-primera, hpe-storeonce, ibm-qradar, ibm-tape-library, icewarp-mailserver, junos, kerio-connect, kubernetes, linux, logmanio, m365, manageengine-ad-audit-plus, manageengine-endpoint, mcafee-webwasher, microsoft-dhcp, microsoft-dns, microsoft-exchange, microsoft-iis, microsoft-sharepoint, microsoft-sql, minolta-bizhub, nas, net-vision, netapp, netscaler, network-policy-server, nginx, nova, nps, ntopng, omniswitch, openvpn, oracle-cloud, oracle-listener, oracle-spark, pan-os, pbx, pfsense, qfx-series, qnap-nas, samba-ad-dc, secure-email-gateway, sentinelone, siemens-scalance, software-defined-access, spectrum-scale, squid, srx-series, storwize, switch, synology-nas, ubiquiti-unifi, ups, veeam-backup-replication, vmware-cloud-director, vmware-esxi, vmware-vcenter, windows, wowza-streaming-engine, ysoft-safeq, zabbix, zeek-analyzer, zeek-conn, zeek-dns, zeek-files, zeek-http, zeek-kerberos, zeek-ldapsearch, zeek-mqttconnect, zeek-mqttpublish, zeek-ntp, zeek-ocsp, zeek-pe, zeek-quic, zeek-radius, zeek-sip, zeek-smtp, zeek-snmp, zeek-ssh, zeek-ssl, zeek-syslog, zeek-tunnel, zeek-weird, zeek-x509, zyxel-firewall, zyxel-switch
služba (abecedně)
Používá se pouze v některých šablonách (často souvisejících s Microsoftem): aaa, auditd, messagetrace, syslog
Skalární logsource v korelačních pravidlech
V /Correlations/ můžete také vidět jednotlivou hodnotu místo objektu, například:
logsource: complex
Hodnoty jako base, complex nebo activity určují, kterou třídu vstupu pravidlo využívá. Nejsou totéž jako výše uvedené seznamy šablon vendor / product.
Objekt logsource v korelačních pravidlech
Když filtrujete podle klasifikace jízdního pruhu, použijte stejné klíče jako v šablonách (vendor, product, category, service, …) a vyberte hodnoty ze seznamů na této stránce nebo z událostního pruhu, který odpovídá vašemu proudu. Pokud potřebujete hodnotu, která ještě není uvedena, nejprve rozšiřte příslušnou šablonu v /Templates/EventLanes/, aby byly analýza a korelace synchronizované.
Viz také
- Mapování
event.datasetnalogsource, když potřebujete propojit hodnoty parseruevent.datasets poli lanelogsource.
Sigma používá související, ale odlišný model logsource. Pro konvence Sigma category, product a service viz Log sources.
Window Correlator
Window correlator detekuje příchozí události na základě sekce predicate a ukládá je do datových struktur na základě sekce evaluate. Pokud je potom pravidlo test v sekci analyze shodné, je zavolána sekce trigger.
Sigma Correlations
Window Correlator je také používán jako engine pro Sigma Correlations, jehož syntaxe může být nativně použita v LogMan.io. Pro více informací o Sigma Correlations, viz Sigma Correlations Documentation.
Následující ukázka korelace detekuje více než nebo rovno 5 chybových připojení mezi dvěma IP adresami:
Ukázka
---
define:
name: "Network T1046 Network Service Discovery"
description: "Detekuje více než nebo rovno 5 chybových připojení mezi dvěma IP adresami"
type: correlator/window
logsource:
type: "Network"
mitre:
technique: "T1046"
tactic: "TA0007"
predicate:
!OR
- !EQ
- !ITEM EVENT log.level
- "error"
- !EQ
- !ITEM EVENT log.level
- "critical"
- !EQ
- !ITEM EVENT log.level
- "emergency"
evaluate:
dimension: [source.ip, destination.ip]
by: "@timestamp"
resolution: 60
analyze:
window: hopping
aggregate: sum
span: 10
test:
!GE
- !ARG
- 5
trigger:
- event:
threat.indicator.confidence: "Medium"
threat.indicator.ip: !ITEM EVENT source.ip
threat.indicator.port: !ITEM EVENT source.port
threat.indicator.type: "ipv4-addr"
Sekce define
Tato sekce obsahuje běžnou definici a metadata.
Položka name
Kratší název této deklarace srozumitelný lidem.
Položka type
Typ této deklarace, musí být correlator/window.
Položka description (volitelné)
Delší, případně víceliniový, popis deklarace srozumitelný lidem.
Sekce logsource
Specifikuje typy event lanes, z kterých by měly být čteny příchozí události.
Sekce predicate
Sekce predicate filtruje příchozí události pomocí výrazu.
Pokud výraz vrátí True, událost přejde do sekce evaluate.
Pokud výraz vrátí False, událost je přeskočena.
Ostatní vrácené hodnoty jsou nedefinované.
Vložení vnořených filtrů predikátů
Filtry predikátů jsou výrazy umístěné ve vyhrazeném souboru, které mohou být vloženy do mnoha různých predikátů jako jejich části.
Pokud chcete vložit externí filtr predikátů, umístěný buď v knihovně,
použijte klíčové slovo !INCLUDE:
!INCLUDE /predicate_filter.yaml
kde /predicate_filter je cesta k souboru v knihovně.
Obsah souboru predicate_filter.yaml je výraz, který má být vložen, například:
---
!EQ
- !ITEM EVENT category
- "MyEventCategory"
Sekce evaluate
Sekce evaluate specifikuje primární klíč, rozlišení a další atributy, které se aplikují na příchozí událost.
Funkce evaluate je přidat událost do dvourozměrné struktury, definované časem a primárním klíčem.
Položka dimension
Specifikuje jednoduchý nebo složený primární klíč (nebo dimenzi) pro událost. Dimenze je definována názvy polí vstupní události.
Příklad jednoduchého primárního klíče:
evaluate:
dimension: [source.ip]
Note
Tenant je automaticky přidán do seznamu dimenzí.
Příklad složeného primárního klíče:
evaluate:
dimension: [source.ip, destination.ip]
Pokud je přesně jedna dimenze jako DestinationHostname v původní události
a korelace by měla proběhnout pro každou hodnotu dimenze, dimenze by měla být uzavřena v [ ]:
evaluate:
dimension: [source.ip, destination.ip, [DestinationHostname] ]
Položka by
Specifikuje název pole vstupní události, které obsahuje informaci o datu/čase, která bude použita pro vyhodnocení. Výchozí hodnota je: @timestamp.
Položka event_count (volitelné)
Název atributu, který specifikuje počet událostí k korelaci v jedné události, čímž ovlivňuje "součet událostí" v analýze. Výchozí hodnota je 1.
Položka resolution
Specifikuje rozlišení časové agregace korelátoru. Jednotka je sekundy.
evaluate:
resolution: 3600 # 1 hodina
Výchozí hodnota: 3600
Položka saturation (volitelné)
Specifikuje délku trvání intervalu silent po vyvolání trigger.
Je specifická pro dimenzi.
Jednotka je resolution.
Výchozí hodnota: 3
Sekce analyze (volitelné)
Sekce analyze obsahuje konfiguraci časového okna, které je aplikováno na vstupní události.
Výsledek analýzy časového okna podléhá konfigurovatelnému testu. Když je test úspěšný (tedy vrátí True), je spuštěn trigger.
Poznámka: Tato sekce je volitelná, výchozí chování je spustit trigger pokud je alespoň jedna událost v tumbling s span rovno 2.
Položka when (volitelné)
Specifikuje, kdy by měla proběhnout analýza událostí v oknech.
Možnosti:
event(výchozí): Analýza probíhá po příchodu události a jejím vyhodnocení, obvykle užitečné pro korelaci shody a aritmetikuperiodic/...: Analýza probíhá po zadaném intervalu v sekundách, napříkladperiodic/10(každých 10 sekund),periodic/1h(každých 3600 sekund / jednu hodinu) atd. Obvykle užitečné pro vyhodnocení UEBA.
Periodická analýza vyžaduje správné nastavení rozlišení a rozsahu časového okna, aby analýza neprobíhala příliš často.
Položka window (volitelné)
Specifikuje, jaký druh časového okna použít.
Možnosti:
tumbling: Pevnýspan(délka trvání), nepřekrývající se, souvislé časové intervaly bez mezerhopping: Pevnýspan(délka trvání), překrývající se souvislé časové intervaly
Výchozí hodnota: hopping
Položka span
Specifikuje šířku okna.
Jednotka je resolution.
Položka aggregate (volitelné)
Specifikuje jaké agregační funkce budou aplikovány na události v okně.
Funkce agregace
sum: Součetmedian: Mediánaverage: Průměr (vážený)mean: Aritmetický průměrstd: Směrodatná odchylkavar: Rozptylmean spike: Pro detekci spike. Základní hodnota je průměr, vrací procento.median spike: Pro detekci spike. Základní hodnota je medián, vrací procento.unique count: Pro jedinečný počet atributů události: musí být poskytnutadimension.
Výchozí hodnota: sum
Příklad jedinečného počtu:
analyze:
window: hopping
aggregate: unique count
dimension: client.ip
span: 6
test:
!GE
- !ARG
- 5
Spustí trigger, když je pozorováno 5 a více jedinečných client.ip.
Položka test (volitelné)
Sekce test je výraz aplikovaný na výsledek výpočtu aggregate.
Pokud výraz vrátí True, trigger bude spuštěn, pokud dimenze není již saturována.
Pokud výraz vrátí False, žádná akce není přijata.
Ostatní vrácené hodnoty jsou nedefinované.
Sekce trigger
Sekce trigger specifikuje druhy akcí, které mají být provedeny, když test v sekci analyze spustí trigger.
Podrobnosti viz kapitola correlator triggers.
Ukládací korelátor
V oblasti kybernetické bezpečnosti je ukládací korelátor nástrojem, který shromažďuje a dočasně ukládá související události na základě specifických identifikátorů, jako jsou ID zpráv. Tento proces pomáhá sledovat a analyzovat sekvence událostí v čase, což umožňuje identifikaci vzorců nebo anomálií, které mohou naznačovat bezpečnostní hrozby. Seskupením souvisejících událostí ukládací korelátor zvyšuje schopnost monitorovat a reagovat na potenciální kybernetické incidenty, poskytuje komplexní pohled na aktivity, které nemusí být zřejmé při zkoumání jednotlivých událostí zvlášť.
Analogie pro lepší pochopení
Představte si ukládacího korelátora jako detektiva, který skládá dohromady stopy z různých zdrojů. Představte si, že detektiv dostane dva lístky: jeden se jménem osoby a druhý s jejím umístěním. Jednotlivě tyto lístky neposkytují mnoho informací, ale detektiv si všimne, že oba lístky mají stejné číslo případu (ID). Detektiv je spojí a pochopí, kdo je kde. Podobně ukládací korelátor spojuje související události pomocí společného atributu, jako je ID, aby vytvořil úplný obrázek pro další analýzu.
Příklad scénáře
Představte si, že dostanete dva kusy pošty: jeden vám říká, kdo poslal dopis, a druhý vám říká, kdo ho obdržel. Jednotlivě tyto kusy pošty neposkytují celý obrázek. Ukládací korelátor je jako chytrý asistent, který si všimne, že oba kusy mají stejné sledovací číslo (ID zprávy) a spojí je do jednoho komplexního záznamu, který ukazuje jak odesílatele, tak příjemce. To pomáhá pochopit celý kontext komunikace.
Zvažte následující logy z Event lane Postfixu pro daný tenant:
June 14 09:19:21 alice postfix/qmgr[59833]: F3710A248D: from=<alice@example.com>, size=304, nrcpt=1 (queue active)
June 14 09:19:21 alice postfix/local[60446]: F3710A248D: to=<bob@example.com>, orig_to=<alice>, relay=local, delay=0.04, delay>
Tyto logy jsou zpracovávány samostatně pomocí LogMan.io Parsec. První log ukazuje, kdo poslal email (alice@example.com), a druhý log ukazuje příjemce (bob@example.com). Parsované logy vypadají takto:
# Log #1
{
"email.message_id": "F3710A248D",
"email.from.address": ["alice@example.com"],
...
}
# Log #2
{
"email.message_id": "F3710A248D",
"email.to.address": ["bob@example.com"],
...
}
Pro spojení všech informací pro budoucí analýzu je nutné konsolidovat události do jednoho logu, který obsahuje jak informace odesílatele, tak příjemce. Ukládací korelátor provádí tuto úlohu spojením parsovaných událostí pomocí společného atributu, jako je ID zprávy (F3710A248D). Pokud žádná jiná událost se stejným ID zprávy nedorazí v rámci období send_after_seconds, vytvoří se nová událost, která zahrnuje všechny shromážděné informace:
# Uložený log
{
"email.message_id": "F3710A248D",
"email.from.address": ["alice@example.com"],
"email.to.address": ["bob@example.com"],
...
}
Tento konsolidovaný log může být poté analyzován jinými detekčními korelátory, jako je Window Correlator, pro další vyšetřování a reakci na potenciální bezpečnostní incidenty.
Ukázka
Následující ukázka ukládá události podle jejich ID zpráv a odesílá je po 10 sekundách nečinnosti:
---
define:
name: "Ukládání událostí podle ID zprávy"
description: "Příklad pro ukládání událostí podle ID zprávy"
type: correlator/stashing
logsource:
vendor: [WietseVenama]
predicate:
!IN
what: message.id
where: !EVENT
stash:
dimension: message.id
send_after_seconds: 10 # Odeslat uloženou zprávu po sekundách nečinnosti
Sekce define
Tato sekce obsahuje společnou definici a metadata.
Položka name
Kratší čitelný název tohoto prohlášení.
Položka type
Typ tohoto prohlášení, musí být correlator/stashing.
Položka description (volitelně)
Delší, případně vícero řádková čitelná popisná poznámka k prohlášení.
Sekce logsource
Specifikuje zdroje logů, uvádí výrobce nebo produkty, jejichž události pocházející z event lanes budou zpracovány.
Sekce predicate
Predicate filtruje příchozí události pomocí výrazu. Pokud výraz vrátí !!true, událost vstoupí do sekce stash. Pokud !!false, je událost přeskočena.
Zahrnutí zanořených filtračních predikátů
Filtrační predikáty jsou výrazy umístěné ve vyhrazeném souboru, které mohou být zahrnuty do mnoha různých predikátů jako jejich části.
Pro zahrnutí externího filtračního predikátu:
!INCLUDE /predicate_filter.yaml
kde /predicate_filter je cesta k souboru v knihovně.
Sekce stash
Specifikuje chování ukládání, včetně dimenze pro seskupování událostí a časového limitu pro odesílání uložených událostí po nečinnosti.
Položka dimension
Specifikuje primární klíč (nebo dimenzi) pro událost. Definováno názvy polí vstupních událostí.
Příklad primárního klíče:
stash:
dimension: [message.id]
Položka send_after_seconds
Specifikuje časový limit pro odeslání uložených událostí po období nečinnosti. Jednotkou je sekundy.
stash:
send_after_seconds: 10 # 10 sekund
Shrnutí
Stručně řečeno, ukládací korelátor funguje jako chytrý organizátor, shromažďující a spojující související události k vytvoření úplného obrázku pro další analýzu. To pomáhá identifikovat vzorce a anomálie v kybernetické bezpečnosti, poskytuje efektivnější způsob monitorování a reakce na potenciální incidenty.
Entitní Korelátor
Korelátor oken detekuje příchozí události na základě sekce predicate a ukládá je do datových struktur na základě sekce evaluate. Pokud z události detekovaná dimenze neprodukuje žádná data, je volána sekce lost v sekci triggers, jinak je volána sekce seen v sekci triggers.
Příklad
define:
name: Detekce chování uživatelské entity
description: Detekce chování uživatelské entity
type: correlator/entity
span: 5
delay: 5m # doba analýzy = delay + resolution
logsource:
vendor: "Microsoft"
predicate:
!AND
- !EQ
- !ITEM EVENT message
- "FAIL"
- !EQ
- !ITEM EVENT device.vendor
- "Microsoft"
- !EQ
- !ITEM EVENT device.product
- "Exchange Server"
evaluate:
dimension: [source.user]
by: @timestamp # Název pole události s časem události
resolution: 60 # jednotka je sekunda
lookup_seen: active_users
lookup_lost: inactive_users
triggers:
lost:
- event:
severity: "Low"
seen:
- event:
severity: "Low"
Sekce define
Tato sekce obsahuje obecné definice a meta data.
Položka name
Kratší lidsky čitelný název této deklarace.
Položka type
Typ této deklarace, musí být correlator/entity.
Položka span
Specifikuje šířku okna.
Jednotka je resolution.
Položka delay (volitelná)
Analýza probíhá po specifikovaném čase v sekundách a tento čas je založen na resolution.
Pokud je potřeba prodloužit dobu a tím zpozdit analýzu, může být uvedena volba delay, například 300 (300 sekund), 1h (3600 sekund / jedna hodina) atd.
Položka aggregation_count_field
Název atributu, který určuje počet událostí v rámci jedné agregované události, a tím ovlivňuje součet událostí v analýze. Výchozí hodnota je 1.
Položka description (volitelná)
Delší, případně víceřádkový, lidsky čitelný popis deklarace.
Sekce logsource
Specifikuje typy event lanes, ze kterých by měly být čteny příchozí události.
Sekce predicate (volitelná)
predicate filtruje příchozí události pomocí výrazu.
Pokud výraz vrátí True, událost přejde do sekce evaluate.
Pokud výraz vrátí False, je událost přeskočena.
Ostatní návratové hodnoty jsou nedefinované.
Sekce evaluate
Sekce evaluate specifikuje primární klíč, rozlišení a další atributy, které se aplikují na příchozí událost.
Funkcí evaluate je přidat událost do dvourozměrné struktury, definované časem a primárním klíčem.
Položka dimension
Specifikuje jednoduchý nebo složený primární klíč (nebo dimenzi) pro událost.
dimension je definována názvy vstupních polí události.
Příklad jednoduchého primárního klíče:
evaluate:
dimension: [source.ip]
Note
Tenant je automaticky přidán do seznamu dimenzí.
Příklad složeného primárního klíče:
evaluate:
dimension: [source.ip, destination.ip]
Pokud je přesně jedna dimenze, jako je DestinationHostname, seznam v původní události a korelace by měla probíhat pro každou hodnotu dimenze, měla by být dimenze zabalená do [ ]:
evaluate:
dimension: [source.ip, destination.ip, [DestinationHostname] ]
Položka by
Specifikuje název pole vstupní události, které obsahuje datum/čas, který bude použit pro vyhodnocení. Výchozí hodnota je: @timestamp.
Položka resolution (volitelná)
Specifikuje rozlišení časové agregace korelátoru. Jednotka je sekundy.
evaluate:
resolution: 3600 # 1 hodina
Výchozí hodnota: 3600
Položka lookup_seen
lookup_seen specifikuje ID lookupu, kam se zapisují viděné entity s časem posledního vidění
Položka lookup_lost
lookup_lost specifikuje ID lookupu, kam se zapisují ztracené entity s časem poslední analýzy
Sekce triggers
Sekce triggers specifikuje druhy akcí, které mají být provedeny, když proběhne periodická analýza.
Podporované akce jsou lost a seen.
Podrobnosti viz kapitola korelační triggery.
seen triggery
Triggery seen se provádějí, když analýza nalezne události, které vstoupily do okna v analyzovaném čase.
Dimezi (název entity) lze získat pomocí !ITEM EVENT dimension.
Čas poslední události, která přišla do okna v dané dimenzi, lze získat pomocí !ITEM EVENT last_event_timestamp (entita aktualizována).
Příklad:
seen:
- lookup: user_inventory
key: !ITEM EVENT dimension
set:
last_seen: !ITEM EVENT last_event_timestamp
lost triggery
Triggery lost se provádějí, když analýza zjistí, že do specifikované dimenze v analyzovaném čase nepřišla žádná událost (entita klesla).
Dimezi (název entity) lze získat pomocí !ITEM EVENT dimension.
Příklad:
lost:
- event:
severity: "Low"
dimension: !ITEM EVENT dimension
Korelátor shody
Korelátor shody detekuje příchozí události na základě sekce predicate. Pokud událost odpovídá filtru predicate, je volána sekce trigger.
Hint
Vždy zvažte použití Korelátoru okna místo Korelátoru shody, protože Korelátor shody produkuje jednu výstupní událost na jednu vstupní událost a tedy neprovádí žádné seskupování příchozích událostí na základě času.
Příklad
---
define:
name: "Network T1046 Network Service Discovery"
description: "Detekuje připojení mezi dvěma IP adresami"
type: correlator/match
logsource:
type: "Network"
mitre:
technique: "T1046"
tactic: "TA0007"
predicate:
!OR
- !EQ
- !ITEM EVENT log.level
- "error"
- !EQ
- !ITEM EVENT log.level
- "critical"
- !EQ
- !ITEM EVENT log.level
- "emergency"
trigger:
- event:
threat.indicator.confidence: "Medium"
threat.indicator.ip: !ITEM EVENT source.ip
threat.indicator.port: !ITEM EVENT source.port
threat.indicator.type: "ipv4-addr"
Sekce define
Tato sekce obsahuje společnou definici a metadata.
Položka name
Kratší, člověkem čitelný název této deklarace.
Položka type
Typ této deklarace, musí být correlator/match.
Položka description (volitelné)
Delší, pravděpodobně víceliniový, člověkem čitelný popis deklarace.
Sekce logsource
Specifikuje typy event lanes, ze kterých by měly být čteny příchozí události.
Sekce predicate
Predicate filtruje příchozí události pomocí výrazu. Pokud výraz vrátí True, událost vstoupí do sekce trigger.
Pokud výraz vrátí False, pak je událost přeskočena.
Jiné návratové hodnoty jsou nedefinované.
Sekce trigger
Sekce trigger specifikuje, jaké druhy akcí mají být provedeny, když je trigger vyvolán úspěšným výsledkem v sekci predicate.
Podrobnosti viz kapitola triggery korelátoru.
Spouštěče
Spouštěče definují výstup korelátorů, baselineů atd. Žijí v sekci trigger korelátoru. Každé pravidlo v knihovně může definovat mnoho spouštěčů (je to seznam).
Spouštěč může přistupovat k původní události prostřednictvím výrazu !EVENT, což je poslední událost, která prošla testem hodnocení.
Hodnota z agregační funkce je dostupná na !ARG.
Spouštěč event
Tento spouštěč vloží novou událost do komplexního Event lane.
Příklad event spouštěče:
trigger:
- event:
threat.indicator.confidence: "Medium"
threat.indicator.ip: !ITEM EVENT source.ip
threat.indicator.port: !ITEM EVENT source.port
threat.indicator.type: "ipv4-addr"
Může se jednat až o 5 výsledků, například v agregační funkci mean spike:
trigger:
- event:
events: !ARG EVENTS
MeanSpike:
!GET
from: !ARG RESULTS
what: 0
MeanSpikeLastCount:
!GET
from: !ARG RESULTS
what: 1
MeanSpikeMean:
!GET
from: !ARG RESULTS
what: 2
Spouštěč lookup
Spouštěč lookup manipuluje s obsahem lookupu. To znamená, že může přidat (set), inkrementovat (add), dekrementovat (sub) a odstranit (delete) záznam v lookupu.
Záznam je identifikován pomocí klíče, což je jedinečný primární klíč.
Příklad spouštěče, který přidá záznam do lookupu user_list:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
set:
score: 1
Příklad spouštěče, který odstraní záznam z lookupu user_list:
trigger:
- lookup: user_list
delete: !ITEM EVENT user.name
Příklad spouštěče, který inkrementuje čítač (pole my_counter) v záznamu lookupu user_list:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
add: my_counter
Příklad spouštěče, který dekrementuje čítač (pole my_counter) v záznamu lookupu user_list:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
sub: my_counter
Pokud pole čítače neexistuje, je vytvořeno s defaultní hodnotou 0.
Spouštěč notification
Tento spouštěč vloží nové oznámení do primární datové cesty, kterou čte asab-iris.
Příklad notification spouštěče:
- notification:
type: email
template: "/Templates/Email/notification_4728.md"
to: eliska.novotna@teskalabs.com
variables:
name: "brute-force"
events: !ARG
Tenant Rex
LogMan.io Tenant Rex
LogMan.io Tenant Rex (lmio-trex) je mikroslužba, která spravuje obchodní tenanty a automaticky nasazuje pro každého tenanta modely baseliner a correlator vzdálené kontroly.
Tato stránka je jediným místem pro operátory a administrátory, kteří potřebují pochopit, jak T Rex umisťuje korelátory, obnovuje je a které soubory odstraňuje.
Analytici, kteří v uživatelském rozhraní pouze povolují pravidla, by si měli přečíst Nasazení detekčních pravidel.
Co dělá T Rex
- Vytváří, aktualizuje a odstraňuje objekty podnikových nájemců (MongoDB), včetně atributů, jako jsou schéma a časové pásmo.
- Píše modely knihoven do
/Site/model-trex-{tenant}.yamlprolmio-baselineralmio-correlator. - Po změně modelu žádá ASAB Remote Control, aby spustil
compose up(standardně postupynode_upgrade/cluster_sequential_up; volitelně starší metoda per-nodePOST /node/{id}). - Volitelně komunikuje s Kafka Admin API pro zpoždění spotřebitelů, členství (HA) a mazání nepoužívaných skupin spotřebitelů korelátoru.
T Rex ne hodnotí korelační pravidla. Hodnocení pravidel zůstává uvnitř lmio-correlator.
Volba vůdce
S volbou vůdce pomocí ZooKeeper ([trex] leader_name, výchozí lmio-trex):
- Pouze vedoucí přestavuje modely, spouští životní cyklus korelátoru (prodleva / HA / údržba Kafka) a ukládá nájemce do ZooKeeperu.
- Následovníci udržují HTTP API.
Spusťte jednu nebo více instancí T Rex na každý cluster. Musí sdílet MongoDB a ZooKeeper.
Umístění korelátoru
T Rex vytváří instance korelátoru z výběru nájemce Detections v MongoDB (knihovní složky; vybraný soubor se mapuje na svou rodičovskou složku).
Vyloučené složky
Ve výchozím nastavení se tyto předpony knihoven nikdy nezmění na skupiny korelátorů ([correlator] exclude_folders):
/Detections/Parsec//Detections/Filtry/
Jsou vyřazeni z výběrů nasazení a z tvorby modelů.
Hloubka složky (folder_max_depth)
Ve výchozím nastavení T Rex umístí korelátor na nejbližší / nejhlubší vybranou složku.
Hloubku můžete omezit pod vybranými kořeny pomocí [correlator] folder_max_depth (víceřádkově path=N). Hloubka je počet segmentů cesty pod tímto kořenem.
Výchozí:
[correlator]
folder_max_depth=
/Detections/Sigma/=3
Příklad s /Detections/Sigma/=3:
- Cesta k pravidlu:
/Detections/Sigma/windows/builtin/security/account_management/rule.yaml - Korelátor
groups:/Detections/Sigma/windows/builtin/security/ - Hlouběji ukryté podsložky sdílejí tu jednu instanci (korelátor stále načítá pravidla rekurzivně).
Cesty, které nejsou uvedeny, si zachovávají chování nejbližší / nejhlubší složky (typické pro /Correlations/…).
Nastavení folder_max_depth v konfiguraci nahrazuje celý výchozí seznam. Pokud přidáte jiné kořenové složky a stále chcete limit Sigma, znovu zahrňte /Detections/Sigma/=3.
Prázdné nebo chybějící složky
Pokud vybraná složka nemá v Knihovně žádné povolené soubory pravidel (je prázdná, smazaná nebo všechny jsou zakázané), T Rex tento korelátor z modelu vynechá. Při příští přestavbě ho prostřednictvím Vzdálené správy up odinstaluje.
Kafka spotřebitel group_id
Každá instance korelátoru získá explicitní skupinu spotřebitelů Kafka pod pipeline:CorrelatorsPipeline:KafkaSource:
lmio_correlator_<instance_id>
Pomlčky v ID instance se změní na podtržítka.
Když instance opustí model, T Rex smaže tu spotřebitelskou skupinu (pokud je nastaveno [kafka] bootstrap_servers). Periodická údržba také odstraňuje opuštěné skupiny s předponami lmio_correlator* a starší lmio-correlator*.
Adresáře s daty na disku nejsou mazány. Po odstranění instance může na uzlu zůstat hostitelská složka, například /data/ssd/correlators/lmio-correlator-…. Příkaz Remote Control up neodstraní nepoužívané zdroje svazků. Pokud je potřeba, vyčistěte je na uzlu.
Rozdělování pravidel založené na prodlevě
Když je [correlator:lag] enabled=yes a Kafka je dostupná:
- T Rex vzorkuje zpoždění spotřebitele pro známé skupiny.
- Chronicky rostoucí zpoždění snižuje efektivní limit pravidel na instanci pro tuto složku.
- Další přestavba modelu vytváří více instancí se stejnou složkou
groups, ale s různými částmiread_from/read_declarations. - Každá část má svůj vlastní
group_ida stále čte celý proud událostí; hodnotí pouze svůj podmnožinu pravidel.
Tím se přidává kapacita CPU pro pravidla. Nejde o škálování particí Kafka.
I když je adaptace zpoždění vypnutá, T Rex stále rozděluje složku, pokud má více pravidel než default_rules_limit (výchozí 500), až do max_instances_per_folder (výchozí 10).
Zakázání škálování korelátoru
- Zastavte snižování limitu pravidel na jeden případ způsobené zpožděním:
[correlator:lag]
enabled=no
- Uchovávat jednu instanci korelátoru na složku bez ohledu na počet pravidel (žádné statické dělení):
[correlator:lag]
enabled=no
max_instances_per_folder=1
Alternativně zvyšte default_rules_limit dostatečně vysoko, aby žádná složka jej nepřekročila. Kafka sampling pro HA může stále používat sample_every_ticks z této sekce; pouze přehodnocení zpoždění se přeskočí, pokud je enabled=no.
Zakázat synchronizaci položky knihovny (detekční obrazovka)
Po změně výběru detekce se T Rex synchronizuje s příznaky zakázání asab-knihovny podle výběru (PUT /library/item-disable/...) pro YAML ve nasazených složkách. Vybraná pravidla, která byla zakázána, se povolí; nevybraná se zakážou. To udržuje knihovnu a obrazovku detekcí v souladu.
Ve výchozím nastavení T Rex synchronizuje každou složku (item_disable_sync_max_rules=0). Velké složky jsou pomalé (jedno PUT na pravidlo, které je potřeba změnit). Nastavte kladnou hodnotu [correlator] item_disable_sync_max_rules (např. 500) pro přeskočení zakázání položek u nadměrných složek a uložení pouze výběru / přestavbu modelu.
- Kompromis při přeskočení: dříve zakázaná pravidla v té složce zůstávají zakázána, dokud znovu nezvýšíte limit na
0, nesnížíte jej nebo je z jiného způsobu nezapnete. - PUTy používají
[asab:library] item_disable_concurrency(výchozí 1; vyšší hodnoty mohou způsobit závod na/.disabled.yaml). Po každé aplikaci T Rex znovu vylistuje a zkouší až do[asab:library] item_disable_sync_rounds(výchozí 8, s postupným zpožděním). Synchronizace je na úrovni nájemce a běží z detekčního API, nikoliv z modelového zápisového tiknutí.
[correlator]
item_disable_sync_max_rules=0
# item_disable_sync_max_rules=500 # skip item-disable on folders with more than 500 rules
[asab:library]
# item_disable_concurrency=1
# item_disable_sync_rounds=8
Vysoká dostupnost (HA)
Když je [correlator:ha] enabled=yes a Kafka je dostupná:
- T Rex sleduje počet členů Kafka pro každou skupinu korelátorů.
- Pokud členové zůstanou na nule déle než
unhealthy_after_sec(výchozí 300 s), T Rex požádá Remote Control oupna aktuálním uzlu (lokální restart; umístění beze změny). - Pokud členové zůstanou na nule ještě další
unhealthy_after_secpo tomto lokálnímup, T Rex přiřadí instanci k jinému způsobilému uzlu (uzly ZooKeeper kroměarbiterano-trex) a znovu nahraje model.
failover_cooldown_sec (výchozí 600 s) omezuje, jak často se může přesun opakovat.
Když je přepnutí při selhání přeskočeno
Přepnutí uzlu nemůže opravit poškozené pravidlo korelace. T Rex proto nepřesouvá instanci, když ASAB zjištění pro tento korelator stále hlásí:
correlation_rules_with_errors(z korelátoru AttentionService)- nebo
attention_requiredna mikroservisu advertisement
V takovém případě dostanete nejvýše jeden lokální up, poté varování k opravě pravidel / problémů s knihovnou. Zkontrolujte protokoly korelátoru a upozornění knihovny.
Jistič
[correlator:ha] max_failovers (výchozí 2) omezuje, kolik přesunů uzlů se může stát během jedné epizody s nefunkčním stavem. Poté T Rex přestane provádět failover (užitečné pro smyčky zhroucení, kdy objevování nikdy neoznamuje). Nastavte 0 pro neomezený počet přesunů (nedoporučuje se).
Aktivní aktivní umístění
Když [correlator:active_active] enabled=yes (výchozí hodnotou je vypnuto):
- Každý logický řez korelátoru je nasazen na každém způsobilém uzlu.
- Repliky sdílejí stejnou konfiguraci a stejný Kafka
group_id. - Přepnutí uzlu při selhání je zakázáno; lokální
upmůže stále běžet, pokud sdílená skupina nemá žádné členy.
Umístění baselineru
Ve výchozím nastavení ([baseliner:ha] enabled=yes) T Rex umístí jednu instanci baselineru na každý způsobilý uzel. Nastavte enabled=no pro jednu instanci s hashováním umístěnou na každého nájemce.
Odkaz na konfiguraci (lmio-trex)
[kafka]
# Required for lag, HA membership, and consumer group deletion.
bootstrap_servers=kafka-1:9092,kafka-2:9092
[correlator]
exclude_folders=
/Detections/Parsec/
/Detections/Filters/
folder_max_depth=
/Detections/Sigma/=3
# item_disable_sync_max_rules=0
# item_disable_sync_max_rules=500 # skip item-disable on oversized folders
[asab:library]
# item_disable_concurrency=1
# item_disable_sync_rounds=8
[correlator:lag]
enabled=yes
sample_every_ticks=6
housekeep_every_ticks=30
# default_rules_limit=500
# max_instances_per_folder=10
# enabled=no # no lag driven split
# max_instances_per_folder=1 # at most one instance per folder (also with enabled=no)
[correlator:ha]
enabled=yes
unhealthy_after_sec=300
failover_cooldown_sec=600
max_failovers=2
[correlator:active_active]
enabled=no
[baseliner:ha]
enabled=yes
[trex]
leader_name=lmio-trex
[asab:remote:control]
# use_procedures=yes # default: node_upgrade / cluster_sequential_up
# use_procedures=no # legacy POST /node/{id} command=up
# Wait for Remote Control procedure completion (seconds). 0 = fire and forget after Accepted.
procedure_wait_sec=600
procedure_poll_sec=5
HTTP API poslouchající port: 8962 (viz Síťové porty).
Související čtení
- Nasazení pravidel detekce (uživatelské rozhraní analytika)
- Monitorování výkonnosti detekce (zpožděná a pomalá pravidla)
- Konfigurace korelátoru (manuální modely a Kafka pro
lmio-correlator) - Metriky korelátoru
Alerts
LogMan.io Alerty
TeskaLabs LogMan.io Alerty je mikroslužba SIEM, která je primárně zodpovědná za vytváření a správu tiketů alertů a incidentů. Provádí analýzu a zpracování bezpečnostních událostí jak v uživatelském (API), tak v automatickém režimu (zpracování událostí Kafka generovaných LogMan.io Correlatorem, LogMan.io Baselinerem, LogMan.io Watcherem, LogMan.io Wardenem a dalšími službami), přičemž nabízí řadu různých možností, jako je skupinování, potlačení, notifikace atd.
LogMan.io Alerty - konfigurace
LogMan.io Alerty mají následující závislosti:
- Apache ZooKeeper
- NGINX (pro produkční nasazení)
- Apache Kafka
- MongoDB
- Elasticsearch
- TeskaLabs SeaCat Auth
- LogMan.io Knihovna s adresáři
/Alertsa/Schemas
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-alerts:
- <node> # Nahraďte názvem uzlu
Příklad
Tento příklad ukazuje nejzákladnější konfiguraci potřebnou pro LogMan.io Alerty:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[elasticsearch]
url=http://es01:9200/
[asab:storage]
mongodb_uri=mongodb://mongodb1,mongodb2,mongodb3/?replicaSet=rs0
[auth]
multitenancy=yes
public_keys_url=http://localhost:8081/openidconnect/public_keys
[tenants]
tenant_url=http://localhost:8081/tenant
Zookeeper
Uveďte umístění Zookeeper serverů v clusteru.
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Hint
Pro neprodukční nasazení je možné použít jediný Zookeeper server.
Knihovna
Uveďte cestu k knihovně, ze které se budou načítat deklarace workflow a schémata tenantů.
[library]
providers=zk:///library
Hint
Jelikož jsou workflow vždy umístěny v /Alerts/Workflow, zvažte použití LogMan.io Common Library.
Hint
Jelikož je schéma ECS.yaml v /Schemas využíváno ve výchozím nastavení, zvažte použití LogMan.io Common Library.
Kafka
Uveďte bootstrap servery Kafka clusteru.
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Hint
Pro neprodukční nasazení je možné použít jediný Kafka server.
Elasticsearch
Uveďte URL Elasticsearch master serverů.
Elasticsearch se používá k načítání událostí spojených s ticketem.
[elasticsearch]
url=http://es01:9200/
username=MOJEJMÉNOUTIVATELE
password=MOJEHESLO
MongoDB
Uveďte URL MongoDB clusteru s replikací.
Tickety jsou ukládány do MongoDB.
[asab:storage]
type=mongodb
mongodb_uri=mongodb://mongodb1,mongodb2,mongodb3/?replicaSet=rs0
Auth
Sekce Auth zajišťuje, že uživatelé mají přístup pouze ke svým přiřazeným tenantům pro nastavení alertů.
Podporuje multitenanci a kontroluje zdroje uvedené v deklaracích workflow.
[auth]
multitenancy=yes
public_keys_url=http://localhost:8081/openidconnect/public_keys
Tenants
Sekce Tenants zajišťuje čtení seznamu dostupných tenantů.
[tenants]
tenant_url=http://localhost:8081/tenant
Vstup
Mikroslužba Alerty obsahuje Kafka rozhraní, které čte příchozí signály z dedikovaného topicu lmio-signals.
Jméno topicu nebo group ID lze změnit pomocí:
[kafka:signals]
topic=lmio-signals
group_id=lmio-alerts
Note
Změna vstupního topicu se nedoporučuje, aby se předešlo zbytečným komplikacím.
Webová API
Alerty poskytují jedno webové API.
Webové API je navrženo pro komunikaci s UI.
[web]
listen=0.0.0.0 8953
Výchozí port veřejného webového API je tcp/8953.
Tento port je navržen pro využití jako NGINX upstream pro spojení z kolektorů.
Taxonomie alertů
TeskaLabs LogMan.io poskytuje následující taxonomii pro organizaci a správu různých artefaktů generovaných v systému:
- Událost
- Log
- Komplexní
- Ticket
- Alert
- Incident
Události jsou záznamy aktivit, které se vyskytují v síti, systémech nebo aplikacích organizace. Mohou být dále klasifikovány na logy a komplexní události.
Tickety jsou záznamy, které pomáhají sledovat a spravovat bezpečnostní události, které vyžadují pozornost. Tickety jsou vytvářeny analytiky kybernetické bezpečnosti nebo automatizovanými koreláttory a detektory. Ticket může odkazovat na nula, jednu nebo více událostí. V současnosti rozlišujeme mezi alerty a incidenty.
Tato klasifikace má za cíl pomoci analytikům kybernetické bezpečnosti prioritizovat jejich pracovní zátěž a rychle reagovat na bezpečnostní hrozby.
Typy událostí
Logy jsou základní záznamy generované různými zařízeními, systémy nebo aplikacemi, které ukládají informace o jejich činnosti. Příklady zahrnují logy firewallu, logy serveru nebo logy aplikace. Pomáhají analytikům pochopit, co se děje v prostředí organizace, a mohou být použity k detekci bezpečnostních hrozeb a anomálií.
Komplexní události se týkají korelovaných nebo agregovaných událostí, které mohou naznačovat bezpečnostní incident nebo vyžadovat další analýzu. Jsou generovány koreláttory, baselinery a dalšími detektory, které shromažďují události z různých zdrojů, analyzují je a vytvářejí alerty na základě předdefinovaných pravidel nebo algoritmů strojového učení.
Typy ticketů: Fáze vyšetřování
Alerty jsou generovány, když je detekována specifická událost, série událostí nebo anomálie, která může naznačovat potenciální bezpečnostní hrozbu. Alerty obvykle vyžadují okamžitou pozornost od analytiků kybernetické bezpečnosti k třídění, vyšetřování a určení, zda je ticket skutečným bezpečnostním incidentem.
Incidenty jsou potvrzené bezpečnostní události, které byly prozkoumány a klasifikovány jako hrozby. Představují vyšší úroveň závažnosti než alerty a často zahrnují koordinovanou reakci od více týmů, jako je odezva na incidenty nebo správa sítě, k zadržení, nápravě a obnově.
Typy ticketů: Fáze životního cyklu
Spící ticket je ticket bez přiřazeného stavu pracovního postupu, který ještě nevstoupil do pracovního postupu. Není viditelný / přístupný uživatelům.
Běžný ticket je ticket, který vstoupil do pracovního postupu a je v aktivním stavu.
Ticket
Hlavní parametry tiketu
Každý tiket má své unikátní ID a název i další parametry (povinné i volitelné):
- Typ:
alert/incident - Závažnost
- Stav: fáze workflow, ve které se tiket nachází (
open/triaged/closed/deleted) - Skóre rizika
- Responder: osoba odpovědná za probíhající vyšetřování
- Popis
ID tiketu
Výchozí nastavení
ID tiketu se skládá ze dvou částí:
- čtyřpísmenného prefixu
- šestimístného čísla, tj.
000001
Pokud není nakonfigurován písmenkový prefix, jako prefix se použijí první čtyři písmena tenantu, tj. SYST pro tenant system.
Například první tiket v tenantu system bude mít ID SYST-000001.
Note
Každé ID tiketu má být unikátní.
- první číselná posloupnost jde od
000001do999999, - druhý blok posloupnosti je
A00001ažA99999a automaticky se resetuje naB00001, - poslední blok posloupnosti končí ID tiketu
{letter_prefix}-Z99999.
Hint
Pro pokračování generování unikátních ID tiketů po přidělení posledního čísla poslední posloupnosti nastavte v konfiguraci jiný prefix. Generování ID se vrátí k 1. bloku posloupnosti, tj. {new_letter_prefix}-000001.
Konfigurace ID tiketu
Formát ID lze do jisté míry nakonfigurovat v /Site/model.yaml:
- délka prefixu (výchozí 4 písmena)
- délka čísla (výchozí 6 číslic)
- společný prefix (jeden pro všechny tikety ve všech tenantech)
- prefix specifický pro tenant (výchozí je zkrácený název tenantu)
Společný prefix
services:
lmio-alerts:
asab:
config:
ticket:
id_prefix: LMIO
V uvedeném příkladu:
- všechny tikety ve všech tenantech budou mít ID s prefixem
LMIO, tj.LMIO-{number}.
Prefix specifický pro tenant
services:
lmio-alerts:
asab:
config:
tenant_prefix:
system: SSTM
standard: STRD
V uvedeném příkladu:
- tikety pro tenant
systembudou mít ID s prefixemSSTM, tj.SSTM-{number}; - tikety pro tenant
standardbudou mít ID s prefixemSTRD, tj.STRD-{number}.
Délka prefixu
services:
lmio-alerts:
asab:
config:
ticket:
len_prefix: 5
V uvedeném příkladu:
- všechny tikety ve všech tenantech vyžadují 5písmenný prefix pro ID tiketů;
- pokud je nakonfigurován kratší prefix, automaticky se doplní nulami;
- pokud je nakonfigurován delší prefix, automaticky se zkrátí na pět písmen;
- pokud prefix není nakonfigurován, jako prefix se použijí první pět písmen názvu tenantu.
Délka čísla
services:
lmio-alerts:
asab:
config:
ticket:
len_number: 3
V uvedeném příkladu:
- všechny tikety budou mít v ID 3místné číslo, tj.
{letter_prefix}-001.
Další detaily tiketu
Atributy
Atributy jsou různé indikátory kompromitace, které mohou být relevantní pro vyšetřování daného bezpečnostního incidentu.
Názvy atributů pocházejí ze Schema (např. source.ip, source.port, user.id atd.).
Ve výchozím nastavení zobrazujeme seznam hodnot atributů s počítadlem pro každou. Číslo udává, kolikrát se tato hodnota v souvislosti s tímto tiketem objevila.
Obohacení tiketu
Můžete přidat konkrétní atributy a vytvořit flexibilnější obsah tiketu orientovaný na incident.
Jak obohatit tiket o vlastní atributy:
- uveďte zvolené atributy v sekci
additional_attributespříslušného detekčního pravidla, nebo - použijte volbu
Add new attributesv UI pro obohacení konkrétního tiketu.
Záznam atributů
Některé typy atributů (strings, ips, floats, booleans) se ve výchozím nastavení ukládají automaticky.
Celočíselné atributy se zaznamenávají pouze pokud je ve Schema určena metoda skupinování.
Hint
Pokud v tiketu chybí atribut z detekčního pravidla, zkontrolujte, zda je jeho typ ve výchozím nastavení zaznamenáván, nebo zda ve Schema potřebuje metodu skupinování.
Existují dvě metody skupinování:
rawukládá celočíselnou hodnotu beze změny (např. porty, status kódy).log10seskupuje neomezené počítadlo velikosti do bucketů (např. bajty, velikosti souborů). Přesná hodnota se nezaznamenává.
Volba format: humanize zobrazí hodnotu v UI v kratší, uživatelsky přívětivé podobě, například 1M místo 1000000.
destination.port:
type: ui16
alert:
grouping:
method: raw
description: Stores attribute value as is
http.response.bytes:
type: si64
format: humanize
alert:
grouping:
method: log10
description: Groups large values into magnitude buckets
Časová osa
Časová osa zaznamenává všechny relevantní změny v tiketu, jako jsou fáze životního cyklu tiketu, změny responderů, relevantní komentáře uživatelů atd.
Je to entita orientovaná na vyšetřování, což znamená, že zobrazuje pouze data aktuálně relevantní k danému problému.
Události
Úplná hierarchie přímo přiřazených událostí a událostí z vnořených tiketů.
Související tikety
Úplná hierarchie přímo přiřazených tiketů a jejich vnořených tiketů.
Workflow
Workflow je popis standardního životního cyklu tiketu, který specifikuje:
- autorizaci (zdroje) potřebnou k zobrazení podrobností tiketu
- stavy, do kterých může tiket vstoupit
- autorizaci (zdroje) potřebnou k provedení těchto přechodů
LogMan.io Alerts používá následující workflow uložené v Knihovně:
/Alerts/Workflow/alert.yaml(pro tikety s typem alert)/Alerts/Workflow/incident.yaml(pro tikety s typem incident)
Schéma workflow
Deklarace workflow
---
define:
type: alerts/workflow
workflow:
open:
label: {
'c': "Otevřený",
'en': "Open",
'cs': "Otevřený",
}
icon: ""
transitions:
triaged:
resources: [lmio:alert:triaged]
closed: {}
deleted: {}
triaged:
label: {
"c": "Roztříděný",
"en": "Triaged",
"cs": "Roztříděný",
}
icon: ""
transitions:
closed: {}
deleted: {}
closed:
resources: lmio:alert:closed
label: {
"c": "Zavřený",
"en": "Closed",
"cs": "Zavřený",
}
icon: ""
transitions:
deleted: {}
deleted:
label: {
"c": "Smazaný",
"en": "Deleted",
"cs": "Smazaný",
}
icon: ""
workflow
Existují čtyři stavy v standardním životním cyklu tiketu:
opentriaged*closeddeleted
Note
Čtyři stavy výše jsou výchozími stavy standardního životního cyklu tiketu.
Vlastní stavy workflow jsou podporovány: další stavy přidejte jako klíče deklarace workflow.
Definice pro každý stav může obsahovat následující atributy:
label
Uživatelsky přívětivý název pro daný stav tiketu se všemi dostupnými jazykovými variantami.
icon
Uživatelsky přívětivá vizuální reprezentace pro daný stav tiketu.
resources
Název nebo seznam zdrojů, ke kterým musí být uživatel přiřazen k zobrazení podrobností tiketu.
Pokud není specifikováno (žádná sekce resources), nejsou vyžadovány žádné speciální zdroje pro přístup k datům tiketu.
V výše uvedeném příkladu:
- jakýkoli uživatel může přistupovat k
opentiketům (žádná sekceresources); - pro zobrazení
closedtiketů je vyžadován zdrojlmio:alert:closed.
transitions
Definuje povolené přechody do jiných stavů, stejně jako zdroje, ke kterým musí být uživatel přiřazen k změně stavu tiketu.
Stavy mohou být uvedeny buď s:
- prázdnými závorkami
{ }(není potřeba žádný specifický zdroj pro přesunutí tiketu do daného stavu), nebo - názvem či seznamem zdrojů, ke kterým musí být uživatel přiřazen, aby mohl tiket přesunout do daného stavu.
Pokud není specifikováno (žádná sekce transitions), není povolen žádný přechod do jiného stavu.
V výše uvedeném příkladu:
- přechody z
deletedtiketů nejsou povoleny (žádná sekcetransitions); - zpětné přechody pro
closedtikety nejsou povoleny (pouze možnostdeletedv sekcitransitions); - pro změnu stavu tiketu z
opennatriagedje vyžadován zdrojlmio:alert:triaged; - nejsou vyžadovány žádné speciální zdroje pro změnu stavu tiketu z
opennaclosednebodeleted.
Výchozí přechody
Note
Tikety, které nebyly upraveny po dobu 10 let, budou automaticky uzavřeny.
Výchozí přechodové období lze přeconfigurovat v model.yaml:
asab:
config:
ticket:
period: 120d
Warning
Všimněte si, že zpětný přechod ze stavu uzavřený není v současnosti možný.
Naplánované přechody
LogMan.io Alerts může automaticky otevírat a uzavírat tikety jak v reálném čase, tak ve formě naplánovaných přechodů. Další podrobnosti naleznete v Schedule Tickets.
*triaged zhruba znamená "v procesu", ale přesnější definice by byla "prochází bezpečnostní kontrolou".
Signál
Signál je informativní pojem / indikace pro správu alertů generovaný LogMan.io Correlatorem, LogMan.io Baselinerem, LogMan.io Watcherem, LogMan.io Wardenem a dalšími službami.
Na základě těchto zpráv LogMan.io Alerts vytváří nové tikety nebo aktualizuje existující a aplikuje skupinování.
Konfigurace signálu v deklaracích
Detekční pravidla (korelační pravidla, baseline pravidla a podobně) mohou ve své deklaraci obsahovat sekci signal, která určuje, zda a jak posílají signály do Alert Management (výchozí trigger, skupinování, název tiketu).
Výchozí trigger signálu
Ve výchozím nastavení při spuštění korelačního nebo baseline pravidla odešle signál, aby LogMan.io Alerts mohly vytvořit nebo aktualizovat tiket. Pro zakázání tohoto výchozího signálu (pravidlo nebude vytvářet tikety v Alert Management) nastavte:
signal:
default: false
Hint
Tuto volbu použijte, když je pravidlo určeno pro analýzu nebo jako vstup pro jiná pravidla, ne jako přímý zdroj alertů. Například baseline, který pouze napájí korelační logiku, by nastavil default: false.
Atributy skupinování
Signály se seskupují do tiketů podle group id. Ve výchozím nastavení se group id odvozuje z atributů v sekci evaluate pravidla (nebo z cesty pravidla). Pro určení jiných atributů pro skupinování použijte volbu grouping:
signal:
grouping:
- user.name
- host.id
Uvedené atributy se použijí pro sestavení group id. Když dorazí nový signál, LogMan.io Alerts hledá existující tiket se stejným group id a aktualizuje ho; jinak vytvoří nový tiket. Podrobnosti viz Skupinové lístky.
Název
Můžete nastavit vlastní název tiketu vytvořeného ze signálu:
signal:
title: Host Anomaly
Pokud není uveden, název tiketu se odvozuje z pravidla (např. cesta pravidla nebo výchozí pojmenování).
Vlastní atributy
Pro obohacení tiketu o další atributy:
signal:
additional_attributes:
- event.action
Kombinace voleb
V jedné sekci signal můžete kombinovat default, grouping, title a další parametry:
signal:
default: true
title: Host Anomaly
grouping:
- user.name
- host.id
additional_attributes:
- event.action
Kde sekce signal platí
- Correlator deklarace: použijte sekci
signalpro řízení výchozího signálu, skupinování a názvu (viz Correlator). Pro explicitní položku- signal:v seznamutriggerpravidla (mapování polí do payloadu signálu) viz Triggers. - Baseliner deklarace: použijte
signal: default: false, když je baseline pouze pro analýzu nebo vstup do korelace; lze také nastavitsignal: title:asignal: grouping:(viz Defining baselines). - Další služby (např. Warden, lookups) mohou podporovat signálové triggery ve svých definicích triggerů; viz příslušná dokumentace.
Skupinové lístky
Když je přijato nové signal, LogMan.io Alerts hledá lístek se stejnou hodnotou group id.
Pokud existuje, stávající lístek je aktualizován následujícím způsobem:
- přidružené události z příchozího signálu přidány do dat stávajícího lístku;
- přidružené lístky z příchozího signálu přidány do dat stávajícího lístku;
- atributy (indikátory kompromitace) z příchozího signálu přidány do dat stávajícího lístku;
- závažnost a rizikové skóre jsou aktualizovány, pokud došlo k nárůstu.
Odpovědnost za nastavení společného group id pro řadu po sobě jdoucích signálů leží na klientské službě, která posílá své signály do správy upozornění.
Notifikace
Info
Notifikace jsou k dispozici od LogMan.io v25.30.
Tato stránka je plně aktualizována pro změny zavedené v LogMan.io v26.37
LogMan.io Alerts mohou posílat notifikace o aktivitě na tiketech prostřednictvím několika kanálů a režimů doručení.
Konfigurace je uložena v Knihovně na /Alerts/Notifications/settings.yaml.
Kanály notifikací
Režimy doručení
- Naplánované — odesílány v konfigurovaných intervalech
- Okamžité — odesílány ihned po události
- SLA — odesílány při porušení SLA
Povolit kanály notifikací
Note
Notifikace se odesílají prostřednictvím mikroservisy ASAB Iris. Před povolením notifikací se ujistěte, že je správně nakonfigurována.
Pro povolení kanálu notifikací přidejte odpovídající sekci do nastavení Knihovny.
---
define:
type: alerts/notifications
email: {}
slack: {}
sms: {}
push: {}
Povolit režimy doručení
Pro povolení režimu doručení přidejte odpovídající sekci pro požadovaný kanál notifikací.
---
define:
type: alerts/notifications
email:
schedule: {}
instant: {}
sla: {}
slack:
instant: {}
Emailové notifikace
Výchozí e-maily
Výchozí hodnoty parametrů to (příjemce) a from (odesílatel) lze nakonfigurovat v nastavení Knihovny. Parametr from je volitelný.
---
define:
type: alerts/notifications
email:
from: tester@teskalabs.com
to: user@teskalabs.com
Hint
Pro odesílání notifikací na jednu nebo více výchozích cílových adres přidejte pod parametr to více e-mailů oddělených čárkami, např. user1@teskalabs.com,user2@teskalabs.com.
- Tiket má respondera a
toje nakonfigurováno → notifikace se odesílají responderovi i na nakonfigurované výchozí adresy - Tiket má respondera a
tonení nakonfigurováno → notifikace se odesílají pouze responderovi - Tiket nemá respondera a
toje nakonfigurováno → notifikace se odesílají na nakonfigurované výchozí adresy - Tiket nemá respondera a
tonení nakonfigurováno → notifikace se neodesílají
SMS notifikace
Výchozí telefonní číslo
Výchozí telefonní číslo lze nakonfigurovat v nastavení Knihovny.
---
define:
type: alerts/notifications
sms:
phone: 700700700
Warning
V LogMan.io v25.30 není podporováno více telefonních čísel v SMS notifikacích. Nakonfigurované číslo se používá pro notifikace napříč všemi tenanty.
- Tiket má respondera a výchozí
phoneje nakonfigurováno → notifikace se odesílají responderovi - Tiket má respondera a výchozí
phonenení nakonfigurováno → notifikace se odesílají responderovi - Tiket nemá respondera a výchozí
phoneje nakonfigurováno → notifikace se odesílají na výchozí telefonní číslo - Tiket nemá respondera a výchozí
phonenení nakonfigurováno → notifikace se neodesílají
Responderi by měli mít telefonní číslo uvedené ve svém profilu přihlašovacích údajů.
Push notifikace
Výchozí topic lze nakonfigurovat v nastavení Knihovny.
---
define:
type: alerts/notifications
push:
topic: lmio-alerts
Okamžité notifikace
Okamžitá notifikace se odešle ihned po události.
Zakázat okamžité notifikace
Pro zakázání okamžitých notifikací odstraňte sekci instant z nastavení nebo explicitně použijte off.
---
define:
type: alerts/notifications
email:
# instant: {}
instant: off
Výchozí šablona
Povolte nebo upravte šablonu Knihovny Ticket Overview.md pro každý kanál:
/Templates/Email/Ticket Overview.md/Templates/Slack/Ticket Overview.md/Templates/Push/Ticket Overview.md
Šablona a wrapper
Pro použití jiné šablony nebo wrapperu než výchozích přidejte params do sekce instant konkrétního kanálu notifikací.
---
define:
type: alerts/notifications
email:
instant:
params:
template: /Templates/Email/Test.md
wrapper: /Templates/Wrapper/Simple Wrapper.html
Pokročilá nastavení
Pro filtrování notifikací podle parametru tiketu přidejte sekci exclude.
Použijte standardní porovnávací operátory gt / gte / lt / lte / eq.
Note
Podporovány jsou pouze základní parametry tiketu. Atributy tiketu aktuálně nejsou podporovány.
---
define:
type: alerts/notifications
email:
instant:
exclude:
# Neodesílat notifikace pro tikety se závažností lowest
- attribute: severity
op: eq
value: lowest
SLA notifikace
LogMan.io Alerts kontrolují splnění Service Level Agreements podle předem nakonfigurovaných pravidel SLA.
V případě porušení se jednorázová notifikace odešle na určený kanál.
Zakázat SLA notifikace
Pro zakázání SLA notifikací odstraňte sekci sla z nastavení nebo explicitně použijte off.
---
define:
type: alerts/notifications
email:
# sla: {}
sla: off
Výchozí šablona
Povolte nebo upravte šablonu Knihovny SLA Violation.md pro každý kanál:
/Templates/Email/SLA Violation.md/Templates/Slack/SLA Violation.md/Templates/Push/SLA Violation.md
Šablona a wrapper
Pro použití jiné šablony nebo wrapperu než výchozích přidejte params do sekce sla konkrétního kanálu notifikací.
---
define:
type: alerts/notifications
email:
sla:
params:
template: /Templates/Email/Test.md
wrapper: /Templates/Wrapper/Simple Wrapper.html
Naplánované notifikace
Naplánované notifikace o aktualizacích tiketů se odesílají v konfigurovaných intervalech.
Zakázat naplánované notifikace
Pro zakázání naplánovaných notifikací odstraňte sekci schedule z nastavení nebo explicitně použijte off.
---
define:
type: alerts/notifications
email:
# schedule: off
schedule: off
Výchozí šablona
Povolte nebo upravte šablonu Knihovny Ticket Activity Update.md pro každý kanál:
/Templates/Email/Ticket Activity Update.md/Templates/Slack/Ticket Activity Update.md/Templates/SMS/Ticket Activity Update.md/Templates/Push/Ticket Activity Update.md
Šablona a wrapper
Pro použití jiné šablony nebo wrapperu než výchozích přidejte params do sekce schedule konkrétního kanálu notifikací.
---
define:
type: alerts/notifications
email:
schedule:
params:
template: /Templates/Email/Test.md
wrapper: /Templates/Wrapper/Simple Wrapper.html
Období notifikací
Výchozí období notifikací je 1 hodina.
Období lze nakonfigurovat pro každý kanál notifikací (hodnoty délky jako 2h).
---
define:
type: alerts/notifications
slack:
schedule:
period: 2h
Pozastavit naplánované notifikace
Notifikace lze pozastavit na úrovni tenantu a pro každý kanál notifikací. Během pozastavení jsou aktualizace zahazovány nebo odkládány.
Note
Výchozí nastavení Knihovny pro notifikace:
- Notifikace se odesílají pouze během standardní pracovní doby (06:00–16:00 UTC)
- Notifikace jsou pozastaveny od pátku 16:00 UTC do pondělí 06:00 UTC
- Akumulované aktualizace se po obnovení notifikací odesílají na email a Slack
- Akumulované aktualizace se po obnovení notifikací neodesílají prostřednictvím SMS
V případě potřeby upravte výchozí nastavení.
Pozastavené naplánované notifikace
---
define:
type: alerts/notifications
slack: # (1)
schedule:
pause:
- at: 0 16 * * FRI # (2)
duration: 62h # (3)
action: discard # (4)
# Odeslat akumulované aktualizace
- at: 0 16 * * * # (5)
duration: 14h # (6)
action: delay # (7)
- Kanál notifikací (např.
slack,emailnebosms) - Přestat odesílat notifikace každý pátek v 16:00 UTC (standardní cron výraz)
- Pozastavit notifikace na 62 hodin; obnovit v pondělí v 06:00 UTC
- Po obnovení notifikací neodesílat akumulované aktualizace
- Přestat odesílat notifikace každý den v 16:00 UTC
- Pozastavit notifikace na 14 hodin; obnovit v 06:00 UTC
- Po obnovení notifikací odeslat akumulované aktualizace
Podporované přípony délky:
- Y: rok (365 dní)
- M: měsíc (31 dní)
- W: týden
- D: den
- h: hodina
- m: minuta
Příklady: 3h (tři hodiny), 5M (pět měsíců), 1Y (jeden rok).
Ztlumit naplánované notifikace
Pro ztlumený tiket se neodesílají naplánované notifikace, i když je tiket aktualizován.
Pro ztlumení nebo zrušení ztlumení naplánovaných notifikací použijte ikonu zvonku v detailu tiketu.
Naplánovat lístky
Lístky, které mají přiřazený stav workflow, se označují jako běžné lístky. Lístky vytvořené ručně v UI jsou vždy běžné.
Lístky, které nemají přiřazený aktivní stav workflow a jsou naplánovány na otevření v budoucnu, se označují jako spící lístky. Spící lístky mohou vytvářet pouze služby.
LogMan.io Alerts mohou automaticky vytvářet, aktualizovat a uzavírat různé typy lístků.
Tato funkčnost je určena hlavně parametry direction a period příchozích signálů.
direction UP: označuje aktivní stav lístkudirection DOWN: označuje neaktivní stav lístkudirection ZERO: označuje, že nedochází ke změně stavu lístkuperiod: určuje, kdy má proběhnout naplánovaný přechod
Warning
V každém workflow ponechte stav closed.
Pokud je ze workflow odstraněn, lístky nelze uzavřít.
Přehled hlavních případů
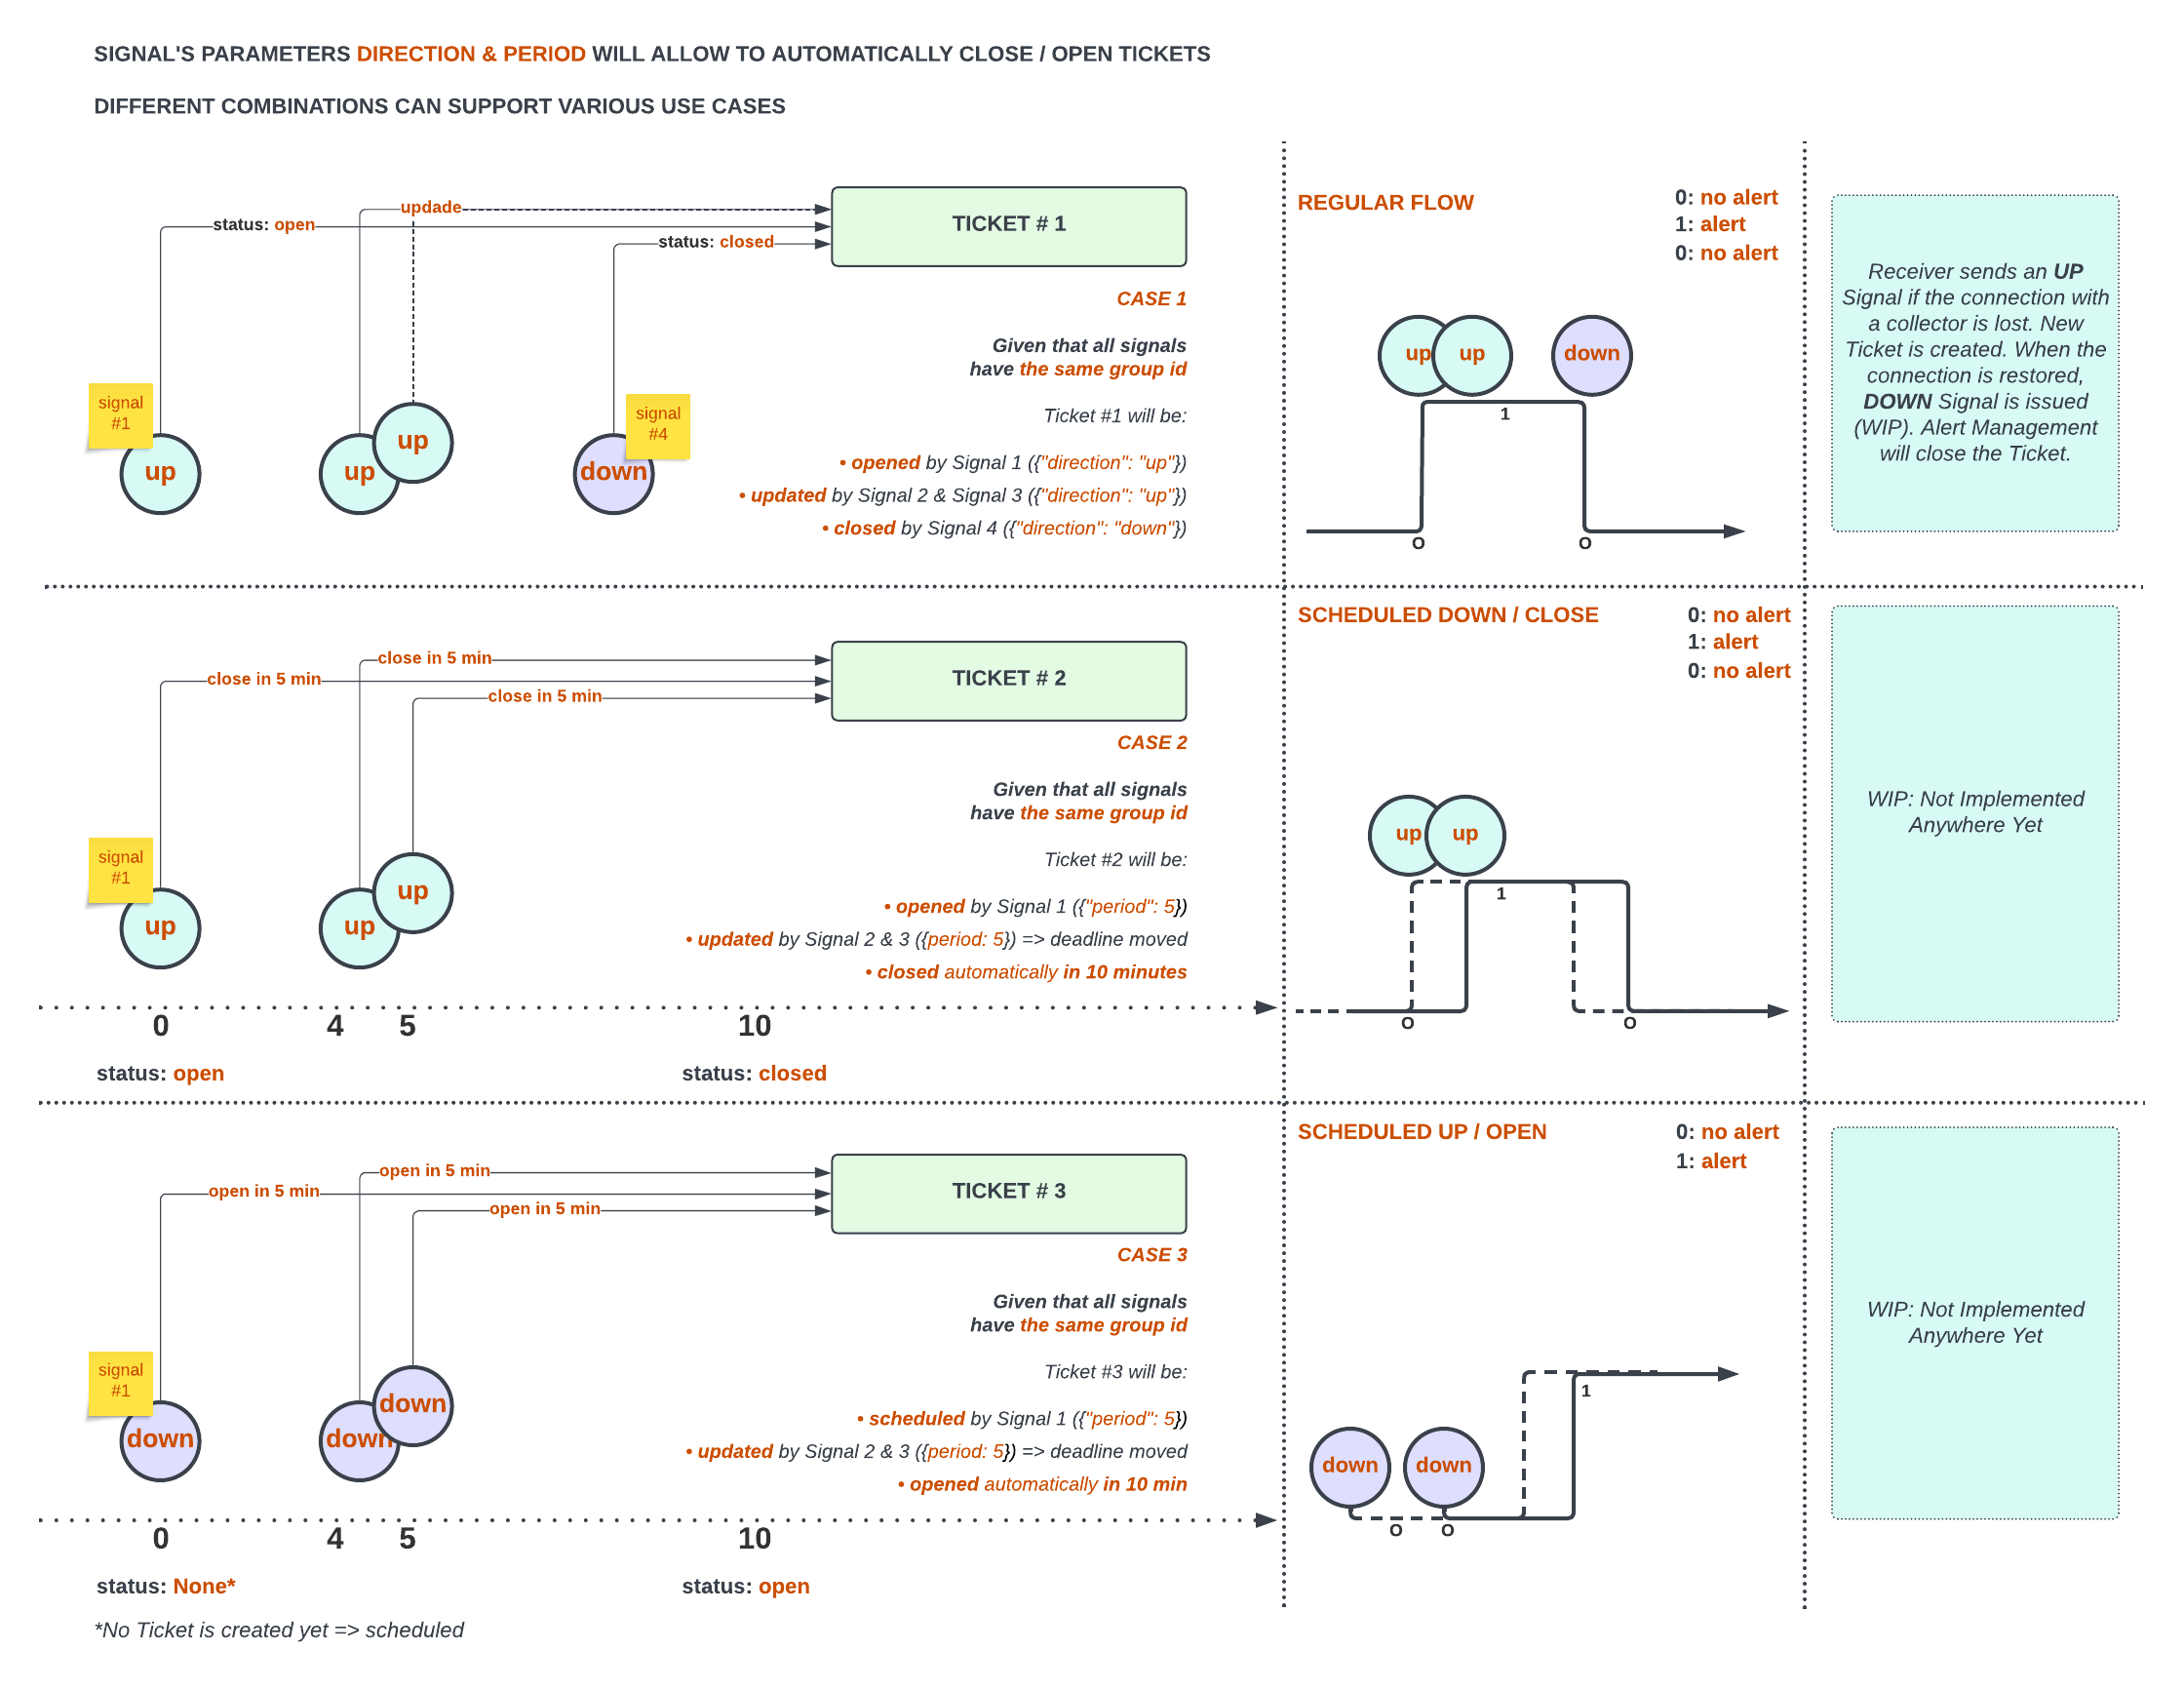
Nastavení plánu
Řada kombinací parametrů signálu direction a period podporuje různé use casy a přináší různé výsledky.
Podívejte se, jak různé signály mění stav lístku:
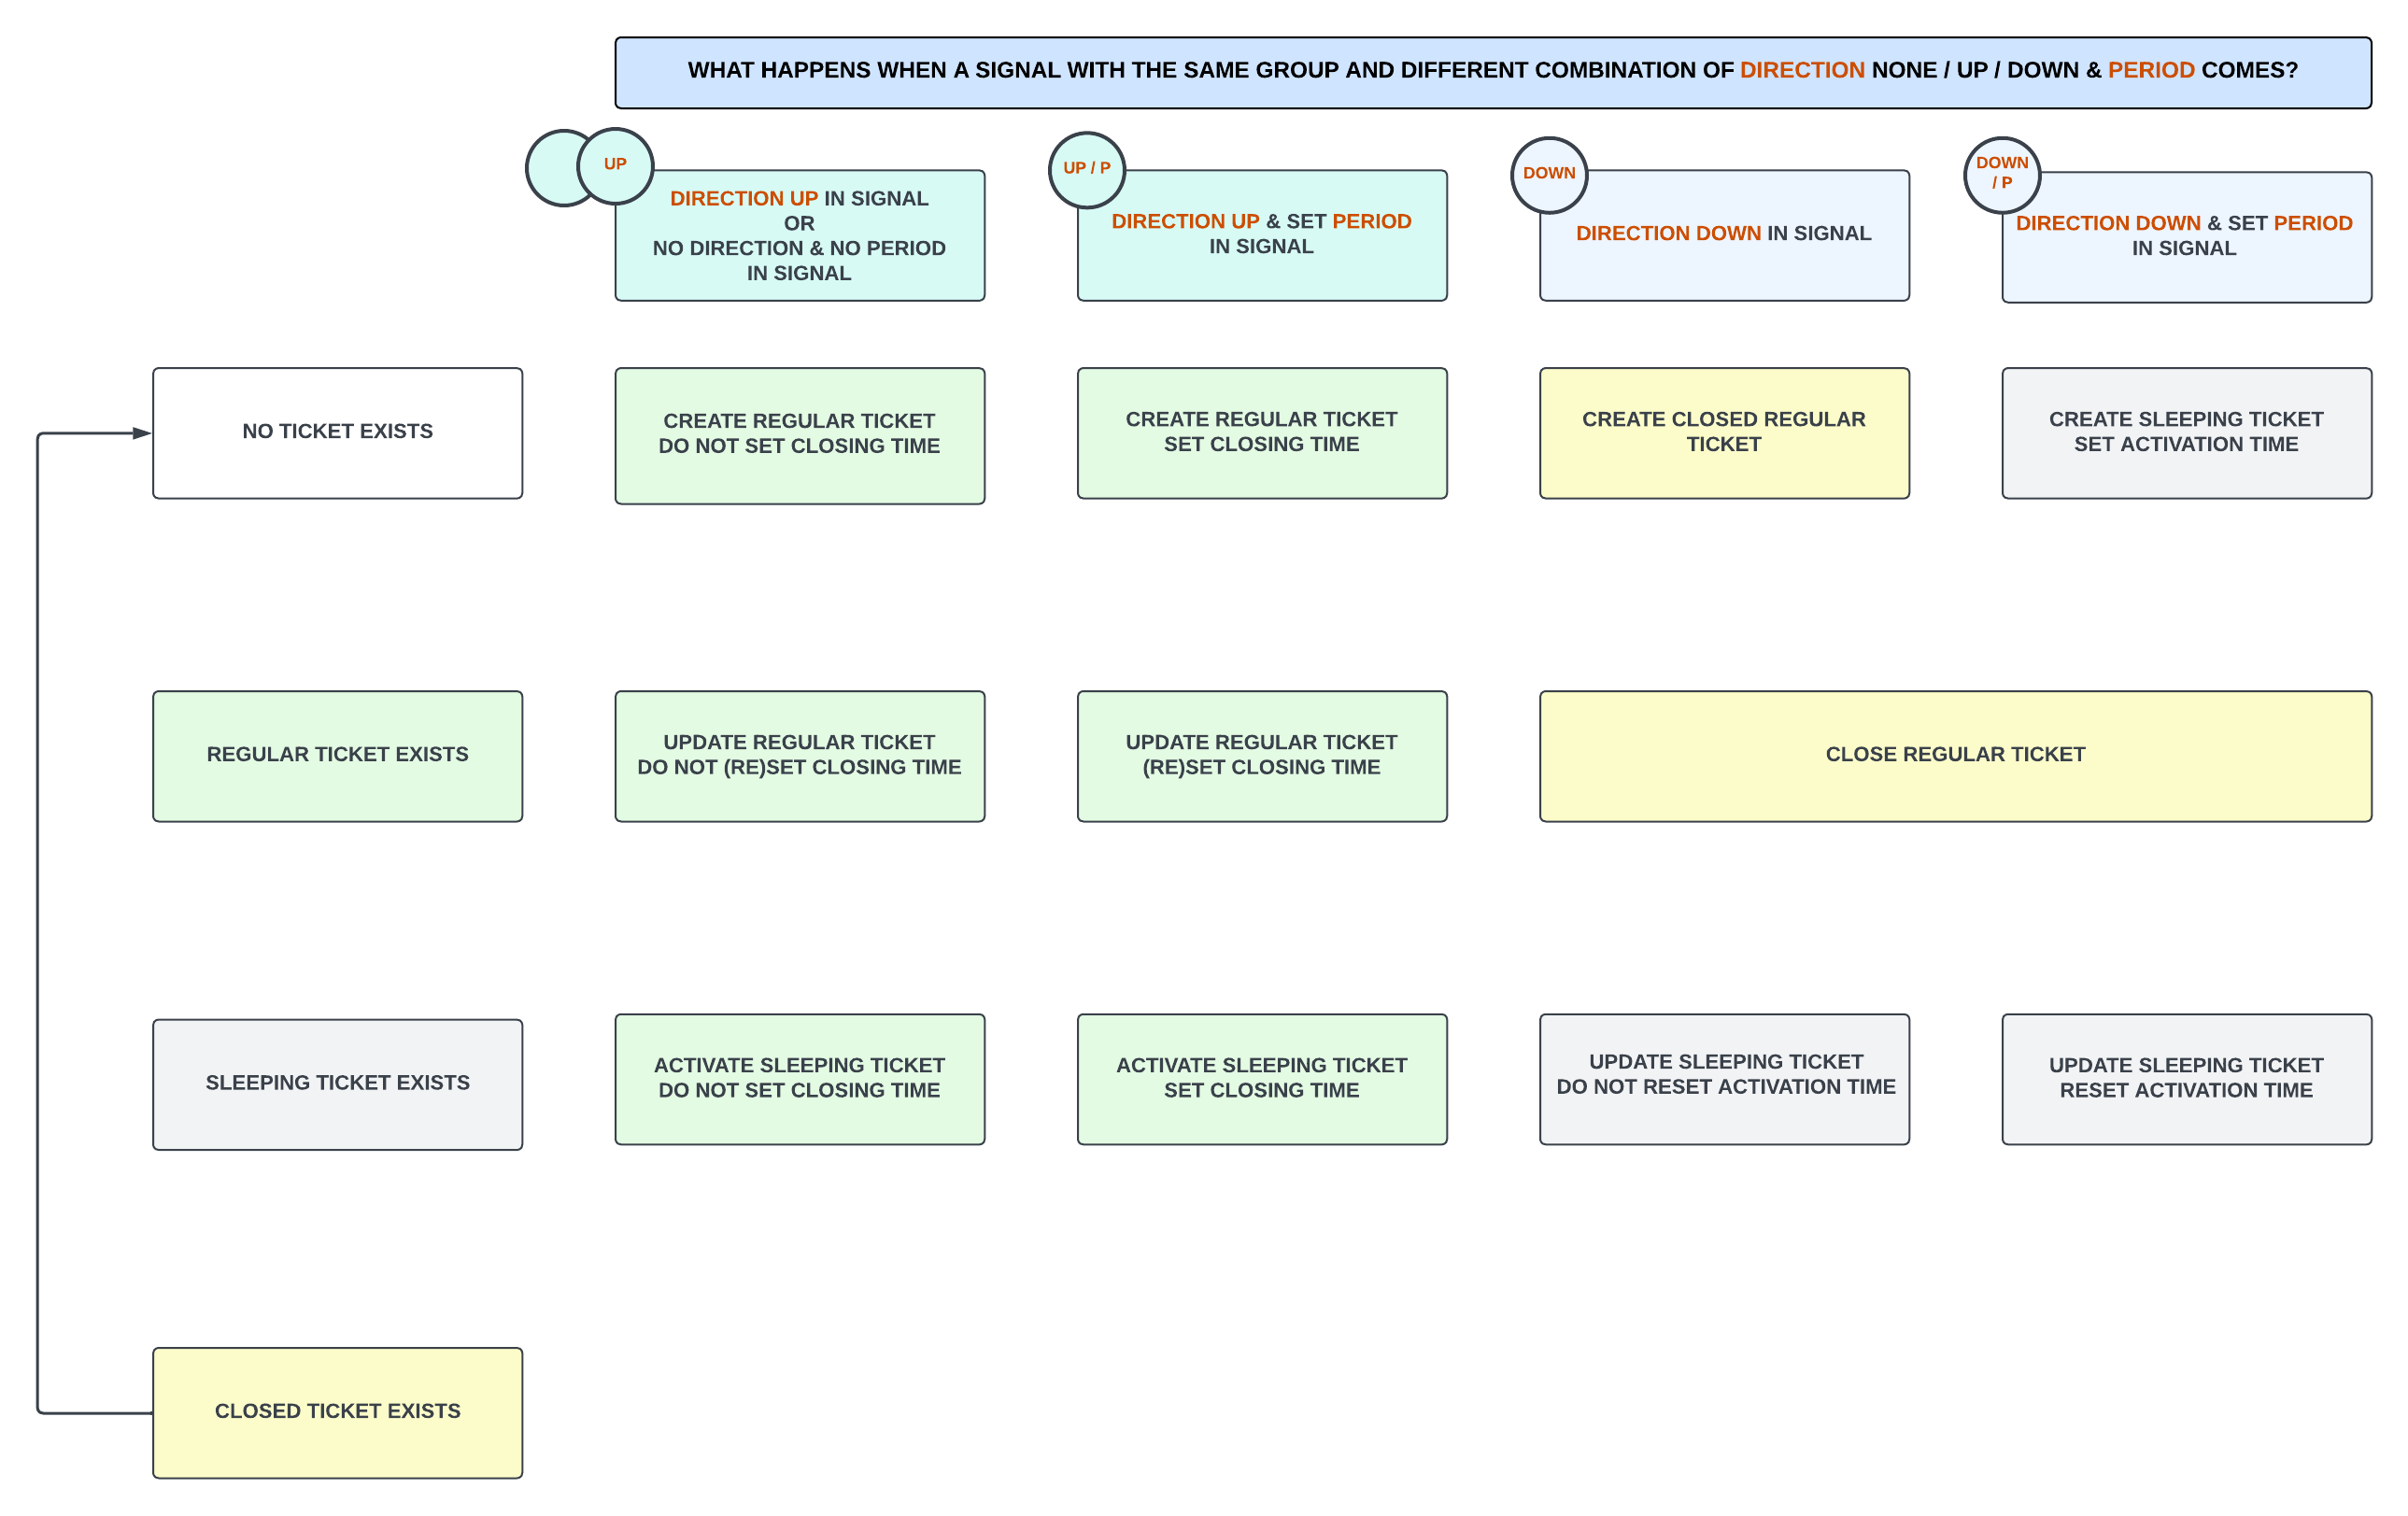
Nebo si určete hlavní cíl a najděte nejlepší posloupnost signálů:
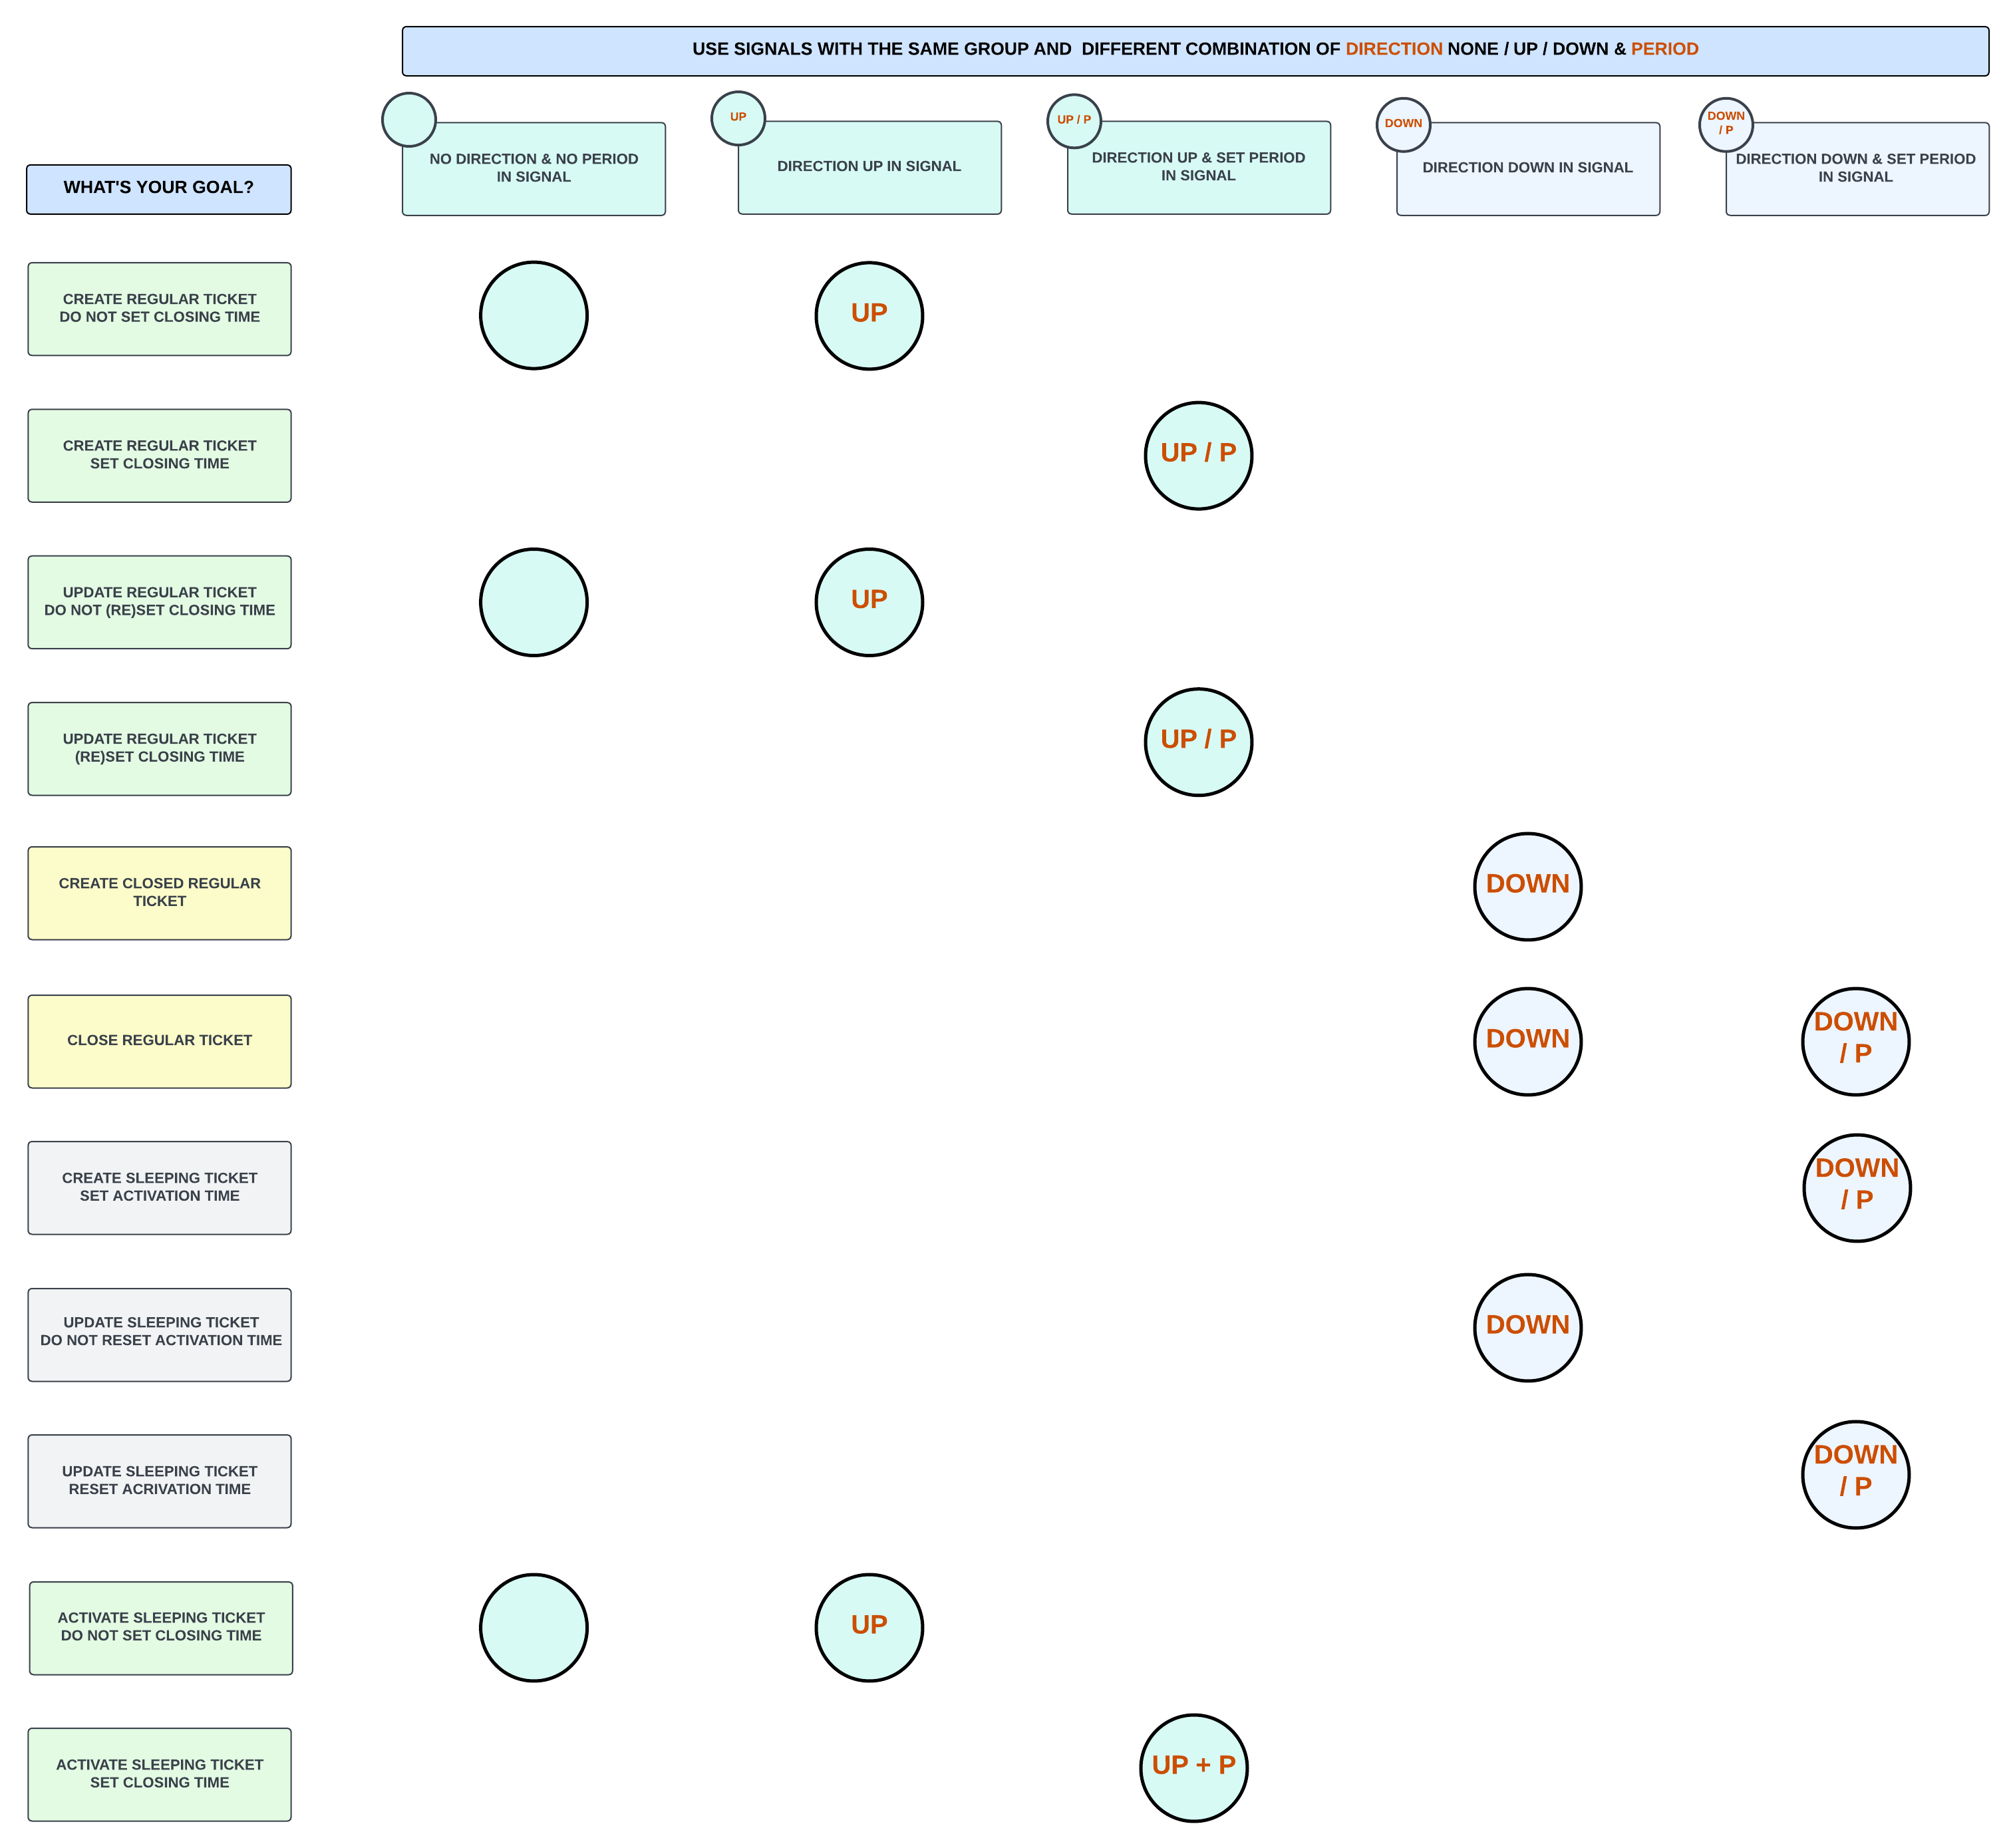
Bez lístku → vytvoření
Případ 1: v signálu není direction ani period
- výchozí direction: UP
- vytvoří se běžný lístek
- plán se nenastaví
Případ 2: v signálu je direction UP
- vytvoří se běžný lístek
- plán se nenastaví
Případ 3: v signálu je direction UP a nastavený period
- vytvoří se běžný lístek
- naplánuje se čas uzavření lístku
Případ 4: v signálu je direction DOWN
- signál se ignoruje
Případ 5: v signálu je direction DOWN a nastavený period
- vytvoří se spící lístek
- naplánuje se čas otevření lístku
Případ 6: v signálu je direction ZERO
- vytvoří se spící lístek
- naplánuje se čas expirace lístku (výchozí)
Případ 7: v signálu je direction ZERO a nastavený period
- vytvoří se spící lístek
- naplánuje se čas expirace lístku
Aktualizace běžného lístku
Také viz skupinování.
Případ 1: v signálu není direction ani period
- výchozí direction: UP
- existující běžný lístek se aktualizuje
- plán se nenastaví
Případ 2: v signálu je direction UP
- existující běžný lístek se aktualizuje
- plán se nenastaví
Případ 3: v signálu je direction UP a nastavený period
- existující běžný lístek se aktualizuje
- naplánuje se čas uzavření lístku
Případ 4: v signálu je direction DOWN
- existující běžný lístek se okamžitě uzavře
Případ 5: v signálu je direction DOWN a nastavený period
- lístek v aktivním stavu nelze vrátit do spícího stavu
- existující běžný lístek se okamžitě uzavře
Případ 6: v signálu je direction ZERO
- existující běžný lístek se aktualizuje
Případ 7: v signálu je direction ZERO a nastavený period
- existující běžný lístek se aktualizuje
Aktualizace spícího lístku
Také viz skupinování.
Případ 1: v signálu není direction ani period
- výchozí direction: UP
- naplánovaný čas otevření se ignoruje
- spící lístek se okamžitě otevře
- plán se nenastaví
Případ 2: v signálu je direction UP
- naplánovaný čas otevření se ignoruje
- spící lístek se okamžitě otevře
- plán se nenastaví
Případ 3: v signálu je direction UP a nastavený period
- naplánovaný čas otevření se ignoruje
- spící lístek se okamžitě otevře
- naplánuje se čas uzavření lístku
Případ 4: v signálu je direction DOWN
- spící lístek se aktualizuje
- čas otevření lístku se nepřeplánuje
Případ 5: v signálu je direction DOWN a nastavený period
- spící lístek se aktualizuje
- čas otevření lístku se přeplánuje
Případ 6: v signálu je direction ZERO
- spící lístek se aktualizuje
- čas expirace lístku se nepřeplánuje
Případ 7: v signálu je direction ZERO a nastavený period
- spící lístek se aktualizuje
- čas expirace lístku se přeplánuje, pokud není nastaven čas aktivace
Komprese
Některá detekční pravidla, zejména pokud nejsou optimálně nakonfigurována pro vaše potřeby, mohou generovat tisíce událostí za hodinu. Pokud tiket není včas prošetřen a uzavřen, objem nahromaděných dat může enormně narůst.
Aby bylo vyšetřování zvládnutelné, jsou starší tikety pravidelně „čištěny“. Komprese určitých datových položek udržuje úložiště databáze i konkrétní tikety v rozumné velikosti, takže LogMan.io Alerts jsou výrazně rychlejší a flexibilnější.
Povolit kompresi
Pro povolení konkrétního typu komprese musí být odpovídající sekce přítomna v konfiguraci LMIO Alerts v /Site/model.yaml.
services:
lmio-alerts:
asab:
config:
compression:event:
enabled: yes
Hint
Pro release v26.12:
V případě clusterové konfigurace se společnou databází povolte kompresi pouze na jedné instanci.
Kontroly komprese se provádějí každých 12 hodin.
Komprese událostí
Komprese se pravidelně provádí pro přidružené události a záznamy na časové ose, což znamená, že některé události přiřazené k tiketu jsou odstraněny.
Toto jsou výchozí parametry komprese událostí, které lze změnit v /Site/model.yaml.
Výchozí konfigurace
[compression:event]
ticket_lifetime=1W # (1)
events=100 # (2)
trailing=10 # (3)
trigger=10 # (4)
- Komprimují se pouze tikety starší než 1 týden
- V tiketu ponechat 100 událostí
- Ponechat 10 nejnovějších událostí, zbytek jsou nejstarší události tohoto tiketu
- Data nekomprimovat, dokud se nenahromadí 10+ nadbytečných položek
Podporované postfixy stáří:
- Y: rok, resp. 365 dní
- M: měsíc, resp. 31 dní
- W: týden
- D: den
- h: hodina
- m: minuta
Například: „3h“ (tři hodiny), „5M“ (pět měsíců), „1y“ (jeden rok) a podobně.
Výchozí filtry
Výchozí filtry jsou přednastavená kombinace filtrů, řazení a fulltextového hledání, kterou LogMan.io Alerts aplikuje na seznam tiketů. Určují, co uživatel uvidí při prvním otevření seznamu tiketů, a slouží jako referenční bod pro akci Reset filters.
Výchozí filtry jsou uloženy v Knihovně jako /Alerts/List/default.json.
Struktura souboru
Soubor default.json obsahuje tři volitelné klíče na nejvyšší úrovni:
filters– pokročilé filtry aplikované na seznam tiketůsort– počáteční řazení seznamu tiketůsearch– fulltextové hledání předvyplněné ve vyhledávacím poli
Kterýkoli z těchto klíčů může být vynechán. Pokud je soubor prázdný nebo chybí, nejsou aplikovány žádné výchozí filtry.
Deklarace výchozích filtrů
{
"filters": {
"status": ["open", "triaged"]
},
"sort": {
"type": "desc"
},
"search": "Ticket-01"
}
filters
Mapa názvů polí na jednu nebo více hodnot. Každý záznam se zobrazí jako filtrační „pill“ nad tabulkou a odpovídající dotaz se přidá do požadavku na seznam tiketů.
Každá hodnota musí být pole řetězců.
V uvedeném příkladu:
- seznam tiketů je filtrován podle
statusse dvěma hodnotami —openatriaged.
Více polí lze kombinovat:
{
"filters": {
"status": ["open", "triaged"],
"severity": ["high", "critical"]
}
}
sort
Mapa názvů polí na směr řazení. Názvy polí jsou specifické pro aplikaci (např. severity, ticket_id, type, status, responder, _m, _c).
Podporované směry:
asc— vzestupnědesc— sestupně
Pro každé pole je povolen pouze jeden směr řazení.
V uvedeném příkladu:
- seznam tiketů je řazen podle
typesestupně.
Pokročilé řazení může kombinovat více polí:
{
"sort": {
"type": "desc",
"_c": "asc"
}
}
search
Řetězec předvyplněný do vyhledávacího pole. Aplikuje se na stejné fulltextové hledání, jako by ho uživatel zadal ručně.
{
"search": "Ticket-01"
}
Kdy se aplikují výchozí filtry
Výchozí filtry se aplikují automaticky pouze když uživatel otevře seznam tiketů bez filtrů, řazení nebo hledání nastavených uživatelem (typicky při první návštěvě). Jakmile uživatel něco z toho změní, výchozí hodnoty se už automaticky znovu neaplikují — zachová se tak aktuální pohled uživatele při navigaci.
Pro návrat k výchozím filtrům použijte tlačítko Reset filters v hlavičce seznamu tiketů.
Reset filters pokrývá několik případů
- Výchozí filtry nejsou viditelné — uživatel dříve změnil filtry a tabulka neodráží aktuální
default.json. Kliknutí na Reset filters obnoví výchozí hodnoty. - Výchozí filtry byly změněny v Knihovně — soubor
default.jsonbyl aktualizován, ale tabulka stále zobrazuje starý stav. Kliknutí na Reset filters aplikuje nové výchozí hodnoty. - Uživatel přidal vlastní filtry — uživatel chce vrátit pohled definovaný v Knihovně. Kliknutí na Reset filters zruší uživatelské filtry, řazení a hledání a znovu aplikuje výchozí hodnoty.
Pokud je default.json prázdný nebo chybí, Reset filters jednoduše vymaže všechny filtry, řazení a hledání a vrátí tabulku na stránku 1.
Zakázání výchozích filtrů
Pro zakázání výchozích filtrů bez smazání souboru default.json deaktivujte v Knihovně soubor disabled.
Warning
Zakázání výchozích filtrů neovlivňuje filtry již přítomné v URL nebo v relaci uživatele — potlačí se pouze automatická aplikace výchozích hodnot při první návštěvě. Filtry nastavené uživateli tato změna neovlivňuje.
Závažnost
Závažnost vyjadřuje potenciální dopad události, tj. úroveň škody, kterou by mohla způsobit, pokud je skutečná a úspěšná.
Používaný numerický rozsah je 0 až 90.
Obvykle jde o relativně statické klasifikaci definovanou detekčním pravidlem nebo use casem, která se v čase výrazně nemění.
Úrovně závažnosti lze aktualizovat automaticky prostřednictvím signálů nebo ručně v UI. Pro automaticky vytvořené tikety je závažnost přiřazena podle atributu severity v sekci define příslušného detekčního pravidla. Na investigátorech a analytikách je určit úrovně závažnosti pro konkrétní případy podle bezpečnostních postupů společnosti. Například korelace s mnoha vstupy (např. neúspěšná přihlášení následovaná úspěšnými) může mít vyšší závažnost, protože je potenciálně nebezpečnější.
Konfigurace závažnosti je uložena v Knihovně na /Alerts/Severity/severity.yaml.
Pokud při vytvoření tiketu závažnost není nastavena, aplikuje se výchozí hodnota z Knihovny: hodnota pod _ (ve výchozím nastavení 50 / medium). Lze ji přizpůsobit pro jednotlivé prostředí.
Standardní úrovně
Ve výchozím nastavení se používá standardní notace SIGMA.
Úrovně závažnosti jsou uvedeny v sekci severity konfiguračního souboru Knihovny s příslušnou numerickou ekvivalentní hodnotou.
---
define:
type: alerts/severity
severity:
critical: 90
high: 70
medium: 50
low: 30
info: 10
_: 50
variants:
highest: 90
Note
Možnosti ze sekce severity mají přednost před ekvivalenty v sekci variants. S výše uvedeným nastavením bude úroveň critical nabídnuta v UI pro výběr, zatímco úroveň highest bude ignorována.
Varianty názvů
Možnosti v sekci variants umožňují odkazovat na stejnou úroveň závažnosti různými názvy.
S níže uvedeným nastavením lze úroveň info v detekčních pravidlech a signálech označovat také jako lowest nebo informational.
---
define:
type: alerts/severity
severity:
<...>
info: 10
variants:
lowest: 10
informational: 10
Další možnosti
Možnosti v sekci variants umožňují v UI nabídnout další volby, pokud je to potřeba.
S níže uvedeným nastavením bude custom nabídnuto v UI pro výběr a po výběru tiket dostane závažnost 77.
---
define:
type: alerts/severity
severity:
<...>
variants:
custom: 77
Nespecifikované úrovně
Pokud je přijata numerická úroveň závažnosti, která není uvedena v žádné sekci konfiguračního souboru, zobrazí se v detailu tiketu beze změny.
Příslušný název lze do konfiguračního souboru doplnit kdykoli.
SLA
LogMan.io Alerts kontrolují, zda jsou splněny vaše Service Level Agreements (SLA).
V případě porušení:
- pokud je aktivováno, jednorázová notifikace odeslaná na určený kanál
- záznam na časové ose tiketu pro budoucí referenci
Funkčnost je dostupná prostřednictvím popisů pravidel SLA uložených v Knihovně na /Alerts/SLA/sla.yaml.
Podporované typy SLA
responder_assigned
Konfigurace
Note
Nejprve se ujistěte, že jsou notifikace povoleny a správně nakonfigurovány.
Vytvoření SLA
Vytvoření SLA
---
define:
type: alerts/sla
SLA:
SLA_ID113: # (1)
type: responder_assigned # (2)
level: 4h # (3)
description: "Responder must be assigned to a newly created ticket during first 4 hours." # (4)
- Unikátní identifikátor SLA
- type: kontrola, zda je k tiketu přiřazen responder
- level: 4 hodiny
- Stručný popis SLA pro uživatele
Podporované postfixy stáří:
- Y: rok, resp. 365 dní
- M: měsíc, resp. 31 dní
- W: týden
- D: den
- h: hodina
- m: minuta
Například: „3h“ (tři hodiny), „5M“ (pět měsíců), „1Y“ (jeden rok) a podobně.
Pravidla potlačení
LogMan.io Alerts mohou určitá bezpečnostní upozornění ztišit, tj. potlačit, například duplicity nebo známé falešné pozitivy.
Potlačení se provádí na základě předem nakonfigurované sady podmínek zvané suppression rule (pravidlo potlačení).
Pokud je v Knihovně uloženo alespoň jedno aktivní pravidlo potlačení, je funkčnost povolena a každý příchozí signál je kontrolován proti dostupným pravidlům potlačení.
Signál je potlačen, pokud jsou splněny následující podmínky:
- odpovídá aktivnímu pravidlu potlačení
- není součástí větší skupiny (viz skupinování signálů)
Příklad
Pravidlo potlačení v pokročilém režimu
---
define:
name: Advanced Mode Suppression Rule
description: Suppress signals with matching attributes
type: alerts/suppressions
mode: advanced
format: splang
author: <.....>
created_at: '2026-04-07T10:53:49.494006Z'
schedule:
expires_at: '2026-12-05T12:39:34.457844Z'
predicate:
!AND
- !NE
- !ITEM EVENT host.hostname
- test
- !OR
- !EQ
- !ITEM EVENT event.action
- Accept
- !EQ
- !ITEM EVENT event.action
- Success
- !IN
what: !ITEM EVENT event.code
where: ["45", "72", "85"]
define
Tato sekce obsahuje společnou definici, metadata a identifikátory pravidla potlačení.
Položky type, mode, format, author, created_at přidává LogMan.io Alerts.
name
Krátký lidsky čitelný název pravidla potlačení.
description
Stručné lidsky čitelné vysvětlení charakteru a cílů pravidla potlačení.
schedule
Tato sekce obsahuje časová nastavení pravidla potlačení.
expires_at
Časové razítko, po kterém pravidlo potlačení již není aktivní.
predicate
Tato sekce obsahuje filtr pro příchozí signály ve formě výrazu SP-Lang.
Pokud se výraz vyhodnotí jako true, signál je ignorován.
V uvedeném příkladu:
LogMan.io Alerts ignorují všechny signály, kde
host.hostnamese nerovnátestaevent.actionse rovnáAcceptneboSuccessaevent.codeje"45","72"nebo"85"
Vytvoření pravidla potlačení
Pravidla potlačení se vytvářejí v dedikovaném UI a ukládají do Knihovny.
Jsou k dispozici dva režimy.
Pokročilý režim
Pravidla se vytvářejí jako sada podmínek v SP-Lang.
Pokud je pravidlo vytvořeno v pokročilém režimu, lze ho upravovat pouze v pokročilém režimu.
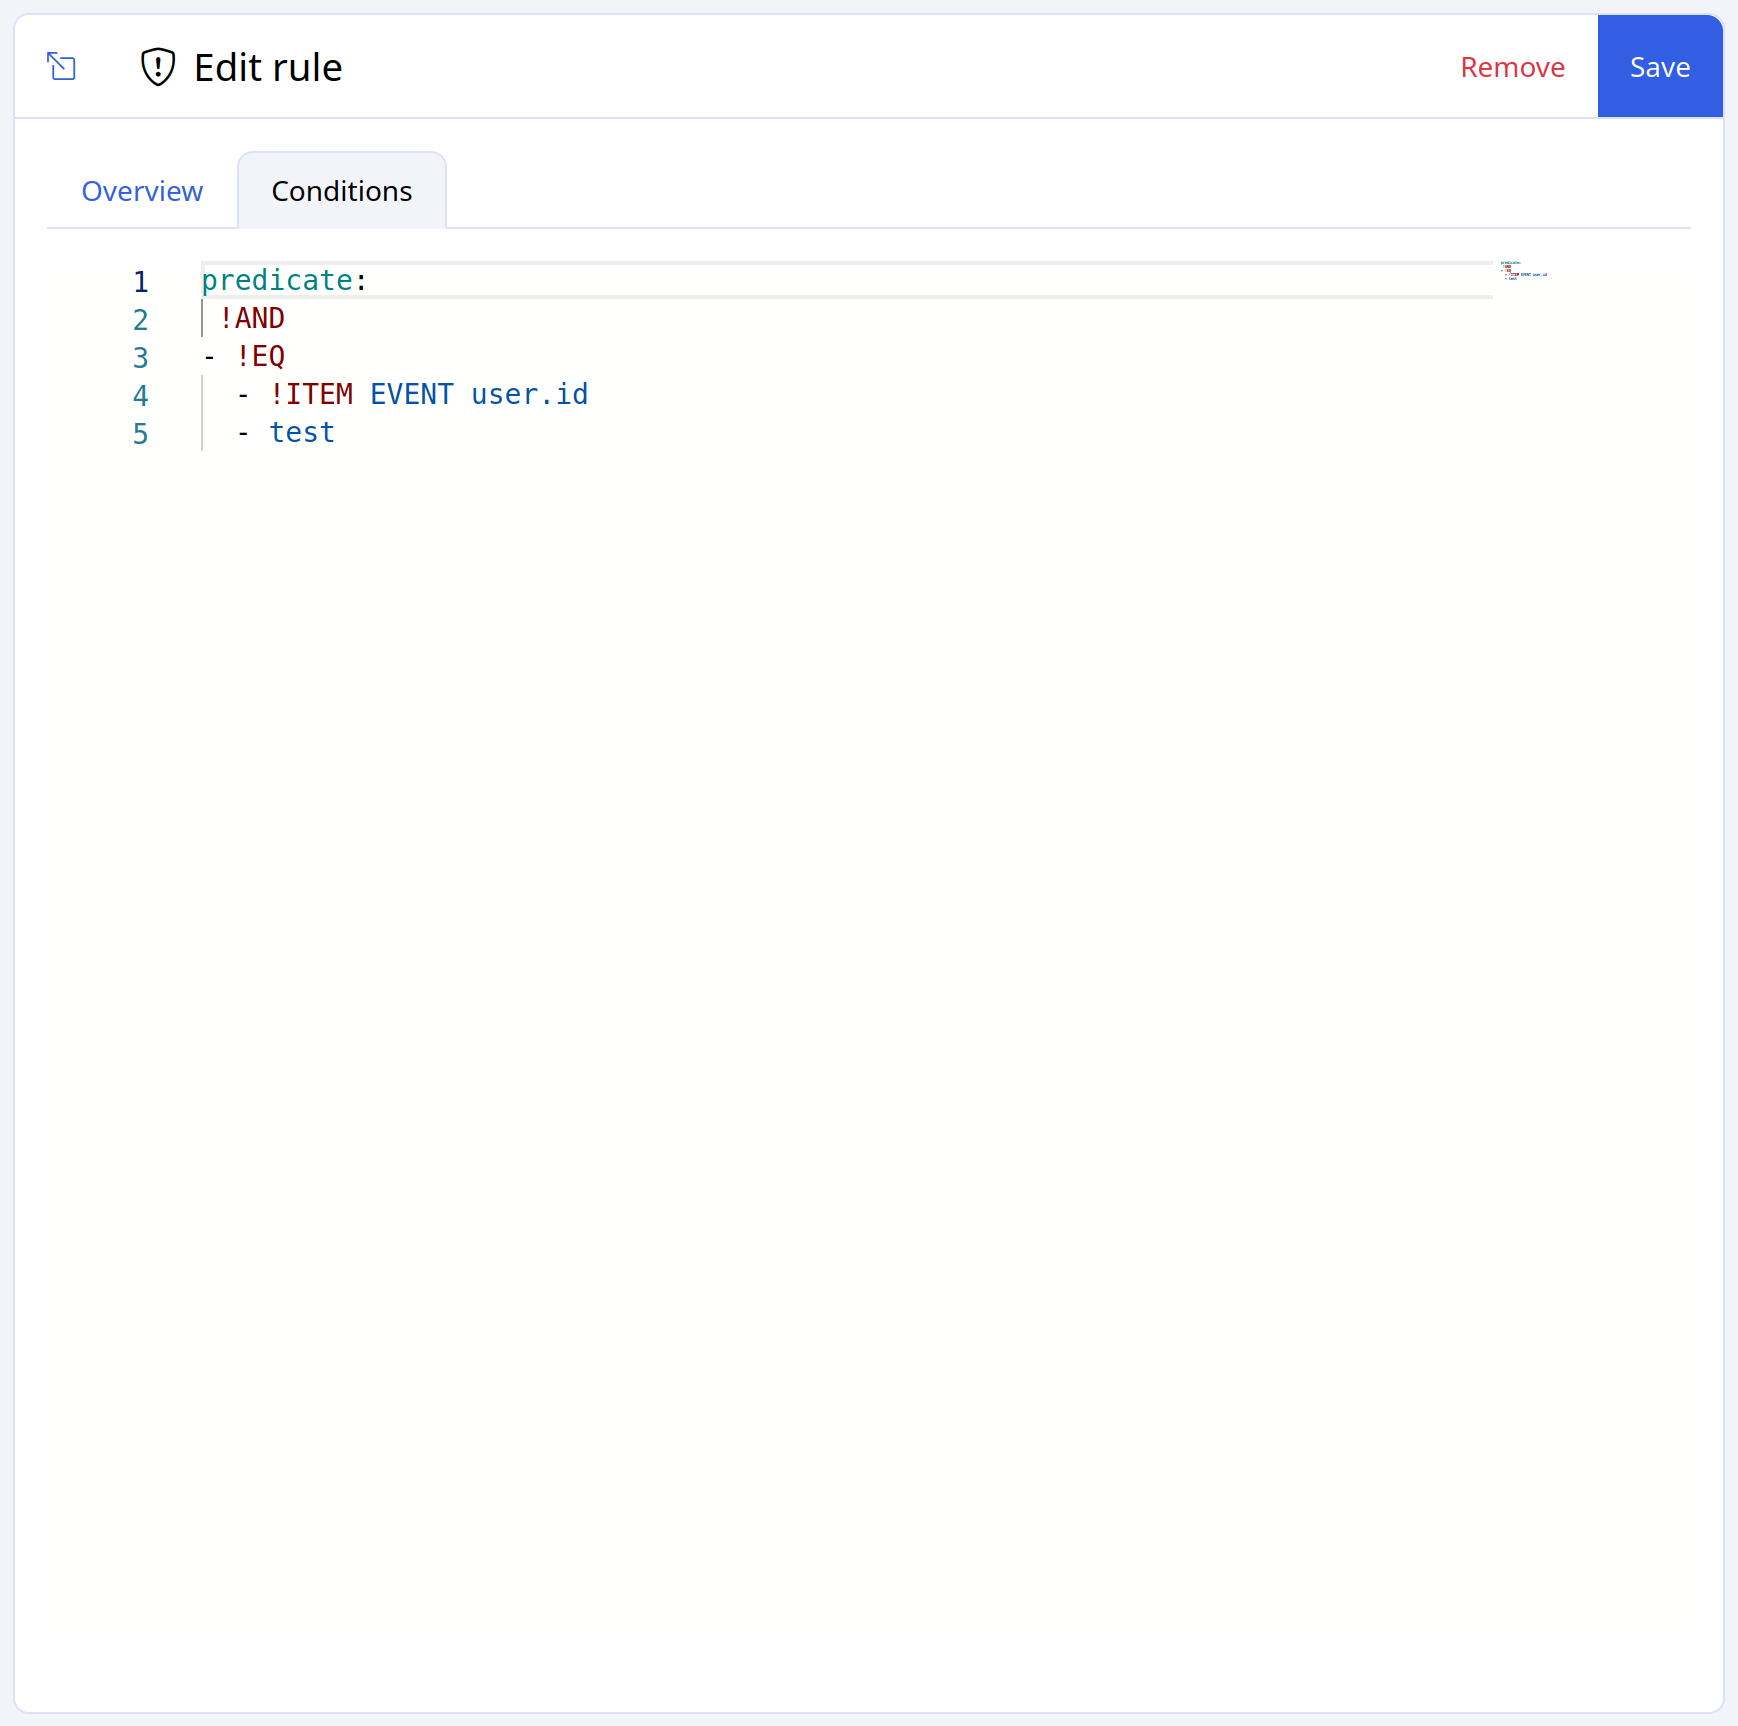
Základní režim
Pravidla se vytvářejí jednoduchým konstruktorem v UI, který nevyžaduje SP-Lang.
Ve srovnání s pokročilým režimem je sada dostupných podmínek omezenější.
Pokud je pravidlo vytvořeno v základním režimu, lze ho upravovat v základním i pokročilém režimu.
Warning
Pokud přepnete do pokročilého režimu a uložíte změny, základní konstruktor v UI pro toto pravidlo již není dostupný.
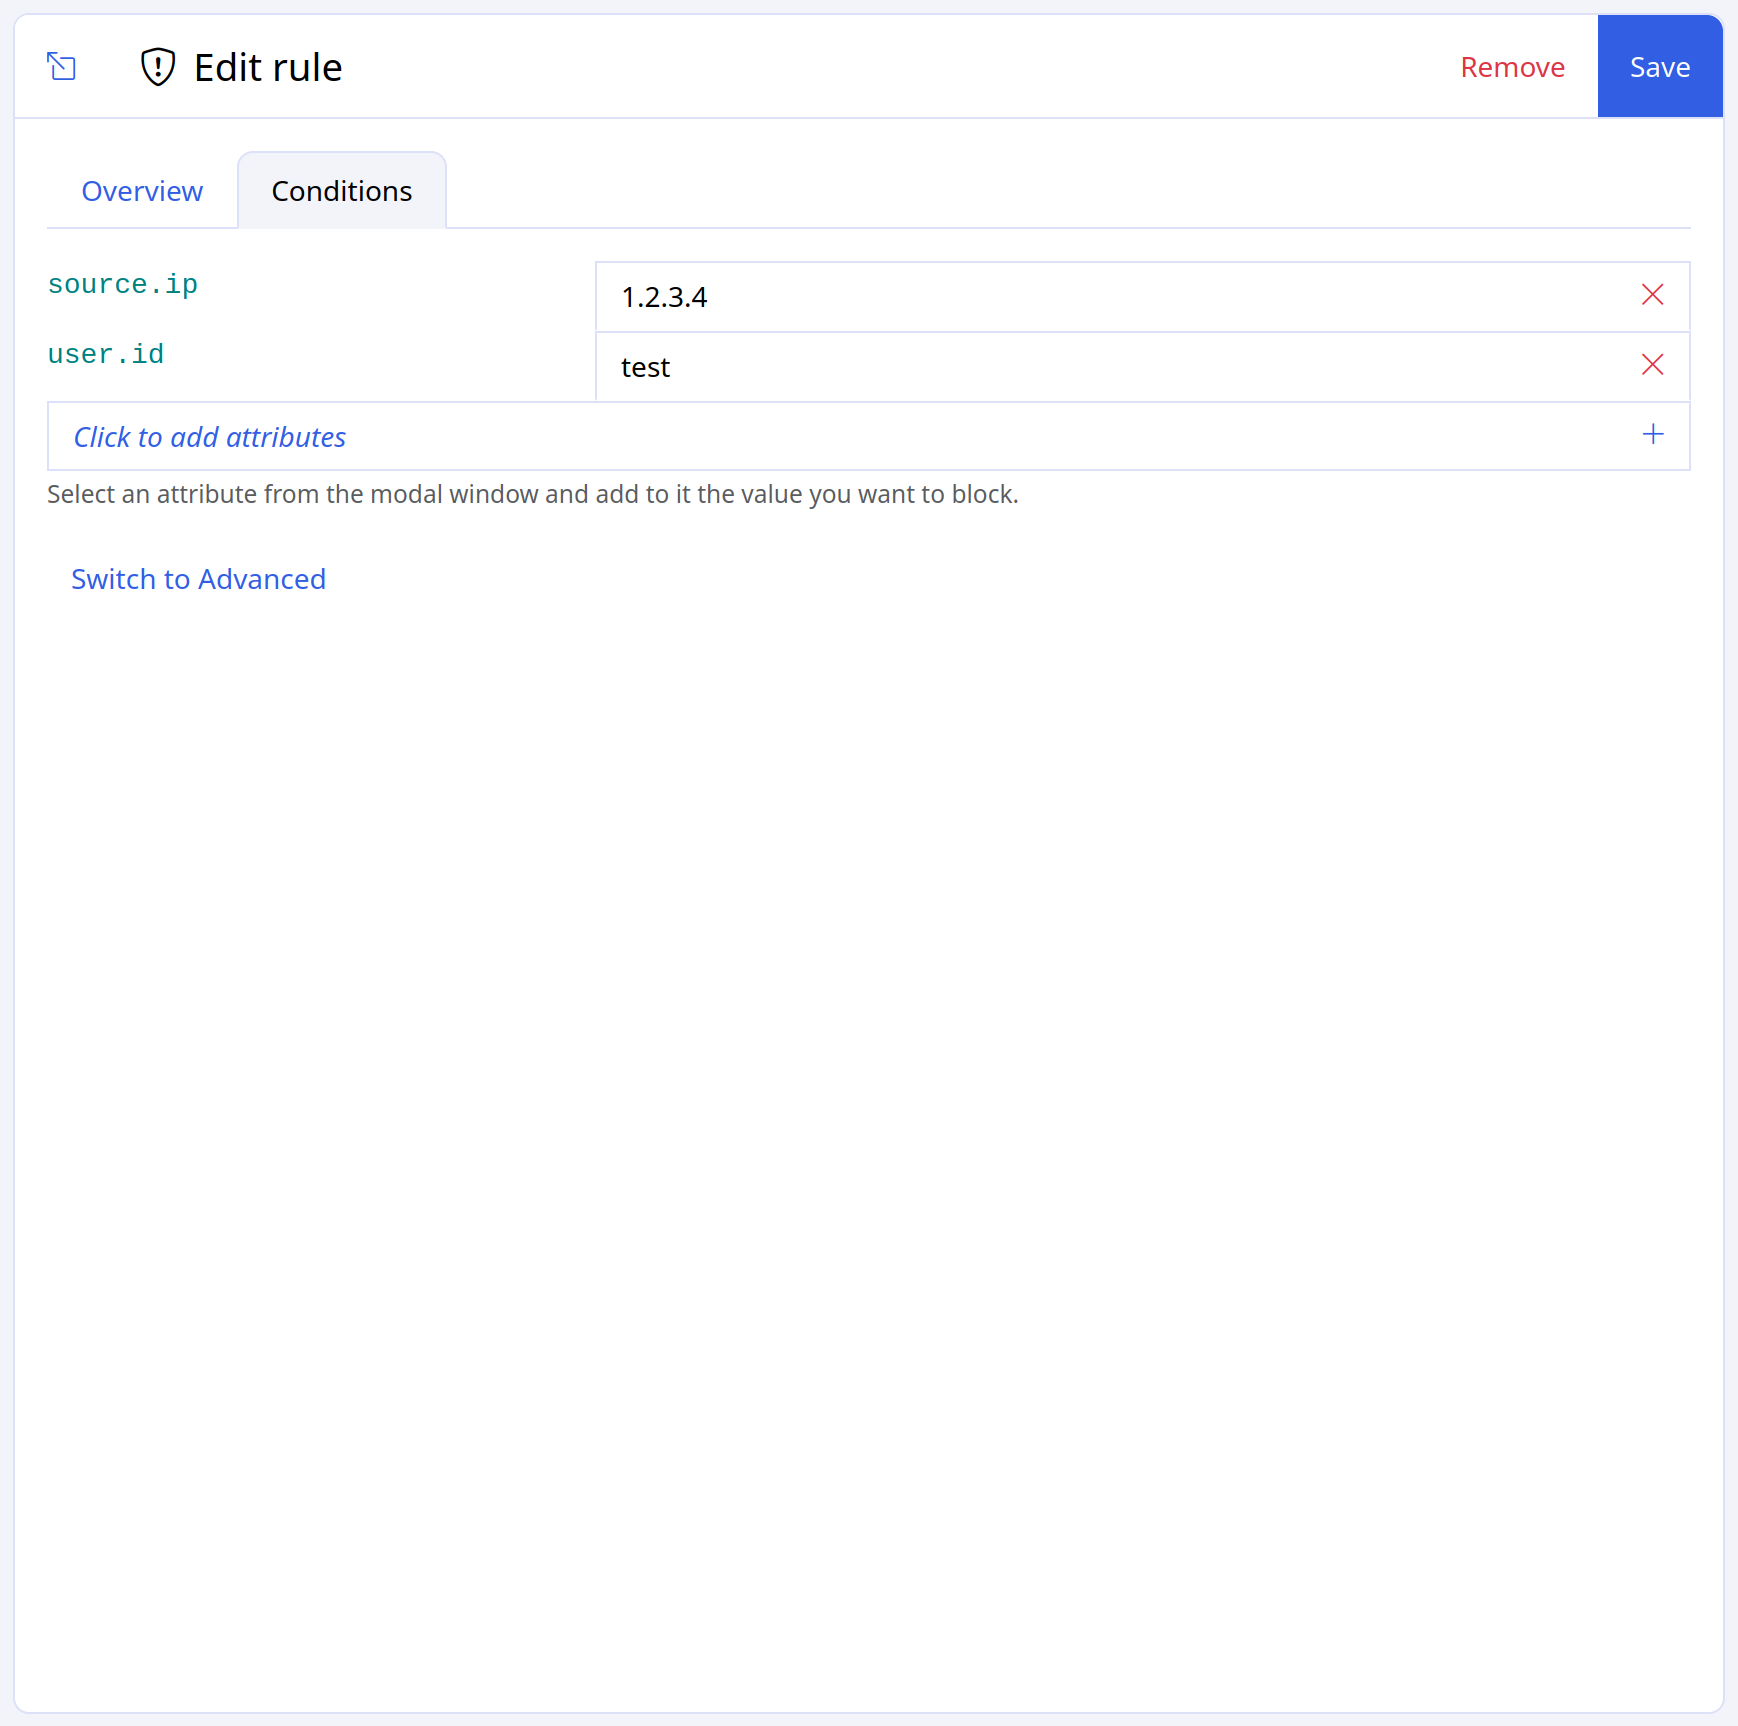
Lookups
Vyhledávání
Vyhledávání jsou slovníky entit s atributy, které jsou relevantní buď pro analýzu, nebo pro detekci kyberbezpečnostních incidentů.
Vyhledávání mohou být:
- Jednoduchý seznam podezřelých IP adres, aktivních VPN připojení, apod.
- Slovníky uživatelských jmen s uživatelskými atributy, jako je user.id, user.email, apod.
- Slovníky složených klíčů, jako jsou kombinace IP adres a uživatelských jmen pro monitorování uživatelské aktivity.
Co dělají vyhledávání?
Vyhledávání, podobná slovníkům, obsahují další užitečné informace o datech, která již máte, což může učinit vaše logy informativnějšími a cennějšími.
Jednoduchý příklad:
Vaše organizace má logy o odeslaných e-mailech, které obsahují e-mailové adresy odesílatelů.
Chcete však, aby logy v uživatelském rozhraní LogMan.io obsahovaly nejen e-mailovou adresu odesílatele, ale i jeho jméno.
Máte tedy vyhledávání, ve kterém je každá položka e-mailová adresa zaměstnance s přiřazeným jménem zaměstnance.
Pokud toto vyhledávání použijete v obohacovací části procesu analýzy, analyzátor „vyhledá“ jméno zaměstnance na základě jeho e-mailové adresy v tomto slovníku a zahrne jméno zaměstnance do logu.
Rychlý start
K nastavení vyhledávání:
- Vytvořte deklaraci vyhledávání v Knihovně LogMan.io (popis vyhledávání)
- Vytvořte vyhledávání a jeho obsah v sekci Vyhledávání v UI (obsah vyhledávání)
- Přidejte vyhledávání do relevantních pravidel pro analýzu a/nebo korelaci v Knihovně (aplikace vyhledávání)
Note
Ujistěte se, že všechny relevantní komponenty jsou nasazeny, viz Nasazení.
Deklarace
Všechna vyhledávání jsou definována jejich deklaracemi uloženými ve složce /Lookups.
Názvoslovná konvence pro deklarace je lookupname.yaml, například myuserlookup.yaml:
---
define:
type: lookup
name: myuserlookup
keys:
- name: userid
type: str
fields:
username:
type: str
V define specifikujte typ vyhledávání type, jméno vyhledávání name (informace o tenantovi budou přidány automaticky), klíče s jejich jmény (volitelnými) a typy a pole ve výstupní struktuře záznamu. Struktura záznamu NENÍ založena na schématu a NEMĚLA by obsahovat tečky.
Note
Názvy klíčů a polí nesmějí obsahovat speciální znaky, jako je tečka, apod.
Typy vyhledávání
Obecné vyhledávání
Obecné vyhledávání slouží k vytváření seznamů klíčů nebo párů klíč-hodnota. Typ type v deklaraci v části define je prostě lookup:
---
define:
type: lookup
...
Při analýze mohou být obecná vyhledávání použita pouze ve standardním obohacovači s výrazem !LOOKUP.
Pro více informací o obecných vyhledáváních viz Obecné vyhledávání.
Vyhledávání IP adres
Vyhledávání rozsahu IP adres
Vyhledávání rozsahu IP adres používá rozsahy IP adres, jako jsou 192.168.1.1 až 192.168.1.10, jako klíče.
Deklarace vyhledávání rozsahu IP adres musí obsahovat typ lookup/ipaddressrange v sekci define a dva klíče s typem ip v sekci keys:
define:
type: lookup/ipaddressrange
name: mylookup
group: mygroup
keys:
- name: range1
type: ip
- name: range2
type: ip
fields:
...
Vyhledávání jedné IP adresy
Vyhledávání jedné IP adresy je vyhledávání, které má přesně jeden klíč IP adresy s typem ip, který může být spojen s volitelným a proměnným počtem atributů definovaných žádnými nebo více hodnotami pod fields.
Aby bylo možné použít vyhledávání jedné IP adresy spolu s následujícími obohacovači, musí být typ vyhledávání v sekci define vždy lookup/ipaddress.
---
define:
type: lookup/ipaddress
name: mylookup
group: mygroup
keys:
- name: sourceip
type: ip
fields:
...
Pro více informací o vyhledávání IP adres viz Vyhledávání IP adres.
Vyhledávání MAC adres
Vyhledávání rozsahu MAC adres
Vyhledávání rozsahu MAC adres používá rozsahy MAC adres, jako jsou 0c:12:30:00:00:01 až 0c:12:30:00:00:ff, jako klíče.
Deklarace vyhledávání rozsahu MAC adres musí obsahovat typ lookup/macaddressrange v sekci define a dva klíče s typem mac v sekci keys:
define:
type: lookup/macaddressrange
name: mylookup
group: mygroup
keys:
- name: range1
type: mac
- name: range2
type: mac
fields:
...
Vyhledávání jedné MAC adresy
Vyhledávání jedné MAC adresy je vyhledávání, které má přesně jeden klíč MAC adresy s typem mac, který může být spojen s volitelným a proměnným počtem atributů definovaných žádnými nebo více hodnotami pod fields.
Aby bylo možné použít vyhledávání jedné MAC adresy spolu s následujícími obohacovači, musí být typ vyhledávání v sekci define vždy lookup/macaddress.
---
define:
type: lookup/macaddress
name: mylookup
group: mygroup
keys:
- name: sourcemac
type: mac
fields:
...
Pro více informací o vyhledávání MAC adres viz Vyhledávání MAC adres.
Výchozí vyhledávání
Pokud by mělo být vyhledávání automaticky vytvořeno z deklarace, musí mít příznak default nastaven na true:
define:
type: lookup/string
default: true
...
Chcete-li specifikovat výchozí položky vyhledávání, které mají být uloženy ve vyhledávání při jeho vytvoření, musí mít možnost default_items (očekává seznam) specifikovanou v sekci define:
define:
type: lookup/string
default: true
default_items:
- {"_keys": ["john.doe", "192.168.108.11"], "name": "John Doe"}
- {"_keys": ["jane.doe", "192.168.108.12"], "name": "Jane Doe"}
...
Pokud existuje pouze jeden klíč a žádná hodnota ve vyhledávání, může být default_items zjednodušeno tak, aby obsahovalo pouze tuto hodnotu:
define:
type: lookup/string
default: true
default_items:
- john.doe
- jane.doe
...
Sledování
Položky uložené v každém vyhledávání mohou být pravidelně analyzovány. Pokud je analýza úspěšná, je definován spouštěč, který například vytvoří signál pro správu upozornění nebo složitou událost.
Následující příklad je sledování uložené ve složce /Watches/ uvnitř Knihovny LogMan.io. Analyzuje položky vyhledávání scheduledtasks, které mají dva klíče: host.id a task.name.
Analýza je úspěšná a přechází na spouštěč, když byla položka vyhledávání po dobu 4 dnů (345600 sekund) nezměněna.
---
define:
name: Naplánovaná úloha nebyla aktualizována
description: Naplánovaná úloha nebyla dlouho aktualizována
lookup: scheduledtasks
analyze:
when: 1h
test:
!AND
# Úloha nebyla aktualizována více než čtyři dny
- !GT
- !ARG DURATION
- 345600
- !NE
- !ITEM EVENT host.id
- test
trigger:
- event:
host.id: !ITEM EVENT host.id
we.task_name: !ITEM EVENT task.name
- signal:
host.id: !ITEM EVENT host.id
we.task_name: !ITEM EVENT task.name
Note
Každé vyhledávání má vlastní schéma založené na svých klíčích a polích, které mohou být nekompatibilní se schématem tenantů (ECS, CEF atd.), proto neexistuje žádný výchozí spouštěč signálu.
Nasazení
Návrh

lmio-watcher
LogMan.io Watcher spravuje obsah lookups v Elasticsearch. Watcher čte lookup události z HTTP(S) API a Kafky.
lmio-lookupbuilder
LogMan.io Lookup Builder zpracovává generický obsah lookups z Elasticsearch a deklarace lookups z Knihovny a vytváří binární soubory lookups. Tyto binární soubory lookups jsou poté používány dalšími mikroslužbami, jako jsou LogMan.io Parsec, LogMan.io Correlator, atd.
lmio-ipaddrproc
LogMan.io IP Address Processor zpracovává obsah IP adresních lookups z Elasticsearch a deklarace lookups z Knihovny a vytváří binární soubory IP lookups. Tyto binární soubory IP lookups jsou poté používány dalšími mikroslužbami, jako jsou LogMan.io Parsec, LogMan.io Correlator, atd. Také stahuje vestavěné lookups z Azure úložiště z internetu.
Krok za krokem
Aby bylo možné pracovat s lookups, následujte tyto kroky nasazení. Pro více informací o tom, co jsou lookups a k čemu se používají, přejděte na Lookups.
-
Na každém stroji v rámci LogMan.io clusteru nasadíte jednu instanci LogMan.io Watcher.
-
Na každém stroji v rámci LogMan.io clusteru nasadíte jednu instanci
lmio-lookupbuilder.Informace o konfiguraci a položkách v Docker Compose jsou uvedeny v sekci Konfigurace.
-
Na každém stroji v rámci LogMan.io clusteru nasadíte jednu instanci
lmio-ipaddrproc.Informace o konfiguraci a položkách v Docker Compose jsou uvedeny v sekci Konfigurace.
-
Přidáte cestu k složce
/lookupsdo sekce svazků Docker Compose každé instance LogMan.io Parsec, LogMan.io Correlator, LogMan.io Alerts a LogMan.io Baseliner. Cesta je ve výchozím nastavení:volumes: - /data/ssd/lookups:/lookups -
Zahrnete LogMan.io Watcher do konfiguračního souboru každé instance NGINX jako záznam umístění na
/api/lmio-lookups:location /api/lmio-lookup { auth_request /_oauth2_introspect; rewrite ^/api/lmio-lookup/(.*) /$1 break; proxy_pass http://lmio-watcher; }Všimněte si proxy_pass, který ukazuje na upstream
lmio-watcher, který by měl být definován na začátku každého konfiguračního souboru NGINX:upstream lmio-watcher { server HOSTNAME_PRVNIHO_SERVERU_V_CLUSTERU:8952 max_fails=0 fail_timeout=30s; server HOSTNAME_DRUHEHO_SERVERU_V_CLUSTERU:8952 max_fails=0 fail_timeout=30s; server HOSTNAME_TRETIM_SERVERU_V_CLUSTERU:8952 max_fails=0 fail_timeout=30s; }Nahraďte
HOSTNAME_PRVNIHO_SERVERU_V_CLUSTERU,HOSTNAME_DRUHEHO_SERVERU_V_CLUSTERU,HOSTNAME_TRETIM_SERVERU_V_CLUSTERUhostitelskými jmény serverů, na kterých je LogMan.io Watcher nasazen v prostředí LogMan.io clusteru.To je vše! Nyní jste připraveni vytvářet deklarace lookups a obsah lookups. Vraťte se zpět na Lookups pro další kroky.
Konfigurace
LogMan.io Lookup Builder
LogMan.io Lookup Builder bere generický obsah pro lookupy z Elasticsearch a deklarace lookupů z Library a vytváří binární soubory pro lookupy. Tyto binární soubory jsou následně používány jinými mikroslužbami, jako jsou LogMan.io Parsec, LogMan.io Correlator, atd.
Závislosti
LogMan.io Lookup Builder má následující závislosti:
- Elasticsearch
- Zookeeper
- Library
- Tenanti pro vytváření lookupů
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Apply.
define:
type: rc/model
services:
lmio-lookupbuilder:
- <node> # Nahraďte názvem uzlu
Docker Compose
lmio-lookupbuilder:
network_mode: host
image: docker.teskalabs.com/lmio/lmio-lookupbuilder:VERSION
volumes:
- ./lmio-lookupbuilder:/conf
- /data/ssd/lookups:/lookups
restart: always
logging:
options:
max-size: 10m
Konfigurační soubor
Toto je nejzákladnější požadovaná konfigurace:
[tenants]
ids=mytenant
[elasticsearch]
url=http://es01:9200/
username=MYUSERNAME
password=MYPASSWORD
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
Alternativně, místo přímého specifikování id tenantů můžete přidat všechny tenanty z LogMan.io clusteru následující konfigurací:
[tenants]
tenant_url=http://<SEACAT_AUTH_NODE>:3081/tenant
Nahradit <SEACAT_AUTH_NODE> názvem hostitele, kde běží služba SeaCat Auth.
LogMan.io IP Address Processor
LogMan.io IP Address Processor bere obsah lookupů IP adres z Elasticsearch a deklarace lookupů z Library a vytváří binární soubory pro lookupy IP adres. Tyto binární soubory jsou následně používány jinými mikroslužbami, jako jsou LogMan.io Parsec, LogMan.io Correlator, atd. Rovněž stahuje vestavěné lookupy z Azure úložiště z internetu.
Závislosti
LogMan.io IP Address Processor má následující závislosti:
- ElasticSearch
- Zookeeper
- Library
- Tenanti pro vytváření lookupů
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Apply.
define:
type: rc/model
services:
lmio-ipaddrproc:
- <node> # Nahraďte názvem uzlu
Docker Compose
lmio-ipaddrproc:
network_mode: host
image: docker.teskalabs.com/lmio/lmio-ipaddrproc:VERSION
volumes:
- ./lmio-ipaddrproc:/conf
- /data/ssd/lookups:/lookups
restart: always
logging:
options:
max-size: 10m
Konfigurační soubor
Toto je nejzákladnější požadovaná konfigurace:
[tenants]
ids=mytenant
[elasticsearch]
url=http://es01:9200/
username=MYUSERNAME
password=MYPASSWORD
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
Alternativně, místo přímého specifikování id tenantů můžete přidat všechny tenanty z LogMan.io clusteru následující konfigurací:
[tenants]
tenant_url=http://<SEACAT_AUTH_NODE>:3081/tenant
Nahradit <SEACAT_AUTH_NODE> názvem hostitele, kde běží služba SeaCat Auth.
Generické lookupy
TeskaLabs LogMan.io generické lookupy slouží k vytváření seznamů klíčů nebo dvojic klíč-hodnota. type v deklaraci v sekci define je jednoduše lookup:
---
define:
type: lookup
...
Pokud jde o parsování, generické lookupy mohou být použity pouze ve standardním enricheři s výrazem !LOOKUP.
Vytváření generického lookupu
Existují vždy tři kroky pro povolení lookupů:
- Vytvořte deklaraci lookupu v Knihovně LogMan.io (popis lookupu)
- Vytvořte lookup a jeho obsah v sekci Lookupy v UI (obsah lookupu)
- Přidejte lookup do relevantních parsingových a/nebo korelačních pravidel v Knihovně (aplikace lookupu)
Případ použití: Uživatelský lookup
Uživatelský lookup se používá k získání informací o uživateli, jako je uživatelské jméno a email podle ID uživatele.
-
V LogMan.io přejděte do Knihovny.
-
V Knihovně přejděte do složky
/Lookups. -
Vytvořte novou deklaraci lookupu pro váš lookup, třeba „userlookup.yaml“, přičemž se ujistěte, že soubor má příponu YAML.
-
Přidejte následující deklaraci:
define: type: lookup name: userlookup group: user keys: - name: userid type: str fields: user_name: type: str email: type: strUjistěte se, že
typeje vždylookup.Změňte
namev sekcidefinena název vašeho lookupu.groupse používá při procesu obohacení k nalezení všech lookupů, které sdílejí stejnou skupinu. Hodnota je jedinečný identifikátor skupiny (případ použití), zde:user.Do
fieldspřidejte názvy a typy atributů lookupu. Tento příklad používáuser_nameaemailjako řetězce.V současné době jsou podporovány tyto typy:
str,fp64,si32,geopointaip. -
Uložte deklaraci.
-
V LogMan.io přejděte do Lookupů.
-
Vytvořte nový lookup se stejným názvem jako výše, tj. „userlookup“. Specifikujte ID uživatele jako klíč.
-
Vytvořte záznamy v lookupu s ID uživatele jako klíčem a poli, jak je uvedeno výše.
-
Přidejte následující enricheř do pravidla LogMan.io Parsec, které by mělo využívat lookup:
define: type: enricher/standard enrich: user_name: !GET from: !LOOKUP what: userlookup what: !GET from: !EVENT what: user.idTento vzorový enricheř získá
user_namezuserlookupna základě atributuuser.idz parsovaného eventu.
Vyhledávání IP adres
TeskaLabs LogMan.io nabízí optimalizované sady vyhledávání pro IP adresy, nazvané IP Lookups.
Existují vždy tři kroky k povolení IP Lookups:
- Vytvořte deklaraci vyhledávání v LogMan.io Library (popis vyhledávání)
- Vytvořte vyhledávání a jeho obsah v sekci Lookups v UI (obsah vyhledávání)
- Přidejte vyhledávání do relevantních pravidel parsování a/nebo korelace v Library (aplikace vyhledávání)
Vyhledání IP adresy na geografickou polohu
IP Geo Location je proces, kdy na základě rozsahu IP adres, jako je 192.168.1.1 až 192.168.1.10, chcete získat geografickou polohu IP adresy, jako je název města, zeměpisná šířka, délka apod.
Vestavěné vyhledávání IP na geografickou polohu
Když IP adresa z události neodpovídá žádnému z poskytnutých geo vyhledávání, bude použito výchozí veřejné vyhledávání IP adres poskytované TeskaLabs LogMan.io.
-
V LogMan.io přejděte do Library.
-
V Library, přejděte do složky
/Lookups. -
Vytvořte novou deklaraci vyhledávání pro vaše vyhledávání, jako například "ipgeolookup.yaml" s příponou YAML
-
Přidejte následující deklaraci:
define: type: lookup/ipaddressrange name: ipgeolookup group: geo keys: - name: range1 type: ip - name: range2 type: ip fields: location: type: geopoint value: lat: 50.0643081 lon: 14.443938 city_name: type: strUjistěte se, že
typeje vždylookup/ipaddressrange.Změňte
namev sekcidefinena název vašeho vyhledávání.groupse používá v obohacovacím procesu pro nalezení všech vyhledávání, která sdílí stejnou skupinu. Hodnota je unikátní identifikátor skupiny (use case), zde:geo.Klíče nechte tak, jak jsou, abyste specifikovali rozsahy.
Do
fieldspřidejte názvy a typy atributů vyhledávání. V tomto příkladu je jenom město, ale může být i poloha (zeměpisná šířka a délka) atd.:fields: name: type: str continent_name: type: str city_name: type: str location: type: geopointPři použití Elastic Common Schema (ECS) jsou všechny dostupné geo pole, která mohou být použita, specifikována v dokumentaci: https://www.elastic.co/guide/en/ecs/current/ecs-geo.html
Hodnota
valuebude použita jako výchozí.V současnosti jsou podporovány tyto typy:
str,fp64,si32,geopointaip. -
Uložte
-
V LogMan.io přejděte do Lookups.
-
Vytvořte nové vyhledávání se stejným názvem jako výše, tj. "ipgeolookup". Specifikujte dva klíče s názvy:
range1,range2. -
Vytvořte záznamy ve vyhledávání s rozsahy jako klíči a poli, jak je uvedeno výše (v příkladu je ve slovníku hodnot uložených ve vyhledávání pouze město).
-
Přidejte následující obohacovač do pravidla LogMan.io Parsec, které by mělo použít vyhledávání:
define: type: enricher/ip group: geo schema: /Schemas/ECS.yaml: postfix: geo.Specifikujte skupinu vyhledávání, která by měla být použita v atributu
group. Měla by být stejná jako skupina uvedená výše v deklaraci vyhledávání. Tenants jsou řešeni automaticky.Obohacování probíhá na každém poli, které má typ
ipve schématu.Postfix specifikuje příponu pro atribut:
Pokud je vstup
source.ipPak je výstup
source.geo.<NAME_OF_THE_ATTRIBUTE>Když jde o výchozí veřejné GEO vyhledávání (viz výše), následující položky jsou vyplněny ve výchozím nastavení:
city_name: type: str country_iso_code: type: str location: type: geopoint region_name: type: str
Vyhledávání rozsahu IP adres
Vyhledávání rozsahu IP adres používá rozsahy IP adres, jako je 192.168.1.1 až 192.168.1.10, jako klíče.
Deklarace vyhledávání rozsahu IP adres musí obsahovat typ lookup/ipaddressrange v sekci define a dva klíče s typem ip v sekci keys:
define:
type: lookup/ipaddressrange
name: mylookup
group: mygroup
keys:
- name: range1
type: ip
- name: range2
type: ip
fields:
...
Případ použití: Obohacení privátní IP adresy do zóny
Můžete použít vyhledávání IP-to-zone, když na základě rozsahu IP adres, jako je 192.168.1.1 až 192.168.1.10, chcete získat název zóny, název podlaží a další informace (např. budova společnosti, zda je to privátní nebo veřejná zóna atd.).
Hint
Použijte vyhledávání IP-to-zone pro obohacování privátní IP adresy.
-
V LogMan.io, přejděte do Library.
-
V Library přejděte do složky
/Lookups. -
Vytvořte novou deklaraci vyhledávání pro vaše vyhledávání, jako například "ipzonelookup.yaml" s příponou YAML
-
Přidejte následující deklaraci:
define: type: lookup/ipaddressrange name: ipzonelookup group: zone keys: - name: range1 type: ip - name: range2 type: ip fields: location: type: geopoint value: lat: 50.0643081 lon: 14.443938 zone_name: type: str value: myzone floor_name: type: strUjistěte se, že typ je vždy
lookup/ipaddressrange.Změňte
namev sekci define na název vašeho vyhledávání.groupse používá v obohacovacím procesu pro nalezení všech vyhledávání, která sdílí stejnou skupinu. Hodnota je unikátní identifikátor skupiny (use case), zde:zone.Klíče nechte tak, jak jsou, abyste specifikovali rozsahy.
Do
fieldspřidejte názvy a typy atributů vyhledávání. Zde v příkladu je pouze název podlaží, ale může být i název místnosti, název společnosti atd.:yaml fields: floor_name: type: strHodnota
valuebude použita jako výchozí.V současnosti jsou podporovány tyto typy:
str,fp64,si32,geopointaip. -
Uložte
-
V LogMan.io přejděte do Lookups.
-
Vytvořte nové vyhledávání se stejným názvem jako výše, tj. "ipzonelookup". Specifikujte dva klíče s názvy:
range1,range2. -
Vytvořte záznamy ve vyhledávání s rozsahy jako klíči a poli, jak je uvedeno výše (v příkladu je ve slovníku hodnot uložených ve vyhledávání pouze podlaží).
-
Přidejte následující obohacovač do pravidla LogMan.io Parsec, které by mělo použít vyhledávání:
define: type: enricher/ip group: floor schema: /Schemas/ECS.yaml: prefix: lmio.ipenricher. postfix: zone.Specifikujte skupinu vyhledávání, která by měla být použita v atributu
group. Měla by být stejná jako skupina uvedená výše v deklaraci vyhledávání. Tenants jsou řešeni automaticky.Obohacování probíhá na každém poli, které má typ
ipve schématu.Prefix specifikuje předponu a postfix specifikuje příponu pro atribut:
Pokud je vstup
source.ip, pak je výstuplmio.ipenricher.source.zone.<NAME_OF_THE_ATTRIBUTE>.
Vyhledávání jedné IP adresy
Vyhledávání jedné IP adresy je vyhledávání, které má přesně jeden klíč IP adresy s typem ip, který může být spojen s volitelným a variabilním počtem atributů definovaných žádnými nebo více hodnotami v fields.
Pro použití single IP vyhledávání spolu s následujícími obohacovači musí být typ vyhledávání v sekci define vždy lookup/ipaddress.
---
define:
type: lookup/ipaddress
name: mylookup
group: mygroup
keys:
- name: sourceip
type: ip
fields:
...
Případ použití: Vyhledávání špatných IP adres
Můžete použít obohacení špatné IP adresy, když na základě jedné IP adresy, jako je 192.168.1.1, chcete získat informace o rizikovém skóre IP adresy atd.
-
V LogMan.io, přejděte do Library.
-
V Library, přejděte do složky
/Lookups. -
Vytvořte novou deklaraci vyhledávání pro vaše vyhledávání, jako například "badips.yaml" s příponou YAML.
-
Přidejte následující deklaraci:
--- define: type: lookup/ipaddress name: badips group: bad keys: - name: sourceip type: ip fields: base: type: si32Ujistěte se, že typ je vždy
lookup/ipaddress.Změňte
namev sekcidefinena název vašeho vyhledávání.groupse používá v obohacovacím procesu pro nalezení všech vyhledávání, která sdílí stejnou skupinu. Hodnota je unikátní identifikátor skupiny (use case), zde:bad.Zachovejte jeden klíč v sekci
keyss typemip. Název by neměl obsahovat tečky ani jiné speciální znaky.Do
fieldspřidejte názvy a typy atributů vyhledávání. Zde v příkladu jebasejako integer, ale mohou být i jiné bezpečnostní atributy z https://www.elastic.co/guide/en/ecs/current/ecs-vulnerability.html:fields: base: type: si32V současnosti jsou podporovány tyto typy:
str,fp64,si32,geopoint, aip. -
Uložte
-
V LogMan.io přejděte do "Lookups".
-
Vytvořte nové vyhledávání se stejným názvem jako výše, tj. badips. Specifikujte IP adresu jako klíč.
-
Vytvořte záznamy ve vyhledávání s IP adresou jako klíčem a poli, jak je uvedeno výše (v příkladu je v hodnotovém slovníku uloženém ve vyhledávání pouze
base). -
Přidejte následující obohacovač do pravidla LogMan.io Parsec, které by mělo použít vyhledávání:
define: type: enricher/ip group: bad schema: /Schemas/ECS.yaml: # https://www.elastic.co/guide/en/ecs/current/ecs-vulnerability.html prefix: lmio.vulnerability. postfix: score.Specifikujte skupinu vyhledávání, která by měla být použita v atributu
group. Měla by být stejná jako skupina uvedená výše v deklaraci vyhledávání. Tenants jsou řešeni automaticky.Obohacování probíhá na všech polích, které mají typ
ipve schématu.Prefix je přidán k poli s rozřešenými atributy, které mají být použity pro další mapování:
Pokud je vstup
source.ipPak je výstup
lmio.vulnerability.source.score.<NAME_OF_THE_ATTRIBUTE> -
Na základě atributu a následného mapování může být přidána korelace s výstražným triggerem do
/Correlatorspro notifikaci o špatné IP adrese, jejíž základní skóre je vyšší než prahová hodnota:--- define: name: Bad IP Notification description: Bad IP Notification type: correlator/window predicate: !AND - !IN what: source.ip where: !EVENT - !GT - !ITEM EVENT lmio.vulnerability.source.score.base - 2 evaluate: dimension: [tenant, source.ip] by: "@timestamp" # Název event field s časem události resolution: 60 # jednotka je vteřina saturation: 10 # jednotka je resolution analyze: window: hopping # to je výchozí aggregate: sum # to je výchozí span: 2 # 2 * resolution z evaluate = mé časové okno test: !GE - !ARG - 1 trigger: - event: !DICT type: "{str:any}" with: message: "Bad IP Notification" events: !ARG EVENTS source.ip: !ITEM EVENT source.ip event.dataset: correlation - notification: type: email to: [logman@example.co] template: "/Templates/Email/Notification.md" variables: !DICT type: "{str:any}" with: name: Bad IP Notification events: !ARG EVENTS dimension: !ITEM EVENT source.ip
Případ použití: Obohacení IP adresy do assetu
Použijte obohacení IP-to-asset, když na základě jediné IP adresy, jako je 192.168.1.1, chcete získat informace z připraveného vyhledávání o assetech, zařízeních, hostech atd.
-
V LogMan.io, přejděte do Library.
-
V Library, přejděte do složky
/Lookups. -
Vytvořte novou deklaraci vyhledávání pro vaše vyhledávání, jako například "ipassetlookup.yaml" s příponou YAML.
-
Přidejte následující deklaraci:
--- define: type: lookup/ipaddress name: ipassetlookup group: asset keys: - name: sourceip type: ip fields: asset: type: strUjistěte se, že
typeje vždylookup/ipaddress.Změňte
namev sekcidefinena název vašeho vyhledávání.groupse používá v obohacovacím procesu pro nalezení všech vyhledávání, která sdílí stejnou skupinu. Hodnota je unikátní identifikátor skupiny (use case), zde:asset.Zachovejte jeden klíč v sekci
keyss typemip. Název by neměl obsahovat tečky ani jiné speciální znaky.Do `fields
Vyhledávání MAC adres
TeskaLabs LogMan.io nabízí optimalizovanou sadu vyhledávání pro práci s MAC adresami, nazvanou MAC vyhledávání.
Existují vždy tři kroky k povolení MAC vyhledávání:
- Vytvořte deklaraci vyhledávání v LogMan.io Knihovně (popis vyhledávání)
- Vytvořte vyhledávání a jeho obsah v sekci Vyhledávání v uživatelském rozhraní (obsah vyhledávání)
- Přidejte vyhledávání do relevantních pravidel pro analýzu a/nebo korelaci v Knihovně (aplikace vyhledávání)
Vyhledávání MAC adresy podle výrobce
Vyhledávání výrobce MAC je, když na základě rozsahu MAC adres, jako je 0c:12:30:00:00:01 až 0c:12:30:00:00:ff, chcete získat informace o výrobci zařízení, kterému je MAC adresa přidělena.
Vestavěné vyhledávání MAC adresy podle výrobce
Když MAC adresa z události neodpovídá žádnému z poskytnutých macvendor vyhledávání, bude použito výchozí veřejné vyhledávání výrobce MAC poskytované TeskaLabs LogMan.io.
-
V LogMan.io přejděte do Knihovny.
-
V Knihovně přejděte do složky
/Vyhledávání. -
Vytvořte novou deklaraci vyhledávání pro vaše vyhledávání, například "macvendorlookup.yaml" s příponou YAML.
-
Přidejte následující deklaraci:
define: type: lookup/macaddressrange name: macvendorlookup group: macvendor keys: - name: range1 type: mac - name: range2 type: mac fields: manufacturer: type: strUjistěte se, že
typeje vždylookup/macaddressrange.Změňte
namev sekcidefinena název vašeho vyhledávání.groupse poté používá v procesu obohacení k nalezení všech vyhledávání, která sdílejí stejnou skupinu. Hodnota je jedinečný identifikátor skupiny (použití), zde:macvendor.Zachovejte klíče tak, jak jsou, abyste specifikovali rozsahy.
Do
fieldspřidejte názvy a typy atributů vyhledávání.fields: manufacturer: type: strAtribut
valuebude použit jako výchozí.V současnosti jsou podporovány tyto typy:
str,fp64,si32,geopoint,ipamac. -
Uložte.
-
V LogMan.io přejděte do Vyhledávání.
-
Vytvořte nové vyhledávání se stejným názvem jako výše, tj. "macvendorlookup". Specifikujte dvě klíče s názvy:
range1,range2. -
Vytvořte záznamy ve vyhledávání s rozsahy jako klíči a poli, jak je uvedeno výše (v příkladu je v hodnotovém slovníku uložen pouze výrobce).
-
Přidejte následující obohacovač do pravidla Parsec LogMan.io, které by mělo využívat vyhledávání:
define: type: enricher/mac group: macvendor schema: /Schemas/ECS.yaml: postfix: device.Specifikujte skupinu vyhledávání, která má být použita v atributu
group. Měla by být stejná jako skupina zmíněná výše v deklaraci vyhledávání. Nájemníci jsou automaticky vyřešeni.Obohacení se provádí na každém poli, které má typ
macve schématu.Postfix specifikuje postfix pro atribut:
Pokud je vstup
source.macPak je výstup
source.observer.<NAME_OF_THE_ATTRIBUTE>.Pokud jde o výchozí veřejné vyhledávání výrobce MAC (viz výše), následující položky jsou vyplněny výchozími hodnotami:
manufacturer: type: str
Vyhledávání rozsahu MAC adres
Vyhledávání rozsahu MAC adres používá rozsahy MAC adres, jako je 0c:12:30:00:00:01 až 0c:12:30:00:00:ff, jako klíče.
Deklarace vyhledávání rozsahu MAC adres musí obsahovat typ lookup/macaddressrange v sekci define a dva klíče s typem mac v sekci keys:
define:
type: lookup/macaddressrange
name: mylookup
group: mygroup
keys:
- name: range1
type: mac
- name: range2
type: mac
fields:
...
Adaptivní vyhledávání
Adaptivní vyhledávání umožňuje komponentám pro zpracování událostí TeskaLabs LogMan.io, jako jsou LogMan.io Parsec, LogMan.io Correlator a LogMan.io Alerts, automaticky aktualizovat vyhledávání pro obohacení dat v reálném čase pomocí pravidel.
Vlastní pravidla mohou dynamicky přidávat nebo odstraňovat položky z těchto vyhledávání na základě poznatků získaných z příchozích logů nebo jiných událostí. To zajišťuje, že vaše strategie detekce a reakce na hrozby zůstávají agilní, přesné a v souladu s neustále se měnícím kybernetickým prostředím, čímž poskytují nezbytnou vrstvu inteligence pro vaše bezpečnostní operace.
Triggery
Obsah vyhledávání je manipulován specifickým záznamem v sekci trigger deklaračního souboru.
To znamená, že může vytvořit (set), incrementovat (add), dekrementovat (sub) a odstranit (delete) položku ve vyhledávání.
Položka je identifikována pomocí key, což je jedinečný primární klíč.
Příklad triggeru, který přidává položku do vyhledávání user_list:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
set:
event.created: !NOW
foo: bar
Příklad triggeru, který odstraňuje položku z vyhledávání user_list:
trigger:
- lookup: user_list
delete: !ITEM EVENT user.name
Příklad triggeru, který incrementuje čítač (pole my_counter) v položce ve vyhledávání user_list:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
add: my_counter
Příklad triggeru, který dekrementuje čítač (pole my_counter) v položce ve vyhledávání user_list:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
sub: my_counter
Pro oba add a sub, název čítače může být vynechán, a implicitně bude použita výchozí atribut _counter:
trigger:
- lookup: user_list
key: !ITEM EVENT user.name
sub:
Pokud pole s čítačem neexistuje, je vytvořeno s výchozí hodnotou 0.
Note
Položky z vyhledávání lze přistupovat z deklaračních výrazů pomocí !GET a !IN entry.
Lookups API
Změny lookupu mohou zahrnovat vytváření nebo mazání celé struktury lookupu, stejně jako přidávání, aktualizaci nebo odstraňování konkrétních položek v lookupu. Položky lze navíc automaticky odstranit při jejich vypršení platnosti. Tyto změny lze provést prostřednictvím UI systému (HTTPS API) nebo prostřednictvím Apache Kafka.
Události lookupu jsou zasílány každou komponentou, která vytváří události lookupu, do témat lmio-lookups.
Struktura události lookupu
Událost lookupu má JSON strukturu se třemi povinnými atributy: action, lookup_id a data. Atributy @timestamp a tenant jsou přidávány automaticky spolu s dalšími konfigurovanými meta atributy.
action
Specifikuje akci, kterou událost lookupu způsobila. Akce může být prováděna na celé lookupu nebo jen na jedné z jejích položek. Podívejte se na níže uvedený seznam, který zahrnuje všechny dostupné akce a jejich přidružené události.
lookup_id
ID nebo název lookupu. ID lookupu v událostech lookupu také obsahuje název tenantu po tečce . , takže každá komponenta ví, pro který tenant je lookup specifický.
data
Specifikace dat lookupu (tj. položky lookupu), která mají být vytvořena nebo aktualizována, stejně jako metainformace (v případě smazání položky).
Položky lookupu obsahují své ID v atributu _id struktury data. _id je řetězec založený na:
Jediný klíč
Pokud má lookup pouze jeden klíč (např. userName), _id je samotná hodnota pro řetězcovou hodnotu.
'data': {
'_id': 'JohnDoe'
}
...
Pokud je hodnota v bajtech, _id je UTF-8 dekódovaná řetězcová reprezentace hodnoty. Pokud hodnota není ani řetězec, ani bajty, je zpracována stejně jako ID při použití složených klíčů.
Složený klíč
Pokud se lookup skládá z více klíčů (např. [userName, location]), _id je hash reprezentace hodnoty.
Původní hodnoty jsou pak uloženy v atributu _keys uvnitř struktury data:
'data': {
'_id': '<INTERNAL_HASH>',
'_keys': ['JohnDoe', 'Company 1']
}
...
Vytvořit lookup
Když je lookup vytvořen, je vygenerována následující akce:
{
'@timestamp': <UNIX_TIMESTAMP>,
'tenant': <TENANT>,
'action': 'create_lookup',
'data': {},
'metadata': {
'_keys': ['key1name', 'key2name' ...]
...
},
'lookup_id': 'myLookup.tenant'
}
Metadata obsahují informace o vytvoření lookupu, jako jsou názvy jednotlivých klíčů (např. [userName, location]) v případě složených klíčů.
Smazat lookup
Když je lookup smazán, je vygenerována následující akce:
{
'@timestamp': <UNIX_TIMESTAMP>,
'tenant': <TENANT>,
'action': 'delete_lookup',
'data': {},
'lookup_id': 'myLookup.tenant'
}
Vytvořit položku
Když je vytvořena položka, je vygenerována následující akce:
{
'@timestamp': <UNIX_TIMESTAMP>,
'tenant': <TENANT>,
'action': 'create_item',
'data': {
'_id': 'newItemId',
'_keys': [],
...
},
'lookup_id': 'myLookup.tenant'
}
Aktualizovat položku
Když je položka aktualizována, je vygenerována následující akce:
{
'@timestamp': <UNIX_TIMESTAMP>,
'tenant': <TENANT>,
'action': 'update_item',
'data': {
'_id': 'existingOrNewItemId',
'_keys': [],
...
},
'lookup_id': 'myLookup.tenant'
}
Smazat položku
Když je položka smazána, je vygenerována následující akce.
Vypršení platnosti
V případě smazání z důvodu vypršení platnosti:
{
'@timestamp': <UNIX_TIMESTAMP>,
'tenant': <TENANT>,
'action': 'delete_item',
'data': {
'_id': 'existingItemId',
'reason': 'expiration'
},
'lookup_id': 'myLookup.tenant'
}
Prosím, vezměte na vědomí: Pokud není volba use_default_expiration_when_update zakázána (nastavena na false) v metainformacích lookupu, doba platnosti je obnovována při každé aktualizaci položky lookupu (aktuální čas + výchozí doba platnosti). Smazání z důvodu vypršení platnosti se tedy stane pouze v případě, že nebyla provedena žádná aktualizace položky po dobu trvání doby platnosti.
Smazat
Z jiných důvodů:
{
'@timestamp': <UNIX_TIMESTAMP>,
'tenant': <TENANT>,
'action': 'delete_item',
'data': {
'_id': 'existingItemId',
'reason': 'delete'
},
'lookup_id': 'myLookup.tenant'
}
Interní mechanismy vyhledávání
Služba vyhledávání
Služba správy vyhledávání zahrnuje:
- Objekty vyhledávání pouze pro čtení, které mohou fungovat jak v asynchronním, tak synchronním režimu (osvěžením při tiknutí)
- Objekty pro úpravu vyhledávání pouze pro zápis
- Objekty builderu pro synchronní soubory vyhledávání, které budou použity builderovými službami
Tato služba poskytuje rozhraní jak pro BSPump, tak pro SP-Lang.
Typy vyhledávání
Synchronní vyhledávání
Synchronní vyhledávání jsou vyhledávání načítaná ze souborů, která zahrnují:
- Vyhledávání IP adres
- Vyhledávání v Elasticsearch serializovaná do souborů
Vytvoření synchronních vyhledávání je řízeno pomocí LogMan.io Lookup Builderu (viz konfigurace), jehož výstup je uložen ve složce /lookups.
Asynchronní vyhledávání
Vyhledávání přímo načítaná z Elasticsearch.
Pokud synchronní soubor vyhledávání chybí nebo je poškozen, zpracování je automaticky řešeno pomocí asynchronních vyhledávání.
Asynchronní vyhledávání vyžadují méně nastavení, ale jsou méně optimální než synchronní vyhledávání.
Warden
LogMan.io Warden
TeskaLabs LogMan.io Warden je mikroservis, který periodicky provádí předdefinované detekce na zpracovaných událostech uložených v Elasticsearch. Elasticsearch indexy, ze kterých se události načítají, jsou získávány pomocí deklarací event lane pro daného nájemce, které jsou uloženy ve složce /EventLanes/ v knihovně. Detekce vytváří alerty ve službě LogMan.io Alerts.
Dostupné jsou následující detekce:
- Detekce IP, která detekuje IP adresy uložené v lookup
LogMan.io Warden konfigurace
LogMan.io Warden vyžaduje následující závislosti:
- Apache ZooKeeper
- Apache Kafka
- Elasticsearch
- SeaCat Auth
- LogMan.io Alerty
- LogMan.io Knihovna se složkami
/EventLanesa/Lookups/a schéma ve složce/Schemas
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-warden:
- <node> # Nahraďte názvem uzlu
Příklad
Toto je nejzákladnější konfigurace potřebná pro každou instanci LogMan.io Warden:
[tenant]
name=default
[ip]
lookup=ipbad
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=zk:///library
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[elasticsearch]
url=http://es01:9200/
[auth]
public_keys_url=http://localhost:8081/openidconnect/public_keys
Tenant
Specifikujte tenant, ve kterém je LogMan.io Warden nasazen a bude provádět detekce.
[tenant]
name=mytenant
Doporučuje se spustit jednu instanci LogMan.io Warden na tenant.
Detekce
IP
Specifikujte lookup, který uvádí IP adresy, které by měly být detekovány.
[ip]
lookup=ipbad
Lookup's key MUSÍ být typu ip ve specifikaci lookup, která je uložena ve složce /Lookups/ v knihovně.
---
define:
type: lookup/ipaddress
name: ipbad
group: bad
keys:
- name: sourceip
type: ip # Typ klíče musí být IP
Zookeeper
Specifikujte umístění serveru Zookeeper v clusteru:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Hint
Pro neprodukční nasazení je možné použít jeden server Zookeeper.
Knihovna
Specifikujte cestu(é) ke Knihovně pro načtení specifikací:
[library]
providers=zk:///library
Hint
Vzhledem k tomu, že schéma ECS.yaml ve složce /Schemas je využíváno ve výchozím nastavení, zvažte použití LogMan.io Common Library.
Kafka
Definujte bootstrap servery Kafka clusteru:
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Hint
Pro neprodukční nasazení je možné použít jeden server Kafka.
ElasticSearch
Specifikujte URL master uzlů Elasticsearch.
Elasticsearch je nezbytný pro používání lookup, např. jako !LOOKUP výraz nebo lookup trigger.
[elasticsearch]
url=http://es01:9200
username=MYUSERNAME
password=MYPASSWORD
Exporty
Exporty
Funkce exportů jsou zajišťovány mikroslužbou BS-Query, která klientům umožňuje snadno vytvářet, přizpůsobovat a spravovat exporty z databáze do souborů, nabízející různé možnosti, jako je výběr formátu, stahování dat, doručování e-mailem a automatické plánování.
Chcete-li se dozvědět, jak vytvářet a monitorovat exporty, navštivte odpovídající sekci uživatelské příručky zde.
Terminologie
Export
S výrazem "export" se můžete setkat v různých kontextech.
- Exportovaný soubor
- Především, "export" je data vyextrahovaná ze zdroje dat (typicky databáze). Říkejme mu "exportovaný soubor".
- Export v uživatelském rozhraní
- Export v LogMan.io Web Application je záznam informující o stavu exportu a poskytuje dodatečné informace. Nabízí také rozhraní pro stažení obsahu - "exportovaný soubor".
- Deklarace exportu
- Export v kontextu knihovny (YAML soubory v sekci
Exportsknihovny) je "deklarace exportu" - plán říkající, jak vytvořit nový export. - Exportní objekt
- A v neposlední řadě je "Export" objekt v aplikaci BS-Query a jeho reprezentace na disku. BS-Query Exportní objekt ukládá minimální informace v paměti. Místo toho slouží jako spojení k datovému úložišti.
Datové úložiště
Datové úložiště je organizováno následovně:
.
└── data
└── <export_id>.exp
├── content
│ └── <export_id>.json
├── declaration.yaml
└── export.json
└── schedule.json
- Adresář
contentukládá exportovaná data. Tento adresář může obsahovat žádný nebo pouze jeden soubor. - Soubor
declaration.yamlukládá všechny proměnné potřebné pro tento export. Kompletní strukturu deklarace najdete v této kapitole. - Soubor
export.jsonukládá metadata tohoto konkrétního exportu. Mohl by vypadat takto:{"state": "finished", "_c": 1692975120.0054746, "_m": 1692975120.0054772, "export_size": 181610228, "_f": 1692975170.0347197} - Soubor
schedule.jsonje zde pouze pro naplánované exporty. Ukládá časové razítko dalšího spuštění.
Zdroj dat
Se "zdrojem dat" nebo i "datasource" se můžete setkat v různých kontextech.
- Zdroj dat
- Zdroj dat. Toto je originální databáze nebo jiná technologie, ze které extrahujeme data.
- Deklarace zdroje dat
- Toto je YAML soubor v sekci
DataSourcesknihovny. Je to plán/příručka specifikující připojení k externímu zdroji dat. - Objekt datasource
- Objekt v aplikaci BS-Query zodpovědný za připojení ke zdroji dat/databázi a extrakci dat.
Deklarace
Deklarace je manuál nebo plán pro systém, který předepisuje, jak vykonat. Deklarace exportu jednoduše předepisuje, co by mělo být v výsledném exportovaném souboru. Tyto deklarace najdete ve formátu YAML v knihovně. Naučte se, jak číst nebo psát export a deklarace zdrojů dat v této kapitole.
Exportní životní cyklus
Každý export má stav. Každý přechod stavu spouští akci.
Vytvořen
Nejprve je export vytvořen na základě vstupu. Každý export musí být vytvořen na základě deklarace. Existuje několik způsobů, jak poskytnout deklaraci - jako soubor JSON nebo YAML nebo jako odkaz na Knihovnu.
Je generováno ID exportu a složka <export_id>.exp se objeví v úložišti dat.
Následně je export přemístěn do stavu "vědění".
Vědění
Každá deklarace exportu obsahuje položku "datasource". Toto je odkaz na sekci knihovny /DataSources.
Ve stavu zpracování BS-Query čte deklaraci zdroje dat z Knihovny a vytváří objekt zdroje dat - toto je specifické připojení k vybrané databázi. Každý objekt exportu vytváří a používá jeden objekt zdroje dat.
Query je řetězcová proměnná z deklarace exportu určující, která data se mají sbírat.
Při použití dokumentových databází je každý dokument zpracováván jeden po druhém, čímž se vytváří stream, který snižuje využití paměti a zvyšuje výkon.
Každý dokument/záznam prochází transformačními funkcemi. Více se dozvíte o tom, jak transformovat exportovaná data na základě schématu.
Následně je uložen ve formátu zvoleném v sekci output deklarace exportu.
Ne všechny zdroje dat podporují všechny výstupní formáty.
Komprese
Krok komprese je volitelný, na základě deklarace exportu.
Postprocessing
V této fázi již není obsah exportu editován, je odeslán na vybrané cíle, přičemž první volbou je e-mail. BS-Query používá ASAB Iris k odesílání exportů prostřednictvím e-mailu.
Dokončeno
Existují dvě možnosti. Export byl úspěšně dokončen a je připraven ke stažení nebo došlo k výjimce v životním cyklu exportu a takový export "dokončen s chybou".
Existují známé chyby, kterým lze předcházet poskytnutím lepšího vstupu. Takové chyby jsou navrženy tak, aby poskytovaly dostatek informací na UI. Objekt exportu, který byl dokončen s výjimkou, je uložen spolu s informacemi o chybě. Neznámé chyby jsou označeny kódem GENERAL_ERROR.
Plánované exporty
Plánované exporty nesledují standardní životní cyklus exportu. Namísto toho končí ve stavu scheduled když jsou vytvořeny.
Existují dva typy plánovaných exportů.
Jednorázové plánované exporty
Tyto exporty jsou naplánovány na jeden konkrétní okamžik v budoucnosti. Při vytvoření je budoucí časové razítko uloženo do souboru schedule.json. Když tento čas nastane, BS-Query vytvoří nový export, který dědí deklaraci plánovaného exportu ALE vynechává položku schedule. Původní plánovaný export již není potřeba a je odstraněn.
Opakované plánované exporty
Tyto exporty obsahují řetězec ve formátu cron v možnosti schedule deklarace. Tento rozvrh ve formátu cron se používá k výpočtu času dalšího spuštění, když je vytvořen nový export dědící deklaraci plánovaného exportu stejným způsobem jako jednorázové exporty. Plánovaný export není smazán, ale vypočítává nové budoucí časové razítko a cyklus se opakuje.
Varování
Dávejte pozor při řešení problémů s chováním plánovaného exportu. Plánovaný export má vždy alespoň dvě ID. Jedno původního plánovaného exportu a druhé potomka běžícího exportu. Může to být ještě složitější - při úpravě plánovaného exportu je odstraněn a nový export s novým ID je vytvořen. Tímto způsobem má plánovaný export (zobrazený z UI) více ID (jedná se o více exportních objektů v aplikaci BS-Query).
Exports a Knihovna
Existují tři typy artefaktů Knihovny, které používá aplikace BS-Query.
DataSources
Deklarace datových zdrojů jsou zásadní pro funkčnost BS-Query. Bez datového zdroje nejsou žádné exporty.
Aplikace BS-Query podporuje následující typy deklarací datových zdrojů:
datasource/elasticsearchdatasource/pyppeteer
/DataSources/elasticsearch.yaml
define:
type: datasource/elasticsearch
specification:
index: lmio-{{tenant}}-events*
request:
<key>: <value>
<key>: <value>
query_params:
<key>: <value>
<key>: <value>
define
type: technický název, který pomáhá najít deklaraci datového zdroje v Knihovně.
specification
index: kolekce JSON dokumentů v Elasticsearch. Každý dokument je soubor polí, která obsahují data prezentovaná jako páry klíč-hodnota. Pro podrobnější vysvětlení se podívejte na tento článek.
Existuje také několik dalších položek, které lze konfigurovat v deklaraci DataSource. Jedná se o standardní parametry API Elasticsearch, pomocí kterých můžete doladit šablonu deklarace, abyste určili konkrétní obsah požadovaných dat a/nebo akcí prováděných na nich. Jedním z takových parametrů je size - počet odpovídajících dokumentů, které mají být vráceny v jednom požadavku.
request
Pro více podrobností se podívejte na dokumentaci Elastic.
query_params
Pro více podrobností se podívejte na dokumentaci Elastic.
Exports
Deklarace exportů specifikují, jak získat data z datového zdroje. YAML soubor obsahuje následující sekce:
define
Sekce define obsahuje následující parametry:
name: Název exportu.datasource: Název deklarace DataSource v knihovně, uvedený jako absolutní cesta k knihovně.output: Výstupní formát exportu. Dostupné možnosti jsou "raw", "csv" a "xlsx" pro ES DataSources a "raw" pro Kafka DataSources.header: Při použití výstupu "csv" nebo "xlsx" musíte specifikovat hlavičku výsledné tabulky jako pole názvů sloupců. Ty se objeví ve stejném pořadí, v jakém jsou uvedeny.schedule: Existují tři možnosti, jak naplánovat export: - datetime ve formátu "%Y-%m-%d %H:%M" (například 2023-01-01 00:00) - timestamp jako celé číslo (například 1674482460) - cron - pro více informací se podívejte na http://en.wikipedia.org/wiki/Cronschema: Schéma, ve kterém by měl být export spuštěn.
Schema
Vždy je pro každý tenant konfigurováno jedno schéma (viz sekce Tenants konfigurace). Deklarace exportu může uvádět schéma, k němuž patří.
Pokud se schéma deklarace exportu neshoduje s konfigurací schématu tenant, export přestane být vykonáván.
target
Sekce target obsahuje následující parametry:
type: Pole typů cílového místa pro export. Možnosti jsou "download", "email" a "jupyter". "download" je vždy vybrán, pokud sekce target chybí.email: Pro typ cílového místa email musíte specifikovat alespoň poleto, což je pole e-mailových adres příjemců. Mezi další nepovinná pole patří: -cc: pole příjemců CC -bcc: pole příjemců BCC -from: e-mailová adresa odesílatele (řetězec) -subject: předmět e-mailu (řetězec) -body: název souboru (s příponou) uložený ve složce Template knihovny, použitý jako šablona těla e-mailu. Můžete také přidat speciálníparameters, které mají být použity v šabloně. Jinak použijte libovolné klíčové slovo ze sekce define vašeho exportu jako parametr šablony (pro každý export to je:name,datasource,output, pro specifické exporty můžete také použít parametry:compression,header,schedule,timezone,tenant).
query
Pole query musí být řetězec.
Tip
Kromě těchto parametrů můžete ve své deklaraci exportu použít klíčová slova specifická pro deklaraci datového zdroje. Pokud dojde ke konfliktům, bude mít přednost deklarace datového zdroje.
schema
Můžete přidat částečné schéma, které přepíše běžné schéma nastavené v konfiguraci.
Tato funkce umožňuje převody založené na schématu na exportovaných datech. To zahrnuje:
- Převod z časového razítka na lidsky čitelný formát data, kde schéma specifikuje typ
datetime - Deidentification
/Exports/example_export.yaml
define:
name: Export e-mail test
datasource: elasticsearch
output: csv
header: ["@timestamp", "event.dataset", "http.response.status_code", "host.hostname", "http.request.method", "url.original"]
target:
type: ["email"]
email:
to:
- john.doe@teskalabs.com
query: >
{
"bool": {
"filter": [{
"prefix": {
"http.version": {
"value": "HTTP/1.1"
}
}
}]
}
}
schema:
fields:
user.name:
deidentification:
method: hash
source.address:
deidentification:
method: ip
Templates
Sekce Templates Knihovny se používá při odesílání Exportů e-mailem. Tělo e-mailu musí být založeno na šabloně. Vložte vlastní šablonu do adresáře Templates/Email. V těchto souborech můžete použít šablonování jinja. Další informace naleznete v dokumentaci jinja. Všechna klíčová slova z deklarace exportu mohou být použita jako proměnné jinja.
Deidentifikace
LogMan.io vám umožňuje exportovat jakákoli data pro vlastní účely, např. pro externí analýzy.
Logy velmi často obsahují citlivé osobní údaje o uživatelích.
Používejte deidentifikaci během exportů, kdykoli poskytujete data třetím stranám.
Deidentifikační algoritmy zachovávají granularitu a jedinečnost dat, což umožňuje analýzu bezpečnostních incidentů bez vystavení osobních informací uživatelů.
Použijte schema k aplikaci deidentifikačních metod na exportovaná data.
Deidentifikační metody
hash-
Používá algoritmus SHA256 k hashování hodnoty.
email-
Vyhledává emailové adresy pomocí regulárního výrazu
^(.*)@(.*)(\..*)$(john.doe@company.com) a používá SHA256 k hashování jména a domény zvlášť. Vracínot email, pokud hodnota neodpovídá regulárnímu výrazu. username-
Je kombinace metody
hashaemail. Aplikuje metodu email, ale vrací hodnotu hash, pokud hodnota neodpovídá regulárnímu výrazu. filepath-
Hashuje název souboru, ale zachovává příponu. Umožňuje další analýzu na základě typů souborů.
ip-
Náhodně mění poslední část ipv4 adresy.
drop-
Zcela vymaže citlivá data z exportu.
Konfigurace BS-Query
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
bs-query:
- <node> # Nahraďte názvem uzlu
Běžná konfigurace clusteru
Tato konfigurace závisí na dalších clusterových službách a musí odpovídat architektuře clustery.
Umístění Zookeeper serveru v clusteru.
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
Vrstva knihovny.
[library]
providers=zk:///library
Telemetrie.
[asab:metrics]
Navštivte ASAB dokumentaci pro více informací o metrikách.
Datové zdroje
Zde jsou některé příkladové konfigurační sekce potřebné pro připojení datového zdroje.
[mongodb]
mongodb_uri=mongodb://mongo-1/?replicaSet=rs0
[elasticsearch]
url=
http://es01:9200
http://es02:9200
http://es03:9200
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[pyppeteer]
url=http://<example_url>
username=<pyppeteer_username>
password=<pyppeteer_password>
Autorizace
[auth]
Viz ASAB dokumentace.
Specifická konfigurace BS-Query
Adresář pro ukládání všech exportů.
[storage]
path=/data/bsquery
Poskytněte URL k ASAB Iris mikroslužbě a výchozí emailovou šablonu nacházející se ve složce /Templates/Email knihovny.
Limit velikosti souboru je v bytech a výchozí nastavení je 50 MB.
[target:email]
url=http://<example_url>
template=bsquery.md
file_size_limit=52 000 000
Název adresáře sdíleného s Jupyter Notebook. Pro konfiguraci cíle Jupyter, musí Jupyter Notebook a BS-Query sdílet společný adresář v souborovém systému.
[target:juptyer]
path=/data/jupyter
Existuje výchozí limit řádků pro exporty ve formátu Excel o velikosti 50 000 řádků. Buďte si vědomi, že tento limit chrání BS-Query před načítáním příliš velkého množství dat do paměti.
[xlsx]
limit=60000
BS-Query čte vlastní konfiguraci tenanta z ASAB Config. Pokud není konfigurace tenanta k dispozici, používá se tato výchozí konfigurace časového pásma a používaného schématu. Výchozí hodnoty jsou UTC a ECS Schema. Vypršení říká, za kolik dní je dokončený export smazán. Výchozí hodnota je 30 dní.
[default]
schema=/Schemas/ECS.yaml
timezone=UTC
expiration=30
Poskytněte tajný klíč a vypršení odkazu pro stažení v sekundách. Klíč je náhodný řetězec. Udržte vypršení co nejkratší. Doporučuje se výchozí nastavení vypršení.
[download]
secret_key=<custom_secret_key>
expiration=5
Řešení problémů
Řešení nejčastěji se vyskytujících problémů:
Speciální znaky v exportním souboru jsou zkreslené / nesprávné
Exportní soubory jsou kódovány jako UTF-8.
Pokud vaše nástroje takové soubory ve výchozím nastavení správně nezpracovávají, je třeba upravit jejich nastavení.
Možná řešení:
-
Nastavte svou Excel aplikaci, aby správně otevírala UTF-8 CSV soubory.
-
Zkontrolujte nastavení kódování vašeho systému (například Windows-1250), abyste našli vhodný konverzní nástroj.
Reporty
ASAB Pyppeteer
Microservice ASAB Pyppeteer usnadňuje tvorbu naplánovaných reportů.
ASAB Pyppeteer provozuje bezhlavý prohlížeč Chromium, který může otevírat a generovat reporty. Umožňuje vám využít funkci plánování Exportů k definování, kdy bude report vytvořen a odeslán e-mailem.
Je důležité poznamenat, že každý uživatel může mít různé úrovně přístupu k různým sekcím LogMan.io, včetně reportů. Důsledkem toho musí být naplánované reporty ověřeny a povoleny stejným způsobem jako původní plánovací akce. Pro informace o nastavení autorizace pokračujte do sekce autentizace.
Autorizace plánovaných reportů
Plánovaný report obsahuje informace o jeho autorovi. Když nastane čas pro tisk a odeslání reportu, mikroslužba ASAB Pyppeteer zastupuje autora, což zajišťuje, že report je vytvořen z perspektivy a na úrovni přístupu konkrétního uživatele.
Pro správnou konfiguraci BS-Query (Exporty), SeaCat Auth a ASAB Pyppeteer tak, aby umožňovaly kompletní komunikaci mezi službami, postupujte podle těchto kroků:
1. Konfigurace ASAB Pyppeteer
Ujistěte se, že instance ASAB Pyppeteer může přistupovat k SeaCat Auth.
[seacat_auth]
url=http://localhost:3081
2. Konfigurace SeaCat Auth
Ujistěte se, že konfigurace SeaCat Auth umožňuje vytváření strojových pověření.
[seacatauth:credentials:m2m:machine]
mongodb_uri=mongodb://localhost:27017
mongodb_database=auth
3. Vytvoření pověření pro ASAB Pyppeteer
Odkazujte se na uživatelský manuál pro instrukce, jak vytvářet a přiřazovat pověření, zdroje, role a tenancy.
Nejprve vytvořte zdroj authz:impersonate a globální roli s tímto zdrojem (pojmenovanou např. "impersonator").
Poté vytvořte nová pověření machine s <pyppeteer_username> a <pyppeteer_password> a přiřaďte jim roli "impersonator" a relevantní tenanty.
4. Zadejte pověření pyppeteer do konfigurace BS-Query
[pyppeteer]
url=http://localhost:8895
username=<pyppeteer_username>
password=<pyppeteer_password>
Upozornění
Dávejte pozor, že ASAB Pyppeteer nemůže zastupovat superuživatele. Proto uživatel s rolí superuživatele nemůže vytvářet plánované reporty, pokud mu není explicitně přidělena role se zdrojem bitswan:report:access.
Zprávy a notifikace
Zprávy a oznámení
Zprávy a oznámení LogMan.io jsou spravovány službou asab-iris.
Služba zasílání zpráv odesílá zprávy prostřednictvím nakonfigurovaných komunikačních kanálů. Používá se, když LogMan.io potřebuje doručit oznámení, upozornění, zprávy nebo jiné zprávy určené uživatelům do externích systémů.
Služba zasílání zpráv vytváří šablony zpráv a odesílá vykreslený výstup prostřednictvím nakonfigurované integrace. Přesné integrace dostupné v nasazení závisí na konfiguraci služby.
Vyberte výstup
| Výstup | Použijte, když | Konfigurace |
|---|---|---|
| SMTP e-mail | E-mail musí být odeslán prostřednictvím SMTP serveru nebo poštovního relé. | smtp |
| Microsoft 365 email | E-mail musí být odeslán přes tenant Microsoft 365. | m365_email |
| Slack | Oznámení musí být odeslána do veřejného kanálu Slacku. | slack |
| Push notifikace | Oznámení musí být odeslána odběratelům ntfy. | push |
| Mattermost | Upozornění musí být odeslána do kanálu nebo uživateli na Mattermostu. | mattermost |
| Microsoft Teams | Oznámení musí být odeslána do kanálu Microsoft Teams. | msteams |
| SMS | Upozornění musí být odesílána jako SMS zprávy. | sms |
SMTP e-mail
Služba zasílání zpráv může odesílat e-mailová oznámení prostřednictvím serveru SMTP.
Pokyny pro konfiguraci naleznete v SMTP e-mailu.
E-mail Microsoft 365
Služba zasílání zpráv může odesílat e-maily prostřednictvím Microsoft 365 pomocí Microsoft Graph API.
Pokyny k nastavení naleznete v Microsoft 365 e-mailu.
Slack
Služba zasílání zpráv může posílat oznámení do kanálu Slack.
Pokyny pro konfiguraci naleznete na Slacku.
Push oznámení
Služba zasílání zpráv může odesílat push notifikace prostřednictvím ntfy nebo na vlastním serveru kompatibilním s ntfy.
Pokyny pro konfiguraci naleznete v Push notifikacích.
Mattermost
Služba zasílání zpráv může odesílat oznámení do kanálů Mattermost nebo přímo uživatelům Mattermost.
Pokyny pro konfiguraci naleznete v Mattermost.
Microsoft Teams
Služba zasílání zpráv může odesílat oznámení do Microsoft Teams pomocí adresy URL webhooku Teams.
Pokyny pro konfiguraci naleznete v Microsoft Teams.
SMS
Služba zasílání zpráv může odesílat SMS upozornění pomocí SMSBrána SMS Connect.
Pokyny pro konfiguraci naleznete v SMS.
SMTP e-mail
Služba zasílání zpráv může odesílat e-mailová oznámení prostřednictvím serveru SMTP.
Použijte SMTP, když organizace již poskytuje poštovní relé nebo když není v nasazení používán e-mail Microsoft 365.
Poznámka
Pokud je nakonfigurován SMTP, služba používá SMTP pro e-mail. Pokud SMTP není nakonfigurováno a je nakonfigurován e-mail Microsoft 365, služba používá Microsoft 365.
Předpoklady
Než nakonfigurujete SMTP, ujistěte se, že:
- organizace poskytuje SMTP server nebo přeposílač pošty
- server LogMan.io se může připojit k SMTP serveru na nakonfigurovaném portu
- je známo požadované SMTP TLS nastavení, buď implicitní TLS nebo STARTTLS
- jsou k dispozici SMTP přihlašovací údaje, pokud server vyžaduje autentizaci
- nakonfigurovaná odesílací adresa je povolena k odesílání přes SMTP server
- je k dispozici řetězec certifikátů CA, pokud SMTP server používá interní certifikační autoritu
- jsou k dispozici údaje o HTTP CONNECT proxy, pokud musí odchozí SMTP provoz procházet proxy serverem
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
host |
Název hostitele nebo IP adresa SMTP serveru. |
port |
Port serveru SMTP. Běžné hodnoty jsou 465 pro implicitní TLS a 587 pro STARTTLS. |
from |
Výchozí e-mailová adresa odesílatele. |
Ověřovací pole jsou vyžadována, když SMTP server vyžaduje přihlášení:
| Pole | Popis |
|---|---|
user |
Uživatelské jméno SMTP. |
password |
Heslo SMTP. |
Pole TLS určují, jak služba komunikuje se SMTP serverem:
| Pole | Popis |
|---|---|
ssl |
Nastavte na yes pro implicitní TLS, běžně na portu 465. |
starttls |
Nastavte na yes pro STARTTLS, běžně na portu 587. |
validate_certs |
Nastavte na yes pro ověření certifikátu SMTP serveru. Toto se doporučuje pro produkční prostředí. |
cert_bundle |
Volitelná cesta k CA nebo souboru PEM pro certifikační řetězec pro interní certifikační autority. |
Varování
Nepovolujte současně ssl a starttls.
Nepovinná konfigurační pole
| Pole | Popis |
|---|---|
subject |
Výchozí předmět e-mailu používaný, když oznámení neposkytne vlastní. |
proxy_host |
HTTP CONNECT proxy hostname. |
proxy_port |
Port proxy serveru HTTP CONNECT. |
proxy_user |
Nepovinné uživatelské jméno proxy. |
proxy_password |
Nepovinné heslo proxy. |
proxy_connect_timeout |
Časový limit připojení proxy v sekundách. |
Nastavení proxy je potřeba pouze tehdy, když server LogMan.io musí dosáhnout SMTP serveru prostřednictvím HTTP CONNECT proxy.
Ukázka konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
smtp:
host: smtp.example.com
port: 587
user: "{{SMTP_USER}}"
password: "{{SMTP_PASSWORD}}"
from: "noreply@example.com"
ssl: no
starttls: yes
validate_certs: yes
cert_bundle: ""
Instrukce k nastavení
- Získejte údaje o SMTP serveru od správce pošty:
- název hostitele
- port
- režim TLS
- uživatelské jméno a heslo, pokud je vyžadována autentizace
- adresa odesílatele
- Potvrďte, že server LogMan.io se může připojit k SMTP serveru.
- Vyberte režim TLS:
- použijte
ssl: yesastarttls: nopro implicitní TLS na portu465 - použijte
ssl: noastarttls: yespro STARTTLS na portu587 - Pokud SMTP server používá interní certifikační autoritu, zkopírujte soubor PEM s řetězcem CA do prostředí LogMan.io a nakonfigurujte
cert_bundle. - Uložte SMTP přihlašovací údaje do Vault nebo do úložiště tajemství nasazení používaného instalací LogMan.io.
- Aktualizujte
/Site/model.yaml. - Aplikujte model z Knihovny nebo spusťte příkaz pro aplikaci nasazení používaný instalací.
- Odeslat testovací e-mailové upozornění.
Ověřte konfiguraci
Konfigurace je připravena, když:
- služba se spouští bez chyb konfigurace SMTP
- testovací e-mail je doručen očekávanému příjemci
- zpráva je odeslána z nakonfigurované adresy
from - validace TLS certifikátu uspěje, pokud je povoleno
validate_certs - přílohy jsou doručeny, pokud oznámení obsahuje přílohy
Běžná nastavení
STARTTLS na portu 587
services:
asab-iris:
asab:
config:
smtp:
host: smtp.example.com
port: 587
user: "{{SMTP_USER}}"
password: "{{SMTP_PASSWORD}}"
from: "noreply@example.com"
ssl: no
starttls: yes
validate_certs: yes
cert_bundle: ""
Implicitní TLS na portu 465
services:
asab-iris:
asab:
config:
smtp:
host: mail.internal.example
port: 465
user: "{{SMTP_USER}}"
password: "{{SMTP_PASSWORD}}"
from: "noreply@example.com"
ssl: yes
starttls: no
validate_certs: yes
cert_bundle: "/etc/ssl/internal-ca.pem"
SMTP přes HTTP CONNECT proxy
services:
asab-iris:
asab:
config:
smtp:
host: mail.internal.example
port: 465
user: "{{SMTP_USER}}"
password: "{{SMTP_PASSWORD}}"
from: "noreply@example.com"
ssl: yes
starttls: no
validate_certs: yes
cert_bundle: "/etc/ssl/internal-ca.pem"
proxy_host: proxy.example.com
proxy_port: 3128
proxy_user: "{{SMTP_PROXY_USER}}"
proxy_password: "{{SMTP_PROXY_PASSWORD}}"
proxy_connect_timeout: 10
Šablony e-mailů
E-mailové šablony musí být uloženy v adresáři /Templates/Email/ v Knihovně.
Pro více informací o e-mailových oznámeních a šablonách viz:
E-mail Microsoft 365
Služba zasílání zpráv může odesílat e-mailová oznámení prostřednictvím Microsoft 365 (M365) pomocí rozhraní Microsoft Graph API.
Použijte tuto integraci, když mají být oznámení, upozornění nebo zprávy z LogMan.io odesílány z poštovní schránky v tenantovi Microsoft 365.
Služba zasílání zpráv podporuje dva režimy Microsoft 365:
- Režim aplikace: služba zasílání zpráv odesílá e-mail jako aplikace.
- Delegovaný režim: služba zasílání zpráv odesílá e-mail jménem přihlášeného uživatele Microsoft 365.
Předpoklady
Ujistěte se, že server LogMan.io má odchozí přístup přes HTTPS na TCP port 443 na:
graph.microsoft.comlogin.microsoftonline.com
Je vyžadován přístup k Microsoft Entra ID s oprávněními k vytvoření nebo aktualizaci registrace aplikace a udělení souhlasu.
Režim aplikace
Režim aplikace používá oprávnění aplikace Microsoft Graph. Tento režim použijte, když by služba měla automaticky odesílat e-maily bez přihlášení uživatele.
Toto je doporučený režim pro oznámení o službách a automatizaci na pozadí.
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
mode |
Nastaveno na app. |
api_url |
Microsoft Graph send-mail endpoint. Use https://graph.microsoft.com/v1.0/users/{}/sendMail. |
tenant_id |
ID adresáře (tenant) Microsoft Entra. |
client_id |
ID aplikace (klienta) registrace aplikace. |
client_secret |
Hodnota klientského tajemství z registrace aplikace. |
user_email |
Poštovní schránka, ze které služba zasílání zpráv odesílá. |
Ukázka konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
m365_email:
mode: app
api_url: https://graph.microsoft.com/v1.0/users/{}/sendMail
tenant_id: "{{M365_TENANT_ID}}"
client_id: "{{M365_CLIENT_ID}}"
client_secret: "{{M365_CLIENT_SECRET}}"
user_email: "noreply@example.com"
Konfigurace Azure
- Otevřete Microsoft Entra admin center.
- Přejděte na Aplikace > Registrace aplikací.
- Klikněte na Nová registrace.
- Zadejte popisný název, například
LogMan.io Notifications Email. - Vyberte Účty pouze v tomto organizačním adresáři.
- Pole Přesměrovací URI nechte prázdné.
- Klikněte na Registrovat.
- Na stránce Přehled zkopírujte:
- ID aplikace (klienta) do
client_id - ID adresáře (nájemce) do
tenant_id - Přejděte na Certifikáty a tajemství.
- Klikněte na Nové klientské tajemství.
- Zkopírujte hodnotu tajemství Value do
client_secret.
Varování
Hodnota tajného klíče klienta je zobrazena pouze jednou. Uložte ji bezpečně, než stránku opustíte.
Oprávnění API
- Otevřete registraci aplikace.
- Přejděte na Oprávnění API.
- Klikněte na Přidat oprávnění.
- Vyberte Microsoft Graph.
- Vyberte Oprávnění aplikace.
- Přidejte
Mail.Send. - Klikněte na Poskytnout souhlas správce pro organizaci.
Doporučení ohledně bezpečnosti
Aplikace s oprávněním Mail.Send může umožnit odesílání e-mailů z libovolné schránky v tenantovi.
Použijte zásadu přístupu aplikace Exchange Online (Exchange Online Application Access Policy) k omezení aplikace pouze na schránku nakonfigurovanou v user_email.
Použít konfiguraci
- Uložte tajné hodnoty do Vaultu nebo do úložiště tajemství nasazení používaného instalací LogMan.io.
- Aktualizujte
/Site/model.yaml. - Aplikujte model z Knihovny nebo spusťte příkaz pro aplikaci nasazení používaný instalací.
- Odešlete testovací oznámení a ověřte, že zpráva byla doručena z nakonfigurované schránky
user_email.
Ověřte konfiguraci
Konfigurace režimu aplikace je připravena, když:
- služba se spouští bez chyb konfigurace Microsoft 365
- registrace aplikace má oprávnění aplikace Microsoft Graph
Mail.Send - byl udělen souhlas správce
- testovací e-mail je doručen z nakonfigurované schránky
user_email - logy služby neobsahují chyby autentizace Microsoft Graph
Delegovaný režim
Delegovaný režim používá delegovaná oprávnění Microsoft Graph. Tento režim použijte, když musí komunikační služba odesílat e-maily jménem konkrétního uživatele Microsoft 365.
Delegovaný režim vyžaduje jednorázové povolení v prohlížeči. Uživatelem, který se přihlásí, musí být uživatel poštovní schránky nastavený v user_email, nebo uživatel, kterému Microsoft 365 umožňuje odesílat e-maily jako tato poštovní schránka.
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
mode |
Nastaveno na delegované. |
api_url |
Microsoft Graph send-mail endpoint. Use https://graph.microsoft.com/v1.0/users/{}/sendMail. |
tenant_id |
ID adresáře (tenant) Microsoft Entra. |
client_id |
ID aplikace (klienta) registrace aplikace. |
client_secret |
Hodnota klientského tajemství z registrace aplikace. |
user_email |
Poštovní schránka, ze které služba zasílání zpráv odesílá. |
redirect_uri |
Veřejná URL zpětného volání autorizace končící na /authorize_ms365. |
Vzor konfigurace
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
m365_email:
mode: delegated
api_url: https://graph.microsoft.com/v1.0/users/{}/sendMail
tenant_id: "{{M365_TENANT_ID}}"
client_id: "{{M365_CLIENT_ID}}"
client_secret: "{{M365_CLIENT_SECRET}}"
user_email: "notifications@example.com"
redirect_uri: "https://logman.example.com/api/asab-iris/authorize_ms365"
URL authorize_ms365
URL authorize_ms365 spouští přihlašovací proces Microsoftu pro delegovaný režim.
Otevřete tuto URL v prohlížeči poté, co je nakonfigurován delegovaný režim. Služba přesměruje prohlížeč na přihlášení Microsoft. Po úspěšném přihlášení Microsoft přesměruje zpět na stejný koncový bod služby a služba uloží delegované oprávnění pro budoucí e-maily.
Jak sestavit URL
Sestavte URL z veřejně dostupné adresy služby přístupné z prohlížeče:
<public service base URL>/authorize_ms365
Pokud je služba zpřístupněna za reverzní proxy s předponou cesty, zahrňte předponu:
https://logman.example.com/api/asab-iris/authorize_ms365
Hodnota musí být nastavena na dvou místech:
- V registraci aplikace Microsoft Entra ID jako URI pro přesměrování.
- V konfiguračním poli
m365_email.redirect_uri.
Nebezpečí
Přesměrovací URI v Microsoft Entra ID a hodnota redirect_uri v m365_email.redirect_uri se musí přesně shodovat, včetně https, hostitele, portu a cesty.
Konfigurace Azure
- Otevřete Microsoft Entra admin center.
- Přejděte na Applications > App registrations.
- Vytvořte novou registraci aplikace nebo otevřete registraci aplikace používanou pro zasílání zpráv a oznámení.
- Zkopírujte Application (client) ID do
client_id. - Zkopírujte Directory (tenant) ID do
tenant_id. - Přejděte na Authentication.
- Přidejte platformu pro Web.
- Přidejte přesný
redirect_uri, napříkladhttps://logman.example.com/api/asab-iris/authorize_ms365. - Přejděte na Certificates & secrets a vytvořte klientské tajemství.
- Zkopírujte Value tajemství do
client_secret.
Oprávnění API
- Otevřete registraci aplikace.
- Přejděte na Oprávnění API.
- Klikněte na Přidat oprávnění.
- Vyberte Microsoft Graph.
- Vyberte Delegovaná oprávnění.
- Přidejte
Mail.Send. - Udělte souhlas správce, pokud to organizace vyžaduje.
Autorizovat delegované odesílání
- Nakonfigurujte
m365_emailsmode: delegated. - Aplikujte model LogMan.io.
- Otevřete veřejnou URL
authorize_ms365v prohlížeči. - Přihlaste se pomocí uživatele Microsoft 365, který má odesílat e-maily.
- Po zobrazení zprávy o úspěchu zavřete okno prohlížeče.
- Odešlete testovací oznámení.
Pokud chybí autorizace, služba vrátí chybu obsahující authorize_url. Otevřete tuto URL v prohlížeči a dokončete přihlášení.
Ověřte konfiguraci
Konfigurace delegovaného režimu je připravena, když:
- služba se spouští bez chyb konfigurace Microsoft 365
- registrace aplikace má delegované oprávnění Microsoft Graph
Mail.Send redirect_uriodpovídá URI přesměrování v Microsoft Entra ID- otevření
authorize_ms365se dokončí s úspěšnou zprávou
Šablony e-mailů
E-mailové šablony musí být uloženy v adresáři /Templates/Email/ v Knihovně.
E-mail MS365 podporuje přílohy. Služba je odesílá jako přílohy souborů Microsoft Graph.
Pro více informací o e-mailových oznámeních a šablonách viz:
Slack
Služba zasílání zpráv může odesílat oznámení do kanálů Slacku.
Používejte Slack, když by se oznámení z LogMan.io měla zobrazovat v týmovém kanálu, například pro provozní upozornění, aktualizace incidentů nebo sledovací zprávy.
Předpoklady
Než začnete nastavovat Slack, ujistěte se, že:
- přístup k pracovnímu prostoru Slack, kam budou odesílána oznámení, je dostupný
- povolení k vytvoření nebo instalaci aplikace Slack v tomto pracovním prostoru je dostupné
- aplikace Slack má požadované oprávnění tokenu bota
- aplikace Slack je pozvána do cílového veřejného kanálu
- server LogMan.io může komunikovat se Slackem přes HTTPS
- je dostupné bezpečné místo pro uložení OAuth tokenu uživatele bota Slack
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
token |
Přístupový token OAuth pro aplikaci Slack. |
channel |
Název kanálu Slack, kam služba posílá zprávy. |
Ukázka konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
slack:
token: "{{SLACK_TOKEN}}"
channel: "logman-alerts"
secrets:
SLACK_TOKEN: {}
Nastavení aplikace Slack
- Otevřete Slack API Apps.
- Klikněte na Vytvořit novou aplikaci.
- Vyberte Od začátku.
- Zadejte název aplikace, například
LogMan.io Notifications. - Vyberte Slack workspace.
- Klikněte na Vytvořit aplikaci.
- Otevřete OAuth & oprávnění.
- V sekci Rozsahy tokenu bota přidejte následující rozsahy:
| Rozsah | Proč je potřeba |
|---|---|
chat:write |
Umožňuje aplikaci Slack odesílat upozorňovací zprávy do nakonfigurovaného kanálu. |
channels:read |
Umožňuje službě vyhledat ID kanálu podle názvu veřejného kanálu. |
files:write |
Umožňuje aplikaci Slack nahrávat přílohy upozornění, pokud upozornění obsahuje soubory. |
- Klikněte na Nainstalovat do pracovního prostoru.
- Schvalte instalaci.
- Zkopírujte OAuth token uživatele bota. Obvykle začíná na
xoxb-.
Nastavení kanálu
- Otevřete Slack.
- Přejděte na kanál, kam by služba měla posílat oznámení.
- Pozvěte aplikaci Slack do kanálu.
- Použijte název kanálu v konfiguraci
channelslužby.
Nezahrnujte # do názvu kanálu. Například použijte logman-alerts, ne #logman-alerts.
Použít konfiguraci
- Uložte Slack token do Vaultu nebo do úložiště tajemství nasazení používaného instalací LogMan.io.
- Aktualizujte
/Site/model.yaml. - Aplikujte model z Knihovny, nebo spusťte příkaz pro aplikaci nasazení používaný instalací.
- Odešlete testovací Slack upozornění.
Ověřte konfiguraci
Konfigurace je připravena, když:
- služba se spouští bez chyb konfigurace Slacku
- aplikace Slack je nainstalována ve správném workspace
- aplikace Slack je přítomna v nakonfigurovaném veřejném kanálu
- testovací oznámení se zobrazí v nakonfigurovaném kanálu
- protokoly služby neobsahují chyby Slack API
Šablony Slack
Šablony oznámení Slack musí být uloženy v adresáři /Templates/Slack/ v knihovně.
Tělo zprávy může používat šablonové parametry, takže jedna šablona může být znovu použita pro různá oznámení.
Push oznámení
Služba zasílání zpráv může odesílat push notifikace prostřednictvím ntfy nebo na vlastním serveru kompatibilním s ntfy.
Používejte push notifikace, když by se měly notifikace LogMan.io zobrazit na přihlášených mobilních zařízeních, desktopových klientech, prohlížečích nebo u jiných odběratelů ntfy.
Předpoklady
Než nakonfigurujete push notifikace, ujistěte se, že:
- server ntfy je k dispozici, například
https://ntfy.shnebo vlastní hostovaný server ntfy - server LogMan.io může dosáhnout serveru ntfy přes HTTPS
- je k dispozici název tématu pro notifikace
- odběratelé jsou nastavena pro téma v mobilní aplikaci ntfy, desktopové aplikaci, webové aplikaci, CLI nebo jiném kompatibilním klientu
- název tématu není snadno uhodnutelný, pokud server ntfy umožňuje veřejná témata bez autentizace
- je k dispozici výchozí téma, pokud by požadavky na notifikace měly být povoleny bez uvedení
topic
Poznámka
Tato konfigurace používá publikování založené na tématech ntfy. Konfigurované téma je součástí doručovací adresy, takže název tématu musí odpovídat politice serveru ntfy.
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
url |
Base URL of the ntfy server, for example https://ntfy.sh. |
Nepovinná konfigurační pole
| Pole | Popis |
|---|---|
default_topic |
Téma použité, když požadavek na oznámení neposkytuje topic. |
timeout |
Časový limit požadavku HTTP v sekundách. Výchozí hodnota je 10. |
Ukázka konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
push:
url: "https://ntfy.sh"
default_topic: "logman-alerts"
timeout: 10
ntfy nastavení
- Vyberte ntfy server, který bude přijímat oznámení.
- Vyberte název tématu, například
logman-alerts. - Přihlaste požadovaná zařízení nebo klienty k tématu.
- Zkopírujte základní URL ntfy serveru do
push.url. - Nastavte
push.default_topic, pokud by oznámení měla používat výchozí téma. - Nastavte
push.timeout, pokud výchozí časový limit není vhodný pro nasazení. - Aktualizujte
/Site/model.yaml. - Aplikujte model z Knihovny nebo spusťte příkaz pro aplikaci nasazení používaný při instalaci.
- Odešlete testovací push oznámení.
Varování
Na veřejných serverech ntfy může kdokoli, kdo zná název tématu, být schopen se k tomuto tématu přihlásit. Použijte ne zřejmý název tématu, nebo použijte server ntfy hostovaný sami se zabezpečením přístupu podle potřeby nasazení.
Ověřte konfiguraci
Konfigurace je připravena, když:
- služba se spustí bez chyb konfigurace push notifikací
- server LogMan.io se může připojit ke konfigurovanému serveru ntfy
- testovací notifikace se zobrazí na klientovi přihlášeném k očekávanému tématu
- logy služby neobsahují chyby ntfy API ani sítě
Šablony push
Šablony push notifikací musí být uloženy v adresáři /Templates/Push/ v Knihovně.
Vzorový šablona:
TITLE: {{ severity }} notification
{{ message }}
Nepovinný řádek TITLE: se používá jako název oznámení a před odesláním je odstraněn z těla zprávy.
Příklad webového požadavku
{
"body": {
"template": "/Templates/Push/alert.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
Pokud není topic zadán, služba používá push.default_topic.
Příklad oznámení Kafka
Při odesílání přes Kafka nastavte type na push.
{
"type": "push",
"body": {
"template": "/Templates/Push/alert.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
Metadata oznámení
Push notifikace mohou obsahovat volitelné zobrazovací metadata v body.params.
| Parametr | Popis |
|---|---|
title |
Název oznámení. Přepisuje řádek TITLE: v šabloně. |
priority |
Priorita oznámení ntfy. |
tags |
štítky ntfy zobrazované kompatibilními klienty. |
click |
URL se otevře po kliknutí na oznámení. |
Příklad:
{
"topic": "logman-alerts",
"body": {
"template": "/Templates/Push/alert.md",
"params": {
"title": "High CPU",
"priority": "high",
"tags": "warning,monitoring",
"click": "https://grafana.example.com/d/abc123",
"message": "CPU usage above 90% on node ant-3"
}
}
}
Pokud click není poskytnut, služba použije první URL nalezenou v vykreslené zprávě, pokud nějaká existuje.
Mattermost
Služba zasílání zpráv může odesílat oznámení do Mattermostu.
Používejte Mattermost, když by se oznámení z LogMan.io měla objevit v kanálu Mattermost nebo být odeslána přímo uživateli Mattermost.
Upozornění Mattermost mohou být spouštěna službou přes HTTP nebo prostřednictvím upozornění Kafka.
Poznámka
Výstup Mattermost je k dispozici v nasazeních, která zahrnují podporu oznámení Mattermost.
Předpoklady
Než nakonfigurujete Mattermost, ujistěte se, že:
- je dostupný přístup k serveru Mattermost, kam budou zasílána oznámení
- je dostupný účet bota Mattermost pro posílání zpráv
- je dostupný přístupový token bota pro tento účet
- bot může posílat zprávy do cílového kanálu Mattermost
- je dostupné ID cílového kanálu pro výchozí kanál oznámení
- je dostupné uživatelské jméno bota, pokud má služba posílat přímé zprávy
- server LogMan.io se může připojit k serveru Mattermost přes HTTPS
- je dostupné bezpečné místo pro uložení tokenu bota Mattermost
Podporované destinace
Služba zasílání zpráv může odesílat oznámení Mattermost na:
- nakonfigurovaný výchozí kanál
- konkrétní ID kanálu Mattermost
- přímá zpráva s uživatelem Mattermost
Pro přímé zprávy musí služba znát uživatelské jméno účtu bota Mattermost a uživatelské jméno cílového uživatele.
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
url |
Základní URL serveru Mattermost. |
token |
Token bota používaný službou k volání API Mattermostu. |
security_channel_id |
Výchozí ID kanálu se používá, když oznámení neposkytuje channel_id nebo username. |
Nepovinná konfigurační pole
| Pole | Popis |
|---|---|
bot_username |
Uživatelské jméno účtu bota Mattermost. Vyžaduje se pro přímé zprávy. |
timeout |
Časový limit požadavku na Mattermost API v sekundách. Výchozí hodnota je 10. |
Vzor konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
mattermost:
url: "https://mattermost.example.com"
token: "{{MATTERMOST_TOKEN}}"
security_channel_id: "logman-alerts-channel-id"
bot_username: "logman-notifications"
timeout: 10
secrets:
MATTERMOST_TOKEN: {}
Nastavení Mattermost
- Vytvořte nebo vyberte účet bota Mattermost pro službu.
- Vytvořte přístupový token pro tohoto bota.
- Zkopírujte token do
mattermost.token. - Zkopírujte URL serveru Mattermost do
mattermost.url, napříkladhttps://mattermost.example.com. - Zkopírujte ID výchozího kanálu a nastavte ho jako
mattermost.security_channel_id. - Pokud by služba měla posílat přímé zprávy, nastavte
mattermost.bot_usernamena uživatelské jméno účtu bota. - Volitelně nastavte
mattermost.timeoutna časový limit požadavku Mattermost API v sekundách. Výchozí hodnota je10. - Uložte token Mattermost do Vault nebo do úložiště tajemství používaného při instalaci LogMan.io.
- Aktualizujte
/Site/model.yaml. - Aplikujte model z Knihovny, nebo spusťte příkaz pro aplikaci nasazení používaný při instalaci.
- Odešlete testovací notifikaci Mattermost.
Poznámka
security_channel_id je ID kanálu v Mattermostu, nikoli zobrazované jméno.
Použijte ID kanálu z administrace Mattermostu nebo z informací o kanálu v Mattermostu.
Ověřte konfiguraci
Konfigurace je připravena, když:
- služba startuje bez chyb konfigurace Mattermostu
- token bota patří očekávanému účtu bota Mattermost
- testovací oznámení se zobrazí v nastaveném výchozím kanálu nebo v požadovaném kanálu
- soukromé zprávy jsou doručeny, pokud je použit způsob doručení pomocí
username - protokoly služby neobsahují chyby API Mattermostu
Odesílání do výchozího kanálu
Pokud je nakonfigurováno security_channel_id, mohou oznámení vynechat cíl a služba je odešle do výchozího kanálu.
{
"body": {
"template": "/Templates/Mattermost/message.md",
"params": {
"name": "LogMan.io",
"severity": "High",
"message": "New security notification"
}
}
}
Odesílání do konkrétního kanálu
Nastavte channel_id pro odeslání oznámení do konkrétního kanálu Mattermost.
{
"channel_id": "logman-alerts-channel-id",
"body": {
"template": "/Templates/Mattermost/message.md",
"params": {
"name": "LogMan.io",
"severity": "High",
"message": "New security notification"
}
}
}
Odesílání přímé zprávy
Nastavte username pro odeslání přímé zprávy uživateli Mattermostu.
{
"username": "alice",
"body": {
"template": "/Templates/Mattermost/message.md",
"params": {
"name": "Alice",
"severity": "High",
"message": "New security notification"
}
}
}
Varování
Neposkytujte zároveň channel_id a username ve stejné notifikaci.
Použijte channel_id pro zprávu do kanálu nebo username pro přímou zprávu.
Vlastnosti Mattermost
Upozornění Mattermost mohou zahrnovat volitelné props v těle zprávy. Použijte props, když integrace Mattermost používá strukturované metadata zpráv nebo přílohy.
Řetězcové hodnoty uvnitř props mohou používat stejné šablonové parametry jako obsah zprávy.
{
"channel_id": "logman-alerts-channel-id",
"body": {
"template": "/Templates/Mattermost/message.md",
"params": {
"severity": "High",
"event_code": "HIP_Sentinel_Fail"
},
"props": {
"attachments": [
{
"color": "#d9534f",
"title": "{{ severity }} notification",
"text": "Event code: {{ event_code }}"
}
]
}
}
}
Šablony Mattermost
Šablony Mattermost musí být uloženy v adresáři /Templates/Mattermost/ v Knihovně.
Vzorový šablona:
**{{ severity }} notification**
{{ message }}
Příklad oznámení Kafka
Při odesílání přes Kafka nastavte type na mattermost.
{
"type": "mattermost",
"channel_id": "logman-alerts-channel-id",
"body": {
"template": "/Templates/Mattermost/message.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
Microsoft Teams
Služba zasílání zpráv může odesílat oznámení do Microsoft Teams pomocí adresy URL webhooku Teams.
Používejte Microsoft Teams, když by se oznámení z LogMan.io měla zobrazit v kanálu Teams, například pro provozní upozornění, aktualizace incidentů nebo sledovací zprávy.
Služba vykreslí nakonfigurovanou šablonu a odešle vykreslenou zprávu do Microsoft Teams jako Adaptive Card.
Předpoklady
Než nakonfigurujete Microsoft Teams, ujistěte se, že:
- přístup k týmu a kanálu Microsoft Teams, kam budou odesílána oznámení, je k dispozici
- oprávnění k vytvoření nebo konfiguraci webhooku Teams pro tento kanál je k dispozici
- URL webhooku Teams je k dispozici
- server LogMan.io může dosáhnout URL webhooku přes HTTPS
- je k dispozici bezpečné místo pro uložení URL webhooku, pokud nasazení považuje tento údaj za tajný
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
webhook_url |
URL webhooku Microsoft Teams. |
Vzor konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
msteams:
webhook_url: "{{MSTEAMS_WEBHOOK_URL}}"
Nastavení Microsoft Teams
- Otevřete Microsoft Teams.
- Přejděte do týmu a kanálu, kam má služba posílat oznámení.
- Vytvořte schválený koncový bod webhook pro kanál. V závislosti na zásadách tenantů to může být konektor Incoming Webhook nebo workflow v Teams, které přijímá požadavky na webhook.
- Zkopírujte vygenerovanou URL webhooku.
- Uložte URL webhooku do Vaultu nebo do úložiště tajemství nasazení používaného instalací LogMan.io.
- Aktualizujte
/Site/model.yaml. - Použijte model z Knihovny, nebo spusťte příkaz pro aplikaci nasazení používaný instalací.
- Odešlete testovací oznámení Microsoft Teams.
Poznámka
Přesné umístění nastavení webhooku závisí na zásadách nájemce Microsoft Teams a konfiguraci kanálu. Microsoft přesouvá scénáře konektorů Microsoft 365 směrem k pracovním postupům Teams. Pokud příchozí webhooky nejsou k dispozici, požádejte správce Microsoft 365, aby poskytl schválenou URL adresu webhooku pracovního postupu Teams.
Ověřte konfiguraci
Konfigurace je připravena, když:
- služba se spouští bez konfiguračních chyb Microsoft Teams
- URL webhooku patří očekávanému kanálu Teams nebo workflow
- v nakonfigurovaném kanálu se zobrazí testovací oznámení
- v protokolech služby se nevyskytují chyby webhooku Microsoft Teams
Šablony Microsoft Teams
Šablony Microsoft Teams musí být uloženy v adresáři /Templates/MSTeams/ v Knihovně.
Vzorový šablona:
**{{ severity }} notification**
{{ message }}
Příklad webového požadavku
{
"body": {
"template": "/Templates/MSTeams/alert.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
Příklad oznámení Kafka
Při odesílání přes Kafka nastavte type na msteams.
{
"type": "msteams",
"body": {
"template": "/Templates/MSTeams/alert.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
SMS
Služba zasílání zpráv může odesílat SMS upozornění pomocí SMSBrána SMS Connect.
Používejte SMS, když musí oznámení LogMan.io dorazit na telefonní číslo mimo e-mail nebo chatovací nástroje, například pro vysoce prioritní operační upozornění.
Služba vykreslí nakonfigurovanou SMS šablonu, normalizuje text zprávy a odešle ji do nakonfigurovaného SMS API.
Předpoklady
Než začnete nastavovat SMS, ujistěte se, že:
- účet SMSBrána s povolenou službou SMS Connect je k dispozici
- jsou k dispozici přihlašovací údaje a heslo k SMSBrána
- server LogMan.io může přes HTTPS dosáhnout SMS API
- účet SMSBrána má dostatek kreditu pro odesílání zpráv
- je známé telefonní číslo příjemce, buď z požadavku na oznámení, nebo konfigurace nájemce
- SMSBrána umožňuje požadavky z IP adresy serveru LogMan.io, pokud jsou povolena IP omezení
- je k dispozici bezpečné místo pro ukládání hesla SMSBrána
Požadovaná konfigurační pole
| Pole | Popis |
|---|---|
login |
Přihlášení do SMSBrány. |
password |
Heslo SMSBrána. |
api_url |
URL API SMS Connect SMSBrána. |
Vzor konfigurace
Upravte soubor model.yaml pro konfiguraci služby asab-iris:
define:
type: rc/model
services:
asab-iris:
instances:
- node1
asab:
config:
sms:
login: "{{SMSBRANA_LOGIN}}"
password: "{{SMSBRANA_PASSWORD}}"
api_url: "https://api.smsbrana.cz/smsconnect/http.php"
secrets:
SMSBRANA_LOGIN: {}
SMSBRANA_PASSWORD: {}
Nastavení SMSBrány
- Otevřete administraci SMSBrána.
- Povolit SMS Connect pro účet, který bude služba používat.
- Zkopírujte přihlašovací údaje SMSBrána do
sms.login. - Uložte heslo SMSBrána do Vaultu nebo do úložiště tajemství používaného instalací LogMan.io.
- Potvrďte URL API SMS Connect. Výchozí je
https://api.smsbrana.cz/smsconnect/http.php. - Pokud SMSBrána omezuje API volání podle IP adresy, povolte IP adresu serveru LogMan.io.
- Potvrďte, že účet má dostatek kreditu.
- Aktualizujte
/Site/model.yaml. - Použijte model z Knihovny, nebo spusťte příkaz pro aplikaci nasazení používaný instalací.
- Odešlete testovací SMS notifikaci.
Ověřte konfiguraci
Konfigurace je připravena, když:
- služba startuje bez chyb konfigurace SMS
- SMSBrána přijímá API požadavek
- testovací SMS je doručena na očekávané telefonní číslo
- logy služby neobsahují chyby autentizace ani doručení SMSBrána
- dlouhé zprávy jsou doručovány jako číslované části SMS, pokud zpráva přesáhne délku jednoho SMS segmentu
Šablony SMS
Šablony SMS musí být uloženy ve složce /Templates/SMS/ v Knihovně.
Vzorový šablona:
{{ severity }}: {{ message }}
Držte šablony SMS krátké a používejte pouze text ASCII. Služba odmítá SMS zprávy, které obsahují znaky mimo ASCII.
Příklad webového požadavku
{
"phone": "+420123456789",
"body": {
"template": "/Templates/SMS/alert.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
Příklad oznámení Kafka
Při odesílání přes Kafka nastavte type na sms.
{
"type": "sms",
"phone": "+420123456789",
"body": {
"template": "/Templates/SMS/alert.md",
"params": {
"severity": "High",
"message": "New security notification"
}
}
}
Délka zprávy
Služba rozděluje dlouhé SMS zprávy na části:
- první část může obsahovat až 160 znaků
- následující části mohou obsahovat až 153 znaků
- každá část je opatřena číslováním, například
1/2
SMSBrána odmítá zprávy, které jsou delší než její povolené limity. Udržujte text upozornění krátký a výstižný.
Konfigurace
Branding
Zákaznicky specifikovaný branding může být nastaven v aplikaci LogMan.io WebUI.
Statický branding
Příklad:
let ConfigDefaults = {
title: "App Title",
brand_image: {
full: "media/logo/header-full.svg",
minimized: "media/logo/header-minimized.svg",
}
};
Dynamický branding
Branding lze nakonfigurovat pomocí dynamického nastavení.
Dynamická konfigurace je injektována pomocí ngx_http_sub_module, jelikož nahrazuje předdefinovaný obsah souboru index.html (v našem případě).
Více o ngx_http_sub_module
Existují 3 možnosti pro dynamický branding - logo v záhlaví, název a vlastní CSS styly.
Logo v záhlaví
Pro nahrazení výchozího loga v záhlaví musí nginx sub_filter konfigurace dodržovat pravidla nahrazení <meta name="header-logo-full"> a <meta name="header-logo-minimized"> s konkrétním name. Nahrazení musí mít vlastnost content, jinak obsah nahrazení nebude propagován. content musí obsahovat řetězec s cestou k logu.
Velikost obrázků pro branding lze nalézt zde
Full
Příklad importu loga v plné velikosti (když není postranní panel aplikace sbalený)
sub_filter '<meta name="header-logo-full">' '<meta name="header-logo-full" content="/<location>/<path>/<to>/<custom_branding>/<logo-full>.svg">';
Minimalizované
Příklad importu loga v minimalizované velikosti (když je postranní panel aplikace sbalený)
sub_filter '<meta name="header-logo-minimized">' '<meta name="header-logo-minimized" content="/<location>/<path>/<to>/<custom_branding>/<logo-minimized>.svg">';
Název
Příklad nahrazení názvu aplikace, konfigurace musí dodržovat pravidla nahrazení <meta name="title"> s konkrétním name. Nahrazení musí mít vlastnost content, jinak obsah nahrazení nebude propagován. content musí obsahovat řetězec s názvem aplikace.
sub_filter '<meta name="title">' '<meta name="title" content="Custom app title">';
Vlastní CSS styly
Příklad importu vlastních CSS stylů, konfigurace musí dodržovat pravidla nahrazení <meta name="custom-css-file"> s konkrétním name. Nahrazení musí mít vlastnost content, jinak obsah nahrazení nebude propagován. content musí obsahovat řetězec s cestou k souboru CSS.
sub_filter '<meta name="custom-css-file">' '<meta name="custom-css-file" content="/<location>/<path>/<to>/<custom_branding>/<custom-file>.css">';
Příklad vlastního CSS souboru
.card .card-header-login .card-header-title h2 {
color: violet !important;
}
.text-primary {
color: yellowgreen !important;
}
Definujte cestu nginx k obsahu dynamického brandingu
Aby bylo možné určit umístění dynamického (vlastního) obsahu brandingu, musí být definováno v nastavení nginx.
# Path to location (directory) with the custom content
location /<location>/<path>/<to>/<custom_branding> {
alias /<path>/<to>/<custom_branding>;
}
Kompletní příklad
Kompletní příklad konfigurace nginxu s vlastním brandingem
...
location /<location> {
root /<path>/<to>/<build>;
index index.html;
sub_filter '<meta name="header-logo-full">' '<meta name="header-logo-full" content="/<location>/<path>/<to>/<custom_branding>/<logo-full>.svg">';
sub_filter '<meta name="header-logo-minimized">' '<meta name="header-logo-minimized" content="/<location>/<path>/<to>/<custom_branding>/<logo-minimized>.svg">';
sub_filter '<meta name="title">' '<meta name="title" content="Custom app title">';
sub_filter '<meta name="custom-css-file">' '<meta name="custom-css-file" content="/<location>/<path>/<to>/<custom_branding>/<custom-file>.css">';
sub_filter_once on;
}
# Path to location (directory) with the custom content
location /<location>/<path>/<to>/<custom_branding> {
alias /<path>/<to>/<custom_branding>;
}
...
Průvodce styly
Každý obrázek MUSÍ být poskytován ve formátu SVG (vektorizovaný). Použití pixelových formátů (PNG, JPG, ...) je silně odrazováno. Při tvorbě obrázků pro branding používejte celou šířku/výšku plátna (poměr 3:1 na plnou verzi a 1:1 na minimalizovanou verzi). Pro optimální zobrazení není vyžadováno žádné odsazení.
Obrázky pro branding
formát: SVG
Plné:
* vykreslený poměr: 3:1
* vykreslená velikost: 150x50 px
Minimalizované:
* vykreslený poměr: 1:1
* vykreslená velikost: 50x50 px
Branding je umístěn v levém horním rohu na velkých obrazovkách. Plný obrázek brandingu je použit, když není postranní panel sbalený a je nahrazen minimalizovanou verzí při sbalení. Na menších obrazovkách (<768px) branding v postranním panelu zmizí a objeví se pouze plný obrázek brandingu ve středové horní části stránky.
Logo by mělo být vhodné pro použití v obou režimech - světlém i tmavém.
Logo postranního panelu je vždy umístěno ve spodní části postranního panelu. Minimalizovaná verze se objeví při sbalení postranního panelu.
Plné:
* vykreslená velikost: 90x30 px
Minimalizované:
* vykreslená velikost: 30x30 px
Poznámka: Plný obrázek je také používán na úvodní obrazovce, 30% šířky obrazovky.
Discover Configuration

Nastavení obrazovky Discover
Obrazovka Discover se používá k zobrazení a prozkoumání dat (nejen) v ElasticSearch.
Konfigurace obrazovky Discover může být načtena z Knihovny nebo ze statického souboru ve složce public stejným způsobem, jako je tomu v případě Dashboards.
Typ filtrovaných dat závisí na specifikaci, která musí být definována spolu s datetimeField. Tyto hodnoty jsou zásadní, bez nichž není možné filtrování.
Konfigurace Discover
Konfigurace Knihovny
Konfigurace Knihovny je uložena v uzlu Knihovny. Musí být typu JSON.
Aby bylo možné získat konfiguraci z Knihovny, musí být služba asab_config spuštěna s konfigurací ukazující na hlavní uzel Knihovny. Pro více informací se prosím odkažte zde: http://gitlab.teskalabs.int/lmio/asab-config
Konfigurace z Knihovny je editovatelná.
V uzlu Knihovny Discover může být více konfiguračních souborů, přičemž v každém z nich může být nastavena pouze jedna obrazovka konfigurace Discover. Další obrazovka Discover musí být nakonfigurována v novém uzlu konfigurace Knihovny.
Všechny konfigurační soubory z uzlu Knihovny Discover jsou načteny v jednom API volání.
Struktura konfigurace Knihovny
Struktura konfigurace v Knihovně
- main Library node
- config
- Discover
- **config**.json
- type
- Discover.json
- schema
- config je název konkrétní konfigurace Discover, musí být typu
json.
V Knihovně vypadá cesta k souboru s konfigurací takto:
/<hlavní uzel Knihovny>/config/Discover/<discoverConfig>.json
Cesta ke schématu bude následující:
/<hlavní uzel Knihovny>/type/Discover.json
Příklad výše popsané struktury Knihovny pro případ více konfiguračních souborů Discover:
- logman
- config
- Discover
- declarative.json
- default.json
- speed.json
- type
- Discover.json
DŮLEŽITÁ POZNÁMKA
Schéma (type) a konfigurační soubor (config) musí být nastaveny v Knihovně, jinak nebude Discover načteno správně.
Všechny konfigurační soubory z uzlu Knihovny Discover jsou načteny v jednom API volání.
Příklad konfigurace:
{
"Discover:datasource": {
"specification": "declarative*",
"datetimeField": "@timestamp",
"type": "elasticsearch"
}
}
Kde
- klíč objektu slouží k pojmenování objektu. Musí být pojmenován jako
Discover:datasource. - type je typ vyhledávacího enginu
- specification je url s vzorem indexu ElasticSearch. Pokud byste chtěli hledat všechna data, musí url končit hvězdičkou
*. Toto je povinný parametr. - datetimeField je index datumu a času položky. Je to povinný parametr, protože je potřebný pro vyhledávání/procházení s ElasticSearch.
Schéma (volitelné nastavení)
Nedoměňujte s schématem Knihovny
Nastavte název pro získání schématu z knihovny (pokud je přítomno), které je pak aplikováno na hodnoty definované v rámci schématu. Se schématem můžeme aplikovat akce na hodnoty odpovídající definovanému type, např. použitím komponenty DateTime z ASAB-WebUI pro časové hodnoty.
{
...
"Discover:schema": {
"name": "ECS"
}
...
}
Příklad struktury schémat v knihovně:
- library
- Schemas
- Discover.yaml
- ECS.yaml
...
Příklad schématu v knihovně:
---
define:
name: Elastic Common Schema
type: common/schema
description: https://www.elastic.co/guide/en/ecs/current/index.html
fields:
'@timestamp':
type: datetime
label: "Datetime"
unit: seconds
docs: https://www.elastic.co/guide/en/ecs/current/ecs-base.html#field-timestamp
Autorizace (volitelné nastavení)
Konfigurace Discover může být omezena na přístup pouze s konkrétními nájemci. To znamená, že uživatelé bez konkrétních nájemců nemohou přistupovat k konfiguraci Discover s jejím zdrojem dat. To je výhodné např. když chce administrátor omezit přístup k konfiguraci Discover s citlivými daty na konkrétní skupiny uživatelů.
Pokud je konfigurace nastavena přímo v Knihovně (a ne prostřednictvím nástroje pro konfiguraci), doporučuje se přidat sekci Autorizace a nechat klíč tenants jako prázdný řetězec (pokud není omezení vyžadováno). To pomůže udržet stejnou strukturu konfigurace napříč konfiguracemi Discover:
{
...
"Authorization": {
"tenants": ""
}
...
}
Příklad nastavení Autorizace v rámci konfigurace, kde je vyžadován omezený přístup:
{
...
"Authorization": {
"tenants": "tenant one, tenant two"
}
...
}
Kde klíč tenants slouží k zobrazení a používání konfigurace pouze konkrétními nájemci. Může být specifikováno více nájemců, oddělených čárkou. Typ klíče tenants je string.
Nastavení výzev (volitelné nastavení)
Sekce nastavení výzev poskytuje další možnost nastavit výzvu Discover nebo změnit její výchozí hodnoty.
Příklad sekce Discover:prompts v rámci konfigurace:
{
...
"Discover:prompts": {
"dateRangePicker:datetimeStart": "now-15m",
"dateRangePicker:datetimeEnd": "now+15s"
...
},
...
}
Nastavení vlastních období datumu a času
Někdy je žádoucí nastavit vlastní období datumu a času pro zobrazení dat, protože data leží např. mimo výchozí období nastavené pro Discover. Výchozí období je now-1H, což by mělo hledat data v rozmezí now a 1 hodina zpět. Například, to by mohlo být nastaveno v Discover:prompts následujícím způsobem:
{
...
"Discover:prompts": {
"dateRangePicker:datetimeStart": "now-1H",
"dateRangePicker:datetimeEnd": "now"
},
...
}
Kde dateRangePicker:datetimeStart a dateRangePicker:datetimeEnd jsou období, která nastavují rozsah na počáteční období (počáteční) a na koncové období (konečné).
Možnosti nastavení pro obě období jsou:
- now-
ns - now-
nm - now-
nH - now-
nd - now-
nw - now-
nM - now-
nY - now
- now+
ns - now+
nm - now+
nH - now+
nd - now+
nw - now+
nM - now+
nY
Kde
- n je číslo, např. 2,
- s označuje sekundy,
- m označuje minuty,
- H označuje hodiny,
- d označuje dny,
- w označuje týdny,
- M označuje měsíce,
- Y označuje roky.
Ostatní hodnoty budou ignorovány.
Je možné např. nastavit pouze jedno období, jak je v tomto příkladu, druhé období zůstane výchozí:
{
...
"Discover:prompts": {
"dateRangePicker:datetimeStart": "now-2H"
},
...
}
Další příklad nastavení rozsahu datumu a času, kde jsou data zobrazena 15 hodin do minulosti a hledána 10 minut do budoucnosti:
{
...
"Discover:prompts": {
"dateRangePicker:datetimeStart": "now-15H",
"dateRangePicker:datetimeEnd": "now+10m"
},
...
}
Schéma Knihovny
Pro manuální nastavení obrazovky Discover v Knihovně musí být schéma Discover nastavena ve validním JSON formátu.
Schéma musí být poskytnuto a uloženo v /<hlavní uzel Knihovny>/type/<discoverType>.json
Schéma může vypadat takto:
{
"$id": "Discover schema",
"type": "object",
"title": "Discover schema",
"description": "The Discover schema",
"default": {},
"examples": [
{
"Discover:datasource": {
"specification": "declarative*",
"datetimeField": "@timestamp",
"type": "elasticsearch"
}
}
],
"required": [],
"properties": {
"Discover:datasource": {
"type": "string",
"title": "Discover source",
"description": "The data specification for Discover screen",
"default": {},
"examples": [
{
"specification": "declarative*",
"datetimeField": "@timestamp",
"type": "elasticsearch"
}
],
"required": [
"specification",
"datetimeField",
"type"
],
"properties": {
"specification": {
"type": "string",
"title": "Specification",
"description": "Specify the source of the data",
"default": "",
"examples": [
"declarative*"
]
},
"datetimeField": {
"type": "string",
"title": "Datetime",
"description": "Specify the datetime value for data source",
"default": "",
"examples": [
"@timestamp"
]
},
"type": {
"type": "string",
"title": "Type",
"description": "Select the type of the source",
"default": [
"elasticsearch",
"sentinel"
],
"$defs": {
"select": {
"type": "select"
}
},
"examples": [
"elasticsearch*"
]
}
}
},
"Discover:prompts": {
"type": "string",
"title": "Discover prompts",
"description": "Update Discover prompt configuration",
"default": {},
"examples": [],
"required": [],
"properties": {
"dateRangePicker:datetimeStart": {
"type": "string",
"title": "Starting date time period",
"description": "Setup the prompt's starting date time period",
"default": "now-1H",
"examples": [
"now-1H"
]
},
"dateRangePicker:datetimeEnd": {
"type": "string",
"title": "Ending date time period",
"description": "Setup the prompt's ending date time period",
"default": "now",
"examples": [
"now"
]
}
}
},
"Discover:schema": {
"type": "string",
"title": "Discover schema name",
"description": "Apply schema over discover values",
"default": {},
"properties": {
"name": {
"type": "string",
"title": "Schema name",
"description": "Set up the schema name for configuration (without file extension)",
"default": ""
}
}
},
"Authorization": {
"type": "string",
"title": "Discover authorization",
"description": "Limit access to discover configuration by tenant settings",
"default": {},
"examples": [],
"required": [],
"properties": {
"tenants": {
"type": "string",
"title": "Tenants",
"description": "Specify the tenant(s) separated by comma to restrict the usage of this configuration (optional)",
"default": "",
"examples": [
"tenant1, tenant2"
]
}
}
}
},
"additionalProperties": false
}
Příklad předávání vlastností konfigurace
Příklad předávání vlastností konfigurace do DiscoverContainer:
...
this.App.Router.addRoute({
path: "/discover",
exact: true,
name: 'Discover',
component: DiscoverContainer,
props: {
type: "Discover"
}
});
...
this.App.Navigation.addItem({
name: "Discover",
url: "/discover",
icon: 'cil-compass'
});
Při používání DiscoverContainer jako komponenty ve vašem kontejneru mohou být vlastnosti předány následujícím způsobem:
<DiscoverContainer type="Discover" />
Statický konfigurační soubor aplikace zůstává prázdný:
module.exports = {
app: {
},
webpackDevServer: {
port: 3000,
proxy: {
'/api/elasticsearch': {
target: "http://es-url:9200",
pathRewrite: {'^/api/elasticsearch': ''}
},
'/api/asab_print': {
target: "http://asab_print-url:8083",
pathRewrite: {'^/api/asab_print': ''}
},
'/api/asab_config': {
target: "http://asab_config-url:8082",
pathRewrite: {'^/api/asab_config': ''}
}
}
}
}
Statická konfigurace
Obrazovka Discover nemusí být získána pouze z Knihovny. Další možností je nakonfigurovat ji přímo v souboru JSON a uložit ji do složky public projektu.
Příklad statické konfigurace
V index.js musí vývojář specifikovat:
JSON soubor s konfigurací může být uložen kdekoli ve složce public, ale silně se doporučuje uložit jej do složky /public/discover/, aby se odlišil od ostatních veřejně přístupných komponent.
- Struktura konfigurace ve složce
public
- public
- discover
- JSON config file
- dashboards
- locales
- media
- index.html
- manifest.json
URL statické konfigurace uložené ve složce public může vypadat takto:
https://my-project-url/discover/Discover-config.json
Příklad Discover-config.json:
[
{
"Config name 1": {
"Declarative": {
"specification": "declarative*",
"datetimeField": "last_inform",
"type": "elasticsearch"
}
}
},
{
"Config name 2": {
"Default": {
"specification": "default*",
"datetimeField": "@timestamp",
"type": "elasticsearch"
}
}
}
]
Příklad předávání vlastností konfigurace
Předávání vlastností konfigurace do aplikace:
this.App.Router.addRoute({
path: "/discover",
exact: true,
name: 'Discover',
component: DiscoverContainer,
props: {
type: "https://my-project-url/discover/Discover-config.json"
}
});
this.App.Navigation.addItem({
name: "Discover",
url: "/discover",
icon: 'cil-compass'
});
Při používání DiscoverContainer jako komponenty ve vašem kontejneru mohou být vlastnosti předány následujícím způsobem:
<DiscoverContainer type="https://my-project-url/discover/Discover-config.json" />
Statický konfigurační soubor aplikace zůstává prázdný:
module.exports = {
app: {
},
webpackDevServer: {
port: 3000,
proxy: {
'/api/elasticsearch': {
target: "http://es-url:9200",
pathRewrite: {'^/api/elasticsearch': ''}
},
'/api/asab_print': {
target: "http://asab_print-url:8083",
pathRewrite: {'^/api/asab_print': ''}
},
'/api/asab_config': {
target: "http://asab_config-url:8082",
pathRewrite: {'^/api/asab_config': ''}
}
}
}
}
path: "/discover",
exact: true,
name: 'Discover',
component: DiscoverContainer,
props: {
type: "https://my-project-url/discover/Discover-config.json"
}
});
this.App.Navigation.addItem({ name: "Discover", url: "/discover", icon: 'cil-compass' });
Při používání `DiscoverContainer` jako komponenty ve vašem kontejneru mohou být vlastnosti předány následujícím způsobem:
Statický konfigurační soubor aplikace zůstává prázdný:
```javascript
module.exports = {
app: {
},
webpackDevServer: {
port: 3000,
proxy: {
'/api/elasticsearch': {
target: "http://es-url:9200",
pathRewrite: {'^/api/elasticsearch': ''}
},
'/api/asab_print': {
target: "http://asab_print-url:8083",
pathRewrite: {'^/api/asab_print': ''}
},
'/api/asab_config': {
target: "http://asab_config-url:8082",
pathRewrite: {'^/api/asab_config': ''}
}
}
}
}
Jazykové lokalizace
WebUI LogMan.io poskytuje možnost přizpůsobení jazykových lokalizací. Používá knihovnu pro internalizaci i18n. Pro podrobnosti se podívejte na: https://react.i18next.com
Import a nastavení vlastní lokalizace
WebUI LogMan.io umožňuje předefinovat texty aplikačních komponent a zpráv pro každou sekci aplikace. Jazykové lokalizace jsou uloženy v JSON souborech nazvaných translate.json.
Vlastní lokalizace mohou být nahrány do aplikace WebUI LogMan.io prostřednictvím konfiguračního souboru.
Soubory jsou nahrávány například z externí složky obsluhované nginx, kde mohou být uloženy vedle CSS stylování a další konfigurace webu.
Příklad definice ve statickém konfiguračním souboru WebUI LogMan.io:
module.exports = {
app: {
i18n: {
fallbackLng: 'en',
supportedLngs: ['en', 'cs'],
debug: false,
backend: {
{% raw %}loadPath: 'path/to/external_folder/locales/{{lng}}/{{ns}}.json',{% endraw %}
{% raw %}addPath: 'path/to/external_folder/locales/add/{{lng}}/{{ns}}',{% endraw %}
}
}
}
}
Kde
* fallbackLng je náhradní jazyk
* supportedLngs jsou podporované jazyky
* debug pokud je nastaveno na true, zobrazuje ladicí zprávy v konzoli prohlížeče
* backend je backend plugin pro načítání zdrojů ze serveru
Cesta path/to/external_folder/ je cesta k externí složce s lokální složkou locales, kterou zpracovává nginx. Tam musejí být dvě složky odkazující na podporované jazyky. Tyto složky jsou en a cs, ve kterých jsou uloženy soubory translate.json, jak lze vidět v níže uvedené struktuře složek:
* external_folder
* locales
* cs
* translation.json
* en
* translation.json
Příklad vlastního souboru translate.json
en
{
"i18n": {
"language": {
"en": "English",
"cs": "Česky"
}
},
"LogConsole": {
"Connection lost": "Connection lost, will reconnect ...",
"Mark": "Mark",
"Clear": "Clear"
},
...
}
cs
{
"i18n": {
"language": {
"en": "English",
"cs": "Česky"
}
},
"LogConsole": {
"Connection lost": "Spojení ztraceno, připojuji se ...",
"Mark": "Označit",
"Clear": "Smazat"
},
...
}
Dashboardy
Configuration overview
---
title: Konfigurace dashboardu a widgetů
---
# Konfigurace dashboardu a widgetů

## Nastavení dashboardu
Pro úpravu rozložení nebo konfigurace dashboardu musí mít uživatel přiřazený prostředek `dashboards:admin`.
### Ruční nastavení dashboardu z knihovny
#### Konfigurace knihovny
Konfigurace knihovny je uložena v uzlu Knihovny. Musí být typu JSON.
Aby bylo možné získat konfiguraci z knihovny, musí běžet služba `asab_library` s konfigurací ukazující na hlavní uzel knihovny.
Konfigurace z knihovny je editovatelná - pozice a velikost widgetů mohou být uloženy do knihovny přímo z BS-WebUI.
##### Nastavení dashboardu s konfigurací z knihovny
- Konfigurační soubory dashboardů musí být uloženy v uzlu `dashboard/Dashboards` knihovny podle následující struktury.
- **konfigurační soubor knihovny** (`config`), který definuje váš uzel knihovny s konfigurací v uzlu Knihovny Dashboardů. Název `config` je také **název dashboardu zobrazeného v postranním panelu** aplikace. Je to povinný parametr.
- **DŮLEŽITÁ POZNÁMKA** - konfigurační soubor MUSÍ mít příponu `.json`, jinak nebude možné zobrazit konfigurační soubor v modulu `Knihovna` a tím spustit funkce jako `Upravit` nebo `Zakázat`.
Struktura konfigurace v knihovně
library)
- Dashboards
- config.json
Kde
- \*\*hlavní uzel knihovny\*\* by měl být obvykle pojmenován jako `library`
- \*\*config\*\* je název konkrétní konfigurace dashboardu, např. `My Dashboard.json`
V knihovně vypadá cesta k konfiguračnímu souboru takto:
`/<hlavní uzel knihovny>/Dashboards/<dashboardConfig>.json`
Podívejte se na [příklad](./configuration-example.md) konfigurace dashboardu.
## Konfigurace dashboardu
### Zdroje dat
Primárně se používá pro nastavení zdroje dat pro widgety. Může být neomezený počet zdrojů dat.
Příklad nastavení zdroje dat
"Dashboard:datasource:elastic": {
"type": "elasticsearch", // Zdroj dat
"datetimeField": "@timestamp", // Typ datumu a času
"specification": "es-pattern*" // Indexový vzor nebo vzor URL
},
...
}
Pokročilé nastavení Elasticsearch
{
...
"Dashboard:datasource:elastic": {
// Základní nastavení
"type": "elasticsearch",
"datetimeField": "@timestamp",
"specification": "es-pattern*",
// Pokročilé nastavení
"sortData": "asc", // Řadit data "asc" nebo "desc" během zpracování (volitelné)
// Pokročilé nastavení elasticsearch
"size": 100, // Max velikost hitů v odpovědi (výchozí 20) (volitelné)
"aggregateResult": true, // Pouze pro grafy (ne PieChart) - požádá ES o agregované hodnoty (volitelné)
"groupBy": "user.id", // Pouze pro grafy - požádá ES o agregaci podle termínu definovaného v klíči "groupBy" (volitelné)
"matchPhrase": "event.dataset: microsoft-office-365" // Pro výchozí zobrazení konkrétního shody zdroje dat
},
...
} ```
Propojení zdroje dat s widgetem
Pokud není zdroj dat přiřazen k widgetu, žádná data nejsou zpracovávána pro zobrazení ve widgetu. ``` { ...
"Dashboard:widget:somewidget": {
"datasource": "Dashboard:datasource:elastic",
...
},
...
} ```
Výzvy
Sekce nastavení výzev poskytuje další možnosti pro nastavení výzvy dashboardu nebo změnu jejích výchozích hodnot. Použití v konfiguračním souboru: ``` { ...
"Dashboard:prompts": {
"dateRangePicker": true, // Povolit výzvu pro výběr datového rozsahu
"filterInput": true, // Povolit výzvu pro vstup filtru
"submitButton": true // Povolit výzvu pro tlačítko odeslat
},
...
} ```
Nastavení vlastních časových období
Někdy je žádoucí nastavit vlastní časové období pro zobrazení dat, protože data leží např. mimo výchozí období nastavené pro dashboard. Výchozí období je now-1H, které by mělo hledat data v rozmezí now a 1 hodina zpět. Například to může být nastaveno v Dashboard:prompts následujícím způsobem:
```
{
...
"Dashboard:prompts": {
...
"dateRangePicker": true,
"dateRangePicker:datetimeStart": "now-1H",
"dateRangePicker:datetimeEnd": "now",
...
},
...
}
Kde `dateRangePicker:datetimeStart` a `dateRangePicker:datetimeEnd` jsou období, které nastavují rozsah na **počáteční období** (počáteční) a na **koncové období** (konečné).
Možnosti nastavení pro obě období jsou:
- now-`n`s
- now-`n`m
- now-`n`H
- now-`n`d
- now-`n`w
- now-`n`M
- now-`n`Y
- now
- now+`n`s
- now+`n`m
- now+`n`H
- now+`n`d
- now+`n`w
- now+`n`M
- now+`n`Y
Kde
- `n` je číslo, např. 2,
- `s` označuje sekundy,
- `m` označuje minuty,
- `H` označuje hodiny,
- `d` označuje dny,
- `w` označuje týdny,
- `M` označuje měsíce,
- `Y` označuje roky
Ostatní hodnoty budou ignorovány.
Je možné například nastavit pouze jedno období, jak je uvedeno v tomto příkladu, druhé období zůstane výchozí:
{
...
"Dashobard:prompts": {
...
"dateRangePicker": true,
"dateRangePicker:datetimeStart": "now-1H",
...
},
...
}
Další příklad nastavení časového rozsahu, kde jsou data zobrazena 15 hodin zpět a hledána 10 minut do budoucnosti:
{
...
"Dashboard:prompts": {
...
"dateRangePicker": true,
"dateRangePicker:datetimeStart": "now-15H",
"dateRangePicker:datetimeEnd": "now+10m",
...
},
...
} ```
Systém mřížky (volitelné nastavení)
Mřížka může být nakonfigurována unikátně pro různé dashboardy. Tímto způsobem může být konfigurace mřížky implementována do konfigurace dashboardu, jak je vidět v příkladu. Pokud není v konfiguraci specifikováno, použije se výchozí nastavení mřížky. ``` { ...
"Dashboard:grid": {
"preventCollision": false // Pokud je nastaveno na true, zabrání kolizím widgetů na mřížce
},
"Dashboard:grid:breakpoints": {
"lg": 1200,
"md": 996,
"sm": 768,
"xs": 480,
"xxs": 0
},
"Dashboard:grid:cols": {
"lg": 12,
"md": 10,
"sm": 6,
"xs": 4,
"xxs": 2
},
...
} ``` Výše uvedené nastavení je také výchozím nastavením dashboardu.
Autorizace / Zakázání konfigurace
Dashboard může být omezen na přístup pouze pro konkrétní nájemce. To znamená, že uživatelé bez konkrétního nájemce nemohou přistupovat k dashboardu. To je výhodné např. když chce administrátor omezit přístup k dashboardům se citlivými daty na konkrétní skupiny uživatelů.
Pro zakázání konfigurace pro konkrétního nájemce se musí uživatel navigovat do sekce Knihovna aplikace a Zakázat konkrétní soubor kliknutím na přepínač v souboru.
Zakázaný název souboru konkrétní konfigurace dashboardu bude poté přidán do souboru .disabled.yaml s dotčenými nájemci v uzlu Knihovny.
Zlidnění
Komponenta používaná pro převod číselných hodnot do lidsky čitelné formy.
Zobrazuje hodnoty v lidsky čitelné formě, jako:
0.000001 => 1 µ
0.00001 => 10 µ
0.0001 => 100 µ
0.001 => 1 m
0.01 => 10 m
0.1 => 100 m
1 => 1
10 => 10
100 => 100
1000 => 1 k
10000 => 10 k
100000 => 100 k
1000000 => 1 M
atd.
Může být použit pro widgety hodnot a více hodnot.
Aby byla komponenta Humanize povolena ve widgetu, musí být nastavena
- "humanize": true v konfiguraci widgetu
- "base": <number> definuje základ pro převod (přepočet), volitelný parametr, výchozí je 1000
- "decimals": <number> definuje, kolik desetinných míst by měla zobrazit, volitelný parametr
- "displayUnits": true zobrazuje prefix (tj. µ, m, k, M, G) jednotek, volitelný parametr, výchozí false
- "units": <string> zobrazuje uživatelsky definovaný příponu jednotek (např. B, Hz, ...)
displayUnits a units budou spojeny ve widgetu a výsledek může vypadat jako MHz, kde M je prefix a Hz je uživatelsky definovaná přípona
```
{
...
"Dashboard:widget:valuewidget": {
...
"humanize": true,
"base": 1024,
"decimals": 3,
"displayUnits": true,
"units": "B",
...
},
...
} ```
Nápověda (volitelné nastavení)
Nápověda může být přidána pro jakýkoli widget kromě widgetu Nástroje. Tímto způsobem bude nápověda vložena jako tooltip vedle názvu widgetu.
Po přidání nápovědy se v záhlaví widgetu objeví ikona s informacemi (vedle názvu). Po najetí myší na ikonu se zobrazí vložená nápověda.
Nápověda může být pouze typu string.
Příklad, jak přidat nápovědu:
```
{
...
"Dashboard:widget:somewidget": {
...
"hint": "Nějaká nápověda",
...
},
...
} ```
Rozložení widgetu
Velikost a pozice widgetu na mřížce mohou být definovány pro každý widget v konfiguraci. Pokud není nastaveno, má widget své předdefinované hodnoty pro rozložení a pozici a bude vykreslen odpovídajícím způsobem.
Widgety mohou být přesouvány a měněny v rámci mřížky prostřednictvím Nastavení dashboardu >> Upravit. To je k dispozici pro uživatele s prostředkem dashboards:admin.
Příklad základních nastavení rozložení:
```
{
...
"Dashboard:widget:somewidget": {
...
// Základní nastavení
"layout:w": 4, // Šířka widgetu v jednotkách mřížky
"layout:h": 2, // Výška widgetu v jednotkách mřížky
"layout:x": 0, // Pozice widgetu na ose x v jednotkách mřížky
"layout:y": 0, // Pozice widgetu na ose y v jednotkách mřížky
// Vlastní nastavení (volitelné)
"layout:minW": 2, // Minimální šířka widgetu
"layout:minH": 2, // Minimální výška widgetu
"layout:maxW": 6, // Maximální šířka widgetu
"layout:maxH": 6, // Maximální výška widgetu
...
},
...
}
Příklad pokročilých nastavení rozložení:
{
...
"Dashboard:widget:somewidget": {
...
// Pokročilé nastavení (volitelné)
"layout:isBounded": false, // Pokud je true a je možné táhnout, položka bude přesunuta pouze v rámci mřížky
"layout:resizeHandles": ?Array<'s' | 'w' | 'e' | 'n' | 'sw' | 'nw' | 'se' | 'ne'> = ['se'], // Ve výchozím nastavení je úchytka zobrazena pouze v pravém dolním rohu
"layout:static": ?boolean = false, // Opravit widget na statické pozici (nelze přesunout ani změnit velikost). Pokud je true, rovno `isDraggable: false, isResizable: false`
"layout:isDraggable": ?boolean = true, // Pokud je false, nebude možné widget táhnout. Přepíše `static`
"layout:isResizable": ?boolean = true, // Pokud je false, nebude možné widget měnit velikost. Přepíše `static`
...
},
...
} ```
Widgety
Příklad widgetu v konfiguračním souboru: ``` { ...
"Dashboard:widget:somewidget": {
"datasource": "Dashboard:datasource:elastic",
"type": "Value",
"field": "some.variable",
"title": "Nějaký název",
"layout:w": 2,
"layout:h": 1,
"layout:x": 0,
"layout:y": 1
},
...
} ```
Widget s hodnotou
Běžně se používá k zobrazení jedné hodnoty, i když může také zobrazit datetime a filtrovaný widget hodnoty najednou. ``` { ...
"Dashboard:widget:valuewidget": {
// Základní nastavení
"datasource": "Dashboard:datasource:elastic",
"type": "Value", // Typ widgetu
"field": "some.variable", // Pole (hodnota) zobrazené ve widgetu
"title": "Nějaký název", // Název widgetu
// Pokročilé nastavení (volitelné)
"onlyDateResult": true, // Zobrazit pouze datum s časem
"units": "GB", // Jednotky hodnoty pole
"displayWidgetDateTime": true, // Zobrazit datum a čas ve widgetu pod hodnotou
"hint": "Nějaká nápověda", // Zobrazit nápovědu widgetu
// Zlidnění hodnoty (může být použito k transformaci hodnot do čitelné formy pro člověka, např. bajty na GB) (volitelné)
"humanize": true, // Povolit komponentu Humanize
"base": 1024, // Základ pro přepočet hodnoty pro komponentu Humanize
"decimals": 3, // Zaokrouhlit hodnotu na n číslic v komponentě Humanize
"displayUnits": true, // Zobrazit prefix jednotky velikosti (např. k, M, T,...) v komponentě Humanize
// Nastavení rozložení
"layout:w": 2,
"layout:h": 1,
"layout:x": 0,
"layout
Příklad konfigurace dashboardu
Příklad:
{
"Dashboard:datasource:elastic": {
"type": "elasticsearch",
"datetimeField": "@timestamp",
"specification": "default-events*"
},
"Dashboard:datasource:elastic-aggregation": {
"type": "elasticsearch",
"datetimeField": "@timestamp",
"specification": "default-events*",
"aggregateResult": true
},
"Dashboard:datasource:elastic-size100": {
"type": "elasticsearch",
"datetimeField": "@timestamp",
"specification": "default-events*",
"size": 100
},
"Dashboard:datasource:elastic-stacked": {
"type": "elasticsearch",
"datetimeField": "@timestamp",
"specification": "default-events*",
"groupBy": [
"sender.address",
"recipient.address"
],
"matchPhrase": "event.dataset:microsoft-office-365",
"size": 50,
"stackSize": 100
},
"Dashboard:grid": {
"preventCollision": false
},
"Dashboard:grid:breakpoints": {
"lg": 1200,
"md": 996,
"sm": 768,
"xs": 480,
"xxs": 0
},
"Dashboard:grid:cols": {
"lg": 12,
"md": 10,
"sm": 6,
"xs": 4,
"xxs": 2
},
"Dashboard:prompts": {
"dateRangePicker": true,
"dateRangePicker:datetimeStart": "now-15H",
"dateRangePicker:datetimeEnd": "now+10s",
"filterInput": true,
"submitButton": true
},
"Dashboard:widget:table": {
"datasource": "Dashboard:datasource:elastic-size100",
"field:1": "@timestamp",
"field:2": "event.dataset",
"field:3": "host.hostname",
"title": "Table",
"type": "Table",
"layout:w": 6,
"layout:h": 4,
"layout:x": 0,
"layout:y": 9,
"layout:minW": 2,
"layout:minH": 3
},
"Dashboard:widget:hostname": {
"datasource": "Dashboard:datasource:elastic",
"field": "host.hostname",
"title": "Hostname",
"type": "Value",
"layout:w": 2,
"layout:h": 1,
"layout:x": 10,
"layout:y": 12
},
"Dashboard:widget:lastboot": {
"datasource": "Dashboard:datasource:elastic",
"field": "@timestamp",
"units": "ts",
"title": "Last boot",
"type": "Value",
"layout:w": 2,
"layout:h": 1,
"layout:x": 8,
"layout:y": 12,
"layout:minH": 1
},
"Dashboard:widget:justdate": {
"datasource": "Dashboard:datasource:elastic",
"field": "@timestamp",
"onlyDateResult": true,
"title": "Just date",
"type": "Value",
"layout:w": 4,
"layout:h": 2,
"layout:x": 8,
"layout:y": 9
},
"Dashboard:widget:displaytenant": {
"datasource": "Dashboard:datasource:elastic",
"field": "tenant",
"title": "Tenant",
"type": "Value",
"layout:w": 2,
"layout:h": 2,
"layout:x": 6,
"layout:y": 9
},
"Dashboard:widget:baraggregationchart": {
"datasource": "Dashboard:datasource:elastic-aggregation",
"title": "Request body bytes aggregation",
"type": "BarChart",
"xaxis": "@timestamp",
"yaxis": "http.request.body.bytes",
"yaxisDomain": [
"auto",
0
],
"ylabel": "bytes",
"layout:w": 6,
"layout:h": 3,
"layout:x": 0,
"layout:y": 6,
"layout:minW": 4,
"layout:minH": 3,
"layout:isBounded": true
},
"Dashboard:widget:barchart": {
"datasource": "Dashboard:datasource:elastic",
"title": "Request body bytes",
"type": "BarChart",
"hint": "Some hint",
"width": "95%",
"xaxis": "@timestamp",
"yaxis": "http.request.body.bytes",
"ylabel": "bytes",
"layout:w": 6,
"layout:h": 3,
"layout:x": 6,
"layout:y": 6
},
"Dashboard:widget:scatterchart": {
"datasource": "Dashboard:datasource:elastic-size100",
"title": "Request body bytes scatter size 100",
"type": "ScatterChart",
"xaxis": "@timestamp",
"xlabel": "datetime",
"yaxis": "http.request.body.bytes",
"ylabel": "http.request.body.bytes",
"layout:w": 6,
"layout:h": 3,
"layout:x": 6,
"layout:y": 0,
"layout:minH": 2,
"layout:maxH": 6
},
"Dashboard:widget:scatteraggregationchart": {
"datasource": "Dashboard:datasource:elastic-aggregation",
"title": "Request body bytes scatter aggregation",
"type": "ScatterChart",
"xaxis": "@timestamp",
"yaxis": "http.request.body.bytes",
"xlabel": "datetime",
"ylabel": "count",
"layout:w": 6,
"layout:h": 3,
"layout:x": 0,
"layout:y": 0
},
"Dashboard:widget:areachart": {
"datasource": "Dashboard:datasource:elastic",
"height": "100%",
"title": "Request body bytes area",
"type": "AreaChart",
"width": "95%",
"xaxis": "@timestamp",
"yaxis": "http.request.body.bytes",
"ylabel": "area bytes",
"layout:w": 6,
"layout:h": 3,
"layout:x": 6,
"layout:y": 3,
"layout:minH": 2,
"layout:maxH": 6,
"layout:resizeHandles": [
"sw"
]
},
"Dashboard:widget:areaaggregationchart": {
"datasource": "Dashboard:datasource:elastic-aggregation",
"title": "Request body bytes area aggregation",
"type": "AreaChart",
"xaxis": "@timestamp",
"xlabel": "datetime",
"yaxis": "http.request.body.bytes",
"ylabel": "count",
"layout:w": 6,
"layout:h": 3,
"layout:x": 0,
"layout:y": 3
},
"Dashboard:widget:multiplevalwidget": {
"datasource": "Dashboard:datasource:elastic",
"type": "MultipleValue",
"title": "Multiple values",
"field:1": "event.dataset",
"field:2": "http.response.status_code",
"field:3": "url.orignal",
"layout:w": 2,
"layout:h": 2,
"layout:x": 6,
"layout:y": 11
},
"Dashboard:widget:statusindicatorwidget": {
"datasource": "Dashboard:datasource:elastic",
"type": "StatusIndicator",
"title": "Bytes exceedance",
"field": "http.request.body.bytes",
"units": "bytes",
"lowerBound": 20000,
"upperBound": 40000,
"lowerBoundColor": "#a9f75f",
"betweenBoundColor": "#ffc433",
"upperBoundColor": "#C70039 ",
"nodataBoundColor": "#cfcfcf",
"layout:w": 2,
"layout:h": 1,
"layout:x": 10,
"layout:y": 11
},
"Dashboard:widget:toolswidget": {
"type": "Tools",
"title": "Grafana",
"redirectUrl": "http://www.grafana.com",
"image": "tools/grafana.svg",
"layout:w": 2,
"layout:h": 1,
"layout:x": 8,
"layout:y": 11
},
"Dashboard:widget:flowchart": {
"title": "Gantt chart",
"type": "FlowChart",
"content": "gantt\ntitle A Gantt Diagram\ndateFormat YYYY-MM-DD\nsection Section\nA task:a1, 2014-01-01, 30d\nAnother task:after a1,20d\nsection Another\nTask in sec:2014-01-12,12d\nanother task: 24d",
"layout:w": 12,
"layout:h": 2,
"layout:x": 0,
"layout:y": 13
},
"Dashboard:widget:markdown": {
"title": "Markdown description",
"type": "Markdown",
"description": "## Markdown content",
"layout:w": 12,
"layout:h": 2,
"layout:x": 0,
"layout:y": 15
},
"Dashboard:widget:barchart-stacked": {
"datasource": "Dashboard:datasource:elastic-stacked",
"title": "Grouped sender X recipient address",
"type": "StackedBarChart",
"xlabel": "Sender x Recipient",
"ylabel": "Count",
"layout:w": 12,
"layout:h": 4,
"layout:x": 0,
"layout:y": 17
}
}
Office 365 přehledový panel
Příklad:
{
"Dashboard:prompts": {
"dateRangePicker": true,
"filterInput": true,
"submitButton": true
},
"Dashboard:datasource:elastic-office365-userid": {
"datetimeField": "@timestamp",
"groupBy": "user.id",
"matchPhrase": "event.dataset:microsoft-office-365",
"specification": "lmio-default-events*",
"type": "elasticsearch",
"size": 100
},
"Dashboard:datasource:elastic-office365-clientip": {
"datetimeField": "@timestamp",
"groupBy": "client.ip",
"matchPhrase": "event.dataset:microsoft-office-365",
"specification": "lmio-default-events*",
"type": "elasticsearch",
"size": 100
},
"Dashboard:datasource:elastic-office365-activity": {
"datetimeField": "@timestamp",
"groupBy": "o365.audit.Workload",
"matchPhrase": "event.dataset:microsoft-office-365",
"specification": "lmio-default-events*",
"type": "elasticsearch",
"size": 100
},
"Dashboard:datasource:elastic-office365-actions": {
"datetimeField": "@timestamp",
"groupBy": "event.action",
"matchPhrase": "event.dataset:microsoft-office-365",
"specification": "lmio-default-events*",
"type": "elasticsearch",
"size": 50
},
"Dashboard:widget:piechart": {
"datasource": "Dashboard:datasource:elastic-office365-clientip",
"title": "Client IP",
"type": "PieChart",
"table": true,
"layout:w": 6,
"layout:h": 4,
"layout:x": 6,
"layout:y": 0
},
"Dashboard:widget:piechart2": {
"datasource": "Dashboard:datasource:elastic-office365-userid",
"title": "User ID's",
"type": "PieChart",
"useGradientColors": true,
"table": true,
"tooltip": true,
"layout:w": 6,
"layout:h": 4,
"layout:x": 0,
"layout:y": 0
},
"Dashboard:widget:piechart3": {
"datasource": "Dashboard:datasource:elastic-office365-activity",
"title": "Activity by apps",
"type": "PieChart",
"table": true,
"tooltip": true,
"layout:w": 6,
"layout:h": 4,
"layout:x": 6,
"layout:y": 4
},
"Dashboard:widget:barchart": {
"datasource": "Dashboard:datasource:elastic-office365-actions",
"title": "Actions",
"type": "BarChart",
"table": true,
"xaxis": "event.action",
"xlabel": "Actions",
"ylabel": "Count",
"layout:w": 6,
"layout:h": 4,
"layout:x": 0,
"layout:y": 4
}
}
Katalog widgetů
Podrobnější pohled na nastavení widgetů.
Pro nastavení Dashboardu a widgetů naleznete informace zde.
Hodnotové widgety
Použití hodnotových widgetů je vhodné, když je potřeba zobrazit data v textové formě.
Widget jedné hodnoty
Slouží k zobrazení pouze jedné hodnoty.
Hodnota může být typu: string, boolean, number.
Jedna hodnota může zobrazovat pouze datum (převést např. unix timestamp na lidsky čitelné datum), pokud je to potřeba.
Widget více hodnot
Slouží k zobrazení n hodnot v jednom widgetu.
Kromě zobrazení n hodnot v jednom widgetu obsahuje widget více hodnot stejné funkce jako widget jedné hodnoty.
Hodnoty mohou být typu: string, boolean, number.
Widget indikátoru stavu
Widget indikátoru stavu zobrazuje číselnou hodnotu a barevnou indikaci na základě definovaných hranic.
Hodnota může být typu: number.
Tabulkový widget
Tabulkový widget může zobrazovat více hodnot v tabulkové formě.
Hodnoty mohou být typu: string, boolean, number.
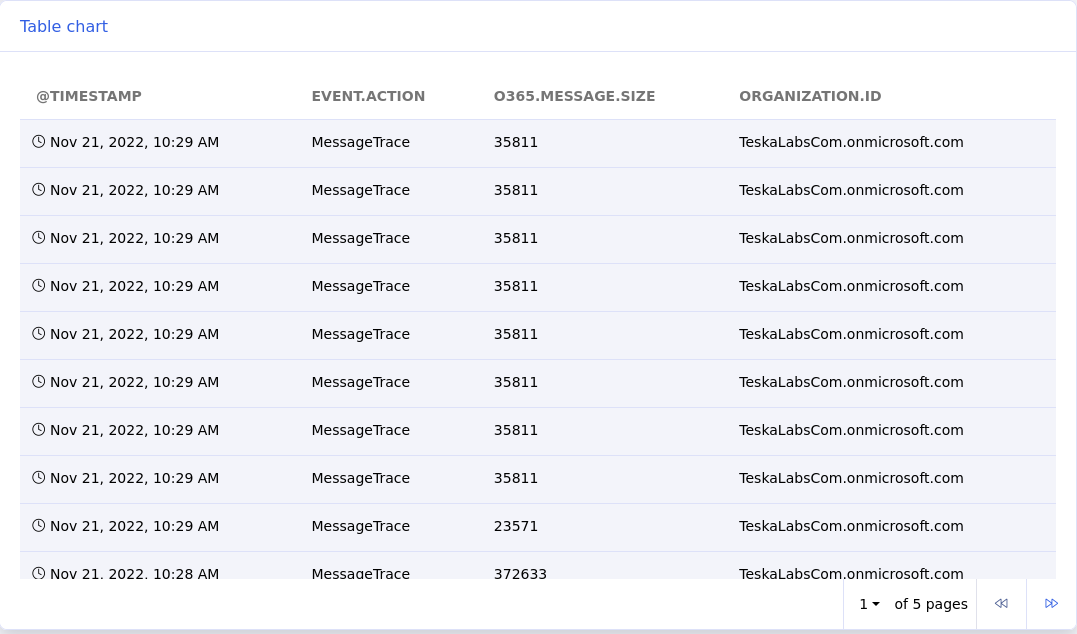
Tool widgety
Tool widgety slouží jako "tlačítko", které po kliknutí otevře novou kartu v prohlížeči s odkazem (URL adresou) specifikovaným v konfiguraci widgetu. Obrázky pro tool widget mohou být nahrané přímo do složky public aplikace nebo načtené jako base64 řetězec obrázku.
Grafické widgety
Použití grafických widgetů je vhodné, když je potřeba zobrazit data v grafické formě.
Recharts je použita jako knihovna pro vykreslování dat ve formě grafu.
Widget sloupcového grafu
Widget sloupcového grafu má 4 typy zobrazení dat:
Widget sloupcového grafu s ukázkovými daty
Zobrazení dat na základě určitého klíče na časové ose.

Widget sloupcového grafu s agregovanými daty
Zobrazení počtu dat na základě určitého klíče na časové ose.
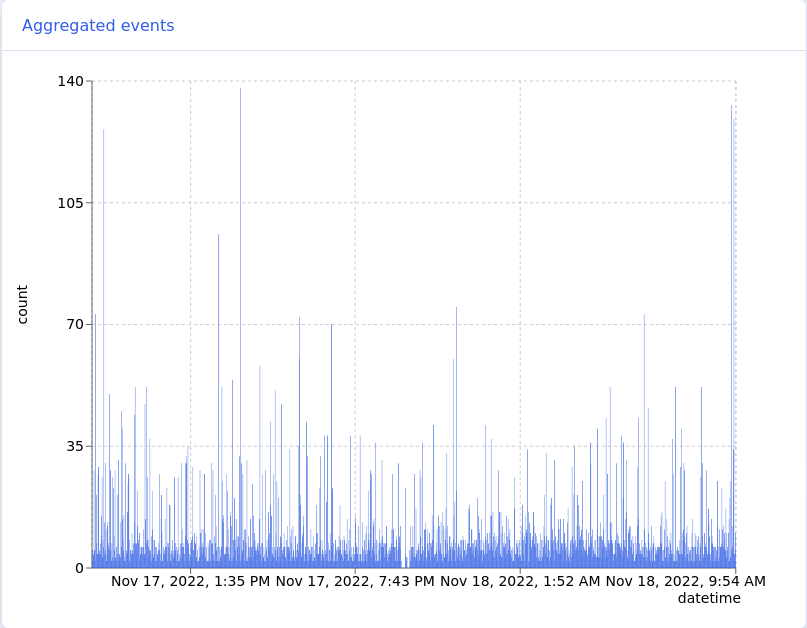
Widget sloupcového grafu s seskupenými daty
Zobrazení dat na základě klíče podle celkového počtu.
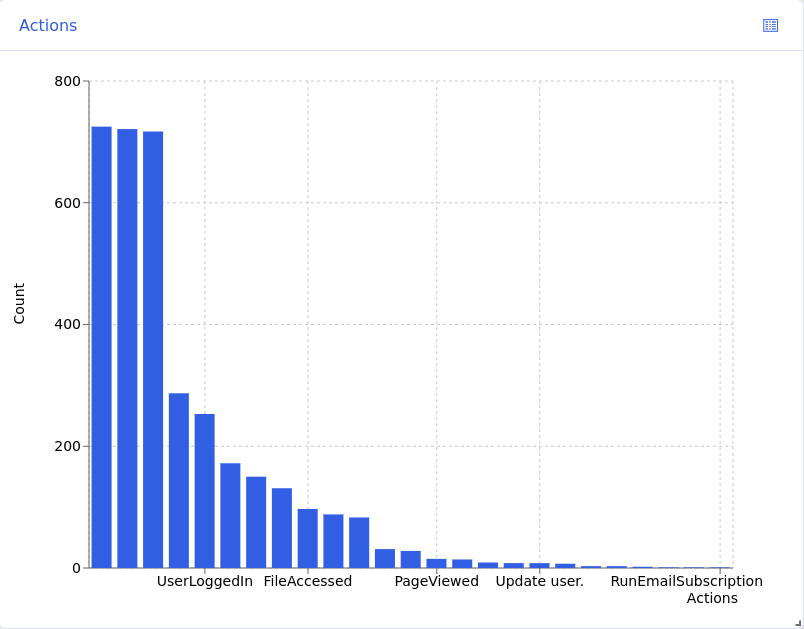
Widget sloupcového grafu s tabulkou dat
Zobrazení dat grafu v tabulce. Tuto funkci lze povolit v nastavení grafu a aktivujte ji kliknutím na tlačítko v pravém horním rohu widgetu.
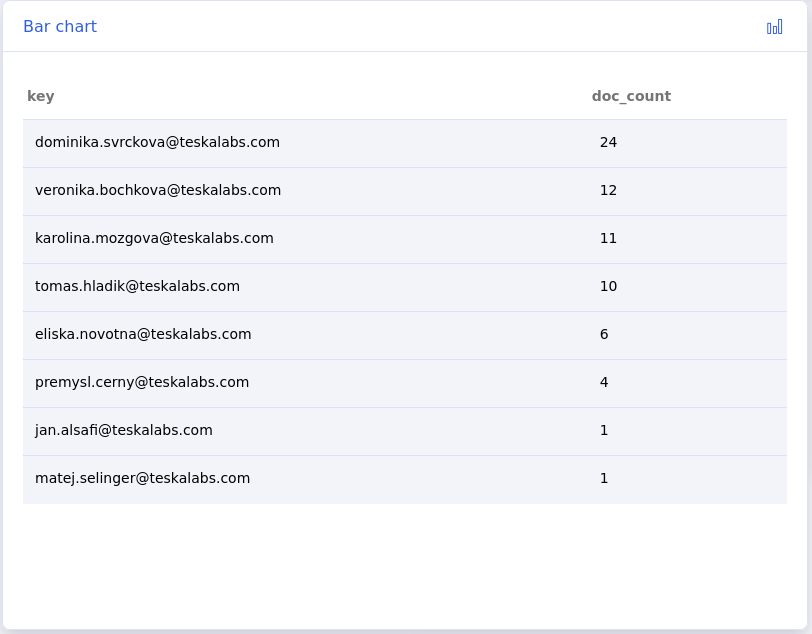
Widget plošného grafu
Obsahuje stejné funkce jako widget sloupcového grafu, ale zobrazuje data ve formě plochy.
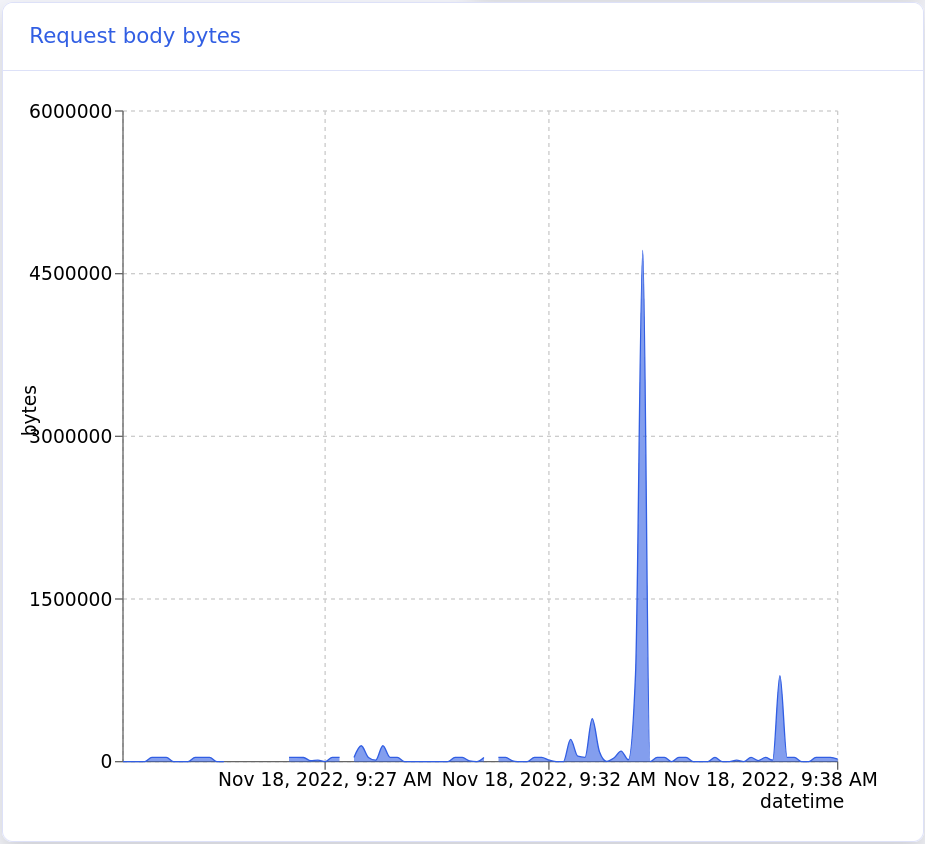
Widget bodového grafu
Obsahuje stejné funkce jako widget sloupcového grafu, ale zobrazuje data ve formě bodů.

Widget výsečového grafu
Widget výsečového grafu zobrazuje pouze seskupená data ve formě výsečového grafu a tabulky.
Widget výsečového grafu s gradientními barvami
V tomto příkladu se nástroj zobrazí pro zobrazení podrobných informací o konkrétní části (nástroj není zobrazen na tomto obrázku).
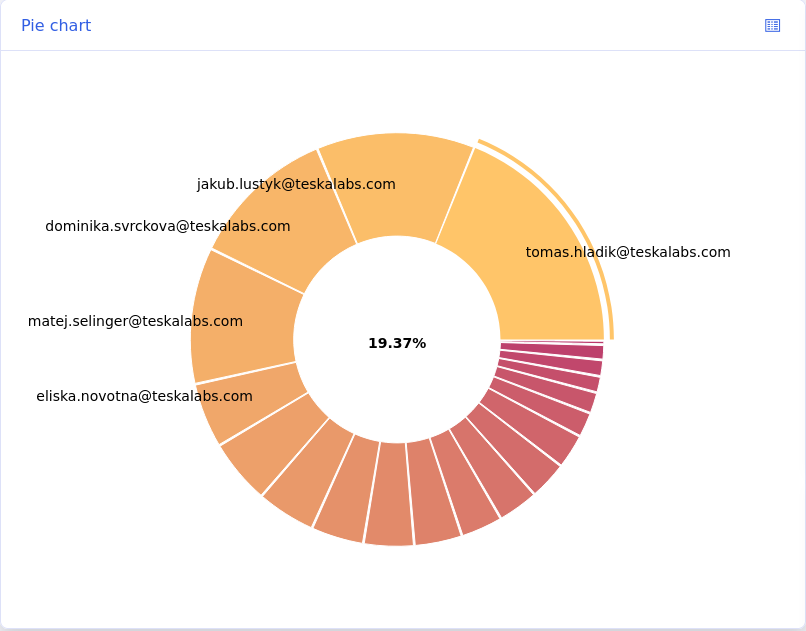
Widget výsečového grafu s více barvami
V tomto příkladu je nástroj nahrazen indikací aktivní části v levém horním rohu widgetu.
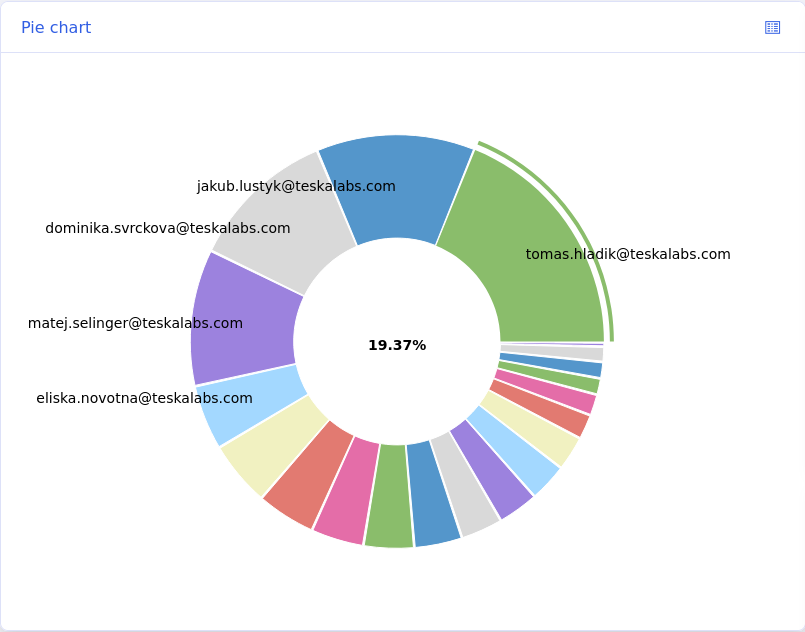
Widget blokového schématu
Mermaid je použitá jako knihovna pro vykreslování blokových schémat.
Mermaid playground lze najít zde.
Maestro
ASAB Maestro
ASAB Maestro je technologie pro správu clusteru.
Je zodpovědná za:
- Instalaci a aktualizaci TeskaLabs LogMan.io
- Správu služeb clusteru
- Monitorování clusteru
ASAB Maestro byl vyvinut k překonání výzev spojených s pracně intenzivní ruční konfigurací clusterů.
Přináší několik výhod:
- Rychlá instalace TeskaLabs LogMan.io
- Snížení lidských chyb
- Konzistence napříč všemi nasazovacími místy
- Monitorování všech vrstev - hardware, kontejnerizace, aplikace
- Snadné aktualizace TeskaLabs LogMan.io
Přehled funkčnosti ASAB Maestro
Automatizace
TeskaLabs LogMan.io a naše další aplikace jsou obvykle nasazovány on-premises do zákaznických prostředí, označovaných jako míst. ASAB Maestro zajišťuje konzistentní a rychlé nasazování napříč více místy díky rozsáhlé automatizaci. Podpůrné týmy mohou obsluhovat více zákazníků za použití méně zdrojů, protože automatizace je činí vysoce efektivními a všechna místa mají jednotné nastavení.
Systém zaručuje konzistentní konfigurace napříč všemi aplikacemi, technologiemi clusteru (jako Apache Kafka a Elasticsearch) a API bránou (NGINX). ASAB Maestro také zjednodušuje nasazování webových aplikací do clusteru a spravuje nasazování obsahu, jako jsou databázová schémata, počáteční plnění dat a další.
Správa clusteru
Správa služeb clusteru je prováděna z TeskaLabs LogMan.io Web UI.
ASAB Maestro vynucuje globální verzi, což představuje komprehenzivní verzi vydání, která určuje verze všech nasazených komponent a potvrzuje jejich kompatibilitu. Výsledkem je snadný postup aktualizace, když je vydána nová verze produktu.
Monitorování
ASAB Maestro zahrnuje také centralizované monitorování clusteru. Toto monitorování zahrnuje logování a telemetrii ze všech komponent, které běží v clusteru.
Hlavní komponenty ASAB Maestro

Diagram: Příklad 5 uzlového clusteru spravovaného ASAB Maestro.
Kontejnerizace
Pod povrchem, ASAB Maestro využívá Docker a konkrétně Docker Compose k správě kontejnerů. Alternativně je kompatibilní i s Podman, což poskytuje další flexibilitu a bezpečnost.
ASAB Maestro jde nad rámec schopností Docker Compose bez složitostí a režijních nákladů, které mohou přicházet se systémy jako Kubernetes.
ASAB Remote Control
ASAB Remote Control (asab-remote-control) je mikroslužba, která je zodpovědná za centrální správu clusteru. Musí běžet alespoň v jedné instanci v clusteru. Doporučené nastavení jsou tři instance, vedle každé instance ZooKeeper.
ASAB Governator
ASAB Governator (asab-governator) je mikroslužba, která lokálně interaguje s Docker technologií. ASAB Governator musí běžet na každém uzlu clusteru. ASAB Governator se připojuje k ASAB Remote Control.
Knihovna ASAB Maestro
Knihovna ASAB Maestro je open-source repozitář spravovaný TeskaLabs s popisem mikroslužeb, které mohou být spuštěny v clusteru. Knihovna se nachází na github.com/TeskaLabs/asab-maestro-library.
Poznámka: Další knihovny mohou být přidány na vrch ASAB Maestro Knihovny pro rozšíření sady spravovaných mikroslužeb v clusteru.
Terminologie
Cluster
Cluster je množina počítačových uzlů, které spolupracují za účelem dosažení vysoké dostupnosti a odolnosti proti chybám, fungující jako jediný systém. Uzly v clusteru mohou hostovat služby a zdroje, které jsou mezi nimi rozděleny. Klustrování je běžný přístup používaný k zlepšení výkonu, dostupnosti a škálovatelnosti softwarových aplikací a služeb.
Clustery mohou být geograficky rozmístěny napříč různými datovými centry, cloudovými poskytovateli, regiony nebo dokonce kontinenty. Toto geografické rozložení pomáhá snížit latenci, zvýšit redundantnost a zajistit lokalitu dat pro zlepšenou výkonnost aplikací a uživatelské zkušenosti.
Jednotlivý cluster se nazývá lokalita (site) a je identifikován pomocí site_id.
Node
Node slouží jako základní stavební jednotka clusteru, představující buď fyzický nebo virtuální stroj (server), který běží na Linuxu a podporuje konteinerizaci pomocí Dockeru nebo Podmanu.
Každému uzlu v clusteru je přiřazen jedinečný identifikátor, node_id. Tento node_id nejen rozlišuje každý uzel, ale také slouží jako název hostitele (hostname) uzlu, což usnadňuje síťovou komunikaci a správu uzlu v rámci clusteru.
Uzel je spravován mikroslužbou ASAB Governator.
Tip
node_id se vždy překládá na IP adresu uzlu v každém místě clusteru.
Core node
Core node přispívá k sdílenému konsenzu clusteru. Tento konsenzus je zásadní pro udržení integrity, konzistence a synchronizace dat a operací napříč clusterem.
Core node jsou klíčové pro dosažení konsenzu, což je proces, který zajišťuje, že všechny uzly v clusteru se shodují na stavu dat a pořadí transakcí. Tato dohoda je zásadní pro Data Integrity, Pořadí Transakcí a Odolnost proti Chybám.
Obvykle jsou první tři uzly přidané do clusteru označeny jako core uzly. Tento počet je zvolen pro dosažení rovnováhy mezi potřebou redundantnosti a snahou vyhnout se režii spojené s koordinací velkého počtu uzlů. S třemi core uzly může systém tolerovat selhání jednoho uzlu a stále dosáhnout konsenzu.
Warning
Větším nasazením musí být počet core uzlů konfigurován jako lichý počet, například 5, 7, 9 a tak dále, aby se zabránilo split-brain scénářům a zajistilo se dosažení většiny pro konsenzus.
Peripheral node
Peripheral node, na rozdíl od core uzlu, se nepodílí na tvorbě sdíleného konsenzu clusteru. Jeho hlavní funkcí je poskytování služeb dat, provádění výpočtů, hostování služeb nebo jiné doplňkové role, které rozšiřují schopnosti a kapacitu clusteru.
Přestože periferní uzly nepřispívají k tvorbě konsenzu clusteru, udržují si symbiotický vztah s core uzly.
Service
Služba (Service) je sbírka mikroslužeb, které poskytují funkčnost napříč celým clusterem. Příkladem je ASAB Library, Zookeeper, Apache Kafka, Elasticsearch a další.
Každá služba má v rámci clusteru svůj jedinečný identifikátor, nazývaný service_id.
Instance
Instance představuje jednotlivý kontejner, který běží danou službu. Pokud je služba naplánována na běh na více uzlech clusteru, každá běžící entita je instance dané služby.
Každá instance má v rámci clusteru svůj jedinečný identifikátor, nazývaný instance_id. Každá instance má také své číslo, nazývané instance_no. Každá instance je také označena příslušnými service_id a node_id.
Tip
instance_no může být také řetězec!
Sherpa
Sherpa je pomocný kontejner spuštěný vedle instancí některých specifických služeb. Běží pouze krátkou dobu, dokud není úloha sherpa dokončena.
Typickým použitím pro sherpa je počáteční nastavení databáze.
Model
Model představuje chtěné uspořádání clusteru.
Je to jeden nebo více YAML souborů uložených v Knihovně (Library).
ASAB Maestro spravuje cluster aplikací modelu. Všechny služby uvedené v modelu jsou spuštěny nebo aktualizovány službami ASAB Remote Control a ASAB Governator.
Název souboru modelu model.yaml je určen k úpravám. Další soubory jsou vytvářeny automaticky prostřednictvím dalších komponent LogMan.io.
Descriptor
Deskriptor je YAML soubor žijící v Knihovně (Library), který určuje, jak by měla být služba, přesněji instance služby, vytvořena a spuštěna.
Application
Aplikace je sada deskriptorů a jejich verzí na úrovni clusteru.
Global Version
Každá Aplikace může mít více globálních verzí. Každá verze je specifikována ve verzi souboru uloženého v Knihovně, která ukládá verze pro každou službu aplikace.
Tech / Technology
Tech znamená technologii. Technologie je specifický typ služby (tj. NGINX, Mongo), která poskytuje nějaké zdroje ostatním službám.
How to
Ve výstavbě

Instalace simulátoru logů
Pro instalaci simulátoru logů budete potřebovat běžící TeskaLabs LogMan.io instalaci.
Simulátor logů je součástí Kolektoru LogMan.io. Výchozí konfigurace Kolektoru LogMan.io vám poskytuje simulované logy technologií Microsoft 365, Microsoft Windows Events a vzorové logy Linuxu ve formátu RFC 3164.
Vytvoření nájemce
Vytvořte nájemce, ve kterém chcete simulovat logy.
- Vytvořte nového nájemce v uživatelském rozhraní (Auth&Roles > Tenants > New tenant)
- Přiřaďte své přihlašovací údaje novému nájemci
- Přejděte na Maintenance > Configuration a vytvořte novou konfiguraci ve složce
Tenantss názvem vašeho nájemce. V nové konfiguraci vyberte ECS schema a své časové pásmo - Odhlaste se a přihlaste se do nového nájemce
Přidání knihovny se simulovanými zdroji logů
V uživatelském rozhraní přejděte na Maintanance > Configuration
Přidejte další vrstvu knihovny.
libsreg+https://libsreg.z6.web.core.windows.net/lmio-collector-library
Přidání služby kolektoru do modelu
Přidejte službu lmio-collector do sekce services souboru model.yaml.
services:
...
lmio-collector:
- <node_id>
Aplikujte změny!
curl -X 'POST' 'http://<node_id>:8891/node/<node_id>' -H 'Content-Type: application/json' -d '{"command": "up"}'
V uživatelském rozhraní přejděte na obrazovku Kolektory a zprovozněte nového kolektora.
Vytvoření eventlane a zahájení analýzy
Jednoduše použijte Event Lane Manager:
curl -X 'PUT' 'http://<node_id>:8954/create-eventlane' -H 'Content-Type: application/json' -d '{"tenant": "<your tenant>", "stream": "microsoft-365-mirage", "node_id": "<node_id>" }'
ASAB Maestro bootstrap
Bootstrap je proces, jak nasadit ASAB Maestro na novém uzlu clusteru.
Bootstrap pomocí Dockeru
$ docker run -it --rm --pull always \
-v /var/run/docker.sock:/var/run/docker.sock \
-v /opt/site:/opt/site \
-v /opt/site/docker/conf:/root/.docker/ \
-v /data:/data \
-e NODE_ID=`hostname -s` \
--network=host \
pcr.teskalabs.com/asab/asab-governator:stable \
python3 -m governator.bootstrap
Bootstrap pomocí Podmanu
Nasazení pomocí Podmanu je inherentně bez root přístupu, což přidává další vrstvu bezpečnosti k nasazení.
Note
Version 4+ nebo Podman je silně doporučován.
Toto je způsob, jak nainstalovat Podman na Ubuntu 22.04 LTS:
$ export ubuntu_version='22.04'
$ export key_url="https://download.opensuse.org/repositories/devel:/kubic:/libcontainers:/unstable/xUbuntu_${ubuntu_version}/Release.key"
$ export sources_url="https://download.opensuse.org/repositories/devel:/kubic:/libcontainers:/unstable/xUbuntu_${ubuntu_version}"
$ echo "deb $sources_url/ /" | sudo tee /etc/apt/sources.list.d/devel:kubic:libcontainers:unstable.list
$ curl -fsSL $key_url | gpg --dearmor | sudo tee /etc/apt/trusted.gpg.d/devel_kubic_libcontainers_unstable.gpg > /dev/null
$ sudo apt update
$ sudo apt install podman
Nakonfigurujte Podman:
$ systemctl --user start podman.socket
$ systemctl --user enable podman.socket
$ sudo ln -s /run/user/${UID}/podman/podman.sock /var/run/docker.sock
$ loginctl enable-linger ${USER}
Připravte rozložení souborového systému OS:
$ sudo mkdir /opt/site
$ sudo chown ${USER} /opt/site
$ mkdir -p /opt/site/docker/conf
$ sudo mkdir /data
$ sudo chown ${USER} /data
Spusťte bootstrap:
$ podman run -it --rm --pull always \
-v /var/run/docker.sock:/var/run/docker.sock \
-v /opt/site:/opt/site \
-v /opt/site/docker/conf:/root/.docker/ \
-v /data:/data \
-e NODE_ID=`hostname -s` \
--network=host \
pcr.teskalabs.com/asab/asab-governator:stable \
python3 -m governator.bootstrap
Vlastní verze
Vyhněte se vlastním verzím
LogMan.io se skládá z více služeb a před každým vydáním testujeme jejich kompatibilitu. Verze distribuované společností TeskaLabs jsou testovány a důrazně doporučovány.
Nemůžeme zaručit kompatibilitu služeb, pokud jsou použity kombinace JINÉ než ty v oficiálních souborových verzích.
Pro pokročilé uživatele, kteří varování přeskočili, zde jsou tipy, jak přizpůsobit verze:
Vytvoření nového souboru verze
V Knihovně vytvořte nový YAML soubor ve složce /Site/<application>/Versions/. Udržujte požadovanou strukturu souboru verze a specifikujte verze služeb. Pokud není pro službu specifikována žádná verze, bude ve výchozím nastavení použita verze latest. Nastavte název nového souboru jako verzi aplikace v modelu.
Verze a soubory verzí
Verze se odkazuje na konkrétní soubor verze v Knihovně.
Verze v24.30.01 aplikace ASAB Maestro se odkazuje na soubor verze /Site/ASAB Maestro/Versions/v24.30.01.yaml.
Verze v24.30.01 aplikace LogMan.io se odkazuje na soubor verze /Site/LogMan.io/Versions/v24.30.01.yaml.
define:
    type: rc/version
    product: LogMan.io
    version: v24.30.01
    asab_maestro_library: v24.29

versions:
    lmio-collector: v24.25
    lmio-receiver: v24.19.01
    lmio-parsec: v24.30
    lmio-depositor: v24.30
    lmio-alerts: v24.24

    lmio-elman: v24.22-beta3

    lmio-lookupbuilder: v24.30
    lmio-ipaddrproc: v24.30
    lmio-watcher: v24.22
    system-collector: v24.25

    lmio-baseliner: v24.30
    lmio-correlator: v24.30.01

    library lmio-common-library: v24.30.01
Vlastní verze
Předpokládejme, že nový soubor vlastní verze aplikace LogMan.io je pojmenován custom.yaml a je umístěn v /Site/LogMan.io/Versions/custom.yaml v Knihovně.
Aby bylo možné použít nový soubor verze, propojte ho v modelu a stiskněte tlačítko "Apply".
define:
    type: rc/model

services:
    ...

applications:
    - name: "ASAB Maestro"
        version: v24.30.01
    - name: "LogMan.io"
        version: custom
Přepsání verze v modelu
Pro přepsání souboru verze z modelu použijte klíč "version" v deklaraci služby.
V tomto příkladu bude verze instance asab-iris-1 nastavena na v24.36. Verze v souboru verze /Site/ASAB Maestro/Versions/v24.30.01.yaml bude ignorována.
define:
    type: rc/model

services:
    ...

    asab-iris:
        instances:
            - node1
        version: v24.36

applications:
    - name: "ASAB Maestro"
        version: v24.30.01
    - name: "LogMan.io"
        version: v24.30.01
Nastavení verze pro každou instanci se nedoporučuje
Je možné nastavit odlišnou verzi pro každou instanci. Tento přístup však nedoporučujeme. Spuštění více instancí s odlišnými verzemi vede ve většině služeb k vážným chybám.
define:
    type: rc/model

services:
    ...

    asab-iris:
        instances:
            1:
                node: node1
                version: v24.36
            2:
                node: node1
                version: v24.25

applications:
    - name: "ASAB Maestro"
        version: v24.30.01
    - name: "LogMan.io"
        version: v24.30.01
Nastavení Library
Knihovna je domovem různých deklarací, které popisují komponenty potřebné pro funkčnost LogMan.io a jejich specifické chování.
Funkčnost Maestra je závislá a řízena několika typy souborů Knihovny:
- Nedílnou součástí je model. Určuje, které komponenty se mají nasadit.
- Deskriptory poskytují instrukce jak nainstalovat každou službu.
- Verze souborů obsahují verze všech softwarových komponent, čímž vytváří globální verzi každé aplikace.
Všechny deklarace a soubory používané v ASAB Maestro se nacházejí v adresáři /Site. Na nejvyšší úrovni adresáře /Site vždy naleznete soubory modelu a adresáře aplikací. Všechny deskriptory a verze souborů jsou specifické pro danou aplikaci. Deskriptory, Verze a Webové aplikace jsou probírány v dalších kapitolách.
V každé aplikaci je ještě jedna složka nazvaná jednoduše Files. Soubory v těchto adresářích jsou tříděny podle služeb, k nimž náleží. Mohou být referencovány v deskriptorech.
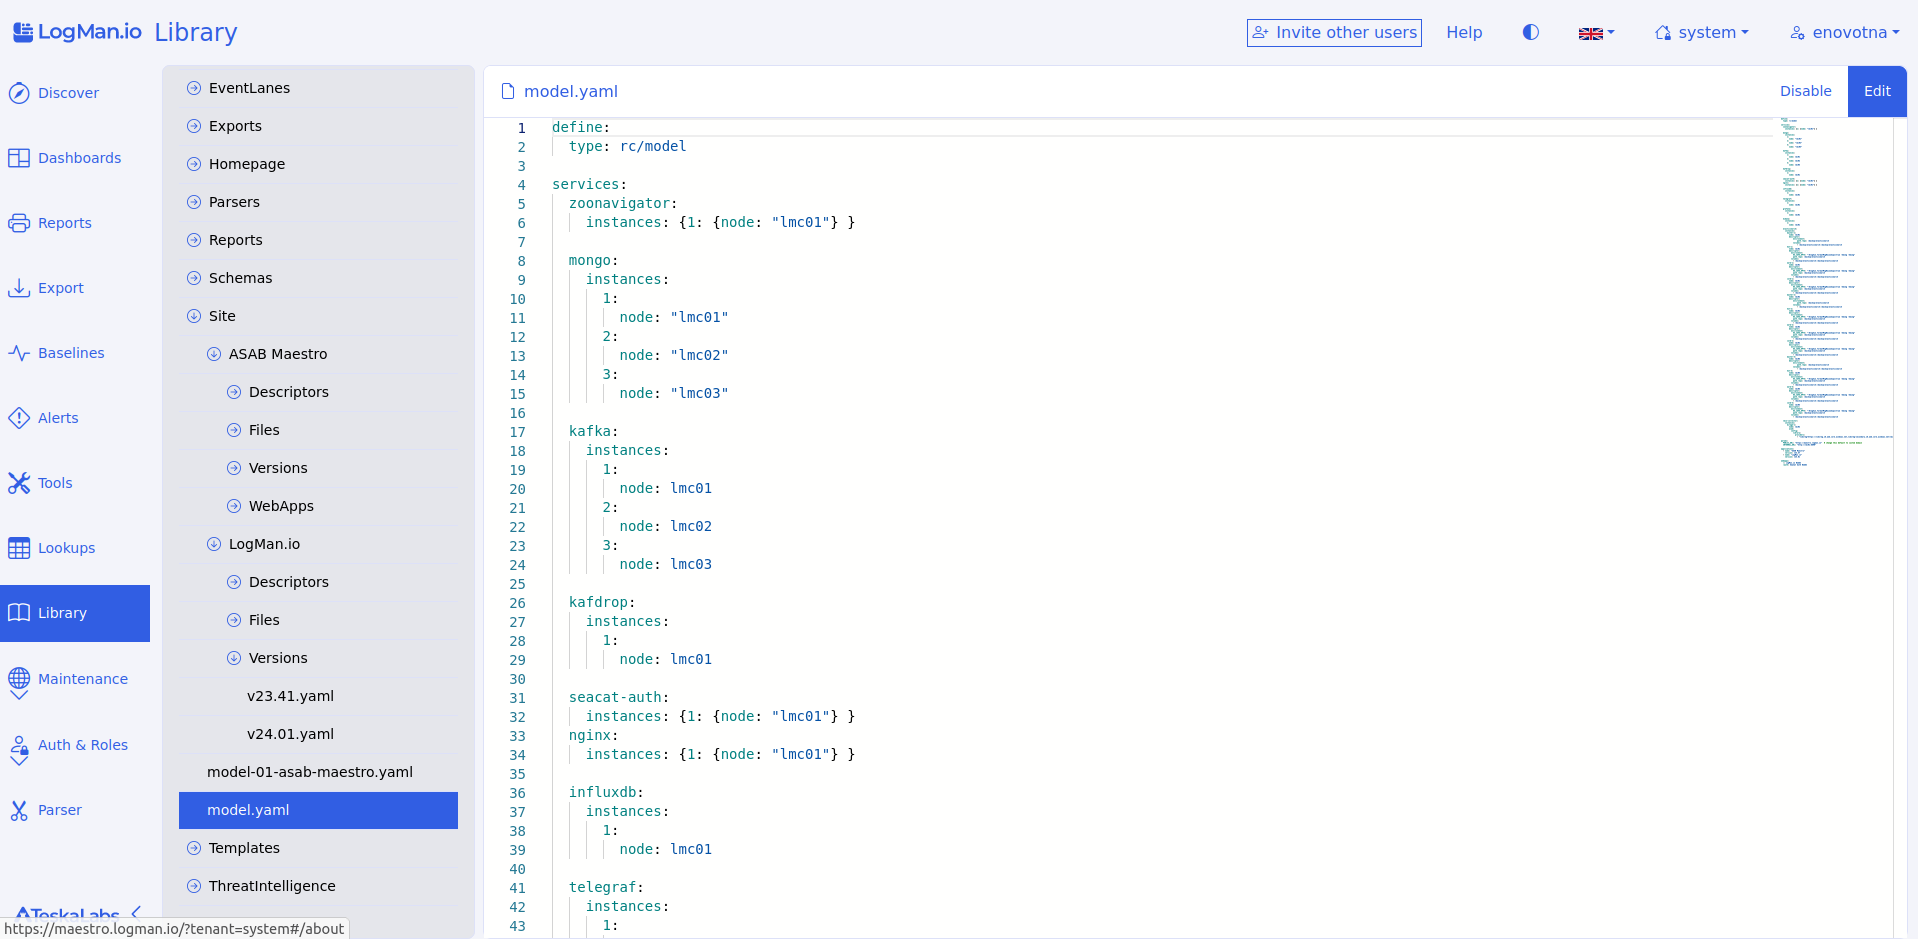
Model ASAB Maestro
Model je soubor YAML nebo více souborů YAML popisujících požadované uspořádání clusteru. Je to hlavní bod interakce mezi uživatelem a ASAB Maestro. Model je místo, kde lze přizpůsobit instalaci LogMan.io.
Soubor(y) modelu
Soubory modelu jsou ukládány v knihovně ve složce /Site/.
Soubor modelu na uživatelské úrovni je /Site/model.yaml.
Správce tento soubor upravuje ručně, tj. v Knihovně.
Může existovat více souborů modelu. Zejména spravované části modelu jsou odděleny do specifických souborů. Všechny soubory modelu jsou sloučeny do jediné datové struktury modelu, když je model aplikován.
Varování
Nepřepisujte soubory modelu označené jako automaticky generované.
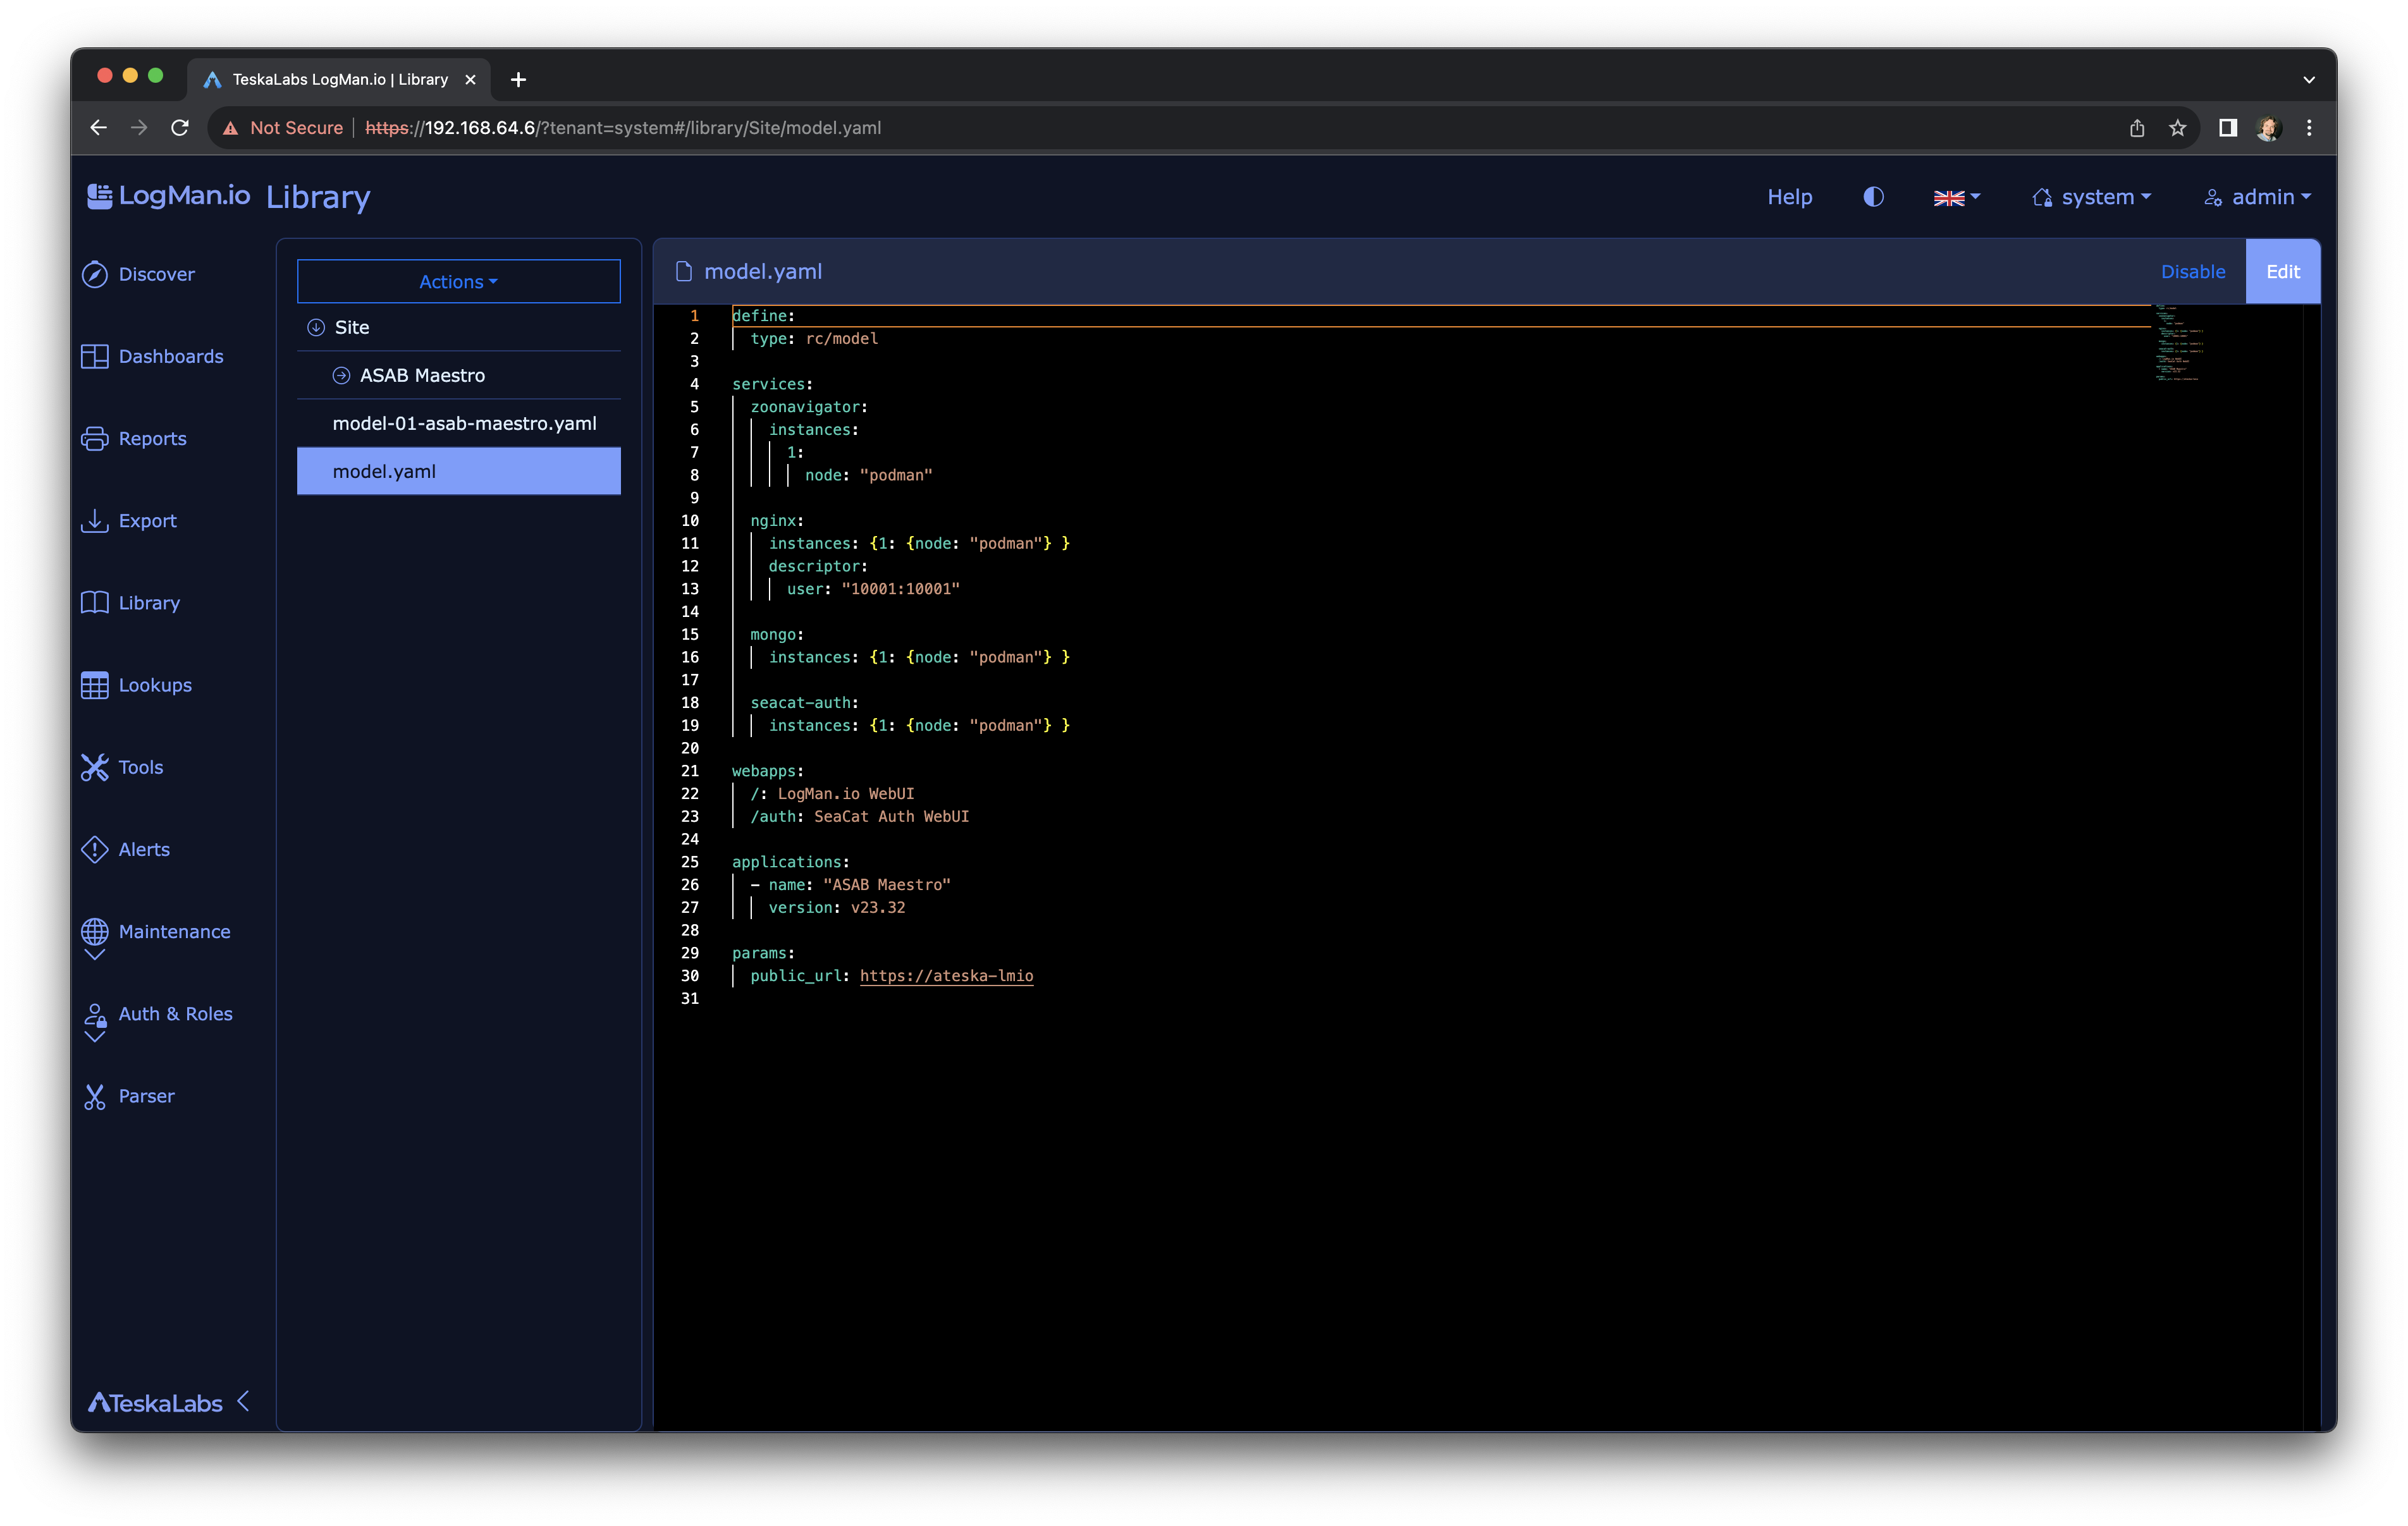
Struktura modelu
Příklad souboru /Site/model.yaml:
define:
type: rc/model
services:
nginx:
instances:
1: {node: "node1"}
2: {node: "node2"}
2: {node: "node3"}
mongo:
- {node: "node1"}
- {node: "node2"}
- {node: "node3"}
myservice:
instances:
id1: {node: "node1"}
webapps:
/: My Web application
/auth: SeaCat Auth WebUI
/influxdb: InfluxDB UI
applications:
- name: "ASAB Maestro"
version: v23.32
- name: "My Application"
version: v1.0
params:
PUBLIC_URL: https://ateska-lmio
Sekce define
define:
type: rc/model
Určuje typ tohoto souboru YAML tím, že uvádí type: rc/model.
Sekce services
Tato sekce uvádí všechny služby v clusteru. V uvedeném příkladu jsou služby „nginx“, „mongo“ a „myservice“.
Každý název služby musí odpovídat příslušnému deskriptoru v knihovně.
Sekce services je stanovena následovně:
services:
<service_id>:
instances:
<instance_no>:
node: <node_id>
<instance-level overrides>
...
<service-level overrides>
Přidat novou instanci
Sekce instances v záznamu služby v services musí specifikovat, na kterém uzlu spustit každou instanci.
Toto je kanonická, plně rozvinutá forma:
myservice:
instances:
1:
node: node1
2:
node: node2
3:
node: node2
Služba myservice je naplánována ke spuštění ve třech instancích (instance číslo 1, 2 a 3) na uzlech node1 a node2.
Pro stručnost jsou k dispozici následující formy:
myservice:
instances: {1: node1, 2: node2, 3: node2}
myservice:
instances: ["node1", "node2", "node2"]
Poslední příklad definuje pouze jednu instanci (čísla 1) služby myservice, která bude naplánována na uzel node1:
myservice:
instances: node1
ID instancí v objektové podobě mohou být celá čísla nebo řetězce (např. master-1, hot-2):
myservice:
instances:
master-1:
node: node1
hot-2:
node: node2
Odstraněné instance
Některé služby potřebují pevné číslo instance po celou životnost clusteru, zejména pokud jsou některé instance odstraněny.
!!! varování „Přejmenovávání a přesouvání instancí“
Kdykoli přejmenováváte nebo přesouváte instance z jednoho uzlu na druhý, mějte na paměti, že mezi „starou“ a „novou“ instancí neexistuje žádná reference. To znamená, že jedna instance je mazána a druhá vytvářena. Pokud přesunete instanci služby z jednoho uzlu na druhý, mějte na paměti, že data uložená na tomto uzlu a spravovaná nebo používaná službou nebudou přesunuta.
ZooKeeper
Číslo instance v službě ZooKeeper se používá technologií ZooKeeper k identifikaci instance v rámci clusteru. Změna čísla instance tedy znamená odebrání jednoho uzlu ZooKeeper ze clusteru a přidání nového.
Odebraný případ je číslo dvě:
myservice:
instances:
1: {node: "node1"}
# There used to be another instance here but it is removed now
3: {node: "node2"}
V zjednodušené podobě musí být použito null:
myservice: ["node1", null, "node2"]
Zakázané služby
Služby lze zakázat tak, že před ID služby vložíte . (tečku). Zakázané služby nejsou nasazeny do clusteru, ale jejich konfigurace zůstává v modelu pro budoucí použití nebo rychlé znovuzapnutí.
services:
# This service is active and will be deployed
my-active-service:
instances:
1:
node: node1
# This service is disabled and will NOT be deployed
.my-disabled-service:
instances:
1:
node: node1
Chcete-li znovu povolit zakázanou službu, jednoduše odstraňte předponu ..
Odkazy na služby napříč aplikacemi
ID služeb mohou zahrnovat předponu aplikace k odkázání na deskriptory z jiných aplikací v Knihovně. Použijte formát <AppName>/<název-služby>.
To je užitečné, když chcete nasadit službu z jiné aplikace (např. sdílené infrastruktury služby).
services:
# Reference a service from "ASAB Maestro" application
"ASAB Maestro/zookeeper":
instances:
1:
node: node1
2:
node: node2
3:
node: node3
Bez předpony je služba vyhledávána v aplikacích definovaných v sekci applications modelu.
Přepsání hodnot popisovače
Chcete-li přepsat hodnoty z deskriptoru, můžete tyto hodnoty zadat na značkách <instance-level overrides> nebo <service-level overrides>.
V následujícím příkladu je počet cpu nastaven na 2 v Docker Compose a také je sekce asab z popisu asab-governator přepsána na úrovni instance:
services:
...
asab-governator:
instances:
1:
node: node1
descriptor:
cpus: 2
asab:
config:
remote_control:
url:
- http://nodeX:8891/rc
Stejné přepsání, ale na úrovni služby:
services:
...
asab-governator:
instances: [node1, node2]
descriptor:
cpus: 2
asab:
config:
remote_control:
url:
- http://nodeX:8891/rc
Přepisování verzí
Chcete-li přepsat verzi, která je ve výchozím nastavení nastavena v souboru verze, použijte v modelu klíčové slovo "version".
V následujícím příkladu bude verze instance asab-governator-1 nastavena na v24.36. Verze v souboru s verzí bude ignorována.
services:
...
asab-governator:
instances:
- node1
version: v24.36
Sekce webapps
Sekce webapps popisuje, jaké webové aplikace nainstalovat do clusteru. Podrobnější informace naleznete v kapitole NGINX.
Sekce applications
Sekce aplikace uvádí aplikace z Knihovny, které mají být zahrnuty.
applications:
- name: <application name>
version: <application version>
...
Aplikace žije v Knihovně ve složce /Site/<application name>/.
version odkazuje na soubor verze pod /Site/<application name>/Versions/. Pro verze ve formátu v<major>.<minor> může být soubor umístěn v kořenovém adresáři Versions/ nebo ve složce odpovídající verzi (např. v26.12.08 → /Site/<application name>/Versions/v2612/v26.12.08.yaml). Podrobné rozložení a pravidla řešení naleznete v Versions.
Pokud je v sekci applications modelu více položek aplikací, lze více aplikací nasadit společně ve stejném clusteru.
Soubor verze
Příklad souboru verze
/Site/ASAB Maestro/Versions/v2612/v26.12.08.yaml (nebo /Site/ASAB Maestro/Versions/v26.12.08.yaml v kořeni Versions/):
define:
type: rc/version
product: ASAB Maestro
version: v23.32
versions:
zookeeper: '3.9'
nginx: '1.25.2'
mongo: '7.0.1'
asab-remote-control: latest
asab-governator: stable
asab-library: v23.15
asab-config: v23.31
seacat-auth: v23.37-beta
asab-iris: v23.31
Sekce params
Tato sekce obsahuje parametrizaci webu na úrovni clusteru (globální) klíč/hodnota.
Nastavení proxy
Když cluster běží za HTTP/HTTPS proxy, nastavte v sekci params HTTP_PROXY, HTTPS_PROXY a volitelně NO_PROXY. ASAB Maestro automaticky aplikuje tyto proměnné prostředí na všechny kontejnery v clusteru.
params:
HTTP_PROXY: http://X.X.X.X/
HTTPS_PROXY: http://X.X.X.X/
NO_PROXY: localhost,127.0.0.1,10.0.0.0/8
| Parametr | Popis |
|---|---|
HTTP_PROXY |
Proxy URL pro odchozí HTTP provoz |
HTTPS_PROXY |
Proxy URL pro odchozí HTTPS provoz |
NO_PROXY |
Čárkou oddělený seznam názvů hostitelů, IP adres nebo rozsahů CIDR, které obejdou proxy |
Tip
Každá odchozí komunikace HTTPS z clusteru může používat proxy server. Nakonfigurujte svůj proxy server tak, aby umožňoval provoz na doménová jména uvedená v Networking.
Sekce secrets
Volitelné. Tajemství na úrovni clusteru jsou generována a uložena ve skladu. Stejná struktura jako u tajemství popisu (klíče VELKÝM_SNAKE_CASE; každý záznam např. type: token, volitelné length). Hodnoty jsou k dispozici jako šablonové parametry v popisech.
secrets:
API_TOKEN:
type: token
length: 32
SHARED_SECRET: {}
Sekce hosts
Seznam dalších hostitelů sdílených mezi kontejnery v souboru /etc/hosts.
define:
type: rc/model
...
hosts:
- 10.173.34.1 custom_host
Rozšíření na úrovni modelu
Některé technologie umožňují modelu specifikovat rozšíření jejich konfigurace.
Příklad rozšíření na úrovni modelu NGINX:
define:
type: rc/model
...
nginx:
https:
location /:
- gzip_static on
- alias /webroot/lmio-webui/dist
Více modelových souborů
Kromě uživatelského modelového souboru (/Site/model.yaml) tam najdete také generované modelové soubory pojmenované podle tohoto vzoru: /Site/model-*.yaml.
Modelové soubory jsou sloučeny do jednoho velkého modelu těsně před zpracováním pomocí ASAB Remote Control.
Modelové soubory v podsložkách
Soubory modelu mohou být také organizovány v podsložkách pod /Site/Models/. Soubory odpovídající vzoru model-*.yaml v tomto adresáři a jeho podsložkách jsou rekurzivně zjišťovány a sloučeny do hlavního modelu.
/Site/
model.yaml # Main model file
model-01.automation.yaml # Partial model (merged)
Models/
model-network.yaml # Additional model (merged)
monitoring/
model-metrics.yaml # Nested model (merged)
Poznámka: Sloučeny jsou pouze soubory začínající na model- a končící .yaml. Ostatní soubory jsou ignorovány.
To umožňuje organizovat velké modely do logických skupin, například oddělením síťových služeb, monitorovacího stacku nebo konfigurací specifických pro aplikace.
Částečné soubory modelů (jak model-*.yaml v /Site/, tak model-*.yaml pod /Site/Models/) musí ve své sekci define používat type: rc/model-part:
define:
type: rc/model-part
Deskriptor ASAB Maestro
Deskriptory jsou soubory YAML uložené v Knihovně. Každá aplikace se skládá ze skupiny deskriptorů /Site/<název aplikace>/Descriptors/.
Deskriptor poskytuje podrobné informace o službě a/nebo technologii. Deskriptore slouží jako specifická rozšíření modelu.
Poznámka
Popisy poskytují autoři každé žádosti.
Struktura deskriptoru
Příklad /Site/ASAB Maestro/Descriptors/mongo.yaml:
define:
type: rc/descriptor
name: MongoDB document database
url: https://github.com/mongodb/mongo
descriptor:
image: library/mongo
volumes:
- "{{SLOW_STORAGE}}/{{INSTANCE_ID}}/data:/data/db"
- "{{SITE}}/{{INSTANCE_ID}}/conf:/etc/mongo:ro"
command: mongod --config /etc/mongo/mongod.conf --directoryperdb
healthcheck:
test: ["CMD-SHELL", 'echo "db.runCommand(\"ping\").ok" | mongosh 127.0.0.1:27017/rs0 --quiet']
interval: 60s
timeout: 10s
retries: 5
start_period: 30s
sherpas:
init:
image: library/mongo
entrypoint: ["mongosh", "--nodb", "--file", "/script/mongo-init.js"]
command: ["echo", "DONE"]
volumes:
- "{{SITE}}/{{INSTANCE_ID}}/script:/script:ro"
- "{{SITE}}/{{INSTANCE_ID}}/conf:/etc/mongo:ro"
depends_on: ["{{INSTANCE_ID}}"]
environment:
MONGO_HOSTNAMES: "{{MONGO_HOSTNAMES}}"
files:
- "conf/mongod.conf": |
net:
bindIp: 0.0.0.0
port: 27017
replication:
replSetName: rs0
- "script/mongo-init.js"
Šablonování
Deskriptory využívají šablony Jinja2, které se rozvinou, když je deskriptor aplikován.
Běžné parametry:
{{NODE_ID}}: Identifikace uzlu / hostname hostitelského stroje (node1).{{SERVICE_ID}}: Identifikace služby (např.mongo).{{INSTANCE_ID}}: Identifikace instance (např.mongo-2).{{INSTANCE_NO}}: Číslo instance (např.2).{{SITE}}: Adresář s konfigurací webu na hostitelském stroji (např./opt/site).{{FAST_STORAGE}}: Adresář s rychlým úložištěm na hostitelském stroji (např./data/ssd).{{SLOW_STORAGE}}: Adresář s pomalým úložištěm na hostitelském stroji (např./data/hdd).
Poznámka
Ostatní parametry lze specifikovat v deskriptorech, v modelu nebo je zajistit prostřednictvím technologií.
Vlastní filtry Jinja2 registrované ASAB Remote Control mohou transformovat hodnoty šablon — například {{MY_SECRET|argon2_hash}} vytváří deterministický Argon2id hash tajemství.
Technologie
Některé z nich také zavádějí specifické sekce do Deskriptorů.
Zjistěte více o Technologiích
Složitost
- Soubor
/Site/<název aplikace>/Descriptors/__commons.yaml__Knihovny je společnou základnou pro všechny deskriptory aplikace. Obsahuje konkrétně položky pro režim sítě, restartovací politiku, protokolování a další. - Specifický deskriptor služby (např.
/Site/<název aplikace>/Descriptors/nginx.yaml) je vrstvený nad obsahem__commons__.yaml - Model může přepsat deskriptor.
Sloučit algoritmus
Tato skladebnost je implementována prostřednictvím slučovacího algoritmu. Ten samý algoritmus naleznete použitý v několika případech, kdy kousky z různých zdrojů vedou k funkční konfiguraci webu.
Vrstevnění knihovny
Chcete-li získat úplný přehled o Knihovně v rámci ASAB Maestro, seznamte se také s vrstvením knihovny ASAB.
Sekce
Sekce define
define:
type: rc/descriptor
name: <human-readable name>
url: <URL with relevant info>
type musí být rc/descriptor.
Položky name a url poskytují informace o službě a/nebo technologii.
Sekce params
Určete parametry pro šablonování tohoto a všech ostatních Deskriptorů. Jakýkoli parametr specifikovaný v této sekci lze použít v dvojitých složených závorkách pro šablonování Jinja2.
define:
type: rc/descriptor
params:
MY_PARAMETER: "ABCDEFGH"
descriptor:
environment: "{{MY_PARAMETER}}"
Sekce secrets
Podobně jako params mohou být tajemství použita také jako parametry pro tvorbu šablon. Jejich hodnota však není určena v popisu, ale je generována a uložena ve Vault. Tajemství si můžete přizpůsobit určením type a length. Výchozí je "token" o délce 64 bytů.
define:
type: rc/descriptor
secrets:
MY_SECRET:
type: token
length: 32
descriptor:
environment: "{{MY_SECRET}}"
Varování
Části popisu jsou používány přímo k přípravě docker-compose.yaml. Sekce secrets může být také specifikována v docker-compose.yaml. Tato funkcionalita Docker Compose je však v ASAB Maestro vynechána a je plně nahrazena sekcí secrets v popisu.
Sekce descriptor
Sekce descriptor je šablona pro sekci service souboru docker-compose.yaml.
Následující transformace byly provedeny:
- Proměnné Jinja2 jsou rozvinuty.
- Verze z
../Versions/...je připojena kimage, pokud tam není přítomna. - Specifické technologie provádějí vlastní transformace, obvykle jsou označeny
null.
Podrobnosti o volumes
Služba má k dispozici následující tři úložiště pro jejich trvalá data:
{{SITE}}: adresář webu (např./opt/site/...){{SLOW_STORAGE}}: pomalé úložiště (např./data/hdd/...){{FAST_STORAGE}}: rychlé úložiště (např./data/ssd/...)
Každá instance může vytvořit podsložku v kterékoliv z výše uvedených umístění pojmenovanou podle svého instance_id.
Sekce files
Tato sekce určuje, které soubory mají být zkopírovány do podadresáře instance v adresáři webu (tj. /opt/site/...).
Následně může být tento obsah zpřístupněn kontejneru instance prostřednictvím příslušného záznamu volumes.
Vypište soubory podle následujícího schématu:
files:
- destination:
source: file_name.txt
OR
files:
- destination:
content: |
Multiline plain text
that will be written into
the destination path.
Cíl
Existují tři možné destinace:
- Tato služba
- Jiná služba
- ZooKeeper
1. Tato služba
Zadaná cesta k souboru je relativní k cíli v adresáři webu.
Ve příkladu, tento záznam v deskriptoru...
files:
- script/mongo-init.js:
source: some_source_dir/mongo-init.js
...vytvoří soubor /opt/site/mongo-1/script/mongo-init.js, pokud je ID INSTANCE mongo instance mongo-1.
2. Jiná služba
Použijte URL s protokolem service k cílení souboru do jiné služby.
Například tento záznam v JAKÉMKOLIV popisu služby v modelu...
files:
- service://mongo/script/mongo-init.js:
source: some_source_dir/mongo-init.js
...vytvoří soubor /opt/site/mongo-1/script/mongo-init.js, pokud je instance mongo přítomna v modelu a její ID INSTANCE je mongo-1.
3. Ošetřovatel v zoo
Použijte schéma URL zk k určení cesty v ZooKeeper, kam nahrát soubor. Soubor je v režimu „spravováno“. To znamená, že je vždy aktualizován podle aktuálního stavu knihovny.
files:
- zk:///asab/library/settings/lmio-library-settings.json:
source: asab-library/setup.json
V tomto příkladu bude vytvořen uzel ZooKeeper s cestou /asab/library/settings/lmio-library-settings.json, nebo aktualizován, pokud již existuje.
Zdroj
Zdroj je relativní cesta ke složce knihovny přiřazená jako /Site/<application>/Files/<service>/. Např. pro službu mongo odkazuje na /Site/ASAB Maestro/Files/mongo/.
Zdroj může být buď soubor, nebo složka. Cesta ke složce musí končit lomítkem.
!!! tip „Zkratky syntaxe zdrojového souboru“
Pokud v deklaraci chybí zdroj, sdílí stejnou cestu jako cíl.
Tento záznam kopíruje soubor /Site/ASAB Maestro/Files/mongo/script/mongo-init.js do /opt/site/mongo-1/script/mongo-init.js, za předpokladu, že identifikace instance je mongo-1:
```yaml
files:
- "script/mongo-init.js"
```
Podobný záznam s koncovým znakem / zkopíruje celý adresář z /Site/ASAB Maestro/Files/mongo/script/conf do adresáře /opt/site/mongo-1/conf/.
```yaml
files:
- "conf/"
```
Soubory nejsou šablonovány
Na rozdíl od Deskriptorů a modelu, soubory uložené v adresáři /Site/<název aplikace>/Files/<service_id>/ nejsou šablonovány. To znamená, že složené závorky s parametry nejsou nahrazeny příslušnými hodnotami. Pokud potřebujete ve souboru používat šablony, vložte soubor přímo do Deskriptore prostřednictvím operátoru pro vícenásobný řetězec ("|").
Obsah
Uveďte obsah souboru přímo v deskriptoru. To je zvláště výhodné pro krátké soubory a/nebo soubory, které vyžadují parametry poskytnuté Maestrem.
Doslovný styl použitím svislíku (|) v souboru yaml umožňuje psaní víceliniových řetězců (blokových skalárů).
files:
- "conf/mongod.conf":
content: |
net:
bindIp: 0.0.0.0
port: 27017
replication:
replSetName: rs0
Klíčové slovo content lze vynechat pro stručnost.
files:
- "conf/mongod.conf": |
net:
bindIp: 0.0.0.0
port: 27017
replication:
replSetName: rs0
Sekce sherpas
Šerpové jsou pomocné kontejnery, které jsou spouštěny společně s hlavními kontejnery instance. Kontejnery šerpy se očekává, že skončí relativně rychle a nejsou restartovány. Šerpové, kteří úspěšně skončí (s výstupním kódem 0), jsou okamžitě odstraněni.
Příklad:
sherpas:
init:
image: library/mongo
entrypoint: ["mongosh", "--nodb", "--file", "/script/mongo-init.js"]
command: ["echo", "DONE"]
volumes:
- "{{SITE}}/{{INSTANCE_ID}}/script:/script:ro"
- "{{SITE}}/{{INSTANCE_ID}}/conf:/etc/mongo:ro"
depends_on: ["{{INSTANCE_ID}}"]
environment:
MONGO_HOSTNAMES: "{{MONGO_HOSTNAMES}}"
Toto definuje init sherpa kontejner. Název kontejneru sherpa by byl mongo-1-init, parametr INSTANCE_ID zůstává mongo-1.
Obsah sherpy je šablona pro relevantní část docker-compose.yaml.
Pokud sherpa nespecifikuje image, použije se obraz služby včetně verze. Alternativně doporučujeme použít docker.teskalabs.com/asab/asab-governator:stable jako obraz pro sherpu, protože tento obraz je vždy k dispozici a není třeba jej stahovat.
Jinja2 filtry v ASAB Remote Control
Když ASAB Remote Control čte YAML modelu a descriptoru z Knihovny, expanduje Jinja2 šablony a aplikuje vlastní filtry v pipe syntaxi:
{{PARAMETER|filter_name}}
Filtry fungují v libovolné templatované YAML sekci (descriptor, files, sherpas, tech sekce a podobně). Statické soubory v /Site/.../Files/ se netemplatují — obsah deklarujte inline v sekci files descriptoru (viz Soubory descriptoru).
Dostupné filtry
| Filtr | Popis |
|---|---|
argon2_hash |
Deterministický Argon2id hash např. tajemství |
argon2_hash
Hash je deterministický — stejné tajemství vždy na každém uzlu clusteru produkuje stejný řetězec. Remote Control odvozuje salt z tajemství (Argon2id, time cost 3, memory 64 MiB, parallelism 4).
Verze v ASAB Maestro
Globální verze aplikace je uvedena v sekci applications modelu:
define:
type: rc/model
services:
zoonavigator:
instances: {1: {node: "lmc01"} }
params:
PUBLIC_URL: "https://maestro.logman.io"
applications:
- name: "ASAB Maestro"
version: v23.47
- name: "LogMan.io"
version: v24.01
Soubor verze popisující globální verze se nacházejí v adresáři /Site/<název aplikace>/Versions knihovny. Např. pro aplikaci ASAB Maestro existuje adresář /Site/ASAB Maestro/Versions.
Umístění souboru verze
Dálkové ovládání ASAB přijímá soubor s verzí pouze na jedné z těchto cest:
- Kořen
Versions/—/Site/<application>/Versions/<version>.yaml - Složka verze —
/Site/<application>/Versions/v<major><minor>/<version>.yaml(tato možnost je dostupná od verze 26.37)
Název složky verze je odvozen od řetězce verze aplikace. Vezměte hlavní a vedlejší číslo (v25.47.08 → 25 a 47, v26.12-beta8 → 26 a 12) a spojte je po předponě v: v2547, v2612. Čísla opravných verzí a přípony jako -beta7 nejsou součástí názvu složky.
Příklad rozvržení pro verzi v26.12.08:
/Site/LogMan.io/Versions/
v26.12.08.yaml ← allowed (root)
v2612/
v26.12.08.yaml ← allowed (preferred)
Jak je vybrán soubor s verzí
Při vytváření konfigurace clusteru ASAB Remote Control hledá soubor <version>.yaml v adresáři Versions/ a aplikuje tato pravidla:
- Pokud soubor existuje ve složce verze (např.
v2612/v26.12.08.yaml), použije se tato cesta. - Pokud soubor existuje přímo v
Versions/(např.v26.12.08.yaml), použije se tato cesta. - Pokud soubor existuje na obou místech, upřednostní se kopie ve složce verze.
- Soubor v jakékoli jiné lokaci se ignoruje (například nesprávná složka
v2515/nebo vnořená cestav2612/nested/). Remote Control zaznamená varování pro každou ignorovanou cestu. - Pokud soubor není nalezen v žádné povolené cestě, Remote Control zaznamená varování s očekávanými umístěními a soubor verze je považován za chybějící.
Obsah souboru verze
Soubor s verzí v24.01.yaml by mohl vypadat takto:
define:
type: rc/version
product: ASAB Maestro
version: v24.01
versions:
zookeeper: '3.9'
asab-remote-control: latest
asab-governator: stable
asab-library: v23.15-beta
asab-config: v23.45
seacat-auth: v23.47
asab-iris: v23.31-alpha
nginx: '1.25.2'
elasticsearch: '7.17.12'
mongo: '7.0.1'
kibana: '7.17.2'
influxdb: '2.7.1'
telegraf: '1.28.2'
grafana: '10.0.8'
kafdrop: '4.0.0'
kafka: '7.5.1'
jupyter: "lab-4.0.9"
webapp seacat-auth: v23.29-beta
Sekce define určuje typ souboru a poskytuje o něm další informace. Může také sloužit k ukládání komentářů a poznámek.
Sekce versions obsahuje názvy služeb jako klíče a jejich verze jako hodnoty. Jedná se o verze příslušných docker image. Speciálními záznamy v tomto seznamu jsou webové aplikace. Použijte klíčové slovo webapp pro přiřazení verze konkrétní webové aplikace. Pokud verze není uvedena, použije se nejnovější verze.
Webové Aplikace
Pro instalaci webové aplikace potřebujete:
- Webová aplikace uvedená v modelu
- Nginx (a SeaCat Auth)
- Příslušný soubor webové aplikace v knihovně
Model
Použijte sekci webapps k určení, které webové aplikace by měly být nainstalovány. Vyberte umístění nginx, kde bude každá webová aplikace sloužena.
Příklad /Site/model.yaml
define:
type: rc/model
services:
zoonavigator:
instances:
1:
node: "lmc01"
nginx:
instances:
1:
node: "lmc01"
mongo:
instances:
1:
node: "lmc01"
seacat-auth:
instances:
1:
node: "lmc01"
applications:
- name: "ASAB Maestro"
version: v23.47
params:
PUBLIC_URL: "https://maestro.logman.io"
webapps:
/: LogMan.io WebUI
/auth: SeaCat Auth WebUI
Závislosti
Webové aplikace mohou být slouženy pouze z proxy serveru Nginx.
Ujistěte se, že vaše veřejná URL v sekci params ve vašem modelu je správná.
Většina webových aplikací vyžaduje autorizační server. Pro úspěšné spuštění LogMan.io web UI nainstalujte také SeaCat Auth a Mongo jako jeho závislosti.
Soubor Webové Aplikace
Deklarace webové aplikace obsahuje distribuční bod, specifikaci Nginx a seznam webových aplikací.
- Vyberte mezi
mfeaspa - Vyberte server ("https", "http", "internal")
- Specifikujte umístění nginx, kde bude webová aplikace sloužena
- Specifikujte název webové aplikace
Note
mfe znamená "mikro-frontend" aplikace. LogMan.io Web UI se skládá z mnoha mikrofrontend aplikací.
spa znamená "jednoduchá aplikace".
Verze každé aplikace je uvedena v souboru versií. Aplikace, které nejsou uvedeny v souborech versií, jsou použity ve své latest verzi.
Descriptor Webové Aplikace pro MFE
define:
type: rc/webapp
name: TeskaLabs LogMan.io WebUI
url: https://teskalabs.com
webapp:
distribution: https://asabwebui.z16.web.core.windows.net/
mfe:
https:
/: lmio_webui
/asab_config_webui: asab_config_webui
/asab_library_webui: asab_library_webui
/asab_maestro_webui: asab_maestro_webui
/asab_tools_webui: asab_tools_webui
/bs_query_webui: bs_query_webui
/lmio_analysis_webui: lmio_analysis_webui
/lmio_lookup_webui: lmio_lookup_webui
Sekce webapp a klíč distribution specifikuje základní URL, ze které je aplikace distribuována.
Sekce mfe obsahuje specifikaci serveru (https, http nebo internal), na který bude instalace provedena.
Uvnitř serveru je slovník "subpath" (/) a název MFE komponenty (lmio_webui).
Jedno umístění by mělo být /, to je vstupní bod do MFE aplikace.
Descriptor Webové Aplikace pro SPA
define:
type: rc/webapp
name: TeskaLabs SeaCat Auth WebUI
url: https://teskalabs.com
webapp:
distribution: https://asabwebui.z16.web.core.windows.net/
spa:
https: seacat-auth
Sekce webapp a klíč distribution specifikuje základní URL, ze které je aplikace distribuována.
Sekce spa obsahuje specifikaci serveru (https, http nebo internal), na který bude instalace provedena.
Hodnota seacat-auth specifikuje název (jedné) SPA komponenty, která bude nainstalována.
Verzování
Verze komponent webových aplikací jsou specifikovány v příslušném souboru /Site/<název aplikace>/Versions/v<verze aplikace>.yaml:
define:
type: rc/version
product: ASAB Maestro
version: v23.32
versions:
...
webapp seacat-auth: 'v23.13-beta'
webapp lmio_webui: 'v23.43'
Webová aplikace má prefix webapp s připojením mezery.
Pokud verze není specifikována, předpokládá se verze "master".
Tento soubor poskytuje kompatibilní kombinaci verzí komponent webové aplikace a příslušných mikroservis.
Ruční Spuštění Distribuce Webové Aplikace
Možná budete potřebovat spustit distribuci webové aplikace ručně, například pro upgrade na novou verzi webové aplikace.
Postup je následující:
$ cd /opt/site
$ ./gov.sh compose up nginx-1-webapp-dist
[+] Running 1/1
✔ Container nginx-1-webapp-dist Created 0.1s
Attaching to nginx-1-webapp-dist
nginx-1-webapp-dist | Installing lmio_webui (mfe) ...
nginx-1-webapp-dist | lmio_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing asab_config_webui (mfe) ...
nginx-1-webapp-dist | asab_config_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing asab_maestro_webui (mfe) ...
nginx-1-webapp-dist | asab_maestro_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing asab_tools_webui (mfe) ...
nginx-1-webapp-dist | asab_tools_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing bs_query_webui (mfe) ...
nginx-1-webapp-dist | bs_query_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing lmio_analysis_webui (mfe) ...
nginx-1-webapp-dist | lmio_analysis_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing lmio_lookup_webui (mfe) ...
nginx-1-webapp-dist | lmio_lookup_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing lmio_observability_webui (mfe) ...
nginx-1-webapp-dist | lmio_observability_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing lmio_parser_builder_webui (mfe) ...
nginx-1-webapp-dist | lmio_parser_builder_webui already installed and up-to-date.
nginx-1-webapp-dist | Installing seacat-auth (spa) ...
nginx-1-webapp-dist | seacat-auth already installed and up-to-date.
nginx-1-webapp-dist exited with code 0
$
Techs
Technologie v ASAB Maestro
Technologie je specifický typ služby (např. NGINX, Mongo), která poskytuje prostředky jiným službám.
Kromě své hlavní funkce jako služby mikroslužba ASAB Remote Control rozšiřuje technologie a jejich dopad na konfiguraci clusteru.
Některé konfigurační možnosti vyžadují aktuální znalosti komponent clusteru. Například, pokud mikroslužba potřebuje konfiguraci Kafka serverů, Kafka tech v ASAB Remote Control zjistí, kde běží Kafka a poskytne konfiguraci.
Každá technologie je navržena tak, aby poskytovala jednu nebo více z následujících funkcí:
Parametry
Technologie poskytuje parametry, které lze použít v modelu a popisovači během šablonování.
Sekce v popisu
Technologie může využívat svou specifickou sekci popisovačů. Například viz Nginx tech.
Konfigurace služeb ASAB
ASAB služba je v tomto kontextu rozpoznána tím, že má asab sekci v popisovači.
Podívejte se na ASAB tech, abyste věděli, jak je vytvořena konfigurace ASAB služby.
Technologie mohou rozšířit konfiguraci ASAB služeb (např. Elasticsearch nebo Kafka techs).
Příklad
define:
type: rc/descriptor
name: ASAB Remote Control
descriptor:
image: docker.teskalabs.com/asab/asab-remote-control
volumes:
- "{{SITE}}/{{INSTANCE_ID}}/conf:/conf:ro"
asab:
configname: conf/asab-remote-control.conf
config: {}
nginx:
api: 8891
Úprava konfigurace služby
Některé technologie upraví svou vlastní konfiguraci na základě aktuálního rozložení clusteru.
ASAB Služby v rámci ASAB Maestro
Konfigurace služeb ASAB
Tato technologie poskytuje každé službě ASAB specifickou konfiguraci.
Sekce asab musí být specifikována v popisu.
Sekce asab vyžaduje:
configname- Název konfiguračního souboru, který odpovídá Dockerfile služby a mapování svazků (Dockerfiles nejsou v ASAB Maestro vůbec pokryty).config- Specifická konfigurace vyžadovaná nad rámec obecné a generované konfigurace psané ve formátu YAML.
define:
type: rc/descriptor
name: ASAB Remote Control
descriptor:
image: docker.teskalabs.com/asab/asab-remote-control
volumes:
- "{{SITE}}/{{INSTANCE_ID}}/conf:/conf:ro"
asab:
configname: conf/asab-remote-control.conf
config: {}
Konfigurace je složena v tomto pořadí:
- Nejdůležitější je generovaná konfigurace, která přepisuje všechny ostatní. Toto je konfigurace poskytovaná z technologií clusteru.
- Druhá je konfigurace služby řízená ASAB Config, editovatelná z webového rozhraní.
- Obecná konfigurace je také uvnitř ASAB Config a přístupná z webového rozhraní. Tato konfigurace je společná pro všechny služby ASAB. Skládá se z konfigurace Library a SMTP serveru.
- Konfigurace přítomná v modelu. Konfigurace instance přepisuje konfiguraci služby.
- Konfigurace z popisu služby.
- V neposlední řadě je výchozí konfigurace. Zajišťuje, že služba bude připojena k Library.
{ "library": { "providers": [ "zk:///library", "git+https://github.com/TeskaLabs/asab-maestro-library.git", ], } }
ASAB Governator technologie
Rozšiřuje konfiguraci instancí ASAB Governator tak, aby poskytovala aktuální URL spojení všech instancí ASAB Remote Control v clusteru. Neovlivňuje to jiné služby.
Část konfigurace ASAB Governator vytvořená technologií:
[remote_control]
url=http://asab-remote-control-1:8891/rc
http://asab-remote-control-2:8891/rc
http://asab-remote-control-3:8891/rc
ASAB Config technologie
Deskriptory mohou specifikovat výchozí konfigurace clusteru díky technologii ASAB Config.
Sekce deskriptoru asab-config
Tato technologie čte sekci asab-config ze všech deskriptorů a vytváří konfiguraci clusteru.
Například deskriptor Kafdrop specifikuje konfigurační soubor Kafdrop.json pro konfigurační typ Tools:
define:
type: rc/descriptor
name: Kafdrop
url: https://github.com/obsidiandynamics/kafdrop
descriptor:
image: obsidiandynamics/kafdrop
environment:
SERVER_PORT: 9000 # toto je jediný funkční port
SERVER_SERVLET_CONTEXTPATH: /kafdrop
KAFKA_BROKERCONNECT: '{{KAFKA_BOOTSTRAP_SERVERS}}'
asab-config:
Tools:
Kafdrop:
file:
{
"Tool": {
"image": "media/tools/kafka.svg",
"name": "Kafdrop",
"url": "/kafdrop"
},
"Authorization": {
"tenants": "system"
}
}
if_not_exists: true
Instrukce v deskriptoru je vytvořit konfiguraci Kafdrop typu Tools. Uvnitř konfigurace Kafdrop můžete vidět dvě sekce: file a if_not_exists.
- Sekce
fileočekává konfigurační soubor, což je json soubor přímo vložený do deskriptoru (jako zde v příkladu). Druhou možností je specifikovat soubor z adresáře/Site/Files/<service_id>/Knihovny, podobně jako vefilessekci deskriptoru. if_not_existsumožňuje pouze dvě možnosti:truenebofalse. Výchozí jefalse- to znamená, že konfigurace je nahrána a aktualizována podle deskriptoru pokaždé, když je model aplikován. Když jetrue, konfigurace je vytvořena pouze pokud ještě neexistuje. To znamená, že taková konfigurace může být změněna manuálně a nebude přepsána automatickými akcemi ASAB Remote Control. Na druhou stranu, taková konfigurace není aktualizována novými verzemi deskriptoru.
Elasticsearch v ASAB Maestro
Technologie Elasticsearch rozšiřuje konfiguraci služby Elasticsearch a spojuje Elasticsearch s ostatními službami.
Parametry
Seznam parametrů vytvořených technologií Elasticsearch, dostupných modelu a deskriptorům, kdykoli je Elasticsearch přítomen v instalaci.
- ELASTIC_HOSTS_KIBANA
-
Řetězec URL adres všech ElasticSearch master nodů.
"[http://lmc01:9200, http://lmc02:9201, http://lmc03:9202]"Deskriptor Kibana
define: type: rc/descriptor name: Kibana url: https://www.elastic.co/kibana descriptor: image: docker.elastic.co/kibana/kibana volumes: - "{{SITE}}/{{INSTANCE_ID}}/config:/usr/share/kibana/config" files: - "config/kibana.yml": | # https://github.com/elastic/kibana/blob/main/config/kibana.yml server.host: {{NODE_ID}} elasticsearch.hosts: {{ELASTIC_HOSTS_KIBANA}} elasticsearch.username: "elastic" elasticsearch.password: {{ELASTIC_PASSWORD}} xpack.monitoring.ui.container.elasticsearch.enabled: true server.publicBaseUrl: {{PUBLIC_URL}}/kibana server.basePath: "/kibana" server.rewriteBasePath: true - ELASTIC_PASSWORD
-
Tajný klíč umožňující přístup a zápis do Elasticsearch.
Konfigurace ASAB služeb
Každá ASAB služba obdrží konfigurační sekci elasticsearch.
[elasticsearch]
url=http://lmc01:9200
http://lmc02:9201
http://lmc03:9202
username=elastic
password=<ELASTIC_PASSWORD>
Konfigurace Elasticsearch
Proměnné prostředí
Existuje několik proměnných prostředí v deskriptoru Elasticsearch nastavených na null a nahrazených technologií.
- node.roles
-
Roles jsou načítány z modelu pro každou instanci. Názvy specifikované pro každou instanci (master, hot, warm, cold) jsou přeloženy do node.roles následovně:
- master ->
node.roles=master,ingest - hot ->
node.roles=data_content,data_hot - warm ->
node.roles=data_warm - cold ->
node.roles=data_cold
Jiné názvy a vrstvy nejsou podporovány Elasticsearchem ani ASAB Maestro.
- master ->
- http.port
-
Každá instance Elasticsearchu dostává jedinečný port podle své role. Všechny master instance začínají na 9200, všechny hot instance začínají na 9250, všechny warm instance začínají na 9300, všechny cold instance začínají na 9350.
- transport.port
-
Každá instance Elasticsearchu dostává jedinečný port pro vnitřní (mezi-elastickou) komunikaci. Všechny master instance začínají na 9400, všechny hot instance začínají na 9450, všechny warm instance začínají na 9500, všechny cold instance začínají na 9550.
- cluster.initial_master_nodes
-
Všechny master instance Elasticsearchu.
- discovery.seed_hosts
-
Všechny master nody kromě toho, který je právě konfigurován.
- ES_JAVA_OPTS
-
Pokud není
-Xmsjiž nastavena, nastaví se na-Xms2gpro master nody a-Xms28gpro ostatní nody. Pokud není-Xmxjiž nastavena, nastaví se na-Xmx2gpro master nody a-Xmx28gpro ostatní nody.
Certifikáty
Komunikace mezi instancemi Elasticsearch je zabezpečena certifikáty. Certifikáty jsou generovány ASAB Remote Control, pomocí jeho certifikační autority.
Konfigurace Nginx
Porty přiřazené master nodům jsou šířeny do konfigurace Nginx, aby vytvořily záznam upstream pro službu Elasticsearch.
InfluxDB v ASAB Maestro
Rozšiřuje konfiguraci služby InfluxDB a umožňuje ostatním službám se připojit k InfluxDB.
Parametry
Parametry Organization a bucket v konfiguraci InfluxDB jsou nastaveny striktně následujícím způsobem:
- INFLUXDB_ORG
-
system - INFLUXDB_BUCKET
-
metrics
Konfigurace ASAB Služeb
Každá ASAB služba získává konfigurační sekce asab:metrics a asab:metrics:influxdb.
[asab:metrics]
target=influxdb
[asab:metrics:influxdb]
url=http://influxdb:8086/
token=I1x1URqoTP31o6lmnZO1gbm_FkskGoIkRnsVKoJLmLSOd8YQQNoLBkRpDzSxVJR17JoFQ3DvMXcmJn9ItjLoTQ
bucket=metrics
org=system
Proměnné prostředí
- DOCKER_INFLUXDB_INIT_USERNAME a DOCKER_INFLUXDB_INIT_PASSWORD
-
ASAB Maestro vytvoří a uloží (ve Vault) správcovský přístup do InfluxDB.
Kafka v ASAB Maestro  
Poskytuje připojení ke všem službám prostřednictvím dynamické konfigurace ASAB nebo připojovacího řetězce KAFKA_BOOTSTRAP_SERVERS.
Parametry
- KAFKA_BOOTSTRAP_SERVERS
-
Čárkou oddělené URL adresy ke Kafka instancím
lmc01:9092,lmc02:9092,lmc03:9092
Konfigurace ASAB Služeb
Každá ASAB Služba získá sekci konfigurace kafka.
[kafka]
bootstrap_servers=lmc01:9092,lmc02:9092,lmc03:9092
Mongo DB v ASAB Maestro
Umožňuje ostatním službám se připojit k databázi Mongo. Parametry jsou také používány Mongo a SeaCat Auth sherpy.
Parametry
- MONGO_HOSTNAMES
-
čárkami oddělené instance ID všech Mongo instancí
mongo-1,mongo-2,mongo-3 - MONGO_URI
-
URI ke všem Mongo instancím
mongodb://mongo-1,mongo-2,mongo-3/?replicaSet=rs0 - MONGO_REPLICASET
- je nastaven na
rs0
Konfigurace ASAB Služeb
Každá ASAB Služba získá konfigurační sekci mongo.
[mongo]
url=mongodb://mongo-1,mongo-2,mongo-3/?replicaSet=rs0
NGINX v ASAB Maestro
Technologie NGINX poskytuje:
- Schopnosti aplikační brány
- Vyvažování zátěže
- Průzkumník služeb
- Autorizaci pro další služby v clusteru
Servery
ASAB Maestro organizuje konfiguraci NGINX do následující struktury:
- HTTP server:
http, viz config - HTTPS server:
https, viz config - Interní HTTP server na portu tcp/8890:
internal, viz config - Upstreamy
Konfigurace NGINX v deskriptorech
Sekce nginx deskriptoru poskytuje informace o tom, jak očekává příslušná služba, že bude NGINX nakonfigurován.
To znamená, že specifikuje pravidla proxy přeposílání, která zpřístupňují API mikroslužby.
Příklad deskriptoru /Site/.../Descriptors/foobar.yaml:
define:
type: rc/descriptor
...
nginx:
api:
port: 5678
upstreams:
upstream-foobar-extra: 1234
https:
location = /_introspect:
- internal
- proxy_method POST
- proxy_pass http://{{UPSTREAM}}/introspect
- proxy_ignore_headers Cache-Control Expires Set-Cookie
location /subpath/api/foobar:
- rewrite ^/subpath/api/(.*) /$1 break
- proxy_pass http://upstream-foobar-extra
server:
- ssl_client_certificate shared/custom-certificate.pem
- ssl_verify_client optional
Konverze konfigurace NGINX do YAML
Konfigurace NGINX v ASAB Maestro je přeložena do YAML, aby mohla být zahrnuta v modelu nebo deskriptorech.
Následující úryvek konfigurace NGINX:
location /api/myapp {
rewrite ^/api/myapp/(.*) /myapp/$1 break;
proxy_pass http://my-server:8080;
}
se stane v souborech YAML ASAB Maestro:
location /api/myapp:
- rewrite ^/api/myapp/(.*) /myapp/$1 break
- proxy_pass http://my-server:8080
Podobně můžete přidat konfiguraci do bloku serveru:
server:
- ssl_client_certificate shared/lmio-receiver/client-ca-cert.pem
- ssl_verify_client optional
Sekce api
Sekce api umožňuje rychlé specifikování "hlavního" API služby.
Klíč port specifikuje TCP port, na kterém je API vystaveno službou.
Tato položka vygeneruje příslušné položky location a upstream.
Plná automatizace
Sekce api může být snadno jedinou sekcí v části nginx deskriptoru služby.
Sekce upstream
Definuje specifické upstreamy pro službu. Každá instance služby bude přidána do záznamu upstreamů v konfiguraci NGINX.
Navštivte dokumentaci Nginx, abyste se dozvěděli více o upstream direktivě.
Příklad:
nginx:
upstreams:
upstream-foobar: 1234
Služba foobar má publikované API na portu tcp/1234. Další záznam upstream je definován a pojmenován upstream-foobar.
Předpokládáme-li tři instance služby foobar na třech uzlech, výsledná konfigurace upstream je:
upstream upstream-foobar {
keepalive 32;
server server1:3081;
server server2:3081;
server server3:3081;
}
Pokročilé použití upstreamů
Můžete definovat upstream jako seznam pro přidání dalších konfiguračních možností.
Například SeaCat Auth, server pro autorizaci, vyžaduje, aby požadavky od jednoho uživatele během jedné relace byly odesílány na stejnou instanci služby. NGINX to může zajistit pomocí metody vyvažování ip_hash.
Zde je sekce deskriptoru definující upstreamy pro SeaCat Auth:
nginx:
upstreams:
upstream-seacat-auth-public:
- port 3081
- ip_hash
upstream-seacat-auth-private:
- port 8900
- ip_hash
Předpokládáme-li, že node1 a node2 jsou názvy uzlů v clusteru, výsledná konfigurace NGINX pro upstreamy bude:
upstream upstream-seacat-auth-public {
keepalive 32;
server node1:3081;
server node2:3081;
ip_hash;
}
upstream upstream-seacat-auth-private {
keepalive 32;
server node1:8900;
server node2:8900;
ip_hash;
}
V seznamu můžete specifikovat jakoukoli další konfiguraci, kterou chcete přidat do konfigurace upstream.
Direktiva port není přímo používána NGINX, ale zpracovává ji Maestro.
Konfigurace server je přidána pro každou instanci služby (v tomto případě SeaCat Auth) přítomnou v clusteru.
Konfigurace serveru
Další možnosti jsou implementovány pro každý server zvlášť (http, https, internal).
Dodatečné lokace mohou být specifikovány pro server.
Sekce location
Typicky, proxy konfigurace konkrétní komponenty nebo lokace staticky obsluhovaného obsahu.
Každá další lokace je přidána do konfigurace nginx jednou za službu, pokud není parametr INSTANCE_ID použit v hlavičce lokace. Pak je lokace zavedena pro každou instanci.
Sekce server
Konfigurace bloku serveru.
Konfigurace NGINX na úrovni modelu
Na úrovni modelu můžete specifikovat vlastní konfiguraci NGINX, která přepíše vygenerovanou konfiguraci.
V příkladu přidává extra sekce v model.yaml location "/my-special-location" na https server.
define:
type: rc/model
...
nginx:
https:
location /my-special-location:
- gzip_static on
- alias /webroot/lmio-webui/dist
Můžete také nastavit konfiguraci serveru a upstream. Možnost port v konfiguraci upstream není podporována v přepsání modelu.
Distribuce webových aplikací
Technologie NGINX slouží pro webové aplikace.
sherpa webapp-dist stahuje a instaluje webové aplikace definované v modelu.
Webové aplikace budou nasazeny (pokud je to potřeba) pokaždé, když je model aplikován (tj. je vydán příkaz "up").
Příklad model.yaml:
define:
type: rc/model
...
webapps:
/: Moje webová aplikace
/auth: SeaCat Auth WebUI
/influxdb: InfluxDB UI
...
Sekce webapps v modelu předepisuje nasazení tří webových aplikací:
- "Moje webová aplikace" bude nasazena do umístění
/na HTTPS serveru - "SeaCat Auth WebUI" bude nasazena do umístění
/authna HTTPS serveru - "InfluxDB UI" bude nasazena do umístění
/influxdbna HTTPS serveru
Podporované typy webových aplikací:
SeaCat Auth v ASAB Maestro
SeaCat Auth je open-source technologie pro kontrolu přístupu vyvinutá v TeskaLabs.
Integrace do ASAB Maestro zajišťuje automatickou introspekci pro všechny api lokace na https serveru.
"Sherpa obsahu Mongo" služby SeaCat Auth vytváří záznamy v databázi auth v Mongo. Pomáhá integrovat autorizaci třetích stran.
Další služby mohou přidat dodatečnou konfiguraci instancí SeaCat Auth, pokud je to potřeba.
Sekce deskriptoru seacat-auth
Každý deskriptor může použít sekci seacat-auth k přidání konfigurační sekce do služby SeaCat Auth a požadovaných dat do databáze auth v Mongo.
seacat-auth:
config:
"batman:elk":
url: "http://{{NODE_ID}}:9200"
username: elastic
password: "{{ELASTIC_PASSWORD}}"
content:
- "cl.json": |
[{
"_id": "kibana",
"application_type": "web",
"authorize_anonymous_users": false,
"client_name": "Kibana",
"code_challenge_method": "none",
"grant_types": [
"authorization_code"
],
"redirect_uri_validation_method": "prefix_match",
"redirect_uris": [
"{{PUBLIC_URL}}/kibana"
],
"response_types": [
"code"
],
"token_endpoint_auth_method": "none",
"cookie_entry_uri": "{{PUBLIC_URL}}/api/cookie-entry",
"client_uri": "{{PUBLIC_URL}}/kibana"
}]
Sekce seacath-auth:config
Přidá konfiguraci do všech instancí SeaCat Auth ve formátu YAML.
Sekce seacat-auth:content
Stejně jako v sekci files sekce deskriptoru, toto je seznam záznamů.
Každý záznam je buď název souboru uvnitř adresáře /Site/Files/<service_id>/ nebo záznam klíč:hodnota, kde klíč je název souboru a hodnota je samotný soubor napsaný jako řetězec.
Název souboru musí odpovídat názvu cílové Mongo kolekce.
Interakce s konfigurací NGINX
Přítomnost SeaCat Auth v clusteru přidává introspekci do konfigurace NGINX. Introspekční endpoint je přidán a všechny lokace NGINX pocházející z nginx:api používají tuto introspekci.
S SeaCat Auth v clusteru mohou do backendových služeb projít pouze autorizované požadavky.
Pro interní komunikaci mezi službami použijte internal HTTP server nginx.
Například, asab-governator lokace, která vyžaduje introspekční endpoint (zpracovávaný SeaCat Auth)
# GENEROVANÝ SOUBOR!
location /api/asab-governator {
auth_request /_oauth2_introspect;
auth_request_set $authorization $upstream_http_authorization;
proxy_set_header Authorization $authorization;
rewrite ^/api/asab-governator/(.*) /$1 break;
proxy_pass http://upstream-asab-governator-8892;
# GENEROVANÝ SOUBOR!
location = /_oauth2_introspect {
internal;
proxy_method POST;
proxy_set_body "$http_authorization";
proxy_pass http://upstream-seacat-auth-private/nginx/introspect/openidconnect;
proxy_set_header X-Request-URI "$scheme://$host$request_uri";
proxy_ignore_headers Cache-Control Expires Set-Cookie;
proxy_cache oauth2_introspect;
proxy_cache_key "$http_authorization $http_sec_websocket_protocol";
proxy_cache_lock on;
proxy_cache_valid 200 30s;
ZooKeeper v ASAB Maestro
ZooKeeper je technologie konsenzu pro ASAB Maestro. Všechny ostatní služby musí komunikovat se ZooKeeperem, aby měly přístup k datům na úrovni clusteru. Proto je řetězec serveru ZooKeeper poskytován jako parametr pro všechny služby a služby ASAB získávají konfigurační sekci [zoookeeper] z technologie ZooKeeper.
Parametry
- ZOOKEEPER_SERVERS
-
Adresy všech instancí ZooKeeper, oddělené čárkami. V tříuzlovém clusteru (s uzly pojmenovanými lm1, lm2, lm3) by parametr
ZOOKEEPER_SERVERSbyl nahrazen řetězcemlm1:2181,lm2:2181,lm3:2181.Příklad
define: type: rc/descriptor name: Webové uživatelské rozhraní ZooKeeper url: https://zoonavigator.elkozmon.com/ descriptor: image: elkozmon/zoonavigator volumes: - "{{SLOW_STORAGE}}/{{INSTANCE_ID}}/logs:/app/logs" environment: HTTP_PORT: "9001" CONNECTION_ZK_NAME: Lokální ZooKeeper CONNECTION_ZK_CONN: "{{ZOOKEEPER_SERVERS}}" AUTO_CONNECT_CONNECTION_ID: ZK BASE_HREF: /zoonavigator
Konfigurace služeb ASAB
Každá služba ASAB získává konfigurační sekci zookeeper.
[zookeeper]
servers=lmc01:2181,lmc02:2181,lmc03:2181
Proměnné prostředí
Dostupné pouze pro příslušnou instanci ZooKeeper.
- ZOO_MY_ID
-
Číslo instance každé instance ZooKeeper se stává proměnnou prostředí
ZOO_MY_IDkontejneru ZooKeeper (Docker). Proto může být přejmenování instancí ZooKeeper v modelu problematické.
Consensus
Konsensus v ASAB Maestro
LogMan.io je klastrová technologie. Tento fakt přináší do produktu vysokou dostupnost a bezpečnost. Nicméně to také zvyšuje složitost systému. Mnoho služeb a mikroslužeb musí mezi sebou komunikovat v rámci clusteru a sdílet data. Používáme Apache ZooKeeper jako technologii konsensu v distribuovaném systému. V ZooKeeper mají všechny služby přístup k "společné pravdě" bez ohledu na to, kde v clusteru se nacházejí.
Jádro „běžné pravdy“ je uloženo v uzlu /asab v ZooKeeperu.
/asab obsah
Můžete si všimnout, že některé informace o clustru se překrývají. Abychom poskytli spolehlivá data o clustru, používáme více zdrojů dat. Můžete si také všimnout více strategií objevování služeb a vícestupňového monitorování.
Certificate Authority
ASAB Remote Control vytváří a provozuje interní Certificate Authority (CA).
Technologie využívající CA
Elasticsearch
Komunikace mezi instancemi Elasticsearch je zabezpečena vlastními certifikáty, které jsou automaticky generovány ASAB Remote Control během instalace ElasticSearch.
Nginx
Nginx je ve výchozím nastavení vybaven SSL certifikáty z lokální CA.
Konfigurace Clusteru
Ukládá vlastní konfigurační možnosti specifické pro nasazení a velmi často společné pro více služeb v clusteru.
Konfigurace ASAB
Microservice ASAB Config je pravděpodobně nejmenší microservice v ekosystému LogMan.io, ačkoli to nesnižuje jeho důležitost. Poskytuje REST API pro obsah konfigurace clusteru, kterou většinou využívá Web UI.
Konfigurace je dostupná a editovatelná z Web UI.
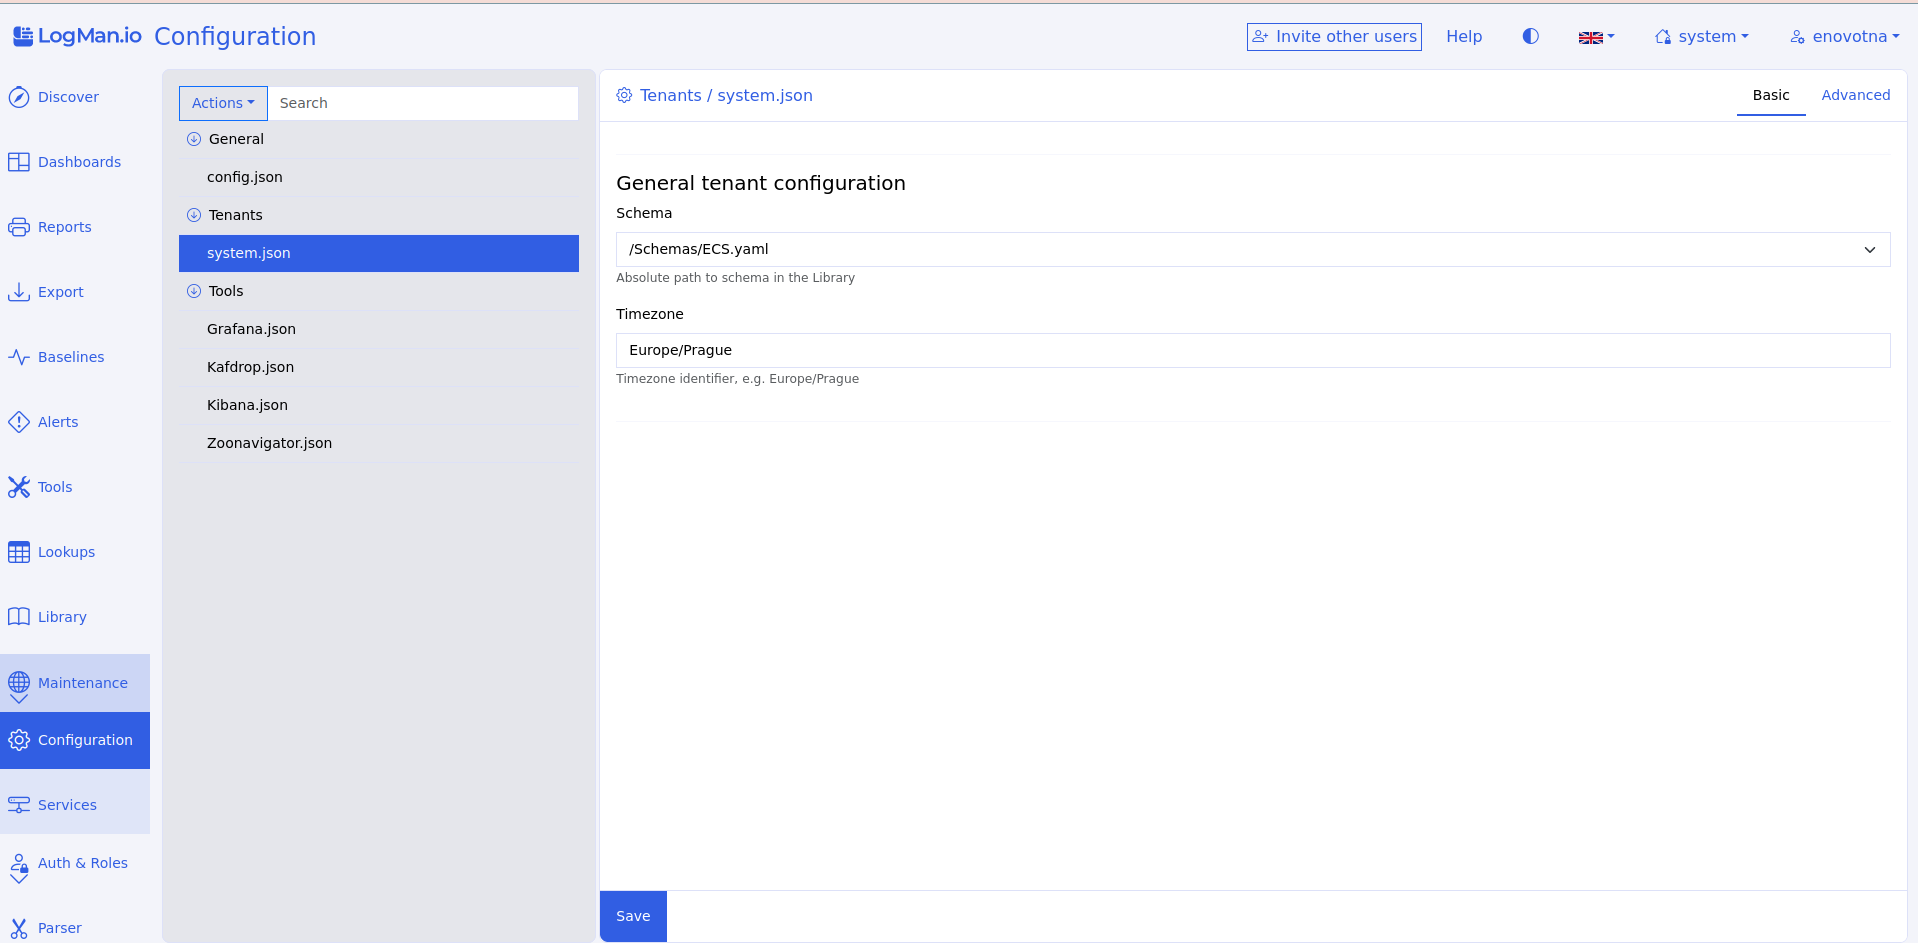
Organizace konfigurace clusteru
Konfigurace clusteru je organizována podle konfiguračních typů. Každý typ (např. Objevování, Tenants) poskytuje JSON schéma popisující povahu konfiguračních souborů.
Každý konfigurační soubor musí odpovídat JSON schématu svého typu.
Struktura ZooKeeper node /asab/config:
- /asab/config/
- Objevování/
- lmio-system-events.json
- lmio-system-others.json
- Tenants/
- system.json
Příklad JSON schématu asab/config/Tenants:
{
"$id": "Tenants schema",
"type": "object",
"title": "Tenants",
"description": "Konfigurace dat tenanta",
"default": {},
"examples": [
{
"General": {
"schema": "/Schemas/ECS.yaml",
"timezone": "Europe/Prague"
}
}
],
"required": [],
"properties": {
"General": {
"type": "object",
"title": "Obecná konfigurace tenanta",
"description": "Data specifická pro tenanta",
"default": {},
"required": [
"schema",
"timezone"
],
"properties": {
"schema": {
"type": "string",
"title": "Schéma",
"description": "Absolutní cesta k schématu v knihovně",
"default": [
"/Schemas/ECS.yaml",
"/Schemas/CEF.yaml"
],
"$defs": {
"select": {
"type": "select"
}
},
"examples": [
"/Schemas/ECS.yaml"
]
},
"timezone": {
"type": "string",
"title": "Časová zóna",
"description": "Identifikátor časové zóny, např. Europe/Prague",
"default": "",
"examples": [
"Europe/Prague"
]
}
}
}
},
"additionalProperties": false
}
Příklad /asab/config/Tenants/system.json:
{
"General": {
"schema": "/Schemas/ECS.yaml",
"timezone": "Europe/Prague"
}
}
Uzly Clusteru
Příklad organizace /asab/nodes:
- /asab/nodes/
- cluster_node_1/
- governator-<uuid>.json
- info.json
- mailbox/
- cluster_node2/
- cluster_node3/
Upozornění
V tomto kapitole je bohužel terminologický rozpor. V ASAB Maestro je slovo "uzel" vyhrazeno pro "clusterový uzel" - typicky izolovaný server připojený k síti s ostatními servery, které tvoří cluster.
Avšak technologie ZooKeeper používá termín "uzel" pro svou strukturu souborů. Uzly ZooKeeper mohou obsahovat jak data, tak i poduzly. V přirovnání k souborovému systému, každý uzel se chová současně jako soubor i adresář. Kde to jen lze, označujeme uzly ZooKeeper jako soubory a adresáře. Když je uzel používán jak k ukládání dat, tak poduzlů, tato zjednodušení nefunguje. Tehdy používáme termíny "clusterový uzel" a "ZooKeeper uzel" pro jasnost.
Clusterový uzel
Každý ZooKeeper uzel uvnitř /asab/nodes (např. cluster_node_1/) obsahuje IP adresu připojeného clusterového uzlu.
ip:
- 10.25.128.81
Připojení ASAB Governatora
Soubor governator-<uuid>.json obsahuje informace o websocketovém připojení z instance ASAB Governator přítomné na tom clusterovém uzlu.
Každé připojení je označeno uuid pro zamezení překrývání dvou pokusů o připojení. Avšak jeden clusterový uzel by měl vytvořit pouze jedno Remote Control-Governator připojení.
{"address": "10.25.128.81", "rc_node_id": "cluster_node_1"}
Podrobné informace o clusterovém uzlu
info.json obsahuje data o uzlu sesbírané ASAB Governatorem. Aktualizují se pravidelně, ale nejsou uchovávána. Historická data nejsou přítomna. Sledujte místo toho metriky ASAB, InfluxDB a Grafana dashboardy pro získání informací o zdraví clusteru v čase.
Poštovní schránka
Adresář mailbox/ pomáhá řídit úkoly mezi dvěma typy služeb.
Instance ASAB Remote Control jsou identické napříč clusterem a mohou se navzájem zastupovat.
Naopak mikroservisy ASAB Governatora jsou pro každý uzel unikátní a nemohou být nahrazeny jinými.
Poštovní schránka (mailbox) funguje jako spojení mezi těmito službami, umožňuje komunikaci a koordinaci úkolů.
Když uživatel odešle instrukce z Web UI, poštovní schránka pomáhá instancím ASAB Remote Control najít a komunikovat s příslušným ASAB Governatorem pro provedení úkolu.
Instance ASAB Remote Control s pokyny od uživatele "odesílá zprávu" instanci ASAB Remote Control s cílovým připojením ASAB Governatora.
Spouštění mikroservis ASAB
Každá instance mikroservisy ASAB může aktivně propagovat data o sobě do konsenzu.
Používají se efemérní a sekvenční uzly ZooKeeperu. To znamená, že:
- Každá běžící instance vytváří uzel ZooKeeper.
- Každý uzel je propojen s běžícím mikroslužbou. Když mikroslužba přestane běžet, uzel ZooKeeper zmizí.
Co se z těchto dat můžete naučit o každém případě mikroservis ASAB:
- Instance je spuštěná a běží
- Uzel clusteru, na kterém běží
- Technologie kontejnerizace (Docker, Podman nebo žádná)
- Verze image a kdy a jak byla vytvořena
- Čas vytvoření a spuštění kontejneru
- Port otevřený pro webové požadavky
- Stav zdraví, pokud to může daná mikroslužba indikovat
Tato data inzerovaná běžícími ASAB mikroservisami patří mezi vstupy pro monitorování clusteru a slouží při objevování služeb.
Příklad uzlu ZooKeeper /asab/run:```
- /asab/run/
- ASABConfigApplication.0000000108
- ASABConfigApplication.0000000115
- ASABConfigApplication.0000000144
- ASABGovernatorApp.0000000095
- ASABGovernatorApp.0000000098
- ASABGovernatorApp.0000000104
- ASABLibraryApplication.0000000113
- ASABLibraryApplication.0000000114
- ASABLibraryApplication.0000000147
- ASABRemoteControlApp.0000000109
- ASABRemoteControlApp.0000000110
- ASABRemoteControlApp.0000000107
Příklad `/asab/run/ASABConfigApplication.0000000108`:```json
{
"host": "asab-config-3",
"appclass": "ASABConfigApplication",
"launch_time": "2023-12-19T09:52:46.468038Z",
"process_id": 1,
"instance_id": "asab-config-3",
"node_id": "lmc03",
"service_id": "asab-config",
"containerized": true,
"created_at": "2023-11-06T17:18:54.206827Z",
"version": "v23.45",
"CI_COMMIT_TAG": "v23.45",
"CI_COMMIT_REF_NAME": "v23.45",
"CI_COMMIT_SHA": "cf3be4570f363b8e9ed400ffbaea8babac957688",
"CI_COMMIT_TIMESTAMP": "2023-11-06T17:15:54+00:00",
"CI_JOB_ID": "55305",
"CI_PIPELINE_CREATED_AT": "2023-11-06T17:16:58Z",
"CI_RUNNER_ID": "74",
"CI_RUNNER_EXECUTABLE_ARCH": "linux/amd64",
"web": [
[
"0.0.0.0",
8894
]
]
}
Kontejnery spravované ASAB Maestro
Hostname a název kontejneru
hostname a container_name je nastaven na INSTANCE_ID (např. mongo-1).
/etc/hosts
/etc/hosts je poskytnut ASAB Maestrem s názvy a IP adresami všech instancí v clusteru.
To je používáno pro účely průzkumu služeb.
Příklad /etc/hosts:
# Tento soubor je generován ASAB Remote Control
# VAROVÁNÍ: NEUPRAVUJTE HO RUČNĚ !!!
127.0.0.1 localhost
::1 localhost ip6-localhost ip6-loopback
fe00::0 ip6-localnet
ff00::0 ip6-mcastprefix
ff02::1 ip6-allnodes
ff02::2 ip6-allrouters
# Uzly
192.168.64.1 node1
192.168.64.2 node2
# Instance
192.168.64.1 zoonavigator-1
192.168.64.1 nginx-1
192.168.64.1 mongo-1
192.168.64.1 seacat-auth-1
192.168.64.2 zookeeper-1
192.168.64.2 asab-governator-1
192.168.64.2 asab-library-1
192.168.64.2 asab-config-1
Poznámka
Soubor hosts se nachází na /opt/site/hosts a je připojen do kontejnerů.
Proměnné prostředí
Následující proměnné prostředí jsou dostupné každé instanci:
NODE_IDSERVICE_IDINSTANCE_ID
Poznámka
Další proměnné prostředí mohou být poskytnuty technologiemi.
Průzkum Služeb
Průzkum služeb v ASAB Maestro představuje skupinu technik, jak nalézt a dosáhnout specifickou službu v síti clusteru.
Identita
Každé instanci jsou přiřazeny tři identifikátory:
- NODE_ID - identifikátor uzlu clusteru
- SERVICE_ID - jméno služby
- INSTANCE_ID - identifikátor instance
Tímto způsobem je umožněno hledat služby v různých situacích podle stejných jmen.
NGINX proxy server
Možnost nginx:api v deskriptorech vytváří standardizovanou konfiguraci Nginx.
Příklad deskriptoru ASAB Library:
define:
type: rc/descriptor
name: ASAB Library
descriptor:
image: docker.teskalabs.com/asab/asab-library
volumes:
- "{{SITE}}/{{INSTANCE_ID}}/conf:/conf:ro"
- "{{SLOW_STORAGE}}/{{INSTANCE_ID}}:/var/lib/asab-library"
asab:
configname: conf/asab-library.conf
config: {}
nginx:
api: 8893
Všechny instance jsou dodávány s umístěním uvnitř konfigurace Nginx.
location /api/<instance_id> {
...
}
Navíc, každá služba má své vlastní umístění a odpovídající záznam upstreams. Váš požadavek je proxyován na náhodnou instanci služby.
location /api/<service_id> {
...
}
Tato umístění jsou přístupná na:
- HTTPS serveru za OAuth2 introspekcí (pokud je nainstalován autorizační server jako například SeaCat Auth) určené především pro Web UI,
- a
internímserveru. Tento server je přístupný z vnitřku clusteru, nesmí být otevřen pro internet a slouží pro interní komunikaci backendových služeb.
PUBLIC_URL
Je klíčové pro funkčnost HTTPS serveru a úspěšné autorizace nastavit parametr PUBLIC_URL v modelu.
define:
type: rc/model
services:
zoonavigator:
instances: {1: {node: "lmc01"} }
params:
PUBLIC_URL: "https://maestro.logman.io"
Vlastní /etc/hosts
Každému běžícímu kontejneru je poskytnuta vlastní a automaticky aktualizovaná konfigurace uvnitř /etc/hosts. IP adresa každé služby nebo instance je rozřešena pomocí příslušných INSTANCE_ID nebo SERVICE_ID.
Příklad /etc/hosts uvnitř kontejneru:
# Tento soubor je generován ASAB Remote Control
# UPOZORNĚNÍ: NEMODIFIKUJTE HO RUČNĚ !!!
127.0.0.1 localhost
::1 localhost ip6-localhost ip6-loopback
fe00::0 ip6-localnet
ff00::0 ip6-mcastprefix
ff02::1 ip6-allnodes
ff02::2 ip6-allrouters
# Uzly
10.35.58.41 lmc02
10.35.58.194 lmc03
10.35.58.88 lmc01
# Instance
10.35.58.88 zoonavigator-1
10.35.58.88 mongo-1
10.35.58.41 mongo-2
10.35.58.194 mongo-3
10.35.58.88 seacat-auth-1
10.35.58.88 nginx-1
10.35.58.88 asab-config-1
10.35.58.41 asab-config-2
10.35.58.194 asab-config-3
10.35.58.88 asab-governator-1
10.35.58.41 asab-governator-2
10.35.58.194 asab-governator-3
10.35.58.88 asab-library-1
10.35.58.41 asab-library-2
10.35.58.194 asab-library-3
10.35.58.88 asab-remote-control-1
10.35.58.41 asab-remote-control-2
10.35.58.194 asab-remote-control-3
10.35.58.88 zookeeper-1
10.35.58.41 zookeeper-2
10.35.58.194 zookeeper-3
# Služby
10.35.58.88 zoonavigator
10.35.58.88 mongo
10.35.58.41 mongo
10.35.58.194 mongo
10.35.58.88 seacat-auth
10.35.58.88 nginx
10.35.58.88 asab-config
10.35.58.41 asab-config
10.35.58.194 asab-config
10.35.58.88 asab-governator
10.35.58.41 asab-governator
10.35.58.194 asab-governator
10.35.58.88 asab-library
10.35.58.41 asab-library
10.35.58.194 asab-library
10.35.58.88 asab-remote-control
10.35.58.41 asab-remote-control
10.35.58.194 asab-remote-control
10.35.58.88 zookeeper
10.35.58.41 zookeeper
10.35.58.194 zookeeper
Konsenzus a data propagovaná běžícími ASAB mikroslužbami
Každá ASAB mikroslužba propaguje data o sobě do konsenzu. Tato data obsahují NODE_ID, SERVICE_ID a INSTANCE_ID rozřešené díky vlastnímu /etc/hosts a portu. ASAB framework také nabízí vzorový kód pro použití aiohttp klientských požadavků s pouze SERVICE_ID nebo INSTANCE_ID cílové služby. Tímto způsobem má každá ASAB mikroslužba nástroje pro přístup k jakékoliv jiné ASAB mikroslužbě v clusteru.
Příklad python kódu v rámci ASAB aplikace používající Průzkum Služeb
async def proxy_to_iris(self, json_data):
async with self.App.DiscoveryService.session() as session:
try:
async with session.put("http://asab-iris.service_id.asab/send_mail", json=json_data) as resp:
response = await resp.json()
except asab.api.discovery.NotDiscoveredError:
raise RuntimeError("ASAB Iris nemohl být dosažen.")
ASAB Governator
ASAB Governator - nebo asab-governator - je mikroslužba, která musí běžet na každém uzlu clusteru.
Připojení k ASAB Remote Control
ASAB Governator je připojen k ASAB Remote Control. Lokální (tj. localhost) připojení je preferované pro základní uzly, ale ASAB Governator se připojí k jiným instancím ASAB Remote Control, pokud není přítomna lokální instance. ASAB Governator se nakonec znovu připojí (pokud je to možné) k lokální instanci.
Údržba
ASAB Governator pravidelně plánuje spouštění příkazu docker system prune k odstranění starých a nepoužívaných obrazů kontejnérů a dalších dat.
Vault
Vault je centralizované clusterové úložiště tajemství a citlivých konfiguračních dat v ASAB Maestro. Zpřístupňuje ho ASAB Remote Control prostřednictvím jednoduchého REST API. Vault poskytuje jedno místo pro API tokeny, hesla a TLS certifikáty, která služby v clusteru mohou bezpečně používat.
Vault API
Vault zpřístupňuje služba ASAB Remote Control na výchozím webovém portu 8891 (viz Síťové porty).
| Metoda | Cesta | Popis |
|---|---|---|
GET |
/vault |
Seznam všech názvů parametrů ve Vaultu. |
PUT |
/vault/{parameter} |
Uložení nebo aktualizace tajemství. Tělo požadavku je surová hodnota tajemství. |
DELETE |
/vault/{parameter} |
Smazání tajemství. |
Poznámky k API:
- Názvy parametrů jsou necitlivé na velikost písmen a vždy se normalizují na malá písmena.
LDAP_USER_PASSWORDaldap_user_passwordodkazují na stejný záznam ve Vaultu. DELETEneexistujícího parametru vrací404.
Vault z příkazové řádky
Vault spravujete pomocí /opt/site/gov.sh curl z libovolného uzlu, na kterém běží ASAB Remote Control (port 8891 na localhost). Volání jsou interně autorizována.
Příkazy spouštějte přímo na uzlu:
# Seznam všech parametrů ve Vaultu
/opt/site/gov.sh curl localhost:8891/vault
# Uložení tajemství jako prostý text
/opt/site/gov.sh curl -X PUT localhost:8891/vault/MY_API_TOKEN --data 'supersecret'
# Uložení tajemství ze souboru (např. certifikát nebo klíč)
/opt/site/gov.sh curl -X PUT localhost:8891/vault/ldap_tls_cafile --data-binary '@/absolute/path/to/cafile.crt'
# Smazání tajemství
/opt/site/gov.sh curl -X DELETE localhost:8891/vault/MY_API_TOKEN
Pro hodnoty s konci řádků (PEM certifikáty, privátní klíče) použijte --data-binary '@file'.
Pro jednořádkový řetězec použijte --data 'value'.
Vault v modelu
Deklarace tajemství
Tajemství deklarujete v sekci secrets modelu nebo deskriptoru.
Deklarace uvádí pouze název a volitelně type a length; hodnota se do modelu nezapisuje.
secrets:
API_TOKEN:
type: token
length: 32
SHARED_SECRET: {}
Pokud tajemství ve Vaultu při aplikaci modelu neexistuje, ASAB Maestro vygeneruje náhodný token požadované délky a uloží ho do Vaultu.
Použití tajemství
Po deklaraci je tajemství dostupné jako parametr šablony Jinja2 pod svým názvem. Použijte ho kdekoli model nebo deskriptor podporuje templating, například v konfiguraci služby:
services:
seacat-auth:
...
asab:
config:
"seacatauth:credentials:ldap:external":
...
password: "{{API_TOKEN}}"
Tajemství deklarovaná v modelu jsou dostupná v celém clusteru. Tajemství v deskriptoru jsou vázána na danou službu (viz Deskriptory).
Soubory z Vaultu
Chcete-li zpřístupnit tajemství ze Vaultu jako soubor v kontejneru, namapujte ho v položce files.
Následující příklad zpřístupní tři LDAPS soubory ze Vaultu službě seacat-auth:
services:
seacat-auth:
...
files:
- "/conf/tls_cafile.crt": "{{LDAP_TLS_CAFILE}}"
- "/conf/tls_certfile.crt": "{{LDAP_TLS_CERTFILE}}"
- "/conf/tls_keyfile.pem": "{{LDAP_TLS_KEYFILE}}"
secrets:
LDAP_TLS_CAFILE: {}
LDAP_TLS_CERTFILE: {}
LDAP_TLS_KEYFILE: {}
Před aplikací modelu nahrajte skutečný obsah souborů do Vaultu (viz Vault z příkazové řádky).
Kompletní postup viz Integrace LDAP serveru.
Související návody
- Aktualizace certifikátu Nginx — nahrajte
nginx_certificateanginx_private_keydo Vaultu a nahraďte výchozí self-signed certifikát. - Integrace LDAP serveru — uložte LDAP bind heslo a TLS soubory do Vaultu.
- Připojení Microsoft 365 pro e-mailové notifikace — uložte přihlašovací údaje Azure aplikace do Vaultu.
Sloučovací algoritmus
Tento algoritmus je nedílnou součástí kompozitelnosti v ASAB Maestro.
ASAB Maestro komponuje různé artefakty do konfigurace webu. V příkladech:
- Můžete přepsat popisovač v modelu
- Generovaná konfigurace Elasticsearch je poskytována každému konfiguračnímu souboru každé mikroservisy ASAB.
Každé prohlášení nebo konfigurace může být transformováno do objektu (nebo Python slovníku) nebo pole (nebo Python seznamu) nebo jejich kombinace.
Sloučovací algoritmus bere dva objekty (slovníky) s prioritou. Jeden objekt je vždy "důležitější". Když začnou objekty slučovat dohromady, jejich obsah se porovnává. Pokud je jejich obsah zcela odlišný, výsledný objekt obsahuje všechny informace z obou. Při konfliktu, když oba objekty obsahují stejný klíč, pouze hodnota z "důležitějšího" objektu se zahrne do výsledku. Pokud jsou porovnávány dvě pole, výsledek je součet polí (seznamů).
Event Lane Manager
LogMan.io Správce Event Lane
TeskaLabs LogMan.io Správce Event Lane (nebo zkráceně LogMan.io Elman) je mikroslužba zodpovědná za správu event lane.
- Přečtěte si více o event lane a jejich deklaracích v Event Lane.
- Přečtěte si více o funkcionalitě LogMan.io Elman a automatickém vytváření event lane v Streams.
- Pro nasazení mikroslužby LogMan.io Elman viz Konfigurace.
Note
LogMan.io Elman je náhledová funkce, která se v budoucnu stane standardní součástí TeskaLabs LogMan.io.
Konfigurace
Závislosti
- Apache Zookeeper je použit pro čtení konfigurace tenantů.
- Apache Kafka je použita pro správu Kafka témat a automatickou detekci nových streamů.
- ASAB Remote Control je potřeba pro vytvoření LMIO Parsecs.
- ASAB Library je potřeba pro nahrávání event lanes do knihovny.
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Apply.
define:
type: rc/model
services:
lmio-elman:
- <node> # Nahraďte názvem uzlu
Požadovaná konfigurace
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[library]
providers=
zk:///library
# (více vrstev, pokud je potřeba...)
Volitelná konfigurace
Volitelně lze počet partišonů a politiku uchovávání konfigurovat v sekci [kafka].
[kafka]
enabled=true # Lze vypnout
partitions=6 # (výchozí: 6) Výchozí počet partišonů Kafka přijatých, událostí a dalších témat
retention.ms_max=604800000 # (výchozí: 7 dní) Maximální doba uchovávání Kafka témat, snížena na optimální, pokud je vyšší
retention.ms_min=172800000 # (výchozí: 24 hodin) Minimální doba uchovávání Kafka témat, zvýšena na optimální, pokud je nižší
retention.ms_optimal=259200000 # (výchozí: 3 dny) Optimální doba uchovávání Kafka témat
Event lane
Když připojíte nový logovací zdroj do LogMan.io Collector, který je přiřazen k jednomu tenantovi, události se začnou posílat do LogMan.io Archive. LogMan.io Receiver vytvoří nový stream pro tyto události, aby je ukládal v logickém pořadí. Proto každý tenant vlastní několik streamů. Události z konkrétního streamu mohou být (okamžitě nebo později) vytaženy z Archivu pro parsování a ukládání do databáze Elasticsearch pro další analýzu.
K vytvoření logického datového streamu v LogMan.io (z Archivu přes Kafka do Elasticsearch) a propojení přilehlého obsahu v Library (dashboardy, reporty, korelace, atd.), se používá koncept event lane. Event lane je reprezentován deklarací v Library, která určuje:
- Jaká pravidla pro parsování budou aplikována na datový stream
- Jaký obsah z Library je přiřazen k datovému streamu
- Kategorizace datového streamu (např. kategorizace technologie, která produkuje tyto události)
- Jaké schéma je použito pro konečná strukturovaná data
- Jaké další obohacení bude aplikováno na stream
- Konfigurace technologií pracujících s daty (Kafka, Elasticsearch)
Následující obrázek ilustruje proces na příkladu, kde je připojen nový logovací zdroj
(Fortinet FortiGate) (pod operujícím tenantem mytenant):

- LogMan.io Receiver sbírá přicházející události a ukládá data do Archivu ve streamu
fortinet-fortigate-10110pro tenantmytenant. - Tyto události mohou být z Archivu vytaženy zpět pro parsování. Jsou poslány do Kafka topicu
received.mytenant.fortinet-fortigate-10110. - LogMan.io Elman detekuje tento topic, přiřadí nový event lane a vytvoří jednu nebo více instancí LogMan.io Parsec.
- LogMan.io Parsec konzumuje syrové události z tohoto topicu a posílá úspěšně zparsované události a nezparsované události do Kafka topiců
events.mytenant.fortinet-fortigate-10110aothers.mytenant, resp. - LogMan.io Depositor konzumuje události z těchto topiců a ukládá je do Elasticsearch indexů
lmio-mytenant-events-fortinet-fortigate-10110almio-mytenant-others.
Deklarace event lane
Deklarace event lane je specifikována v YAML souboru v Library.
Následující příklad je deklarace event lane pro logovací zdroj Microsoft 365 a tenant mytenant:
define:
name: Microsoft 365
type: lmio/event-lane
timezone: UTC
parsec:
name: /Parsers/Microsoft/365/
content:
reports: /Reports/Microsoft/365/
dashboards: /Dashboards/Microsoft/365/
kafka:
received:
topic: received.mytenant.microsoft-365-v1
events:
topic: events.mytenant.microsoft-365-v1
others:
topic: others.mytenant
elasticsearch:
events:
index: lmio-mytenant-events-microsoft-365-v1
others:
index: lmio-mytenant-others
Definice
Část define specifikuje typ deklarace a
vlastnosti event lane použité pro parsování a analýzu dat, jako je použité schéma, časové pásmo a znaková sada.
define:
name: Microsoft 365
type: lmio/event-lane
schema: /Schemas/ECS.yaml # (volitelné, výchozí: /Schemas/ECS.yaml)
timezone: Europe/Prague # (volitelné, výchozí je získáno z konfigurace tenanta)
charset: utf-8 # (volitelné, výchozí: utf-8)
Parsec
Sekce parsec se odkazuje na mikroservisu LogMan.io Parsec. Konkrétně, parsec/name je adresář pro parsovací pravidla v Library. Musí vždy začínat /Parsers/:
parsec:
name: /Parsers/Microsoft/365/
Obsah
Sekce content se odkazuje na obsah event lane v Library, jako jsou dashboardy, reporty, korelace, atd.
Když je vytvořen nový event lane, LogMan.io Elman automaticky povolí obsah popsaný v této sekci.
content:
# Celý adresář, popsán jako jeden řetězec
dashboards: /Dashboards/Microsoft/365/
# Více položek popsáno jako seznam
reports:
- /Reports/Microsoft/365/Daily Report.json
- /Reports/Microsoft/365/Weekly Report.json
- /Reports/Microsoft/365/Monthly Report.json
Kafka, Elasticsearch
Sekce kafka a elasticsearch specifikují vlastnosti Kafka topiců a Elasticsearch indexů, které patří k onomu event lane. Tyto jsou důležité pro LogMan.io Parsec a LogMan.io Depositor.
Nejdůležitější vlastnost je název received, events, a others topiců a lmio-events a lmio-others indexů.
Kafka topic následuje pojmenovací konvenci:
<type>.<tenant>.<stream>
Elasticsearch indexy následují pojmenovací konvenci:
lmio-<tenant>-<type>-<stream>
kde:
typemůže býtreceived,eventsnebootherstenantje název tenantastreamje název logovacího streamu
kafka:
received:
topic: received.mytenant.microsoft-365-v1
events:
topic: events.mytenant.microsoft-365-v1
others:
topic: others.mytenant
elasticsearch:
events:
index: lmio-mytenant-events-microsoft-365-v1
others:
index: lmio-mytenant-others
Poznámka
Každý tenant má pouze jeden others topic, proto zde není specifikace streamu v topicu a indexu others.
Dále jsou v sekci elasticsearch konfigurovány další vlastnosti Elasticsearch (např. počet shardů, životní cyklus indexů atd.). Více se dočtete v dokumentaci LogMan.io Depositor.
Deklarace šablony event lane
Pro automatické přiřazení parsovacích pravidel a obsahu z Library se používají šablony event lane. Když je nalezen nový stream, LogMan.io Elman hledá vhodnou šablonu event lane. Když ji najde, nový event lane je automaticky naplněn vlastnostmi z této šablony.
Následující příklad ilustruje šablonu event lane pro logovací zdroj Microsoft 365:
---
define:
type: lmio/event-lane-template
name: Microsoft 365
stream: microsoft-365-v1
timezone: UTC
logsource:
vendor:
- microsoft
product:
- m365
service:
- audit
- activitylogs
parsec:
name: /Parsers/Microsoft/365
content:
dashboards: /Dashboards/Microsoft/365
reports: /Reports/Microsoft/365
Definice
define:
type: lmio/event-lane-template
name: Microsoft 365
stream: microsoft-365-v1
timezone: UTC
- name: Člověkem čitelný název pro event lane, odvozený z technologie logovacího zdroje. Používá se např. pro konfiguraci Průzkumníka (Discover).
- stream: Název, který bude shodný s aktuálním streamem.
Může zde být přesná shoda (jako např.
microsoft-365-v1), ale zástupné znaky (např.*) jsou povoleny, aby pokryly širokou škálu streamů (např.fortinet-fortigate-*). - timezone (volitelné): Různé logovací zdroje zasílají události v pevně stanoveném časovém pásmu (např. Microsoft 365 používá vždy UTC). Aby to bylo zohledněno, může zde být předepsáno časové pásmo. Jinak je každá event lane řešena ručně.
Kategorizace
Sekce logsource se používá pro kategorizaci logovacího zdroje připojeného k event lane.
Je odvozena z Sigma pravidel.
logsource:
vendor:
- microsoft
product:
- m365
service:
- audit
- activitylogs
Parsec
Možnost parsec/name je adresář pro parsovací pravidla v Library. Musí vždy začínat /Parsers/:
parsec:
name: /Parsers/Microsoft/365
Obsah
Sekce content se odkazuje na obsah event lane v Library, jako jsou dashboardy, reporty, korelace, atd.
LogMan.io Elman automaticky deaktivuje každý obsah ze všech šablon event lane. Když je vytvořen nový event lane, jeho obsah je povolen.
content:
# Celý adresář, popsán jako jeden řetězec
dashboards: /Dashboards/Microsoft/365
# Více položek popsáno jako seznam
reports:
- /Reports/Microsoft/365/Daily Report.json
- /Reports/Microsoft/365/Weekly Report.json
- /Reports/Microsoft/365/Monthly Report.json
Streamy v LogMan.io Elman
Detekce nových streamů v LogMan.io Elman
LogMan.io Elman periodicky detekuje received.* témata v Kafka clusteru.
Pokud je nalezeno nové received téma bez existujícího event lane, je vytvořen nový event lane použitím šablon event lane.
Pro známé zdroje existuje šablona event lane, která se primárně používá k výběru pravidel parsování pro daný event lane.
LogMan.io Elman hledá vhodnou šablonu v /Templates/EventLanes/. Může nastat jedna z následujících situací:
-
Šablona event lane je nalezena v knihovně. Pravidla parsování a další specifický obsah jsou poté zkopírovány do event lane. Poté je vygenerován model pro LogMan.io Parsec v
/Site/a LogMan.io Elman posílá UP příkaz do ASAB Remote Control. Na závěr je veškerý obsah uvedený v event lane povolen v knihovně. -
Šablona event lane není nalezena v knihovně. Poté je vytvořen event lane, ale cesta pro pravidla parsování není vyplněna, stejně jako další specifický obsah event lane. Model není vytvořen automaticky. Je vyžadován zásah uživatele. Uživatel může vhodná pravidla parsování vyplnit ručně v deklaraci event lane. Nakonec je možné všechny modely ručně aktualizovat z terminálu pomocí curl:
curl --location --request PUT 'localhost:8954/model'
Nakonec se vytvoří jeden nebo více instance LogMan.io Parsec a proces parsování začíná.
Kafka témata
LogMan.io Elman aktualizuje vlastnosti Kafka received.*, events.* a others.* témat.
Zejména se zvýší počet oddílů pro každé téma a nastaví se politika uchovávání. Podívejte se na Konfigurace pro více detailů.
Obsah knihovny
LogMan.io Elman zakáže každý obsah ze všem šablon event lane v knihovně. Když je vytvořen nový event lane, jeho obsah je automaticky povolen pro tenant daného event lane.
Event Deduplication
LogMan.io Odstranění duplicit událostí
TeskaLabs LogMan.io Odstranění duplicit událostí (LMIO Ededup pro zkrácení) je mikroservis odpovědný za odstraňování duplicitních událostí z logového proudu před jejich odesláním do LogMan.io Parsec. To zajišťuje, že jsou zpracovávány a ukládány pouze jedinečné události v analyzovaném formátu, což snižuje šum a zlepšuje kvalitu zaznamenaných dat.
- Konfigurace popisuje, jak spustit a nakonfigurovat LMIO Ededup.
- Event Lane popisuje, jak povolit odstranění duplicit událostí pro konkrétní event lane.
Konfigurace deduplikace událostí LogMan.io
Model
Pro spuštění aplikace ji zahrňte do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-ededup:
- <node> # Nahraďte názvem uzlu
Příklad
LMIO Ededup vyžaduje následující závislosti:
- Apache ZooKeeper
- Apache Kafka
Toto je minimalistický příklad konfigurace deduplikace událostí LogMan.io:
[web]
listen = :28964
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
Rámce
Rámce jsou síťové rozhraní, které naslouchá příchozím připojením. Ve výchozím nastavení má LMIO Ededup nakonfigurován jeden rámec, který naslouchá na portu 8964. Můžete změnit naslouchací adresu a port nastavením parametru listen v sekci [frame] konfiguračního souboru.
[frame]
listen=:8964
Časové okno
Časové okno je časové období, během kterého jsou identifikovány a odstraňovány duplicitní události.
Výchozí časové okno je 5 minut. Můžete jej změnit nastavením parametru window v sekci [general] konfiguračního souboru. Hodnota je řetězec trvání, např. 10s, 5m, 1h.
[general]
window=5m
Datová linka
Chcete-li povolit deduplikaci událostí pro konkrétní datovou linku, nastavte možnost deduplicate na true v konfiguračním souboru datové linky.
define:
type: lmio/event-lane
archive:
output:
deduplicate: true
Integrační služba
LogMan.io Integration Service
TeskaLabs LogMan.io Integration Service (zkráceně LMIO Integ) umožňuje integraci TeskaLabs LogMan.io s podporovanými externími systémy přes očekávaný formát zpráv a vstupní/výstupní protokol.
Další informace o Integration Service:
Konfigurace
- Výchozí port:
8960
Model
Chcete-li spustit aplikaci, zahrňte ji do modelu a klikněte na tlačítko Použít.
define:
type: rc/model
services:
lmio-integ:
- <node> # Nahraďte názvem uzlu
Příklad
LMIO Integ vyžaduje pouze minimální konfiguraci:
[zookeeper]
servers=zookeeper-1:2181,zookeeper-2:2181,zookeeper-3:2181
[kafka]
bootstrap_servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
[library]
providers=/library
Integrace jsou specifikovány v událostních lanech.
Ulice událostí
Integrace jsou deklarovány v dráhách událostí. Každá dráha událostí může poskytovat jednu nebo více integrací. Události jsou přeposílány z Kafka tématu events, které je uvedeno v deklaraci dráhy událostí.
---
define:
type: lmio/event-lane
name: Fortinet FortiGate (10040)
...
integrations:
# Forward events using TCP syslog protocol
- bsd_syslog:
output_type: tcp
address: 1.2.3.4 514
# filters: # see below
# rate_limiter: # see below
# Forward events in CEF format
- cef:
output_type: tcp
address: 1.2.3.4 1234
# filters: # see below
# rate_limiter: # see below
Podporované integrace:
json: Přeposílá příchozí událost jako JSON řetězecbsd_syslog: Přeposílá původní událost nebo JSON pomocí BSD Syslogcef: Přeposílá událost ve formátu CEF vhodném např. pro Micro Focus ArcSightraw: Přeposílá původní událost bez jakéhokoli záhlaví nebo formátovánítcp_bsd_syslog_rfc6587: Přeposílá původní událost přes TCP s rámcováním RFC 6587 počítajícím oktety (kompatibilní s LogMan.io Collectorinput:TCPBSDSyslogRFC6587)events: Přeposílá (parsované) události zevnitř Event Lanemapping: Mapuje atributy z události na vlastní názvy polí pomocí konfigurační možnostimapping
typ_výstupu:
tcp: Odesílá zprávy přes protokol TCP. Vyžaduje adresu (host port).kafka: Odesílá zprávy na určené téma Kafka, odkud je může číst jiná služba.unix-stream: Odesílá zprávy přes UNIX stream socket.script: Odesílá zprávy do skriptu specifikovaného v konfigurační volběscript:, skript by měl být umístěn v/Integrations/Scriptsuvnitř knihovny
Omezovač rychlosti
Když je použit výstupní typ tcp, lze pro danou integraci použít možnost omezovače rychlosti s názvem rate_limiter následujícím způsobem k omezení počtu EPS (událostí za sekundu):
bsd_syslog:
output_type: tcp
address: 127.0.0.1 7999
rate_limiter: 20000 # EPS
Omezovač rychlosti tedy nastavuje maximálně 20 000 EPS pro danou integraci, takže výstupní technologie, která bude data zpracovávat, se může vyhnout problémům s výkonem.
Surové přeposílání
Konfigurace:
raw:
output_type: tcp
address: 1.2.3.4 2345
delimiter: Nepovinný argument, který určuje, jaký oddělovač připojit ke každé přeposlané události, je to znak neboCR,LFneboCRLF.
Tato integrace používá pole raw ze schématu.
Tip
Použijte tuto integraci, pokud chcete jednoduše přeposílat příchozí zprávy v jejich původní podobě do jiných aplikací.
TCP BSD Syslog RFC 6587
Konfigurace:
tcp_bsd_syslog_rfc6587:
output_type: tcp
address: 1.2.3.4 514
Přeposílá původní událost pomocí RFC 6587 rámcování počítáním oktetů (<octet-count> SP <message>). Kompatibilní s LogMan.io Collector input:TCPBSDSyslogRFC6587.
Tato integrace používá pole raw ze schématu.
Tip
Použijte tuto integraci místo raw, když mohou protokoly obsahovat znaky nového řádku a přijímající kolektor očekává rámování podle RFC 6587.
JSON
Konfigurace:
json:
output_type: tcp
address: 1.2.3.4 2345
Tato integrace převádí událost na JSON řetězec a odesílá ji na specifikovaný (zde tcp) výstup.
BSD Syslog
Integrace, která vytváří události ve formátu BSD Syslog (RFC 3164).
Konfigurace:
bsd_syslog:
output_type: tcp
address: 1.2.3.4 514
delimiter: Nepovinný argument, který určuje, jaký oddělovač připojit ke každé přeposlané události, je to znak neboCR,LFčiCRLF.
Tato integrace používá pole raw a principal_datetime ze schématu.
Příklad výstupu
<14> Oct 01 12:43:25 instance-1 lmio-integ[1]: <30>Oct 01 12:43:13 bradavice-hagrid ntopng[1007416]: ....
Note the BSD syslog header added by TeskaLabs LogMan.io.
Přesměrování pole
Integrace přeposílání polí vytváří události s konkrétním polem, obvykle event.original, v jednoduchém JSONu.
field:
output_type: tcp
address: 1.2.3.4
field_name: event.original
Příklad výstupu
{
"event.original": <30>Oct 01 12:43:13 bradavice-hagrid ntopng[1007416]: ....
}
CEF
Integrace CEF (např. s Micro Focus ArcSight) odesílá zpracované události z tématu events ve běžném formátu CEF ArcSight.
Konfigurace:
cef:
output_type: tcp
address: 1.2.3.4 1234
Předpokládáme, že Micro Focus ArcSight naslouchá na TCP 1.2.3.4:1234.
Tato integrace používá pole deviceEventClassId_field, name_field a severity_field ze schématu:
---
define:
type: lmio/schema
deviceEventClassId_field: deviceEventClassId
name_field: name
severity_field: severity
...
Příklad výstupu
CEF:0|TeskaLabs|LogMan.io|1.0|<deviceEventClassId_field>|<name_field>|<severity_field>| {
"@timestamp": "2024-09-30T02:30:13.343068Z",
"ecs.version": "1.10.0",
"event.action": "high-download-rate",
"event.dataset": "complex",
"event.kind": "alert",
"related.events": [],
"rule.description": "This baseliner observes logs that indicate file download activity and checks if a user exceeds the expected rate of downloads. It tracks download activity across a defined period (day) and region (Czech Republic), analyzing patterns based on workdays, weekends, and holidays. When the user's download rate exceeds normal behavior by a significant margin (3 standard deviations above the mean), it triggers an alert for further investigation.\n",
"rule.id": "",
"rule.name": "High Download Rate",
"rule.ruleset": "lmio-library",
"tenant": "plus",
"threat.indicator.sightings": 22,
"user.id": "dolores_umbridge@hogwarts.uk",
"_id": "9c15c30d30b3b813df94393288310d17ff06364f6e9cb5bb8d374ec1ca6dd6a0"
}
Filtry
Pro nastavení filtrů pro příchozí události viz sekci Filtry.
Filtry
Pro použití filtrů, které filtrují příchozí události, které mají být předány do výstupu integrace, musí být v deklaraci událostní dráhy specifikována možnost filters.
Událostní dráha
V událostní dráze specifikujte cestu k filtrům v možnosti filters sekce integrations:
---
define:
type: lmio/event-lane
name: Fortinet FortiGate (10040)
kafka:
events:
topic: events.mytenant.fortinet-fortigate-10040 # (povinné)
others:
topic: others.mytenant
integrations:
raw:
output_type: tcp
address: 127.0.0.1 8884
filters: /Integrations/Filters/AuthenticationFilter.yaml
Může být specifikováno více filtrů v seznamu. V tomto případě budou události odpovídající alespoň jednomu filtru předány do specifikovaného výstupu integrace:
---
define:
type: lmio/event-lane
name: Fortinet FortiGate (10040)
kafka:
events:
topic: events.mytenant.fortinet-fortigate-10040 # (povinné)
others:
topic: others.mytenant
integrations:
raw:
output_type: tcp
address: 127.0.0.1 8884
filters:
- /Integrations/Filters/AuthenticationFilter.yaml
- /Integrations/Filters/ConfigurationFilter.yaml
Filtr
Deklarace filtrů se nacházejí v /Integrations/Filters/ v knihovně. Deklarace filtru obsahuje sekce define a predicate:
---
define:
name: AuthenticationFilter
type: integ/filter
predicate:
!EQ
- !ITEM EVENT event.category
- authentication
Definice
Vždy zahrňte do define:
| Položka v pravidle | Jak zahrnout |
|---|---|
|
Pojmenujte filtr. I když název nemá vliv na funkčnost filtru, měl by to být název, který je jasný a snadno pochopitelný pro vás i ostatní. |
|
Zahrňte tuto řádku tak, jak je. type má vliv na funkčnost pravidla.
|
Následující možnosti v define jsou volitelné:
| Položka v pravidle | Jak zahrnout |
|---|---|
|
Stručně a přesně popište filtr. |
Predikát
Sekce predicate je samotný filtr. Když píšete predicate, používáte výrazy SP-Lang k strukturování podmínek pro filtr "povolit" pouze události, které mají být předány do výstupu.
Podívejte se na tento průvodce, abyste se dozvěděli více o psaní predikátů.
Autorizace a Autentizace
TeskaLabs LogMan.io používá TeskaLabs SeaCat Auth jako komponentu, která se zabývá autorizací uživatelů, autentizací, řízením přístupu, rolemi, tenanti, vícefaktorovou autentizací, integracemi s jinými poskytovateli identity a podobně.
TeskaLabs SeaCat Auth má svůj vlastní dokumentační web.
Funkce
- Autentizace
- Dvoufaktorová autentizace (2FA) / Vícefaktorová autentizace (MFA)
- Podporované faktory:
- Heslo
- FIDO2 / Webauthn
- Jednorázové heslo založené na čase (TOTP)
- SMS kód
- Hlavicka požadavku (X-Header)
-
Stroj-na-stroj
- API klíče
-
Autorizace
- Role
-
Správa identit
- Federace identit
- Podporovaní poskytovatelé:
- Soubor (htpasswd)
- In-memory slovník
- MongoDB
- ElasticSearch
- LDAP a Active Directory
- Vlastní poskytovatel
-
Multitenance včetně správy tenantů pro další služby a aplikace
- Správa relací
- Jednotné přihlášení
- OpenId Connect / OAuth2
- Proof Key for Code Exchange aka PKCE pro veřejné klienty OAuth 2.0
- Backend introspekce autorizace/autentizace pro NGINX
- Auditní stopa
- Provisioning mód
- Strukturované logování (Syslog) a telemetrie
LogMan.io Velitel
LogMan.io Velitel umožňuje spouštět následující užitečné příkazy přes příkazovou řádku nebo API.
Přikaz encpwd
Hesla používaná v konfiguracích mohou být chráněna šifrováním.
Příkaz pro šifrování hesel šifruje heslo(a) do formátu hesla LogMan.io pomocí šifry AES.
Hesla jsou pak použita v deklarativní konfiguraci LogMan.io Kolektora v následujícím formátu:
!encpwd "<LMIO_PASSWORD>"
Konfigurace
Výchozí cesta ke klíči AES může být nastavena následujícím způsobem:
[pwdencryptor]
key=/data/aes.key
Použití
Docker kontejner
Příkazová Řádka
docker exec -it lmio-commander lmiocmd encpwd MyPassword
API
LogMan.io Velitel také slouží jako API endpoint, takže příkaz encpwd
lze dosáhnout přes HTTP požadavek:
curl -X POST -d "MyPassword" http://lmio-commander:8989/encpwd
Přikaz library
Příkaz Library slouží k vložení struktury složky knihovny se všemi YAML deklaracemi do ZooKeeperu, odkud si ji ostatní komponenty jako LogMan.io Parser a Korrelátor mohou dynamicky stahovat.
Struktura složky může být umístěna v souborovém systému (namontovaná do Docker kontejneru) nebo na URL adrese GIT.
Takto se inicializuje načítání knihovny do ZooKeeper clusteru:
Konfigurace
Je nutné správně nakonfigurovat zdrojovou složku a výstupní cestu pro ZooKeeper.
[source]
path=/library
[destination]
urls=zookeeper:12181
path=/lmio
Zdrojová cesta může být cesta GIT repozitáře s předponou git://:
[source]
path=git://<username>:<deploy_token>@<git_url_path>.git
Tímto způsobem bude knihovna automaticky klonována z GITu do dočasné složky, nahrána do ZooKeeperu a následně dočasná složka smazána.
Použití
Docker kontejner
Příkazová Řádka
docker exec -it lmio-commander lmiocmd library load
S explicitně definovanou konfigurací:
docker exec -it lmio-commander lmiocmd -c /data/lmio-commander.conf library load
API
LogMan.io Velitel také slouží jako API endpoint, takže příkaz library
lze dosáhnout přes HTTP požadavek:
curl -X PUT http://lmio-commander:8989/library/load
Podívejte se na oddíl Docker Compose níže.
Přikaz iplookup
Příkaz iplookup zpracovává databáze IP rozsahů a generuje IP lookup soubory připravené k použití s lmio-parser IP Enricher.
Má dva podpříkazy: iplookup from-csv pro zpracování obecných CSV souborů a iplookup from-ip2location pro zpracování CSV souborů IP2LOCATION.
Konfigurace
Zdrojové a cílové adresáře lze nastavit v konfiguračním souboru
[iplookup]
source_path=/data
destination_path=/data
iplookup from-csv
Načítá obecný CSV soubor a vytváří soubor lookup IP Enricher.
První řádek souboru by měl obsahovat hlavičku se jmény sloupců.
První dva sloupce musí být ip_from a ip_to.
Interface příkazové řádky
lmiocmd.py iplookup from-csv [-h] [--separator SEPARATOR] [--zone-name ZONE_NAME] [--gzip] [--include-ip-range] file_name
Povinné argumenty:
file_name: Vstupní CSV soubor
Volitelné argumenty:
-h,--help: Zobrazí tuto nápovědu a ukončí program.-g,--gzip: Komprimuje výstupní soubor pomocí gzip.-i INPUT_IP_FORMAT,--input-ip-format INPUT_IP_FORMAT: Formát vstupních IP adres. Výchozí hodnota je 'ipv6'. Možné hodnoty:ipv6: IPv6 adresa reprezentována jako řetězec, např. ::ffff:c000:02eb,ipv4: standardní quad-dotted IPv4 adresa jako řetězec, např. 192.0.2.235,ipv6-int: IPv6 adresa jako 128-bitové desetinné celé číslo, např. 281473902969579,ipv4-int: IPv4 adresa jako 32-bitové desetinné celé číslo, např. 3221226219.-s SEPARATOR,--separator SEPARATOR: Oddělovač sloupců CSV.-o LOOKUP_NAME,--lookup-name LOOKUP_NAME: Název výstupního lookupu. Používá se jako název zóny lookupu. Ve výchozím nastavení je odvozeno od názvu vstupního souboru.--include-ip-range: Zahrnout pole ip_from a ip_to do hodnot lookupu.--force-ipv4: Zabránit mapování IPv4 adres na IPv6. Toto je nekompatibilní s IPv6 vstupními formáty.
Ukázkové použití
lmiocmd iplookup from-csv \
--input-ip-format ipv6 \
--lookup-name ip2country \
--gzip \
my-ipv6-zones.CSV
iplookup from-ip2location
Tento příkaz je podobný příkazu iplookup from-csv, ale je speciálně navržen pro zpracování IP2Location™ CSV databází.
V případě IP2LOCATION LITE databází může příkaz odvodit formát vstupních IP a názvy sloupců z názvu souboru.
Nicméně je možné explicitně specifikovat názvy sloupců
Interface příkazové řádky
lmiocmd.py iplookup from-csv [-h] [--separator SEPARATOR] [--zone-name ZONE_NAME] [--gzip] [--include-ip-range] file_name
Povinné argumenty:
file_name: Vstupní CSV soubor
Volitelné argumenty:
-h,--help: Zobrazí tuto nápovědu a ukončí program.-g,--gzip: Komprimuje výstupní soubor pomocí gzip.-s SEPARATOR,--separator SEPARATOR: Oddělovač sloupců CSV. Výchozí hodnota je ','.-c COLUMN_NAMES,--column-names COLUMN_NAMES: Mezery oddělený seznam názvů sloupců k použití. Ve výchozím nastavení je odvozen z názvu souboru IP2LOCATION.-i INPUT_IP_FORMAT,--input-ip-format INPUT_IP_FORMAT: Formát vstupních IP adres. Ve výchozím nastavení je odvozen z názvu souboru IP2LOCATION. Možné hodnoty:ipv6-int: IPv6 adresa jako 128-bitové desetinné celé číslo, např. 281473902969579,ipv4-int: IPv4 adresa jako 32-bitové desetinné celé číslo, např. 3221226219.-o LOOKUP_NAME,--lookup-name LOOKUP_NAME: Název výstupního lookupu. Používá se jako název zóny lookupu. Ve výchozím nastavení je odvozen z názvu vstupního souboru.-e, --keep-empty-rows: Nevyřazovat řádky s prázdnými hodnotami (označené '-').--include-ip-range: Zahrnout pole ip_from a ip_to do hodnot lookupu.--force-ipv4: Zabránit mapování IPv4 adres na IPv6.
Ukázkové použití
S automatickými názvy sloupců a formátem vstupních IP:
lmiocmd iplookup from-ip2location \
--lookup-name ip2country \
--gzip \
IP2LOCATION-LITE-DB1.IPV6.CSV
S explicitními názvy sloupců a formátem vstupních IP (výsledek bude ekvivalentní výše uvedenému příkladu):
lmiocmd iplookup from-ip2location \
--lookup-name ip2country \
--gzip \
--column names "ip_from ip_to country_code country_name" \
--input-ip-format ipv6-int
IP2LOCATION-LITE-DB1.IPV6.CSV
Docker Compose
Soubor
Následující soubor docker-compose.yml stahuje image LogMan.io Velitele
z TeskaLabs Docker Registry a očekává konfigurační soubor
ve složce ./lmio-commander.
version: '3'
services:
lmio-commander:
image: docker.teskalabs.com/lmio/lmio-commander
container_name: lmio-commander
volumes:
- ./lmio-commander:/data
- /opt/lmio-library:/library
ports:
- "8989:8080"
Cesta /opt/lmio-library vede k repozitáři knihovny LogMan.io.
Spustit kontejner
docker-compose pull
docker-compose up -d
Deklarativní jazyk SP-Lang
TeskaLabs LogMan.io používá SP-Lang jako deklarativní jazyk pro parsery, obohacovače, korelátory a další komponenty.
SP-Lang má svůj vlastní dokumentační web.
Knihovna v TeskaLabs LogMan.io
Knihovna obsahuje deklarace pro analyzátory, obohacovače, korelátory, šablony pro e-maily a instantní zprávy, dashboardy, zprávy a další obsah TeskaLabs LogMan.io.
Organizace knihovny
Knihovna je organizována do složek s položkami, podobně jako soubory v souborovém systému.
Následující příklad ilustruje organizaci knihovny se třemi základními složkami /Baselines/, /Dashboards/ a /Parsers/:
/Baselines/
Dataset.yaml
Host.yaml
User.yaml
/Dashboards/
Linux/
Common/
Overview.json
/Parsers/
Linux/
Auditd/
10_parser.yaml
20_enricher.yaml
30_mapping_ECS.yaml
Common/
10_parser.yaml
20_parser_process.yaml
30_parser_message.yaml
Pravidla pro cesty knihovny
Vnitřně (v konfiguraci mikroservis atd.) musí cesty knihovny splňovat tato pravidla:
- Každá cesta MUSÍ začínat znakem "/", včetně kořenové cesty. Používají se pouze absolutní cesty, např.
/Parsers/Microsoft/Exchange/. - Cesta složky MUSÍ končit znakem "/", např.
/Parsers/Microsoft/Exchange/. - Cesta položky MUSÍ končit příponou (např. ".txt", ".json", ...), např.
/Parsers/Microsoft/Exchange/10_parser.yaml - Název složky NESMÍ obsahovat ".". Název položky NESMÍ začínat ".".
Note
Uživatel nemůže vytvářet nové složky v nejvyšší složce /. Některé složky umožňují uživateli přidávat/ upravovat/ mazat soubory a složky uvnitř nich, zatímco některé to neumožňují. Každá složka knihovny má svá vlastní pravidla pro to.
Některé složky knihovny umožňují pouze specifické přípony souborů.
Příklad: Složka /Parsers/ umožňuje vytváření nových složek a pravidel pro analýzu končících na .yaml uvnitř.
Složka /Homepage/ neumožňuje přidávat další položky (protože existuje pouze jedna domovská stránka).
Složka /Alerts/Workflow/ neumožňuje vytváření nových složek uvnitř, zatímco umožňuje přidávání nebo mazání existujících pracovních postupů upozornění.
Vrstvy knihovny
Knihovna je organizována do vrstev. Každá vrstva knihovny se odkazuje na jeden zdroj souborů knihovny a konkrétní technologii úložiště. Vrstvy knihovny jsou "naskládány" do jednoho pohledu (překryty), což spojuje obsah každé vrstvy do jednoho sjednoceného prostoru. Toto vrstvení umožňuje kombinovat obsah z různých zdrojů (tzv. poskytovatelů) do jedné knihovny. Vrstvy knihovny jsou zpočátku konfigurovány v produktu během instalace. Neexistuje žádný limit na počet naskládaných vrstev knihovny.

Schéma: Příklad nastavení vrstev knihovny, uživatel uvidí položky v zeleném rámečku.
Příklad konfigurace implementující výše uvedené schéma.
Knihovna je konfigurována buď centrálně pomocí ASAB Maestro, nebo v každém konfiguračním souboru mikroservisu.
[knihovna]
poskytovatelé:
zk://
libsreg+https://libsreg1.example.com,libsreg2.example.com/my-library#v24.11
git+https://github.com/john/awesome_project.git#deployment
libsreg+https://vendor.example.com/common-library
- Vrstva 0 je v Apache ZooKeeper, znovu využívající konfiguraci ZooKeeper z části
[zookeeper]. - Vrstva 1 je "my-library" distribuovaná pomocí registru knihoven.
- Vrstva 2 je z Gitu (nebo konkrétněji z GitHubu), sledující větev "deployment".
- Vrstva 3 je "společná knihovna" poskytovatele.
Zapisovatelná vrstva
Vrstva 0 je jediná zapisovatelná vrstva. Je určena k vytváření a úpravě vlastního obsahu. Uživatel může upravovat obsah této vrstvy pomocí editoru "Knihovna" v uživatelském rozhraní.
Vyšší vrstvy jsou pouze pro čtení, určené pro jednosměrnou distribuci obsahu knihovny do nasazení.
Pokud uživatel upraví položku, která je přítomna ve vrstvách pouze pro čtení, je uložena ve vrstvě 0, což přepisuje položku se stejnou cestou na vyšších vrstvách. Toto je mechanismus, jak mohou uživatelé měnit obsah dodaný společnými knihovnami a podobně.
Vrstva 0 je dále rozdělena na cíle, což může být globální cíl pro obsah, který je dostupný pro celé nasazení, nebo nájemní cíl, který ukládá obsah pro konkrétní nájemce. To znamená, že obsah specifický pro nájemce, jako jsou Parsers nebo Dashboards, je uložen ve vrstvě 0, v cíli "nájemce".
Typy vrstev knihovny
Každá vrstva knihovny je dodávána prostřednictvím poskytovatele.
Apache ZooKeeper
Vrstva uložená lokálně v technologii Apache ZooKeeper. Je to distribuovaná a redundantní vrstva prostřednictvím konsensuálního mechanismu v ZooKeeperu. Tato vrstva je typickou volbou pro zapisovatelnou vrstvu 0.
Konfigurační prefix: zk:/.
Note
Administrátoři mohou také použít nástroj ZooNavigator k prozkoumání a úpravě obsahu vrstvy ZooKeeper.
Repozitář knihoven
Obsah v této vrstvě je poskytován prostřednictvím distribučního bodu specifikovaného URI. Distribuční bod je server nebo veřejné cloudové úložiště přístupné přes HTTPS. Je to vrstva pouze pro čtení. Distribuce přes repozitář knihoven je preferovaný způsob distribuce obsahu. Obsah vrstvy je automaticky aktualizován, takže pokud je aktualizovaný obsah dostupný na serverech repozitáře knihoven, bude distribuován do knihoven v nasazeních.
Konfigurační prefix: libsreg:/.
Příklad: libsreg+https://libsreg1.example.com/my-library.
Verze
Tento poskytovatel podporuje verzování.
Verze je specifikována v fragmentové části URL (po symbolu #):
Příklad: libsreg+https://libsreg1.example.com/my-library#v24.11
Verze mohou být statické (tj. v24.11, neměnící se po jejím vydání) nebo rolling (tj. production nebo main, změny jsou nepřetržitě propagovány do distribučního bodu a tím do nasazení).
Tip
Verzování je navrženo tak, aby fungovalo s CI/CD procesem na publikátorovi obsahu knihovny. Typicky je "hlavní" nebo zlatá kopie knihovny uložena v Gitu na platformě CI/CD a je nasazena do distribučního bodu automatizací CI/CD.
Odolnost
Tento poskytovatel podporuje odolné dodávání obsahu. Můžete specifikovat více než jeden distribuční server v konfiguraci. TeskaLabs LogMan.io bude iterovat na další specifikované servery, pokud požadavek selže.
Příklad: libsreg+https://libsreg1.example.com,libsreg2.example.com/my-library.
Git
Vrstva, která poskytuje (pouze pro čtení) obsah z Git repozitáře. Je určena pro nepřetržitou dodávku obsahu z Git serveru, jako je GitHub nebo GitLab.
Konfigurační prefixy: git+https:/, git+http:/ nebo git:/.
Verze v Gitu
Tento poskytovatel podporuje verzování.
Verze je specifikována v fragmentové části URL (po symbolu #):
Příklad: git+https://github.com/john/awesome_project.git#deployment
Výchozí verze je nastavena v konkrétním Git repozitáři.
Typické hodnoty jsou master nebo main.
Používá se, když není poskytnut žádný fragment.
Verze mohou být statické (tj. v24.11, neměnící se po jejím vydání) nebo rolling (tj. production nebo main, změny jsou nepřetržitě propagovány do distribučního bodu a tím do nasazení).
Souborový systém
Vrstva uložená v souborovém systému.
Warning
Jelikož je souborový systém lokální pro uzel, tento typ vrstvy není vhodný pro použití v clusterech.
Konfigurační prefixy: file:/ nebo /.. (jak v absolutních cestách souborového systému).
Microsoft Azure Storage
Vrstva, která poskytuje (pouze pro čtení) obsah z kontejneru umístěného v Microsoft Azure Storage.
Konfigurační prefix: azure+https:/
Note
Pokud není úroveň veřejného přístupu kontejneru nastavena na "Veřejný přístup", pak musí být vytvořena "Politika přístupu" s oprávněním "Číst" a "Seznam" a "Shared Access Signature" (SAS) dotazovací řetězec musí být přidán do URL v konfiguraci:
[knihovna]
poskytovatelé: azure+https://ACCOUNT-NAME.blob.core.windows.net/BLOB-CONTAINER?sv=2020-10-02&si=XXXX&sr=c&sig=XXXXXXXXXXXXXX
Povolení a zakázání obsahu
Jakákoli položka obsahu knihovny může být globálně nebo specificky pro nájemce zakázána. Zakázáním souborů mohou administrátoři upravit obsah dostupný uživatelům konkrétního nájemce.
Obsah může být povolen/zakázán z obrazovky "Knihovna" nebo pomocí souboru /.disabled.yaml umístěného ve vrstvě 0.
Společná knihovna LogMan.io
Společná knihovna LogMan.io je distribuovaný obsah, který se nachází na nejvyšších vrstvách knihovny. Reprezentuje výchozí obsah, poskytovaný TeskaLabs nebo partnery.
Plnotextové indexování
Obsah knihovny (všechny vrstvy) je automaticky indexován, aby uživatelé mohli rychle vyhledávat konkrétní obsah.
Další informace
Technické podrobnosti lze také nalézt zde https://docs.teskalabs.com/asab.
Apache Kafka
Apache Kafka
Apache Kafka slouží jako fronta pro dočasné ukládání událostí mezi mikroservisami LogMan.io. Pro více informací viz Architektura.
Apache Kafka within LogMan.io
Pojmenovávání témat v událostních pruzích
Každý událostní kanál má specifikována témata received, events a others.
Každý název tématu obsahuje jméno nájemce a tok události v následujícím formátu:
received.tenant.stream
events.tenant.stream
others.tenant
přijatý.nájemce.přítok
Téma received ukládá příchozí záznamy pro příchozího tenant a stream událostní linky.
udalosti.nájemce.proud
Tématika events ukládá rozparsované události pro danou událostní dráhu definovanou tenant a stream.
jiný.nájemce
Téma others uchovává neanalyzované události pro daného tenant.
události.nájemce.aktivita
Téma aktivity napříč nájemcem pro kompaktní aktivitu hostitele/uživatele/služby z LogMan.io Parsec. Deklarováno v /EventLanes/<tenant>/activity.yaml. Používá LogMan.io Assets k aktualizaci first_seen / last_seen v inventáři aktiv. Viz Správa aktiv Parsec.
události.nájemce.komplex
Nájemce komplexní téma pro detekce korelátoru. Využívá se LogMan.io Assets pro aktualizace skóre rizika entit. Viz Skóre rizika entity.
Interní témata
Existují následující interní témata pro LogMan.io:
lmio-ohlášení
Téma uchovává vyvolané upozornění a čte ho mikroservis LogMan.io Alerts.
lmio-oznámení
Téma uchovává vyvolané oznámení a čte jej mikroslužba ASAB IRIS.
lmio-vyhledávání
Toto téma ukládá požadované změny v lookupech a čte ho mikroservis LogMan.io Watcher.
Doporučené nastavení pro 3-uzlový cluster
Existují tři instance Apache Kafka, jedna na každém uzlu.
Počet oddílů pro každé téma musí být alespoň stejný jako počet spotřebitelů (3) a dělitelný 2, proto je doporučený počet oddílů vždy 6.
Doporučený počet replik je 1.
Každé téma musí mít rozumnou sadu pro uchování založenou na dostupné velikosti SSD disků.
Ve clusterovém prostředí LogMan.io, kde je průměrný EPS nad 1000 událostí za sekundu a prostor na SSD disku je pod 2 TB, je obvykle doba uchovávání 1 den (86400000 milisekund). Viz sekce Příkazy.
Nápověda
Když je EPS nižší nebo je k dispozici více místa na SSD, doporučuje se nastavit uchovávání pro Kafka témata na vyšší hodnoty, například 2 nebo více dní, aby administrátorům byl poskytnut více času na řešení potenciálních problémů.
Chcete-li správně vytvořit oddíly, repliky a uchovávání, podívejte se na sekci Příkazy.
Kafka témata
LogMan.io default topics
Následující témata jsou výchozí témata LogMan.io používaná k předávání zpracovaných událostí mezi jednotlivými komponentami.
| Téma Kafka | Producent | Spotřebitel(é) | Typ uložených zpráv |
|---|---|---|---|
received.<tenant>.<stream> |
Receiver LogMan.io | LogMan.io Parsec | syrové záznamy / události |
events.<tenant>.<stream> |
LogMan.io Parsec | Vkladatel LogMan.io Základní čára LogMan.io | úspěšně zpracované události. |
others.<tenant> |
LogMan.io Parsec | Vkladatel LogMan.io | události nebyly úspěšně analyzovány. |
events.<tenant>.activity |
LogMan.io Parsec | Aktiva LogMan.io | kompaktní události činnosti pro aktualizace inventáře aktiv |
events.<tenant>.complex |
Korelovací nástroj LogMan.io | Aktiva LogMan.io | složitá detekce pruhů (vstup skóre rizika entity) |
complex.<tenant> |
Korelovací nástroj LogMan.io | Pozorovatel LogMan.io | |
lmio-alerts |
Upozornění LogMan.io | ||
lmio-lookups |
Vyhledávání LogMan.io | události vyhledávání (informace o aktualizaci položky vyhledávání) | |
lmio-notifications |
|||
lmio-stores |
LogMan.io topics within Event Lane
Po nasazení LogMan.io Collector automaticky LogMan.io Receiver vytvoří Kafka téma RECEIVED na základě tenant a stream.
Tento název má formu received.<tenant>.<stream>. Toto téma je unikátní pro každou Event Lane.
LogMan.io Parsec odebírá zprávy z tématu RECEIVED a analyzuje je. Když je analýza úspěšná, zpráva je odeslána do tématu EVENTS, když selže, zpráva je odeslána do tématu OTHERS.
Téma EVENTS má formu events.<tenant>.<stream> a je jedinečné pro každou Event Lane.
Téma OTHERS má formu others.<tenant> a ukládá všechny nesprávně rozpoznané zprávy, bez ohledu na Event Lane, unikátní pro každého nájemce.
LogMan.io Depositor odebírá zprávy z témat EVENTS a OTHERS a posílá je do odpovídajících indexů Elasticsearch.
Příklad
Předpokládejme, že jméno nájemce je hogwarts a jméno streamu je microsoft-365. Pak jsou vytvořena následující témata:
received.hogwarts.microsoft-365: Téma, kde jsou ukládány neupravené (neparsované) události.events.hogwarts.microsoft-365: Téma, kde jsou ukládány úspěšně parsované události.others.hogwarts: Pokud jsou některé události neúspěšně parsovány, jsou ukládány do tohoto tématu.
Příkazy
Následující příkazy slouží k vytváření, změně a mazání Kafka témat v prostředí LogMan.io. Všechna Kafka témata spravovaná LogMan.io vedle interních jsou specifikována v deklaracích event lane, které lze nalézt ve složce /EventLanes v knihovně.
Požadavky
Všechny příkazy by měly být spuštěny z Docker kontejneru Kafka. Je velmi pohodlné vytvořit pomocný dočasný kontejner pro administrativní příkazy.
docker run --network=host --rm -it confluentinc/cp-kafka:<version> bash
Tímto se vytvoří nový Kafka kontejner, který bude odstraněn po vašem odchodu a je vybaven rozhraním příkazového řádku Kafka, které je zdokumentováno zde: Nástroje rozhraní příkazového řádku Kafka (CLI)
Vytvoření tématu
Pro vytvoření tématu specifikujte název tématu, počet partition a faktor replikace. Faktor replikace by měl být nastaven na 1 a partition na 6, což je výchozí hodnota pro Kafka témata LogMan.io.
/usr/bin/kafka-topics --bootstrap-server localhost:9092 --create --topic "events.<tenant>.<stream>" --replication-factor 1 --partitions 6
Nahraďte events.<tenant>.<stream> vaším názvem tématu.
Kafka verze nižší než 7.0
Pro Kafka verze nižší než 7.0 příkaz nepoužívá možnost --bootstrap-server, ale místo toho používá možnost --zookeeper. Zde je příkaz pro starší verze Kafka:
/usr/bin/kafka-topics --zookeeper localhost:2181 --create --topic "events.<tenant>.<stream>" --replication-factor 1 --partitions 6
Konfigurace tématu
Retence
Následující příkaz změní retenci dat pro Kafka téma na 86400000 milisekund, což je 1 den. To znamená, že data starší než 1 den budou odstraněna z Kafka, aby se uvolnilo místo na disku:
/usr/bin/kafka-configs --bootstrap-server localhost:9092 --entity-type topics --entity-name "events.<tenant>.<stream>" --alter --add-config retention.ms=86400000
Nahraďte events.<tenant>.<stream> vaším názvem tématu.
Info
Všechna Kafka témata v LogMan.io by měla mít nastavenou retenci pro data.
Info
Při úpravě nastavení tématu v Kafka by měly být speciální znaky, jako je tečka (.), escapovány lomítkem (\).
Resetování offsetu spotřebitelské skupiny pro dané téma
Pro resetování pozice čtení, nebo offsetu, pro dané ID skupiny (spotřebitelské skupiny) použijte následující příkaz:
/usr/bin/kafka-consumer-groups --bootstrap-server localhost:9092 --group "my-console-client" --topic "events.<tenant>.<stream>" --reset-offsets --to-datetime 2020-12-20T00:00:00.000 --execute
Nahraďte events.<tenant>.<stream> vaším názvem tématu.
Nahraďte my-console-client daným ID skupiny.
Nahraďte 2020-12-20T00:00:00.000 časem, na který chcete resetovat čtecí offset.
Hint
Pro resetování skupiny na aktuální offset použijte --to-current místo --to-datetime 2020-12-20T00:00:00.000.
Mazání offsetu spotřebitelské skupiny pro dané téma
Offset pro dané téma může být odstraněn ze spotřebitelské skupiny, čímž by byla spotřebitelská skupina efektivně odpojena od samotného tématu. Použijte následující příkaz:
/usr/bin/kafka-consumer-groups --bootstrap-server localhost:9092 --group "my-console-client" --topic "events.<tenant>.<stream>" --delete-offsets
Nahraďte events.<tenant>.<stream> vaším názvem tématu.
Nahraďte my-console-client daným ID skupiny.
Mazání spotřebitelské skupiny
Spotřebitelská skupina pro VŠECHNA témata může být odstraněna se svými informacemi o offsetu pomocí následujícího příkazu:
/usr/bin/kafka-consumer-groups --bootstrap-server localhost:9092 --delete --group my-console-client
Nahraďte my-console-client daným ID skupiny.
Změna tématu
Změna počtu partition
Následující příkaz zvyšuje počet partition v daném tématu.
/usr/bin/kafka-topics --bootstrap-server localhost:9092 --alter --partitions 6 --topic "events.<tenant>.<stream>"
Nahraďte events.<tenant>.<stream> vaším názvem tématu.
Specifikujte uzel ZooKeeper
Kafka čte a mění data uložená v ZooKeeperu. Pokud jste nakonfigurovali Kafka tak, aby jeho soubory byly uloženy v konkrétním uzlu ZooKeeper, obdržíte tuto chybu.
Chyba při provádění příkazu tématu: Téma 'events.<tenant>.<stream>' neexistuje, jak se očekávalo
[2024-05-06 10:16:36,207] CHYBA java.lang.IllegalArgumentException: Téma 'events.<tenant>.<stream>' neexistuje, jak se očekávalo
at kafka.admin.TopicCommand$.kafka$admin$TopicCommand$$ensureTopicExists(TopicCommand.scala:539)
at kafka.admin.TopicCommand$ZookeeperTopicService.alterTopic(TopicCommand.scala:408)
at kafka.admin.TopicCommand$.main(TopicCommand.scala:66)
at kafka.admin.TopicCommand.main(TopicCommand.scala)
(kafka.admin.TopicCommand$)
Přizpůsobte argument --zookeeper podle potřeby. Např. data Kafka jsou uložena v uzlu kafka ZooKeeperu:
/usr/bin/kafka-topics --zookeeper lm11:2181/kafka --alter --partitions 6 --topic 'events\.tenant\.fortigate'
Zkuste odstranit escape znaky (/), pokud název tématu stále není rozpoznán.
Smazání tématu
Téma může být smazáno pomocí následujícího příkazu. Mějte prosím na paměti, že Kafka témata jsou automaticky vytvářena, pokud jsou do nich produkována/odesílána nová data jakoukoli službou.
/usr/bin/kafka-topics --bootstrap-server localhost:9092 --delete --topic "events.<tenant>.<stream>"
Nahraďte events.<tenant>.<stream> vaším názvem tématu.
Řešení problémů
V ostatních jsou mnohé logy a nemohu najít ty s atributem "interface"
Kafka Console Consumer může být použit k získání událostí z více témat, zde ze všech témat začínajících na events..
Dále je možné vyhledat pole v dvojitých uvozovkách:
/usr/bin/kafka-console-consumer --bootstrap-server localhost:9092 --whitelist "events.*" | grep '"interface"'
Tento příkaz vám poskytne všechny příchozí logy s atributem "interface" ze všech event témat.
Přiřazení oddílů Kafka
Když je přidán nový uzel Kafka, Kafka automaticky neprovádí přiřazení oddílů. Následující kroky se používají k provedení ručního přiřazení oddílů Kafka pro specifikované téma(y).
-
Vstupte do shellu kontejneru Docker Kafka:
docker exec -it kafka-1 bash -
Vytvořte
/tmp/topics.jsons tématy, jejichž oddíly by měly být přiřazeny v následujícím formátu:cat << EOF | tee /tmp/topics.json { "topics": [ {"topic": "events.tenant.stream"}, ], "version": 1 } EOF -
Vygenerujte JSON výstup pro přiřazení z seznamu témat, která mají být migrována. Specifikujte ID brokerů v seznamu brokerů:
/usr/bin/kafka-reassign-partitions --zookeeper localhost:2181 --broker-list "121,122,221,222" --generate --topics-to-move-json-file /tmp/topics.jsonVýsledek by měl být uložen v
/tmp/reassign.jsona vypadat následovně, přičemž všechna témata a oddíly mají specifikováno své nové přiřazení:[appuser@lm11 data]$ cat /tmp/reassign.json {"version":1,"partitions":[{"topic":"events.tenant.stream","partition":0,"replicas":[122],"log_dirs":["any"]},{"topic":"events.tenant.stream","partition":1,"replicas":[221],"log_dirs":["any"]},{"topic":"events.tenant.stream","partition":2,"replicas":[222],"log_dirs":["any"]},{"topic":"events.tenant.stream","partition":3,"replicas":[121],"log_dirs":["any"]},{"topic":"events.tenant.stream","partition":4,"replicas":[122],"log_dirs":["any"]},{"topic":"events.tenant.stream","partition":5,"replicas":[221],"log_dirs":["any"]}]} -
Použijte výstup z předchozího příkazu jako vstup pro provedení přiřazení/převažování:
/usr/bin/kafka-reassign-partitions --zookeeper localhost:2181 --execute --reassignment-json-file /tmp/reassign.json --additional --bootstrap-server localhost:9092
To je vše! Nyní by Kafka měla provést přiřazení oddílů během následujících hodin.
Pro více informací viz Přiřazení oddílů v Apache Kafka Clusteru.
Standardy pojmenování
Repozitáře produktů
Repozitáře produktů obsahují zdrojové kódy všech komponent LogMan.io (data pumpy, služby, UI atd.).
Názvy repozitářů produktů, které jsou vždy vyvíjeny a udržovány společností TeskaLabs,
vždy začínají předponou lmio-.
Repozitáře produktů by neměly být upravovány zákazníky ani partnery.
Repozitáře konfigurace serverů
Repozitáře konfigurace serverů obsahují konfigurace pro jednotlivé komponenty LogMan.io, základní technologie a soubory Docker Compose pro dané nasazení na daném serveru.
Repozitáře konfigurace serverů mohou být také udržovány partnerem nebo zákazníkem.
Jejich názvy vždy začínají předponou site-.
Repozitáře partnerů
Repozitáře, které udržuje partner nebo zákazník, vždy obsahují název partnera v malých písmenech po předponě, oddělené pomlčkami.
Proto u repozitářů konfigurace serverů formát vypadá následovně:
site-<partner_name>-<location>
Kde location je místo nasazení (název společnosti, která spravuje server).
Pokud je místo všeobecně známé, může být popsáno jiným explicitním způsobem,
například build-env pro označení prostředí pro sestavení.
Poznámky
Klíčové slovo environment je vždy zkráceno na env.
Klíčové slovo encrypt je vždy zkráceno na enc.
Multi-tenancy
TeskaLabs LogMan.io je produkt založený na multitenanci, který vyžaduje specifikaci identifikace tenantu (zákazníka) v každém logu, což lze provést automaticky pomocí Kolektoru logů LogMan.io.
Každá instance Parseru LogMan.io je specifická pro tenant, stejně jako indexy uložené v ElasticSearch. Tudíž pouze logy patřící danému tenantu jsou zobrazeny danému tenantu v Kibana nebo LogMan.io UI.
Také metriky sledování toku v Grafaně jsou tenantově orientované a tudíž umožňují monitorovat tok logů pro každého jednotlivého zákazníka.
Standard pojmenování
Kvůli využití technologie TeskaLabs LogMan.io, všechny identifikace tenantů musí být malým písmem bez jakýchkoliv speciálních znaků (jako jsou #, * atd.).
Nástroje
Seznam open-source nástrojů třetích stran, které lze integrovat s TeskaLabs LogMan.io. Po povolení jsou k dispozici v sekci "Nástroje" LogMan.io.
Kybernetická bezpečnost
Kibana
Kibana je open-source nástroj pro vizualizaci a průzkum dat používaný pro analytiku logů a časových řad. Týmy kybernetické bezpečnosti používají Kibanu hlavně pro analytické úkoly.
Více informací na Průvodce Kibana
Včelí úl
TheHive je platforma pro reakci na bezpečnostní incidenty.
Více informací na thehive-project.org
MISP
MISP je open-source platforma pro získávání, ukládání a sdílení indikátorů a hrozeb kybernetické bezpečnosti týkajících se incidentů kybernetické bezpečnosti.
Chcete-li načíst atributy MISP do vyhledávání IOC na LogMan.io podle plánu (formulář UI Lookups nebo knihovna YAML), podívejte se na Hrozbovou inteligenci: MISP zdroj.
Více informací na misp-project.org
Datová věda
Jupyter Notebook
JupyterLab je webové interaktivní vývojové prostředí pro poznámkové bloky, kód a data. Jeho flexibilní rozhraní umožňuje uživatelům konfigurovat a uspořádávat pracovní postupy v oblasti datové vědy, vědeckého výpočtu, výpočetní žurnalistiky a strojového učení. Modulární design umožňuje rozšíření pro rozšíření a obohacení funkcionality.
Více informací na Jupyter Notebook
Technická podpora
ZooNavigátor
ZooNavigator je webové uživatelské rozhraní pro správu a prohlížení dat Apache Zookeeper.
https://github.com/elkozmon/zoonavigator
Grafana
Grafana je open-source platforma pro monitorování a pozorovatelnost.
https://github.com/grafana/grafana
Kafdrop
Webové rozhraní Kafka pro prohlížení témat a procházení skupin spotřebitelů.
Přehled síťových portů
Tato kapitola obsahuje přehled síťových portů používaných LogMan.io. Většina portů je interní a přístupná pouze z interní sítě clusteru.
Interní s흶
| Port | Protokol | Komponenta |
|---|---|---|
| tcp/8890 | HTTP | NGINX (Interní API brána) |
| tcp/8891 | HTTP | asab-remote-control |
| tcp/8892 | HTTP | asab-governator |
| tcp/8893 | HTTP | asab-library |
| tcp/8894 | HTTP | asab-config |
| tcp/8895 | HTTP | asab-pyppeteer |
| tcp/8896 | HTTP | asab-iris |
| tcp/8897 | HTTP | asab-discovery |
| tcp/8900 | HTTP | seacat-auth (Privátní API) |
| tcp/8910 | HTTP | seacat-pki |
| tcp/8950 | HTTP | lmio-receiver (Privátní API) |
| tcp/8951 | HTTP | lmio-ipaddrproc |
| tcp/8952 | HTTP | lmio-watcher |
| tcp/8953 | HTTP | lmio-alerts |
| tcp/8954 | HTTP | lmio-elman |
| tcp/8955 | HTTP | lmio-lookupbuilder |
| tcp/8956 | HTTP | lmio-ipaddrproc |
| tcp/8957 | HTTP | lmio-correlator-builder |
| tcp/8958 | HTTP | lmio-charts |
| tcp/8959 | HTTP | lmio-categorix |
| tcp/8960 | HTTP | lmio-integ |
| tcp/8961 | HTTP | lmio-parser-builder |
| tcp/8962 | HTTP | lmio-trex |
| tcp/8963 | HTTP | lmio-ededup |
| tcp/8964 | Frames | lmio-ededup |
| tcp/8967 | HTTP | lmio-retrohunt |
| tcp/8968 | HTTP | lmio-profiler |
| tcp/8999 | HTTP | lmio-feeds |
| tcp/3443 | HTTPS | lmio-receiver (Veřejné API) |
| tcp/3080 | HTTP | lmio-receiver (Veřejné API) |
| tcp/3081 | HTTP | seacat-auth (Veřejné API) |
| tcp/8790 | HTTP | bs-query |
| tcp/8810 | HTTP | ACME.sh |
| tcp/9092 | Kafka | Apache Kafka |
| tcp/9000 | HTTP | Kafdrop |
| tcp/2181 | ZAB | Apache Zookeeper |
| tcp/9001 | HTTP | Zoonavigator |
| tcp/8086 | HTTP | InfluxDB |
| tcp/8888 | HTTP | Jupyter Notebook |
| tcp/5601 | HTTP | Kibana |
| tcp/3000 | HTTP | Grafana |
| tcp/27017 | proprietární | MongoDB |
Vyberte službu výše pro otevření API reference, nebo zobrazte úplný seznam služeb.