Metriky potrubí
Metody měření pipeline, nebo měření, sledují propustnost logů a událostí v pipeleinech mikroservis. Tyto metody měření pipeline můžete použít k pochopení stavu a zdraví každé mikroservisy.
Data, která se pohybuje skrze mikroservisy, jsou rozdělena a měřena pomocí událostí. (Každá událost je jedna zpráva v Kafka a bude mít za následek jeden záznam v Elasticsearch.) Protože jsou události spočitatelné, metriky kvantifikují propustnost, což vám umožňuje posoudit stav a zdraví pipeline.
BSPump
Několik mikroslužeb TeskaLabs je postaveno na technologii BSPump, takže názvy metrik obsahují bspump.
Mikroslužby postavené na BSPumpu:
* [Collector](../../architecture/index.md#lmio-collector)
* [Ingestor](../../architecture/index.md#lmio-ingestor)
* [Parser/Parsec](../../architecture/index.md#lmio-parser)
* [Dispatcher](../../architecture/index.md#lmio-dispatcher)
* [Correlator](../../architecture/index.md#lmio-correlator)
* [Watcher](../../architecture/index.md#lmio-watcher)
* [Integrační služba](../../integ/index.md)
* Mirage
!!! tip „Architektura mikroslužeb“
Vnitřní architektura každé mikroslužby se liší a může ovlivnit vaši analýzu metrik. Navštivte naši stránku Architektura.
Mikroslužby, které pravděpodobně způsobí nerovnoměrné metriky počítadel event.in a event.out, aniž by skutečně došlo k chybě, jsou:
- Parser/Parsec - To je způsobeno jeho interní architekturou; parser posílá události do jiného pipeline (Enricher), kde události nejsou započítány v
event.out.- Correlator - Protože korelátor hodnotí události, když jsou zapojeny do vzorců, často má nižší počet
event.outneževent.in.
- Correlator - Protože korelátor hodnotí události, když jsou zapojeny do vzorců, často má nižší počet
Metriky
Pojmenování a štítky v Grafaně a InfluxDB
- Skupiny metrik pipeline jsou pod značkou
measurement. - Metriky pipeline jsou vytvářeny pro mikroservisy (značka
appclass) a mohou být dále filtrovány pomocí dalších značekhostapipeline. - Každá jednotlivá metrika (například
event.in) je hodnota ve značcefield.
Všechna měření se ve výchozím nastavení aktualizují automaticky jednou za minutu.
bspump.pipeline
event.in
Popis: Počítá počet událostí vstupujících do pipeline
Jednotka: Počet (událostí)
Interpretace: Sledování event.in v průběhu času vám může ukázat vzorce, špičky a trendy v tom, kolik událostí bylo přijato mikroservisem. Pokud žádné události nepřicházejí, event.in je čára na hodnotě 0. Pokud očekáváte průtok a event.in je 0, existuje problém v datovém kanálu.
event.out
Popis: Počítá počet událostí, které opustily potrubí úspěšně
Jednotka: Počet (událostí)
Interpretace: event.out by obvykle měl být stejný jako event.in, ale existují výjimky. Některé mikroservisy jsou konstruovány tak, aby měly buď více výstupů na jeden vstup, nebo aby přesměrovávaly data způsobem, který není tímto ukazatelem zaznamenán.
event.drop
Popis: Počítá počet událostí, které byly zahozeny, nebo zpráv, které byly ztraceny mikroservisem.
Jednotka: Počet (událostí)
Interpretace: Protože mikroservisy postavené na BSPump obecně nejsou navrženy tak, aby zahazovaly zprávy, jakékoliv zahazování je s největší pravděpodobností chybou.
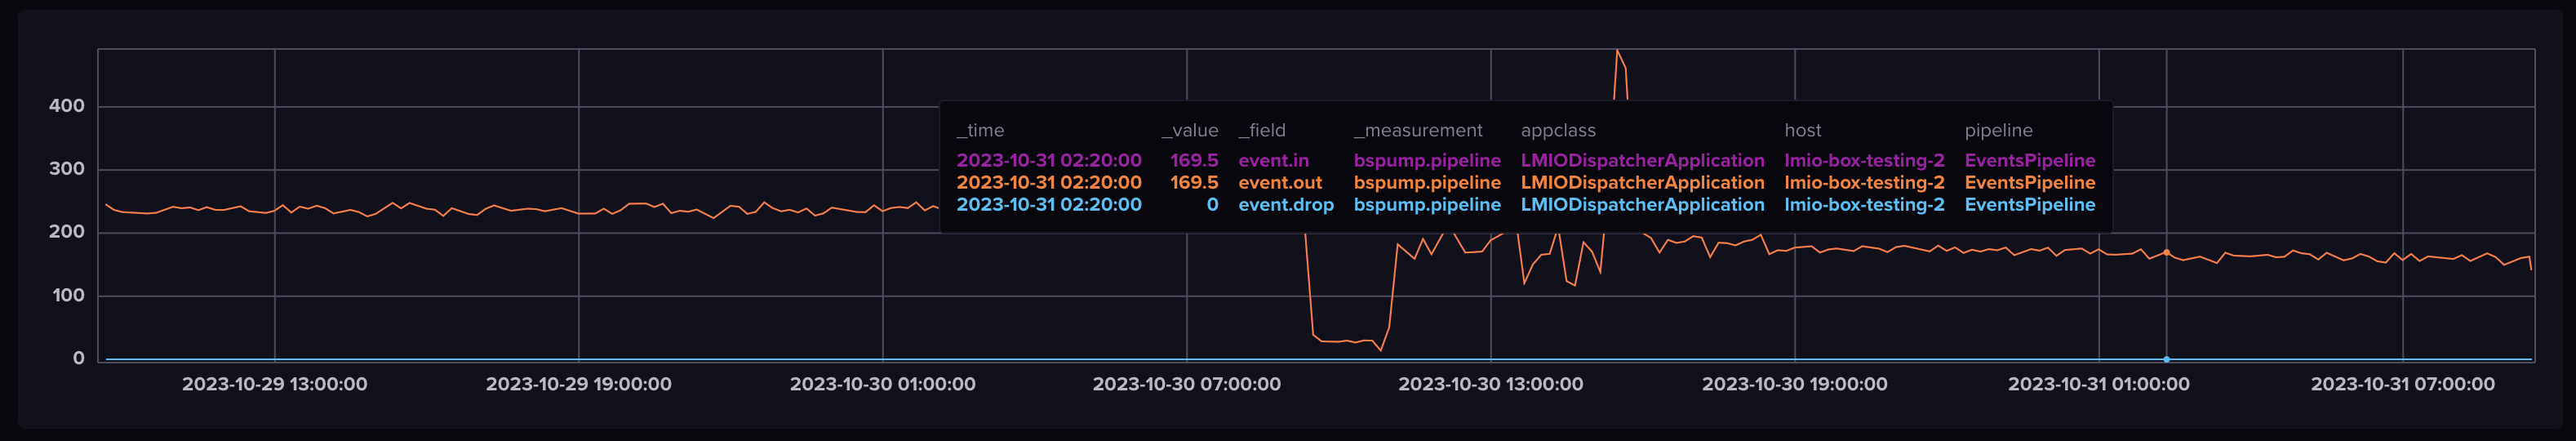 Když najedete myší na graf v InfluxDB, můžete vidět hodnoty každé linie v libovolném čase. V tomto grafu můžete vidět, že
event.out je rovno event.in a event.drop je rovno 0, což je očekávané chování mikroslužby. Stejný počet událostí opouští, kolik jich vstupuje do pipeline, a žádné události nejsou zahozeny.
varování
Popis: Počítá počet varování vzniklých v rámci pipeline.
Jednotka: Počet (varování)
Interpretace: Varování vám říká, že s daty je problém, ale pipeline je stále byla schopna zpracovat. Varování je méně závažné než chyba.
chyba
Popis: Počítá počet chyb v potrubí.
Jednotka: Počet (chyb)
Interpretace: Mikroslužby mohou vyvolat chyby z různých důvodů. Hlavním důvodem chyby je, že data neodpovídají očekávání mikroslužby a pipeline selhala při zpracování těchto dat.
bspump.pipeline.eps
EPS znamená události za sekundu.
eps.in
Popis: "Události za sekundu v" - Míra událostí úspěšně vstupujících do pipeline
Jednotka: Události za sekundu (míra)
Interpretace: eps.in by mělo zůstat konzistentní v průběhu času. Pokud se eps.in mikroslužby neočekávaně zpomaluje, může být problém v datovém potrubí před mikroslužbou.
eps.out
Popis: "Události za sekundu ven" - Míra událostí úspěšně opouštějících potrubí
Jednotka: Události za sekundu (míra)
Interpretace: Podobně jako event.in a event.out, eps.in a eps.out by měly být obvykle stejné, ale mohou se lišit v závislosti na mikroservisu. Pokud události vstupují do mikroservisu mnohem rychleji, než z něj odcházejí, a toto není očekávané chování tohoto pipeline, možná bude potřeba řešit chybu způsobující úzké hrdlo v mikroservisu.
eps.drop
Popis: "Počet událostí za sekundu, které byly zahozeny" - rychlost odhazování událostí v potrubí
Jednotka: Události za sekundu (míra)
Interpretace: Viz event.drop. Pokud eps.drop rychle roste a není to očekávané chování mikroslužby, znamená to, že jsou události vynechávány a v pipeline je problém.
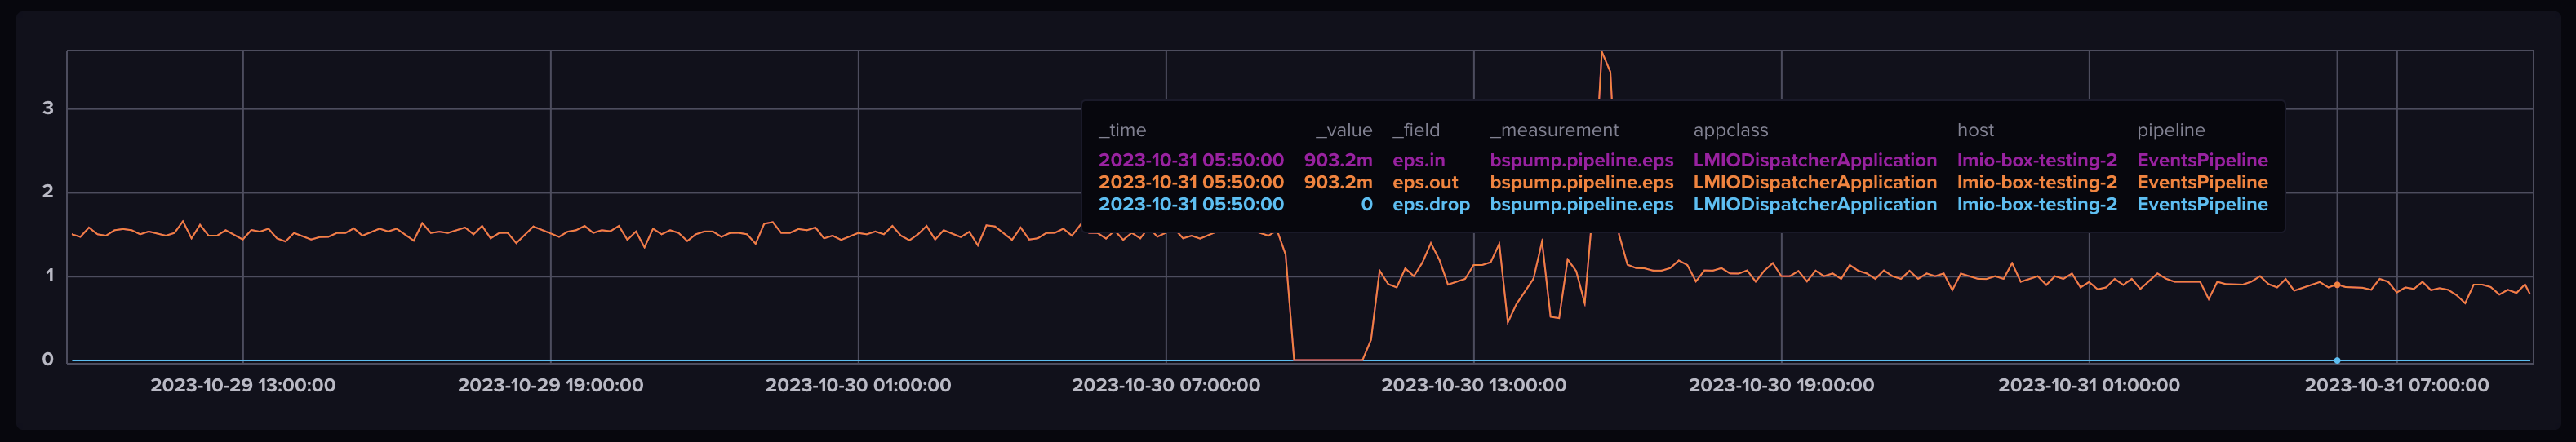 Podobně jako při grafickém znázornění
event.in a event.out, očekávané chování většiny mikroslužeb je, že eps.out bude rovno eps.in a drop bude rovno 0.
varování
Popis: Počítá počet varování vyprodukovaných v rámci pipeline ve specifikovaném časovém období.
Jednotka: Počet (varování)
Interpretace: Varování vám říká, že s daty je problém, ale pipeline je stále byla schopna zpracovat. Varování je méně závažné než chyba.
chyba
Popis: Počítá počet chyb v pipeline během určeného časového období.
Jednotka: Počet (chyb)
Interpretace: Mikroslužby mohou vyvolat chyby z různých důvodů. Hlavním důvodem chyby je, že data neodpovídají očekávání mikroslužby a pipeline selhala při zpracování těchto dat.
bspump.pipeline.gauge
Měřicí metrika, procento vyjádřené číslem od 0 do 1.
varování.poměr
Popis: Poměr událostí, které vyvolaly varování, k celkovému počtu úspěšně zpracovaných událostí.
Interpretace: Pokud se poměr varování neočekávaně zvýší, prozkoumejte potrubí kvůli problémům.
chyba.poměr
Popis: Poměr událostí, které se nepodařilo zpracovat, k celkovému počtu úspěšně zpracovaných událostí.
Interpretace: Pokud se poměr chyb neočekávaně zvýší, prozkoumejte tok zpracování dat kvůli problémům. Můžete vytvořit spouštěč, který vás upozorní, když error.ratio překročí například 5%.
bspump.pipeline.dutycycle
Pracovní cyklus (také nazývaný výkonový cyklus) popisuje, zda je potrubí připraveno přijímat zprávy (připraveno, hodnota 1) nebo není schopno zpracovávat nové zprávy (zaneprázdněno, hodnota 0).
Obecně:
- Hodnota 1 je přijatelná, protože potrubí může zpracovávat nové zprávy
- Hodnota 0 označuje problém, protože potrubí nemůže zpracovávat nové zprávy.
??? tip „Porozumění myšlence pracovní periody“
Můžeme použít lidskou produktivitu k vysvětlení konceptu pracovní periody. Pokud člověk vůbec není zaneprázdněn a nemá co dělat, jen čeká na úkol. Jeho hodnota pracovní periody je 100 % – veškerý čas tráví čekáním a může přijmout více práce. Pokud je člověk zaneprázdněn něčím a nemůže přijmout žádné další úkoly, jeho hodnota pracovní periody je 0 %.
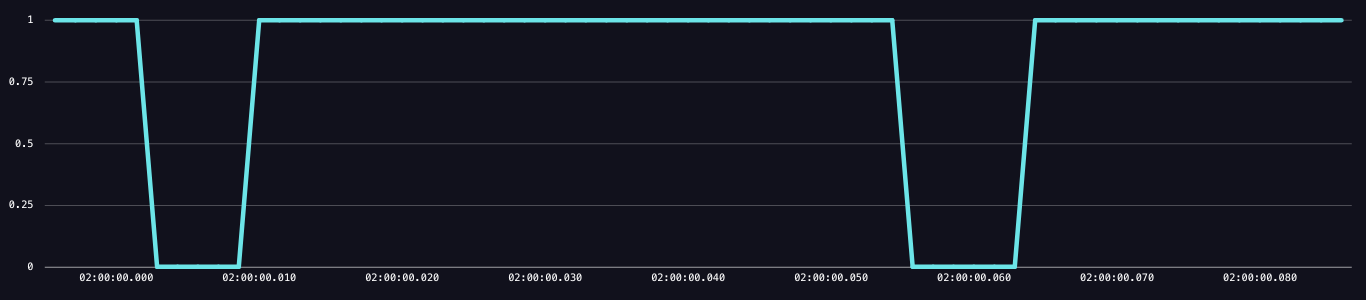 Výše uvedený příklad (nevzešel z InfluxDB) ukazuje, jak vypadá změna pracovní doby na velmi krátkém časovém měřítku. V tomto příkladu měla pipeline dvakrát stav 0, což znamená, že nebyla připravena a nemohla zpracovávat nové příchozí události. Mějte na paměti, že pracovní cyklus vašeho systému se může vybírat mezi 1 nebo 0 tisíckrát za sekundu; grafy pracovního cyklu
ready, které uvidíte v Grafaně nebo InfluxDB, budou již agregovány (více níže).
připravený
Popis: ready agreguje (průměruje) hodnoty poměru pracovní doby jednou za minutu. Zatímco poměr pracovní doby je vyjádřen jako 0 (false, pracuje) nebo 1 (true, čeká), metrika ready představuje procento času, kdy je poměr pracovní doby 0 nebo 1. Proto hodnota ready je procento mezi 0 a 1, takže graf nevypadá jako typický graf poměru pracovní doby.
Jednotka: Procento vyjádřené jako číslo, 0 až 1
Interpretace: Sledování pracovní cyklu je klíčové pro pochopení kapacity vašeho systému. Přestože je každý systém jiný, obecně by ready měla zůstat nad 70 %. Pokud ready klesne pod 70 %, znamená to, že pracovní cyklus klesl na 0 (zaneprázdněno) více než 30 % času v daném intervalu, což naznačuje, že systém je poměrně vytížený a vyžaduje nějakou pozornost nebo úpravu.
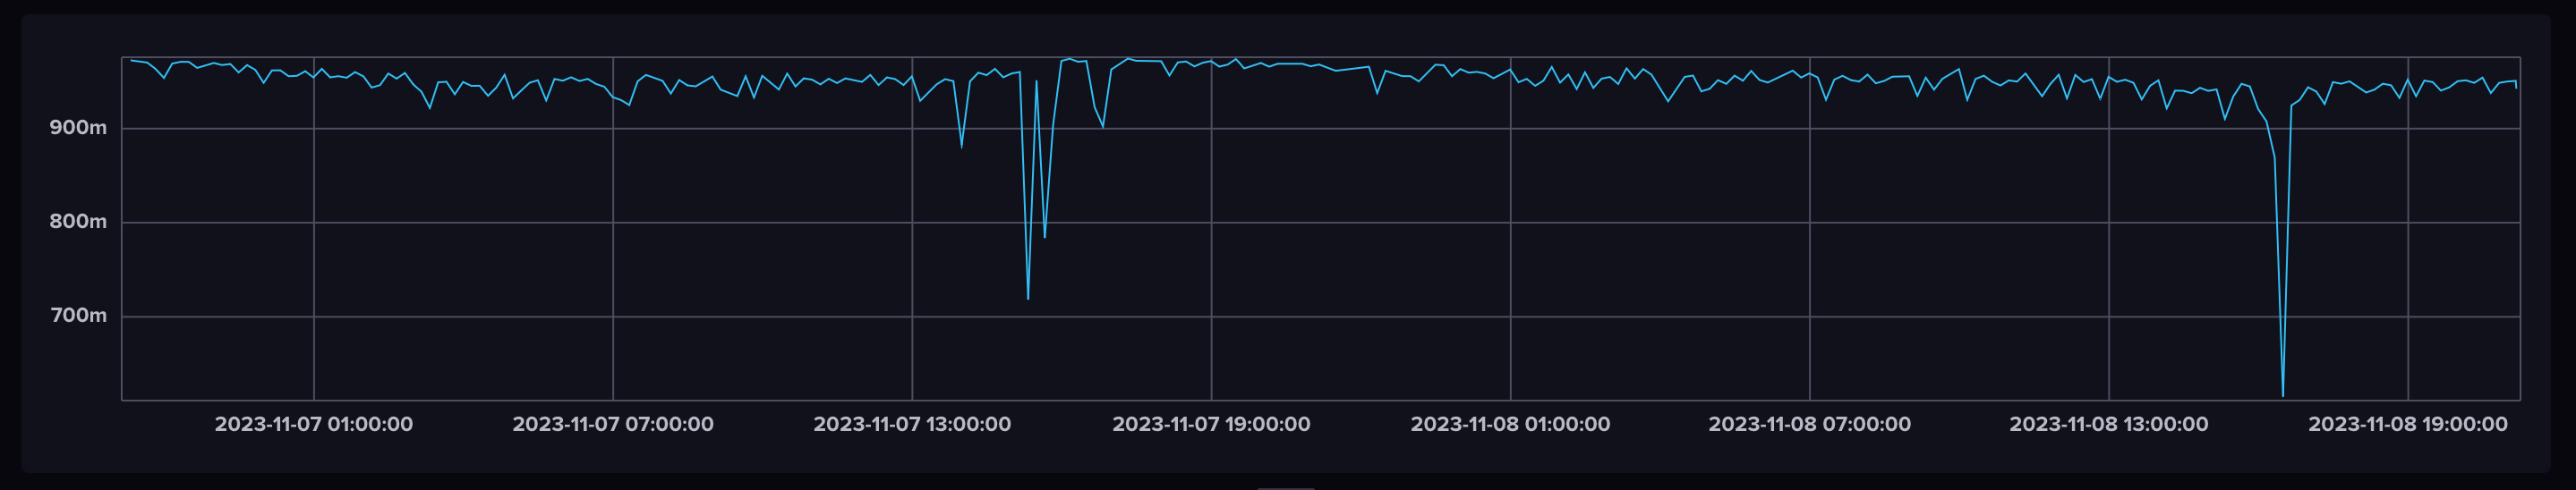 Nahoru uvedený graf ukazuje, že většinu času byl pracovní cyklus připraven více než 90 % času během těchto dvou dnů. Nicméně existují dva body, ve kterých klesl blízko a pod 70 %.
časový posun
Metrika timedrift slouží jako způsob, jak pochopit, do jaké míry se načasování původu událostí (obvykle @timestamp) liší od toho, co systém považuje za "aktuální" čas. To může být užitečné při identifikaci problémů, jako jsou zpoždění nebo nepřesnosti v mikroservisách.
Každá hodnota je ve výchozím nastavení vypočítána jednou za minutu:
průměr
medián
směrodatná odchylka
max
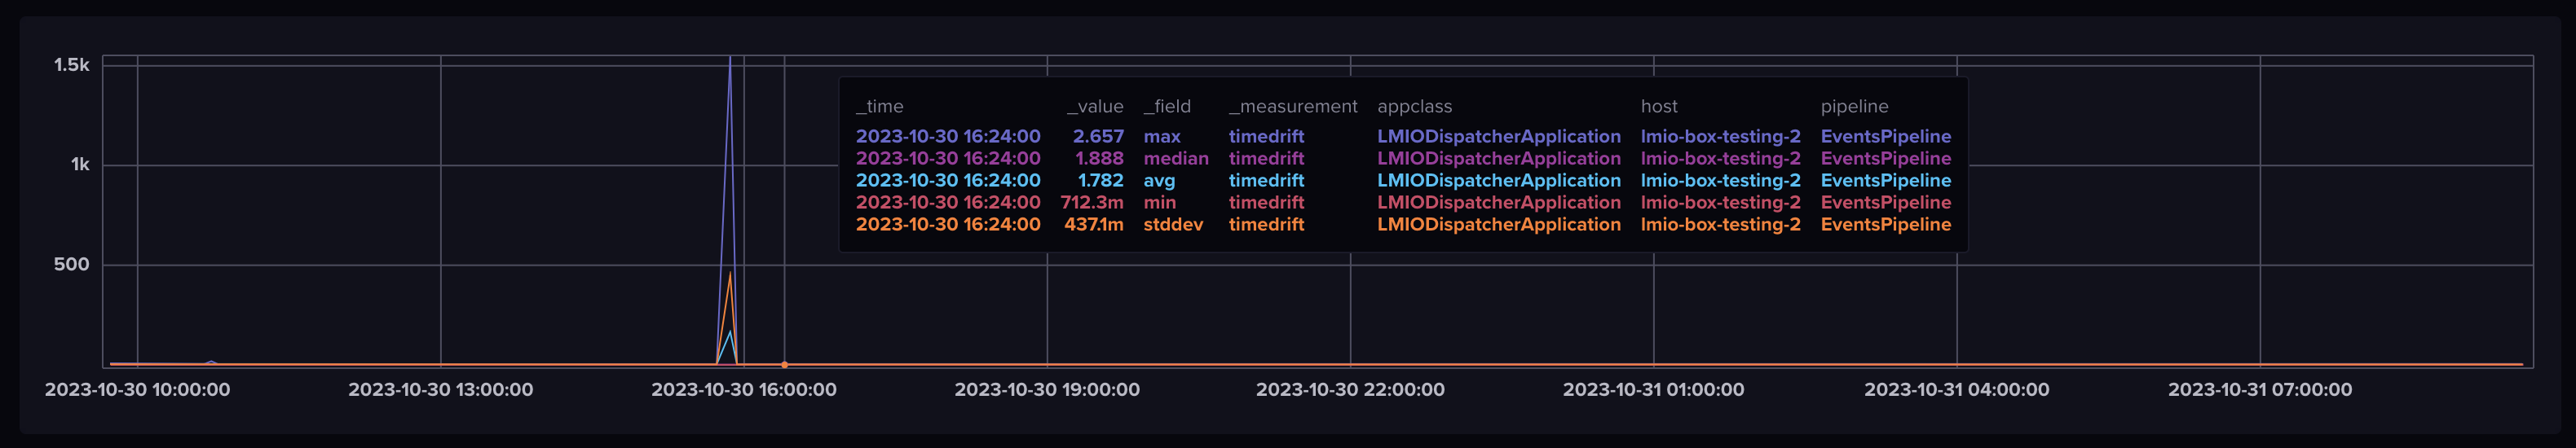 Na tomto grafu posunu času můžete vidět nárůst zpoždění, než se pipeline vrátí do normálu.
commlink
Štítky: ActivityState, appclass (pouze přijímač LogMan.io), host, identity, tenant
- bytes.in: bajty, které vstupují do přijímače LogMan.io
- event.in: události, které vstupují do přijímače LogMan.io
záznamy
Štítky: appclass, host, identity, instance_id, node_id, service_id, tenant
- kritické: Počet kritických záznamů
- chyby: Počet chybových záznamů
- varování: Počet varovných záznamů